文章目录
-
- 一、BERT 出现前的问题
- 二、BERT 是 Encoder-Only Transformer
- 三、BERT 输入格式:`[CLS]`、`[SEP]` 和 Segment
- 四、MLM:遮住一部分 token 再预测
- 五、为什么 MLM 不是普通完形填空
- 六、NSP:判断两句话是否相邻
- 七、BERT 如何用于分类
- 八、BERT 如何用于序列标注和抽取
- 九、BERT 和 Embedding/Rerank 的关系
-
- Embedding
- Rerank
- 十、BERT 的优势
- 十一、BERT 的局限
- 十二、BERT、GPT、T5 怎么对比
- 十三、今天什么时候还该用 BERT 类模型
- 十四、常见误区
- 十五、你应该记住的最小心智模型
- 总结
- 大模型视角
- 下一篇
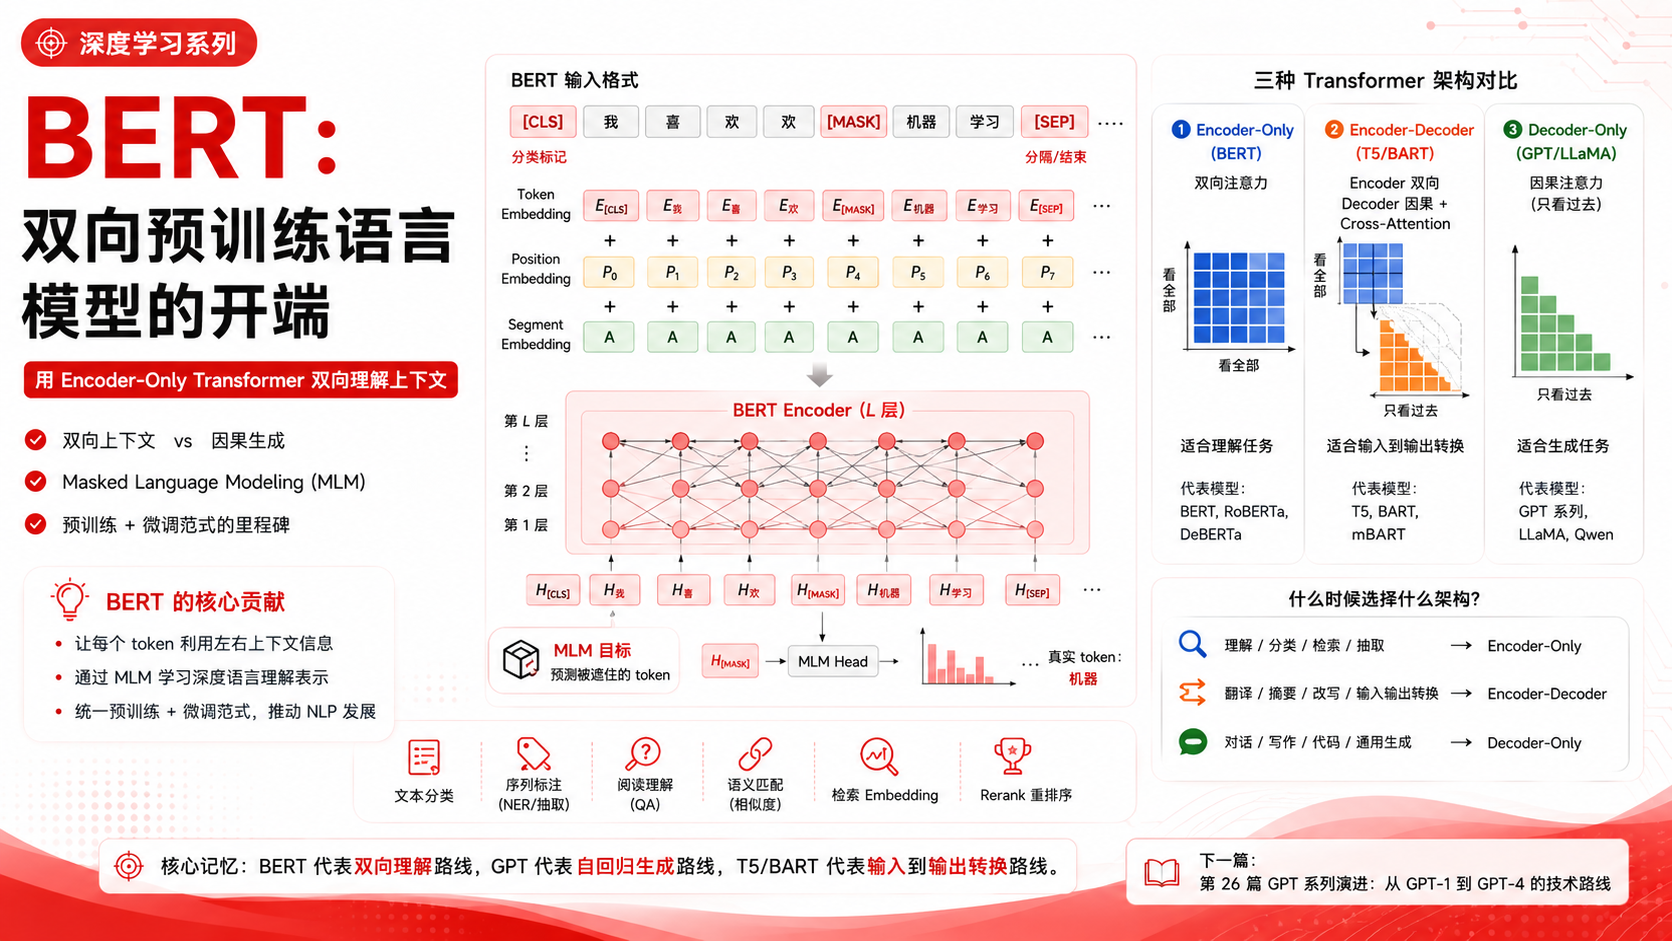
摘要:BERT 是理解型预训练语言模型的里程碑。它不像 GPT 那样从左到右预测下一个 token,而是使用 Encoder-Only Transformer 双向阅读整段文本,并通过 Masked Language Modeling 学习上下文表示。BERT 让“先在海量文本上预训练,再在具体任务上微调”成为 NLP 的主流范式,也为今天的 embedding、rerank、分类、信息抽取等系统打下基础。本文从 BERT 出现前的 NLP 困境讲起,解释 Encoder-Only、MLM、NSP、[CLS]、[SEP]、fine-tuning,并说明为什么在生成式大模型时代,BERT 类模型仍然没有过时。
前置知识: Transformer 架构,多头注意力,架构对比 阅读时间:约 60 分钟 代码环境:Python 3.10+,torch >= 2.0,transformers 可选
入门导读:先抓住主线
BERT 的核心可以用一句话概括:
用 Transformer Encoder 双向阅读文本,通过遮住一部分 token 再预测,让模型学会上下文理解表示。
它和 GPT 的差异非常关键。
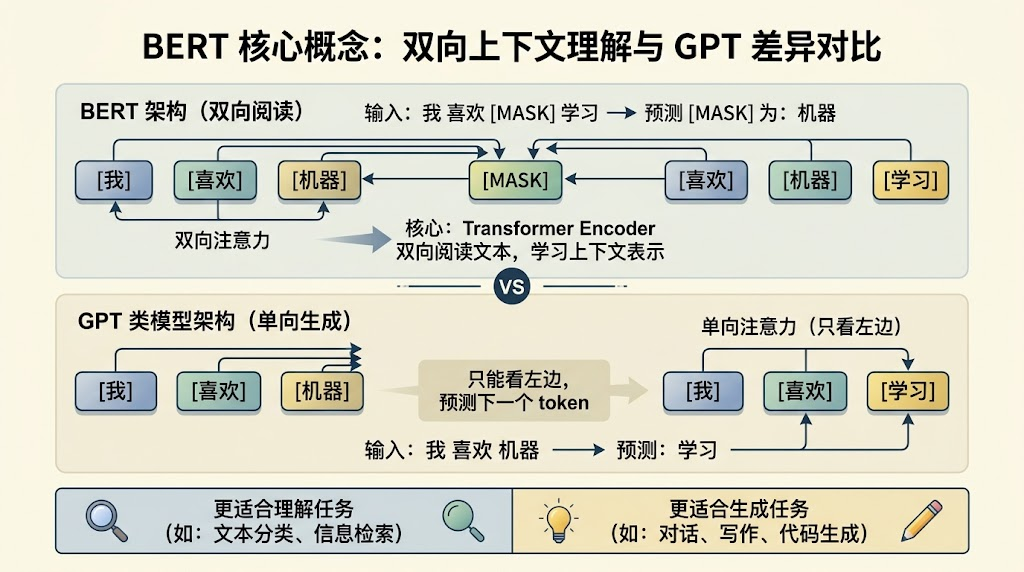
GPT 类模型做的是:
我 喜欢 机器 -> 学习
只能看左边,预测下一个 token。
BERT 做的是:
我 喜欢 [MASK] 学习 -> 机器
可以同时看 [MASK] 左右两边的信息。
所以 BERT 更适合理解任务,GPT 更适合生成任务。
读完先达到这个程度就够了:
- 能解释 BERT 为什么是 Encoder-Only;
- 能理解双向上下文和因果生成的差别;
- 能说清 MLM 是怎么训练的;
- 能知道 NSP 的目的和后来争议;
- 能理解 [CLS]、[SEP]、segment embedding 的作用;
- 能知道 BERT 如何用于分类、序列标注、检索和 rerank;
- 能判断今天什么时候仍然应该用 BERT 类模型。
带着这 3 个问题读:
一、BERT 出现前的问题
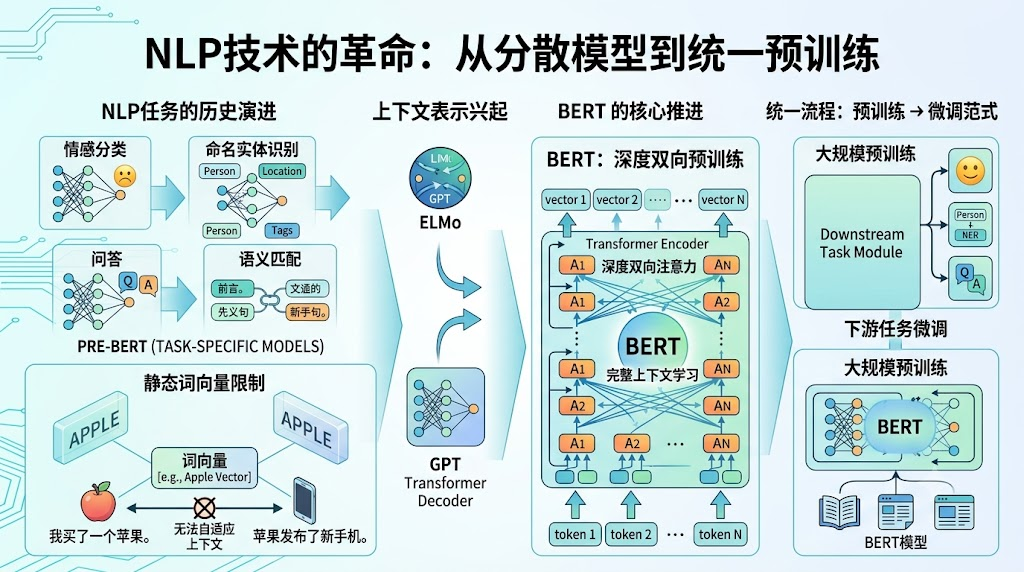
在 BERT 之前,NLP 任务往往需要为不同任务设计不同模型结构。
例如:
- 情感分类有一套模型;
- 命名实体识别有一套模型;
- 问答有一套模型;
- 语义匹配有一套模型;
- 文本蕴含有一套模型。
虽然 Word2Vec、GloVe 等词向量已经能提供通用词表示,但它们有一个重要限制:一个词通常对应一个固定向量。
比如“苹果”在下面两句话里含义不同:
我买了一个苹果。
苹果发布了新手机。
静态词向量很难根据上下文改变“苹果”的表示。后来 ELMo 等模型引入上下文化表示,让同一个词在不同句子中有不同向量。GPT 使用 Transformer Decoder 做自回归预训练,也证明了大规模预训练的价值。
BERT 的关键推进是:用 Transformer Encoder 做深度双向预训练,让模型在完整上下文中学习每个 token 的表示。
这让很多 NLP 任务进入一个统一流程:
大规模预训练 -> 下游任务微调
这就是预训练语言模型时代的核心范式。
二、BERT 是 Encoder-Only Transformer
BERT 使用 Transformer Encoder 堆叠而成。Encoder 的特点是每个 token 可以双向关注整段输入。 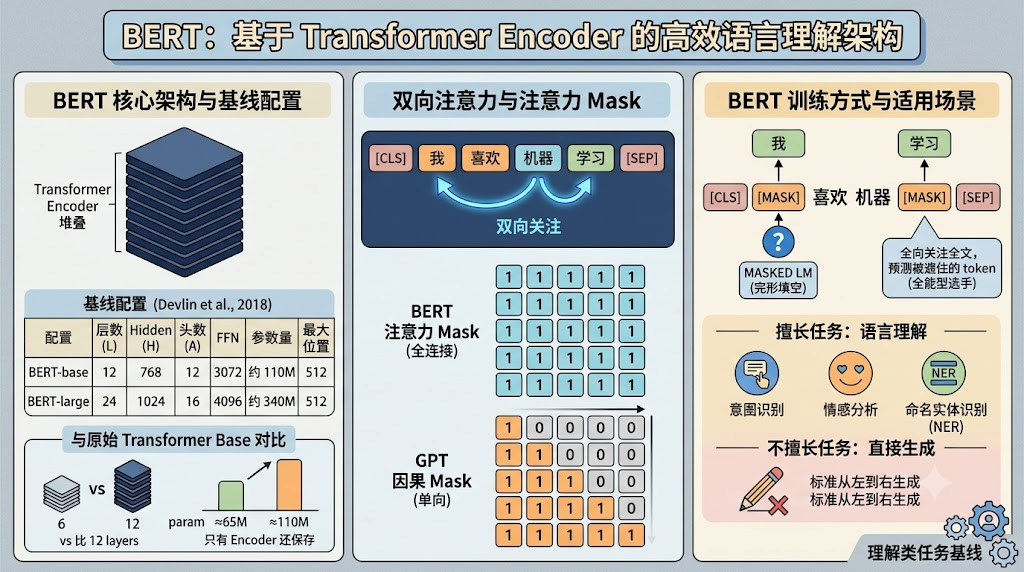
先记住 BERT 原论文(Devlin et al., 2018)里的两个基线配置,后面提到 “BERT-base / BERT-large” 都是指这两个:
| BERT-base | 12 | 768 | 12 | 3072 | 约 110M | 512 |
| BERT-large | 24 | 1024 | 16 | 4096 | 约 340M | 512 |
对照第 21 篇的原始 Transformer Base(6L, d=512, 8 头, ≈65M),BERT-base 相当于把 Encoder 层数从 6 增到 12、隐藏维度从 512 增到 768,同时只保留 Encoder 部分。BERT-large 则进一步加深加宽。这两个规模至今仍是很多"理解类"任务的常用基线。
如果输入是:
[CLS] 我 喜欢 机器 学习 [SEP]
那么“机器”这个位置可以看左边的“我 喜欢”,也可以看右边的“学习”。
它的注意力 mask 可以近似理解成全连接:
1 1 1 1 1
1 1 1 1 1
1 1 1 1 1
1 1 1 1 1
1 1 1 1 1
这和 GPT 的因果 mask 不同:
1 0 0 0 0
1 1 0 0 0
1 1 1 0 0
1 1 1 1 0
1 1 1 1 1
BERT 能双向看全文,所以适合理解。但它也因此不能直接像 GPT 那样做标准从左到右生成。因为它训练时不是“给定前文预测后文”,而是“给定带 mask 的全文预测被遮住的 token”。
三、BERT 输入格式:[CLS]、[SEP] 和 Segment
BERT 的输入不只是 token ids,还包含几类特殊信息。 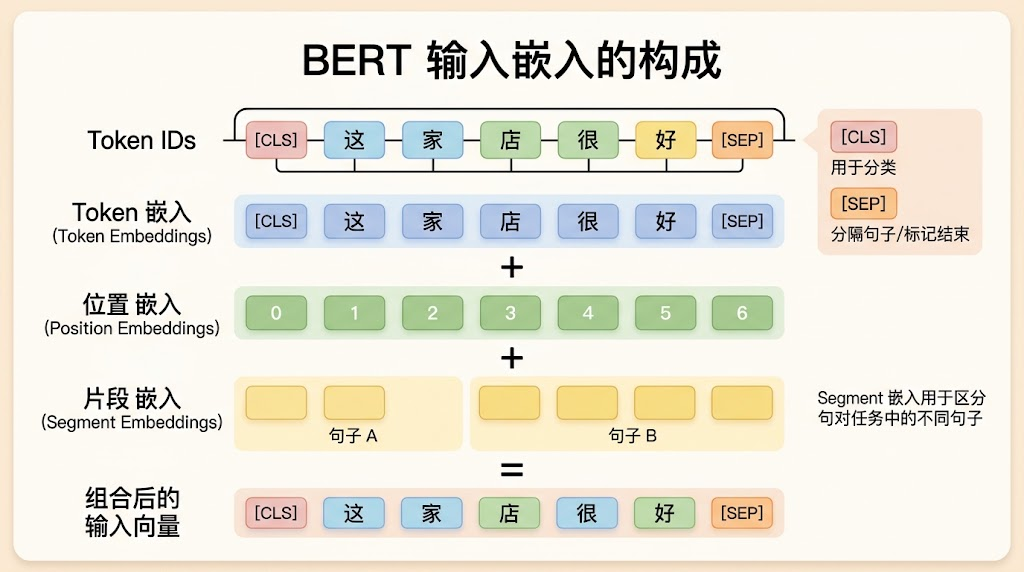
常见单句输入:
[CLS] 这 家 店 很 好 [SEP]
常见双句输入:
[CLS] 今 天 天 气 很 好 [SEP] 我 想 去 公 园 [SEP]
几个特殊符号的作用:
| [CLS] | 放在开头,常用于整句分类表示 |
| [SEP] | 分隔句子或标记输入结束 |
| [MASK] | MLM 中被遮住、需要预测的位置 |
| [PAD] | batch 补齐位置 |
BERT 还使用 token embedding、position embedding 和 segment embedding 相加:
token embedding + position embedding + segment embedding
Segment embedding 用来区分句子 A 和句子 B,常用于句子对任务,例如自然语言推理、问答匹配。
用伪代码表示:
input_embedding = token_embedding(input_ids)
input_embedding += position_embedding(position_ids)
input_embedding += segment_embedding(token_type_ids)
这一步之后,Encoder 才开始做多层双向 self-attention。
四、MLM:遮住一部分 token 再预测
BERT 的核心预训练任务是 Masked Language Modeling,简称 MLM。
做法是:随机选择输入中一部分 token,把它们处理成 [MASK] 或其他形式,然后让模型根据上下文预测原 token。
例子:
原句:我 喜欢 机器 学习
输入:我 喜欢 [MASK] 学习
目标:机器
由于 BERT 是双向 Encoder,它预测 [MASK] 时可以同时利用左边“我 喜欢”和右边“学习”。
这和 GPT 的 CLM 不同:
GPT:我 喜欢 机器 -> 学习
BERT:我 喜欢 [MASK] 学习 -> 机器
一个教学版 mask 函数如下:
import torch
def create_mlm_inputs(input_ids, mask_token_id, vocab_size, mask_prob=0.15):
labels = input_ids.clone()
probability = torch.full(input_ids.shape, mask_prob)
masked_positions = torch.bernoulli(probability).bool()
# 非 mask 位置不计算 MLM loss
labels[~masked_positions] = –100
rand = torch.rand(input_ids.shape)
# 80% 替换成 [MASK]
mask_case = masked_positions & (rand < 0.8)
input_ids[mask_case] = mask_token_id
# 10% 替换成随机 token
random_case = masked_positions & (rand >= 0.8) & (rand < 0.9)
random_tokens = torch.randint(0, vocab_size, input_ids.shape)
input_ids[random_case] = random_tokens[random_case]
# 10% 保持原 token 不变
return input_ids, labels
ids = torch.tensor([[101, 200, 201, 202, 102]])
masked_ids, labels = create_mlm_inputs(ids.clone(), mask_token_id=103, vocab_size=1000)
print("input:", masked_ids)
print("labels:", labels)
这里 labels = -100 的位置通常会被 PyTorch 的交叉熵忽略,只在被选中的 mask 位置计算 loss。
五、为什么 MLM 不是普通完形填空
表面看,MLM 像完形填空。但它对模型训练的意义更深。 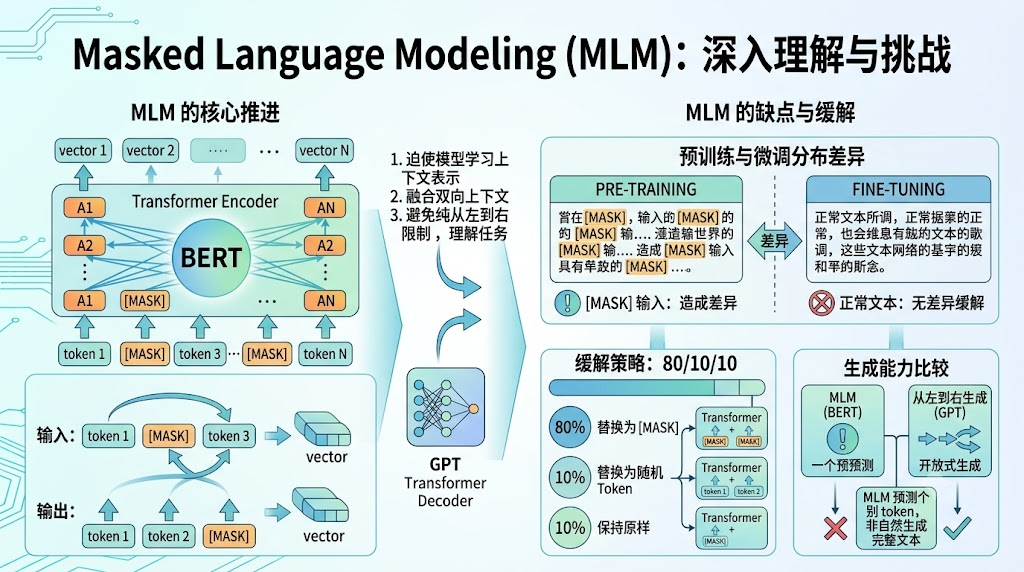
第一,它迫使模型学习上下文表示。要预测被遮住的 token,模型必须理解左右两侧信息。
第二,它让每个 token 的 hidden state 融合双向上下文。下游分类、抽取、匹配任务都可以复用这些表示。
第三,它避免了纯从左到右目标的限制。很多理解任务需要同时看完整句子,而不是只看前文。
不过 MLM 也有缺点。
预训练时输入里有 [MASK],但下游真实文本通常没有 [MASK],这会造成预训练和微调之间的分布差异。BERT 的 80/10/10 策略就是为了缓解这个问题:不是所有选中位置都替换成 [MASK],有些替换成随机 token,有些保持原样。
此外,MLM 预测的是被遮住 token,而不是自然生成完整文本,所以 BERT 不像 GPT 那样适合开放式生成。
六、NSP:判断两句话是否相邻
BERT 原始论文还使用了 Next Sentence Prediction,简称 NSP。
任务形式是:给模型两个句子 A 和 B,判断 B 是否是 A 的下一句。
句子 A:我今天去公园散步。
句子 B:天气很好,很多人在跑步。
标签:IsNext
负例可能是随机采样的不相关句子:
句子 A:我今天去公园散步。
句子 B:这台服务器需要重启。
标签:NotNext
NSP 的设计目标是帮助模型学习句子间关系,服务问答、自然语言推理等句子对任务。
后来一些模型,比如 RoBERTa,移除了 NSP,并通过更多数据、更大 batch、更长训练等方式取得更好效果。这说明 NSP 本身不是 BERT 成功的唯一原因,甚至不一定是必要组件。
但对入门读者来说,理解 NSP 有两个价值:
七、BERT 如何用于分类
BERT 做分类时,常用 [CLS] 位置的输出表示整段文本。
流程如下:
输入文本 -> BERT Encoder -> 取 [CLS] hidden state -> 分类头 -> 标签概率
PyTorch 风格伪代码:
import torch
import torch.nn as nn
class BertForClassification(nn.Module):
def __init__(self, bert_encoder, hidden_size, num_labels):
super().__init__()
self.bert = bert_encoder
self.classifier = nn.Linear(hidden_size, num_labels)
def forward(self, input_ids, attention_mask, token_type_ids=None):
outputs = self.bert(
input_ids=input_ids,
attention_mask=attention_mask,
token_type_ids=token_type_ids,
)
cls_hidden = outputs.last_hidden_state[:, 0, :]
logits = self.classifier(cls_hidden)
return logits
训练时,BERT 的参数和分类头通常一起微调。这就是 fine-tuning:预训练模型提供通用语言理解能力,下游数据让模型适配具体任务。
八、BERT 如何用于序列标注和抽取
对于命名实体识别这类序列标注任务,需要给每个 token 一个标签。
输入:马 云 创立 阿里巴巴
标签:B-PER I-PER O B-ORG
这时不只取 [CLS],而是对每个 token 的 hidden state 接分类头:
# hidden: [batch, seq_len, hidden_size]
logits = token_classifier(hidden)
# logits: [batch, seq_len, num_labels]
对于抽取式问答,常见做法是预测答案起始位置和结束位置:
start_logits = start_classifier(hidden).squeeze(–1)
end_logits = end_classifier(hidden).squeeze(–1)
这类任务体现了 BERT 的优势:它能双向理解完整输入,对每个 token 生成上下文化表示。
九、BERT 和 Embedding/Rerank 的关系
在生成式大模型时代,BERT 类模型仍然大量用于 embedding 和 rerank。 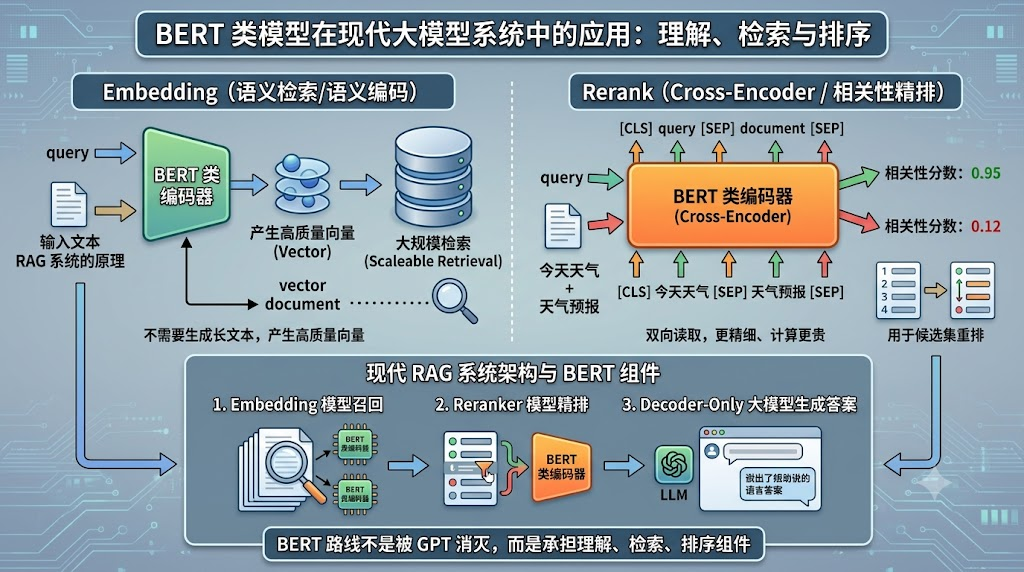
Embedding
语义检索需要把文本编码成向量:
query -> vector
document -> vector
相似度搜索
很多 embedding 模型可以看作 BERT/Encoder 路线的延续或变体。它们不需要生成长文本,只需要产生高质量向量,适合大规模检索。
Rerank
Reranker 常见输入是 query 和 document 拼接:
[CLS] query [SEP] document [SEP]
Encoder 双向读取 query 和 document,然后输出相关性分数。这种 Cross-Encoder 方式比简单向量相似度更精细,但计算更贵,通常用于候选集重排。
在 RAG 系统里,经常是:
Embedding 模型召回候选文档
Reranker 精排候选文档
Decoder-Only 大模型生成最终答案
所以 BERT 路线不是被 GPT 路线消灭了,而是在现代系统里承担理解、检索和排序组件。
十、BERT 的优势
BERT 的优势可以总结为四点。
第一,双向上下文理解强。它能同时利用左右文,适合分类、匹配、抽取等任务。
第二,微调范式简单。很多任务只需要在 BERT 后面接一个小任务头,再用标注数据微调。
第三,表示可复用。BERT 的 hidden state 可以用于 token 级、句子级和句子对任务。
第四,推理成本可控。相比超大生成式模型,小型 BERT 类模型在高 QPS 分类、检索、审核场景里更经济。
这也是为什么很多企业系统里仍然有大量 Encoder 模型。
十一、BERT 的局限
BERT 也有明显局限。
第一,它不擅长开放式生成。MLM 训练目标不是从左到右生成完整回答。
第二,输入长度通常较短。经典 BERT 常见最大长度是 512 token,处理长文档需要切分、滑窗或换长上下文模型。
第三,预训练和下游有分布差异。[MASK] 在预训练中存在,但下游真实输入通常没有。
第四,原始 NSP 后来被证明不是必需。BERT 成功来自整体范式,不应把 NSP 神化。
第五,BERT 本身不具备现代聊天模型的指令跟随和对齐能力。要做对话助手,Decoder-Only 大模型更自然。
所以 BERT 是理解模型的里程碑,不是通用大模型的终点。
十二、BERT、GPT、T5 怎么对比
把三者放在一起看:
| BERT | Encoder-Only | MLM + NSP | 双向理解、分类、抽取、检索 | 不擅长开放式生成 |
| GPT | Decoder-Only | Causal LM | 生成、对话、代码、通用任务 | 理解任务成本可能偏高 |
| T5 | Encoder-Decoder | Text-to-Text | 翻译、摘要、改写、统一 seq2seq | 结构更复杂 |
这张表不是排名,而是帮你理解路线差异。
如果你要做聊天助手,GPT/LLaMA/Qwen 这类 Decoder-Only 更合适。
如果你要做高吞吐语义检索或文本分类,BERT/Encoder 路线可能更合适。
如果你要做专门的翻译、摘要或文本改写,Encoder-Decoder 仍然值得考虑。
十三、今天什么时候还该用 BERT 类模型
可以用几个问题判断。
如果你的任务输出是一个标签、一个分数或一个向量,而不是一大段自然语言,BERT 类模型很可能值得考虑。
如果你的系统 QPS 很高、延迟要求严格、成本敏感,BERT 类小模型可能比调用大语言模型更经济。
如果你要做检索、rerank、相似度匹配,Encoder 模型通常是基础组件。
如果你需要复杂解释、开放式问答、多轮对话、工具调用和代码生成,Decoder-Only 大模型更合适。
真实系统常常组合二者:
BERT/Encoder:找资料、算相似度、做分类、做重排
GPT/Decoder:综合资料、生成答案、执行复杂指令
这是一种更工程化的看法。
十四、常见误区
误区 1:BERT 是 GPT 的旧版本。 不是。BERT 和 GPT 是不同架构与目标路线:BERT 双向理解,GPT 自回归生成。
误区 2:BERT 能双向看,所以一定比 GPT 更强。 双向看适合理解任务,但不适合自然自回归生成。能力强弱要看任务。
误区 3:MLM 只是随机遮词,没有深度。 MLM 迫使模型利用上下文恢复信息,是学习上下文化表示的关键训练信号。
误区 4:生成式大模型出现后 BERT 没用了。 BERT 类模型在 embedding、rerank、分类、审核、抽取等高吞吐任务里仍然重要。
误区 5:[CLS] 一定是最好的句向量。 原始 BERT 的 [CLS] 适合微调分类,但做通用 embedding 时通常需要专门训练和池化策略。
误区 6:NSP 是 BERT 成功的核心。 NSP 是原始 BERT 的一部分,但后续工作表明它不是不可替代的核心。
十五、你应该记住的最小心智模型
BERT 可以这样记:
输入:[CLS] 句子 A [SEP] 句子 B [SEP]
Embedding = token + position + segment
多层 Transformer Encoder 双向阅读
MLM 预测被遮住 token
[CLS] 或 token hidden state 用于下游任务
它的关键词是:
Encoder-Only
Bidirectional
Masked Language Modeling
Fine-tuning
Understanding
和 GPT 的对比是:
BERT:看完整句子,适合理解
GPT:只看过去,适合生成
总结
BERT 是预训练语言模型发展中的关键节点。它用 Encoder-Only Transformer 双向阅读文本,通过 MLM 学习上下文化表示,并用 fine-tuning 范式适配大量下游任务。它让 NLP 从“为每个任务单独设计模型”走向“通用预训练模型 + 任务微调”。
BERT 的强项是理解、分类、匹配、抽取、embedding 和 rerank;局限是开放式生成、长上下文和指令跟随。生成式大模型兴起后,BERT 类模型仍然在现代 AI 系统中承担高效理解和检索组件。
第一遍记住一句话:BERT 不是聊天模型的前身那么简单,它代表的是双向理解型预训练模型路线。
大模型视角
理解 BERT 后,你会更清楚大模型路线为什么分化:Encoder 模型负责理解和表示,Decoder 模型负责生成和交互,Encoder-Decoder 模型负责输入到输出转换。今天的 RAG、搜索、推荐、审核、问答系统,往往不是单一大模型,而是多种模型架构协作。
下一篇
GPT 系列演进:从 GPT-1 到 GPT-4 的技术路线 —— BERT 代表双向理解路线,GPT 代表自回归生成路线。下一篇我们看 GPT 系列如何从语言模型演进成通用对话和推理系统。
