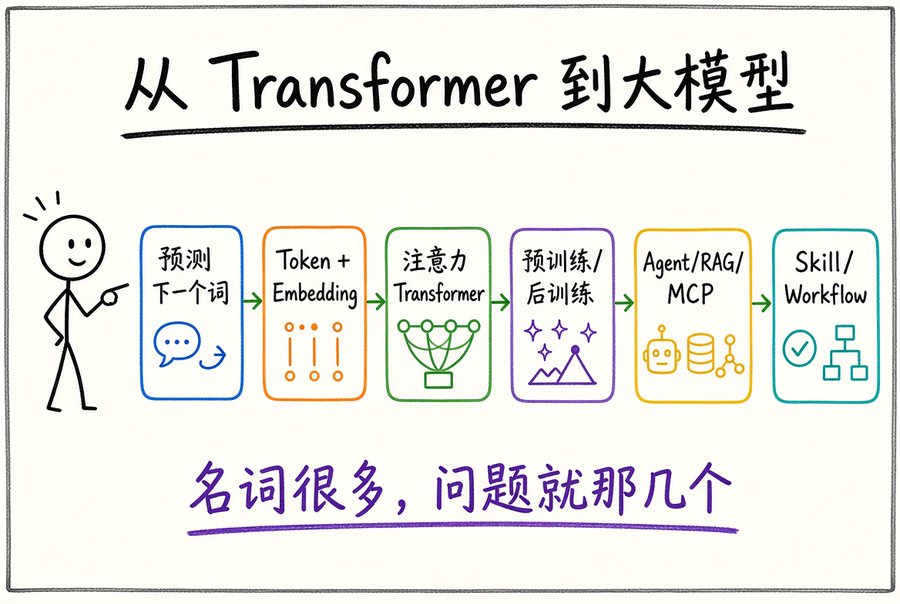
对于本文呢,我不但想把 Transformer 的原理从头到尾讲清楚,还想带你看看今天大家知道的大模型,究竟是怎么在 Transformer 的基础之上一步一步发展出来的。
这篇文章不需要任何前置知识。你对于这些有过了解也好,没有也无伤大雅,只要跟着往前走就行。我们先从最简单的地方开始。
一、大模型的起点:找到一个预测下一个词的函数
现在大语言模型的起点,其实非常简单:我们可以找到这样一个函数——输入是一段文字,输出是下一个最有可能出现的词。
比如输入“今天天气”,模型可能输出“真”;再把“今天天气真”作为输入,模型可能输出“好”。模型不断重复这个过程,最后就能生成一整句话。
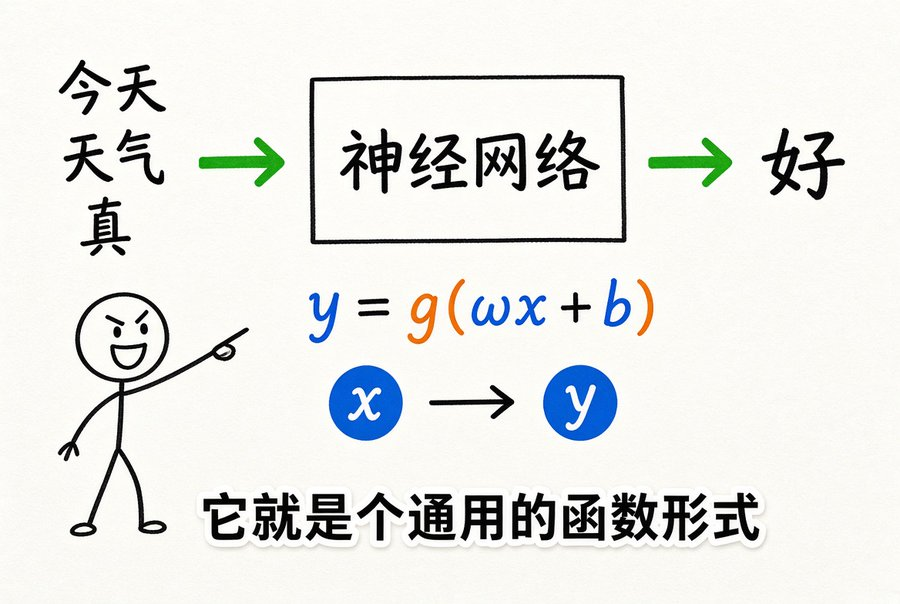 那怎么样才能找到这个函数?把这个浓缩成一句话就是:这个世界上的任何函数,都可以用一个神经网络来表示。
那神经网络是什么?如果再浓缩成一句话,它就是一个里面包含了很多未知参数的通用函数形式。最简单的形式大概是这样:
y = f(x; w, b)
如果把激活函数也去掉,那它甚至就是一个简简单单的线性函数。公式里的 x 对应输入,y 对应输出,w 和 b 是需要通过训练求出来的未知参数。
这里的输入 x 可以变成多个数字,比如 x_1、x_2、x_3;输出 y 也可以变成多个数字。然后,我们就可以根据大量已经知道的输入和输出,逐步求解出未知的参数。
左边是我们常说的训练数据,右边是模型参数,也就是权重。只不过呢就是说站在大模型的角度看,这两边的量都特别特别大,其他没有什么本质区别。
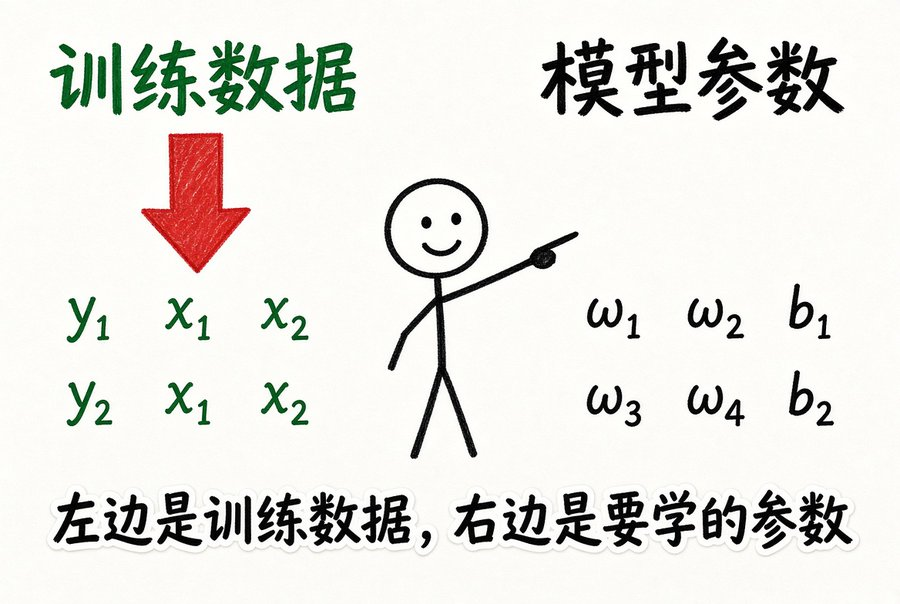 比如,即便是现在看起来已经不算大的 GPT-2,它的 FFN 层输入就有 768 个神经元,中间隐藏层有 3072 个神经元,最后线性投影层的输出更是高达 50257 个,也就是它的词表大小。
现在看不懂这些数字,不要害怕。后面的每一层我都会慢慢讲到。
二、输入和输出都是文字,第一步当然是把文字变成数字
我们知道,神经网络的输入可以是多个数字,输出也可以是多个数字。但现在的问题是,我们的输入和输出都是文字。那第一步要做什么,几乎已经写在脸上了:把文字变成数字。
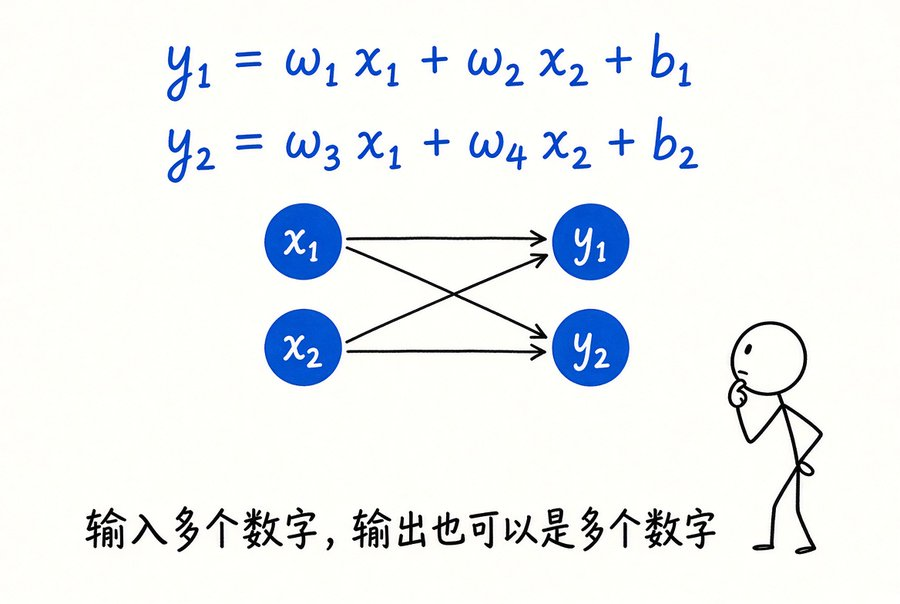 而且很自然地会想到,最好不要把一句话整体变成一个数字,而是把每个词分别变成一组数字。至于为什么要变成一组数字,而不是一个数字,具体怎么变成数字,我们先暂时不考虑。现在你可是一个架构师,不屑于讨论这些细节,反正先给我变成数字就行。
再来看看这个输出。神经网络输出一组数字之后,我们还得把它变回文字。但这件事其实可以先设计出来:让输出向量里的每个位置对应一个词,然后看看哪个位置的数字最大。
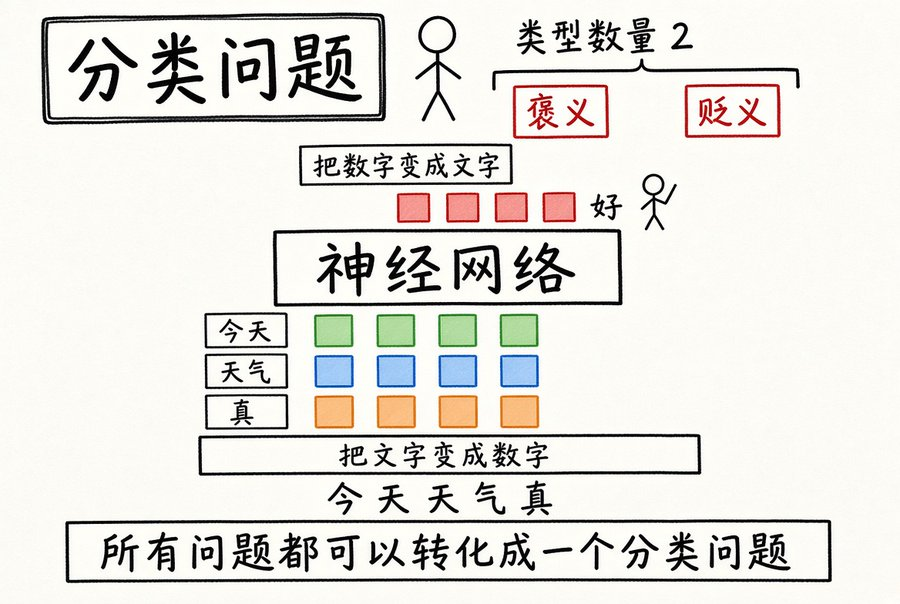 比如第 98 个位置的数字最大,那我们就认为模型预测出来的词是词表中第 98 个词。这样就成功地把一组数字转换成了一个词。
当然,这里也有一个非常明显的要求:输出向量的长度,必须能够囊括所有词,也就是整个词表的大小。GPT-2 的最终输出是 50257 个数字,正是因为它的词表里有 50257 个 token。
其实,只要改变输出的定义,同样一套神经网络架构还可以完成很多其他任务。
比如判断一句话属于什么场景,是生活类、金融类还是职场类;或者判断一句话是褒义还是贬义。判断褒贬可能只需要两个输出数字,判断场景可能需要一百个输出数字。
总之,归根结底,很多问题都可以转化为一个分类问题。只不过预测下一个词时,分类的类别特别特别多而已。
所以到这里,我们先把输入和输出的结构搞定了:输入的文字需要变成数字,输出的一堆数字再根据最大值或概率变回文字。
接下来,我们就要研究:如何把输入的文字变成数字。再简单一点说,就是如何把单独的一个词变成数字。
不过这件事,我们得好好说道说道。我们先从一个看起来特别简单的例子开始。
三、为什么要用向量表示文字?
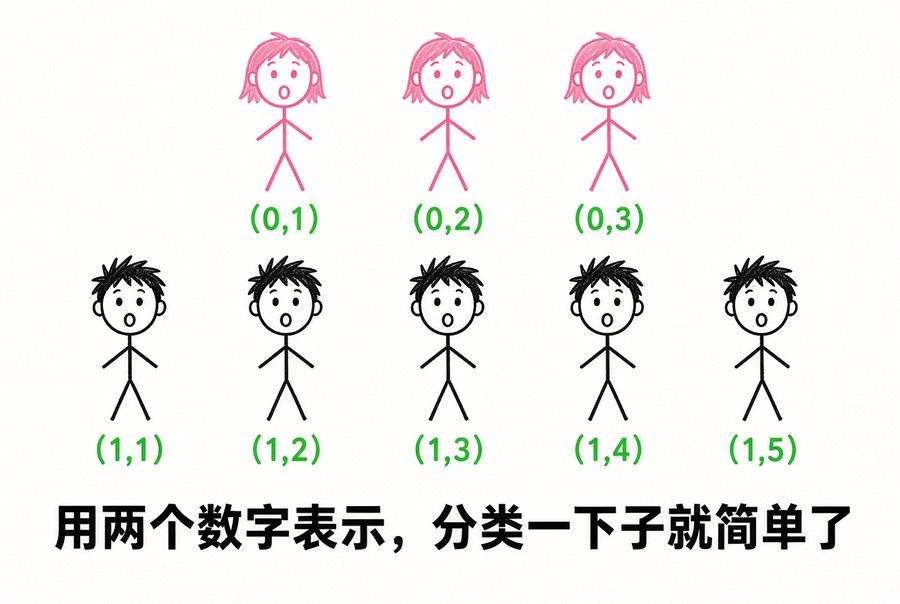
假如有这么多男生和女生,每个人都用一个数字表示。现在你要根据这个数字编号,把他们分成男生和女生,你会怎么做?
如果观察这些编号,也许你能找到一些规律。比如女生的编号都是 2 的幂次,那你就可以利用这个规律来分类。
但如果我们换一种编号方式,每个人不再用一个数字表示,而是用两个数字表示,这时候你会发现,分类可能变得更简单了。比如只看第一个数字是 0 还是 1,就能完成分类。
 我们回到这个事情的数学本质。
刚才用一个数字表示一个人,相当于把所有人放在一维数轴上。你可以把黑色的点想象成男生,粉色的点想象成女生。现在让你用一根直线把它们分成两类,可能根本做不到,只能画一根非常拐弯的线。
但如果我们把它升级到二维空间,也就是每个人用两个数字表示,就可以用一条直线把两类点分开了。这里的第一个数字可以表示性别,第二个数字还可以表示性格,比如内向还是外向。这样一来,原本混在一起的信息就有机会被分到不同方向上。
一个数字的情况,可以叫一维向量;两个数字的情况,可以叫二维向量;更多数字,就叫高维向量。显然,二维向量在表达信息时更加灵活,也更容易变得线性可分。
顺便说一个冷知识:把一个向量从低维变成高维,叫做升维;反过来,从高维变成低维,叫做降维。如果只用一个数字表示一个文字,灵活度显然是不够的。我们需要用一个维度足够多的向量来表示它。
不过在此之前,还要先把最小单位从一个字,改成一个 token。
四、Token:大模型真正理解的最小单位
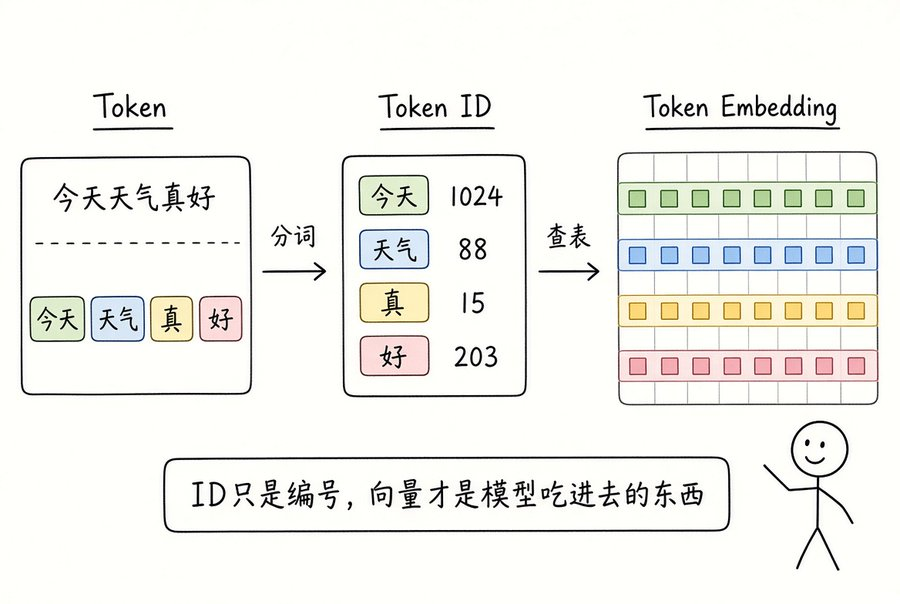
大模型并不一定把一个完整的字或者一个完整的单词作为最小单位,而是使用 token。一个 token 可以是一个汉字、一个英文单词、一个英文单词的一部分,也可以是标点符号。把一句话拆分成一个个 token,这个过程叫 tokenization,也就是分词。
比如一句话经过分词之后,会被切成多个 token。在计算机里面,每个 token 会对应一个数字,这个数字叫 token ID。不过,这个 ID 本身并没有什么语义。它更像是一个编号,代表它在词表中的位置。模型拿到这个 ID 之后,就可以根据这个编号,从嵌入矩阵里取出对应的向量。
因此,我们需要区分三个概念:
-
Token:分词之后得到的文字片段;
-
Token ID:这个文字片段在词表里的数字编号;
-
Token Embedding:根据这个编号从嵌入矩阵里取出来的词向量。
接下来,我们看看每个 token 对应的向量,应该长什么样?
五、人工定义每个特征?这几乎是不可能的
我们可以尝试给向量里的每个位置人为定义一个特征。比如第一个位置表示“食物属性”,苹果的这个数值就很高;“香蕉”的食物属性也很高;“手机”的食物属性就很低。再比如第二个位置表示“科技属性”,那手机的数值就很高。
把所有位置的数值都填好,你就成功用一个向量表示了一个词。如果我们真的能做到这一点,那当然很理想。所有词都可以被放在一个高维空间里,语义相近的词距离更近,语义差异大的词距离更远。
但问题是,这几乎是不可能完成的任务。因为每个词的含义太丰富了,而且会随着上下文变化。就算真的有一个神人,把所有词的每一个特征都定义出来,那么每个特征具体代表什么,可能也会抽象到根本解释不清楚。
所以,人工把所有语义特征一一规定好,显然不现实。所以呢一种极端办法是:向量维度就等于整个词表的大小,每个词只有一个位置是 1,其他位置全是 0。
这就是 One-hot,中文叫独热编码。顾名思义,只有一个位置是“热”的。
六、One-hot、Word2Vec 与 Embedding Matrix
One-hot 编码有两个非常主要的问题。
第一个问题是,词表太大时,向量维度也太大。现在的词表动辄几万、几十万,给每个 token 都配一个这么长的向量,既浪费空间,也不方便计算。
第二个问题是,它无法度量词语之间的相似性。
在 One-hot 编码里,无论是苹果和香蕉,还是苹果和汽车,它们的向量点积和余弦相似度都是 0。因为它们只有一个 1,而且 1 所在的位置不同。这显然不友好。我们希望苹果和香蕉的向量应该更接近,因为它们都是水果;苹果和手机可能也有某种关系,因为苹果也可能指苹果公司;而苹果和桌子之间的关系就应该不一样。
那要怎么让向量具备这些性质呢?
当然可以不去人为定义每个维度到底是什么意思。每个位置先随机初始化一个值,把它作为模型参数,然后指定一个任务去训练。训练出来是多少就是多少,至于每个维度究竟代表什么,不管。正如那句古话所说:遇事不决,上神经网络。
Word2Vec 就是早期的一种典型方法。它的基本思路是:准备大量文本,把文本分词,然后选择一个中心词,其他词作为上下文词。
训练目标是:让中心词和上下文词的向量点积尽量大;同时找一些不相关的负样本,让它们的点积尽量小。训练一段时间之后,所有词的向量就会逐渐形成某种结构。相似的词会更接近,不相似的词会更远。
如果把这些高维向量降维到三维空间方便观察,你可能会看到一些令人惊艳的结果:相似的词距离更近,还可能出现类似:
king – man + woman ≈ queen
这样的语义计算。当然,严格来说 Word2Vec 的中心词和上下文词使用的是两个不同的矩阵,这里为了理解方便,把它简化成了一个矩阵。
不过,Word2Vec 有两个明显问题。
第一,每个词的词向量是静态的、固定的,没有考虑上下文。还是以“苹果”为例:
-
我吃了一个苹果;
-
苹果公司发布了新手机。
这两句话里的“苹果”意思完全不同,但 Word2Vec 给它们的是同一个向量。
第二,训练出来的词向量矩阵,往往会作为下游任务的固定输入,并不是和下游任务端到端一起训练的。这样就会有一种割裂感。
为了解决这些问题,随着算力不断突破,后来基于 Transformer 的 BERT 和 GPT 等模型,直接简单粗暴地随机初始化这个词向量矩阵,然后让它和整个模型一起训练。
现在给它一个正式的名字:Embedding Matrix,嵌入矩阵。 它的纵向是词表大小,横向是词向量维度。token ID 是多少,就去这个矩阵里取第几行。
整个流程可以概括成一句话:先把句子分词成一个个 token;在计算机里,每个 token 对应一个数字 ID;然后根据 ID,在嵌入矩阵里取出对应的词向量;最后把这些词向量送进 Transformer。随着 Transformer 训练不断进行,最初随机初始化的嵌入矩阵也会被不断更新,最后变成适合当前模型的词向量。
所以经过这么多年的演进,最终的嵌入模块其实变得非常简单:说到底就是一个随机初始化、可训练的矩阵。代码实现也不复杂。定义一个 vocabulary size,表示词表大小;再定义一个 embedding dimension,表示词向量维度;然后直接用 PyTorch 的 nn.Embedding 创建矩阵即可。比如 GPT-2 的词向量维度就是 768。
七、Transformer 里真正的核心:把上下文加进来
到这里,我们已经把“如何把文字变成数字”这件事讲清楚了。但问题还没有结束。
现在每个 token 都已经变成一个向量了,可这个向量里暂时只有它自己的信息,没有上下文。比如“苹果”这个词拿到向量之后,并不知道自己是在“水果”“吃”“甜”这样的语境里,还是在“手机”“发布会”“公司”这样的语境里。
我们得想办法把上下文词的信息也加进来。最简单的想法是加权求和:关系大的词,多加一点;关系小的词,少加一点。但问题是,权重具体怎么算?
这就是 Transformer 最核心的注意力机制要解决的问题。
注意力机制本质上是在计算:当前这个 token 应该关注其他哪些 token,以及应该关注多少。
八、Q、K、V:注意力机制到底在算什么?
具体来说,每个 token 的词向量会通过三个简单的线性变换,得到三个向量:Q、K、V。
Q 是 Query,可以理解成“我想查询什么”;
K 是 Key,可以理解成“我这里有什么”;
V 是 Value,可以理解成“我真正能提供的内容”。
Q、K、V 的获取,本质上也只是一个非常简单的单层神经网络,也就是乘上一个可训练的矩阵。这里并没有什么特别神秘的东西。
模型会拿当前 token 的 Q,和其他 token 的 K 做计算,得到相关程度。相关程度越高,注意力权重就越大。接着,再根据这些权重,把其他 token 的 V 加权求和。这样,当前 token 的表示就不再只有自己,而是包含了上下文的信息。
例如,在“我去苹果店买手机”这句话里,“苹果”会更多关注“店”“手机”等词;在“我今天吃了一个苹果”里,它又会更多关注“吃”“一个”等词。所以同一个“苹果”,经过注意力机制之后,最终得到的向量就可以不一样。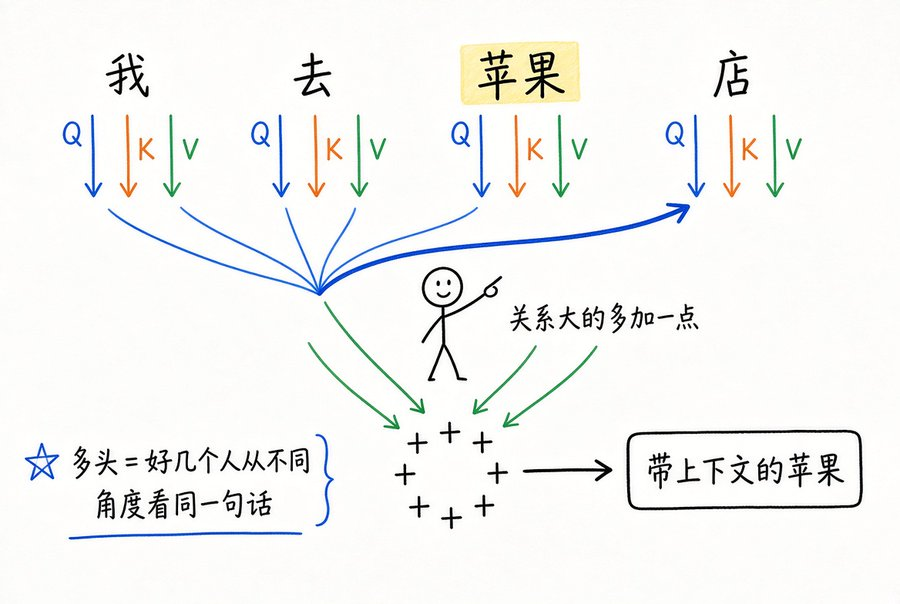
实际模型中,通常不只有一组 Q、K、V,而是有多头注意力。
多头注意力可以粗略理解为:有很多个人一起看这句话,但每个人关注的角度不同。有人关注语法关系,有人关注主谓宾,有人关注远距离指代,有人关注局部词语搭配。最后,把多个头的结果合在一起,就得到更丰富的上下文信息。
九、位置编码:模型还得知道词的先后顺序
注意力机制有一个问题:它可以让每个 token 看到其他 token,但它本身并不天然知道顺序。
“我吃苹果”和“苹果吃我”,词是一样的,但意思完全不同。模型必须知道谁在前、谁在后。
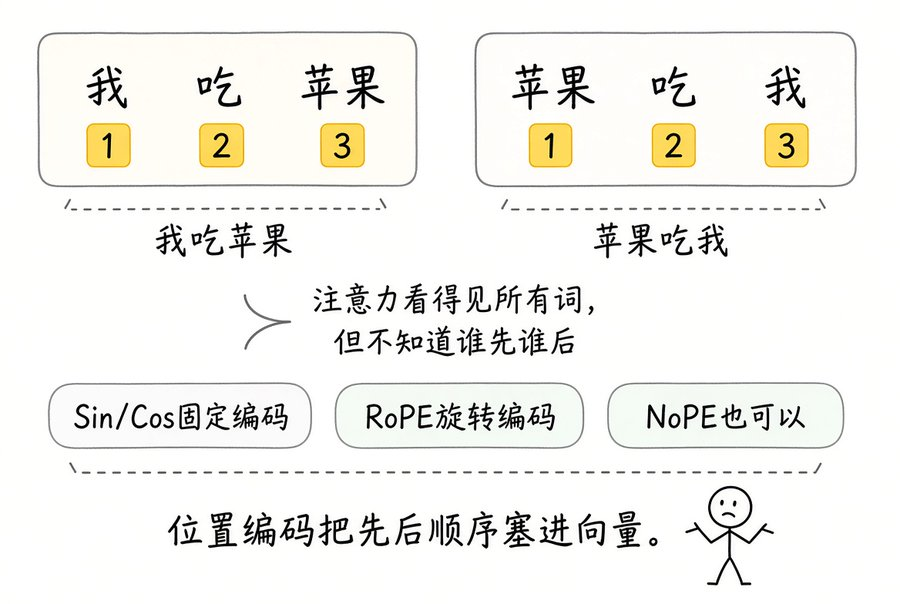 所以我们还要加入位置信息,也就是位置编码。
在原始 Transformer 论文里,位置编码是通过正弦、余弦函数计算出来的一组固定值。这种方式可以叫固定位置编码。后来,旋转位置编码逐渐成为更常见的做法。它可以让向量之间在计算点积时拥有更友好的位置特性,也更方便表达相对位置。
再后来,又有人对旋转位置编码进行扩展,希望模型能够支持更长的上下文;甚至还有人提出 NoPE,也就是不显式使用位置编码的方式,并证明它在一些场景下也有效。你看,就这么一个位置编码,已经被人类从各种角度反复研究了。
不过不管名字怎么变,核心目标还是一样:让模型知道 token 处在什么位置,以及不同 token 之间的相对位置关系。
十、注意力和 FFN:Transformer 一层一层堆起来
经过注意力机制,我们得到了一个包含上下文信息的 token 向量。接下来,这个向量还要进入一个前馈神经网络,也就是 FFN。
FFN 本质上就是一个普通的全连接神经网络,属于深度学习入门级结构。只不过在大模型里,它的规模会变得特别大。FFN 通常会先把向量维度放大,再经过非线性激活,最后再把维度压回来。你可以把注意力理解成“让大家互相交流”,把 FFN 理解成“每个人拿着交流后的信息,自己再加工一遍”。
多头注意力和 FFN 可以堆叠很多层,因为它们前后的输入输出维度通常是不变的。这些层一层一层叠起来,就构成了我们常说的 Transformer 层。最后,模型会把隐藏向量送进一个线性投影层。
线性投影层的作用,就是把当前向量投影成词表大小的向量。它其实也是一个简单的单层神经网络,而且通常只有线性变换,没有激活函数。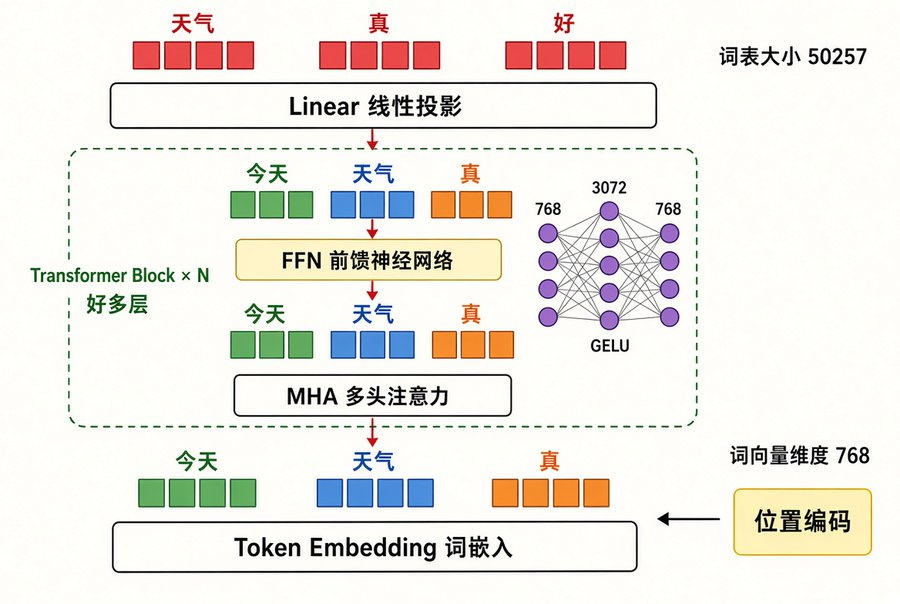
比如词表大小是 50257,那么最后就输出 50257 个数字。每个数字对应一个 token 的分数。
这些分数可以理解为 logits。因为 logits 没有被约束,不能直接当作概率,所以我们再经过 Softmax,把它们转换成概率分布。这就是 Transformer 的整体流程:
文本分词,得到 token ID;
根据 token ID 查找 embedding;
加入位置编码;
通过多头注意力融合上下文;
通过 FFN 进一步处理;
重复堆叠很多 Transformer 层;
通过线性投影得到词表大小的 logits;
用 Softmax 转成概率;
选择下一个 token。
当然,真实模型里还有残差连接、归一化、Dropout 等训练稳定性技巧。
残差连接就是把输入直接加回输出,帮助信息和梯度更好地传播;归一化是把数据控制在更稳定的范围内;Dropout 则是在训练过程中随机丢掉一部分连接,减少过拟合。这些细节对训练非常重要,但暂时不影响我们先把整体流程理解清楚。
十一、模型是怎么学会预测下一个词的?
现在,我们终于得到了一个可以预测下一个 token 的模型。那这样一个模型到底是怎么训练出来的?
其实还是非常简单:找海量文本。比如,我们找到这样一句话:
南晚最帅了
我们可以把“南晚最”作为输入,让模型预测下一个 token。真实答案是“最”。模型输出预测值之后,我们把它和真实答案比较,计算误差,也就是损失函数。接下来就是大家熟悉的流程比如这样:计算损失、求梯度、反向传播、梯度下降、更新参数,直到模型的预测越来越接近真实答案。
然后我们再把“南晚最”作为输入,让模型预测“帅”。
虽然生成的时候,我们通常只关心最后一个位置,但在训练阶段,一整句话里的每个位置都可以贡献训练信号。这样一段文本就能产生很多训练样本。
这种文字预测任务最舒服的地方,是根本不需要人工标注。只要找到一段文本,后面的 token 就可以作为前面 token 的答案。
让数据自己给自己当标准答案的方式,叫做自监督学习,也就是 Self-supervised Learning。
而通过海量文本训练,让模型具备初步语言能力和知识能力的阶段,叫做预训练,也就是 Pre-training。ChatGPT 里的 GPT,全称就是 Generative Pre-trained Transformer,翻译过来就是生成式预训练 Transformer。
你可能会觉得:这也太无脑了吧?不就是给它看一大堆文本,让它做文字接龙吗?没错,底层看起来确实就是这样。但即便是一股脑地把大量文本塞给模型,只要参数量和数据量足够大,就可能涌现出很多神奇能力。
比如我们给模型几个翻译例子:
cat:猫 dog:狗 orange:
模型可能会输出“橙子”。
仔细想一想,你并没有专门训练它做翻译任务。但它根据你在输入里提供的几个例子,居然照猫画虎地完成了翻译。如果这种能力成立,那么过去为了某一个任务专门训练一个模型的做法,就有机会被一个超级通用的预训练大模型替代。
这种从上下文中的少量例子里学习新任务的能力,叫做少样本学习,英文是 Few-shot Learning,也可以理解为上下文学习。只要你能用语言把任务描述清楚,模型就可能表现得像一个什么都会一点的通才。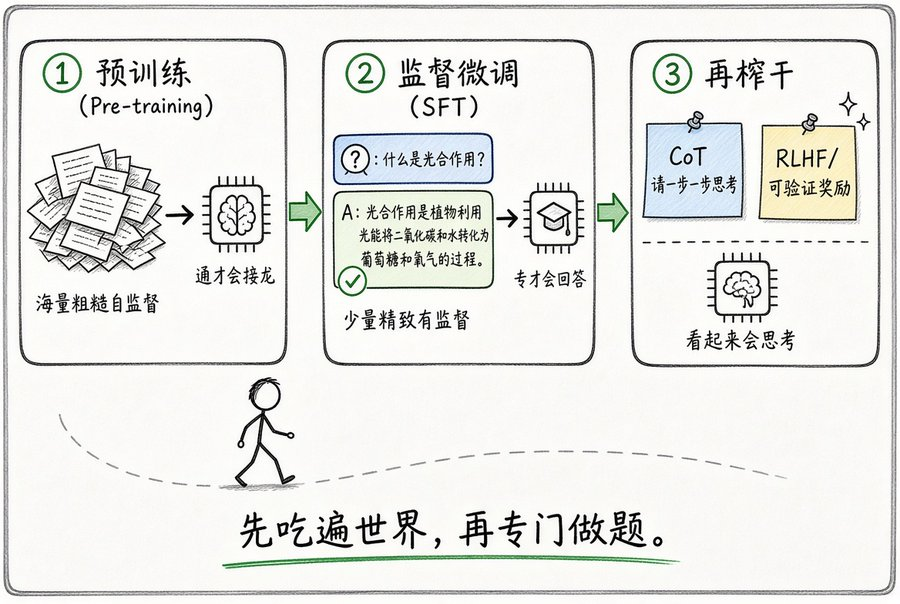
十二、从预训练到后训练:把通才训练成专才
不过,预训练模型虽然懂很多东西,却不一定知道你希望它怎样回答。比如,你输入一个问题。纯预训练模型可能不会直接回答,而是继续和你玩文字接龙。因为在它原来的训练目标里,遇到这段文字之后,最重要的事情就是继续预测后面的文字。
但我们希望它遇到问题之后,能够停下文字接龙,直接回答问题。那怎么办?继续训练,不过这一次要使用专门的问答数据。
我们给它大量经过人工整理的问答样本,让它学习:用户怎么提问,助手应该怎样回答。用这种人工精心准备的数据进行二次训练,叫做监督微调,英文是 Supervised Fine-tuning,简称 SFT。
预训练和后训练可以简单对比成这样:
-
预训练是自监督学习,数据海量但相对粗糙,把模型训练成通才;
-
后训练是有监督学习,数据量少但更加精致,把模型训练成专才。
这和人其实也很像。我们先在自然环境中接触大量信息,自己消化;然后再专门抽时间做题、训练,提升某一种具体能力。当然,随着训练范式不断发展,预训练和后训练之间的量级差距也在逐渐缩小,后训练变得越来越重要。
为了进一步榨干模型的智能,人们又想出了很多办法。一个最简单的办法,就是在提示词里增加一句:“请一步一步思考。”
如果让模型直接给出最终答案,有些复杂问题可能比较难。因为大模型的底层原理就是不断输出下一个 token,它没有一个像人一样完全隐藏在脑中的心算过程,很多中间过程都必须通过输出文字来完成。
所以,你在提示词里让它把思考过程写出来,它就会自说自话地把中间步骤展开。从效果上看,就好像它的推理水平提升了。
这种让模型把推理过程写出来的方式,叫思维链,英文是 Chain of Thought,简称 CoT。你看参数没动,模型架构没变,仅仅增加了一句提示词,就可能获得智能上的提升,是不是非常划算。
除了提示词层面的技巧,还可以在训练阶段直接激发模型的推理能力。比较著名的方式就是强化学习,比如基于人类反馈的强化学习 RLHF,以及基于可验证奖励的强化学习。强化学习又是一个非常庞大的体系,这里就不展开了。总之,到这里,我们手里的模型已经不仅会说,还看起来会“思考”了。
当然,本质上它仍然是在说。只不过从形式上看,它已经不再只是简单的文字接龙,而是能够利用更长的过程来完成复杂任务。
十三、怎么继续榨干一个只会文字接龙的模型?
有了一个会文字接龙、会回答问题、看起来还会思考的大模型,接下来怎么办?我们继续榨干它的价值。为了理解这个过程,我们可以做一个角色扮演。
一开始,小语言模型还是个智障,只会根据前文续写。但随着参数不断增加,到了某个临界点,它居然涌现出了智能。为了和以前的模型区分,我们在前面加了一个“大”字,于是就有了大语言模型,简称 LLM。
但大模型本身只能不断输出下一个 token。如果只是这样使用,看起来还是有点像智障。于是,我们人为地把对话分成一问一答两个角色。你是老板,大模型是员工,我们就叫它小 L。不过这个员工有点特别:它只能一问一答,说完这一轮就结束,不能追问。不能追问,不能追问,不能追问,这个非常重要,后面要考。
既然它不能主动记住过去,那我们就想办法把过去的对话重新放回去。你每次和小 L 沟通时,先把之前的对话历史放进 context 里,再提出新的问题。这样看起来就像多个人在连续对话,其实只是每次都把历史重新喂给模型。
这些历史信息可以叫 memory,也就是记忆。如果历史太长了,还可以再调用一次大模型,把过去的对话总结成一段更短的摘要。这样就能压缩记忆,减少上下文长度。原本只能一问一答的文字接龙模型,就这样被我们玩成了一个能够连续对话的员工。
十四、Agent:给大模型配一双手
很快,我们又发现小 L 有新的问题:它不会上网查资料。不知道的东西,它可能直接说不知道;也可能一本正经地胡说八道;就算知道,知识也可能已经过时。
那我们可以告诉它:如果你需要查资料,就先告诉我,我查完再把结果给你。但这样做有一个问题:到底谁才是牛马?明明是你在替它搜索。
于是,我们把上网搜索这一部分逻辑写成一段程序,让程序去代理你和小 L 的沟通,完成搜索任务,再把搜索结果传回给模型。这个程序看起来像是拥有了某种智能,而且还能操作工具。我们给它取了一个非常科幻的名字:智能体,也就是 Agent。
当然,不要有太大的心理负担。早期很多所谓的 Agent,底层逻辑可能就是多加了一段 prompt,再加上几段工具调用代码。从今天的视角回看,有些甚至有点像“把 if-else 改了个名字”。但它确实解决了一个重要问题:让大模型不再只是说话,而是可以通过程序去操作外部工具。
十五、RAG:让模型搜索参数之外的知识
既然 Agent 能上网搜索,那它当然也可以搜索本地文档和数据库。
但搜索方式和传统数据库不一样。传统数据库往往按照关键词、字段或精确匹配来查,而大模型应用更希望根据语义找到相近的内容。于是,我们把文档切成许多片段,给每个片段生成向量,再存进向量数据库。用户提问时,也把问题转成向量,然后找出语义上最接近的文档片段。
接着,把这些片段加入上下文,再交给大模型生成回答。
这种通过语义匹配找到信息,并把信息加入上下文、增强生成内容可靠性的办法,叫检索增强生成,也就是 RAG,Retrieval-Augmented Generation。
说白了:模型自己不知道,就先帮它把资料找出来,再让它回答。刚才的联网搜索,也可以看成获取模型参数以外信息的一种方式。
十六、Function Calling:让模型用固定格式说话
现在整体架构大概是:你和小 L 之间隔着一层 Agent 程序。Agent 用来减少你和大模型直接沟通的次数,同时处理大模型本身无法操作的东西,包括搜索、读取文件、访问数据库和调用其他工具。
但这里还有一个问题。我们把注意力放到 Agent 和大模型的沟通过程中。如果大模型一直用自然语言表达自己的需求,那程序就很难稳定解析。
大模型可能说:我觉得有必要查一下北京今天的天气,也可能说:请帮我调用天气工具查询北京,还可能写一大段废话。程序哪知道它到底想干什么?所以最好给它规定一种死板的格式。比如 JSON:
{ "tool": "weather", "arguments": { "city": "北京" } }
这样程序就能直接解析:调用哪个工具,参数是什么。这种 Agent 和大模型之间关于工具调用所约定的格式,叫做 Function Calling。其实它就是一套约定,没什么神秘的。就像开发时前端和后端约定接口格式一样。
十七、MCP:把工具从 Agent 主程序里拆出来
如果所有工具都直接写在 Agent 主程序里面,后面会越来越乱。所以可以把每个工具单独写成一个服务。这样,Agent 的主程序就不需要知道每个工具的具体实现,只需要按照统一的规范去发现和调用它们。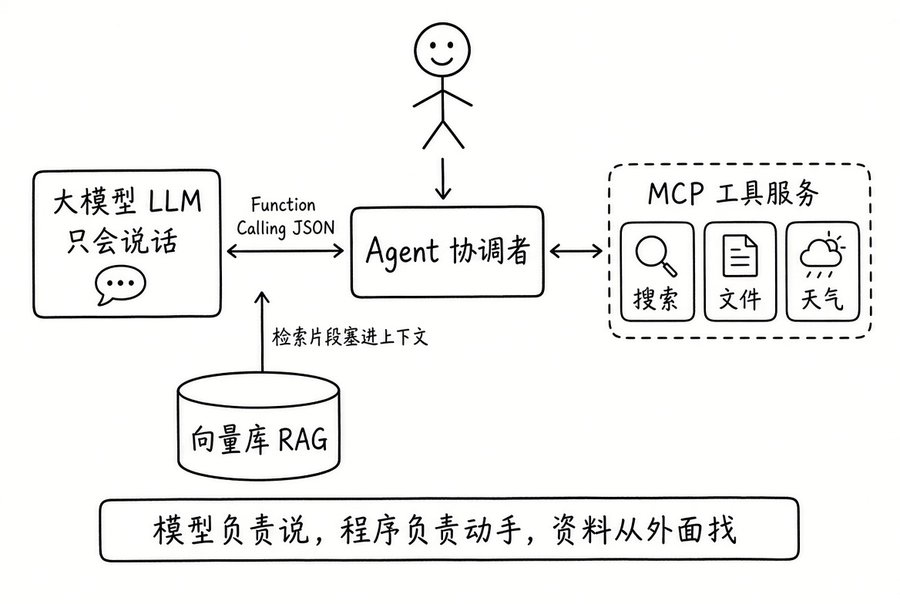
比如规定:某个方法返回工具列表,另一个方法调用具体工具,再约定工具的输入输出格式。这种让模型应用发现和调用外部工具的规范,就叫 MCP,Model Context Protocol,也就是模型上下文协议。
到这里,整个架构可以画成这样:
-
大模型像一个只会说话、不会亲自动手的智者;
-
MCP 服务提供各种工具;
-
Agent 是中间的传话筒和协调者;
-
Agent 把模型的话转换成工具调用,把工具结果再传回模型;
-
最后再把模型整理好的结果交给用户。
主打一个:我不生产信息,我只是信息的搬运工。
十八、不是所有任务都需要 Agent:Workflow
虽然 Agent 很灵活,但它也有一个统一的缺点:不稳定,而且费 token。假设我们要完成这样一个任务:从一个英文 PDF 文档中提取内容,翻译成中文,最后保存成 Markdown 格式。
当然可以直接把需求描述给 Agent,让它自己策划整个流程。但如果这个流程相对固定,每次都让 Agent 自由发挥,不但结果可能不稳定,还会浪费很多 token。比如,PDF 提取和 Markdown 保存这两步,完全可以固化成固定脚本。中间的翻译直接和大模型沟通就行。这样,整个流程不需要任何一个中间智能体插手。
要固化这种流程,可以通过编程来实现。为了方便编写链式任务,人们又发明了各种工作流框架。
如果不想写代码,还可以用低代码方式,在页面上拖拽组件完成流程。这个东西就叫 Workflow,也就是工作流。但问题又来了:原始文档不只有 PDF,也可能是 Word、TXT、PPT;输出也可能是 HTML、PDF,甚至一张图片。难道要为所有排列组合都写一套工作流吗?这显然不合适。
当然,你也可以写一堆 if-else 做判断。但如果还希望用户用自然语言触发任务,就不太好办了。一种折中的设计是:把所有可能用到的转换脚本都准备好,放在一个目录里;再写一个统一的说明文件,把整体流程描述清楚,并告诉 Agent 根据文件格式灵活选择对应脚本。
下达任务之前,先告诉 Agent:请读取刚才那一大串要求,然后按照要求完成任务。这样既保留了一定的灵活性,又让整个过程比较可控。
十九、Skill 和 Subagent:把能力组织起来
但这又产生了一个优化空间:既然每次都要提醒 Agent 先读取说明文件,那不如把这个动作直接固化到 Agent 里。比如提前约定一个固定目录,Agent 每次执行任务前,自动读取那里的一份 SKILL.md 文件。这其实就是把提示词换了一个地方存起来,但想想还是应该给它起个新名字:Skill,也就是 Agent 的技能。
好家伙,这已经开始往游戏里的英雄方向设计了。如果任务非常复杂,Agent 的上下文可能会变得特别大。于是又有人发明了 Subagent。
对于一些相对独立的子任务,可以单独交给一个 Subagent 去完成。它的本质其实就是上下文隔离:子 Agent 产生的上下文不会全部保留在主 Agent 里。
这样可以避免主 Agent 的上下文越来越臃肿,也可以让不同子任务分别处理,最后只把结果汇总回来。
二十、应用层的名词已经够多了,现在回到模型架构本身
到这里,我们已经看到,人们在大语言模型的基础之上,在应用层做了哪些改进:
-
用 Prompt 与模型沟通;
-
用 Context 提供背景;
-
用 Memory 保存历史;
-
用 Agent 调度工具;
-
用 RAG 检索外部资料;
-
用 Function Calling 规定工具调用格式;
-
用 MCP 统一接入工具;
-
用 Workflow 固化稳定流程;
-
用 Skill 组织可复用能力;
-
用 Subagent 做上下文隔离。
这些东西,本质上都是在想办法榨干一个“只会文字接龙”的模型。接下来,我们再看模型架构本身有哪些演进路线。
这部分不像 Agent 那么容易冒出一堆听起来很科幻的名词,因为架构层面的改动必须实打实地提升模型性能。不过现在我要告诉你一个有点扎心的事情:今天的大模型架构,和原始 Transformer 相比,已经有点像特修斯之船了。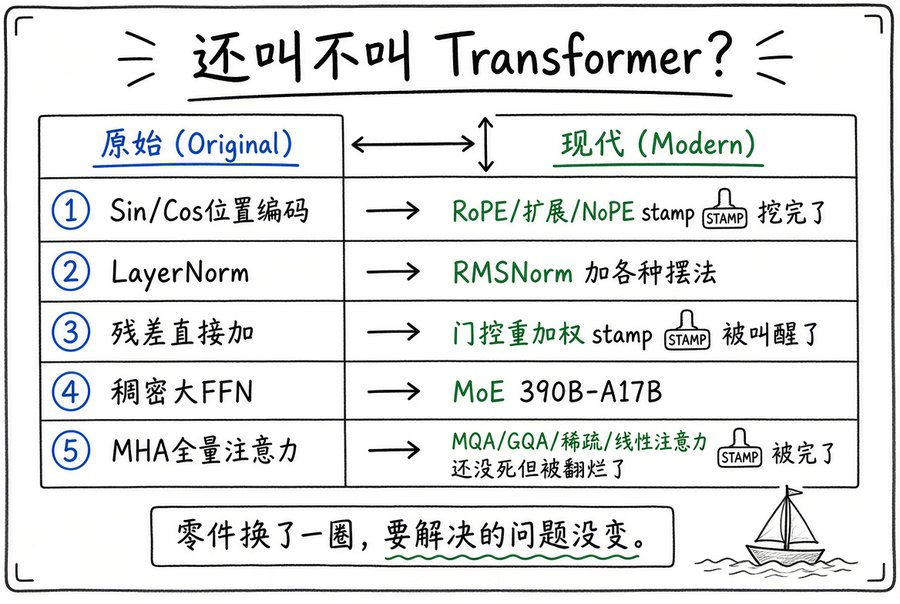
它每过一段时间,其中一个组件就被替换成另一种实现形式,但它要解决的核心问题不变。现在的大模型,几乎已经把 Transformer 的零件换了个遍。那你说它还是不是原始的 Transformer?
有人认为,既然样子已经完全变了,就应该改个名字;也有人认为,本质没有变化,所以仍然可以叫 Transformer。
二十一、位置编码:这个地方已经被反复挖掘
先看 Transformer 的输入部分。原始架构里,它大致由 token embedding 和 positional embedding,也就是词嵌入和位置编码组成。位置编码是在原来的词向量基础上,根据 token 所处的位置,再加上一个新的向量。
Transformer 原论文中使用的是固定的正弦、余弦函数,后来被旋转位置编码逐渐替代。旋转位置编码可以让向量之间做点积时得到一些更友好的位置特性。再后来,又有人提出旋转位置编码的扩展方法,目的是支持更长的上下文。
甚至还有人提出 NoPE,也就是不显式加入位置编码的方式,并证明它在某些场景下也有效。看到这里你会发现,位置编码这个点,基本已经被挖得差不多了。实际应用中的路线也逐渐收束。我宣布:位置编码,死。
当然,“死”只是为了形象地说明它已经从一个巨大的创新空间,变成了一个相对成熟、主要进行细节优化的模块。
二十二、归一化:LayerNorm、RMSNorm 和各种摆放位置
训练深层网络时,我们需要把向量控制在一个比较稳定的范围内,同时尽量保持它们之间原本的相对关系。比如原来的数据可能分布在某个范围里,我们把均值控制为 0、方差控制为 1,这就是归一化在做的事情。
原始 Transformer 使用的是 LayerNorm,也就是层归一化。现在的大模型里,RMSNorm 变得更加常见。这还只是归一化具体计算方式的不同。归一化在模型里的位置也可以变化:
-
放在注意力层之前,叫 Pre-Norm;
-
放在注意力层之后,叫 Post-Norm;
-
前面放一个,后面再放一个,也可以;
-
放在残差连接之前或之后,也可以有不同组合。
组合起来之后,方案就非常多。更夸张的是,归一化不仅可以作用在 token 向量上,还可以作用在注意力层里的 Q、K、V 向量上。作用在 Q 上,可以叫 QK 相关的归一化;作用在 K 上、V 上,也有不同变体;还可以同时对 Q、K 做归一化。不好意思,这些组合也基本都被人类玩过了。
二十三、残差连接:原来默认正确的地方也能被改
刚刚我们提到过残差连接。原始 Transformer 里的残差连接就是一个简单的加法:输入加上这一层的输出。
这么多年来,大家几乎没人敢动这里,因为它已经像默认正确的设计一样存在了。
但后来,也有人开始对残差连接动刀,尝试引入门控、重新加权,或者改变信息通过残差路径的方式。
这部分目前还比较新,花样没有 FFN 和注意力那么多,但至少说明了一件事:即使是大家习以为常的默认组件,也不一定永远不能改。残差连接,暂时还没死,但已经被叫醒了。
二十四、FFN:从一个大网络变成很多专家
接下来轮到 FFN。FFN 本来就是一个普通的全连接神经网络,只不过在大模型里占地面积特别大。这里的每条线都可以表示一个参数,网络越大,参数就越多。
那如果它太大怎么办?答案很简单:变小一点。我们可以把一个很大的 FFN 拆成很多个小的 FFN,最后再增加一个训练出来的路由层。每个 token 经过路由层之后,只被送到其中一个或少数几个 FFN 里计算。
这样就能做到:总参数量仍然很大,但每次推理只激活一小部分参数。这里的每个小 FFN 叫做 expert,也就是专家;整个结构叫做 Mixture of Experts,简称 MoE,混合专家模型。
后来,人们又继续优化 MoE,比如把专家拆得更细,引入共享专家,改变路由方式等等。所以现在你在很多模型名字里看到类似“390B-A17B”这样的写法,往往意味着总参数量有 390B,但每次只激活大约 17B。
为了区分这两种模型,人们又发明了两个词:所有参数都参与计算的模型叫稠密模型,Dense;只激活一部分参数的叫稀疏模型,Sparse。说到底,很多时候还是 MoE,只是专家数量和激活比例各有不同。
我宣布:稠密 FFN,逐渐被 MoE 化了。
二十五、注意力:Transformer 最核心、也最卷的地方
最后只剩下注意力层了。注意力是 Transformer 的精髓,也是大家最卷的地方。原始 Transformer 有 MHA,后来有各种减少计算量的改良方法,也有不同的多查询、分组查询方式;还有一些模型提出了新的注意力结构。
名字看起来眼花缭乱,但本质上都在解决一个非常简单的问题:注意力太贵了。 为什么贵?因为每个 token 都需要和其他 token 做计算。序列越长,计算量增长得越快。
围绕这个问题,大致有几条路线。
第一种路线,是让每个 token 之间仍然计算,但让每次计算便宜一点。比如想办法缩短向量、减少需要参与计算的参数,或者让多个 token 共享某些表示。
第二种路线,是减少需要计算的数量。
比如只计算固定窗口内的 token,或者想办法挑选一部分重要 token 进行计算。这类方法可以叫稀疏注意力。
第三种路线,更激进一点,直接把注意力的复杂度变成线性增长。传统注意力和线性注意力的混合使用,也成为一种新的探索方向。
所以很多注意力改良,不管名字是什么,基本都在做三件事:
-
数量不变,但让每次计算更便宜;
-
每次计算保持原样,但减少计算数量;
-
换一种算法,让整体复杂度增长得更慢。
这块暂时还没有完全统一的答案,现在仍然是百花齐放。谁也不知道哪种方式最终最好,但因为这个领域实在太卷,能创新的点也已经被挖了很多。我宣布:注意力,还没死,但已经快被研究人员翻来覆去检查完了。
二十六、Transformer 的架构空间是不是越来越小了?
总结一下:位置编码、归一化、残差连接、FFN、注意力,Transformer 的主要零件,几乎都已经被反复改造。所以这期文章的标题其实有一点标题党。更严谨地说,我的判断是:现在语言模型领域,单纯依靠继续优化 Transformer 架构,来获得模型能力上限突破的空间,可能已经没有那么大了。
这不是说 Transformer 没用了,而是说它已经成熟到了一定程度。从各种模型发展报告中也可以看到,开源模型和闭源模型之间的差距在缩小,不同厂商之间的差距也在缩小。
这其实很好理解。如果大模型的发展是线性的,那么不同模型之间的差距应该大致保持不变;如果发展是指数型的,差距反而应该越拉越大;只有当发展速度逐渐放缓时,差距才会逐渐缩小。
这也和我们的体感差不多:能大幅提升模型性能的简单手段,确实越来越少了。从更宏观的角度,我觉得可以用几个 AI 发展中的重要观点来理解这件事。
1. 大力出奇迹
大力出奇迹,意思就是增加数据、增加算力、增加模型规模,通常仍然有效。
但现在互联网里的高质量数据,基本已经被人类挖得差不多了;算力和模型规模,也很难永远在短时间内翻倍增长。
所以,单纯扩大规模,迟早会遇到瓶颈。
2. Bitter Lesson:人类小巧思可能不如规模化学习
从长期来看,人类在模型架构层面设计的一些小巧思,放到更大的模型面前,反而可能成为阻碍。更狠一点说,人类的自以为是,有时候会限制模型的学习速度。
当然,这并不是说架构设计没有用,而是说我们应该警惕:某个看起来特别聪明的人类规则,是否真的比让模型自己从数据和计算中学习更好。
尤其是现在 Transformer 架构已经被人类从各个方向动过这么多刀,即便再出现一个新的设计,也可能只是局部优化,甚至可能成为负担。
3. 莫拉维克悖论
莫拉维克悖论说的是:对人类很简单的事情,对机器很难;反过来,对机器很简单的事情,对人类很难。机器在算术方面可以轻松秒杀人类,但你让它真正缝一件衣服试试,这可能就是世纪难题。
在语言模型里,这个问题也一样存在。整个底层 Transformer 架构其实并不一定是最终正确的答案。它只是目前非常有效的一条工程路线。当然,人们也早就在尝试其他方向,比如多模态、世界模型等。
不过现在有一些多模态模型,实际上只是做了不同模态之间的对齐,最后仍然利用大语言模型的便利。至于世界模型,边界和定义都还比较模糊,这里面还有很多东西值得单独讨论。
结语:不要高估名词,也不要低估量变
不知道你看到这里有什么感受。这篇文章里我用了很多“这个死了”“那个死了”的说法,但这并不是对技术的不尊重。恰恰相反,我是想通过这种方式,形象地展示现在大模型架构究竟是怎么一步一步变化的。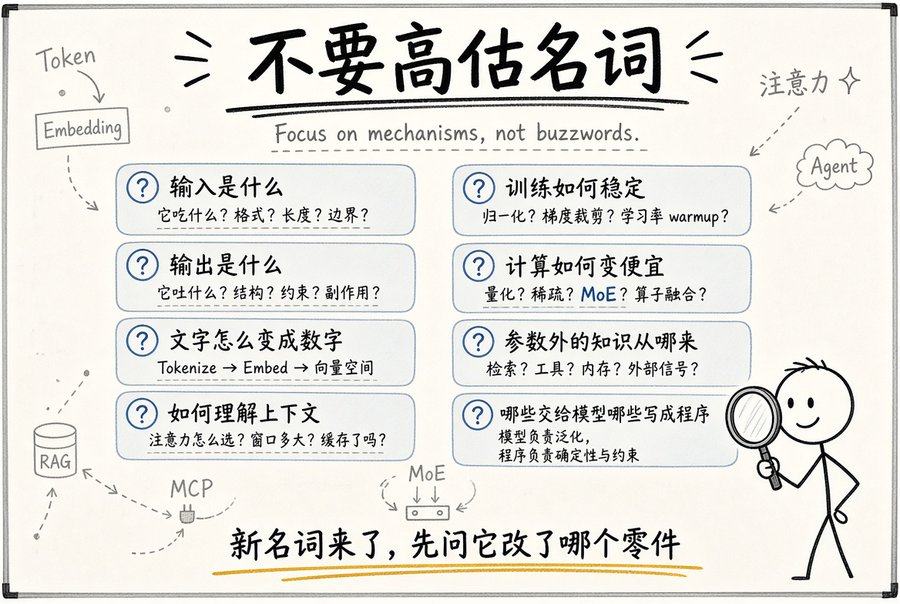
我们每天接触到的新名词可能非常多,而且每一次新技术出现时,都会伴随一些过度宣传。
但你把它拆开看,就会发现很多时候,无非还是几种固定套路:换个地方、换个计算方式、调大一点、调小一点、减少计算、增加信息,再换一个新名字。真正完全出乎意料的花样,其实没有那么多。
所以我觉得,我们不应该高估单个技术的贡献,同时也不应该低估技术量变之后产生质变的过程。
从最初的神经网络,到 Token、Embedding、注意力、Transformer,再到预训练、后训练、Prompt、Context、Memory、Agent、RAG、Function Calling、MCP、Workflow、Skill 和 Subagent,表面上看是发明了一大堆新名词。
但归根结底,它们都在解决几个问题:
-
输入到底是什么?
-
输出到底是什么?
-
如何把文字变成数字?
-
如何让模型理解上下文?
-
如何让训练更稳定?
-
如何降低计算成本?
-
如何让模型获得参数之外的信息?
-
哪些事情交给模型,哪些事情固化成程序?
所以下次再出现一个新技术时,你可以回过头来用这篇文章里的视角重新看一遍:它到底改了哪个零件,解决了什么问题,带来了多大的实际提升?也许你很快就能判断出,这个新技术到底是不是一次真正的架构变化