下面是 LLaMA-Factory(以 WebUI / LlamaBoard 最新版本为准) 的参数说明文档
LLaMA-Factory WebUI 参数说明
(注:本文档基于官方文档、社区教程与源码整理。参见 LLaMA-Factory WebUI 文档与 AiDocZh 的 “WebUI” 部分 (aidoczh.com))
WebUI 通常分为四个主要界面(标签页):
- 训练 (Train / Training)
- 评估与预测 (Evaluate / Predict / Chat / Conversation)
- 对话 (Chat / Conversation 界面,用于交互式体验)
- 导出 (Export) 在训练界面中会展示许多可配置参数,本说明重点在训练 + 导出参数的详解,也会简要提及对话 / 推理相关选项。
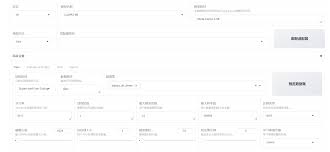
下面首先给出一个截图参考,然后一步步说明各参数块。
WebUI 界面结构与截图参考
界面的顶部通常是模型 / 微调方法 / 模板选择,下方是数据 / 超参数 / 训练控制 / 输出 / 监控等模块。
截图参考(来源于 AiDocZh 的 WebUI 界面)
界面上通常有 “Preview Command / 预览命令” 按钮,用于把当前 WebUI 上的参数转换成 CLI(命令行)格式命令,方便你在终端调试或版本控制。许多教程也建议先通过 WebUI 设定参数,预览命令,然后在终端跑训练。(Medium)
训练(Train)标签页:参数详解
下面以界面模块顺序为线索,从模型、数据、微调算法、超参、训练控制等多个维度说明参数。
模型 / 基础设置模块
| model_name_or_path | 基础模型名称或路径 | 如 meta-llama/Llama-3-8B-Instruct 或本地路径 | 必须是已经下载 / 支持的模型,否则加载失败 |
| adapter_name_or_path | 如果已有 adapter / LoRA 模型,用来做接续训练 | 空 / 某个已训练 adapter 路径 | 用于断点恢复 / 在已有 adapter 基础上继续训练 |
| stage | 训练阶段(一般是 SFT 等) | 默认为 sft | 当前 WebUI 主要支持 supervised fine-tuning(SFT)阶段 |
| template | prompt 模板 / 交互格式 | 如 default、alpaca、vicuna、instruct 等 | 模板会影响模型如何拼接 instruction/input/response,需与数据格式匹配 |
| finetuning_type | 微调方式类型 | full / freeze / lora / galore / badam 等 (aidoczh.com) | 决定训练哪些参数 / 模块,影响显存开销与训练效率 |
关于微调算法(Tuning Algorithm)
LLaMA-Factory 支持多种微调方式:
- Full(全量微调)
- Freeze(冻结部分层,只训练少量层或模块)
- LoRA(低秩适配器微调)
- GaLoRe、BAdam 等(更高级 / 混合策略)(aidoczh.com)
不同方式对显存、训练速度、稳定性有显著影响:
- LoRA / Freeze 一般显存消耗低,适合资源有限环境
- Full 微调对显存要求最高,适合较小模型或多卡 / 分布式环境
- GaLoRe / BAdam 等可能在某些任务上有性能优势,但更容易出错或需更复杂调参
在 WebUI 中,你选定 finetuning_type 后下方可能会出现该方式专属的参数(如 LoRA 的 lora_rank、lora_alpha、lora_dropout;Freeze 的 freeze_trainable_layers 等)。
数据 / 样本 / 长度控制模块
| dataset_dir | 数据集所在目录 | 如 data / 自定义路径 | 必须目录下有数据说明 / 格式正确,否则训练失败 |
| dataset | 数据集名称 / 标识 | 和 data/data_info.json 中注册的名称对应 | 若名称不匹配无法加载数据 |
| cutoff_len | 最大输入长度(token 上限) | 常见值如 2048 | 输入超过此长度将截断;设置过大显存占用高,设置太小可能截断重要信息 (qwen.readthedocs.io) |
| max_samples | 最大训练样本数 | 如 100000 / 50000 / 数据集大小 | 若数据很多但你只想用部分训练,可限制样本数 |
| preprocessing_num_workers | 数据预处理线程数 | 如 4 / 8 / 16 | 较高可加速数据加载,但资源受限时适度即可 |
| shuffle / shuffle_seed(若有) | 是否打乱训练样本 / 随机种子 | true / false / 整数 | 打乱使训练更泛化;固定 seed 有助于复现实验 |
在 WebUI 上,这些参数通常在 “Data / Dataset / Preprocessing” 区块中。
一些教程指出,如果你使用自定义数据集,需要在 data/data_info.json 中注册对应名称,并确保样本格式(如 instruction/input/response 字段)符合框架要求。(llamafactory.readthedocs.io)
超参数 / 优化器 / 正则化模块
| learning_rate | 基础学习率 | 如 5e-5 / 2e-5 / 3e-5 等 | 太高容易发散,太低训练慢,如使用 LoRA 时通常比全量调低 |
| weight_decay | 权重衰减(L2 正则化) | 0.0 / 0.01 / 0.001 | 可防止过拟合,但设置过大会影响性能 |
| warmup_ratio / warmup_steps | 预热比例 / 步数 | 比如 0.03 / 0.1 | 使最初几步梯度平缓,帮助稳定训练 |
| per_device_train_batch_size | 每卡训练批大小 | 如 2 / 4 / 8 / 16 | 根据显存与模型大小调节 |
| gradient_accumulation_steps | 梯度累积步数 | 如 1 / 2 / 4 / 8 | 用于模拟较大 batch 批量;显存受限场景常用 |
| num_train_epochs | 总训练轮数 | 如 3.0 / 5.0 / 1.0 | 过高容易过拟合,过低可能欠拟合 |
| eval_steps / do_eval | 是否评估 + 评估频率 | true / false;步数如 500 / 1000 | 打开评估可监控模型效果变化,但会略微减慢训练 |
| save_steps | checkpoint 保存频率 | 如 500 / 1000 | 频繁保存增加 I/O 开销,过少可能丢失恢复点 |
| save_total_limit | 最多保留的 checkpoint 数量 | 如 2 / 3 / 5 | 超过时自动删除旧模型 |
| logging_steps | 日志记录频率 | 如 每 10 / 50 / 100 步 | 日志过密影响性能,过稀则监控不及时 |
| overwrite_output_dir | 是否覆盖已有输出目录 | true / false | 若目录已有模型且你希望覆盖,则设为 true,否则 false 防止误删 |
在实际训练中,学习率 + 批量大小 + 累积步数 是常见调优组合:若显存不够,可以减 batch_size 或增加 gradient_accumulation_steps。 对于 LoRA 方法,还需注意与 lora_rank / lora_alpha / lora_dropout 等参数协同调试。
LoRA / 微调策略相关子参数
在你选择 finetuning_type = lora 或其他支持 adapter 的方式时,会出现以下专用参数:
| lora_rank | LoRA 低秩近似的秩 r | 默认一般为 8(视框架版本而定) | 值越大参数越多、拟合能力更强,但显存 / 计算成本上升 |
| lora_alpha | 缩放因子(scaling) | 通常是 lora_rank * 2 / 或类似比例 | 较高 alpha 可放大 LoRA 更新;若过高可能不稳定 |
| lora_dropout | 在 LoRA 层的 dropout 概率 | 默认 0 / 可设为 0.05 / 0.1 | 有助于防止过拟合,尤其在数据较少时有用 |
| lora_target | 哪些模块 / 子层应用 LoRA | all 或模块名列表 | 例如你只想给 attention 层加 LoRA,可限定模块名,节省参数与计算 |
| freeze_trainable_layers | 在 freeze 策略下可训练层数 | 如 2 / 4 层等 | 如果是 freeze 策略而非 pure LoRA 时有用 |
| freeze_trainable_modules | 模块名称方式指定可训练子模块 | all 或特定子模块名 | 较细粒度控制训练区域 |
调参建议:
- 若模型较大或显存有限,可从较小 lora_rank(如 4 或 8)起步
- 保持 lora_alpha 与 lora_rank 成合理比例
- 若训练不稳定,可尝试减小 learning_rate / 加入 dropout
- 若你只对模型某些特定子模块微调,可限定 lora_target 或 freeze_trainable_modules
分布式 / 混合精度 / 加速相关模块
| deepspeed | 指定使用 DeepSpeed 引擎 / 配置文件 | JSON config 文件或布尔开关 | DeepSpeed 可极大节省显存 / 扩展训练规模,但配置复杂;要与硬件/框架兼容 (llamafactory.readthedocs.io) |
| ddp / fsdp | 使用 DDP / FSDP 等分布式策略 | 依据硬件环境 | 若多卡环境,可启用 DDP / FSDP;需正确设置环境与通信 |
| flash_attn | 是否启用闪电注意力优化 | auto / true / false | 若环境支持,可用加速 attention;否则禁用以避免兼容问题 |
| quantization | 训练 / 导出时量化位宽 | 2 / 4 / 8 / none | 量化可显著减小模型大小与显存占用,但可能损失精度;配合校准集使用更稳健 |
这些选项可能被折叠在 “Advanced / Extra / Accelerator” 子模块中。在部分环境下(如多 GPU / 多机)才会出现/启用。
输出 / 检查点 / 日志模块
| output_dir | 输出目录,用于保存 adapter / checkpoint / 日志等 | 如 outputs/xxx | 目录必须可写,避免覆盖已有模型 |
| overwrite_output_dir | 是否覆盖已有输出目录 | true / false | 若目录已有模型且不希望覆盖设 false;若想覆盖则 true |
| save_steps / save_total_limit | checkpoint 保存频率与总数上限 | 如 500 / 1000 步;保留 2 / 3 个 | 频繁保存 I/O 成本高;总数上限可防止磁盘占满 |
| logging_steps | 日志记录频率 | 每 10 / 50 / 100 步 | 过频会造成日志过多;过稀监控不及时 |
| eval_steps | 评估频率 | 如 500 / 1000 | 与 do_eval = true 联动 |
| use_swanlab, swanlab_project, swanlab_run_name, swanlab_api_key | SwanLab 实验追踪 / 可视化配置 | 布尔 + 字符串 | 若启用,可将训练进度 / 超参 /日志上传到 SwanLab 平台 (docs.swanlab.cn) |
打开 SwanLab 配置后,WebUI 会出现一个 “SwanLab” 区块,允许你勾选是否上传、设定项目名和运行名等。(docs.swanlab.cn)
导出 (Export) 标签页:模型导出 / 量化 / 推理参数
训练完成后,你可以在 Export 界面配置导出模型的细节:
| export_device | 导出 / 推理目标设备类型 | cpu / cuda / vllm / tgi 等 | 若目标用于 GPU 推理则选 cuda,否则用 cpu;某些推理框架可能需特定支持 |
| quantization_level | 量化位宽 | 如 4 / 8 / none | 较低位宽模型体积更小、显存占用更低,但精度可能下降 |
| calibration_dataset | 校准集路径 / 名称(量化时用) | 已注册数据集名 / 路径 | 用于量化阶段的误差估计,选择合适校准集可提升量化效果 |
| chunk_size | 分块 (chunk / shard) 大小 | 如 1024 / 2048 / 4096 | 影响导出模型的切片方式、加载效率与推理速度 |
| max_shard_size | 每个 shard 最大大小 | 如几个 GB | 避免单个大文件不便传输 / 加载 |
| overwrite_output_dir | 是否覆盖已有导出目录 | true / false | 同训练覆盖逻辑,防止误覆盖之前导出模型 |
| push_to_hub / hub_repo_id | 是否推送模型到 Hugging Face Hub / 仓库标识 | 布尔 + 字符串 | 若希望模型托管到 HF Hub,可启用并提供 repo id / 权限 |
导出参数设置完毕后,通常点击 “Export” 按钮即可进行量化、模块合并、模型切片等操作,得到可以用于推理或部署的模型文件。
对话 / 推理界面相关参数(Evaluate / Chat / Predict)
在 WebUI 的对话 / 推理标签中,一般会有以下控制参数:
- inference_engine / backend:选择用于推理的后端,如 vllm / TGI / HuggingFace / 自身框架
- max_new_tokens / max_length:生成 token 的最大长度 / 总长度控制
- temperature / top_k / top_p / repetition_penalty / beam_size 等采样 / 解码策略参数
- prompt_template / system_prompt / history_length 等上下文 / 对话控制参数
- batch_size / num_return_sequences(如支持批量推理)
这些参数直接影响生成质量、连贯性、随机性及速度,是调优生成行为的关键。
完整参数组合示例与命令预览
在 WebUI 中,当你设定好上述参数后,通常可以点击 “Preview Command / 预览命令” 按钮,把前端参数转为命令行形式。例如:
llamafactory-cli train \\
–stage sft \\
–do_train True \\
–model_name_or_path meta-llama/Llama-3-8B-Instruct \\
–finetuning_type lora \\
–template default \\
–dataset_dir data \\
–dataset my_dataset \\
–cutoff_len 2048 \\
–learning_rate 5e-5 \\
–num_train_epochs 3.0 \\
–max_samples 100000 \\
–per_device_train_batch_size 4 \\
–gradient_accumulation_steps 2 \\
–lora_rank 8 \\
–lora_alpha 16 \\
–lora_dropout 0.1 \\
–save_steps 500 \\
–save_total_limit 3 \\
–logging_steps 50 \\
–overwrite_output_dir True \\
–output_dir outputs/my_adapter
你可以把这个命令拷贝到终端,作为一次训练任务,也方便版本控制、批量运行。
调参建议 / 常见问题 & 注意事项
下面是一些在实践中常见的经验、警示与建议:
显存与批量 / 累积步数平衡 如果显存不够,可以减小 per_device_train_batch_size,同时增大 gradient_accumulation_steps,以模拟更大批量训练。
学习率与 LoRA 参数配合 当 lora_rank 较大时,可能需要调低 learning_rate 或适当减小 lora_alpha,否则训练不稳定。
保存 / 日志频率控制 save_steps / logging_steps / eval_steps 不宜设置过低,以免 I/O 成本过高或训练卡顿;也不宜设置过高,否则监控不及时或恢复点丢失。
断点恢复 / 接续训练 若训练中断,要指定 adapter_name_or_path 为之前保存的 adapter 路径,并设置 overwrite_output_dir = false 以避免覆盖旧模型。
量化 / 导出误差控制 导出时使用低位宽量化(如 4bit)时要搭配好的校准集 (calibration_dataset) 以降低误差;分块 / shard 参数(如 chunk_size)也会影响导出模型结构及加载效率。
分布式 / 多卡训练兼容性 使用 DDP / FSDP / DeepSpeed 时要确保环境(GPU 数量、CUDA 版本、网络通信)兼容,并测试小规模模型稳定性。
模板 / prompt 与数据格式匹配 模板 (template) 必须和你的数据格式(instruction/input/response)对应,否则拼接 prompt 出错。
及时监控 / 可视化 如果你启用 SwanLab,训练过程、损失曲线、超参数等可以实时上传至可视化平台,有助于调试与对比。(docs.swanlab.cn)
版本兼容性与环境约束 有些优化(如 flash_attn、某些量化方案、DeepSpeed autopipeline)在不同 GPU / 驱动 / PyTorch 版本下可能不稳定,遇问题可尝试禁用优化回退方案。
WebUI 本身的限制 在某些多卡环境中,WebUI 可能只支持单卡训练 / 推理,需通过环境变量 CUDA_VISIBLE_DEVICES 指定设备。(CSDN) 若你在 notebook / 容器内启动 WebUI,有些资源(如 CSS / 静态文件)加载可能出错,需要调整代理或路径配置。(GitHub)