一句话读完: 用 Spring Boot + React 搭建带部门权限的企业知识库:DeepSeek 负责有据可查的智能问答,向量语义检索 补上关键词搜不到的缺口;2.0 新增 批量文件上传,并接入 火山方舟 Coding Plan(豆包等模型)基于知识库生成 专业大气的公众号文章——文档入库、对内问答、对外写稿,一套系统全搞定。
🔔 2.0 版本更新(重点)
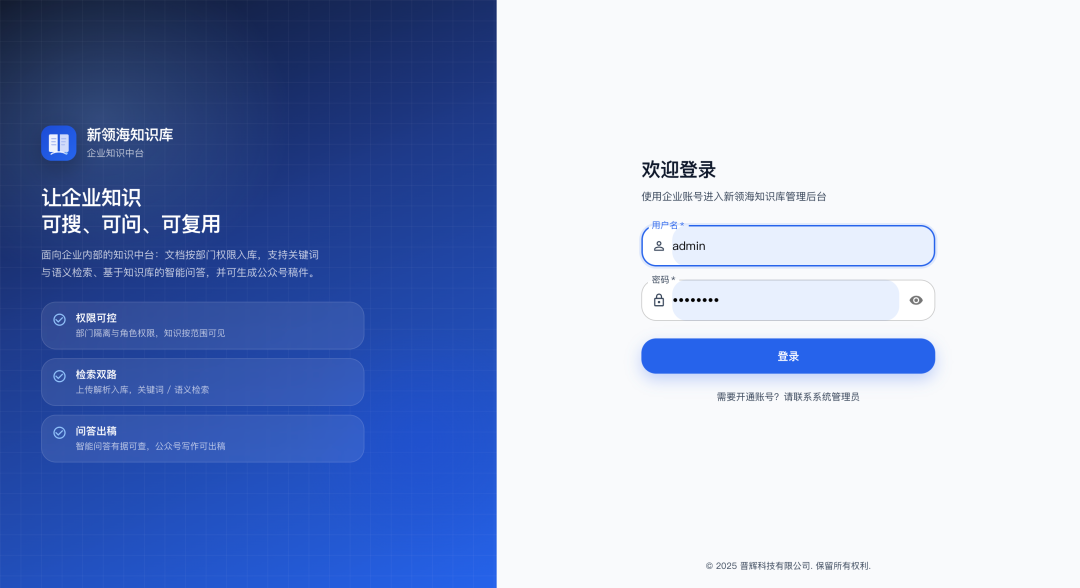
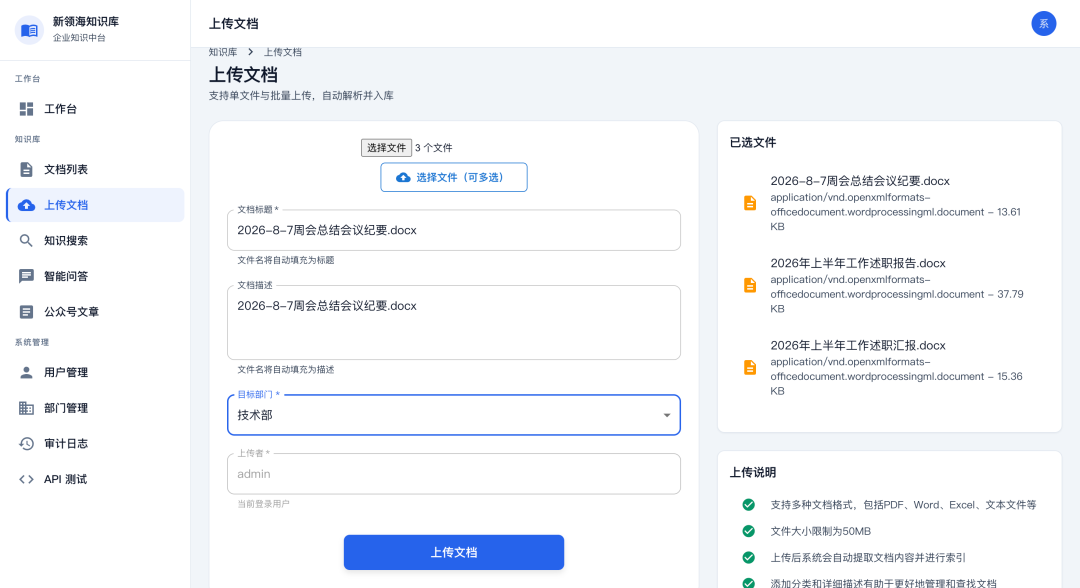
批量文件上传
-
多文件一次入库:上传页支持同时选择多个文件,调用 POST /api/documents/upload-batch 批量落库
-
自动解析与命名:Apache Tika 抽取正文;标题、描述默认取文件名,减少手工填写
-
部门归属:上传时选择目标部门,文档自动关联 department_id
-
上传后自动索引:前端批量上传成功后逐个触发向量/知识条目索引,尽快进入可搜、可问状态
-
适用场景:制度包、培训资料、项目文档等一次性大批量迁移进知识库
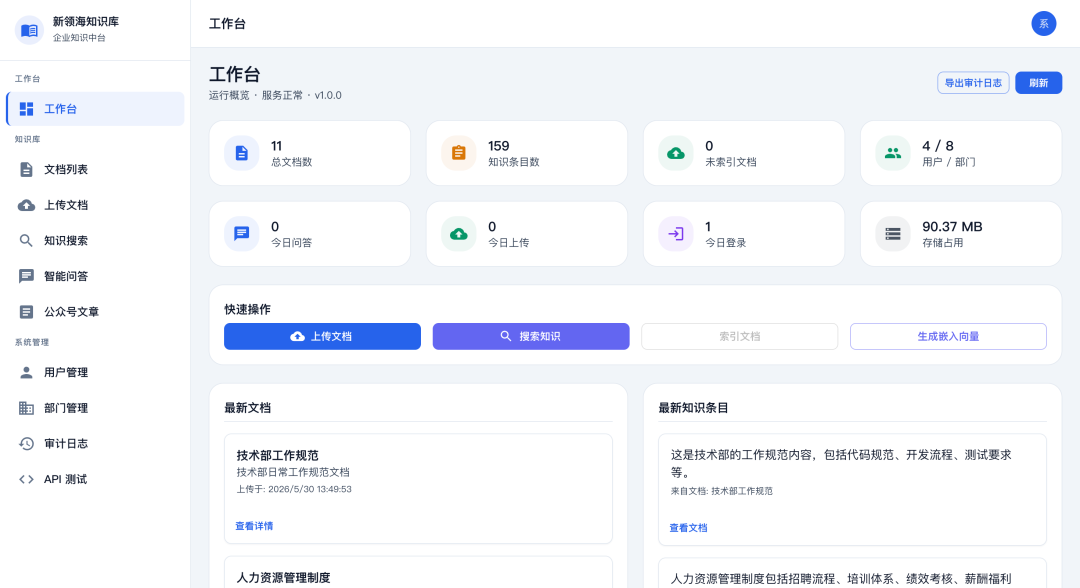
公众号文章助手
-
知识库约束写作:按主题从全库检索相关 KnowledgeEntry,将摘录作为唯一事实来源交给大模型,降低「空口编造」风险
-
专业大气文风:系统提示词要求结构清晰(标题、导语、分节、小结)、Markdown 输出、合规表述,适合企业对外稿件初稿
-
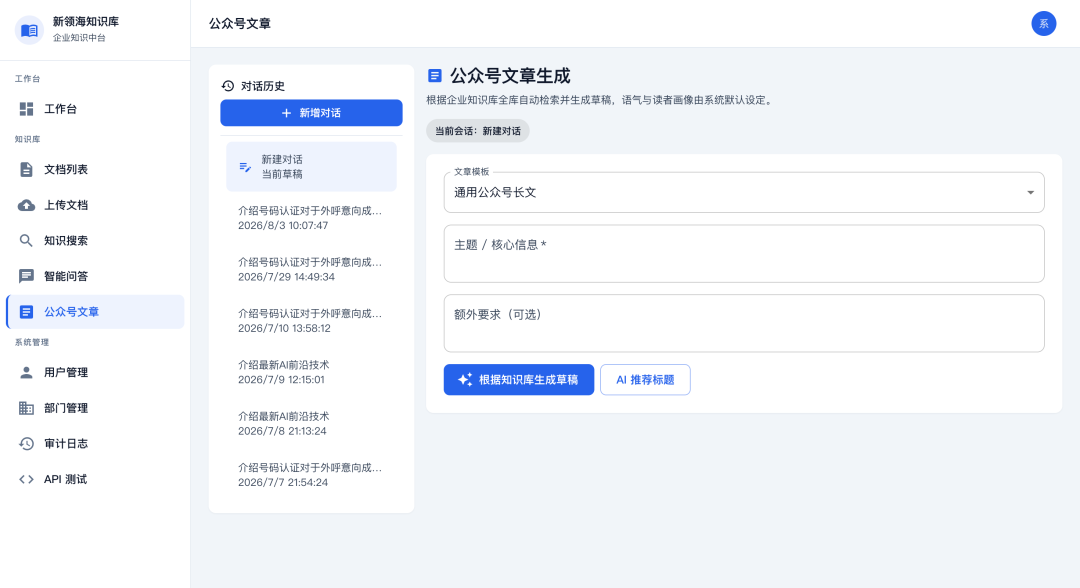
火山方舟驱动写作:公众号文章由 火山方舟 Coding Plan 生成(默认 doubao-seed-2.0-pro,可切换 deepseek-v3.2 等已开通模型),知识库检索结果作为事实依据,输出 Markdown 草稿
-
生成历史:每位用户保留最近 20 条记录,可回看草稿与引用知识片段
-
一键复制:预览区支持复制 Markdown 原文,便于粘贴到微信公众号后台排版
-
同步草稿箱(2.1):生成后可一键同步到微信公众平台草稿箱(Markdown 转 HTML),在 mp.weixin.qq.com 审校后手动发布;不调用群发/发布 API
-
管理端入口:侧边栏「公众号文章」→ 填写主题与额外要求 → 一键生成
一、项目背景及简介
文档分散、权限难控、检索靠人工——AI 问答若缺规范语料,还容易「随口编」。本章说明痛点与本系统如何收口。
1.1 背景概述
企业里常见的是:资料越写越多,但沉淀不等于可检索、可复用。传统做法往往卡在几类典型矛盾上:
-
知识孤岛问题:各部门文档分散存储,缺乏统一管理平台
-
查找效率低下:员工需要花费大量时间在多个系统中查找所需信息
-
权限管理混乱:难以实现细粒度的部门级权限控制
-
知识传承困难:新员工难以快速获取历史经验和最佳实践
-
重复工作频发:相同问题被反复咨询,缺乏知识沉淀机制
1.2 项目简介
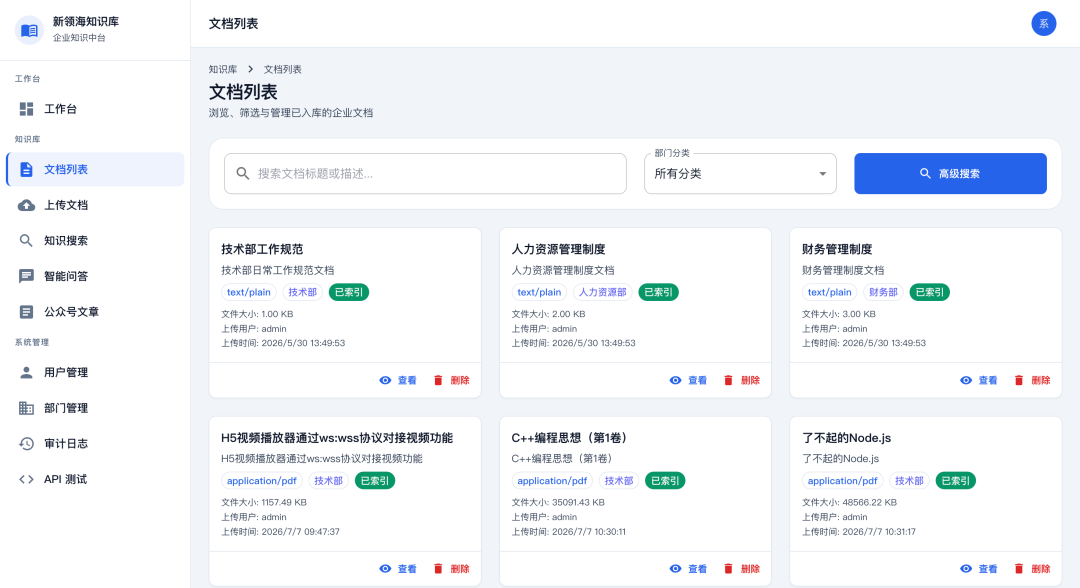
企业知识库管理系统面向中大型企业,提供文档管理(含批量上传)、智能搜索、AI 问答与多部门权限控制。对内问答由 DeepSeek 驱动;对外内容生产由 火山方舟 大模型(Coding Plan)承接——先检索企业知识库,再生成专业、可复核来源的公众号文章草稿,避免「空口写稿、细节编造」。
1.3 核心价值
-
智能化:DeepSeek 问答 + 向量语义搜索;火山方舟生成公众号稿件,让知识从「存起来」到「问得到、写得出来」
-
安全性:多层级权限体系,确保敏感信息仅在授权范围内访问
-
易用性:直观的用户界面,零学习成本,开箱即用
-
可扩展性:模块化设计,支持企业定制化需求
-
成本效益:开源技术栈,降低企业IT成本
1.4 技术特点
系统基于 Spring Boot 2.7 + React 18 构建;AI 能力双引擎:DeepSeek(智能问答)+ 火山方舟 Coding Plan(公众号文章),配合 JWT 认证与向量化检索,兼顾安全、性能与可维护性。
二、目标客户
面向文档多、跨部门协作、权限要求高的组织。
2.1 主要客户群体
-
中大型企业:需要统一知识入口与部门级权限治理
-
技术型团队:需要集中管理技术文档、规范与经验沉淀
-
咨询/项目制组织:需要复用案例模板与行业知识
-
培训与公共服务组织:需要稳定的资料管理与检索能力
2.2 适用场景
| 企业内部知识共享 |
打破部门壁垒,实现知识资产统一管理 |
提升知识利用率,减少重复工作 |
| 技术文档管理 |
集中管理API文档、技术规范、开发指南 |
技术传承,降低新人上手成本 |
| 客服知识库 |
构建智能客服系统,快速响应客户咨询 |
提升服务效率,降低人工成本 |
| 培训资料管理 |
统一管理培训材料,支持在线学习 |
标准化培训,提升培训效果 |
| 政策法规查询 |
快速查询相关政策文件和工作流程 |
提升工作效率,确保合规性 |
三、平台定位
企业知识资产管理的基础设施:存得进、搜得到、问得准、写得出来。
3.1 产品定位
核心定位
-
AI驱动的知识管理:不仅仅是文档存储,更是智能化的知识服务
-
企业级安全标准:满足中大型企业对数据安全和权限管理的严格要求
-
开箱即用:提供完整的解决方案,无需复杂配置即可投入使用
差异化优势
多部门权限管理:支持细粒度的部门级权限控制,确保数据安全隔离
AI智能问答:集成 DeepSeek 大语言模型,提供自然语言交互体验
语义搜索:基于向量相似度的智能检索,超越传统关键词搜索
批量文件上传(2.0):多文件一次入库、自动解析与索引,降低文档迁移成本
公众号文章助手(2.0):火山方舟大模型 + 知识库检索,生成专业大气、来源可复核的公众号稿件初稿
移动端适配(P2):响应式布局 + 抽屉导航,手机浏览器可直接访问
OCR 图文识别(P2):图片上传可配置云 OCR 接口提取文字,未启用时返回测试占位文本
审批流(P2):文档/文章发布支持审批队列,管理端可处理通过/驳回
客户成功体系(P2):客户反馈入口、处理看板与成功率指标,便于运营跟进
零代码配置:管理员通过可视化界面完成上传、生成与权限配置,无需改代码
价值主张
-
让知识资产活起来:从静态存储到动态服务,提升知识利用效率
-
降低知识获取成本:从平均15分钟缩短到2分钟的知识查找时间
-
促进知识传承:避免因人员流动造成的知识流失
3.2 市场定位
-
技术: AI + 向量检索,前后端分离,微服务友好
-
易用: Material Design,响应式,零代码管理端
-
安全: JWT、部门隔离、HTTPS
-
扩展: REST API、模块化,支持定制集成
四、平台技术与系统架构
经典三层、前后端分离,各组件可独立部署。源码入口:backend/src/main/java/com/company/knowledgebase/。
4.1 整体架构
客户端 →(HTTPS)→ Nginx(可选) → React SPA → REST → Spring Boot(Security/JPA/业务)
↓
MySQL / 本地文件 / DeepSeek & Embeddings
4.2 技术栈概览
|
前端 |
React 18、TypeScript、MUI 5、Router 6、Axios |
SPA、路由守卫、HTTP 拦截 |
|
后端 |
Spring Boot 2.7、Security、JPA、Tika、OkHttp |
业务、JWT、文档解析、AI 调用 |
|
数据 |
MySQL 8(生产)/ H2(开发) |
结构化数据;向量存 JSON 字段 |
|
AI |
DeepSeek、OpenAI Embeddings、余弦相似度 |
问答、语义检索(可演进向量库) |
4.3 架构要点
分层: 表现层(React)→ 业务层(Service)→ 数据访问(JPA)→ 持久化(MySQL + 文件)。
安全链: JWT 过滤器 → AuthenticationManager → @PreAuthorize → 部门过滤(PermissionUtil)→ 业务。
数据流:
-
文档:上传 → Tika 抽取 → 分块 →(可选)Embeddings → KnowledgeEntry
-
问答:问句嵌入 → EmbeddingService 取片段 → ChatService 组 prompt → DeepSeek → 落库
详见 DocumentController、ChatService、EmbeddingService。
五、平台核心业务功能
权限、文档、检索、问答、写稿、管理——六大模块,均按部门边界过滤。
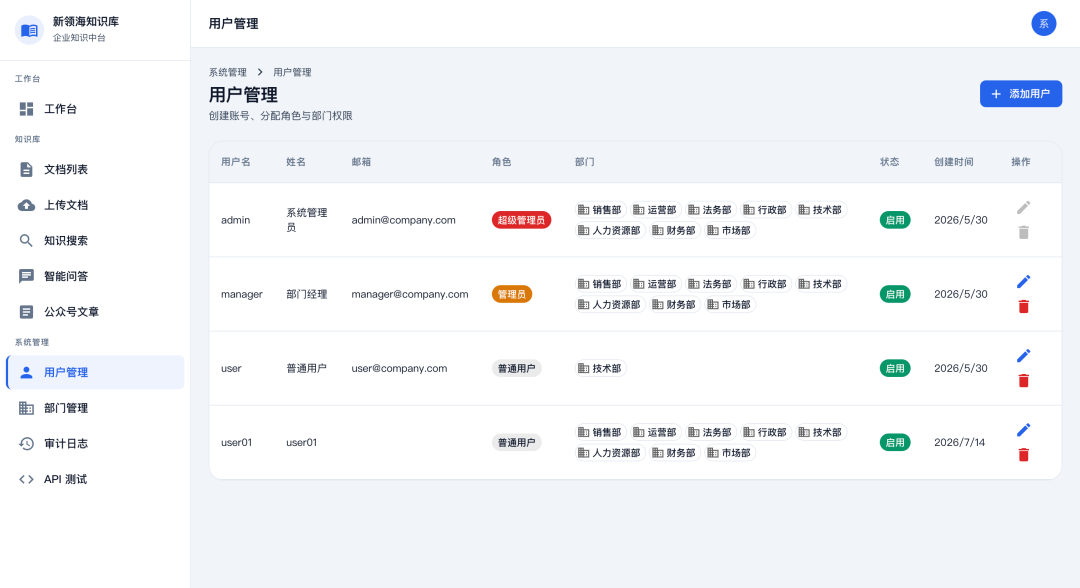
5.1 用户权限管理
| SUPER_ADMIN |
全系统、全部门、用户/部门/参数管理、审计日志查看 |
| ADMIN |
本部门文档浏览/搜索/问答;用户管理需 SUPER_ADMIN |
| USER |
本部门文档浏览、搜索、AI 问答 |
用户可多部门关联(user_departments);普通用户与部门管理员的文档/搜索/问答/公众号写作均按部门过滤;仅 SUPER_ADMIN 可跨部门查看全库。
JWT 认证: 登录校验 → 签发 HS512 Token → 前端携带 → 后端解析;无 Session,支持分布式部署。
5.2 文档管理
格式: PDF / Office / TXT / Markdown / HTML 等,Apache Tika 解析(通用文本抽取,不含专用 OCR 引擎)。
访问控制:GET /api/documents/{id} 校验当前用户是否属于文档所在部门;越权返回 403。
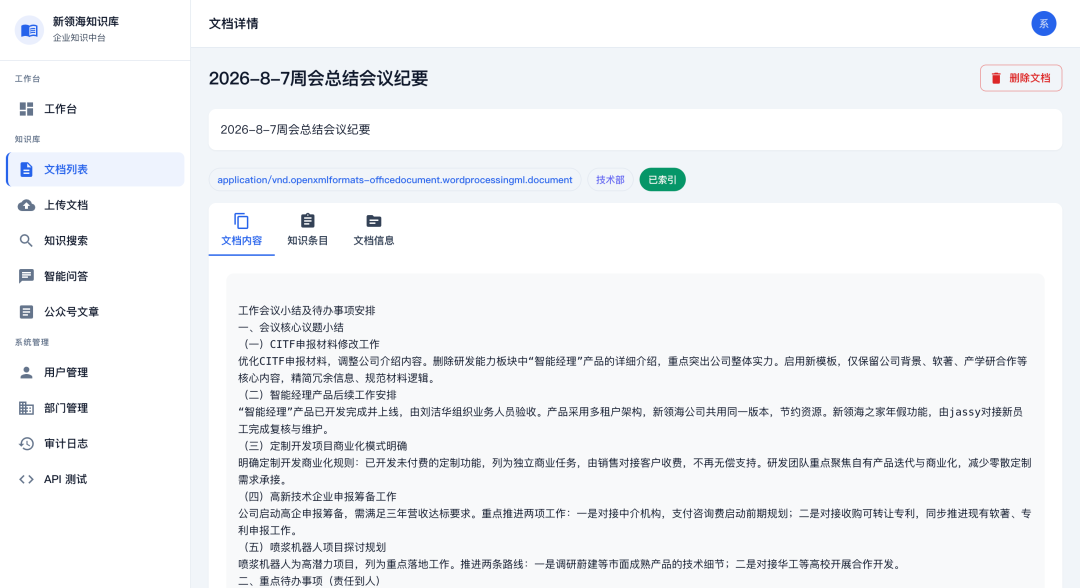
单文件:POST /api/documents/upload — multipart → Tika → 落库 → 生成 KnowledgeEntry 与向量。
批量上传(2.0):
|
接口 |
POST /api/documents/upload-batch |
|
前端 |
DocumentUpload
多选、选部门、进度反馈 |
|
索引 |
上传成功后逐个触发索引接口 |
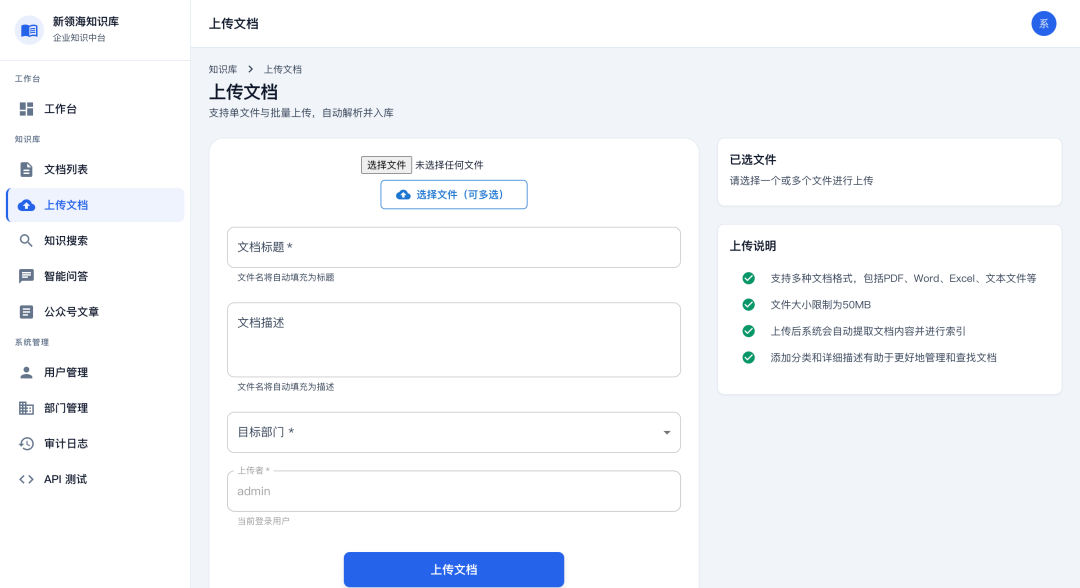
分类: 按部门(必填)、类别、时间、上传者;长文档分块后建向量与全文索引。支持单条删除与手动/批量索引(列表多选删除尚未实现)。
5.3 智能搜索
-
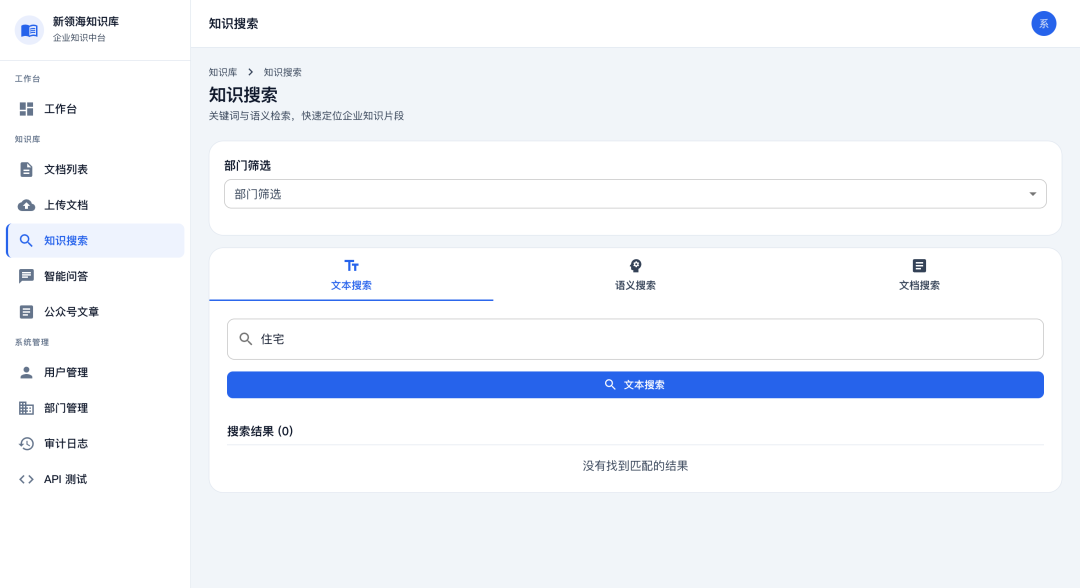
关键词: JPA LIKE 检索 + 部门过滤
-
语义: OpenAI 兼容 Embeddings + 余弦相似度;默认启用(embeddings.enabled=true)。可选接入 Milvus(milvus.enabled=true)做 ANN 检索;未启用 Milvus 时在部门范围内检索,避免全表扫描
-
筛选: 普通用户/ADMIN 限本部门;SUPER_ADMIN 可跨部门
5.4 AI 智能问答
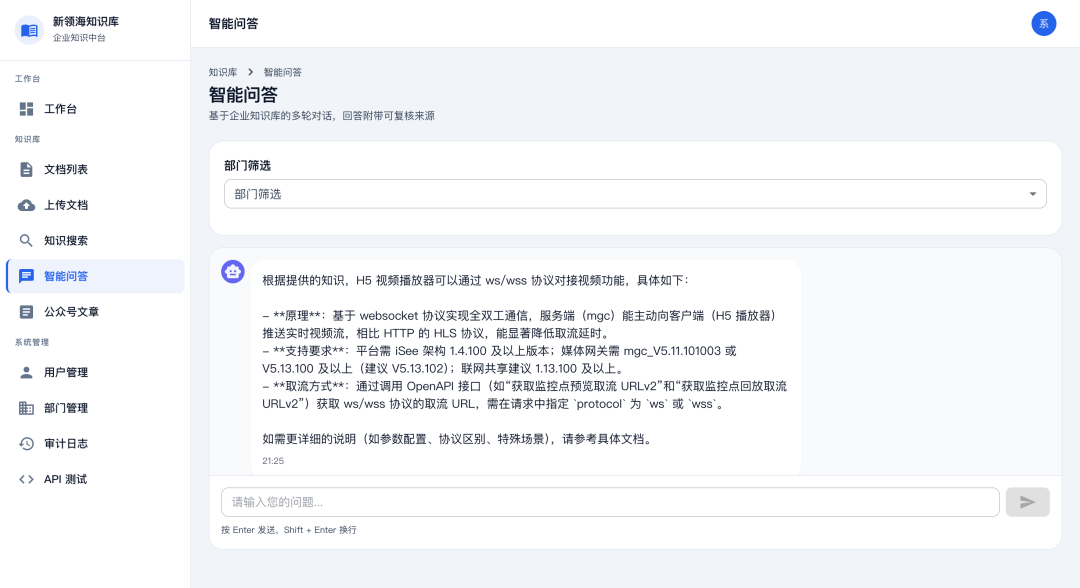
自然语言提问、多轮对话、来源标注、会话历史。聊天消息按用户隔离,不可读取他人 sessionId 会话。流程:检索片段 → ChatService 组 prompt → DeepSeek → 落库。
5.4.1 公众号文章助手(2.0)
页面 /wechat-article:先按用户部门权限检索知识库再写作,返回 Markdown + sourcesUsed。
|
事实来源 |
训练数据 |
知识库摘录 |
|
可追溯 |
难 |
返回引用条目 |
|
资料不足 |
易编造 |
提示需补充 |
|
POST |
/api/articles/wechat/generate |
|
GET |
/api/articles/wechat/history
、/history/{id} |
|
POST |
/api/articles/wechat/history/{id}/sync-draft
(multipart:可选 title、author、coverImage) |
草稿箱同步配置(可选): 设置 WECHAT_MP_ENABLED=true、WECHAT_MP_APP_ID、WECHAT_MP_APP_SECRET;在公众平台配置服务器 IP 白名单;上传封面或配置 WECHAT_MP_DEFAULT_COVER_MEDIA_ID(永久素材 thumb)。已有库执行 database/migrate-v1.3-wechat-draft-sync.sql。
火山方舟 Coding Plan(默认 doubao-seed-2.0-pro);入口:WeChatArticleController、WeChatArticleService、WeChatArticle.tsx。
5.5 系统管理与体验
管理端: 部门/用户 CRUD、多部门授权、文档与用户统计;操作审计 侧边栏「审计日志」(SUPER_ADMIN,GET /api/audit-logs);表结构见 database/init.sql。
体验: MUI 响应式布局、浅色主题、上传与索引进度反馈。
六、平台独特优势
与同类方案相比:部门级隔离 + 有据问答 + 知识约束写稿,而非泛聊天。
6.1 技术优势
-
架构: 前后端分离、REST 无状态,前端/后端可独立部署,易拆微服务
-
AI: DeepSeek 多轮问答 + Embeddings 语义检索 + Tika 自动解析分块
-
工程: TypeScript 编译期检查 + Spring Boot 自动配置与统一异常处理
6.2 安全优势
-
权限: RBAC 三角色 + 用户-部门多对多;文档、搜索、问答、写稿全链路部门过滤
-
认证: JWT(HS512)无 Session;密码 BCrypt;方法级 @PreAuthorize
-
审计: 登录、文档上传/删除、用户变更等写入 audit_logs
-
生产: 强 jwt.secret、HTTPS、敏感密钥仅环境变量;用户密码字段 API 不返回(@JsonIgnore)
6.3 业务优势
-
零代码: 部门/用户/权限可视化配置,初始化脚本含示例数据
-
开箱即用: 前后端 + SQL 一体,约 30 分钟可完成首套部署
-
可集成: REST API 标准化,权限模型可扩展
6.4 性能优势
-
前端: SPA 懒加载,静态资源可 CDN
-
批量(2.0):upload-batch、上传后批量索引、列表多选删除
-
扩展: 无状态多实例 + 负载均衡;向量生成可异步,大规模可迁向量库
七、平台安装使用
标准部署链路:初始化数据库 → 打包后端 API → 构建管理后台 → Nginx 反代 → 进程守护。
7.1 环境要求
|
开发 |
JDK 8+、Node 16+、Maven 3.6+、MySQL 8+(或 H2)、Git |
|
生产 |
Linux、2 核 / 4GB+(推荐 8GB)、50GB+ 磁盘、Nginx 1.18+、HTTPS 证书 |
7.2 数据库初始化
git clone <仓库URL> && cd company-knowledge-devlop
mysql -u root -p < database/init-production.sql
生产账号见 database/init-production.sql 末尾说明;本地 H2 开发无需执行上述脚本,使用 –spring.profiles.active=local 即可。
7.3 后端打包与部署
打包:
cd backend
mvn clean package -DskipTests
# 产物:target/knowledgebase.jar
运行(生产 profile,默认端口 13085):
java -jar target/knowledgebase.jar –spring.profiles.active=prod
后台守护(示例):
mkdir -p logs
nohup java -jar target/knowledgebase.jar \\
–spring.profiles.active=prod \\
> logs/backend.log 2>&1 &
生产配置(application-prod.properties 或环境变量覆盖):
spring.datasource.url=jdbc:mysql://127.0.0.1:3306/knowledgebase?useUnicode=true&characterEncoding=UTF-8&serverTimezone=Asia/Shanghai
spring.datasource.username=your_user
spring.datasource.password=your_password
server.port=13085
jwt.secret=请替换为 openssl rand -base64 48 级别长度
deepseek.api.key=${DEEPSEEK_API_KEY:}
embeddings.enabled=${EMBEDDINGS_ENABLED:true}
milvus.enabled=${MILVUS_ENABLED:false}
codeplan.api.key=${CODEPLAN_API_KEY:}
codeplan.model=${CODEPLAN_MODEL:doubao-seed-2.0-pro}
# OCR(可选:图片上传自动提取文字,支持 baidu/tencent/custom 等自定义 HTTP 接口)
ocr.enabled=${OCR_ENABLED:false}
ocr.provider=${OCR_PROVIDER:custom}
ocr.api.url=${OCR_API_URL:}
ocr.api.key=${OCR_API_KEY:}
ocr.api.secret=${OCR_API_SECRET:}
# 审批流(开启后文档上传/文章生成自动进入审批队列)
approval.auto-enabled=${APPROVAL_AUTO_ENABLED:false}
Milvus(可选,大规模语义检索): 部署 Milvus 后设置 milvus.enabled=true,并配置 milvus.host / milvus.port / embeddings.dimension=1536。
健康检查:
curl http://127.0.0.1:13085/api/auth/health
# 期望:Auth service is running
Docker(可选):
cd backend && mvn clean package -DskipTests
docker build -t knowledgebase:latest .
docker run -d -p 13085:8080 \\
-e SPRING_PROFILES_ACTIVE=prod \\
-e SPRING_DATASOURCE_URL='jdbc:mysql://host:3306/knowledgebase' \\
knowledgebase:latest
7.4 管理后台打包与部署
管理后台为 React SPA,生产环境挂载在 /knowledgeWeb 路径下。
构建:
cd frontend
npm install
npm run build
# 产物:frontend/build/(package.json 已配置 homepage=/knowledgeWeb)
部署静态资源:
# 将 build/ 同步至 Nginx 站点目录,例如:
sudo mkdir -p /etc/www/website/knowledgeWeb
sudo cp -r frontend/build/* /etc/www/website/knowledgeWeb/
sudo chown -R nginx:nginx /etc/www/website/knowledgeWeb
或使用项目脚本(需 root,目标路径见 deploy_frontend.sh):
sudo ./deploy_frontend.sh
Nginx 反代(核心片段):
location /knowledgeWeb/ {
alias /etc/www/website/knowledgeWeb/;
try_files $uri $uri/ /knowledgeWeb/index.html;
}
location /knowledgeWeb/api/ {
proxy_pass http://127.0.0.1:13085/api/;
proxy_set_header Host $host;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
}
完整示例见仓库 nginx.conf。配置变更后执行 nginx -t && systemctl reload nginx。
7.5 启动验证
|
后端存活 |
curl http://127.0.0.1:13085/api/auth/health |
返回 Auth service is running |
|
前端可访问 |
https://<域名>/knowledgeWeb/ |
出现登录页 |
|
登录鉴权 |
admin
/ xlh12345(生产默认) |
进入管理后台仪表盘 |
|
API 连通 |
浏览器 Network 中 /knowledgeWeb/api/ 请求 |
状态 200,非 HTML |
本地联调:
# 终端 1:后端(H2,8080)
cd backend && mvn spring-boot:run -Dspring-boot.run.profiles=local
# 终端 2:前端(3000,代理至 8080)
cd frontend && npm start
# 访问 http://localhost:3000/ ,账号 admin / admin123
7.7 自动化测试
|
后端 API 集成 |
Spring Boot Test |
cd backend && mvn test |
登录、文档、知识检索、问答、权限、管理接口 |
|
前后端 E2E |
Playwright |
cd e2e && npm install && npx playwright install chromium && npm test |
UI 页面、API 代理、上传、问答(默认 backend 8088 / frontend 3008,避免 8080 冲突) |
|
一键全量 |
Shell |
./scripts/run-integration-tests.sh |
先后端再 E2E |
本地 E2E 默认账号 admin / admin123;Playwright 会自动拉起 backend(local + H2,端口 8088)与 frontend(3008)。若本机 8080 已被其他程序占用,不影响 E2E。报告:e2e/playwright-report/index.html。
7.6 配置与运维
-
数据库: 生产用 database/init-production.sql;已有库升级执行 database/migrate-v1.2-security-audit.sql、database/migrate-v1.3-wechat-draft-sync.sql
-
AI: 问答 DEEPSEEK_API_KEY;向量 OPENAI_API_KEY(Embeddings);公众号写作 CODEPLAN_API_KEY;草稿同步 WECHAT_MP_*
-
向量检索:embeddings.enabled=true(默认);大规模建议 milvus.enabled=true 并部署 Milvus(见 application-prod.properties)
-
安全: 密钥走环境变量,全站 HTTPS
-
Docker(可选):backend/Dockerfile,mvn package 后 docker build
-
排障: 查端口、JDBC、CORS、出网;model is not supported 检查 CODEPLAN_MODEL;topic 需 VARCHAR(2000)
八、应用场景及使用案例说明
典型落地路径与效益参考,便于内部评审对齐预期。
8.1 企业案例(摘要)
技术公司(200+ 人): 按技术栈/项目分类入库 → 自然语言问规范(如 JWT 接入)→ 项目组权限隔离。效果:新人上手 2 周→3–5 天,重复咨询显著减少。
咨询公司(80+ 人): 按行业/业务类型建案例库 → 新项目输入需求,语义检索相似历史方案 → 顾问裁剪进标书。效果:项目准备约减半,方案一致性提升。
8.2 功能场景
日常问答: HR 制度、技术规范、客服 SOP——答案须引用已入库文档,不可替代官方资料。
部门权限:
|
普通员工 |
✅ 查看 |
❌ |
|
部门管理员 |
✅ 管理 |
❌ |
|
超级管理员 |
✅ 全部 |
✅ |
文档生命周期: 上传 → Tika 解析 → 分块 KnowledgeEntry → 绑定 departmentId。版本化、定时清理等为扩展能力,以仓库实际代码为准。
8.3 效益与建议
|
查技术文档 |
15–30 分钟 |
2–5 分钟 |
~80% |
|
业务流程咨询 |
20–40 分钟 |
3–8 分钟 |
~75% |
|
重复性问题 |
10–20 分钟/次 |
即时 |
~90% |
落地建议: 统一分类与命名;最小权限 + 定期审权限;问答后核对来源;按反馈持续补文档。
🚀 快速开始
体验访问
-
演示地址:https://www.qdzjkf.com/knowledgeWeb/
-
本地后台入口:http://localhost:3000/knowledgeWeb/(开发环境)
-
测试账号(与 database/init-production.sql 一致):
-
超级管理员:admin / xlh12345
-
部门管理员:manager / manager123
-
普通用户:user / user123
-
本地 H2 开发(local profile):admin / admin123
-