1. 前言
深入理解计算机系统(简称CSAPP)作为计算机领域的一本经典之作,它不仅教会我们知识,更重要的是能改变我们看待程序和系统的方式。
第二章信息的表示和处理详细描述了计算机如何将所有类型的信息都转化为最基础的二进制进行存储和操作,从 C 语言的视角,一点点地深入底层,带我们看清楚位、字节、整数、浮点数以及各种位级运算的真实面貌。
对我个人而言,我作为一个学生在接触本章之前,我觉得数字就是数字,字符就是字符,编程只需要关注逻辑。但读完这一章,我意识到每行代码背后都有一套精密的二进制机制,只去谈所谓的表层逻辑而不去关注底层原理,这可能会酿成大祸。
本文将作为我对 CSAPP 第二章的总结笔记,除了涵盖书中第二章的核心概念之外,还希望能通过我的理解和一些代码示例,帮助我自己和大家更好地掌握这些至关重要的知识。
2. 信息存储
计算机不像我们人类那样能直接认识数字 100 和字符 ‘A’ ,在计算机看来,所有的一切都是位 bit。
大多数计算机使用的都是 8 位的块,也就是字节 byte作为最小的可寻址内存单位,而程序将内存视为一个巨大的字节数组。
2.1 十六进制和字长
虽然计算机只认识 0 和 1,但如果让我们直接读写一长串二进制,这无疑是在折磨人,所以十六进制 便出现了。
我知道十六进制是非常基础的内容,但是为了内容的完整性和上下文的逻辑性,我还是简单介绍一下。
它用 0-9 和 A-F 来表示,十六进制数字的每一位 = 二进制数字的四位,这使得二进制和十六进制之间的转换非常直观,同时我们阅读十六进制的效率也是远高于二进制的。
另一个比较重要的概念是字长,它决定了指针数据的大小。
在 32 位机器上,指针是 4 字节。在 64 位机器上,指针是 8 字节。
无论在 32 位还是 64 位机器上,int 类型都是 4 字节。但 long 类型在 32 位机器上是 4 字节,在 64 位机器上是 8 字节。所以说,原则上在涉及到跨平台移植代码时一般是要谨慎使用 long 这种数据类型的。
2.2 寻址和字节顺序
不知道大家有没有想过,当一个对象跨越多个字节时,就拿int类型来说,它跨越了 4 个字节,这个对象在内存中的地址是什么?而这些字节在内存中又是怎么排列的呢?
这里有两种流派:
举个例子:
假设变量 x 的类型为 int,位于地址 0x100 处,其十六进制值为 0x01234567。
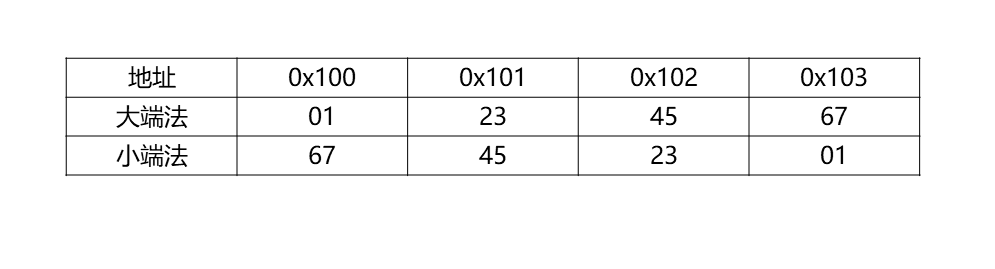
如上表,大小端分别在内存中的布局,可以看出,小端看起来在内存中是反的。
现在我们可以回答上面的问题了,一个对象在内存中的地址就是他所使用的字节中最小的那个地址,这些字节在内存中是连续排列的,具体布局要视情况而定,大端或者小端。
2.3 实践检验真理
书中最经典的一个例子就是通过 C 语言代码来打印对象的字节表示,这能让我们直观地看到小端法是如何工作的。上面提到我们使用的 PC 机大多都是采用的小端法。下面我们来看一下具体实现的核心原理:
我们需要使用强制类型转换,让编译器把一个 int 指针看作是一个 unsigned char 指针,这样当我们做指针加法或数组索引时,步长就从 4 字节变成了 1 字节,方便我们逐字节地观察数据。
代码如下:
#include <stdio.h>
typedef unsigned char *byte_pointer;
//打印从start位置开始的len个字节
void show_bytes(byte_pointer start, size_t len)
{
size_t i;
for (i = 0; i < len; i++)
{
printf(" %.2x", start[i]);//以至少两位16进制打印
}
printf("\\n");
}
void show_int(int x)
{
printf("Int %d (Hex: 0x%x) 的内存表示: \\t", x, x);
//将int*强转为unsigned char*
show_bytes((byte_pointer)&x, sizeof(int));
}
void show_float(float x)
{
printf("Float %f 的内存表示: \\t\\t", x);
show_bytes((byte_pointer)&x, sizeof(float));
}
void show_pointer(void *x)
{
printf("Pointer %p 的内存表示: \\t", x);
show_bytes((byte_pointer)&x, sizeof(void *));
}
int main()
{
int val = 12345; //十六进制是0x00003039
show_int(val);
//测试一下浮点数,看看它和整数有多大区别
float f_val = (float)val;
show_float(f_val);
//测试指针
show_pointer(&val);
return 0;
}
运行结果如下图:
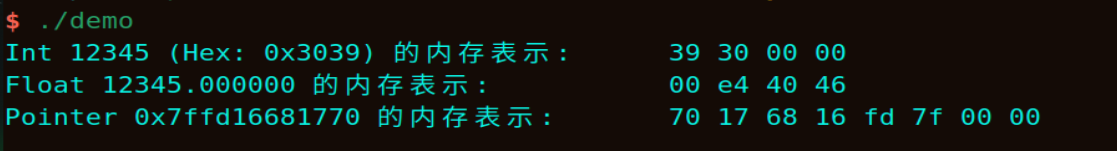
可以看到,内存布局正如我们上面描述的小端法的结果。
指针的大小是 8 个字节,对应我使用的是 64 位机器。
除此之外,浮点数 12345.0 的二进制表示00 e4 40 46和整数 12345 的二进制39 30 00 00完全不同,这里面的玄机我将会在后面的章节解释。
2.4 小结
这段代码最让我印象深刻的是 (byte_pointer)&x 这一句,在 C 语言中,指针的类型不仅仅告诉机器地址在哪里,更重要的是它告诉了机器看待数据的方式。比如对于 int * 一次看 4 个字节,并把它认为是一个整数。而对于 unsigned char * ,一次只看 1 个字节。这种通过改变指针类型来操作内存的技巧,在底层系统编程中非常常见,如果阅读过一些 Linux 内核源码,对这种操作会非常熟悉。
上面的运行结果中,初看 39 30 00 00 确实很别扭,因为这和我们书写 0x00003039 的习惯完全相反。
在硬件层面,小端法有它独特的优势:当处理器读取内存时,首先读到的是低位字节,如果进行加法运算,先处理低位是符合逻辑的,这样方便进位。
但是在网络编程中,网络协议(TCP/IP)通常采用大端法,也叫网络字节序。如果我们直接把一个 Intel 机器上的整数通过网络发送出去,接收方可能会收到一个完全错误的值。因此,在发送数据前,必须使用 htonl 等函数进行转换。
3. 整数表示
在数学中,整数是无限大的。但在计算机中,受限于位长(32 位或 64 位),我们能表示的整数范围是有限的。
计算机主要使用两种方式来编码整数:无符号编码和补码编码。
3.1 无符号数与补码
无符号编码 很好理解,没有符号位,所有的位都代表正的权重并且它只能表示非负数。
补码编码 是最常见的有符号数表示法,很多教科书教我们取反加一来计算负数,但这只是操作层面上的技巧。而 CSAPP 给出了更本质的数学解释:最高有效位(符号位)具有负权重。
对于一个 w 位的整数,最高位的权重是 – 2^(w-1),而其他位的权重仍然是正的。
这也解释了为什么补码范围是不对称的:
3.2 扩展与截断
当我们把一个较小的数据类型转换成较大的类型时,比如 short 转 int ,需要进行扩展。
零扩展比较好理解,这里我们举一个符号扩展的例子:比如 4 位的 -5 是 1011,扩展到 8 位,就要把最高位 1 复制填满,也就是1111 1011。
而截断则相对简单粗暴,直接丢弃高位,但这可能会导致数值发生剧烈变化,且无规则可循。
3.3 有符号与无符号的转换
在 C 语言中,当我们在有符号数和无符号数之间进行强制类型转换时,位模式保持不变,改变的是解释这些位的方式。
这听起来没问题,但如果表达式中同时存在有符号数和无符号数,C 语言会隐式地将有符号数强制转换为无符号数来进行计算,这会导致非常反直觉的结果。
请看下面代码:
#include <stdio.h>
int main()
{
int i = –1;
unsigned int u = 1;
//理论上-1 < 1
if(i < u)
{
printf("-1 < 1:正常\\n");
}
else
{
printf("-1 > 1:有点诡异\\n");
}
//让我们看看发生了什么
printf("int -1 的十六进制: 0x%x\\n", i);
printf("当 -1 被看作 unsigned 时: %u\\n", (unsigned)i);
return 0;
}
我们比较有符号数 i 和无符号数 u 的大小,按照正常人的思维逻辑,1 当然是大于 -1 的。但是这里同一个表达式中同时出现了有符号数和无符号数,有符号数就会被隐式转换为无符号数,从而导致了异常的结果。
请看下面运行结果:
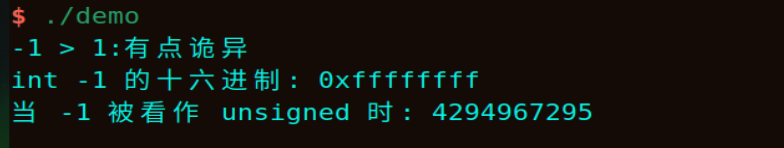
从运行结果可以看出,当int类型的数-1被编译器以unsigned解析时,结果是一个超大的正数。
在本小节的第一句话中,我加粗了一句话,位模式保持不变,改变的是解释这些位的方式。位模式不变其实就体现在这里,有兴趣的话可以试试将0xffffffff转换为十进制,看看是哪个数。
正是4294967295,位模式不变就是内存中的二进制数始终都保持那个样子,改变的是解释这些位的方式意思就是当编译器以int来解释这串二进制时,值为-1,而使用unsigned来解释时,值为4294967295。
现在看来,这个值当然要比 1 大得多。
3.4 小结
计算机使用补码并不是为了让人类看着舒服,毕竟我们其实很难读懂,而是为了硬件设计的统一。在补码体系下,加法运算不需要区分正数和负数,CPU 只需要一套加法器电路就能搞定所有整数加减法。
3.3 节的那个隐式转换是无数程序 bug 的源头,比如 for 循环中如果用 unsigned 变量做倒计时 for (unsigned i = 10; i >= 0; i–),这个循环永远不会停止,因为 unsigned 永远大于等于 0。
4. 整数运算
在数学中,两个正数相加,结果一定更大。但在计算机中,这不一定成立。
4.1 溢出
由于整数的位长是有限的,当计算结果超出了这个限制,就会发生溢出。
4.2 代码演示
我们通过代码来演示一下溢出的情况:
#include <stdio.h>
#include <limits.h>
int main()
{
//有符号数溢出
int i_max = INT_MAX; //值为2147483647
int i_next = i_max + 1;
printf("有符号数溢出测试:\\n");
printf("最大整数:%d\\n", i_max);
printf("最大整数 + 1 = %d\\n", i_next);
//无符号数溢出
unsigned int u_max = UINT_MAX; //值为4294967295
unsigned int u_next = u_max + 1;
printf("\\n无符号数溢出测试\\n");
printf("最大无符号数:%u\\n", u_max);
printf("最大无符号数 + 1 = %u\\n", u_next);
return 0;
}
INT_MAX和UINT_MAX两个宏定义在<limits.h>中,看名称就知道这两个宏的含义了,很好理解。
下面看看测试结果:

在 C 语言中,无符号溢出是标准定义的行为(模运算),程序员有时甚至会利用到这一特点。
但有符号溢出是未定义行为。虽然在我们的 PC 上它通常表现为环绕,但在某些特殊架构或激进的编译器优化下,程序可能会直接崩溃或产生不可预测的结果,这也是为什么很多安全漏洞都源于此。
5. 浮点数
CSAPP 第二章的最后一部分内容是浮点数。这是计算机表示实数(小数)的标准,即 IEEE 754。
5.1 浮点数表示并不完美
可能有不少人认为浮点数就是精确的小数,这是大错特错的,浮点数本质上是对实数的近似。
IEEE 754 将位分为三个部分:
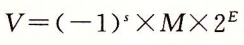
5.2 一个经典的坑
由于计算机是二进制的,像 0.1 这种在十进制里很简单的小数,在二进制里却是无限循环小数,就像十进制里的 1/3一样。由于尾数位数有限,计算机只能截断,这就导致了精度丢失。
请看如下测试代码:
#include <stdio.h>
int main()
{
float a = 0.1;
float b = 0.2;
float sum = a + b;
//理论上0.1 + 0.2应该等于0.3
if(sum == 0.3)
{
printf("没问题: 0.1 + 0.2 == 0.3\\n");
}
else
{
printf("暗藏玄机: 0.1 + 0.2 != 0.3\\n");
}
//看看值到底是多少
printf("sum 的实际值: %.10f\\n", sum);
return 0;
}
我们话不多说,直接看运行结果:
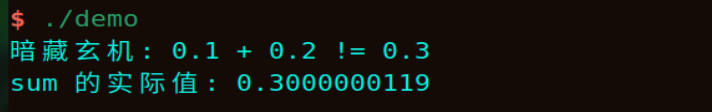
可以看到,即使是再简单不过的0.1和0.2相加,得到的结果也不是精确的,只是个近似值。
这个实验清楚地告诉我们:永远不要使用 == 来比较两个浮点数是否相等。
同时也解释了为什么浮点数运算不满足结合律,即 (a + b) + c 不一定等于 a + (b + c)。
6. 总结
读完第二章,我最大的一个感触是:抽象是有代价的。
高级语言为我们抽象出了整数和小数的概念,让我们不用去关心底层的位模式,但是我们又必须要注意一些额外的问题:比如警惕溢出和类型转换带来的 bug,跨平台通信时要注意大端和小端,还有浮点数的不精确性。
回顾整章,最核心的一句话依然是 CSAPP 第一章提到的:信息 = 位 + 上下文。
同样的二进制位 0x3039,如果是 int,它是 12345。如果是 float,它是一个极小的数。如果是机器指令,它可能是一条跳转命令。
我们必须时刻透过这层抽象,看到底层的本质,这样写出的代码才能更加健壮。
本文完。