系列篇章💥
| 1 | 【AI大模型前沿】深度剖析瑞智病理大模型 RuiPath:如何革新癌症病理诊断技术 |
| 2 | 【AI大模型前沿】清华大学 CLAMP-3:多模态技术引领音乐检索新潮流 |
| 3 | 【AI大模型前沿】浙大携手阿里推出HealthGPT:医学视觉语言大模型助力智能医疗新突破 |
| 4 | 【AI大模型前沿】阿里 QwQ-32B:320 亿参数推理大模型,性能比肩 DeepSeek-R1,免费开源 |
| 5 | 【AI大模型前沿】TRELLIS:微软、清华、中科大联合推出的高质量3D生成模型 |
| 6 | 【AI大模型前沿】Migician:清华、北大、华科联手打造的多图像定位大模型,一键解决安防监控与自动驾驶难题 |
| 7 | 【AI大模型前沿】DeepSeek-V3-0324:AI 模型的全面升级与技术突破 |
| 8 | 【AI大模型前沿】BioMedGPT-R1:清华联合水木分子打造的多模态生物医药大模型,开启智能研发新纪元 |
| 9 | 【AI大模型前沿】DiffRhythm:西北工业大学打造的10秒铸就完整歌曲的AI歌曲生成模型 |
| 10 | 【AI大模型前沿】R1-Omni:阿里开源全模态情感识别与强化学习的创新结合 |
| 11 | 【AI大模型前沿】Qwen2.5-Omni:阿里巴巴的多模态大模型,实现看、听、说、写一体化 |
| 12 | 【AI大模型前沿】SmolDocling:256M参数的轻量级多模态文档处理利器,10分钟搞定百页PDF |
| 13 | 【AI大模型前沿】Stable Virtual Camera:Stability AI 推出的2D图像转3D视频模型,一键生成沉浸式视频 |
| 14 | 【AI大模型前沿】阿里 Qwen3 震撼开源,模型新王诞生,开启全球大模型新纪元 |
| 15 | 【AI大模型前沿】InternVL:OpenGVLab开源多模态大模型,解锁视觉问答与多语言翻译的全能应用图鉴 |
| 16 | 【AI大模型前沿】Fin-R1:上海财经大学联合财跃星辰推出的金融推理大模型,凭7B参数拿下评测第二,离行业第一仅差3分 |
| 17 | 【AI大模型前沿】Med-R1:基于强化学习的医疗视觉语言模型,突破跨模态医学推理的普适性 |
| 18 | 【AI大模型前沿】Baichuan-M1-14B:百川智能推出专为医疗优化的开源大语言模型 |
| 19 | 【AI大模型前沿】一键生成宫崎骏动画风,EasyControl Ghibli 让照片秒变吉卜力艺术品 |
| 20 | 【AI大模型前沿】TxGemma:谷歌推出的高效药物研发大模型,临床试验预测准确率超90% |
| 21 | 【AI大模型前沿】F5R-TTS:腾讯推出TTS领域的新王者,又快又准又自然,零样本语音克隆新高度 |
| 22 | 【AI大模型前沿】MiniMind-V:低成本打造超小多模态视觉语言模型(仅需1.3元人民币和1小时) |
| 23 | 【AI大模型前沿】MoCha:端到端对话角色视频生成模型、电影级对话角色合成黑科技、重新定义动画创作 |
| 24 | 【AI大模型前沿】HuatuoGPT-o1-7B:中英文双语医学推理,打破语言障碍的AI大模型 |
| 25 | 【AI大模型前沿】MedReason:大规模医学推理数据集、借用知识图谱将大模型打造成“医术”专家 |
| 26 | 【AI大模型前沿】SkyReels-V2:昆仑万维开源的无限时长电影生成模型,开启视频生成新纪元 |
| 27 | 【AI大模型前沿】Dia:Nari Labs开源16亿参数TTS模型,只需文本输入,生成媲美真人对话的语音 |
| 28 | 【AI大模型前沿】阿里巴巴开源LHM:单图生成可动画3D人体模型,开启3D建模新纪元 |
| 29 | 【AI大模型前沿】TinyLLaVA-Video-R1:北航开源视频推理模型、小尺寸大智慧、参数少一半,性能翻一番 |
| 30 | 【AI大模型前沿】TTRL:测试时强化学习,开启无标签数据推理新篇章 |
| 31 | 【AI大模型前沿】Aero-1-Audio:Qwen2.5架构加持,轻量级音频模型天花板、吊打Whisper |
| 32 | 【AI大模型前沿】DianJin-R1:阿里云通义点金联合苏大推出的金融推理增强大模型 |
| 33 | 【AI大模型前沿】VITA-Audio:腾讯开源的高效语音交互多模态大语言模型 |
| 34 | 【AI大模型前沿】Multiverse:全球首个AI多人游戏世界模型,低成本高效率新突破 |
| 35 | 【AI大模型前沿】Seed1.5-VL:多模态理解的效率革新者,以小博大,性能惊艳 |
| 36 | 【AI大模型前沿】ViLAMP:蚂蚁集团和人民大学联手打造的长视频理解利器,单卡处理3小时视频 |
| 37 | 【AI大模型前沿】Muyan-TTS:开源零样本语音合成模型、0.33秒极速生成播客级语音、小白也能玩转AI配音 |
| 38 | 【AI大模型前沿】Dolphin:字节跳动开源文档解析大模型,轻量级、高效、多格式,开启文档处理新时代 |
| 39 | 【AI大模型前沿】ChatTS:字节跳动联合清华大学开源、多模态时序大模型助力时序数据对话与推理 |
| 40 | 【AI大模型前沿】Index-AniSora:B站开源的动漫视频生成模型,助力高效创作 |
| 41 | 【AI大模型前沿】RelightVid:上海 AI Lab联合复旦等高校推出的视频重照明模型 |
| 42 | 【AI大模型前沿】BAGEL:字节跳动开源、多模态大模型的创新突破与实践指南 |
| 43 | 【AI大模型前沿】Matrix-Game:昆仑万维开源大模型,一键生成你的专属虚拟世界 |
| 44 | 【AI大模型前沿】Pixel Reasoner:滑铁卢联合港科大等高校推出的视觉语言模型,助力视觉推理新突破 |
| 45 | 【AI大模型前沿】CoGenAV:多模态语音表征新范式、通义联合深技大打造、噪声环境WER降低70%+ |
| 46 | 【AI大模型前沿】Ming-Lite-Omni:蚂蚁集团开源的统一多模态大模型的创新实践 |
| 47 | 【AI大模型前沿】DeepEyes:小红书与西安交大联合打造的多模态深度思考模型 |
| 48 | 【AI大模型前沿】OmniAudio:阿里通义实验室的空间音频生成模型,开启沉浸式体验新时代 |
| 49 | 【AI大模型前沿】MiniCPM 4.0:面壁智能开源的极致高效端侧大模型(小版本、低消耗、220倍极致提速) |
| 50 | 【AI大模型前沿】SmolVLA:Hugging Face开源的轻量级视觉-语言-行动机器人模型 |
| 51 | 【AI大模型前沿】Time-R1:伊利诺伊大学香槟分校开源的时间推理语言模型、实现过去→未来全链路推演 |
| 52 | 【AI大模型前沿】MonkeyOCR:基于结构-识别-关系三元组范式的文档解析模型 |
| 53 | 【AI大模型前沿】GLM-4.5:智谱打造的开源SOTA模型,推理、代码与智能体能力融合先锋 |
| 54 | 【AI大模型前沿】百度飞桨PaddleOCR 3.0开源发布,支持多语言、手写体识别,赋能智能文档处理 |
| 55 | 【AI大模型前沿】Stream-Omni:多模态交互的“黄金三角”——视觉、语音、文本的完美融合 |
| 56 | 【AI大模型前沿】Vui:Fluxions-AI开源的轻量级语音对话模型,开启自然语音交互新时代 |
| 57 | 【AI大模型前沿】腾讯AI Lab开源的SongGeneration:音乐生成大模型的技术探索与实践 |
| 58 | 【AI大模型前沿】Osmosis-Structure-0.6B:小型语言模型在结构化信息提取中的突破 |
| 59 | 【AI大模型前沿】Kwai Keye-VL:颠覆认知!国产多模态大模型突然发布,视频理解能力堪比人类 |
| 60 | 【AI大模型前沿】Nanonets-OCR-s:从学术论文到法律合同,智能识别公式、签名、表格与图像 |
| 61 | 【AI大模型前沿】OmniAvatar:浙大联合阿里打造的音频驱动全身视频生成模型 |
| 62 | 【AI大模型前沿】DAMO GRAPE:阿里达摩院与浙江肿瘤医院联合打造的早期胃癌识别AI模型 |
| 63 | 【AI大模型前沿】阿里开源Lingshu:一个模型搞定12种医学影像诊断 |
| 64 | 【AI大模型前沿】原石科技MetaStone-S1:突破性反思型生成式大模型的技术解析与实践指南 |
| 65 | 【AI大模型前沿】清华实验室开源MOSS-TTSD:口语对话语音生成的突破 |
| 66 | 【AI大模型前沿】昆仑万维开源Skywork-R1V3:38B多模态推理模型,高考数学142分刷新开源SOTA |
| 67 | 【AI大模型前沿】Voxtral:Mistral AI开源的高性价比语音转录与理解模型 |
| 68 | 【AI大模型前沿】Goedel-Prover-V2:普林斯顿联合清华开源的定理证明模型,AI数学研究新里程碑 |
| 69 | 【AI大模型前沿】Seed-X:字节跳动开源的7B参数多语言翻译模型,挑战超大型模型性能 |
| 70 | 【AI大模型前沿】OpenReasoning-Nemotron:英伟达开源的推理利器,助力数学、科学与代码任务 |
| 71 | 【AI大模型前沿】阿里通义千问 Qwen3-Coder:开启智能代码生成与代理式编程新时代 |
| 72 | 【AI大模型前沿】Qwen3-SmVL:基于阿里通义千问3和SmolVLM拼接打造1 GB显存可跑的中文超小多模态大模型 |
| 73 | 【AI大模型前沿】通义万相Wan2.2:阿里270亿参数巨兽开源,消费级显卡就能跑,免费平替Sora上线 |
| 74 | 【AI大模型前沿】Higgs Audio V2杀疯:Boson AI开源语音大模型(克隆声音、同步BGM、低延迟对话一键搞定) |
| 75 | 【AI大模型前沿】腾讯混元3D世界生成模型HunyuanWorld-1.0:开启沉浸式3D内容创作新纪元 |
| 76 | 【AI大模型前沿】Intern-S1:上海AI Lab打造的科学多模态大模型,助力科研智能化 |
| 77 | 【AI大模型前沿】腾讯混元Dense模型:从智能座舱到客服机器人,用0.5B参数打穿全场景 |
| 78 | 【AI大模型前沿】Qwen-Image:免费开源、写段文案→直接出图→还能继续精修,全程不用PS |
| 79 | 【AI大模型前沿】小米开源MiDashengLM:语音、音乐、环境声一网打尽、智能座舱直接起飞 |
| 80 | 【AI大模型前沿】InternVL3.5:上海 AI Lab 开源多模态大模型、荣登多模态开源榜首 |
| 81 | 【AI大模型前沿】Qwen3-Max-Preview:阿里通义千问的万亿参数大模型,开启AI新纪元 |
| 82 | 【AI大模型前沿】dots.vlm1:小红书hi lab开源的高性能多模态大模型、免费可商用,图表推理直接封神 |
| 83 | 【AI大模型前沿】GLM-4.5V:智谱最新一代视觉推理模型,开源即巅峰,42项SOTA碾压全场,多模态一键秒杀 |
| 84 | 【AI大模型前沿】Jan-v1:基于阿里云Qwen3-4B-Thinking的高性能本地运行AI模型 |
| 85 | 【AI大模型前沿】KittenTTS:KittenML开源的轻量级文本转语音模型,离线部署与高效性能的完美结合 |
| 86 | 【AI大模型前沿】Baichuan-M2:百川智能开源医疗增强大模型,助力医疗智能化转型 |
| 87 | 【AI大模型前沿】MiroThinker:基于Qwen3构建的开源Agent模型系列,助力复杂任务解决 |
| 88 | 【AI大模型前沿】DINOv3:Meta开源的自监督视觉模型,卫星/医疗/自拍全通杀,性能吊打CLIP全家桶 |
| 89 | 【AI大模型前沿】VibeVoice:微软开源7B模型,跨语言、多说话人、长文本一次到位 |
| 90 | 【AI大模型前沿】Waver 1.0:字节跳动推出的AI视频生成模型,支持文本/图像到高清视频的创作 |
| 91 | 【AI大模型前沿】MobileCLIP2:苹果开发端侧大模型,让手机秒变AI神器、拍照就能写文案、搜图片零误差 |
| 92 | 【AI大模型前沿】MiniCPM-V 4.5:OpenBMB推出的高性能端侧多模态大模型 |
| 93 | 【AI大模型前沿】Step-Audio 2 mini:阶跃星辰开源的端到端语音大模型,听得清楚、想得明白、说得自然 |
| 94 | 【AI大模型前沿】HunyuanWorld-Voyager:腾讯开源的超长漫游世界模型,开启3D场景生成新纪元 |
| 95 | 【AI大模型前沿】EmbeddingGemma:谷歌开源的移动端优先文本嵌入模型,200MB 内存搞定 100 种语言 RAG,性能翻倍 |
| 96 | 【AI大模型前沿】Apertus:瑞士首个开源大模型,多语言支持,合规训练,高效性能 |
| 97 | 【AI大模型前沿】OneCAT:美团联合上交大推出的纯解码器多模态模型 |
| 98 | 【AI大模型前沿】MiniCPM4.1:面壁智能重磅开源,128K长文本推理秒级响应,端侧性能狂飙7倍 |
| 99 | 【AI大模型前沿】VoxCPM:OpenBMB 推出的无分词器 TTS 模型,实现上下文感知语音生成与逼真语音克隆 |
| 100 | 【AI大模型前沿】IBM Granite-Docling-258M:开源企业级文档 AI 模型的创新与应用 |
| 101 | 【AI大模型前沿】小红书开源FireRedTTS-2:突破性多说话人长对话语音生成系统完全解析 |
| 102 | 【AI大模型前沿】PP-OCRv5:百度飞桨的高效多语言文字识别利器,0.07 亿参数狂飙 370 字/秒,支持 40+ 语种 |
| 103 | 【AI大模型前沿】小米AI实验室发布ZipVoice系列语音合成模型,重塑语音交互体验 |
| 104 | 【AI大模型前沿】IndexTTS2:B站开源的零样本语音合成模型,实现情感与时长精准控制 |
| 105 | 【AI大模型前沿】Ling-V2:蚂蚁百灵团队打造的高效智能语言模型 |
| 106 | 【AI大模型前沿】腾讯ARC开源AudioStory:大语言模型驱动的长篇叙事音频生成技术 |
| 107 | 【AI大模型前沿】Mini-o3:字节跳动联合港大推出的开源视觉推理模型 |
| 108 | 【AI大模型前沿】InternVLA-N1:上海 AI Lab 开源的端到端双系统导航大模型 |
| 109 | 【AI大模型前沿】InternVLA-A1:上海AI实验室开源的具身操作大模型,助力机器人实现理解、想象与执行一体化 |
| 110 | 【AI大模型前沿】深度解析DeepSeek-R1-Safe:华为与浙大合作的安全大模型 |
| 111 | 【AI大模型前沿】小米开源语音大模型 Xiaomi-MiMo-Audio:开启语音领域的“LLaMA时刻” |
| 112 | 【AI大模型前沿】百度Qianfan-VL:企业级多模态大模型的领域增强解决方案,OCR、数学、图表一把抓 |
| 113 | 【AI大模型前沿】Qwen3Guard:阿里云通义千问团队推出的安全防护模型 |
| 114 | 【AI大模型前沿】Qwen3-VL:阿里云通义千问的多模态视觉语言模型,开启智能交互新纪元 |
| 115 | 【AI大模型前沿】Qwen3-Omni:阿里巴巴通义千问团队引领全模态大模型新突破 |
| 116 | 【AI大模型前沿】Qwen3-TTS-Flash:阿里通义的多语言多音色语音合成利器 |
| 117 | 【AI大模型前沿】FLM-Audio:智源研究院开源的全双工音频对话大模型,开启自然流畅语音交互新时代 |
| 118 | 【AI大模型前沿】DeepSeek-V3.2-Exp:基于稀疏注意力机制的高效长文本处理大模型 |
| 119 | 【AI大模型前沿】智谱GLM-4.6:355B参数的旗舰级AI模型,代码能力与推理性能全面升级 |
| 120 | 【AI大模型前沿】Logics-Parsing:阿里巴巴开源的端到端文档解析模型 |
| 121 | 【AI大模型前沿】Ming-UniAudio:蚂蚁集团开源的多功能统一语音大模型 |
| 122 | 【AI大模型前沿】Ling-1T:蚂蚁集团开源万亿参数的高效推理非思考模型 |
| 123 | 【AI大模型前沿】微软UserLM-8b:AI助手的“逼真陪练”,多轮对话精炼利器 |
| 124 | 【AI大模型前沿】NeuTTS Air:Neuphonic打造的超拟真离线语音合成模型 |
| 125 | 【AI大模型前沿】Youtu-Embedding:腾讯优图开源的高性能通用文本表示模型 |
| 126 | 【AI大模型前沿】UniPixel:香港理工大学联合腾讯推出的像素级多模态大模型 |
| 127 | 【AI大模型前沿】SongBloom:腾讯AI Lab开源的全长度歌曲生成模型 |
| 128 | 【AI大模型前沿】SAIL-VL2:字节跳动开源的“小而强”视觉语言模型,2B参数也能吊打大模型 |
| 129 | 【AI大模型前沿】PaddleOCR-VL:百度0.9B超轻量级文档解析利器,多语言多模态功能强大 |
| 130 | 【AI大模型前沿】HunyuanWorld-Mirror:腾讯开源的多功能3D重建大模型 |
| 131 | 【AI大模型前沿】DeepSeek-OCR:开启OCR 2.0时代,用视觉压缩技术革新文档处理 |
| 132 | 【AI大模型前沿】FIBO:首个开源原生支持JSON的文本生成图像模型 |
| 133 | 【AI大模型前沿】SoulX-Podcast:多语言、多方言、多说话人的语音合成新突破 |
| 134 | 【AI大模型前沿】美团 LongCat-Flash-Omni:低延迟音视频交互的全模态大模型 |
| 135 | 【AI大模型前沿】Ouro:字节跳动Seed团队推出的循环语言模型,开启推理新纪元 |
| 136 | 【AI大模型前沿】UniWorld:基于强化学习的图像编辑大模型技术解析与应用探索 |
| 137 | 【AI大模型前沿】FG-CLIP:360推出的双语细粒度视觉语言对齐模型,助力多模态理解新突破 |
| 138 | 【AI大模型前沿】Maya1:Maya Research开源的语音合成模型,让AI声音充满情感 |
| 139 | 【AI大模型前沿】Step-Audio-EditX:全球首个开源LLM音频编辑大模型,开启音频创作新纪元 |
| 140 | 【AI大模型前沿】OmniVinci:NVIDIA全模态大模型,语音、图像、视频全搞定的六边形战士 |
| 141 | 【AI大模型前沿】Open-o3-Video:北大联合字节开源的时空推理视频模型 |
| 142 | 【AI大模型前沿】SenseNova-SI:商汤开源的空间智能大模型,性能超越GPT-5 |
| 143 | 【AI大模型前沿】ERNIE 4.5:百度文心大模型的多模态技术革新与应用实践 |
| 144 | 【AI大模型前沿】腾讯KaLM-Embedding:高性能多语言文本嵌入模型的创新与实践 |
| 145 | 【AI大模型前沿】Bee:腾讯混元与清华联合开源的全栈多模态大模型创新项目 |
| 146 | 【AI大模型前沿】InfinityStar:字节跳动推出的高效视频生成模型,开启视频创作新纪元 |
| 147 | 【AI大模型前沿】Meta SAM 3D:从单图到3D世界的神奇钥匙 |
| 148 | 【AI大模型前沿】Meta SAM 3:基于概念提示的图像与视频分割模型 |
| 149 | 【AI大模型前沿】腾讯 HunyuanVideo-1.5:用消费级显卡解锁高清视频生成的无限可能 |
| 150 | 【AI大模型前沿】Olmo 3:开源时代的 AI 定制先锋,打造专属智能模型 |
| 151 | 【AI大模型前沿】Fara-7B:微软打造的高效计算机操作代理模型,开启智能办公新时代 |
| 152 | 【AI大模型前沿】HunyuanOCR:腾讯混元推出的高效端到端OCR视觉语言模型 |
| 153 | 【AI大模型前沿】Z-Image:阿里通义的图像生成“魔法棒”,低资源设备也能玩转高清图像 |
| 154 | 【AI大模型前沿】Depth Anything 3:字节跳动推出的高效视觉空间重建模型 |
| 155 | 【AI大模型前沿】DeepSeek-Math-V2:数学推理的“智能助手”,从定理证明到竞赛夺冠 |
| 156 | 【AI大模型前沿】GLM-ASR:智谱开源的高性能语音识别模型 |
| 157 | 【AI大模型前沿】GLM-TTS:智谱AI打造的可控情感零样本文本转语音模型 |
| 158 | 【AI大模型前沿】GLM-4.6V:智谱多模态大模型的创新突破与应用实践 |
| 159 | 【AI大模型前沿】GLM-4.7:智谱AI的旗舰大模型,开启智能编程新时代 |
| 160 | 【AI大模型前沿】StepAudio R1:首个解锁音频推理能力的开源大模型 |
| 161 | 【AI大模型前沿】GELab-Zero:阶跃开源的4B端侧多模态GUI Agent模型,助力本地可控的移动设备智能化 |
| 162 | 【AI大模型前沿】Vidi2:由字节跳动开源的多模态视频理解与生成大模型 |
| 163 | 【AI大模型前沿】Mistral 3:欧洲开源力量的AI力作,多模态与高性能的完美融合 |
| 164 | 【AI大模型前沿】NewBie-image-Exp0.1:NewBieAI实验室打造的高效动漫图像生成模型 |
| 165 | 【AI大模型前沿】LongCat-Image:美团开源的高效图像生成与编辑模型 |
目录
- 系列篇章💥
- 前言
- 一、项目概述
- 二、核心功能
-
- (一)文生图(Text-to-Image)
- (二)图像编辑(Image Editing)
- (三)中文文字渲染
- (四)真实感与纹理细节提升
- 三、技术揭秘
-
- (一)架构设计
- (二)渐进式学习策略
- (三)数据工程与训练范式
- (四)中文文字生成优化
- 四、基准评测
-
- (一)图像编辑基准测试
- (二)中文文本渲染专项评测
- (三)文生图基础能力测试
- 五、应用场景
-
- (一)海报设计与广告创作
- (二)教学辅助
- (三)艺术创作与设计
- (四)社交媒体与营销
- (五)个性化图像处理
- 六、快速使用
-
- (一)环境准备
- (二)模型下载
- (三)运行文生图生成
- (四)运行图像编辑
- 七、结语
- 项目地址
前言
在人工智能技术飞速发展的今天,图像生成与编辑领域不断涌现出新的技术和模型。美团开源的LongCat-Image模型以其卓越的性能和强大的功能,为这一领域带来了新的突破。它专注于提升文生图和图像编辑的效率与质量,同时在中文文字渲染方面表现出色,为中文场景下的图像生成与编辑提供了有力支持。 
一、项目概述
LongCat-Image是由美团开源的高性能图像生成与编辑模型,仅用6B参数在文生图和图像编辑上达到开源顶尖水平。该模型采用创新架构和训练策略,支持高质量中文文字渲染,覆盖8105个汉字,适用于海报、广告等设计场景。它通过多任务学习和对抗训练,提升图像真实感与纹理细节,为开发者提供从预训练到微调的完整工具链,助力低门槛探索视觉生成的更多可能。 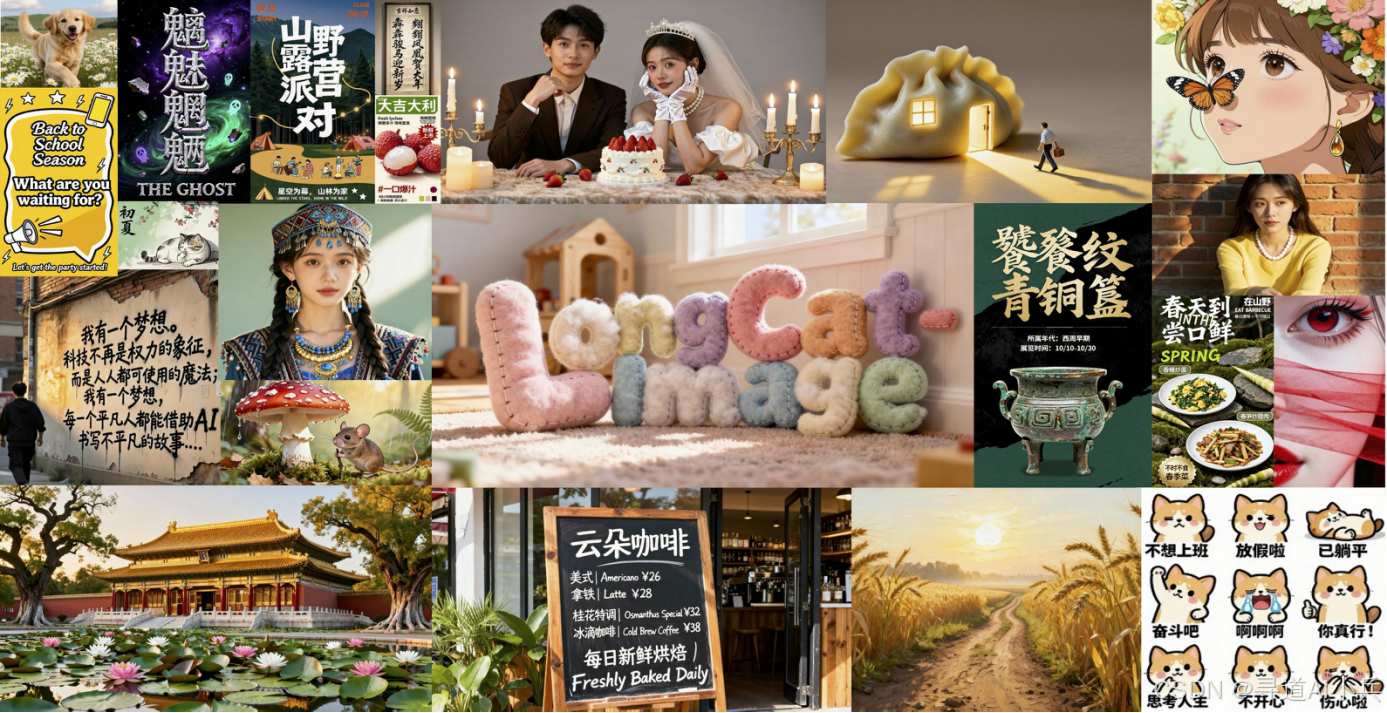
二、核心功能
(一)文生图(Text-to-Image)
LongCat-Image能够根据用户输入的文本描述生成高质量图像,支持多种风格和场景。无论是创意设计、社交媒体内容创作还是影视概念图生成,都能满足用户的需求。
(二)图像编辑(Image Editing)
该模型提供强大的图像编辑能力,支持风格迁移、属性编辑、构图调整等。它能够根据用户指令精准修改图像内容,在设计、广告、影视后期等领域具有广泛的应用前景。
(三)中文文字渲染
LongCat-Image特别优化了中文文字生成能力,覆盖通用规范汉字表的8105个汉字,支持复杂笔画和生僻字渲染。这使得它在海报设计、招牌制作、古诗词插图等场景中表现出色。
(四)真实感与纹理细节提升
通过系统性的数据筛选和对抗训练,LongCat-Image生成的图像具有更高的真实感和纹理细节,避免了“塑料感”纹理。
三、技术揭秘
(一)架构设计
LongCat-Image采用文生图与图像编辑同源的架构设计,通过紧凑的6B参数规模实现高效协同提升,兼顾指令遵循精准度、生图质量和文字渲染能力。
(二)渐进式学习策略
模型训练采用渐进式学习策略,包括预训练阶段、SFT阶段和RL阶段。预训练阶段使用多源数据和指令改写策略,提升模型对多样化指令的理解能力;SFT阶段引入人工精标数据,进一步提升指令遵循精准度和泛化性;RL阶段融入OCR与美学双奖励模型,优化文本准确性和背景融合自然度。
(三)数据工程与训练范式
LongCat-Image通过严格的预训练数据筛选,避免生成图像的“塑料感”纹理。在SFT阶段采用人工精筛数据对齐大众审美,提升生成图像的真实感和美感。创新性地引入AIGC内容检测器作为奖励模型,利用对抗信号引导模型学习真实世界的物理纹理和光影效果。
(四)中文文字生成优化
使用课程学习策略,预训练阶段学习字形,覆盖通用规范汉字表的8105个汉字;SFT阶段引入真实世界文本图像数据,提升字体和排版布局的泛化能力;RL阶段进一步提升文本准确性和背景融合自然度。
四、基准评测
(一)图像编辑基准测试
LongCat-Image在图像编辑基准测试GEdit-Bench和ImgEdit-Bench中表现优异,分别获得7.60/7.64(中英文)和4.50的高分,达到开源模型中的领先(SOTA)水平。 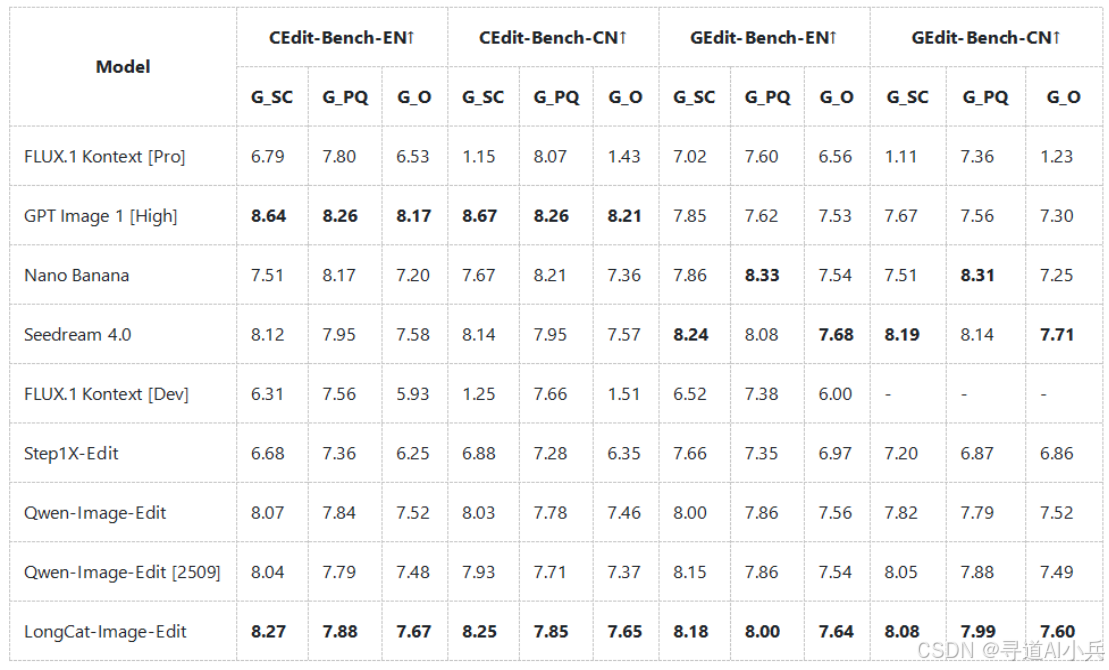
(二)中文文本渲染专项评测
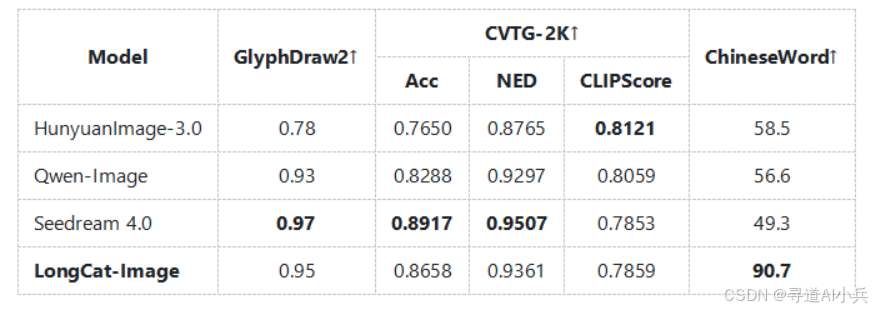
在中文文本渲染专项评测ChineseWord中,LongCat-Image得分为90.7分,显示出其在中文文字生成方面的强大能力。
(三)文生图基础能力测试
在文生图基础能力测试GenEval和DPG-Bench中,LongCat-Image分别获得0.87和86.8的高分,展现了其在文生图任务中的优秀性能。 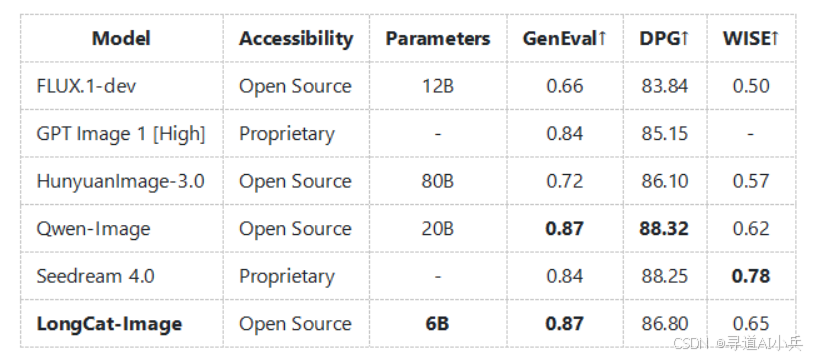
五、应用场景
(一)海报设计与广告创作
LongCat-Image能够根据文案快速生成高质量海报和广告图,支持中文文字渲染和风格定制,满足广告、活动宣传等需求。例如,输入创意文案后,模型可生成具有特定风格的海报,设计师可在此基础上进行微调,大大节省设计时间。
(二)教学辅助
该模型可以生成与教学内容相关的图像,如历史场景、科学实验图示等,帮助学生更好地理解和记忆知识。例如,在讲解古代历史事件时,生成相关场景图,让学生更直观地感受历史情境。
(三)艺术创作与设计
LongCat-Image为艺术家和设计师提供创意生成和图像编辑工具,助力他们实现更多的创意和设计。例如,艺术家可输入创意描述,生成初步设计图,再进行个性化调整,激发更多灵感。
(四)社交媒体与营销
快速生成社交媒体内容和营销素材,提升内容创作的效率和质量。例如,为社交媒体账号生成个性化的图片内容,吸引更多用户关注。
(五)个性化图像处理
对个人照片进行风格转换、背景替换、人物美化等编辑,满足用户的个性化需求。例如,用户可将普通照片转换为复古风格,或替换背景为海边日落,提升照片的趣味性和美观度。
六、快速使用
(一)环境准备
1、克隆仓库
git clone –single-branch –branch main https://github.com/meituan-longcat/LongCat-Image
cd LongCat-Image
2、安装依赖
# create conda environment
conda create -n longcat-image python=3.10
conda activate longcat-image
# install other requirements
pip install -r requirements.txt
python setup.py develop
(二)模型下载
使用huggingface-cli下载模型:
pip install "huggingface_hub[cli]"
huggingface-cli download meituan-longcat/LongCat-Image –local-dir ./weights/LongCat-Image
huggingface-cli download meituan-longcat/LongCat-Image-Dev –local-dir ./weights/LongCat-Image-Dev
huggingface-cli download meituan-longcat/LongCat-Image-Edit –local-dir ./weights/LongCat-Image-Edit
(三)运行文生图生成
import torch
from transformers import AutoProcessor
from longcat_image.models import LongCatImageTransformer2DModel
from longcat_image.pipelines import LongCatImagePipeline
device = torch.device('cuda')
checkpoint_dir = './weights/LongCat-Image'
text_processor = AutoProcessor.from_pretrained( checkpoint_dir, subfolder = 'tokenizer' )
transformer = LongCatImageTransformer2DModel.from_pretrained( checkpoint_dir , subfolder = 'transformer',
torch_dtype=torch.bfloat16, use_safetensors=True).to(device)
pipe = LongCatImagePipeline.from_pretrained(
checkpoint_dir,
transformer=transformer,
text_processor=text_processor,
torch_dtype=torch.bfloat16
)
# pipe.to(device, torch.bfloat16) # Uncomment for high VRAM devices (Faster inference)
pipe.enable_model_cpu_offload() # Offload to CPU to save VRAM (Required ~17 GB); slower but prevents OOM
prompt = '一个年轻的亚裔女性,身穿黄色针织衫,搭配白色项链。她的双手放在膝盖上,表情恬静。背景是一堵粗糙的砖墙,午后的阳光温暖地洒在她身上,营造出一种宁静而温馨的氛围。镜头采用中距离视角,突出她的神态和服饰的细节。光线柔和地打在她的脸上,强调她的五官和饰品的质感,增加画面的层次感与亲和力。整个画面构图简洁,砖墙的纹理与阳光的光影效果相得益彰,突显出人物的优雅与从容。'
image = pipe(
prompt,
height=768,
width=1344,
guidance_scale=4.5,
num_inference_steps=50,
num_images_per_prompt=1,
generator=torch.Generator("cpu").manual_seed(43),
enable_cfg_renorm=True,
enable_prompt_rewrite=True # Reusing the text encoder as a built-in prompt rewriter
).images[0]
image.save('./t2i_example.png')
(四)运行图像编辑
import torch
from PIL import Image
from transformers import AutoProcessor
from longcat_image.models import LongCatImageTransformer2DModel
from longcat_image.pipelines import LongCatImageEditPipeline
device = torch.device('cuda')
checkpoint_dir = './weights/LongCat-Image-Edit'
text_processor = AutoProcessor.from_pretrained( checkpoint_dir, subfolder = 'tokenizer' )
transformer = LongCatImageTransformer2DModel.from_pretrained( checkpoint_dir , subfolder = 'transformer',
torch_dtype=torch.bfloat16, use_safetensors=True).to(device)
pipe = LongCatImageEditPipeline.from_pretrained(
checkpoint_dir,
transformer=transformer,
text_processor=text_processor,
torch_dtype=torch.bfloat16
)
# pipe.to(device, torch.bfloat16) # Uncomment for high VRAM devices (Faster inference)
pipe.enable_model_cpu_offload() # Offload to CPU to save VRAM (Required ~19 GB); slower but prevents OOM
generator = torch.Generator("cpu").manual_seed(43)
img = Image.open('assets/test.png').convert('RGB')
prompt = '将猫变成狗'
image = pipe(
img,
prompt,
negative_prompt='',
guidance_scale=4.5,
num_inference_steps=50,
num_images_per_prompt=1,
generator=generator
).images[0]
image.save('./edit_example.png')
七、结语
LongCat-Image作为美团开源的高性能图像生成与编辑模型,凭借其创新的技术架构和卓越的性能表现,在图像生成与编辑领域展现了巨大的潜力和应用价值。它不仅为开发者提供了低门槛的开发工具链,还为中文场景下的图像生成与编辑提供了有力支持。相信随着技术的不断发展和完善,LongCat-Image将在更多领域发挥重要作用,推动图像生成与编辑技术的发展。
项目地址
- GitHub仓库:https://github.com/meituan-longcat/LongCat-Image
- HuggingFace模型库:https://huggingface.co/meituan-longcat/LongCat-Image
- 技术论文:https://github.com/meituan-longcat/LongCat-Image/blob/main/assets/LongCat_Image_Technical_Report.pdf
🎯🔖更多专栏系列文章:AI大模型提示工程完全指南、AI大模型探索之路(零基础入门)、AI大模型预训练微调进阶、AI大模型开源精选实践、AI大模型RAG应用探索实践🔥🔥🔥 其他专栏可以查看博客主页📑
😎 作者介绍:资深程序老猿,从业10年+、互联网系统架构师,目前专注于AIGC的探索(CSDN博客之星|AIGC领域优质创作者) 📖专属社群:欢迎关注【小兵的AI视界】公众号或扫描下方👇二维码,回复‘入群’ 即刻上车,获取邀请链接。 💘领取三大专属福利:1️⃣免费赠送AI+编程📚500本,2️⃣AI技术教程副业资料1套,3️⃣DeepSeek资料教程1套🔥(限前500人) 如果文章内容对您有所触动,别忘了点赞、⭐关注,收藏!加入我们,一起携手同行AI的探索之旅,开启智能时代的大门!