目录
前言
今日完结任务
今日核心知识点总结
1. 点赞功能的设计
2. 共同关注
3. Feed流实现方案
4. Feed流滚动分页(ZSet实现)
遇到的问题
问题:数据库IN查询后顺序问题
今日实战收获
业务实现流程梳理
1. 点赞功能
2. 点赞排行榜
3. 关注与共同关注
4. Feed流推送与滚动分页
小知识点总结(源自个人笔记.pdf)
总结
前言
本篇笔记聚焦于黑马点评项目的社交互动模块,主要包括达人探店笔记的发布与查看、点赞功能、关注功能以及Feed流。这些功能构成了一个社区的核心交互,其中涉及到的技术点如Set集合的运用、SortedSet实现点赞排行榜、共同关注、Feed流的推拉模式以及滚动分页等,都是构建社交功能的关键。通过本模块的实战,我理解了如何利用Redis高效实现社交关系和数据推送。
今日完结任务
达人探店笔记的发布与查看:实现博客的发布和详情查看。
点赞功能:实现同一个用户只能点赞一次,再次点击则取消点赞,并展示当前用户是否点赞。
点赞排行榜:基于发布时间排序,改为按照点赞时间排序,并展示前5名点赞用户。
关注与共同关注:实现关注和取消关注,并能够查询当前用户与目标用户的共同关注。
Feed流实现关注推送:采用推模式,在用户发布博客时,将博客id推送到其所有粉丝的收件箱(SortedSet)。
Feed流的滚动分页:实现Feed流的滚动分页查询,避免传统分页在数据更新时出现重复或缺失的问题。
今日核心知识点总结
1. 点赞功能的设计
需求:同一个用户只能点赞一次,再次点击则取消点赞。
方案:
-
使用Redis的Set集合去重存储点赞用户id,Key为blog:liked:{blogId}。
-
点赞:SADD key userId
-
取消点赞:SREM key userId
-
判断用户是否点赞:SISMEMBER key userId
-
获取点赞总数:SCARD key
优化(点赞排行榜):
-
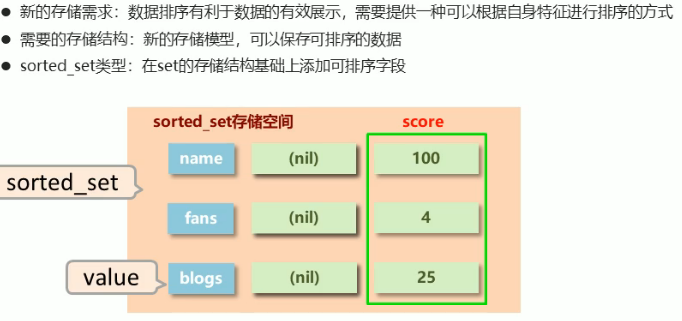
使用SortedSet(ZSet)替代Set,Value为用户id,Score为点赞时间戳。
-
点赞:ZADD key score userId
-
取消点赞:ZREM key userId
-
获取点赞排行榜前5:ZRANGE key 0 4(按时间戳倒序需使用ZREVRANGE)
2. 共同关注
需求:查询当前用户与目标用户的共同关注。
方案:
-
每个用户维护一个关注集合,Key为follows:{userId},存储关注的用户id。
-
使用Set的交集运算:SINTER follows:{userId1} follows:{userId2}
-
将交集结果解析为用户id,查询用户信息返回。
3. Feed流实现方案
Feed流模式:
|
|
拉模式 |
推模式 |
推拉结合 |
|
写比例 |
低 |
高 |
中 |
|
读比例 |
高 |
低 |
中 |
|
用户读取延迟 |
高 |
低 |
低 |
|
实现难度 |
复杂 |
简单 |
很复杂 |
|
使用场景 |
很少使用 |
用户量少、没有大V |
过千万的用户量,有大V |
-
拉模式(读扩散):用户读取时,去查询关注的所有人的动态,然后合并排序。
-
优点:节省存储空间;
-
缺点:读取时延大,且可能给数据库带来压力。
-
-
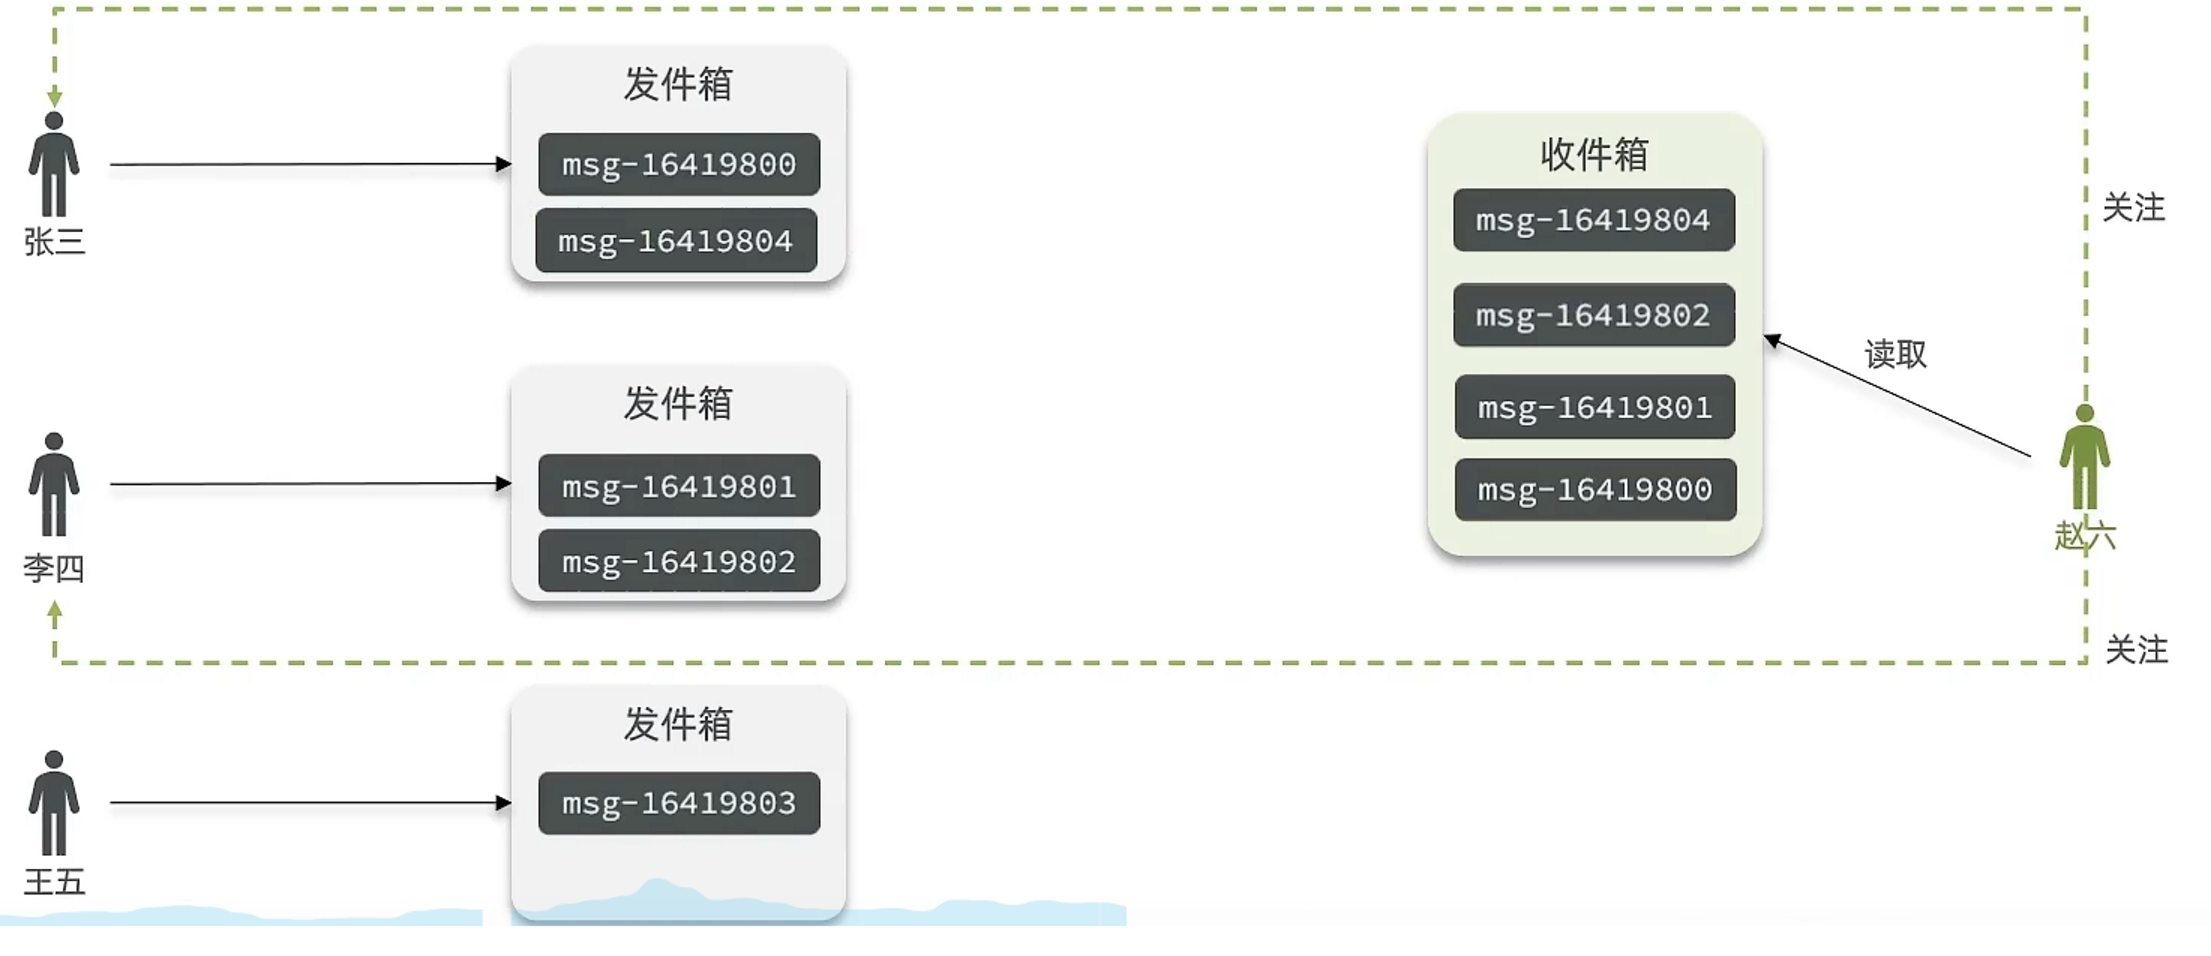
推模式(写扩散):用户发布动态时,将动态推送到所有粉丝的收件箱中。
-
优点:读取速度快;
-
缺点:存储空间大,且大V发布时推送压力大。

-
-
推拉结合:普通用户采用推模式,大V用户采用拉模式,折中方案。
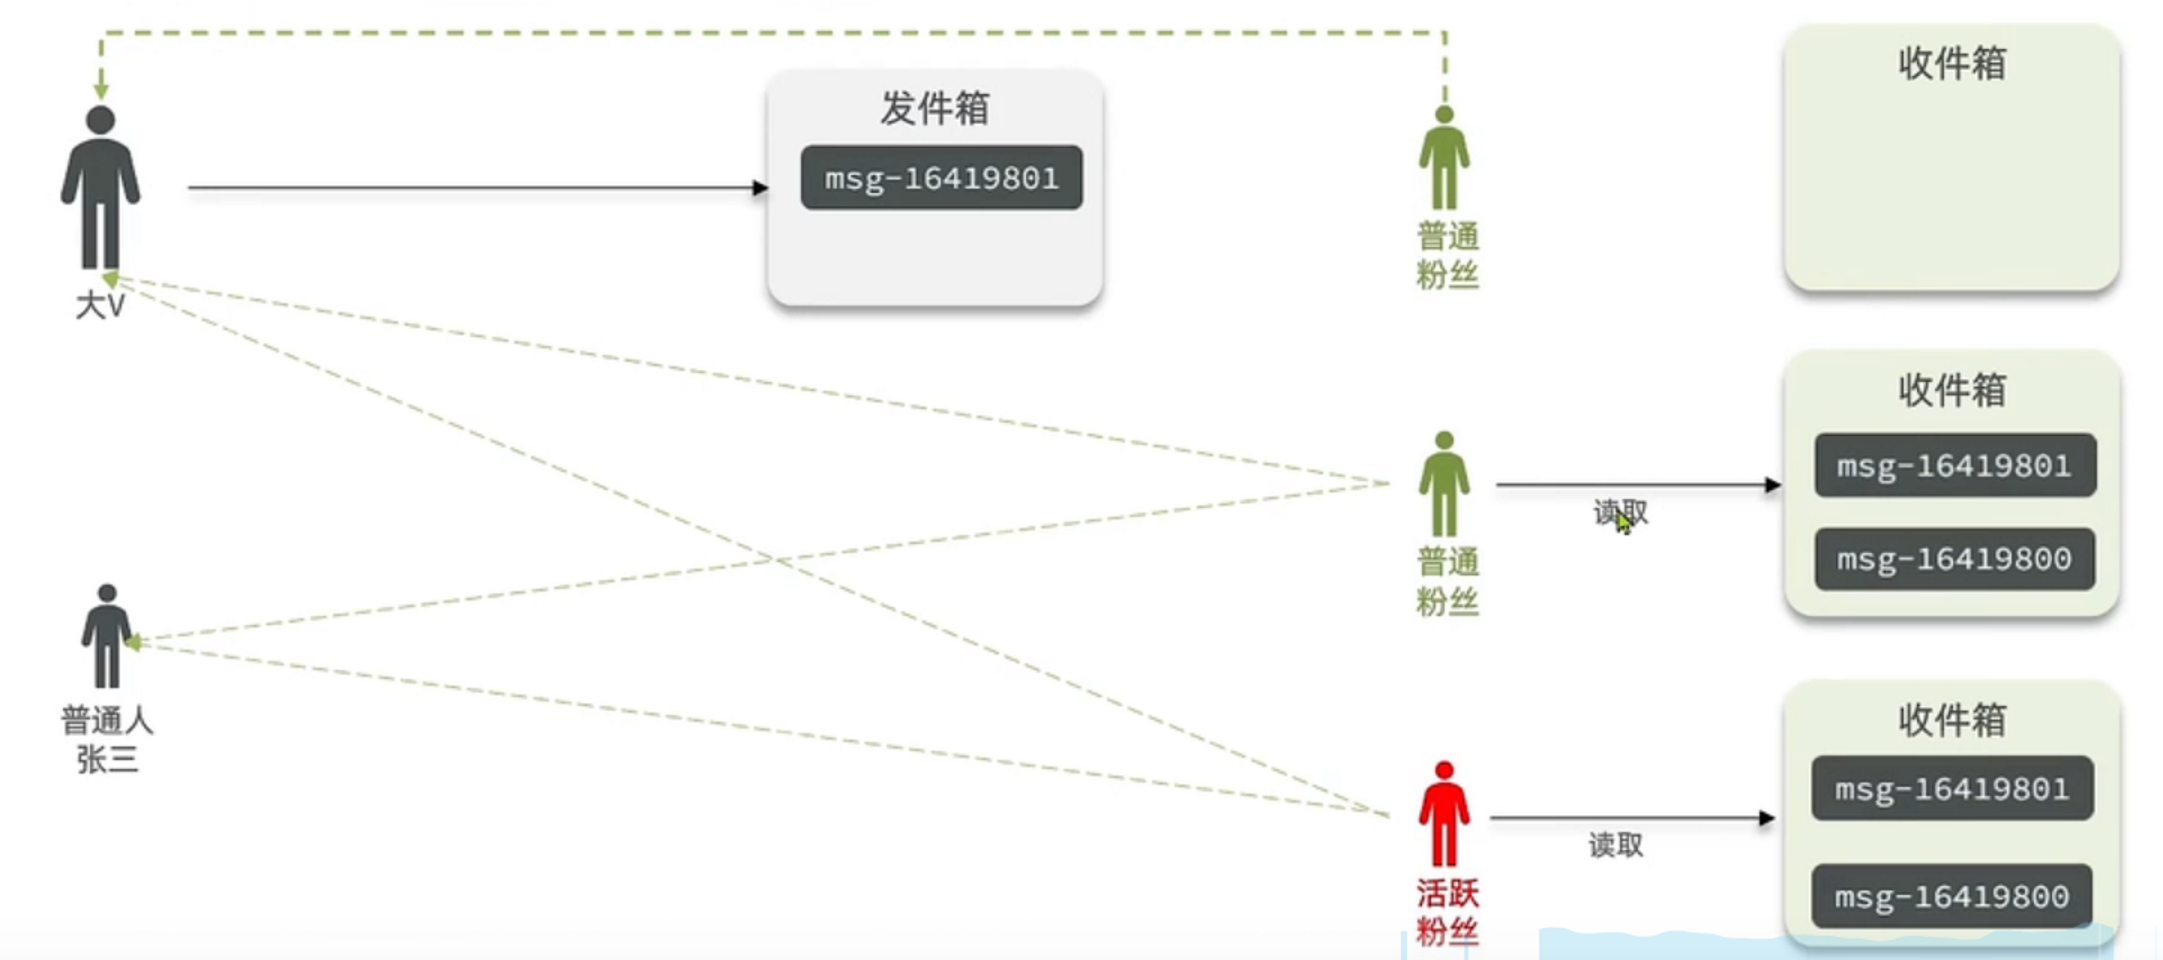
本项目采用推模式:
-
每个用户维护一个收件箱(SortedSet),Key为feed:{userId},Score为发布时间戳,Value为博客id。
-
发布博客时,查询粉丝列表,将博客id写入每个粉丝的收件箱。
-
读取Feed流时,直接从自己的收件箱中按时间倒序分页查询。
4. Feed流滚动分页(ZSet实现)
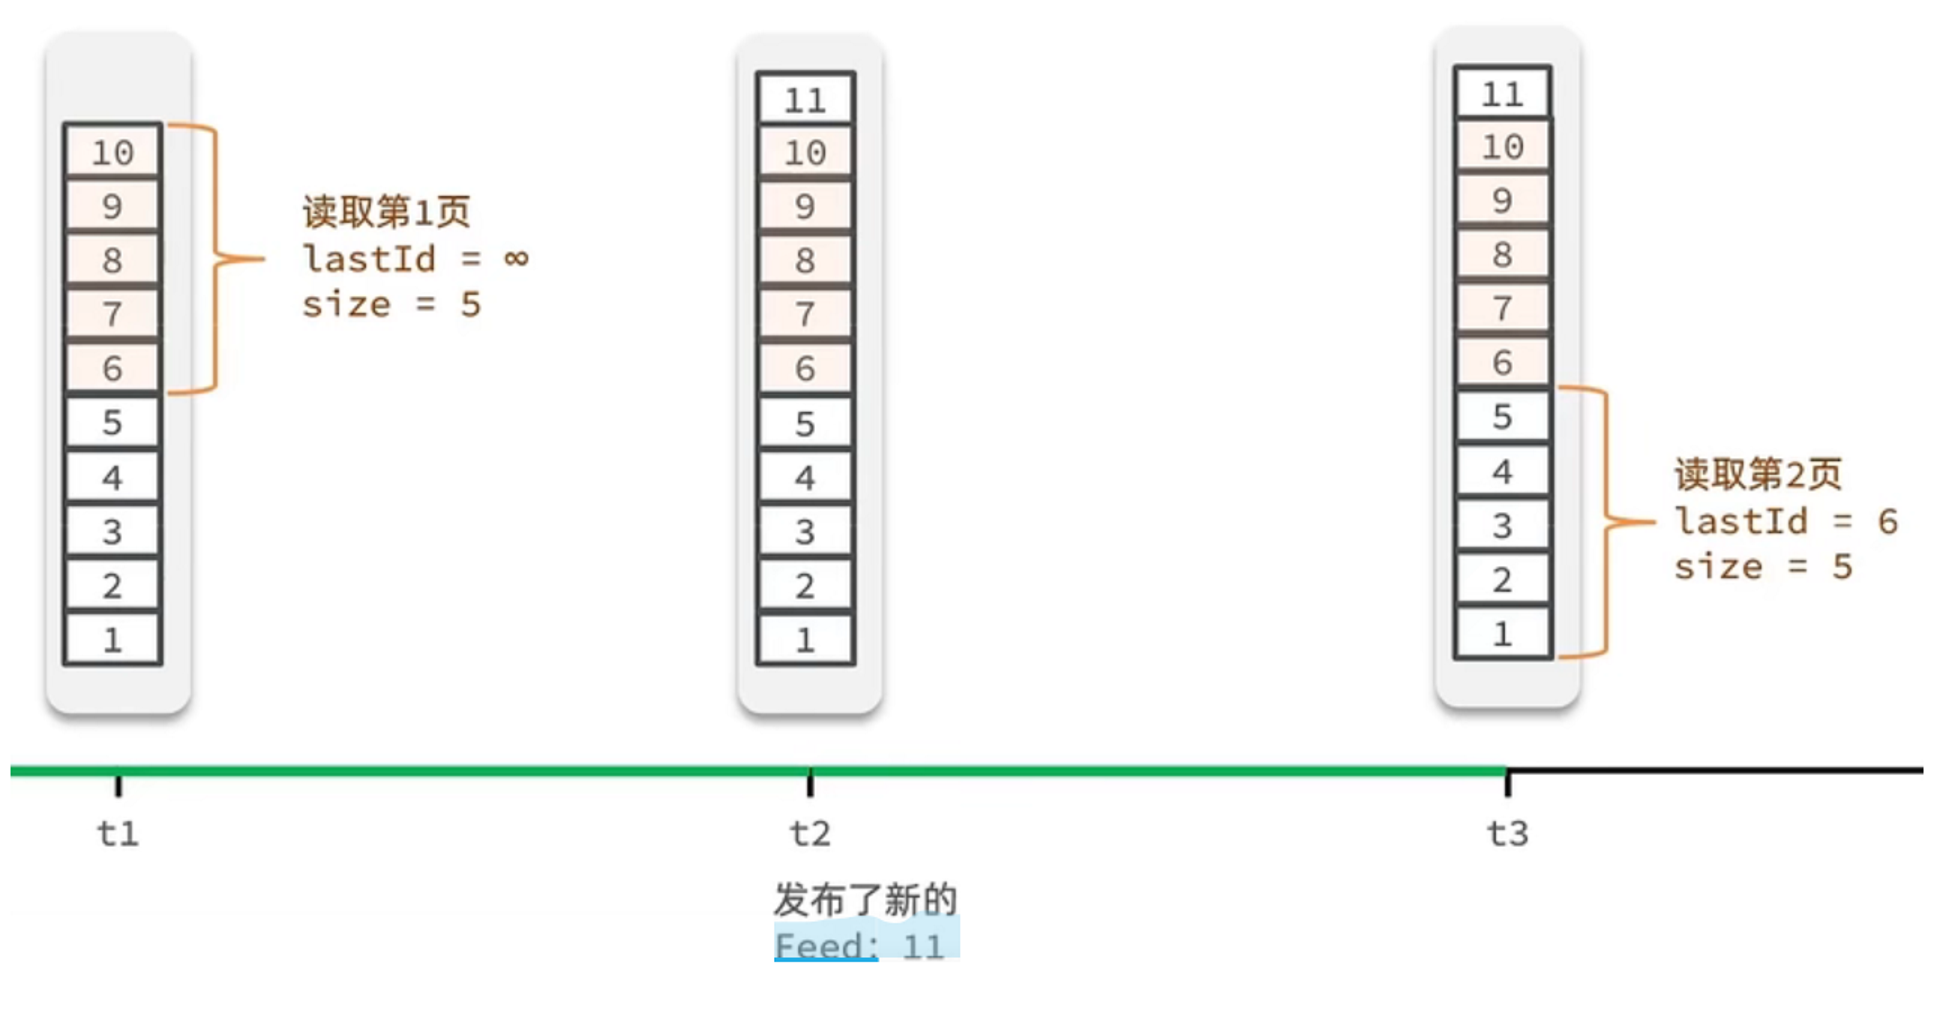
传统分页问题:数据更新时,使用limit offset会导致重复或遗漏。
滚动分页原理:
-
使用SortedSet,Score为时间戳,Value为博客id。
-
每次查询时,传入上次查询的最小Score(即时间戳) 和偏移量。
-
使用Redis命令:ZREVRANGEBYSCORE key max min LIMIT offset count
-
解析结果,记录本次查询的最小Score和相同Score的元素个数,作为下一次查询的偏移量。
遇到的问题
问题:数据库IN查询后顺序问题
现象:在查询点赞排行榜的用户信息时,使用IN (用户id列表),数据库返回的顺序与IN中的顺序不一致,导致展示顺序错乱。
解决方案: 使用ORDER BY FIELD(id, id1, id2, id3…)自定义排序,保证顺序与传入的id列表顺序一致。
SELECT * FROM user WHERE id IN (5, 1) ORDER BY FIELD(id, 5, 1)
对应MyBatis Plus代码:
userService.query()
.in("id", ids)
.last("ORDER BY FIELD(id," + idStr + ")") // idStr是用逗号拼接的id字符串
.list();
今日实战收获
业务实现流程梳理
1. 点赞功能
步骤:
为Blog实体添加一个isLike字段,表示当前登录用户是否点赞。
点赞与取消点赞接口:
-
获取当前登录用户id。
-
判断用户是否已经点赞(使用Set或ZSet的ZSCORE判断)。
-
如果未点赞,则点赞:数据库点赞数+1,并保存用户到Redis集合(Set或ZSet,ZSet需记录时间戳)。
-
如果已点赞,则取消点赞:数据库点赞数-1,并从Redis集合中移除用户。
查询博客详情时,判断当前用户是否在Redis集合中,并赋值给isLike字段。
关键代码(使用ZSet实现):
@Override
public Result likeBlog(Long id) {
// 1.获取登录用户
Long userId = UserHolder.getUser().getId();
// 2.判断当前登录用户是否已经点赞
String key = BLOG_LIKED_KEY + id;
Double score = stringRedisTemplate.opsForZSet().score(key, userId.toString());
if (score == null) {
// 3.未点赞,点赞
// 3.1.数据库点赞数+1
boolean isSuccess = update().setSql("liked = liked + 1").eq("id", id).update();
if (isSuccess) {
// 3.2.保存用户到Redis的ZSet,score为当前时间戳
stringRedisTemplate.opsForZSet().add(key, userId.toString(), System.currentTimeMillis());
}
} else {
// 4.已点赞,取消点赞
// 4.1.数据库点赞数-1
boolean isSuccess = update().setSql("liked = liked – 1").eq("id", id).update();
if (isSuccess) {
// 4.2.从Redis的ZSet移除用户
stringRedisTemplate.opsForZSet().remove(key, userId.toString());
}
}
return Result.ok();
}
2. 点赞排行榜
步骤:
在点赞时,使用ZSet存储,score为点赞时间戳。
开发查询点赞排行榜的接口,返回前5个点赞的用户。
使用ZRANGE命令获取前5个用户id,注意使用ZREVRANGE按时间倒序。
根据用户id查询用户信息,并使用ORDER BY FIELD保证顺序。
关键代码:
@Override
public Result queryBlogLikes(Long id) {
String key = BLOG_LIKED_KEY + id;
// 1.查询top5的点赞用户 ZRANGE key 0 4
Set<String> top5 = stringRedisTemplate.opsForZSet().range(key, 0, 4);
if (top5 == null || top5.isEmpty()) {
return Result.ok(Collections.emptyList());
}
// 2.解析出其中的用户id
List<Long> ids = top5.stream().map(Long::valueOf).collect(Collectors.toList());
String idStr = StrUtil.join(",", ids);
// 3.根据用户id查询用户,并按照idStr中的顺序排序
List<UserDTO> userDTOS = userService.query()
.in("id", ids).last("ORDER BY FIELD(id," + idStr + ")").list()
.stream()
.map(user -> BeanUtil.copyProperties(user, UserDTO.class))
.collect(Collectors.toList());
return Result.ok(userDTOS);
}
3. 关注与共同关注
步骤:
关注与取消关注:在数据库的tb_follow表记录关系,同时在Redis中维护一个关注集合(Set),Key为follows:{userId},方便后续交集运算。
共同关注:使用SINTER命令求两个用户关注集合的交集。
关键代码(关注时维护Redis集合):
@Override
public Result follow(Long followUserId, Boolean isFollow) {
Long userId = UserHolder.getUser().getId();
String key = "follows:" + userId;
if (isFollow) {
// 关注
Follow follow = new Follow();
follow.setUserId(userId);
follow.setFollowUserId(followUserId);
boolean isSuccess = save(follow);
if (isSuccess) {
// 把关注用户的id放入Redis集合
stringRedisTemplate.opsForSet().add(key, followUserId.toString());
}
} else {
// 取关
boolean isSuccess = remove(new QueryWrapper<Follow>()
.eq("user_id", userId).eq("follow_user_id", followUserId));
if (isSuccess) {
// 把关注用户的id从Redis集合中移除
stringRedisTemplate.opsForSet().remove(key, followUserId.toString());
}
}
return Result.ok();
}
共同关注:
@Override
public Result followCommons(Long id) {
// 1.获取当前用户
Long userId = UserHolder.getUser().getId();
String key = "follows:" + userId;
// 2.求交集
String key2 = "follows:" + id;
Set<String> intersect = stringRedisTemplate.opsForSet().intersect(key, key2);
if (intersect == null || intersect.isEmpty()) {
return Result.ok(Collections.emptyList());
}
// 3.解析id集合
List<Long> ids = intersect.stream().map(Long::valueOf).collect(Collectors.toList());
// 4.查询用户
List<UserDTO> users = userService.listByIds(ids)
.stream()
.map(user -> BeanUtil.copyProperties(user, UserDTO.class))
.collect(Collectors.toList());
return Result.ok(users);
}
4. Feed流推送与滚动分页
步骤:
在发布博客时,查询当前用户的粉丝列表,将博客id推送到每个粉丝的收件箱(SortedSet,score为发布时间戳)。
在个人主页的“关注”页中,查询收件箱数据,按时间倒序,使用滚动分页。
关键代码(发布博客时推送):
@Override
public Result saveBlog(Blog blog) {
UserDTO user = UserHolder.getUser();
blog.setUserId(user.getId());
// 1.保存探店笔记到数据库
boolean isSuccess = save(blog);
if (!isSuccess) {
return Result.fail("新增笔记失败!");
}
// 2.查询笔记作者的所有粉丝
List<Follow> follows = followService.query().eq("follow_user_id", user.getId()).list();
// 3.推送笔记id给所有粉丝
for (Follow follow : follows) {
Long userId = follow.getUserId();
String key = FEED_KEY + userId;
stringRedisTemplate.opsForZSet().add(key, blog.getId().toString(), System.currentTimeMillis());
}
return Result.ok(blog.getId());
}
关键代码(滚动分页查询Feed流):
@Override
public Result queryBlogOfFollow(Long max, Integer offset) {
// 1.获取当前用户
Long userId = UserHolder.getUser().getId();
// 2.查询收件箱 ZREVRANGEBYSCORE key Max Min LIMIT offset count
String key = FEED_KEY + userId;
Set<ZSetOperations.TypedTuple<String>> typedTuples = stringRedisTemplate.opsForZSet()
.reverseRangeByScoreWithScores(key, 0, max, offset, 2);
// 3.非空判断
if (typedTuples == null || typedTuples.isEmpty()) {
return Result.ok();
}
// 4.解析数据:blogId、minTime(时间戳)、offset
List<Long> ids = new ArrayList<>(typedTuples.size());
long minTime = 0;
int os = 1;
for (ZSetOperations.TypedTuple<String> tuple : typedTuples) {
ids.add(Long.valueOf(tuple.getValue()));
long time = tuple.getScore().longValue();
if (time == minTime) {
os++;
} else {
minTime = time;
os = 1;
}
}
// 5.根据id查询blog,并封装用户和点赞信息
String idStr = StrUtil.join(",", ids);
List<Blog> blogs = query().in("id", ids).last("ORDER BY FIELD(id," + idStr + ")").list();
for (Blog blog : blogs) {
queryBlogUser(blog);
isBlogLiked(blog);
}
// 6.封装并返回
ScrollResult r = new ScrollResult();
r.setList(blogs);
r.setOffset(os);
r.setMinTime(minTime);
return Result.ok(r);
}
滚动分页参数说明:
-
max:第一次查询传入当前时间戳,后续查询传入上一次查询的最小时间戳。
-
offset:第一次查询传入0,后续查询传入上一次查询中,与最小时间戳相同的元素个数。
-
count:每页大小。
小知识点总结
数据库IN查询自动重排序:使用IN (id1, id2, id3)时,数据库返回的顺序可能与传入顺序不一致。需要使用ORDER BY FIELD(id, id1, id2, id3)自定义排序。
列表拼接字符串:使用StrUtil.join(",", list)快速将List拼接成逗号分隔的字符串。
Feed流产品模式:
-
Timeline:按发布时间排序,信息全面但可能有噪音。
-
智能排序:算法推荐,用户粘度高但可能不准。
Feed流实现方案:
-
拉模式(读扩散):节省空间,读取延迟大。
-
推模式(写扩散):读取快,存储压力大。
-
推拉结合:折中方案,根据用户类型选择。
滚动分页查询参数:
-
Max:当前时间戳(第一次),后续为上一次查询的最小时间戳。
-
Min:0。
-
Offset:0(第一次),后续为上一次查询中与最小值一样元素的个数。
-
Count:每页大小。
总结
通过达人探店模块的实战,我们深入掌握了社交功能中常见的点赞、关注、Feed流等场景的实现。核心在于合理利用Redis的数据结构:
-
使用Set实现简单的集合运算(如共同关注)。
-
使用SortedSet实现有序集合(如点赞排行榜、Feed流收件箱),并利用其排序特性实现滚动分页,解决了传统分页在动态数据下的问题。
在Feed流的设计中,我们选择了推模式,将发布者的动态实时推送到粉丝的收件箱中,保证了读取性能。同时,通过滚动分页优化了查询体验,避免了数据重复和遗漏。
整个模块的实现,体现了Redis在提升系统性能和用户体验方面的巨大价值,也展示了在高并发场景下,如何通过异步、解耦和数据结构优化来构建可靠的社交功能。