1 引言:如何在迷雾中寻找真相?
在统计学诞生之初,无论是天文学家高斯(Gauss)测量星体轨道,还是社会学家调查人口特征,他们都面临着同一个核心难题:上帝视角的缺失。
我们想要知道总体的真实参数(比如所有人类的平均身高,记为 θ\\thetaθ),但我们永远只能获取有限的样本(比如随机抽取的1000人)。如何利用手头这仅有的样本,去猜测那个未知的、确定的真值?这就涉及到了**估计量(Estimator)**的设计。
这就好比打靶。如果把真值 θ\\thetaθ 看作靶心,我们的每一次抽样估计就像是一次射击。我们当然希望射得准,但在数学上,“准”有着不同的定义维度。这便是无偏估计量与有偏估计量博弈的起点。
2 追求“不偏不倚”:无偏估计量
2.1 频率学派的理想
在19世纪,随着概率论的公理化,统计学家们首先确立了一个朴素的道德标准:诚实。
如果我进行无限次重复抽样,计算出无数个估计值,这些估计值的平均数应该恰好等于真实值。既不系统性地偏大,也不系统性地偏小。这就是无偏性(Unbiasedness)。
用数学语言描述:如果估计量 θ^\\hat{\\theta}θ^ 的数学期望等于真值 θ\\thetaθ,即 E(θ^)=θE(\\hat{\\theta}) = \\thetaE(θ^)=θ,则称 θ^\\hat{\\theta}θ^ 为无偏估计量。
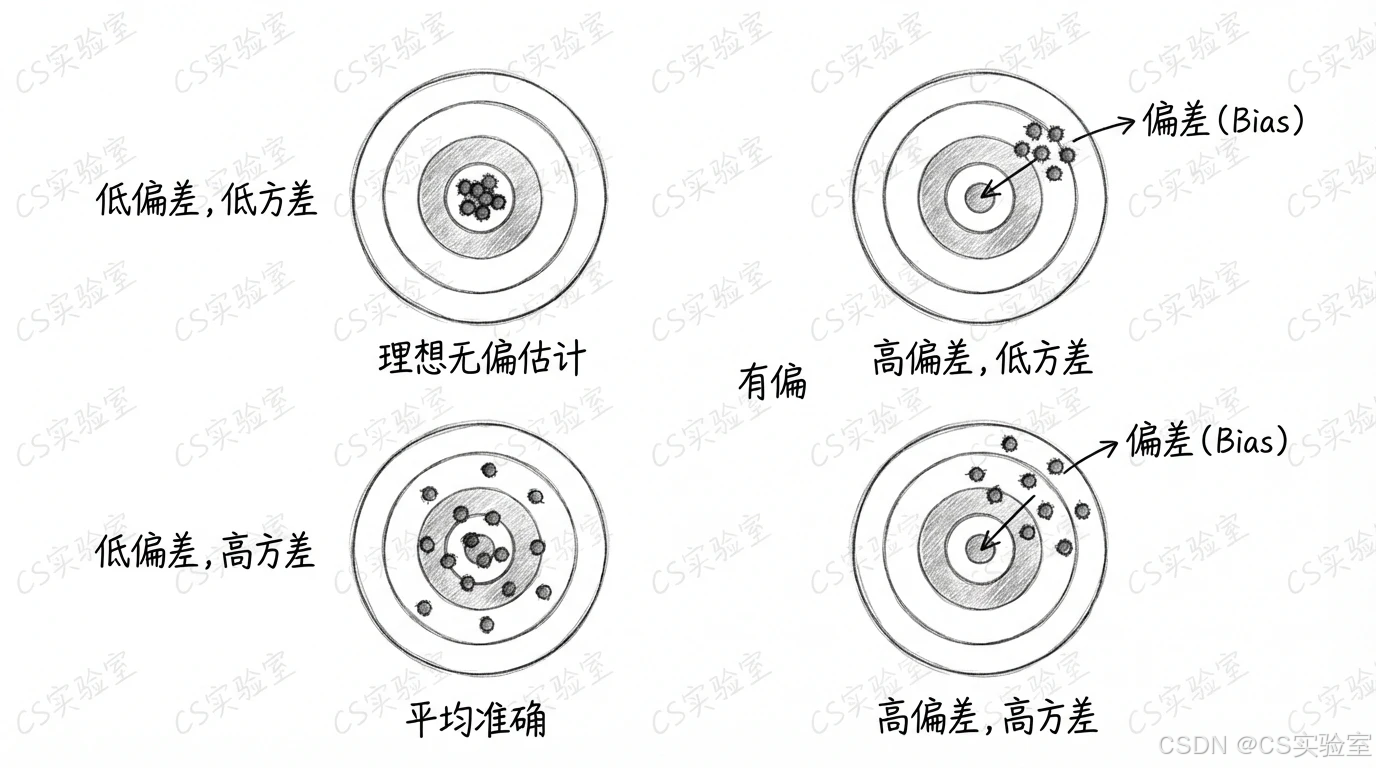
图 1:无偏估计与有偏估计的靶心示意图
2.2 样本均值的胜利
最经典的无偏估计量就是样本均值(Xˉ\\bar{X}Xˉ)。无论总体服从什么分布,样本均值的期望永远等于总体均值。这使得它成为了统计学中最稳健的基石。
实际应用价值:
在科学实验和民意调查中,无偏性至关重要。如果一个测量仪器的读数总是比真实值高0.1,那就是“有偏”的,需要校准。无偏估计保证了科学研究的客观性,没有系统性的误差引入。
3 直觉的陷阱:为什么方差要除以 n-1?
然而,历史的发展并非一帆风顺。当人们试图估计方差(数据的离散程度)时,遇到了直觉上的挑战。
3.1 贝塞尔校正的诞生
假设我们要估计总体的方差 σ2\\sigma^2σ2。直觉告诉我们,应该算出每个数据与均值的差的平方和,然后除以样本数量 nnn。
也就是:Sn2=1n∑(Xi−Xˉ)2S_n^2 = \\frac{1}{n}\\sum(X_i – \\bar{X})^2Sn2=n1∑(Xi−Xˉ)2。
但是,高斯等数学家发现,这个符合直觉的公式竟然是有偏的!它计算出的数值,长期来看总是比真实方差要小。
为什么?
这是因为我们在计算时使用了样本均值 Xˉ\\bar{X}Xˉ 来代替未知的总体均值 μ\\muμ。样本均值天然地位于样本数据的“中心”,它比总体均值更贴近这组样本。因此,样本数据到样本均值的距离(残差),往往小于样本数据到真实总体均值的距离。这导致计算结果被“低估”了。
为了纠正这个偏差,统计学家引入了贝塞尔校正(Bessel’s Correction):将分母中的 nnn 改为 n−1n-1n−1。
即:S2=1n−1∑(Xi−Xˉ)2S^2 = \\frac{1}{n-1}\\sum(X_i – \\bar{X})^2S2=n−11∑(Xi−Xˉ)2。
这神奇的“减1”,让估计量重新变回了无偏估计量。这一发现深刻地揭示了:直觉上的“平均”并不总是统计学上的“无偏”。
4 视角的转折:有偏估计量的逆袭
进入20世纪中叶,随着费希尔(Fisher)极大似然估计(MLE)的普及,以及后来计算机科学的发展,人们开始反思:无偏性真的是唯一的黄金标准吗?
4.1 均方误差(MSE)的权衡
我们在工程实践中发现,有时候无偏估计量的方差(Variance)太大了。
回到图1的例子:如果一个枪手(无偏估计)虽然瞄准的是红心,但手抖得厉害,子弹满天飞;而另一个枪手(有偏估计)虽然瞄得稍微偏了一点点,但由于手非常稳,子弹都密集地打在离红心很近的地方。
问:如果你要根据一次射击结果来做决策,你选谁?
很多时候,我们宁愿要那个稍微有点偏,但非常稳定的枪手。为了量化这个选择,统计学引入了均方误差(MSE, Mean Squared Error):
MSE=方差(Variance)+偏差(Bias)2MSE = \\text{方差(Variance)} + \\text{偏差(Bias)}^2MSE=方差(Variance)+偏差(Bias)2
这意味着,如果我们能引入一点点“偏差”,从而换取“方差”的大幅度降低,那么总体的误差(MSE)反而会变小。这就为有偏估计量的正名打开了大门。
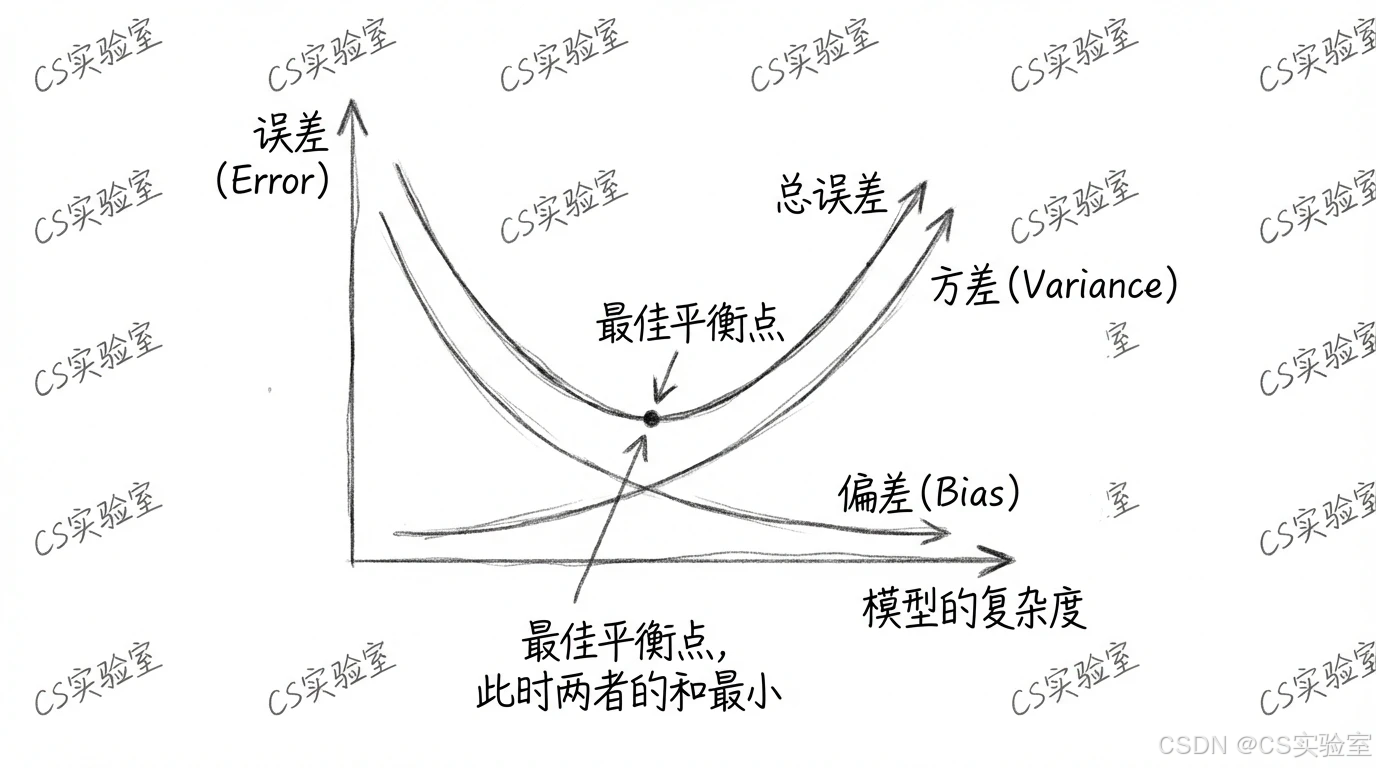
图 2:偏差-方差权衡(Bias-Variance Tradeoff)曲线
5.4.2 现代演进:高维数据与正则化
在现代大数据和机器学习时代,有偏估计量的应用达到了顶峰。特别是在高带宽时延产品环境(这里指代高维数据、稀疏数据环境)下,传统的无偏估计(如普通最小二乘法 OLS)往往会过拟合,导致方差极度膨胀。
岭回归(Ridge Regression):
这是有偏估计的典型应用。通过在损失函数中强行加入一个惩罚项(正则化),我们在估计参数时故意让它们“缩减”向0。虽然这引入了偏差(估计值不再严格等于真值),但却极大地降低了方差,使得模型在面对未见过的测试数据时,预测效果远好于无偏的普通回归。
James-Stein 估计量:
这是一个统计学界的“震撼弹”。斯坦(Stein)在1956年证明,当我们要同时估计3个以上参数的均值时,传统的、被认为完美的无偏估计量(样本均值),竟然不是最优的!一种收缩的有偏估计量在均方误差上全面碾压了它。这彻底打破了“无偏即正义”的传统观念。
5 本章小结
估计理论的发展史,就是人类从追求绝对的“道德正确”(无偏性),走向追求实际的“效用最大化”(偏差-方差权衡)的过程。