【老计带你懂概率统计】12:相关不等于因果,这句话到底是什么意思
开头:一句人人会说、没几个真懂的话
“相关不等于因果”,这句话你肯定听过,可能自己也说过。但我打赌,真正把它理解透、并且在看数据时时时警惕的人,没几个。
这一篇,我要把这句话彻底讲清楚。因为它是数据分析里最大、最常见、代价也最惨重的坑。 无数错误的商业决策、伪科学结论、被带节奏的舆论,根子都在于把相关当成了因果。理解了这一篇,你看数据、看新闻、做判断的水平,会上一个大台阶。
相关是什么:两件事一起变化
先说相关。相关,指的是两件事倾向于一起变化。 一个变大另一个也变大(正相关),或者一个变大另一个变小(负相关)。
比如,身高和体重正相关(个子高的往往更重),学习时间和成绩正相关,气温和羽绒服销量负相关。统计上用相关系数来衡量,它在正1到负1之间,越接近正负1相关越强,接近0则几乎不相关。
相关是一种可以直接从数据里观测和计算出来的统计关系,它只描述两个量一起变动的模式,不解释为什么。 这就是关键,相关只说它们一起变,绝不告诉你谁导致了谁、甚至它们之间到底有没有真实联系。
关于相关系数,还有个常被忽略的陷阱要提醒你,它衡量的主要是线性相关,相关系数接近0,不代表两个变量真的没关系。 举个例子,一个变量和另一个变量呈现完美的抛物线关系(先增后减,比如某种剂量和药效,剂量太小太大都不好、中间最佳),它们明明关系紧密,可算出来的线性相关系数可能接近0,因为那条线性的尺子量不出弯曲的关系。所以看到相关系数很低,别急着说两者无关,它们可能存在线性尺子测不到的非线性关系。 反过来,相关系数很高也未必可靠,可能是被个别极端离群点硬拉出来的假象。结论是,光看一个相关系数的数字很危险,最好把数据画成散点图亲眼看看,图形能告诉你数字掩盖的真相。 这也呼应了前几篇的态度,别只盯着一个概括性的数字,要去看数据的全貌。
因果是什么:一个真的导致了另一个
因果就不同了。因果,指的是一件事真的导致了另一件事的发生,你改变原因,结果会跟着变。
真按下开关(因),灯真的亮了(果),这是因果,你不按就不亮。因果的核心是那种"动它、它就变"的操纵关系,而相关只是"它俩一起动"的伴随关系。 这是两者根本的不同。
问题在于,观测到相关很容易(算一下数据就有),但确认因果却很难。 两件事一起变化,可能有好几种截然不同的原因,只有一种是真因果。
相关但不因果的三种情况
为什么相关不等于因果?因为两件事相关,背后可能是这几种情况,只有一种是真因果:
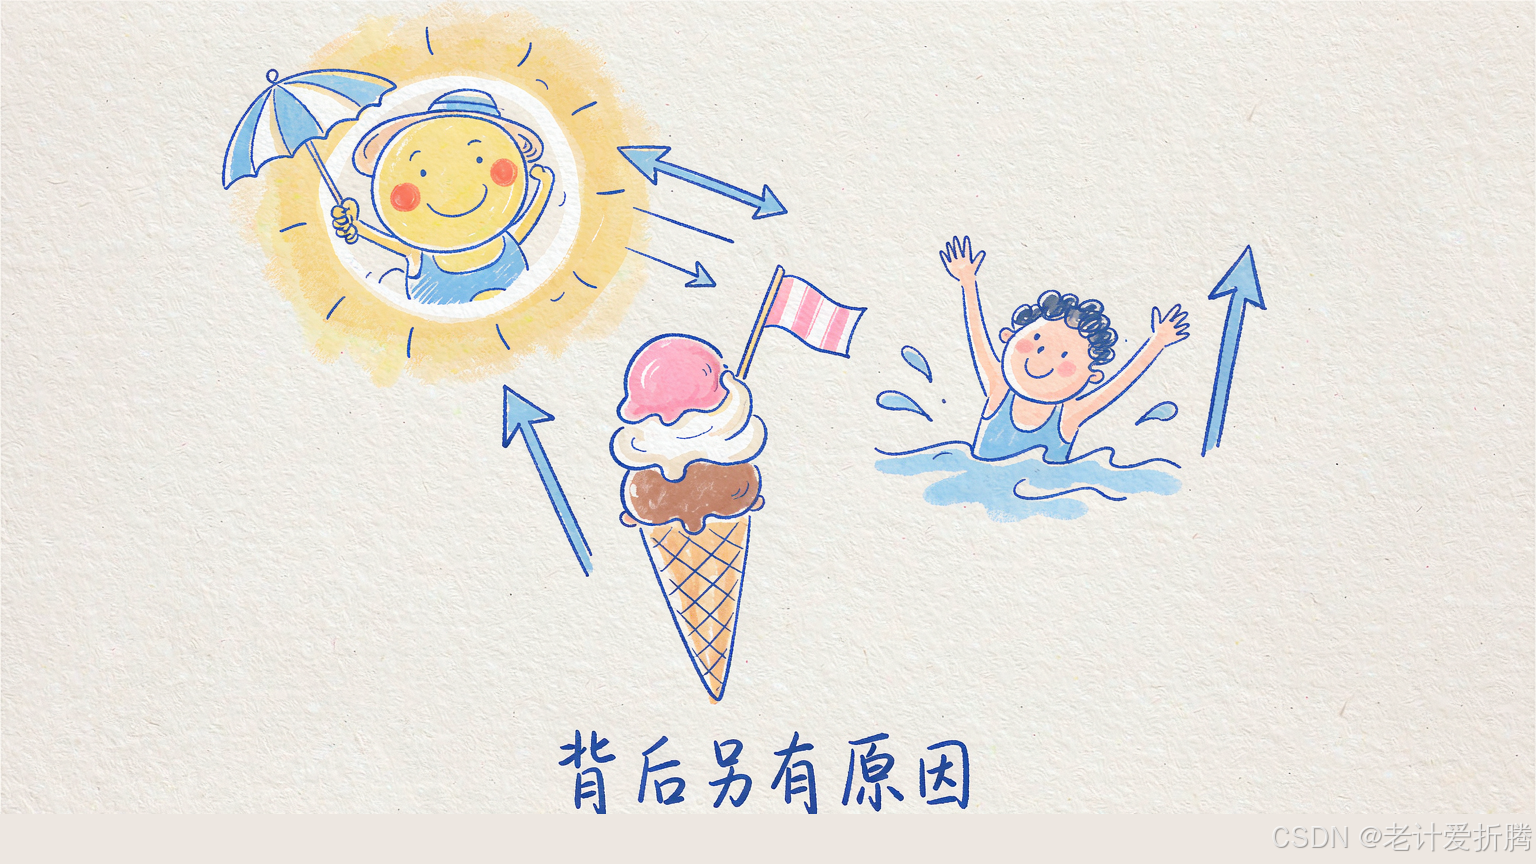
第一种,纯属巧合。 有些相关纯粹是碰巧。有人统计发现,某地区的溺水人数和冰淇淋销量高度正相关。难道吃冰淇淋会导致溺水?当然不是,这是巧合吗?不完全是,看下一种。
第二种,也是最重要的,存在共同的幕后原因(混淆变量)。 冰淇淋和溺水的例子,真相是背后有个共同的原因,夏天(高温)。天热了,大家既更爱吃冰淇淋,又更多下水游泳(于是溺水也多)。是"夏天"这个幕后黑手,同时推高了两者,让它们看起来相关,但它俩之间毫无因果。这个躲在背后、同时影响两件事、制造出虚假相关的第三方因素,叫混淆变量,是相关不等于因果最常见的元凶。
第三种,因果方向反了。 你观测到"用了某App的人更健康",是App让人健康(因果),还是本来就健康、爱运动的人更愿意用这类App(因果反过来了)?光看相关,你分不清方向。
所以看到相关,先别急着下因果结论,问自己三句,是不是巧合?背后有没有混淆变量?因果方向会不会反了? 这三问,能帮你避开绝大多数把相关当因果的坑。
辛普森悖论:分组看和合起来看,结论相反
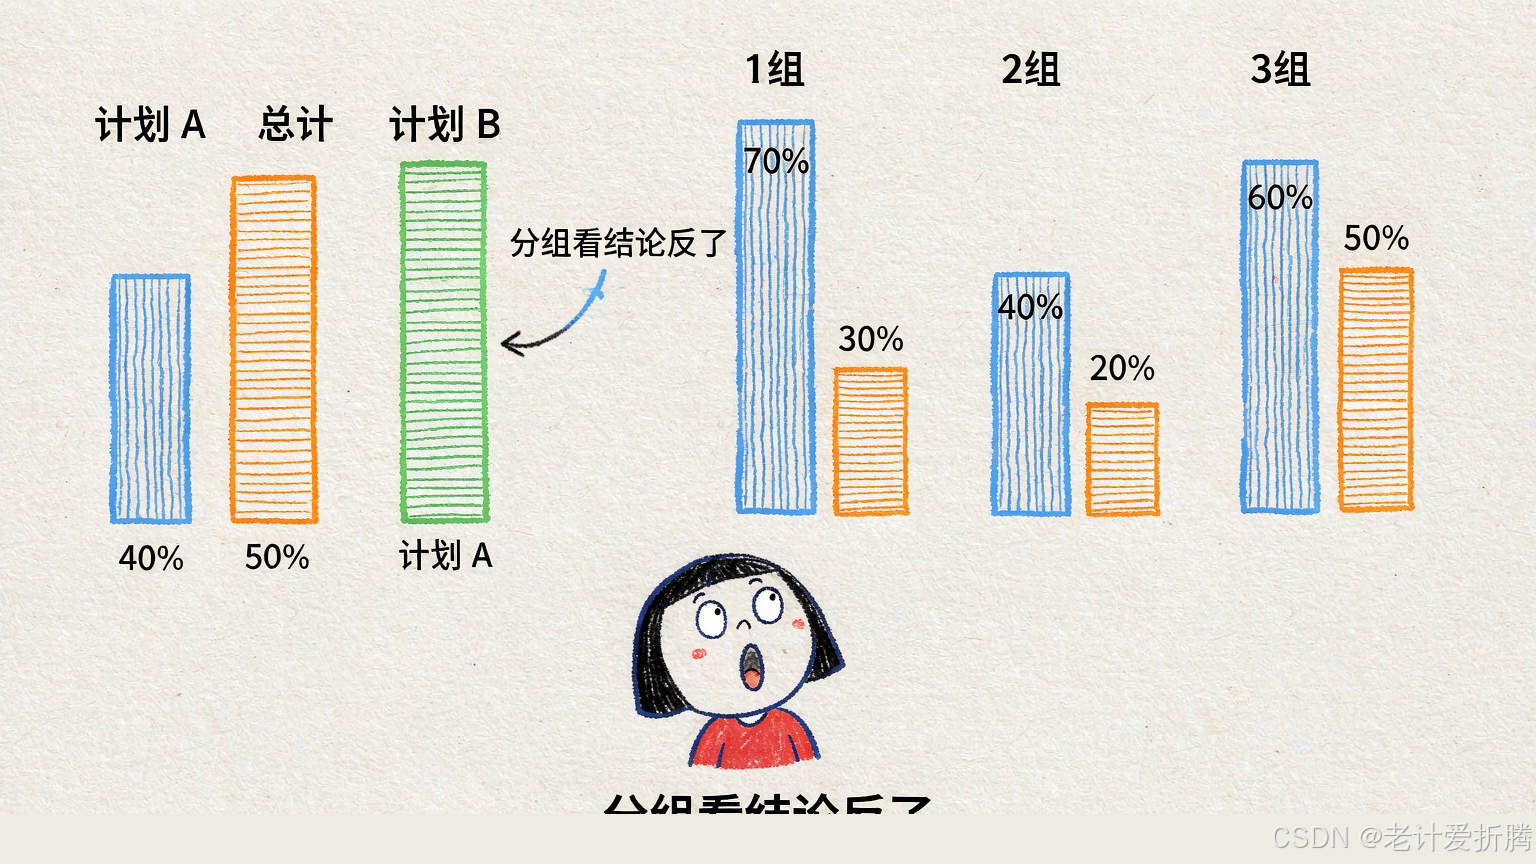
讲一个相关性里最反直觉、最烧脑、也最有名的现象,辛普森悖论。它能让你彻底见识数据有多能骗人。
它说的是:在分组数据里都成立的规律,把数据合起来看,规律可能完全反过来。
举个经典例子。某医院统计两种疗法A和B对肾结石的治疗效果:
- 只看大结石患者,疗法A的成功率更高。
- 只看小结石患者,疗法A的成功率也更高。
- 可是把所有患者合起来算总成功率,居然是疗法B更高。
在每个分组里A都更好,合起来却是B更好,这怎么可能? 这就是辛普森悖论,第一次见到会觉得违反数学常识,但它千真万确。
原因还是那个混淆变量在捣鬼。真相是,医生倾向于用更强的疗法A去治更难治的大结石,用疗法B去治更容易的小结石。A组接的都是硬骨头(大结石,本身就难治、成功率天然低),B组接的都是软柿子(小结石,本身就好治)。 所以合起来一算,B靠着"专挑好治的"占了便宜,总成功率反超了专啃硬骨头的A。可实际上,无论面对哪种结石,A都是更好的选择。
辛普森悖论的杀伤力在于,如果你不注意背后的分组因素,光看合并的总数据,会得出完全错误、甚至相反的结论。 现实里它坑过无数人,比如比较两个部门、两所学校、两个策略时,笼统看总数和分组看,结论可能截然相反。
上代码:亲手复现辛普森悖论
我们用代码造一个辛普森悖论出来,让你亲眼看到分组和合并的相反结论。输入:两组疗法数据。输出:分组成功率 vs 合并成功率。
# 依赖:纯Python
# 经典肾结石疗法数据(辛普森悖论真实案例)
# 疗法A:多用于难治的大结石; 疗法B:多用于好治的小结石
# 大结石(难治): A治了263人成功192, B治了80人成功55
# 小结石(好治): A治了87人成功81, B治了270人成功234
def rate(success, total):
return success / total
print("=== 分组看 ===")
print(f"大结石: 疗法A成功率{rate(192,263):.1%}, 疗法B成功率{rate(55,80):.1%} -> A更好")
print(f"小结石: 疗法A成功率{rate(81,87):.1%}, 疗法B成功率{rate(234,270):.1%} -> A更好")
print("\\n=== 合起来看 ===")
a_total = rate(192+81, 263+87)
b_total = rate(55+234, 80+270)
print(f"疗法A总成功率: {a_total:.1%}")
print(f"疗法B总成功率: {b_total:.1%}")
print(f"-> 合并后 {'B更好' if b_total>a_total else 'A更好'}, 和分组结论相反!")
print("\\n真相:A专治难治的大结石(拉低了它的总成功率),这就是辛普森悖论")
运行输出(示例):
=== 分组看 ===
大结石: 疗法A成功率73.0%, 疗法B成功率68.8% -> A更好
小结石: 疗法A成功率93.1%, 疗法B成功率86.7% -> A更好
=== 合起来看 ===
疗法A总成功率: 78.0%
疗法B总成功率: 82.6%
-> 合并后 B更好, 和分组结论相反!
真相:A专治难治的大结石(拉低了它的总成功率),这就是辛普森悖论
运行你会看到,两个分组里疗法A的成功率都更高,可一合并,疗法B的总成功率反而更高,结论彻底反转。这段代码用具体数字复现了辛普森悖论,它血淋淋地告诉你,不看清数据背后的分组结构、笼统地看合并数据,会得出多离谱的结论。
为什么我们的大脑总爱把相关当因果
你可能会想,这道理听着不难,为什么还有这么多人(包括聪明人)反复掉坑?因为把相关误当因果,是人类大脑根深蒂固的本能。
我们的祖先在野外生存,需要快速地从现象里找因果,看到草丛动一下(现象)就联想到可能有猛兽(原因)、赶紧跑,这种"迅速脑补因果"的本能救过命,被刻进了基因。所以我们天生就爱给任何一起出现的现象,脑补出一个因果故事,因为一个有因有果的故事,比一堆冷冰冰的、说不清关系的数据,让我们舒服得多、有掌控感得多。 这也是为什么各种"某某导致某某"的说法特别容易传播,它迎合了大脑对因果故事的渴望。
打个比方,大脑就像一个特别爱脑补的编剧,看到两个镜头挨在一起,就忍不住给它们编一个前因后果的剧情,哪怕这两个镜头其实毫无关系。 认识到这是个本能陷阱很重要,因为它意味着,抵抗这个诱惑需要刻意的、反直觉的努力。每当你看到一个诱人的因果说法、心里觉得"太有道理了"的时候,恰恰是该踩刹车、多问一句"这真是因果吗"的时候。 这种对抗本能的清醒,正是理性思维最宝贵的地方,也是学统计能带给你的一种深层的思维升级。
既然相关这么不可靠,那怎么才能确认因果?给你几个层次:
最可靠的是随机对照实验,也就是上一篇的AB测试。 为什么AB测试能确立因果?因为随机分组,让两组除了你要测的那个改动外没有系统差异,排除了一切混淆变量,这时观测到的差异,才能干净地归因于你的改动。这就是随机实验的黄金地位,它是确立因果的最强手段。 医学的随机双盲试验、互联网的AB测试,都靠它。
当没法做实验时(比如你不能为了研究吸烟危害就强迫一群人吸烟),科学家发展了一整套因果推断的方法,想办法从观测数据里剥离混淆变量、逼近因果,这是个专门的深水区,这里点到为止。核心记住,光有相关远远不够,确立因果要么靠随机实验,要么靠精心的因果推断,绝不能看到两件事一起变就拍脑袋说谁导致了谁。
在AI和现实里怎么用
- 在AI里:机器学习模型极擅长发现相关性,但它学到的往往只是相关、不是因果。一个模型发现"用户装了某App和高消费相关",不代表装App导致高消费,可能是有钱人既爱装这App又消费高。盲目把模型发现的相关当因果去做决策,是AI落地的大坑,这也是近年因果推断在AI里越来越火的原因。
- 在现实里:看到"吃某食物的人更长寿""上某培训班的孩子成绩更好"这类说法,条件反射地想,这是因果还是相关?有没有混淆变量(爱吃健康食物的人可能本来就更注重养生、更有钱)?方向会不会反?这份警惕,能让你不被无数似是而非的结论和营销忽悠。
小结与承上启下
- 相关:两件事一起变化,能直接从数据算出,但不解释为什么。
- 因果:一件事真的导致另一件,核心是动它就变的操纵关系。
- 相关不等于因果的三种情况:纯属巧合、背后有混淆变量(最常见,如夏天同时推高冰淇淋和溺水)、因果方向反了。
- 辛普森悖论:分组看和合并看结论相反,混淆变量在捣鬼,笼统看总数据会得出错误结论。
- 确认因果:靠随机实验(AB测试的黄金地位)或专门的因果推断,绝不能看到相关就拍脑袋定因果。
这一篇讲的是两个变量之间关系的定性判断。可有时候我们想更进一步,定量地刻画一个变量对另一个的影响有多大,比如广告投入每增加一万,销量大概涨多少。下一篇,我们讲回归分析,从统计的角度重新认识上个系列讲过的线性回归,看它怎么量化变量之间的关系。
我们下一篇见。
延伸阅读
- 辛普森悖论经典案例可按关键词Simpson’s Paradox(含肾结石疗法、伯克利招生案例)检索
- 因果推断入门可按关键词Judea Pearl The Book of Why(《为什么》,因果推断经典科普)检索
(说明:以上为公开资料,如链接失效可用标题搜索。)