【老计带你懂概率统计】05:几个必须认识的分布,什么现象对应什么分布
开头:分布是有性格的
上一篇我们建立了随机变量和分布的框架。这一篇,来认识几个真正的主角,那些在现实和AI里反复出现的具体分布。
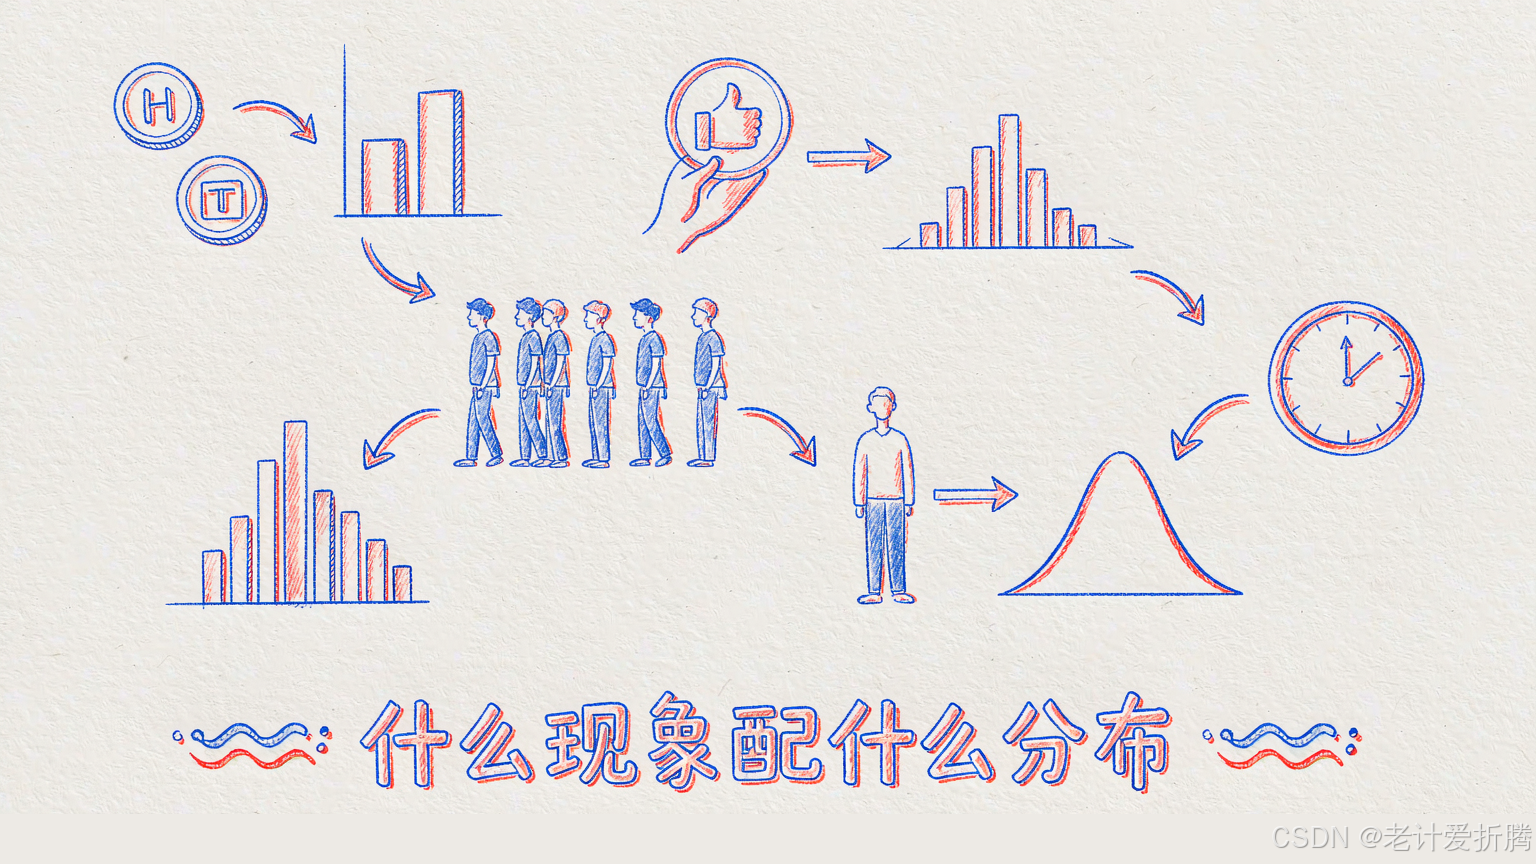
你可以把每一种分布,理解成一种特定的性格,对应着现实里一类特定的现象。 抛硬币这种"成或不成"的事,是一种性格;一段时间内接到多少个电话,是另一种性格;人的身高,又是一种性格。认识了这些常见分布,你就像掌握了一套识人术,看到一份数据,能一眼判断出它大概是什么性格、背后是什么机制、该用什么方法分析。 这是数据素养的重要一环。
我挑几个最常用、最该认识的,一个个说清它是干嘛的、对应什么场景。不求全,求你真正记住它们的性格。
伯努利分布:一锤子买卖,只有成或败
最简单的分布,伯努利分布,描述的是只做一次、只有两种结果(成功或失败)的随机事件。
抛一次硬币(正或反)、投一次篮(进或不进)、一个用户看到广告(点或不点)、一封邮件(是垃圾或不是),这些都是伯努利分布。它只有一个参数,成功的概率p。
伯努利是所有分布里最基础的原子,只有一次、两种结果。 记住它,因为它是下面二项分布的基石。
二项分布:重复很多次一锤子买卖,数成功了几次
把伯努利重复很多次,就是二项分布。它描述的是独立重复做n次伯努利实验,成功的总次数的分布。
抛10次硬币,正面出现几次?投100次篮,进几个?给1000个用户发广告,多少人点击?这些"重复n次、每次成败独立、数一共成功多少次"的场景,就是二项分布。 它有两个参数,重复次数n和每次成功概率p。
打个比方:伯努利是问"这一次成没成",二项是问"这一批里成了多少次"。 二项分布在现实里极其常见,因为大量业务都是"一批用户里有多少转化""一批产品里有多少次品"这种形态。它的图形是,成功次数在"n乘p"附近最密集(比如1000人、点击率10%,那点击数最可能在100附近),两边逐渐稀少。
泊松分布:一段时间内,某件事发生多少次
泊松分布描述的是在固定的一段时间或空间里,某个随机事件发生的次数,前提是这些事件独立发生、平均发生率稳定。
一小时内接到多少个报障电话?一天有多少用户注册?一页书有几个错别字?一段路一年发生几起事故?这些"单位时间/空间内、稀疏随机发生的事件计数",就是泊松分布。 它只有一个参数,平均发生率。
作为一个做运维的人,泊松分布我太熟了。系统在单位时间内的请求数、错误数、告警数,很多都近似泊松分布。 理解它,能帮你判断"这一分钟突然来了50个错误,是正常的随机波动,还是真出事了",这正是异常检测的基础。泊松分布的图形是,次数在平均值附近最多,太多太少都少见。
均匀分布:每个值机会均等
均匀分布最好懂,在某个范围内,每个取值的机会都完全相等。
一个理想的骰子(1到6等可能)、随机数生成器产生的0到1之间的数、完全随机地选一个时间点,都是均匀分布。它的图形是平的一条,没有哪个值更受偏爱。
均匀分布在现实里纯粹的不多,但它在计算机模拟和随机算法里是基石,几乎所有的随机模拟,底层都是先生成均匀分布的随机数,再变换成需要的其他分布。后面讲蒙特卡洛模拟时你会看到它的重要性。
正态分布:大自然最偏爱的钟形曲线
正态分布,也叫高斯分布,是所有分布里最著名、最重要的一个,它就是那条对称的钟形曲线。
它描述的是那种"大部分值集中在中间平均水平附近,越往两边极端越少"的现象,而且左右对称。 人的身高、体重、考试成绩、测量误差、很多自然和社会现象,都近似服从正态分布。它有两个参数,均值(钟形的中心在哪)和标准差(钟形是胖是瘦、数据多分散)。
为什么这么多现象都是正态分布?这背后有个极其深刻的原因,叫中心极限定理,重要到我要用下一整篇专门讲它。 这里你先记住正态分布的性格,中间高两边低、对称的钟形,是最常见、最重要的分布,统计学的半壁江山都建在它之上。
正态分布还有个特别实用的性质,叫68-95-99.7法则,值得先记住。它说的是,对任何正态分布,大约68%的数据落在均值上下一个标准差的范围内,约95%落在两个标准差内,约99.7%落在三个标准差内。这个法则威力很大,它意味着一旦你知道一份数据近似正态、又知道它的均值和标准差,你立刻就能估出各个范围内数据的比例,也能判断某个值算不算异常。 比如某指标正态分布、均值100标准差10,那出现一个130的值(超出三个标准差)就非常可疑了,几乎不该发生。做异常检测、质量管控(六西格玛就是这么来的)、判断一个数据点正不正常,全靠它,简单又好用。
指数分布:还要等多久才发生
指数分布描述的是两次随机事件之间的等待时间,比如两个报障电话之间隔多久、一个设备用多久会坏、你在餐厅等下一桌客人进来要等多久。
它和泊松分布是一对好搭档,泊松数的是"一段时间内发生几次",指数量的是"距离下次发生还要等多久"。 指数分布有个有趣的特点叫无记忆性,一个灯泡已经用了1000小时没坏,它接下来还能用多久的概率分布,和一个新灯泡一模一样(它不会"变老"),这个特性在可靠性分析里很重要。
这些分布其实是一家人
别把这几个分布当成孤立的知识点死记,它们之间有着优美的亲戚关系,理解了关系就不用硬背了。
伯努利是二项的特例(二项做一次就是伯努利)。二项在特定条件下会趋近泊松(当重复次数n很大、单次概率p很小时,比如海量用户里极低概率的点击,二项就近似成泊松了)。二项在n很大时又会趋近正态(这正是下一篇中心极限定理的一个体现)。泊松和指数是一对(泊松数次数、指数量间隔时间)。而正态,是无数分布在样本量足够大时共同的归宿(还是中心极限定理)。
打个比方,这些分布就像一个家族,伯努利是老祖宗,二项是它的直系后代,泊松、正态是在不同条件下从二项这里分化、演变出来的分支。 你看,一旦理清了这张家谱,你记的就不是六个孤立的东西,而是一个有内在逻辑的体系。这也是学任何知识的窍门,找到概念之间的联系,比孤立地背诵省力得多、也牢固得多。这一点,和上个AI算法系列里我反复强调的"万变不离其宗"是一个道理。
我们用代码生成并对比几个分布的样子。输入:分布参数。输出:各分布的形状特征和采样。
# 依赖:pip install numpy scipy
import numpy as np
from scipy import stats
np.random.seed(0)
# 二项分布:1000个用户,点击率10%,模拟点击人数
binom_samples = np.random.binomial(n=1000, p=0.1, size=10000)
print("二项分布(1000人点击率10%):")
print(f" 平均点击人数: {binom_samples.mean():.1f} (理论值n*p=100)")
# 泊松分布:平均每小时5个报障电话
poisson_samples = np.random.poisson(lam=5, size=10000)
print("泊松分布(平均每小时5个电话):")
print(f" 平均次数: {poisson_samples.mean():.2f}")
print(f" 一小时0个电话的概率: {stats.poisson.pmf(0, 5):.3f}")
print(f" 一小时超过10个电话的概率: {1 – stats.poisson.cdf(10, 5):.3f}")
# 正态分布:身高,均值170,标准差7
normal_samples = np.random.normal(loc=170, scale=7, size=10000)
print("正态分布(身高均值170标准差7):")
print(f" 样本均值: {normal_samples.mean():.1f}")
print(f" 身高在163到177之间的比例: {np.mean((normal_samples>163)&(normal_samples<177)):.3f}")
# 指数分布:平均每20分钟来一次事件,看等待时间
exp_samples = np.random.exponential(scale=20, size=10000)
print("指数分布(平均等待20分钟):")
print(f" 平均等待时间: {exp_samples.mean():.1f} 分钟")
运行输出(示例,随机模拟数值每次运行略有差异):
二项分布(1000人点击率10%):
平均点击人数: 100.0 (理论值n*p=100)
泊松分布(平均每小时5个电话):
平均次数: 5.00
一小时0个电话的概率: 0.007
一小时超过10个电话的概率: 0.014
正态分布(身高均值170标准差7):
样本均值: 170.0
身高在163到177之间的比例: 0.683
指数分布(平均等待20分钟):
平均等待时间: 20.0 分钟
运行你会看到:二项的平均点击数在100附近(1000乘0.1);泊松平均5次、一小时超10个电话的概率很小;正态身高在正负一个标准差(163到177)内的比例约0.68;指数平均等待20分钟。这段代码让你看到每个分布的实际数值特征,把抽象的性格变成了具体的数字。建议你改改参数,感受它们的变化。
怎么判断数据大概服从什么分布
学了这些分布,实际拿到一份数据,怎么判断它大概是什么分布?给你几个实用的思路。
第一,先想产生数据的机制。 这是最靠谱的。数据是"成败计数"(一批里多少转化)就往二项想,是"单位时间的稀疏计数"(每小时多少次)就往泊松想,是"等待时间"就往指数想,是"大量微小因素叠加的自然量"(身高、误差)就往正态想。搞清楚背后的机制,往往比看数据本身更能判断分布。第二,画直方图看形状。 把数据画成直方图,对称的钟形大概率是正态,右边拖长尾的可能是指数或对数正态,平的可能是均匀。眼睛看形状是很直接的一招。第三,用统计检验。 有专门的方法(如正态性检验)能定量判断数据是否服从某个分布,代码里调个函数就行。
不过要提醒一句,现实数据很少完美服从某个理论分布,我们说的都是近似。 关键不是纠结它到底是不是标准正态,而是判断用某个分布来近似它、做后续分析,是否足够合理。理论分布是我们理解和简化现实的工具,用得恰当就好,别陷入非黑即白的教条。 这种"用理想模型近似复杂现实"的务实态度,是应用概率统计的重要一课。
- 在AI里:分布假设深深影响模型。逻辑回归背后是伯努利分布,很多模型假设误差服从正态分布,泊松回归专门建模计数数据,生成模型学的就是数据的分布。选对分布假设,模型才对路。
- 在现实里:认出数据的分布,就抓住了它的机制。转化率问题想到二项、计数问题想到泊松、等待时间想到指数、自然测量想到正态。运维里判断请求量错误数是否异常、金融里评估风险、产品里分析用户行为,第一步往往就是搞清楚数据服从什么分布。
小结与承上启下
- 伯努利:一次、两种结果(成或败),最基础的原子。
- 二项:重复n次伯努利,数成功几次,对应一批里多少转化。
- 泊松:单位时间空间内稀疏事件的计数,对应请求数、错误数、注册数。
- 均匀:每个值机会均等,随机模拟的基石。
- 正态:中间高两边低的对称钟形,最重要,大量自然社会现象近似它。
- 指数:两次事件之间的等待时间,和泊松是搭档,有无记忆性。
这几个分布里,正态分布无疑是最重要的。可一个巨大的问题是,凭什么这么多毫不相干的现象,身高、误差、成绩,都不约而同地长成了钟形?这背后藏着概率统计里最深刻、最神奇的一条定理。下一篇,我们专门讲正态分布和那个让它无处不在的中心极限定理。
我们下一篇见。
延伸阅读
- SciPy 官方文档:各类统计分布(伯努利、二项、泊松、正态、指数等):https://docs.scipy.org/doc/scipy/reference/stats.html
- 各分布之间关系可按关键词Distribution Relationships检索经典关系图
(说明:以上为官方与公开资料,链接可能随版本调整,如打不开可用标题搜索。)