一、引言
在上一篇文章中,我们通过一个转账功能的重构,亲身体验了DDD战术设计带来的代码质变——原本臃肿的“事务脚本”被拆解为实体、值对象、仓库、领域服务、防腐层,职责清晰、易于测试。
但是,很多人会产生新的困惑:
-
贫血模型和充血模型到底该选哪个?为什么之前用贫血模型好好的,现在却要“充血”?
-
实体和值对象如何区分?地址到底是实体还是值对象?
-
领域服务和应用服务有什么区别?什么时候该用领域服务?
-
防腐层只用来隔离外部系统吗?还能做更多吗?
本文我们就从应用架构的视角,深入剖析DDD战术设计中的这几个核心概念,帮助你建立一套可落地、可权衡的设计原则。
二、贫血模型 VS 充血模型:两种设计哲学的抉择
1. 什么是贫血模型?
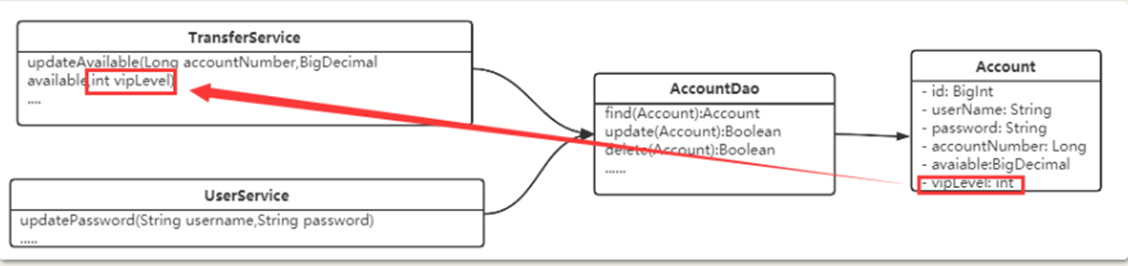
贫血模型(Anemic Domain Model)是指领域对象(如 Account)只包含数据,不包含业务逻辑,所有的业务逻辑都被写在 Service 层的事务脚本中。
典型的贫血模型代码:
java
public class Account {
private Long id;
private Long accountNumber;
private BigDecimal available;
// 仅包含 getter/setter
public Long getId() { return id; }
public void setId(Long id) { this.id = id; }
// … 其他 getter/setter
}
优点:
-
简单直接,开发速度快;
-
与传统的 MVC + DAO 模式无缝结合;
-
容易被初级开发人员理解。
缺点:
-
业务逻辑散落在 Service 中,无法复用;
-
随着业务复杂,Service 迅速膨胀;
-
领域对象变成了“数据容器”,丧失了表达业务的能力——领域失忆症。
贫血模型下的模型变更:
贫血模型下的业务模型变更必然带来大量代码变更

2. 什么是充血模型?
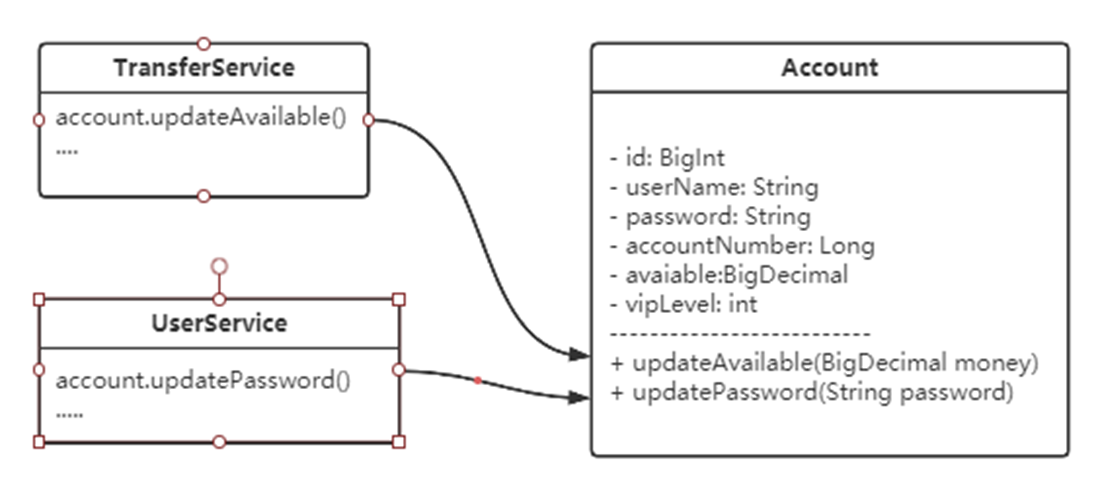
充血模型(Rich Domain Model)将业务逻辑内聚到领域对象本身,对象既有数据,也有行为。
充血模型示例:
java
public class Account {
private Long id;
private Long accountNumber;
private BigDecimal available;
// 转入(商户收到钱)
public void withdraw(BigDecimal money) {
available = available.add(money);
}
// 转出(用户扣钱)
public void deposit(BigDecimal money) {
if (available.compareTo(money) < 0) {
throw new InsufficientMoneyException();
}
available = available.subtract(money);
}
}
优点:
-
业务内敛,变化的影响范围被有效收敛;
-
领域对象自解释,代码即文档;
-
易于单元测试,不依赖基础设施。
缺点:
-
设计难度更高,需要深入理解业务;
-
对团队能力要求较高;
-
若滥用,可能导致模型过度复杂。
充血模型下的业务变更:
充血模型下的模型变更就变得非常简单,模型变更的影响范围也得到有效收敛。
3. 如何取舍?——没有银弹,只有权衡
对两者进行了全面对比:
| 风格 | 简单直接的草根 | 高雅昂贵的贵族 |
| 团队作战 | 适合快速迭代、多人协作 | 对团队成员业务理解要求高 |
| 组件膨胀 | 易膨胀,Service层越来越重 | 模型稳定,Service很薄 |
| 架构退化风险 | 较高,易变成大泥球 | 较低,边界清晰 |
结论:
-
简单业务、原型验证、维护团队能力参差不齐 → 贫血模型仍然可行,不必强求充血。
-
复杂业务、长期演进、领域逻辑是核心竞争力 → 必须拥抱充血模型,否则系统必然走向老化。
一个实用的渐进策略:
先从充血模型设计领域核心(如账户、订单);
外围非核心功能(如简单的配置查询)可暂时保持贫血;
随着业务发展,逐步将散落在Service的逻辑“向内迁移”。
三、实体与值对象:领域模型的基本构造块
1. 实体(Entity)——有生命周期的唯一事物
实体拥有唯一标识(ID),其属性可以变化,但我们关注的是它是谁,而不是它是什么。
-
例子:Account、Order、User
-
实体通过 ID 进行区分,即使其他属性完全相同,也是不同的个体。
2. 值对象(Value Object)——描述性、不可变、无标识
值对象没有唯一标识,我们只关心它是什么。值对象应该是不可变的,通过构造函数一次性创建,所有属性只读。
-
例子:Money、Address、AccountNumber
-
两个值对象如果所有属性值都相等,则认为它们是相等的(需重写 equals 和 hashCode)。
文档第4页展示了一个典型的 JSON 格式的地址:
json
{
"province": "xxxxx",
"city": "xxxxx",
"address": "xxxxx"
}
思考题:地址到底是实体还是值对象?
-
如果地址只是描述某个位置,不单独追溯其变化历史 → 值对象。
-
如果地址需要被独立管理(例如:房产登记系统,每个地址有唯一产权证号) → 实体。
结论:实体与值对象在不同场景下是可以转换的。关键取决于业务关注点。
3. 实体与实体的关联——通过ID
实体之间通过 ID 引用,而不是直接持有另一个实体的实例。这有助于保持限界上下文的边界清晰,避免跨聚合的强一致性。
4. 实体与值对象的关联——通过信息冗余
实体可以直接持有值对象,例如 Account 持有 Money、Address。值对象的状态变化通过替换整个对象来实现(不可变性)。
四、领域服务:跨实体的业务协调者
1. 什么是领域服务?
领域服务(Domain Service)用来处理那些不适合放在实体或值对象中的业务逻辑。典型场景:
-
涉及多个实体的协作(如转账);
-
需要调用外部资源但希望保持领域层纯净(通过依赖注入接口,实现由基础设施层提供);
-
业务流程无状态。
DDD中的服务定义:
服务表示的就是那些在领域对象之外的操作和行为。
跨实体的业务操作,交由服务来协调。
服务用来隔离业务逻辑与技术实现。
2. 领域服务 vs 应用服务
| 位置 | 领域层 | 应用层 |
| 职责 | 封装核心业务规则,协调实体 | 任务编排、事务管理、权限控制 |
| 依赖 | 只依赖领域层接口 | 依赖领域服务、基础设施 |
| 可复用性 | 跨用例复用 | 通常用例独有 |
最佳实践:领域服务保持极薄,只做逻辑编排,不涉及事务、权限、日志等横切关注点。
五、防腐层:守护领域模型安全的闸门
1. 什么是防腐层(Anti-Corruption Layer, ACL)?
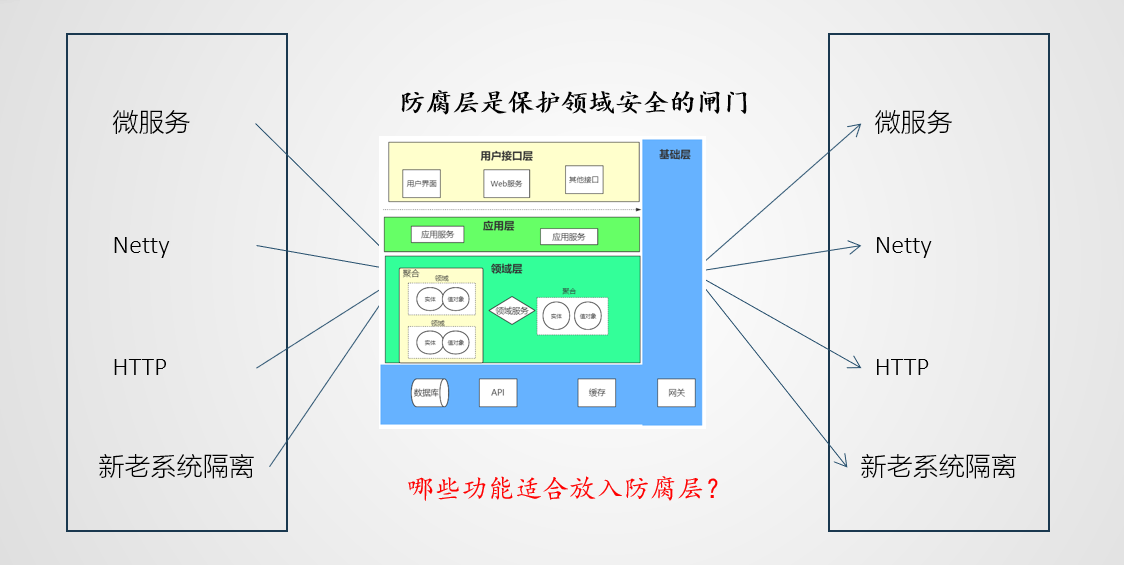
防腐层是 DDD 战略设计中的重要模式,位于领域层与外部系统(包括遗留系统、第三方服务、消息中间件等)之间,负责翻译、隔离、保护。
下图展示了防腐层的角色:
text
微服务 / 外部系统 ←→ [防腐层] ←→ 领域模型
防腐层的核心价值:
-
防止外部概念污染领域模型;
-
将外部模型转换为领域模型,反之亦然;
-
隔离外部系统的变化,降低替换成本。
2. 哪些功能适合放入防腐层?
这个问题,结合实战经验,至少有以下几类:
| 外部RPC调用 | 风控服务、会员服务、短信网关 |
| 技术中间件 | Kafka、Redis、Elasticsearch |
| 遗留系统集成 | 老版本的接口、DB访问 |
| 第三方API | 微信支付、地图服务 |
| 数据格式转换 | XML ↔ JSON,DTO ↔ 领域对象 |
防腐层是保护领域安全的闸门,凡是不属于当前限界上下文的概念,都应在防腐层中被拦截、翻译。
六、小结
这一讲我们从应用架构的高度,重新审视了DDD战术设计中的四个核心概念:
贫血模型 vs 充血模型
-
没有绝对的对错,需要根据业务复杂度、团队能力、演进阶段灵活取舍。
-
充血模型是应对复杂业务、防止系统老化的关键武器。
实体与值对象
-
实体有ID,关注生命周期;值对象无ID,关注描述。
-
场景决定身份——同一事物在不同上下文中可以是实体也可以是值对象。
领域服务
-
处理跨实体的业务逻辑,保持领域层纯净。
-
只做协调,不做具体实现。
防腐层
-
领域层的“防火墙”,隔离一切外部污染。
-
不仅隔离技术实现,更隔离业务概念的泄漏。
DDD 的战术设计,并不是一堆僵硬的教条,而是一套可以灵活组合的工具箱。 真正的挑战在于:在合适的场景,选择合适的工具,并且知道什么时候可以放弃它。
七、思考题
贫血模型与充血模型有什么区别?如何进行取舍?
——结合你当前的项目,哪些模块适合用充血模型重构?哪些模块可以维持贫血?
服务、实体、值对象如何定义?如何区分?
——在你的工作中,有没有可以进行类似抽象的业务场景?试着画一个简单的领域模型。
防腐层如何设计?还有哪些功能可以放到防腐层中?
——除了外部服务,配置中心、缓存、文件存储是否也值得用防腐层隔离?
对于未来不确定的业务变化,还有哪些问题是这几个概念工具解决不了的?
——DDD 不是万能的,它的局限性在哪里?当你遇到这些局限时,会采用什么补充手段?