目录
-
-
- Python爬虫技术选型
- 数据清洗与预处理
- 热度分析模型构建
- 可视化系统设计
- 性能优化与部署
- 伦理与法律合规
- 开发技术路线
- 源码lw获取/同行可拿货,招校园代理 :文章底部获取博主联系方式!
-
Python爬虫技术选型
选择Scrapy或Requests+BeautifulSoup框架,针对小说网站结构设计爬虫规则,处理反爬机制(如动态加载、验证码)。需包含URL去重、增量爬取策略,数据存储至MySQL或MongoDB。
数据清洗与预处理
正则表达式清理HTML标签与广告文本,jieba分词提取关键词,统计章节更新频率、评论数等指标。使用pandas处理缺失值与异常数据,构建结构化数据表。
热度分析模型构建
基于时间序列分析(ARIMA)预测阅读量趋势,TF-IDF加权计算话题热度,协同过滤算法推荐相似小说。引入情感分析(NLP库)评估读者评论倾向。
可视化系统设计
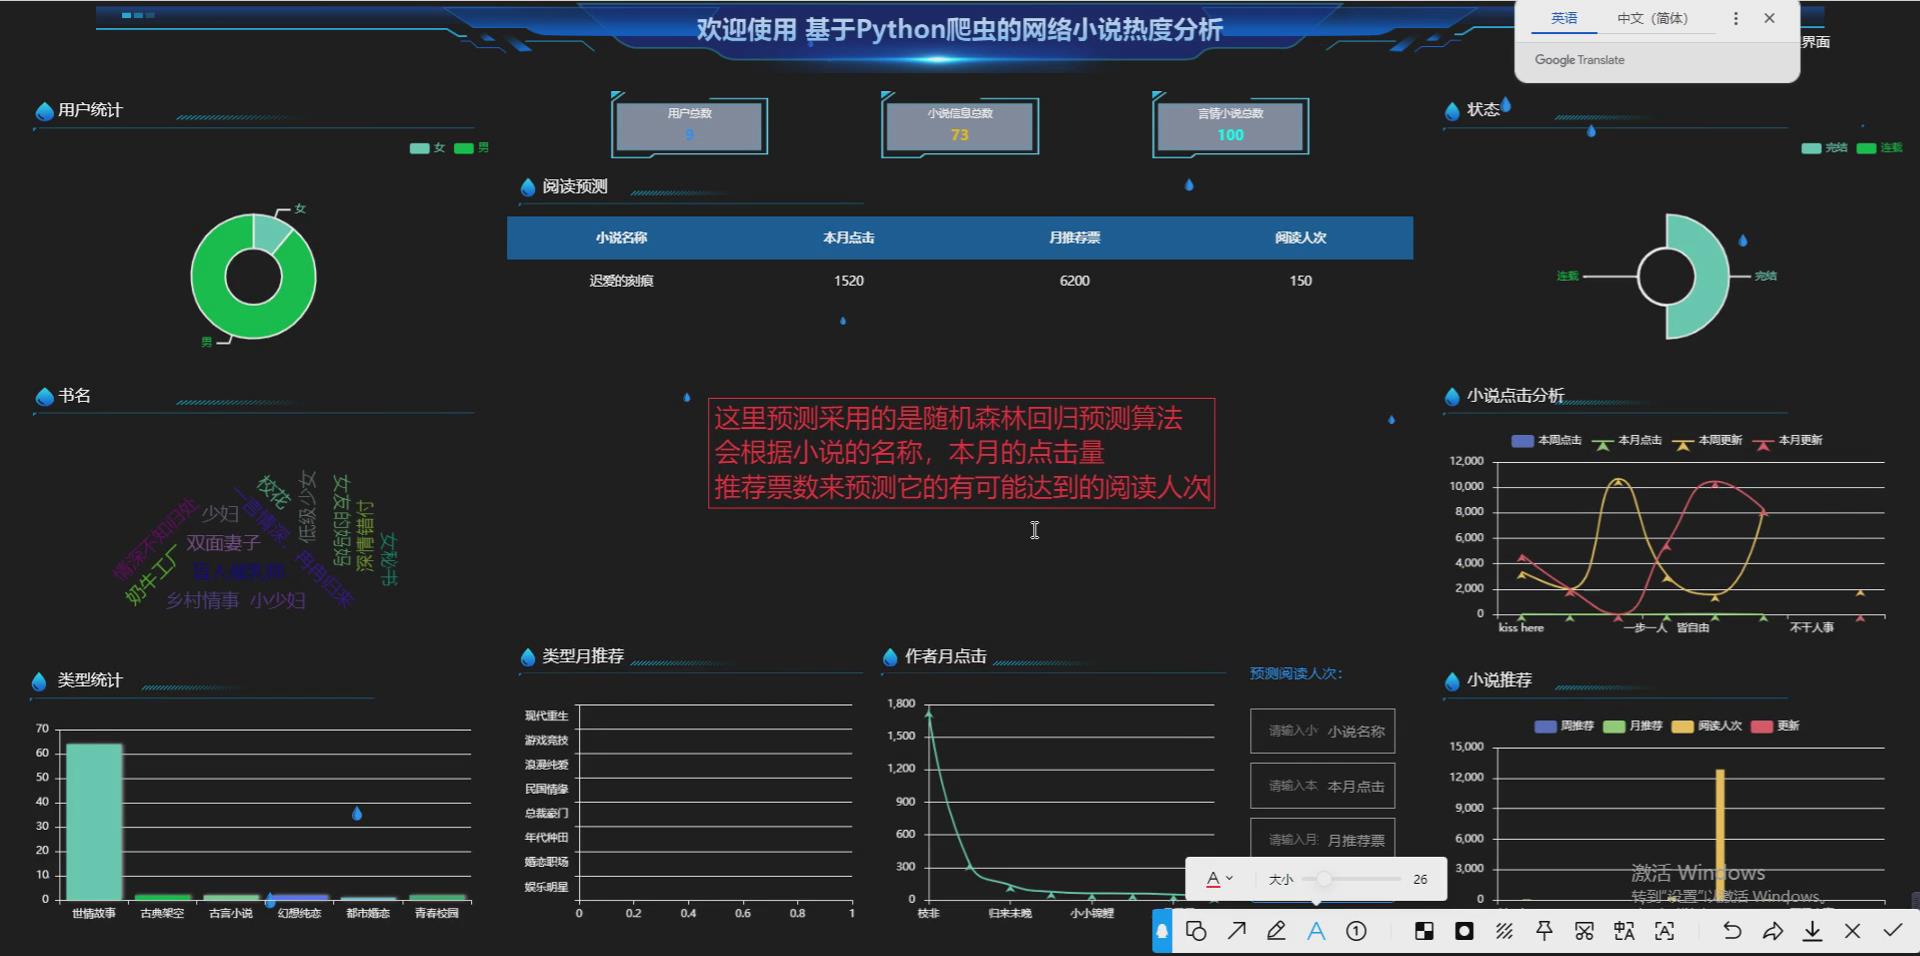
Flask或Django搭建后端接口,ECharts/Pyecharts实现动态图表:
- 热词云图展示高频标签
- 折线图对比多部小说月度热度
- 地理分布图显示读者地域密度
- 桑基图刻画读者流失路径
性能优化与部署
多线程爬虫加速,Redis缓存高频查询结果。Docker容器化部署,Nginx负载均衡,Prometheus监控系统资源占用。
伦理与法律合规
明确Robots协议限制,匿名化处理用户数据,避免侵犯版权。采用代理IP轮换降低封禁风险。
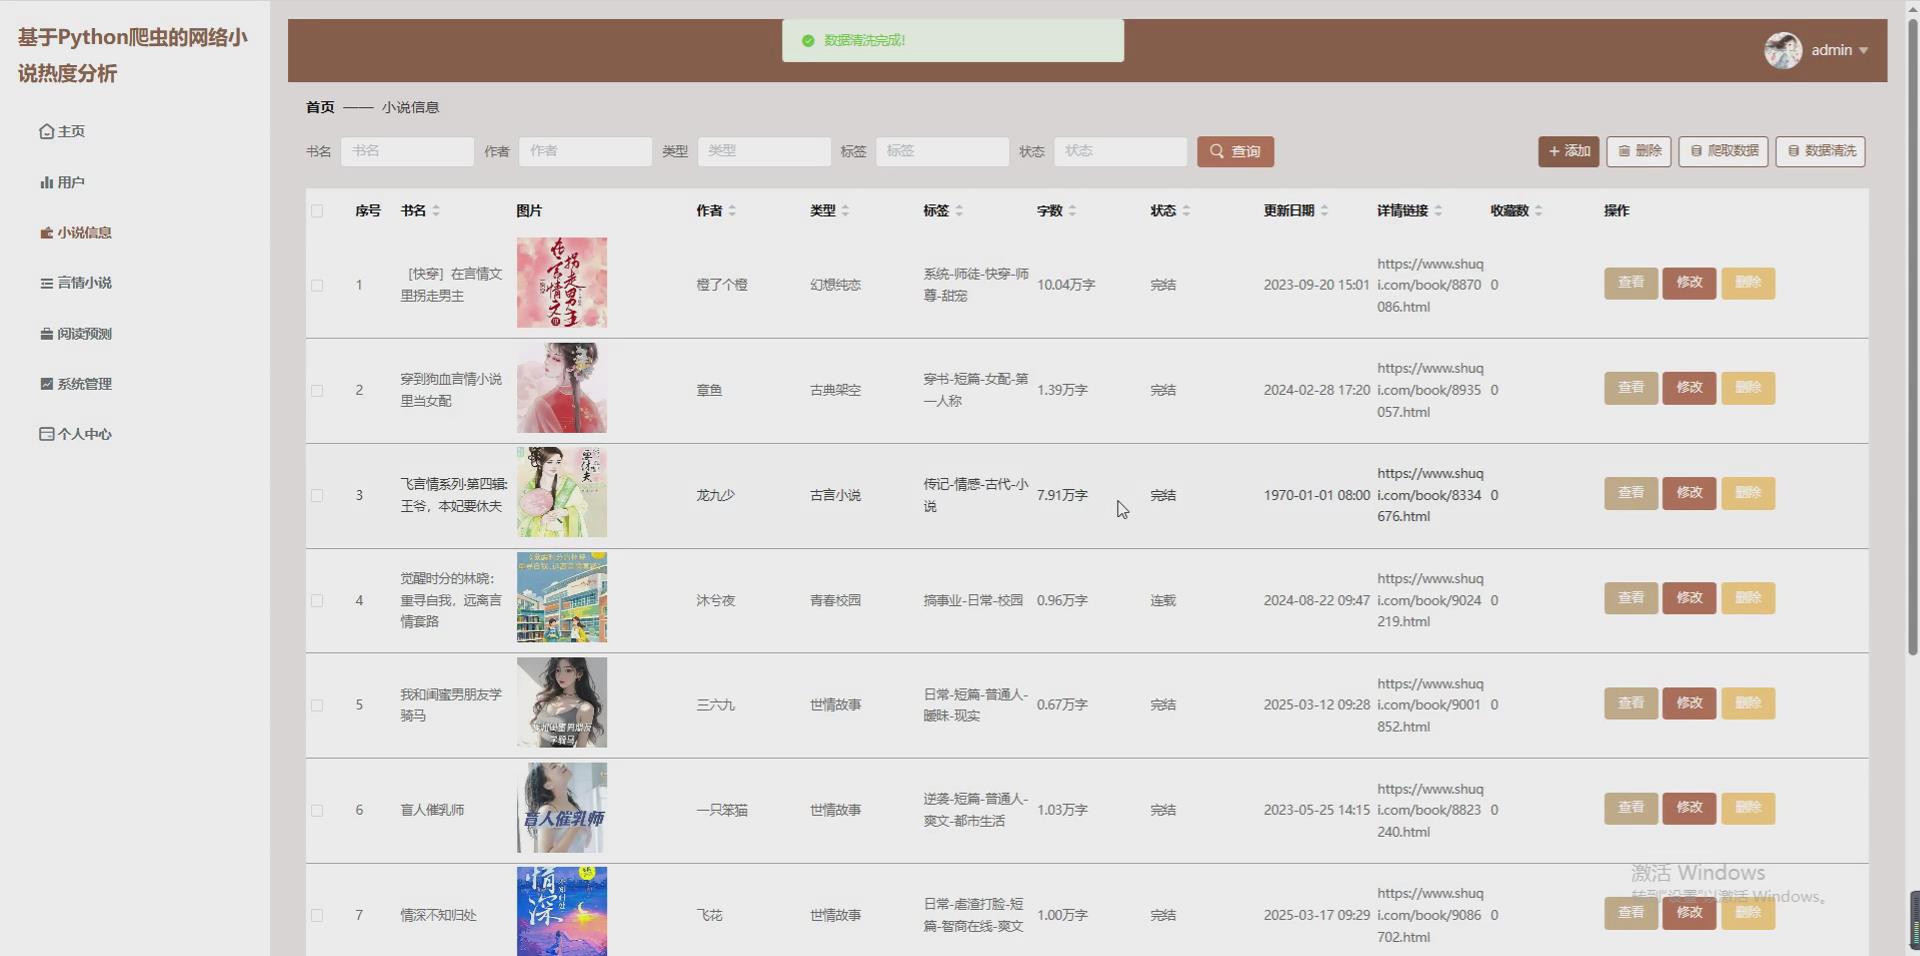
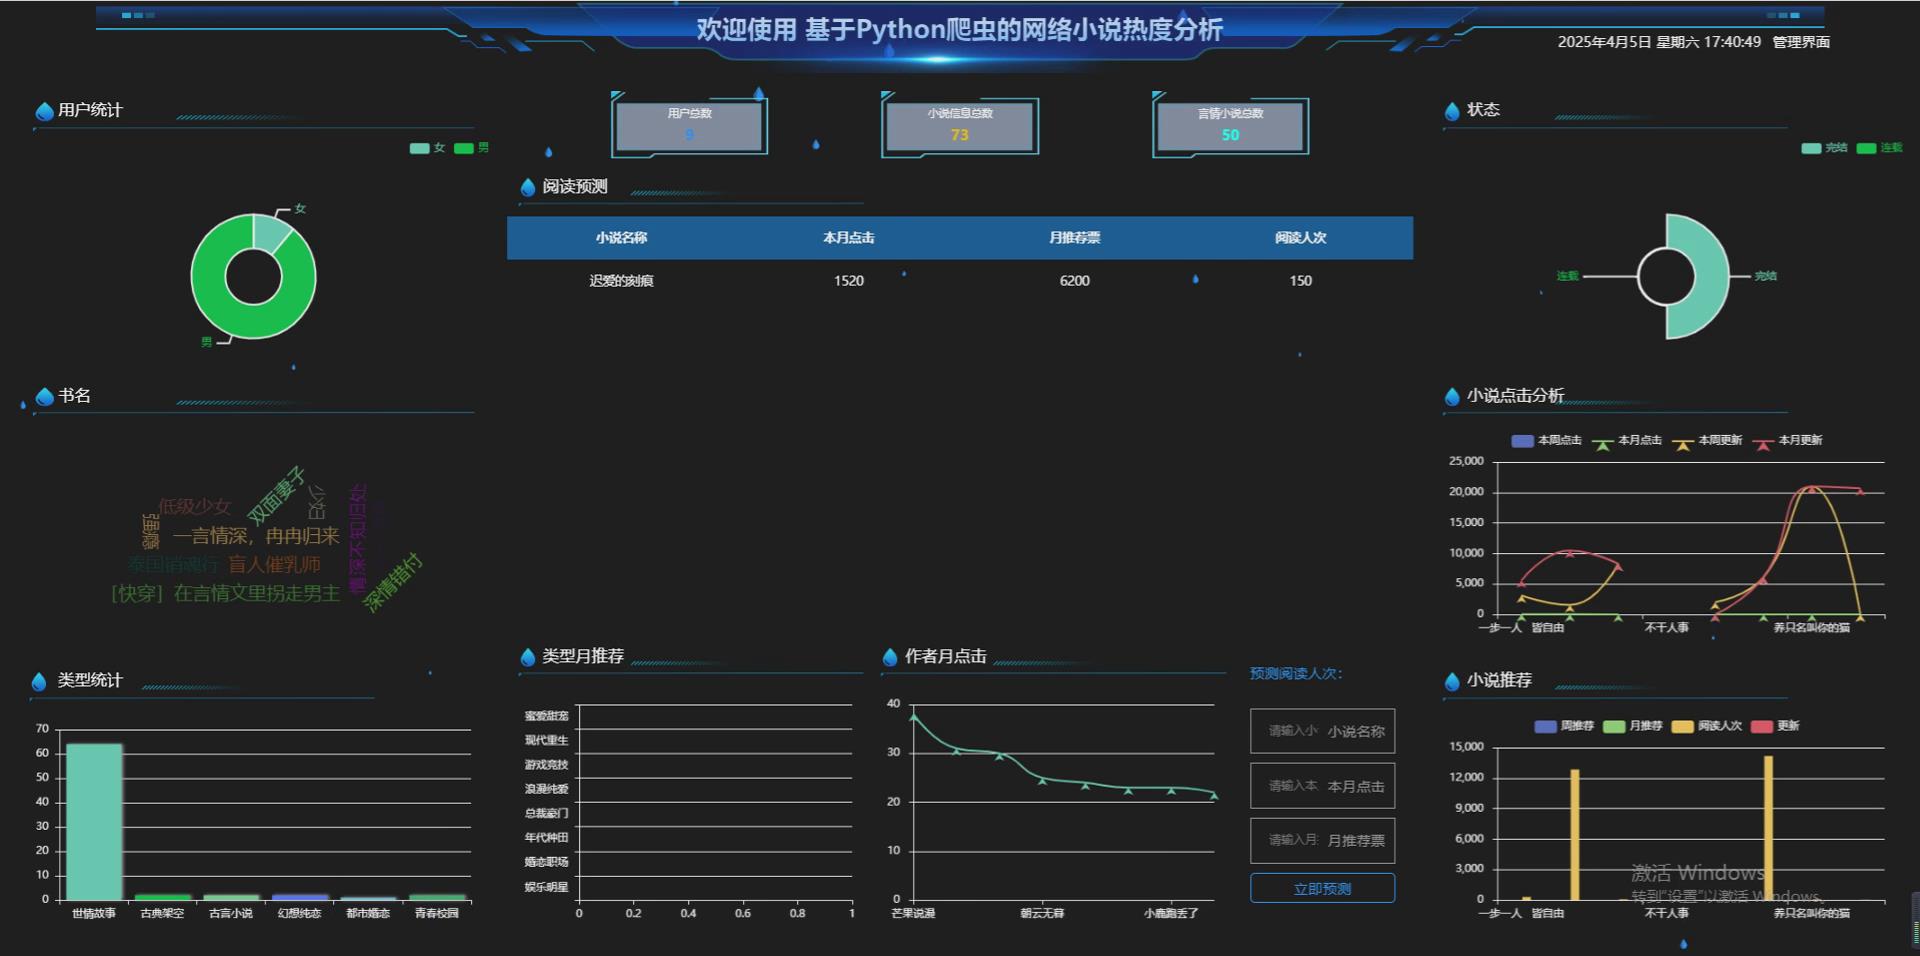
开发技术路线
开发语言:Python 框架:flask/django 开发软件:PyCharm/vscode 数据库:mysql 数据库工具:Navicat for mysql 前端开发框架:vue.js 数据库 mysql 版本不限 本系统后端语言框架支持: 1 java(SSM/springboot)-idea/eclipse 2.Nodejs+Vue.js -vscode 3.python(flask/django)–pycharm/vscode 4.php(thinkphp/laravel)-hbuilderx
源码lw获取/同行可拿货,招校园代理 :文章底部获取博主联系方式!
需要成品或者定制,文章最下方名片联系我即可~ 所有项目都经过测试完善,本系统包修改时间和标题,包安装部署运行调试,不满意的可以定制