一、Stacking 算法核心内容
Stacking的核心是分层学习:
二、Stacking 算法公式
前提假设
- 训练集为

- 第一层有 m 个基学习器:

- 第二层元学习器:g
1. 交叉验证生成第一层特征——以K折CV为例
对每个基学习器  :
- 将训练集 D 分成 K 份:
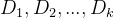
- 对第 i 折(i=1,2,…,K):用D或
 训练,用训练好的预测 ,得到该折的预测值

- 拼接所有折的预测值,得到训练集上的第一层特征:
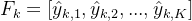
2. 构建元学习器的训练集
第一层所有基学习器的特征拼接成新特征矩阵:

元学习器的训练集为:(F,y),其中
3. 训练元学习器

(L 为损失函数,如分类用交叉熵、回归用均方误差)
4. 预测阶段
对新样本 x:
- 第一层所有基学习器预测:
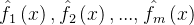
- 拼接成新特征:

- 元学习器输出最终预测:

三、Stacking 算法代码演示
模块一:导入核心库
import numpy as np # 数值计算
import pandas as pd # 数据处理
from sklearn.datasets import load_iris # 加载鸢尾花数据集
from sklearn.model_selection import train_test_split, cross_val_predict # 数据集划分、交叉验证预测
from sklearn.metrics import accuracy_score # 评估指标(准确率)
# 第一层基学习器
from sklearn.ensemble import RandomForestClassifier # 随机森林
from sklearn.svm import SVC # 支持向量机
from sklearn.neighbors import KNeighborsClassifier # K近邻
# 第二层元学习器
from sklearn.linear_model import LogisticRegression # 逻辑回归
模块二:加载并预处理数据
# 加载鸢尾花数据集
iris = load_iris()
# 特征矩阵 X (150行4列:150个样本,4个特征)
X = iris.data
# 标签 y (150行:3类鸢尾花)
y = iris.target
# 划分训练集和测试集(70%训练,30%测试),固定随机种子保证结果可复现
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.3, random_state=42, stratify=y # stratify=y:保证训练/测试集标签分布一致
)
模块三:定义Stacking的第一层基学习器列表
# 选择3种不同类型的模型,避免单一模型的偏差
base_models = [
('rf', RandomForestClassifier(n_estimators=100, random_state=42)), # 随机森林
('svm', SVC(probability=True, random_state=42)), # SVM(开启probability=True,输出概率)
('knn', KNeighborsClassifier(n_neighbors=5)) # K近邻(k=5)
]
模块四:生成第一层基学习器的训练集特征
# 初始化训练集的第一层特征矩阵(行数=训练集样本数,列数=基学习器数量)
train_meta_features = np.zeros((X_train.shape[0], len(base_models)))
# 遍历每个基学习器,生成交叉验证预测结果作为元特征
for idx, (name, model) in enumerate(base_models):
# cross_val_predict:用5折CV,每折用训练集的90%训练,10%预测,最终拼接所有预测结果
# 这里用predict_proba输出概率(分类任务更优),取每个样本的最大概率类别的概率值
# 注:也可以直接用predict输出类别,概率更能保留信息
cv_preds = cross_val_predict(
model, X_train, y_train, cv=5, method='predict_proba' # method指定输出概率
)
# 取每个样本的最大概率(也可以取所有类别的概率,特征数=类别数×基学习器数)
train_meta_features[:, idx*n_classes : (idx+1)*n_classes] = cv_preds
模块五:生成第一层基学习器的测试集特征
# 初始化测试集的第一层特征矩阵
test_meta_features = np.zeros((X_test.shape[0], len(base_models)))
# 遍历每个基学习器,用完整训练集训练后预测测试集,生成测试集元特征
for idx, (name, model) in enumerate(base_models):
# 用完整训练集训练基学习器
model.fit(X_train, y_train)
# 预测测试集的概率
test_preds = model.predict_proba(X_test)
# 取最大概率作为测试集元特征
test_meta_features[:, idx] = np.max(test_preds, axis=1)
模块六:训练第二层元学习器
# 初始化元学习器
meta_model = LogisticRegression(random_state=42)
# 用第一层生成的元特征训练元学习器
meta_model.fit(train_meta_features, y_train)
模块八:用Stacking模型预测测试集
# 用元学习器预测测试集元特征
stacking_preds = meta_model.predict(test_meta_features)
模块九:评估模型性能
# 计算基学习器各自的准确率(对比效果)
print("===== 基学习器准确率 =====")
for name, model in base_models:
model.fit(X_train, y_train)
base_preds = model.predict(X_test)
acc = accuracy_score(y_test, base_preds)
print(f"{name} 准确率: {acc:.4f}")
# 计算Stacking模型的准确率
print("\\n===== Stacking模型准确率 =====")
stacking_acc = accuracy_score(y_test, stacking_preds)
print(f"Stacking 准确率: {stacking_acc:.4f}")
运行结果
===== 基学习器准确率 =====
rf 准确率: 0.8889
svm 准确率: 0.9556
knn 准确率: 0.9778
===== Stacking模型准确率 =====
Stacking 准确率: 0.9556
(注:鸢尾花数据集简单,Stacking 提升可能不明显,但在复杂数据集上,Stacking 通常能显著提升效果。对于代码中使用的基线模型,如果大家有不清楚的部分,大家可以看之前的文章,都有提到。)
四、总结
- 核心逻辑:Stacking 分两层,第一层用 CV 生成基模型的预测特征,第二层用元模型融合这些特征,核心是 “用预测结果做新特征”;
- 关键公式:核心是通过交叉验证生成第一层特征矩阵 F,再训练元模型。
- 代码要点:
- 用cross_val_predict避免第一层过拟合;
- 基学习器选不同类型,如树模型 + 线性模型 + 核模型,提升多样性;
- 分类任务用predict_proba输出概率,比直接输出类别更有效。