目录
一、基础概念与项目结构
(一)链式二叉树核心特性
(二)二叉链与三叉链的区别
(三)项目文件结构与详细分工
(四)结点结构定义
(五)手动创建二叉树
二、二叉树的遍历
(一)前序遍历(根→左→右)
(二)中序遍历(左→根→右)
(三)后序遍历(左→右→根)
(四)层序遍历(广度优先,从上到下→从左到右)
三、二叉树常见操作(递归实现 + 边界情况处理)
(一)统计结点总个数
(二)统计叶子结点个数
(三)统计第 k 层结点个数
(四)计算二叉树深度(高度)
(五)查找值为 x 的节点
(六)销毁二叉树(避免内存泄漏)
(七)二叉树递归万能骨架
四、完全二叉树判断(层序遍历应用)
(一)完全二叉树定义
(二)判断思路
(三)代码实现
五、二叉树核心性质(选择题高频考点)
(一)任意二叉树核心公式
(二)完全二叉树的特殊性质
(三)公式总结
六、常见问题与注意事项
(一)递归相关问题
(二)内存管理问题
(三)参数传递问题
一、基础概念与项目结构
(一)链式二叉树核心特性
1、递归本质
二叉树由根结点、左子树、右子树组成,每个子树本身也是二叉树,天然适合递归操作。
2、结点限制
每个结点的度(子结点个数)不超过 2,且左右子树有明确区分。即左子树 ≠ 右子树,交换后为不同二叉树。
3、核心用途
主要用于数据遍历和查找,基础二叉树不讨论插入 / 删除操作;因为无固定结构规则,需平衡树、红黑树等扩展结构支持)。
4、链式存储优势
相比顺序存储(数组),链式结构无需连续内存空间,插入 / 删除(扩展结构中)效率更高,更适合不规则二叉树。
(二)二叉链与三叉链的区别
1、二叉链
(1)结构特点:每个结点含 “数据域 + 左指针 + 右指针”
(2)适用场景:绝大多数场景(遍历、查找、基础操作)
(3)空间开销:较小(每个节点 2 个指针)
2、三叉链
(1)结构特点:每个节点含 “数据域 + 左指针 + 右指针 + 父指针”
(2)适用场景:需要频繁回溯父结点的场景(如二叉树的线索化)
(3)空间开销:较大(每个结点 3 个指针)
(三)项目文件结构与详细分工
1、Tree.h
(1)核心功能:类型定义 + 函数声明
(2)详细内容
① 包含标准头文件(stdio.h、stdlib.h 等); ② 定义结点数据类型(BTDataType);
③ 定义二叉树结点结构(BTNode); ④ 声明遍历、操作、销毁等函数接口。
2、Tree.c
(1)核心功能:函数实现
(2)详细内容
① 实现结点创建(buyNode)、二叉树构造(createBinaryTree);
② 实现前中后序遍历、层序遍历;
③ 实现结点个数、叶子结点数等常用操作;④ 实现二叉树销毁函数。
3、test.c
(1)核心功能:测试用例
(2)详细内容
① 调用 createBinaryTree 构造测试二叉树;
② 调用各类函数验证功能正确性;③ 打印测试结果,对比预期值与实际值。
4、Queue.h
(1)核心功能:队列结构定义
(2)详细内容
① 定义队列节点结构(存储二叉树节点指针)
② 声明队列操作函数(初始化、入队、出队等)
5、Queue.c
(1)核心功能:队列函数实现
(2)详细内容:实现队列的初始化、入队、出队、判空、销毁等操作。
(四)结点结构定义
// Tree.h 中结点结构定义
#include<stdio.h>
#include<stdlib.h>
#include<assert.h>
#include<stdbool.h>
// 定义结点数据类型(可根据需求修改为int等)
typedef char BTDataType;
// 二叉树结点结构
typedef struct BinaryTreeNode {
BTDataType data; // 数据域
struct BinaryTreeNode* left; // 指向左子树的指针
struct BinaryTreeNode* right; // 指向右子树的指针
} BTNode;
1、typedef 的作用
将 struct BinaryTreeNode 简化为 BTNode,避免重复书写长结构体名;BTDataType 可统一修改数据类型,提高代码复用性。
2、结构体内指针说明
为什么在结构体还未定义完成时,就可以定义这个结构体的指针呢?在 C 语言中,当你开始写struct BinaryTreeNode { … }时,编译器在看到结构体标签BinaryTreeNode的那一刻,就已经知道了这个结构体类型的存在,只是还不知道它的完整大小和成员布局。
对于指针类型来说,编译器并不需要知道结构体的完整定义就能确定指针的大小。指针大小只和系统位数有关,比如 32 位系统是 4 字节,64 位是 8 字节。因此:
你不能在结构体内部直接声明struct BinaryTreeNode left;(非指针),因为此时编译器不知道这个结构体的完整大小,无法分配内存;
但你可以声明struct BinaryTreeNode* left;(指针),因为指针的大小是固定的,编译器不需要知道结构体的完整定义就能确定这个成员的大小。
这种写法在链表、树等数据结构中是标准且必须的,否则无法实现递归式的结构定义。比如二叉树的每个结点都要指向同类型的子结点。
3、指针类型说明
left 和 right 是指向 struct BinaryTreeNode 类型的指针,因结构体未定义完成时无法使用别名BTNode,故需写完整结构体名。
(五)手动创建二叉树
BTNode* buyNode(char x)
{
BTNode* node = (BTNode*)malloc(sizeof(BTNode));
node->data = x;
node->left = node->right = NULL;
return node;
}
BTNode* creatBinaryTree()
{
BTNode* nodeA = buyNode('A');
BTNode* nodeB = buyNode('B');
BTNode* nodeC = buyNode('C');
BTNode* nodeD = buyNode('D');
BTNode* nodeE = buyNode('E');
BTNode* nodeF = buyNode('F');
nodeA->left = nodeB;
nodeA->right = nodeC;
nodeB->left = nodeD;
nodeC->left = nodeE;
nodeC->right = nodeF;
return nodeA;
}
void test01()
{
BTNode* root = creatBinaryTree();
}
buyNode 函数,负责创建单个二叉树结点,初始化数据和左右子树指针;creatBinaryTree 函数,通过手动创建多个结点,并指定它们之间的父子关系,构建一棵完整的二叉树;test01 测试函数,调用构建函数得到二叉树的根结点,完成树的初始化。
手动构建二叉树的整体逻辑就是,我们先初始化多个结点,然后再去指定他们的父子关系,最后返回根结点,完成二叉树的初始化。
二、二叉树的遍历
遍历的核心是:按规则访问所有结点。前中后序遍历属于深度优先遍历(DFS),层序遍历属于广度优先遍历(BFS)。
(一)前序遍历(根→左→右)
1、核心规则
先访问根结点 → 递归遍历左子树 → 递归遍历右子树(根结点的访问时机在最前)。
2、代码实现与逐行解析
// Tree.c 前序遍历实现
void preOrder(BTNode* root) {
// 递归终止条件:空节点打印NULL并返回(避免访问空指针)
if (root == NULL) {
printf("NULL ");
return;
}
// 访问根结点:打印当前结点数据(字符类型)
printf("%c ", root->data);
// 递归遍历左子树(左子树是一棵二叉树,复用preOrder逻辑)
preOrder(root->left);
// 递归遍历右子树(右子树是一棵二叉树,复用preOrder逻辑)
preOrder(root->right);
}
3、递归栈帧可视化(以二叉树 A (B (D), C (E,F)) 为例)
|
递归 步骤 |
栈帧状态 (root 指针指向) |
执行操作 |
输出结果 |
|
1 |
root = A(非空) |
打印 'A' → 递归调用 preOrder (A->left) |
A |
|
2 |
root = B(非空) |
打印 'B' → 递归调用 preOrder (B->left) |
A B |
|
3 |
root = D(非空) |
打印 'D' → 递归调用 preOrder (D->left) |
A B D |
|
4 |
root = NULL(D 的左子树) |
打印 'NULL' → 返回上一层 |
A B D NULL |
|
5 |
root = D(返回步骤 3) |
递归调用 preOrder (D->right) |
– |
|
6 |
root = NULL(D 的右子树) |
打印 'NULL' → 返回上一层 |
A B D NULL NULL |
|
7 |
root = B(返回步骤 2) |
递归调用 preOrder (B->right) |
– |
|
8 |
root = NULL(B 的右子树) |
打印 'NULL' → 返回上一层 |
A B D NULL NULL NULL |
|
9 |
root = A(返回步骤 1) |
递归调用 preOrder (A->right) |
– |
|
10 |
root = C(非空) |
打印 'C' → 递归调用 preOrder (C->left) |
A B D NULL NULL NULL C |
|
11 |
root = E(非空) |
打印 'E' → 递归调用 preOrder (E->left) |
A B D NULL NULL NULL C E |
|
12 |
root = NULL(E 的左子树) |
打印 'NULL' → 返回上一层 |
A B D NULL NULL NULL C E NULL |
|
13 |
root = E(返回步骤 11) |
递归调用 preOrder (E->right) |
– |
|
14 |
root = NULL(E 的右子树) |
打印 'NULL' → 返回上一层 |
A B D NULL NULL NULL C E NULL NULL |
|
15 |
root = C(返回步骤 10) |
递归调用 preOrder (C->right) |
– |
|
16 |
root = F(非空) |
打印 'F' → 递归调用 preOrder (F->left) |
A B D NULL NULL NULL C E NULL NULL F |
|
17 |
root = NULL(F 的左子树) |
打印 'NULL' → 返回上一层 |
A B D NULL NULL NULL C E NULL NULL F NULL |
|
18 |
root = F(返回步骤 16) |
递归调用 preOrder (F->right) |
– |
|
19 |
root = NULL(F 的右子树) |
打印 'NULL' → 返回上一层 |
A B D NULL NULL NULL C E NULL NULL F NULL NULL |
|
20 |
所有栈帧销毁 |
遍历结束 |
最终输出:A B D NULL NULL NULL C E NULL NULL F NULL NULL |
(二)中序遍历(左→根→右)
1、核心规则
先递归遍历左子树 → 访问根结点 → 递归遍历右子树(根结点的访问时机在中间)。
2、代码实现与关键差异
void InOrder(BTNode* root) {
if (root == NULL) {
printf("NULL ");
return;
}
InOrder(root->left); // 先遍历左子树(与前序的核心差异)
printf("%c ", root->data); // 中间访问根节点
InOrder(root->right); // 最后遍历右子树
}
与前序的差异:仅调整了 printf 与递归调用的顺序,左子树遍历完成后才访问根结点。
3、遍历结果:NULL D NULL B NULL A NULL E NULL C NULL F NULL
(三)后序遍历(左→右→根)
1、核心规则
先递归遍历左子树 → 递归遍历右子树 → 访问根结点(根结点的访问时机在最后)。
2、代码实现
void postOrder(BTNode* root) {
if (root == NULL) {
printf("NULL ");
return;
}
postOrder(root->left); // 先遍历左子树
postOrder(root->right); // 再遍历右子树
printf("%c ", root->data); // 最后访问根结点(与前序、中序的核心差异)
}
3、遍历结果:NULL NULL D NULL B NULL NULL E NULL NULL F C A
(四)层序遍历(广度优先,从上到下→从左到右)
1、核心思路
借助队列实现 “先进先出”,确保按层级访问结点:
(1)根结点入队,初始化队列;
(2)队列非空时,出队队头结点并访问;
(3)将队头结点的非空左、右子结点依次入队;
(4)重复步骤 2-3,直至队列为空。
2、队列结构定义
// Queue.h
#include"Tree.h" // 包含二叉树结点定义
// 队列结点结构(存储二叉树节点指针)
typedef struct QueueNode {
BTNode* data; // 数据域:指向二叉树结点
struct QueueNode* next; // 指针域:指向下一个队列结点
} QueueNode;
// 队列结构(队头+队尾指针,方便入队出队)
typedef struct Queue {
QueueNode* front; // 队头指针
QueueNode* rear; // 队尾指针
} Queue;
3、层序遍历代码实现与解析
// Tree.c 层序遍历实现
#include"Queue.h" // 包含队列操作声明
void LevelOrder(BTNode* root)
{
Queue q;
QueueInit(&q); // 初始化队列
// 根结点非空时入队
if (root != NULL) {
QueuePush(&q, root);
}
// 队列非空循环
while (!QueueEmpty(&q)) {
// 出队队头结点
BTNode* top = QueueFront(&q); // 获取队头结点
QueuePop(&q); // 队头结点出队
// 访问队头结点(打印数据)
printf("%c ", top->data);
// 左子结点非空入队
if (top->left != NULL) {
QueuePush(&q, top->left);
}
// 右子结点非空入队
if (top->right != NULL) {
QueuePush(&q, top->right);
}
}
QueueDestroy(&q); // 销毁队列,避免内存泄漏
}
4、遍历结果:A B C D E F
三、二叉树常见操作(递归实现 + 边界情况处理)
所有操作均基于递归思想,核心是 “分解子问题” :将二叉树操作拆解为 “根结点操作 + 左子树操作 + 右子树操作” 。
(一)统计结点总个数
1、核心思路
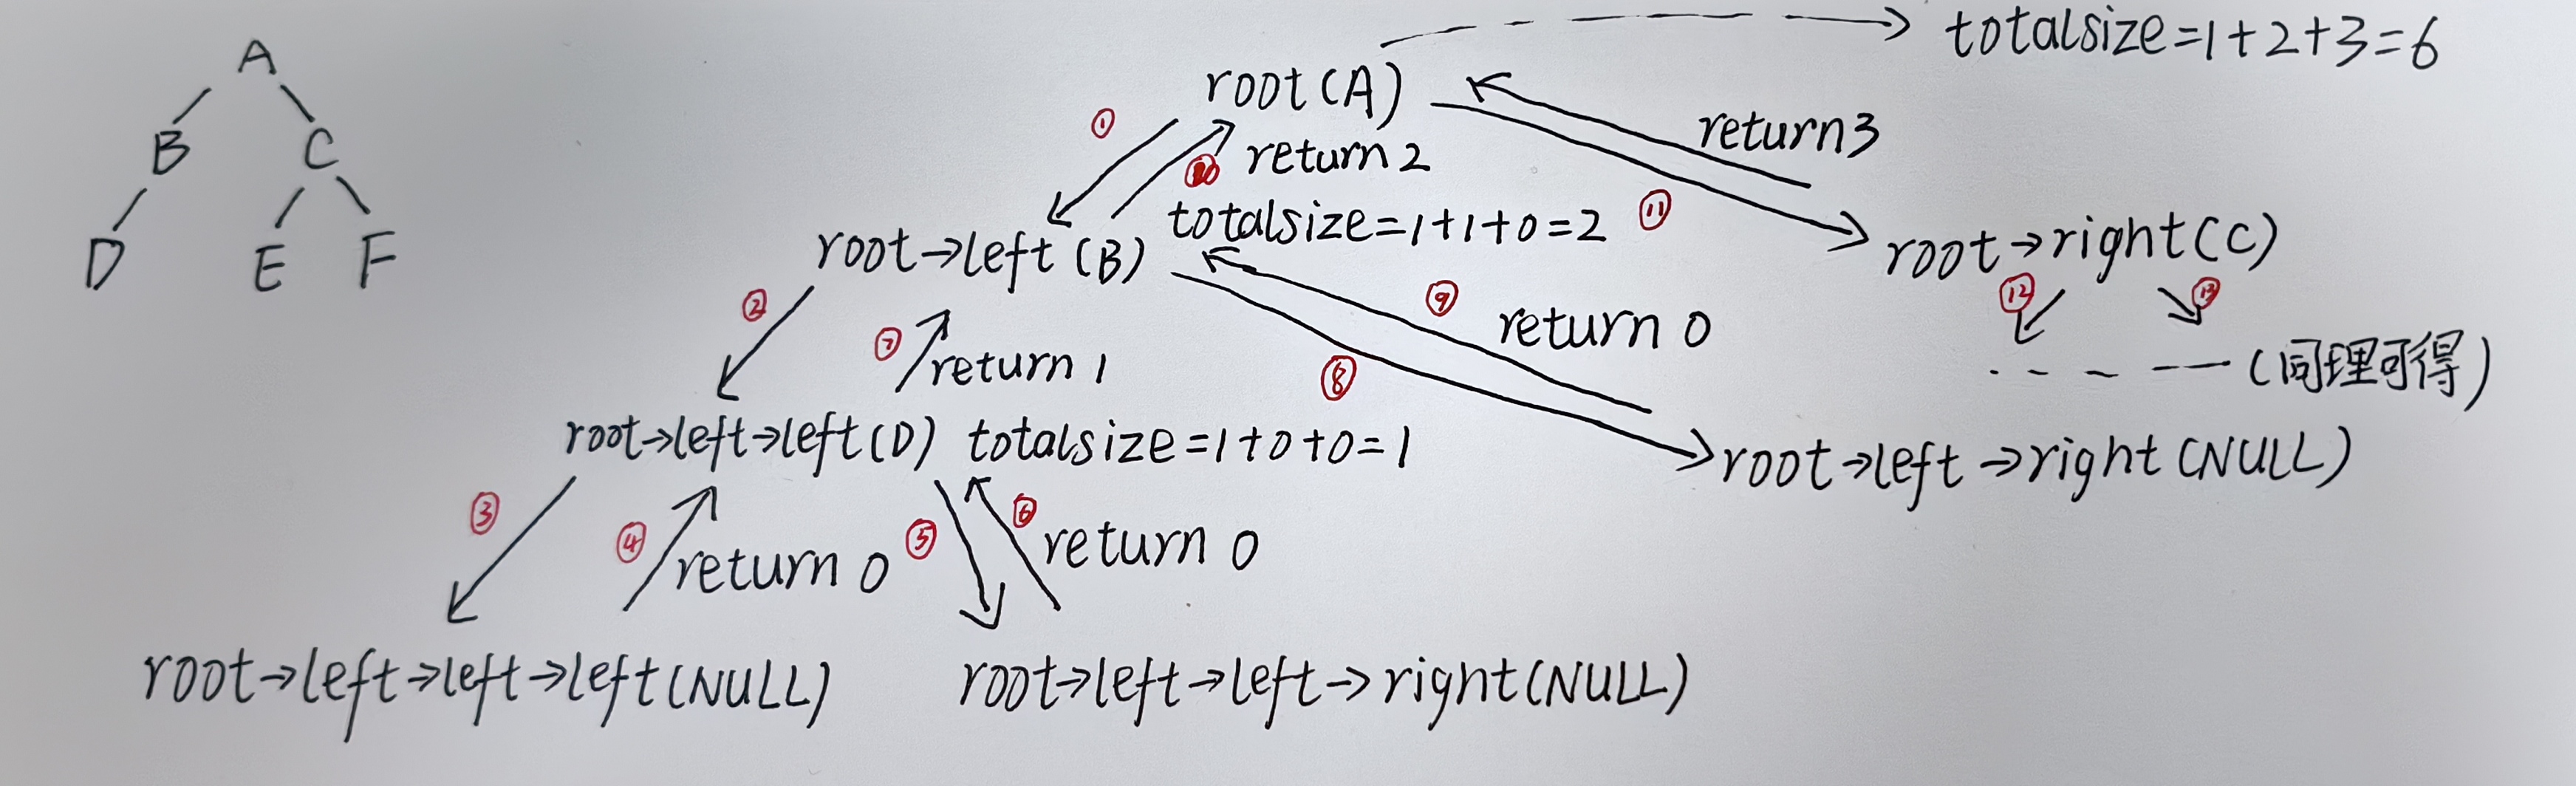
总结点数 = 1(当前根节点) + 左子树节点数 + 右子树节点数,空节点返回 0
2、代码实现
(1)易懂写法
// 计算二叉树的总节点数(拆解版,新手友好)
int BinaryTreeSize(BTNode* root) {
// 第一步:递归终止条件(出口)
// 如果当前结点是空的(NULL),说明这个位置没有结点,返回0
if (root == NULL) {
return 0;
}
// 第二步:递归计算左子树的结点数
// 把当前结点的左孩子作为新的根,计算左子树有多少个结点
int leftSize = BinaryTreeSize(root->left);
// 第三步:递归计算右子树的结点数
// 把当前结点的右孩子作为新的根,计算右子树有多少个结点
int rightSize = BinaryTreeSize(root->right);
// 第四步:汇总结果
// 总结点数 = 当前结点(1个) + 左子树结点数 + 右子树结点数
int totalSize = 1 + leftSize + rightSize;
return totalSize;
}
具体的执行,可以参考下图:
(2)高效写法(不设计额外变量,直接相交)
int BinaryTreeSize(BTNode* root) {
// 边界情况:空树返回0
if (root == NULL) {
return 0;
}
// 递归公式:当前节点数 + 左子树节点数 + 右子树节点数
return 1 + BinaryTreeSize(root->left) + BinaryTreeSize(root->right);
}
3、常见错误
❌ 错误 1:使用局部变量累加(每次递归初始化,结果恒为 1);
int BinaryTreeSize(BTNode* root) {
int count = 0; // 局部变量,每次递归都会重新初始化
if (root == NULL) {
return 0;
}
count++; // 每次递归只加1
BinaryTreeSize(root->left);
BinaryTreeSize(root->right);
return count; // 永远返回1
}
❌ 错误 2:使用全局变量累加(连续调用时结果叠加,即第一次调用如果为6,第二次调用就会为12,计数结果叠加。);
int count = 0; // 全局变量
int BinaryTreeSize(BTNode* root) {
if (root == NULL) {
return 0;
}
count++; // 累加全局变量
BinaryTreeSize(root->left);
BinaryTreeSize(root->right);
return count;
}
✅ 正确:通过返回值递归累加,无状态依赖。(即代码思路中的写法)
(二)统计叶子结点个数
1、叶子结点定义:左右子树均为空的节点(度为 0 的结点)。
2、思路
(1)空结点返回 0;
(2)若当前结点是叶子结点返回 1;
(3)否则返回左、右子树叶子结点数之和。
3、代码实现
(1)易懂写法
// 统计叶子结点数(通俗易懂版)
int BinaryTreeLeafSize(BTNode* root)
{
// 规则1:空结点,没得算,贡献0个叶子
if (root == NULL) {
return 0;
}
// 规则2:左右都空,这就是叶子,贡献1个
if (root->left == NULL && root->right == NULL) {
return 1;
}
// 规则3:既不空也不是叶子,就去问左、右子树要结果
int leftLeaf = BinaryTreeLeafSize(root->left); // 左子树有多少叶子
int rightLeaf = BinaryTreeLeafSize(root->right);// 右子树有多少叶子
return leftLeaf + rightLeaf; // 汇总总数
}
(2)高效写法
int BinaryTreeLeafSize(BTNode* root)
{
// 边界情况:空树返回0
if (root == NULL) {
return 0;
}
// 叶子结点判断:左右子树均为空
if (root->left == NULL && root->right == NULL) {
return 1;
}
// 非叶子结点:递归累加左右子树叶子数
return BinaryTreeLeafSize(root->left) + BinaryTreeLeafSize(root->right);
}
(三)统计第 k 层结点个数
1、层级定义:根结点所在层为第 1 层,依次向下递增(第 k 层需 k ≥ 1)。
2、核心思路
(1)空结点返回 0;
(2)k = 1 时(当前层为目标层),返回 1(非空结点);
(3)k > 1 时,递归统计左、右子树的第 k – 1 层节点数之和。
3、代码实现与边界处理
(1)易懂写法
// 统计二叉树第k层的结点个数
int BinaryTreeLevelKSize(BTNode* root, int k)
{
// 边界情况1:空树,不管第几层,结点数都是0
if (root == NULL) {
return 0;
}
// 边界情况2:k是负数/0,层级无效,返回0(比如问第0层、第-2层,没有意义)
if (k <= 0) {
return 0;
}
// 递归中止:递归终止条件——找到第1层(当前层),只有1个结点
if (k == 1) {
return 1;
}
// 核心逻辑:找第k层 = 找左子树的第k-1层 + 找右子树的第k-1层
// 比如找A的第3层 → 找B的第2层 + 找C的第2层
// 找B的第2层 → 找D的第1层 + 找B右子树的第1层(B右是空,返回0)
int leftSubTreeK_1 = BinaryTreeLevelKSize(root->left, k – 1); // 左子树的k-1层节点数
int rightSubTreeK_1 = BinaryTreeLevelKSize(root->right, k – 1); // 右子树的k-1层节点数
// 汇总:当前节点的第k层 = 左子树k-1层 + 右子树k-1层
int total = leftSubTreeK_1 + rightSubTreeK_1;
return total;
}
(2)高效写法
int BinaryTreeLevelKSize(BTNode* root, int k) {
// 边界情况1:空树返回0
if (root == NULL) {
return 0;
}
// 边界情况2:k≤0返回0(无效层级)
if (k <= 0) {
return 0;
}
// 递归终止:第1层返回1
if (k == 1) {
return 1;
}
// 递归公式:第k层节点数 = 左子树第k-1层 + 右子树第k-1层
return BinaryTreeLevelKSize(root->left, k-1) + BinaryTreeLevelKSize(root->right, k-1);
}
4、代码理解
递归中传递第一层的根结点 root 的指针,以及需要计算的结点数的层级,假设 k = 3 。
此时这里的递归逻辑就是 root 指针每次都会往下探一层,k 每次都是向上走一层,当指针到达我需要统计的第 k 层时,就会触发递归终止的条件,进行计数。
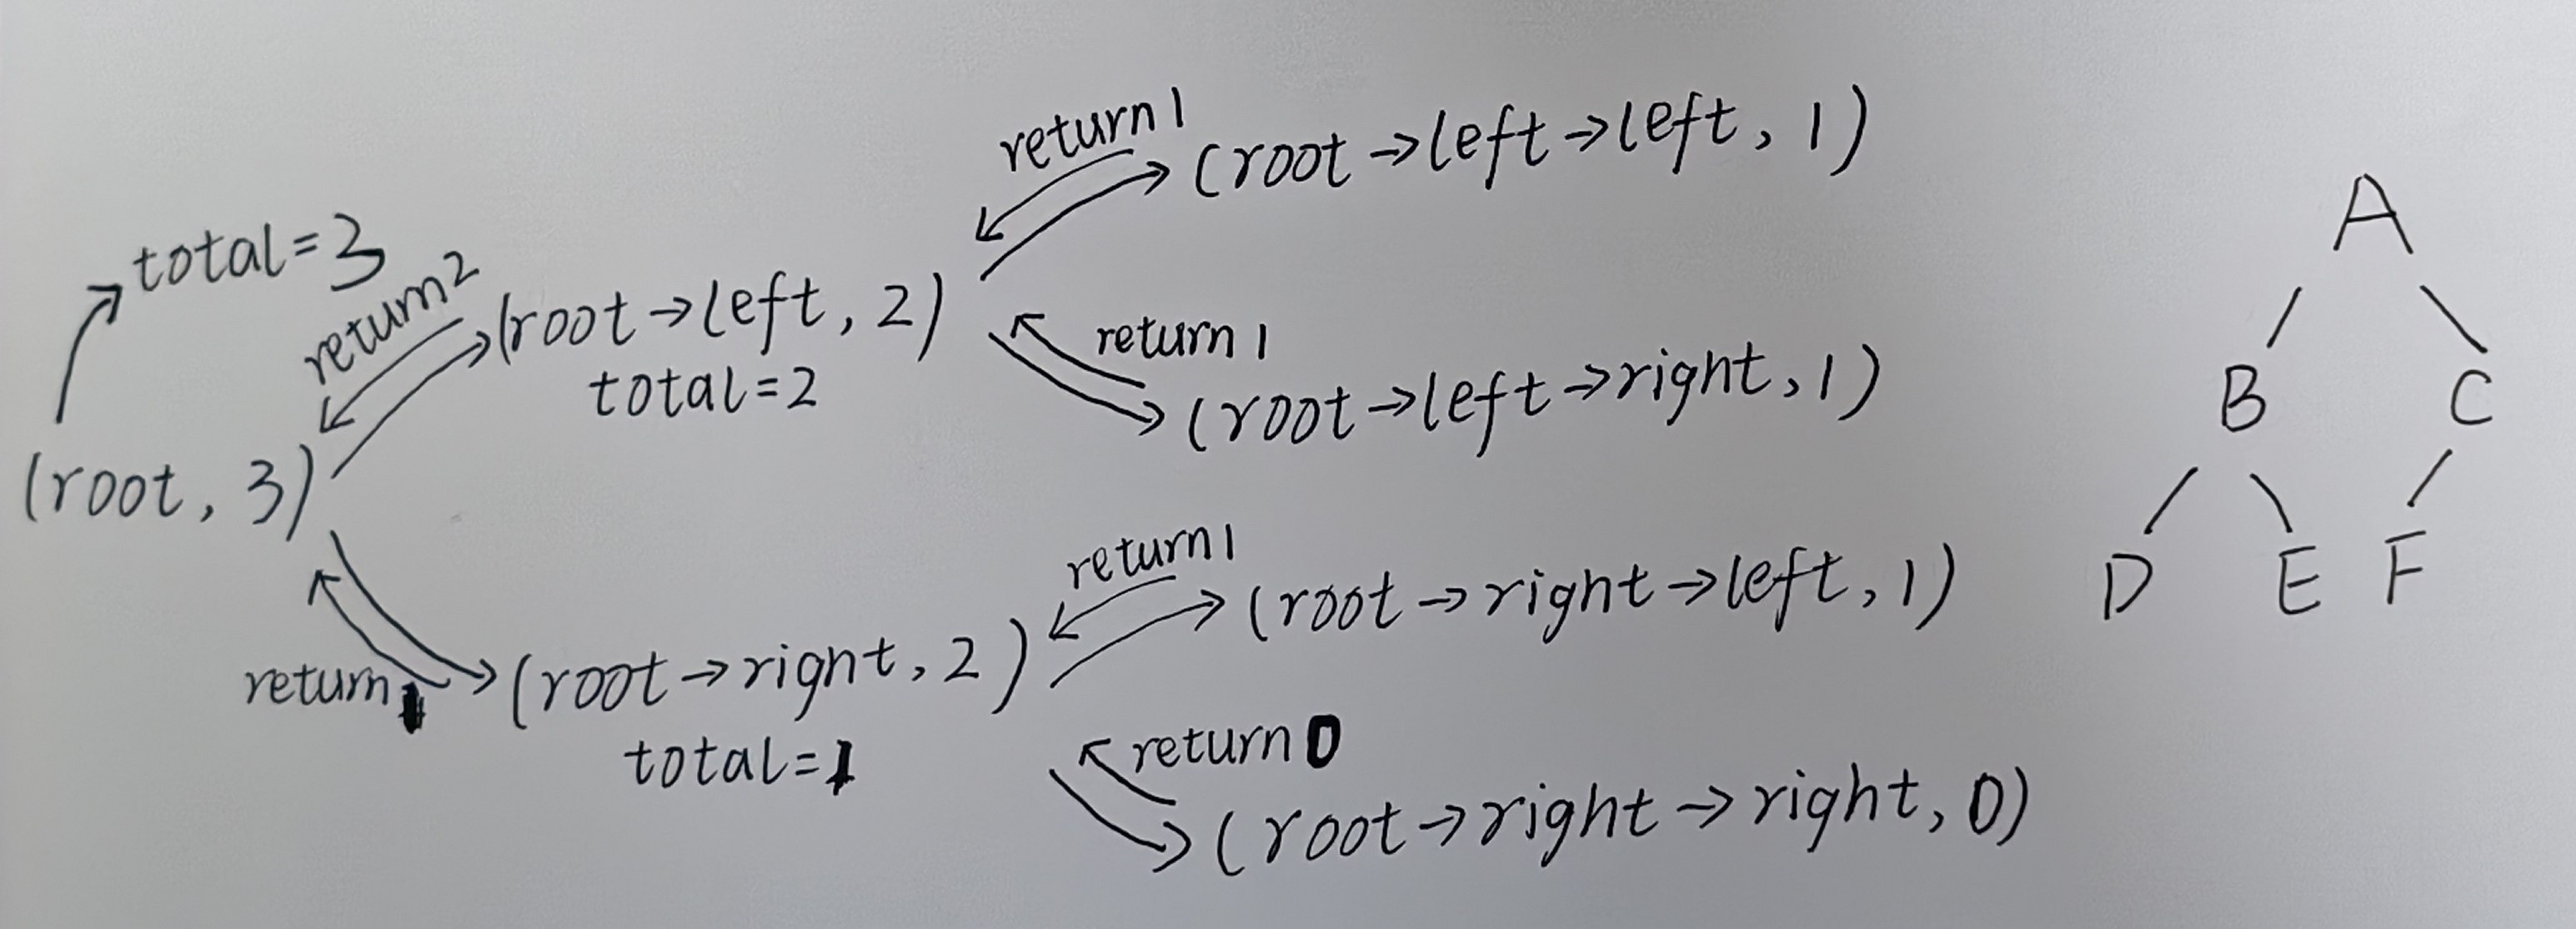
(四)计算二叉树深度(高度)
1、深度定义
从根结点到最远叶子结点的最长路径上的结点数(例:示例二叉树深度为 3)。
2、核心思路
(1)空结点返回 0;
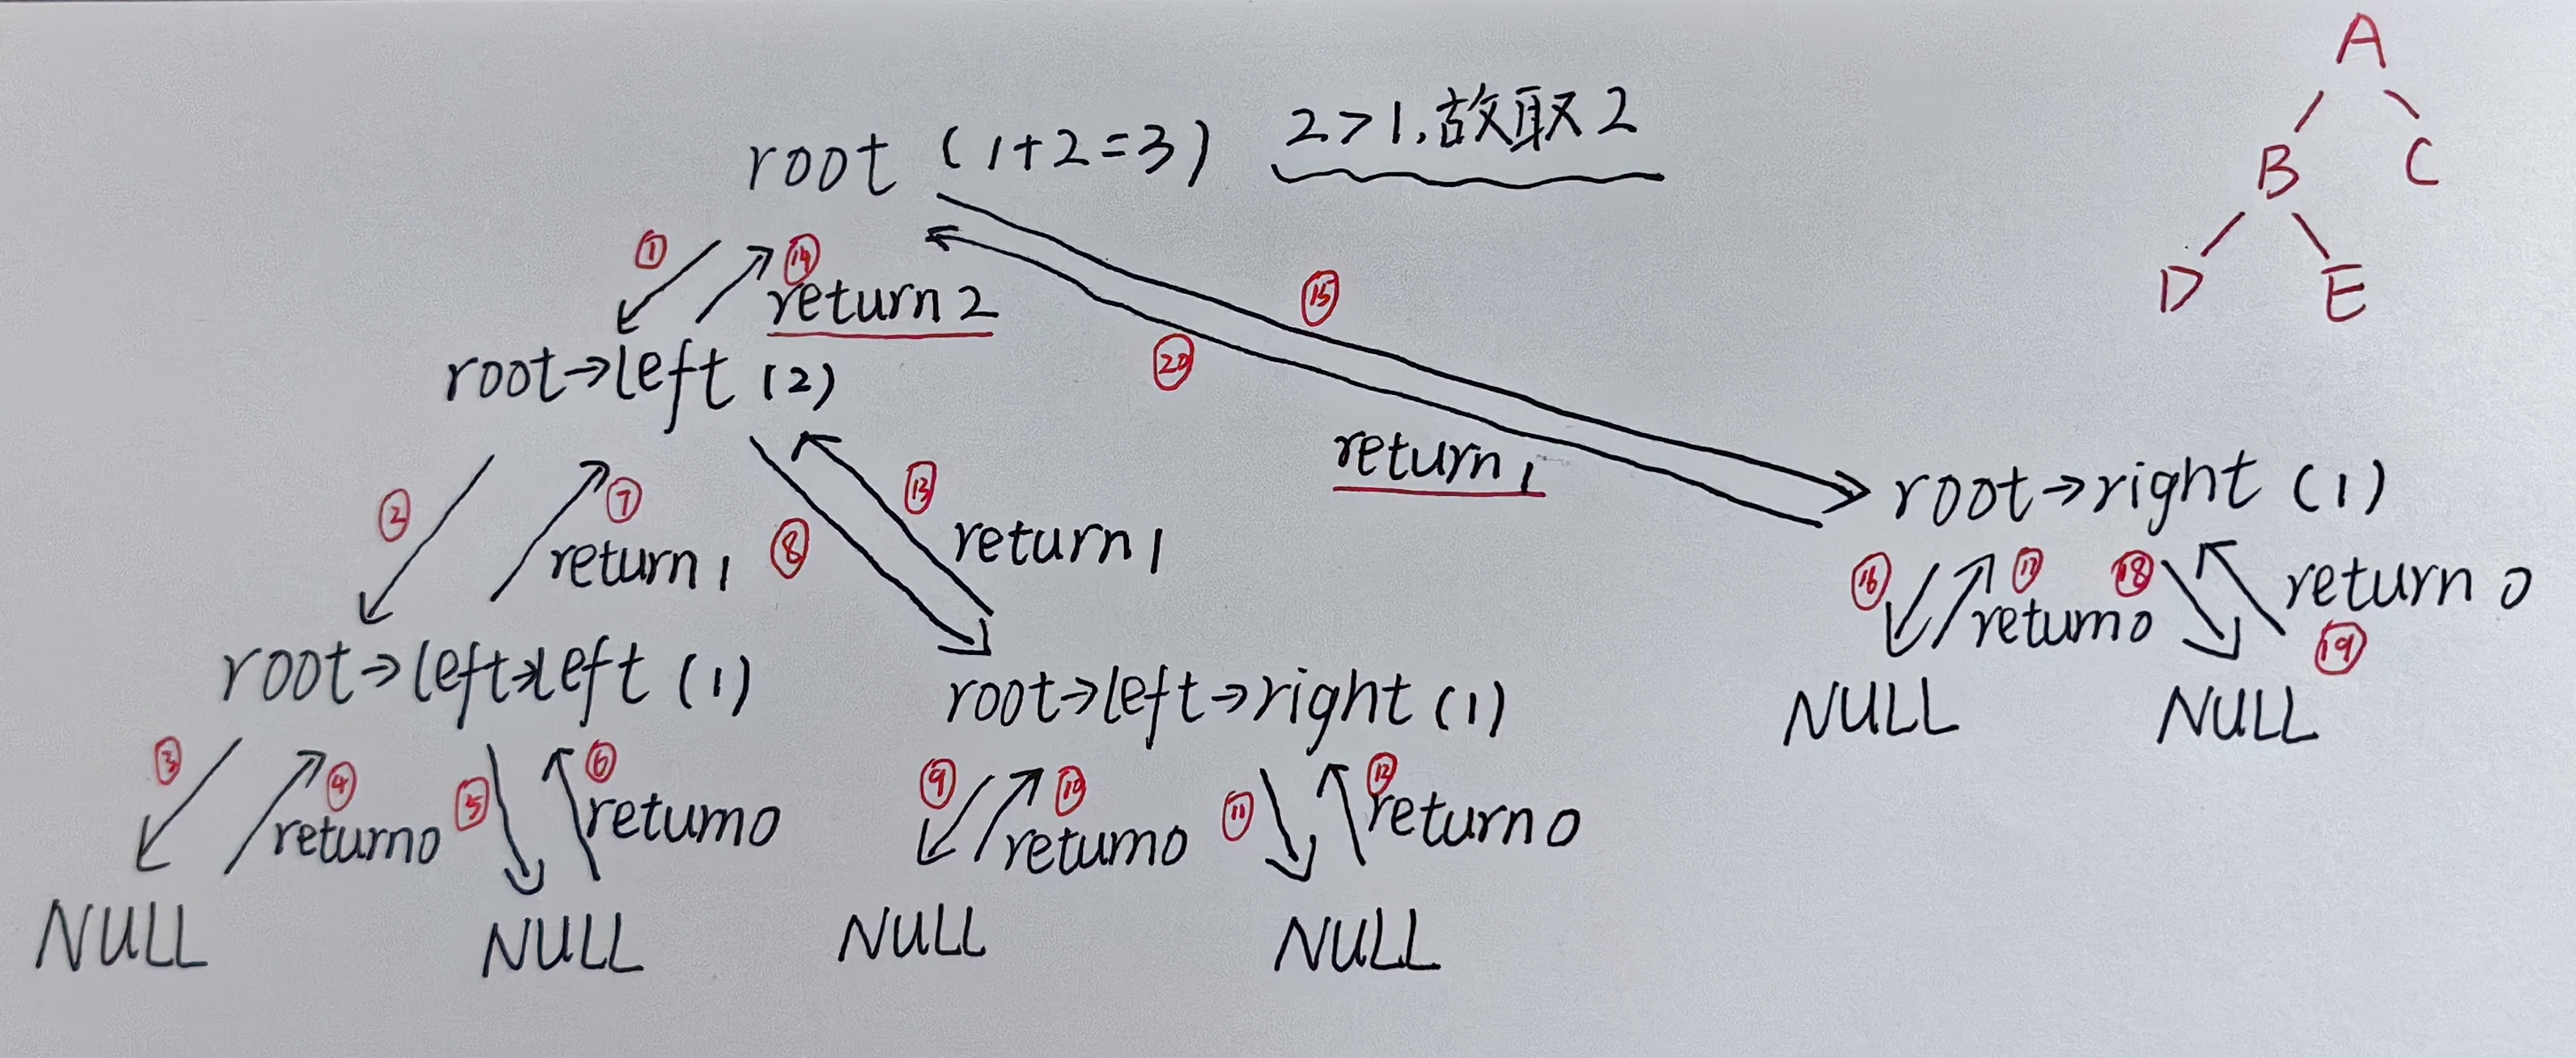
(2)非空结点返回:1 + max (左子树深度,右子树深度)(1 为当前结点所在层)。
3、代码实现与边界处理
(1)易懂写法
// 计算二叉树的深度(高度):从根节点到最远叶子结点的层数
int BinaryTreeDepth(BTNode* root)
{
// 递归终止条件:空树没有结点,深度为0
if (root == NULL) {
return 0;
}
// 第一步:先算左子树的深度
int leftSubTreeDepth = BinaryTreeDepth(root->left);
// 第二步:再算右子树的深度
int rightSubTreeDepth = BinaryTreeDepth(root->right);
// 第三步:找左右子树中“更深的那个”(取最大值)
int maxChildDepth = 0;
if (leftSubTreeDepth > rightSubTreeDepth) {
maxChildDepth = leftSubTreeDepth;
} else {
maxChildDepth = rightSubTreeDepth;
}
// 第四步:当前结点的深度 = 子树最大深度 + 1(+1是算上当前结点这一层)
int currentTreeDepth = 1 + maxChildDepth;
// 返回以当前结点为根的树的深度
return currentTreeDepth;
}
具体的执行,可以参考下图:
(2)高效写法
int BinaryTreeDepth(BTNode* root)
{
// 边界情况:空树深度为0
if (root == NULL) {
return 0;
}
// 递归计算左、右子树深度
int leftDep = BinaryTreeDepth(root->left);
int rightDep = BinaryTreeDepth(root->right);
// 返回较深子树深度 + 当前节点层
return 1 + (leftDep > rightDep ? leftDep : rightDep);
}
(五)查找值为 x 的节点
1、核心思路
(1)空结点返回 NULL;
(2)当前结点值为 x 时,返回当前结点指针;
(3)否则先递归查找左子树,左子树未找到再查找右子树;
(4)左右子树均未找到,返回 NULL。
2、代码实现
BTNode* BinaryTreeFind(BTNode* root, BTDataType x)
{
// 边界情况:空树返回NULL
if (root == NULL) {
return NULL;
}
// 找到目标结点,返回指针
if (root->data == x) {
return root;
}
// 递归查找左子树
BTNode* leftFind = BinaryTreeFind(root->left, x);
if (leftFind != NULL) {
// 左子树找到,直接返回(优化:避免多余递归)
return leftFind;
}
// 左子树未找到,递归查找右子树
BTNode* rightFind = BinaryTreeFind(root->right, x);
if (rightFind != NULL) {
// 右子树找到,直接返回
return rightFind;
}
// 左右子树均未找到
return NULL;
}
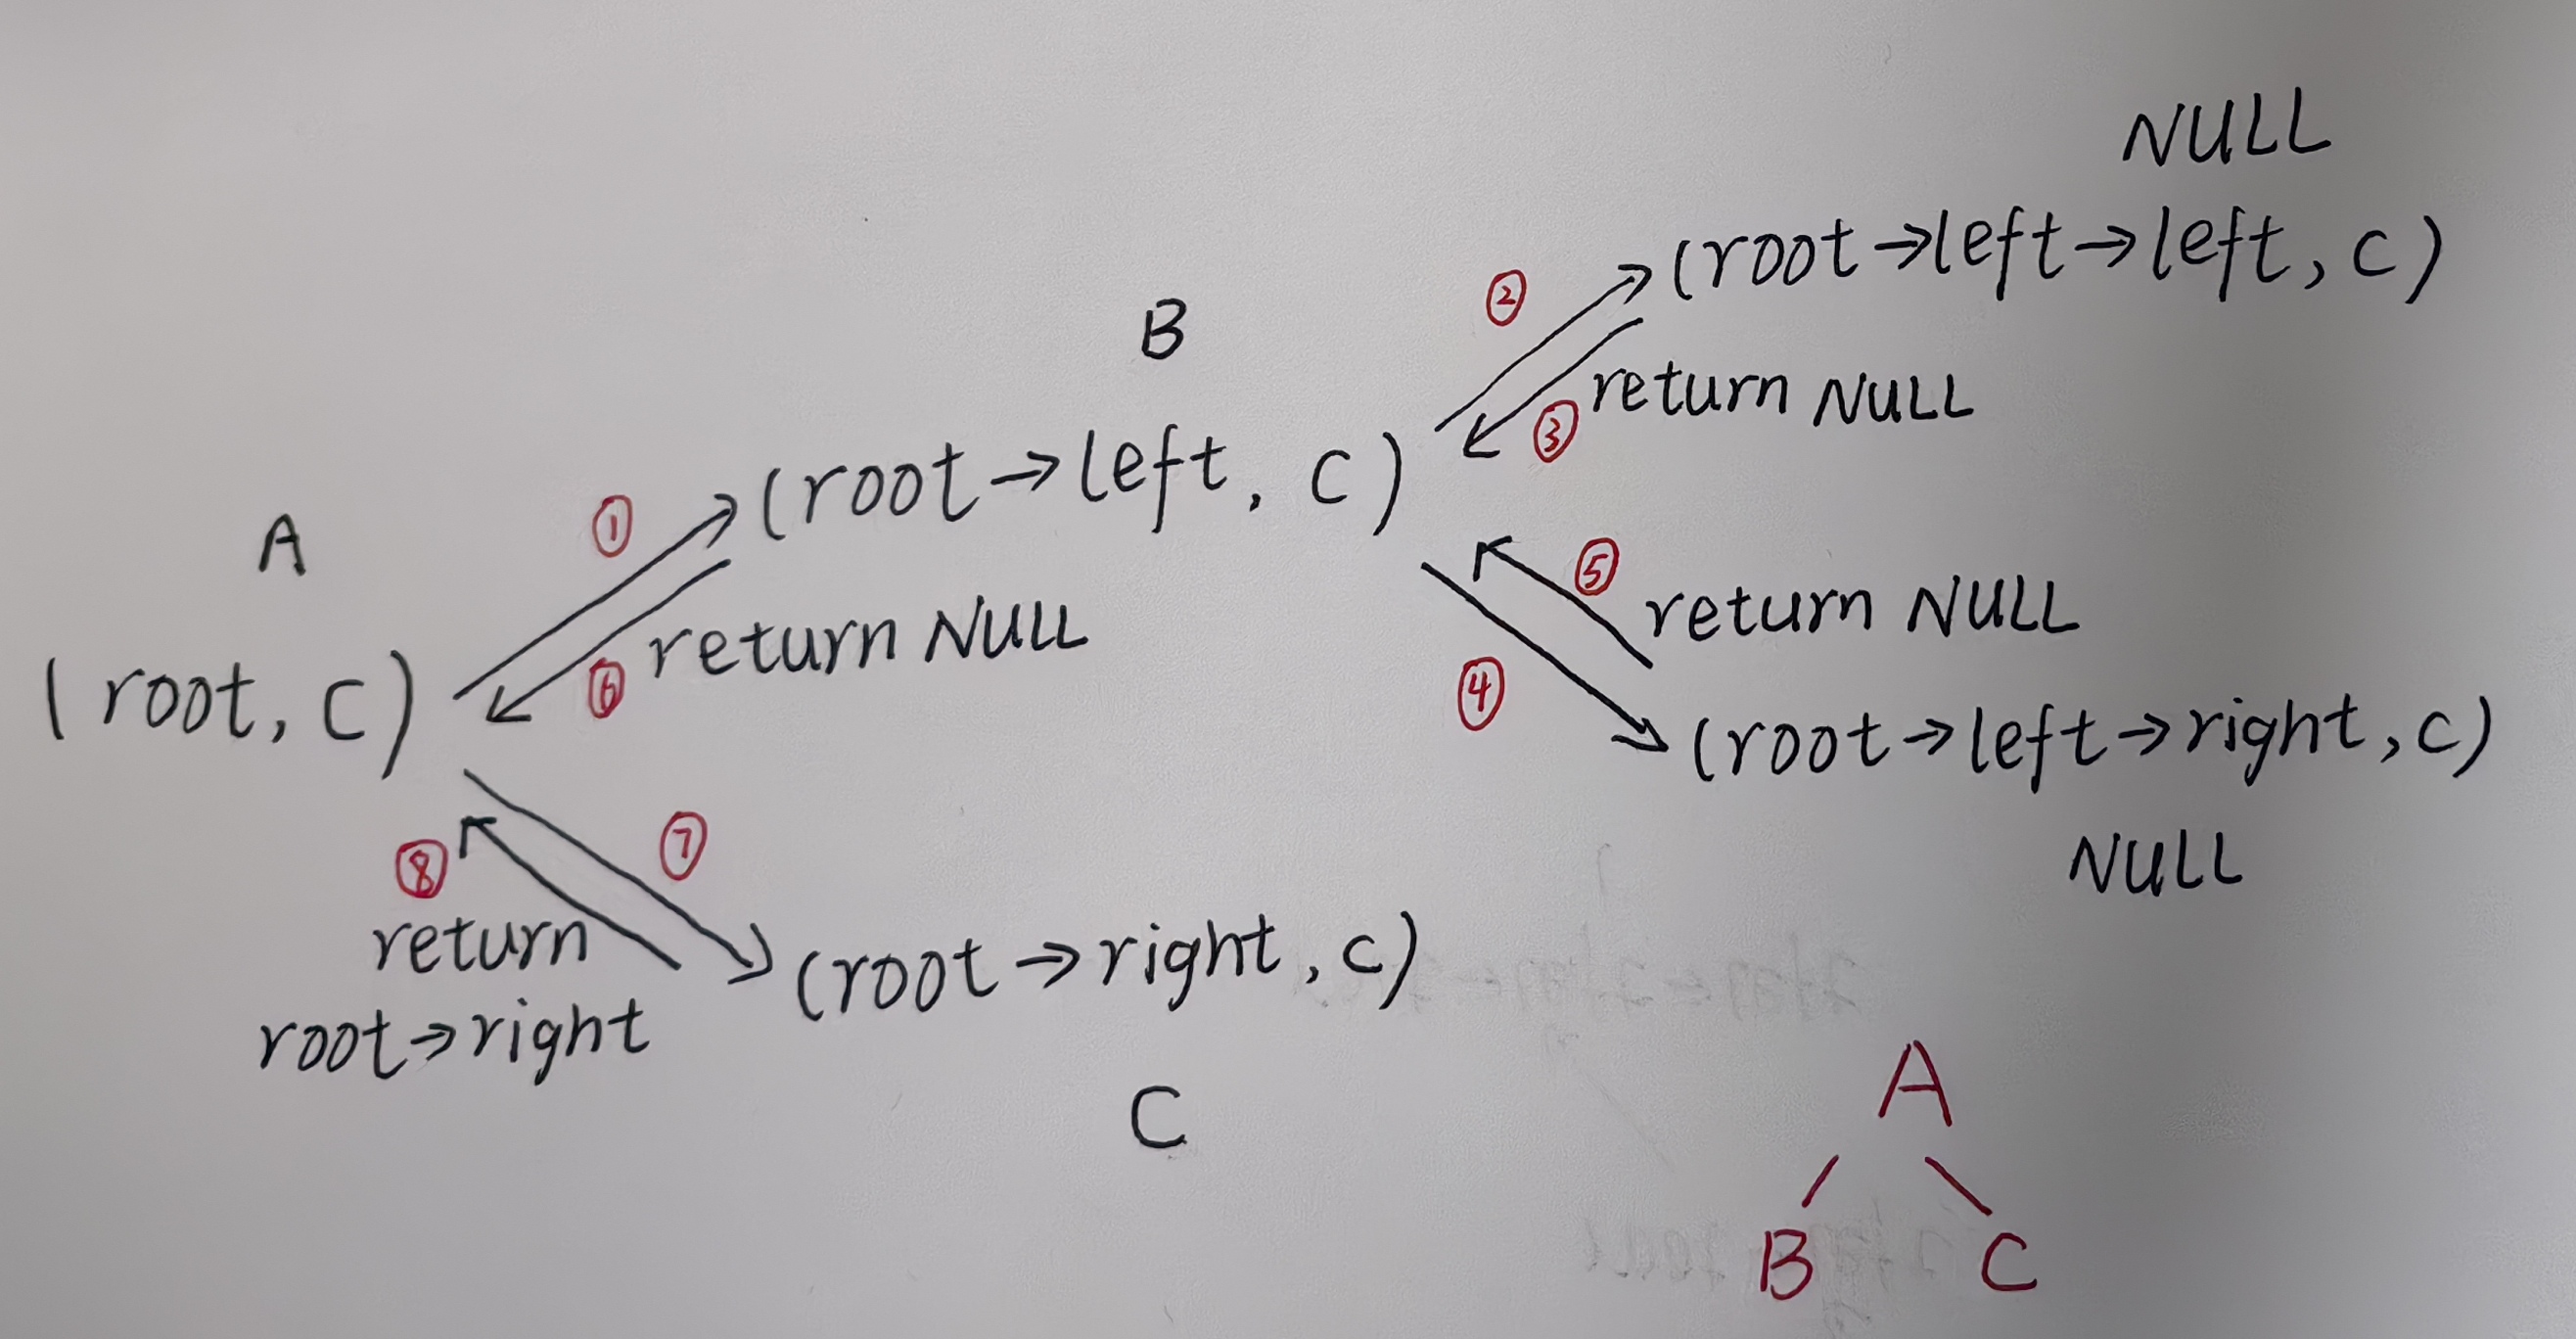
具体的执行,可以参考下图:
(六)销毁二叉树(避免内存泄漏)
1、核心注意事项
(1)必须按 “后序遍历” 顺序销毁(左→右→根),避免根结点提前释放导致子树丢失;
(2)传递二级指针(BTNode** root),确保销毁后根指针置空,避免野指针。
2、代码实现
void BinaryTreeDestory(BTNode** root)
{
// 边界情况:空树直接返回
if (*root == NULL) {
return;
}
// 后序销毁:先销毁左子树
BinaryTreeDestory(&((*root)->left));
// 再销毁右子树
BinaryTreeDestory(&((*root)->right));
// 最后销毁当前结点
free(*root);
*root = NULL; // 置空指针,避免野指针
}
(1)参数说明:二级指针 BTNode** root 接收一级指针 root 的地址,通过 *root 修改实参的值;
(2)销毁流程:从叶子结点开始逐层向上销毁,确保每个结点都被释放。
(七)二叉树递归万能骨架
// 二叉树递归万能骨架(背下来!)
返回值类型 函数名(BTNode* root, 可选参数) {
// 空1:递归终止条件(空树返回啥?)
if (root == NULL) {
return 终止值; // 比如统计数返回0,深度返回0,遍历返回空
}
// 空2:处理当前节点(可选,比如叶子节点返回1,k=1返回1)
(比如:if (k==1) return 1; / if (root->left==NULL && root->right==NULL) return 1;)
// 空3:递归处理左、右子树,拿到结果
左子树结果 = 函数名(root->left, 参数变化); // 比如k-1,无参数则直接传root->left
右子树结果 = 函数名(root->right, 参数变化);
// 空4:汇总结果并返回(核心逻辑)
return 汇总方式; // 比如 1+左+右 / 左+右 / 1+max(左,右)
}
二叉树的递归,本质上是分治的思想,即分而治之。一个大问题,可以拆解成若干个结构相同、规模更小的子问题。
所以我们在写代码的时候,如果以一整个宏观的眼光去看待整个过程,必然是过程极多的;所以既然它是由多个小问题组成,那我们在写代码的时候的,只需要把目光聚焦在当前这一个节点、这一步操作上即可。
不用想递归的全过程,只需要关注三件事:
(1)明确边界(终止条件):递归什么时候停下来,返回什么值;
(2)只关心当前结点该做什么:当前结点要判断什么、计算什么;
(3)确定递归的拆分与汇总:明确如何把当前问题拆解给左右子树(参数如何变化),以及如何汇总左右子树的结果,得到当前结点的答案。
四、完全二叉树判断(层序遍历应用)
(一)完全二叉树定义
1、除最后一层外,其他层结点个数均为最大值(满二叉树特性);
2、最后一层节点从左到右连续排列,中间无空缺。
(二)判断思路
第一步:借助层序遍历,将所有结点(包括空结点)入队;
第二步:首次取出空结点时,终止层序遍历;
第三步:检查队列剩余结点:若存在非空即点,则为非完全二叉树;否则为完全二叉树。
(三)代码实现
bool BinaryTreeComplete(BTNode* root)
{
//步骤1:初始化队列,根节点入队
Queue q;
QueueInit(&q);
if (root != NULL) {
QueuePush(&q, root);
}
// 步骤2:层序遍历,直至取出空结点
while (!QueueEmpty(&q))
{
//取队头,出队头
BTNode* top = QueueFront(&q);
QueuePop(&q);
if (top == NULL)
{
break;// 首次遇到空结点,则终止遍历
}
//队头结点的左右孩子入队列
QueuePush(&q, top->left);
QueuePush(&q, top->right);
}
//步骤3:检查剩余结点是否全为空
//队列不为空,继续取队头出队头
//1)队头存在非空结点—-非完全二叉树
//2)队头不存在非空结点—-完全二叉树
while (!QueueEmpty(&q))
{
BTNode* top = QueueFront(&q);
QueuePop(&q);
if (top != NULL)
{
QueueDestroy(&q);
return false;
}
}
QueueDestroy(&q);
return true;
}
void test02()
{
//见于前面手动建立二叉树
BTNode* root = creatBinaryTree();
bool ret = BinaryTreeComplete(root);
if (ret) {
printf("是完全二叉树!\\n");
}
else {
printf("不是完全二叉树!\\n");
}
}
这个函数的核心思路是:用队列做层序遍历,遇到第一个空结点后,检查后续所有节点是否都是空 —— 是则为完全二叉树,否则不是。
我们先初始化队列,根结点入队。队列是层序遍历的核心工具,先初始化队列,再把根结点(A)入队,为遍历做准备。
然后层序遍历,直到取出第一个空结点。这是最核心的一步,拆解来看:
循环条件:队列不为空就继续遍历;
取队头结点并出队:比如先取 A,再取 B,再取 C,再取 D……;
遇到空结点就 “刹车”:比如遍历到 D 的左子结点(NULL),就终止这个循环;
核心操作:不管当前节点的左 / 右子结点是否为空,都要入队—— 这是判断完全二叉树的关键(空结点也要记录)。
最后检查剩余结点是否全为空。
经过步骤 2 后,队列里剩下的是 “第一个空结点之后的所有结点”;
如果剩下的结点里有任意一个非空。则说明 “空结点后还有非空结点”,不是完全二叉树,返回 false;如果剩下的全是空,则是完全二叉树,最后返回 true 。
五、二叉树核心性质(选择题高频考点)
(一)任意二叉树核心公式
1、具体公式
n0:度为 0 的结点个数(叶子结点);
n1:度为 1 的结点个数;
n2:度为 2 的结点个数。
对于任意一颗二叉树,则有公式:n0 = n2 + 1。(叶子结点数 = 度为 2 的结点数 + 1)。
2、推导过程
(1)树的边数 = 节点总数 – 1,即 “边数 = n0 + n1 + n2 − 1”;因为所有结点通过边连接,根结点无父边。
(2)树的边数 = 各结点度之和,即 边数 = 0 × n0 + 1 × n1 + 2 × n2 = n1 + 2n2;
(3)联立方程:n0 + n1 + n2 − 1 = n1 + 2n2 → 化简得 n0 = n2 + 1
(二)完全二叉树的特殊性质
1、度为 1 的节点数限制
(1)完全二叉树中,度为 1 的结点数 n1 只能是 0 或 1:
(2)若完全二叉树总节点数n为奇数:n1=0(所有层结点均满,最后一层无空缺);
(3)若完全二叉树总节点数n为偶数:n1=1(最后一层结点数不足,仅 1 个度为 1 的结点)。
2、完全二叉树高度(深度)计算
(1)满二叉树结点数公式:结点总数 =  (h为高度,根节点为第 1 层);
(2)完全二叉树高度推导
完全二叉树的高度 h 满足: ≤ n ≤
 (n为总结点数),等价于 h = ⌊log2n⌋+1。⌊x⌋ 表示向下取整。简化计算技巧为:找到最大的整数 h,使得 ≤ n ≤ 。
(3)完全二叉树叶子结点数计算
结合任意二叉树的核心公式 n0 = n2 + 1,与完全二叉树 n1 的取值规则,推导叶子结点数:
① 总结点数:n = n0 + n1 + n2;
② 代入n2 = n0−1,得:n = n0 + n1 + (n0−1) → 2n0 + n1 = n+1;
③ 根据 n 的奇偶性确定n1,进而求解n0:
—— 若n为奇数(n1=0):2n0 = n + 1 → n0 = (n+1) / 2;
—— 若n为偶数(n1=1):2n0 + 1 = n + 1 → n0 = n / 2。
(三)公式总结
1、任意二叉树
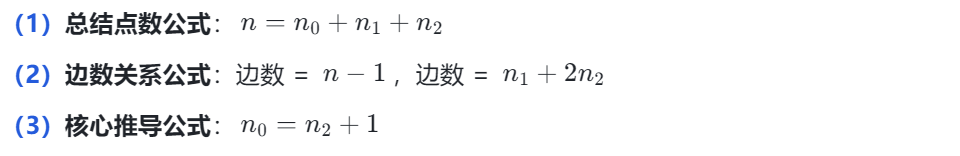
2、满二叉树

3、完全二叉树
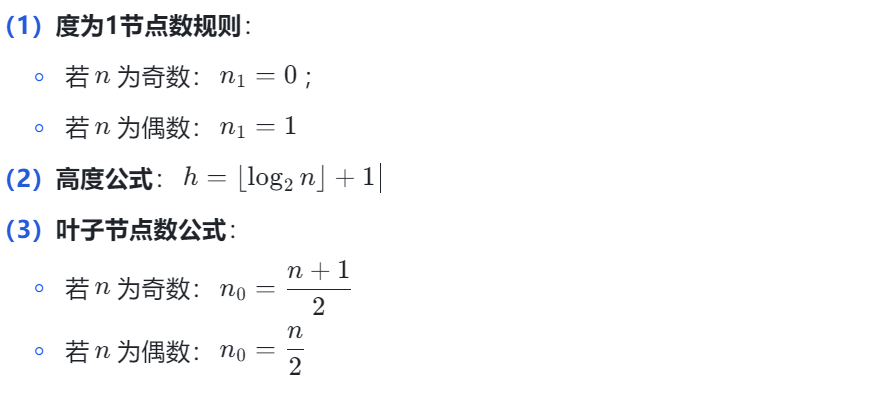
六、常见问题与注意事项
(一)递归相关问题
1、递归栈溢出
当二叉树深度过大(如左斜树深度为 10000),递归调用层级过多会导致栈溢出。我们的解决方案是,使用非递归实现(栈模拟递归);
2、递归终止条件遗漏
未判断 root == NULL 会导致无限递归;我们的解决方案是,所有递归函数均先判断空结点。
(二)内存管理问题
1、内存泄漏
创建结点后未销毁,或销毁时未释放所有结点;解决方案是,使用后调用BinaryTreeDestory进行结点的销毁。
2、野指针
销毁结点后未置空指针,后续访问该指针;解决方案是free后将指针置空,如 *root = NULL。
(三)参数传递问题
1、值传递与地址传递
修改指针本身(如销毁二叉树)需传递二级指针;仅访问指针指向的数据(如遍历、查找)传递一级指针即可。
以上即为 一篇文章掌握“树”(下)—— 链式结构二叉树 的全部内容,创作不易,麻烦三连支持一下呗 ~