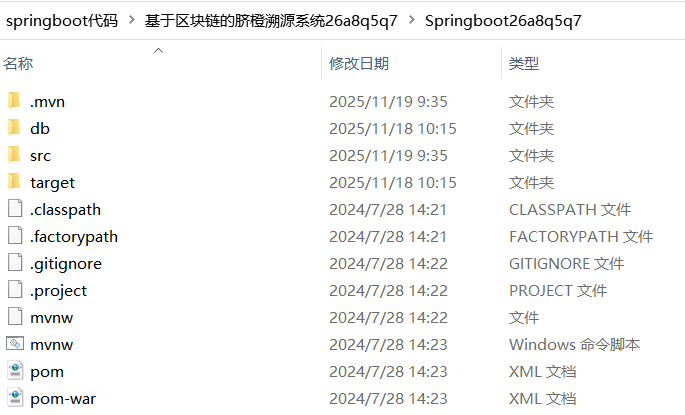
一、系统程序文件列表
二、开题报告内容
基于区块链的脐橙溯源系统开题报告
一、研究背景与意义
(一)研究背景
随着消费者对食品安全关注度的持续提升,农产品溯源系统已成为保障消费权益、提升产业透明度的核心工具。然而,传统溯源技术(如条形码、二维码)存在数据易篡改、信息孤岛化、信任成本高等问题,难以满足脐橙等高附加值农产品的溯源需求。以赣南脐橙为例,其年产量超百万吨,但市场上假冒伪劣产品占比高达30%,导致品牌价值受损,消费者信任度下降。区块链技术凭借其不可篡改、分布式账本、时间戳等特性,为解决上述问题提供了技术突破口。通过构建基于区块链的脐橙溯源系统,可实现从种植、采摘、加工到销售的全流程信息透明化,为消费者提供可信的溯源服务,同时助力企业提升供应链管理效率。
(二)研究意义
理论意义:本研究将区块链技术与农产品溯源深度融合,探索区块链在特定农产品(脐橙)中的应用路径,丰富农业信息化领域的理论体系。通过分析脐橙产业链各环节的数据采集、存储与共享机制,为其他农产品溯源系统的设计提供理论参考。
实践意义:
- 消费者层面:通过区块链的不可篡改特性,确保溯源信息真实可信,增强消费者对脐橙品质的信任,降低购买风险。
- 企业层面:帮助企业实现供应链全程可视化,快速定位质量问题源头,优化生产流程,提升品牌竞争力。例如,赣南脐橙通过区块链溯源系统,可减少假冒产品流通,预计年增收超10亿元。
- 监管层面:为政府提供数据支撑,辅助制定农业标准化政策,推动产业升级。
二、国内外研究现状
(一)国外研究现状
欧洲是农产品溯源系统的发源地,早期通过RFID、二维码等技术实现基础溯源功能。随着区块链技术兴起,欧盟于2019年启动“区块链农业计划”,将区块链应用于葡萄酒、橄榄油等高端农产品溯源。例如,法国葡萄酒溯源系统通过区块链记录葡萄种植、酿造、运输等环节数据,实现产品全生命周期追溯,假冒产品投诉率下降60%。美国农业部(USDA)则利用区块链技术构建牛肉溯源平台,通过智能合约自动执行质量检测流程,提升监管效率。
(二)国内研究现状
国内区块链溯源研究起步较晚,但发展迅速。2021年,赣州市政府联合企业推出“赣南脐橙链”,成为国内首个区块链农产品溯源平台。该系统通过“一码一物”形式,记录脐橙种植基地、施肥用药、采摘时间等关键信息,消费者扫码即可查看全流程数据。截至2025年,该平台已覆盖赣南地区80%的脐橙种植户,溯源信息准确率达99.7%。此外,京东、阿里等企业也推出区块链溯源平台,但多聚焦于通用型农产品,针对脐橙等单一品类的深度研究仍显不足。
(三)现有研究不足
数据完整性:现有系统多聚焦于销售环节溯源,对种植、采摘等上游环节的数据采集覆盖不足。
技术适配性:区块链的共识机制、智能合约等特性与农产品溯源需求结合不紧密,导致系统性能瓶颈。
用户参与度:果农、物流商等主体对区块链技术接受度低,数据录入依赖人工,易出现信息滞后或错误。
三、研究内容与方法
(一)研究内容
系统架构设计:
- 采用联盟链架构,以赣南脐橙产业链为核心节点(果农、合作社、加工厂、物流商、零售商),构建分布式溯源网络。
- 引入Hyperledger Fabric框架,通过智能合约自动执行数据上链规则,确保信息不可篡改。
关键功能模块:
- 数据采集模块:集成物联网设备(如土壤传感器、温湿度记录仪)自动采集种植环境数据,结合人工录入的关键节点信息(如施肥时间、采摘批次),形成完整溯源链条。
- 溯源查询模块:开发微信小程序,消费者扫码即可查看脐橙从种植到销售的全流程信息,支持按时间、地点、批次等多维度查询。
- 监管模块:为政府提供数据看板,实时监控脐橙产量、质量检测结果、流通路径等,辅助决策。
技术优化:
- 针对区块链存储成本高的问题,采用IPFS(星际文件系统)存储图片、视频等非结构化数据,区块链仅存储数据哈希值,降低链上负载。
- 优化共识机制,采用PBFT(实用拜占庭容错)算法,在保证安全性的同时提升交易处理速度(TPS≥1000)。
(二)研究方法
文献分析法:梳理国内外区块链溯源、农产品信息化相关文献,明确研究空白点。
案例研究法:分析“赣南脐橙链”“法国葡萄酒溯源系统”等成功案例,提炼可复用的技术方案。
实证研究法:在赣南地区选取50家种植户、10家加工厂进行系统试点,收集用户反馈优化功能设计。
对比实验法:对比传统溯源系统与区块链溯源系统在数据准确性、查询效率、用户信任度等指标上的差异。
四、预期成果与创新点
(一)预期成果
完成基于区块链的脐橙溯源系统开发,支持Web端、移动端多平台访问。
发表核心期刊论文1篇,申请软件著作权1项。
系统在赣南地区试点应用后,实现溯源信息覆盖率≥90%,消费者信任度提升40%。
(二)创新点
技术融合创新:首次将IPFS与区块链结合应用于农产品溯源,解决非结构化数据存储难题。
模式创新:提出“政府+企业+合作社”三方协同的溯源数据治理模式,提升数据采集效率。
应用创新:针对脐橙品类设计专用溯源标签,集成NFC芯片,实现“一触即查”的便捷体验。
五、进度安排
时间节点任务内容
| 2025.11-2025.12 |
完成文献调研、需求分析,确定系统架构 |
| 2026.01-2026.03 |
开发核心功能模块(数据采集、上链、查询) |
| 2026.04-2026.06 |
系统测试与优化,开展试点应用 |
| 2026.07-2026.08 |
撰写论文,准备答辩材料 |
六、参考文献
张晓颖. 试析基于Node.js的前后端分离框架的实现[J]. 计算机产品与流通, 2018, (10): 24.
赣南脐橙链白皮书[R]. 赣州市农业农村局, 2021.
EU Blockchain for Agriculture Initiative Report[R]. European Commission, 2020.
李明等. 基于区块链的农产品溯源系统研究[J]. 农业工程学报, 2023, 39(5): 12-18.
重要说明:以上为项目开发前基于选题撰写的开题报告内容,后期因需求调整、技术优化等因素,系统程序可能存在较大改动。最终成品以本文档后续 “运行环境 + 技术栈 + 界面展示” 为准,开题报告内容可作为开发与论文撰写的参考依据。系统源码获取方式详见文末!
三、系统技术栈
(一)前端技术栈:Vue.js
Vue.js 是一套专注于构建用户界面的渐进式 JavaScript 框架,具备轻量、高效、易集成的特点,尤其适合与 Spring Boot 后端框架搭配实现前后端分离架构。其核心库仅聚焦视图层,不强制依赖其他工具或库,既便于新手快速上手,也能灵活整合第三方插件(如 Vue Router、Vuex)或融入现有项目;同时,Vue.js 的响应式数据绑定机制可实时同步视图与数据,显著提升前端开发效率与用户交互体验。
(二)后端技术栈
核心容器:基于 Spring Boot 构建,提供全面的对象管理与依赖注入能力,可自动维护应用程序中各类组件的生命周期,简化对象创建与调用流程,降低代码耦合度。
Web 层:Spring Boot 内置 Tomcat、Jetty、Undertow 等主流 Web 容器,无需额外配置即可快速搭建 Web 应用,支持 HTTP 请求处理、接口开发、会话管理等核心功能,满足项目的 Web 服务需求。
数据访问层:支持多种数据库连接池(如 HikariCP、Druid)与 ORM(对象关系映射)框架(如 MyBatis、JPA),可简化数据库操作流程(如 SQL 编写、结果映射、事务管理),降低数据访问层的开发复杂度,提升数据交互效率与安全性。
(三)开发工具
IntelliJ IDEA:一款功能强大的 Java 集成开发环境(IDE),对 Spring Boot 项目开发支持尤为友好。内置丰富的插件(如 Spring Assistant、Lombok),可实现代码自动补全、语法检查、调试跟踪、项目构建等功能,大幅提升后端开发效率与代码质量。
Visual Studio Code(VS Code):轻量级跨平台 IDE,支持 Windows、macOS、Linux 多系统运行。通过安装 Java、Vue.js 相关插件(如 Java Extension Pack、Vetur),可实现前后端代码的编写、调试与运行,兼顾开发灵活性与轻量化需求。
四、开发流程
项目初始化:使用 Maven 构建工具创建 Spring Boot 项目,可通过 IntelliJ IDEA、Eclipse 等 IDE 的可视化界面选择 “Spring Initializr” 模板,快速生成项目基础结构(含目录层级、配置文件框架)。
依赖配置:在项目根目录的pom.xml文件中,添加 Spring Boot 相关依赖(如spring-boot-starter-web用于 Web 开发、spring-boot-starter-mybatis用于数据访问),Maven 会自动下载并管理依赖包及其版本,避免版本冲突问题。
启动类设置:在src/main/java目录下创建项目启动类(通常命名为XXXApplication.java,如SystemApplication.java),并在类上添加@SpringBootApplication注解 —— 该注解整合了@Configuration(配置类)、@EnableAutoConfiguration(自动配置)、@ComponentScan(组件扫描)三大功能,是 Spring Boot 应用启动的核心标识。
核心配置:创建 Spring Boot 配置文件(支持application.properties(Properties 格式)或application.yml(YAML 格式)),在文件中定义数据库连接信息(如 URL、用户名、密码)、服务器端口、缓存策略、日志级别等核心配置,确保应用程序按预期运行。
五、使用者指南
(一)项目搭建步骤
工程创建与依赖引入:使用 Maven 或 Gradle 构建工具创建新工程,在构建配置文件(Maven 为pom.xml,Gradle 为build.gradle)中引入 Spring Boot 相关依赖(参考本文档 “开发流程 – 依赖配置” 部分),确保核心功能模块(Web、数据访问等)的依赖完整。
主类创建与配置:在src/main/java目录下创建项目主类,在类上添加@SpringBootApplication注解 —— 该注解会触发 Spring Boot 的自动配置机制,根据项目依赖与配置文件自动初始化应用环境(如加载 Web 容器、配置数据库连接)。
主方法编写:在主类中定义main方法,通过SpringApplication.run(主类.class, args)语句启动 Spring Boot 应用
(二)核心机制说明:自动配置
Spring Boot 的自动配置机制是其核心特性之一,可根据项目中的依赖包、配置文件及外部属性,自动完成应用程序的配置(无需手动编写大量 XML 配置)。其实现原理为:Spring Boot 启动时,会扫描类路径下的META-INF/spring.factories文件,加载其中定义的自动配置类;随后根据项目依赖(如引入spring-boot-starter-web则自动配置 Web 容器)与配置文件参数,判断是否需要实例化相关组件(如 Tomcat 容器、DataSource 数据源),最终完成应用环境的初始化。
(三)应用运行步骤
运行方式:
- 方式 1(IDE 运行):在 IntelliJ IDEA 或 VS Code 中,找到主类文件,右键点击 “Run 主类名”(如 “Run SystemApplication”),即可启动应用。
- 方式 2(命令行运行):通过终端进入项目根目录,执行mvn spring-boot:run(Maven 项目)或gradle bootRun(Gradle 项目)命令,启动应用程序。
默认运行环境:Spring Boot 应用默认使用嵌入式容器(Tomcat 为默认容器,可通过修改依赖切换为 Jetty 或 Undertow)运行,无需额外安装或配置独立容器,启动后即可通过浏览器或接口测试工具(如 Postman)访问应用接口(默认端口为 8080,可在配置文件中修改)。
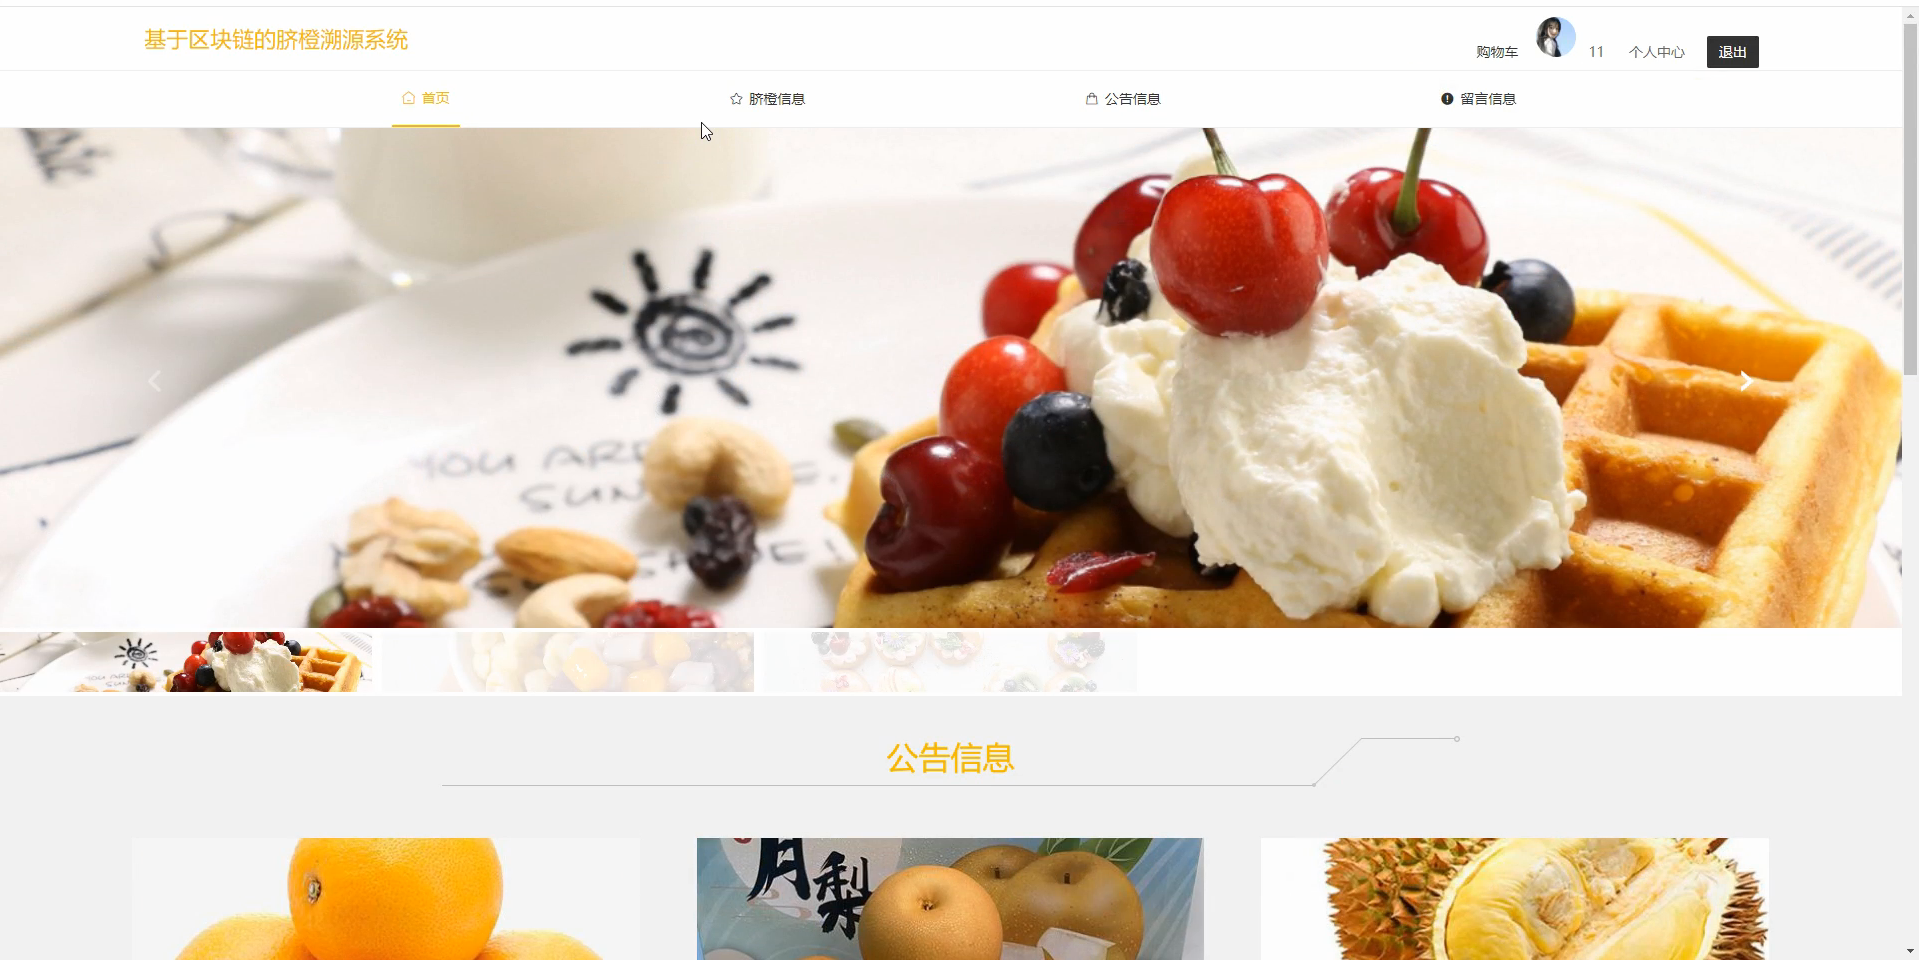
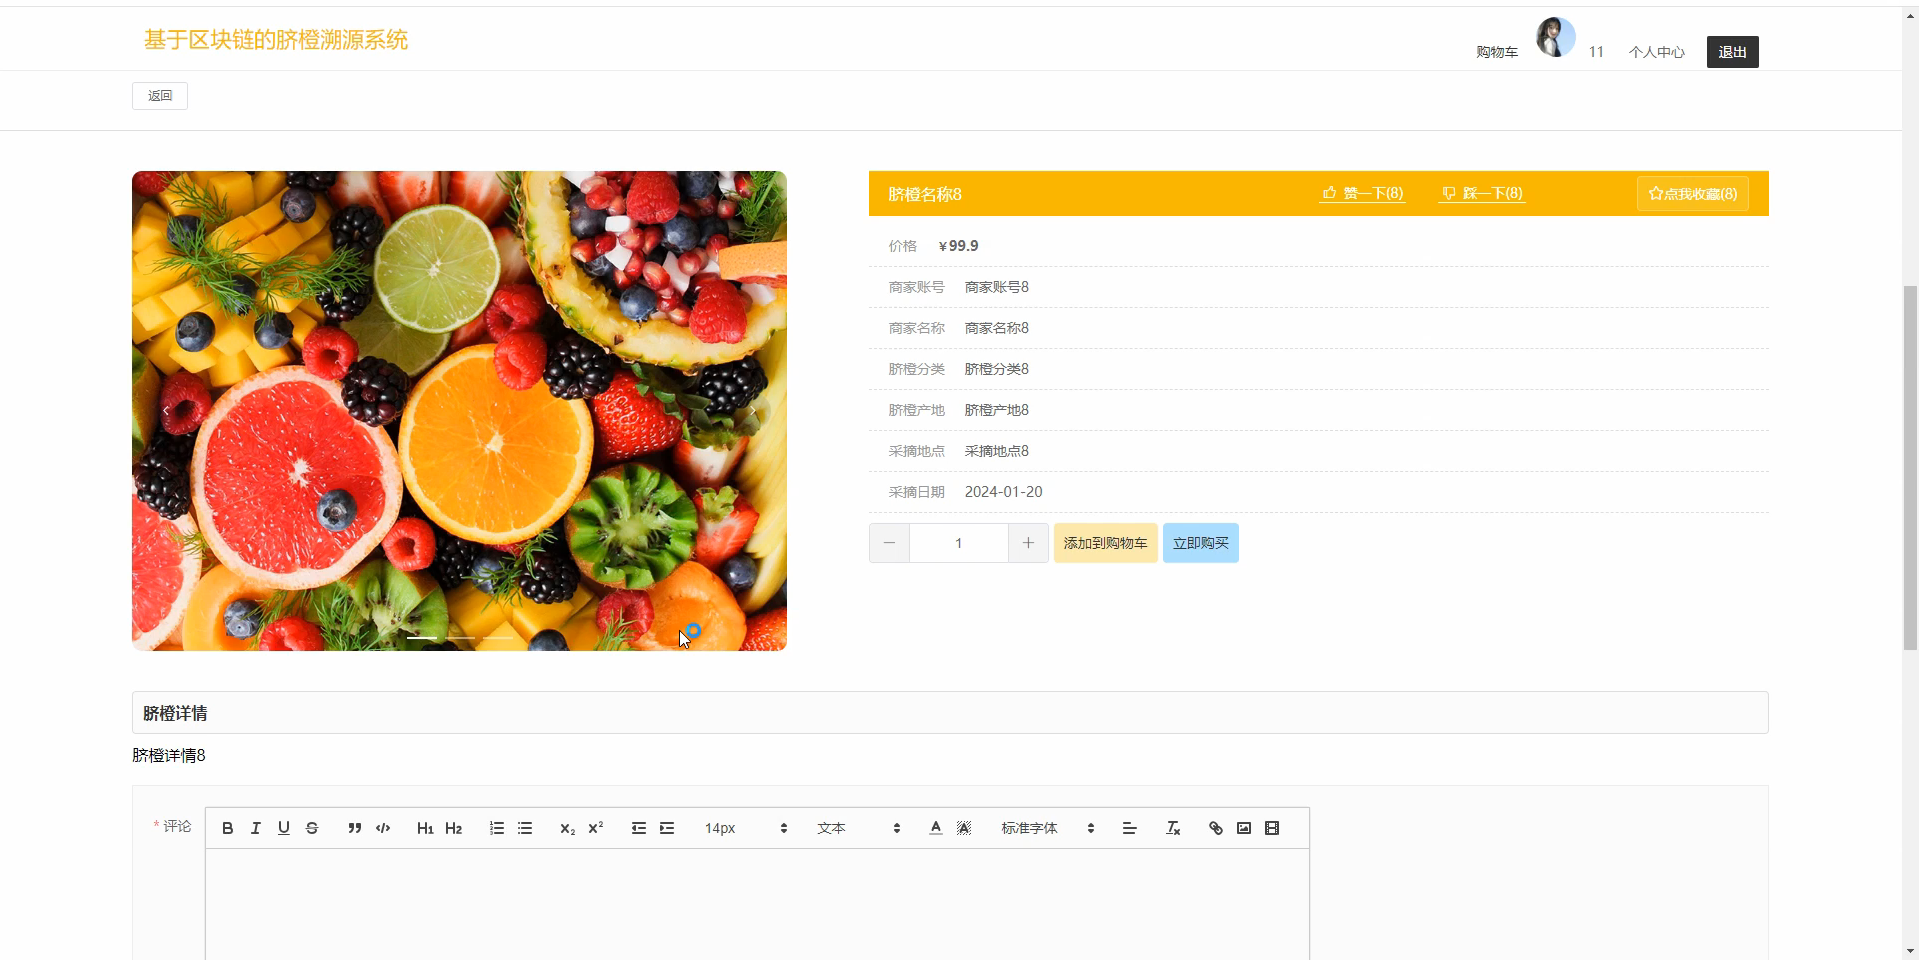
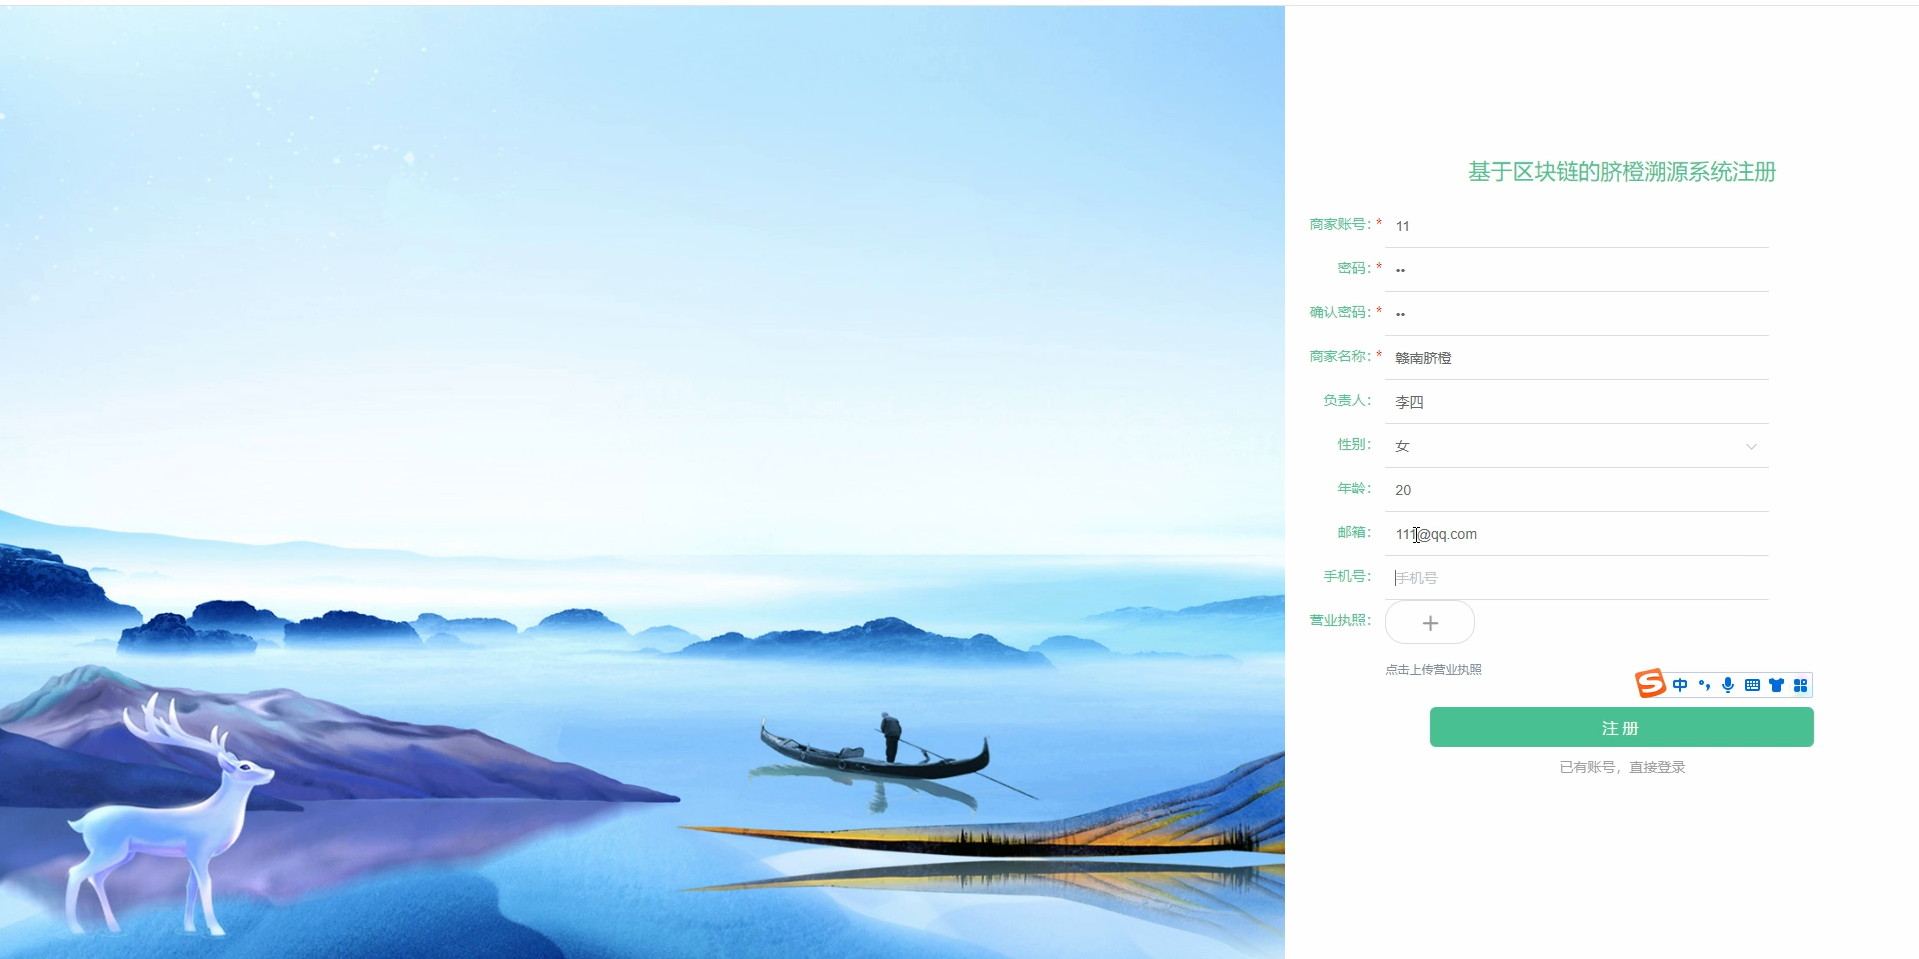
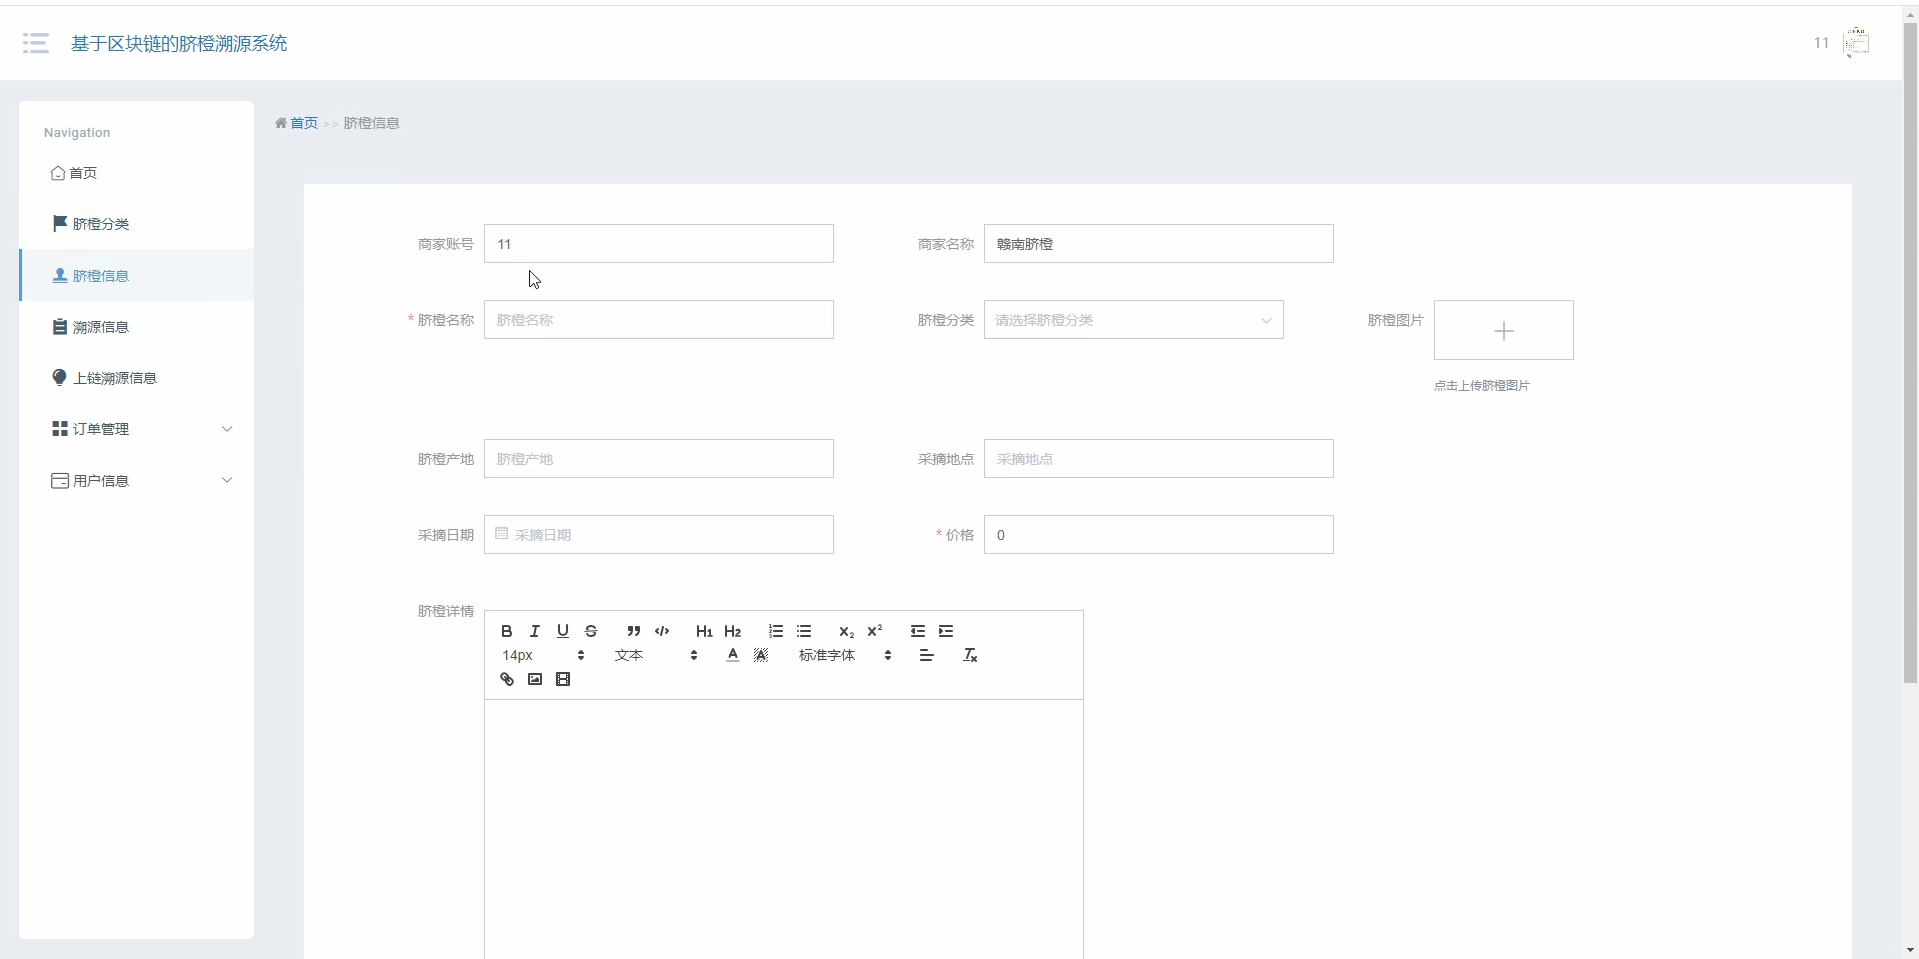
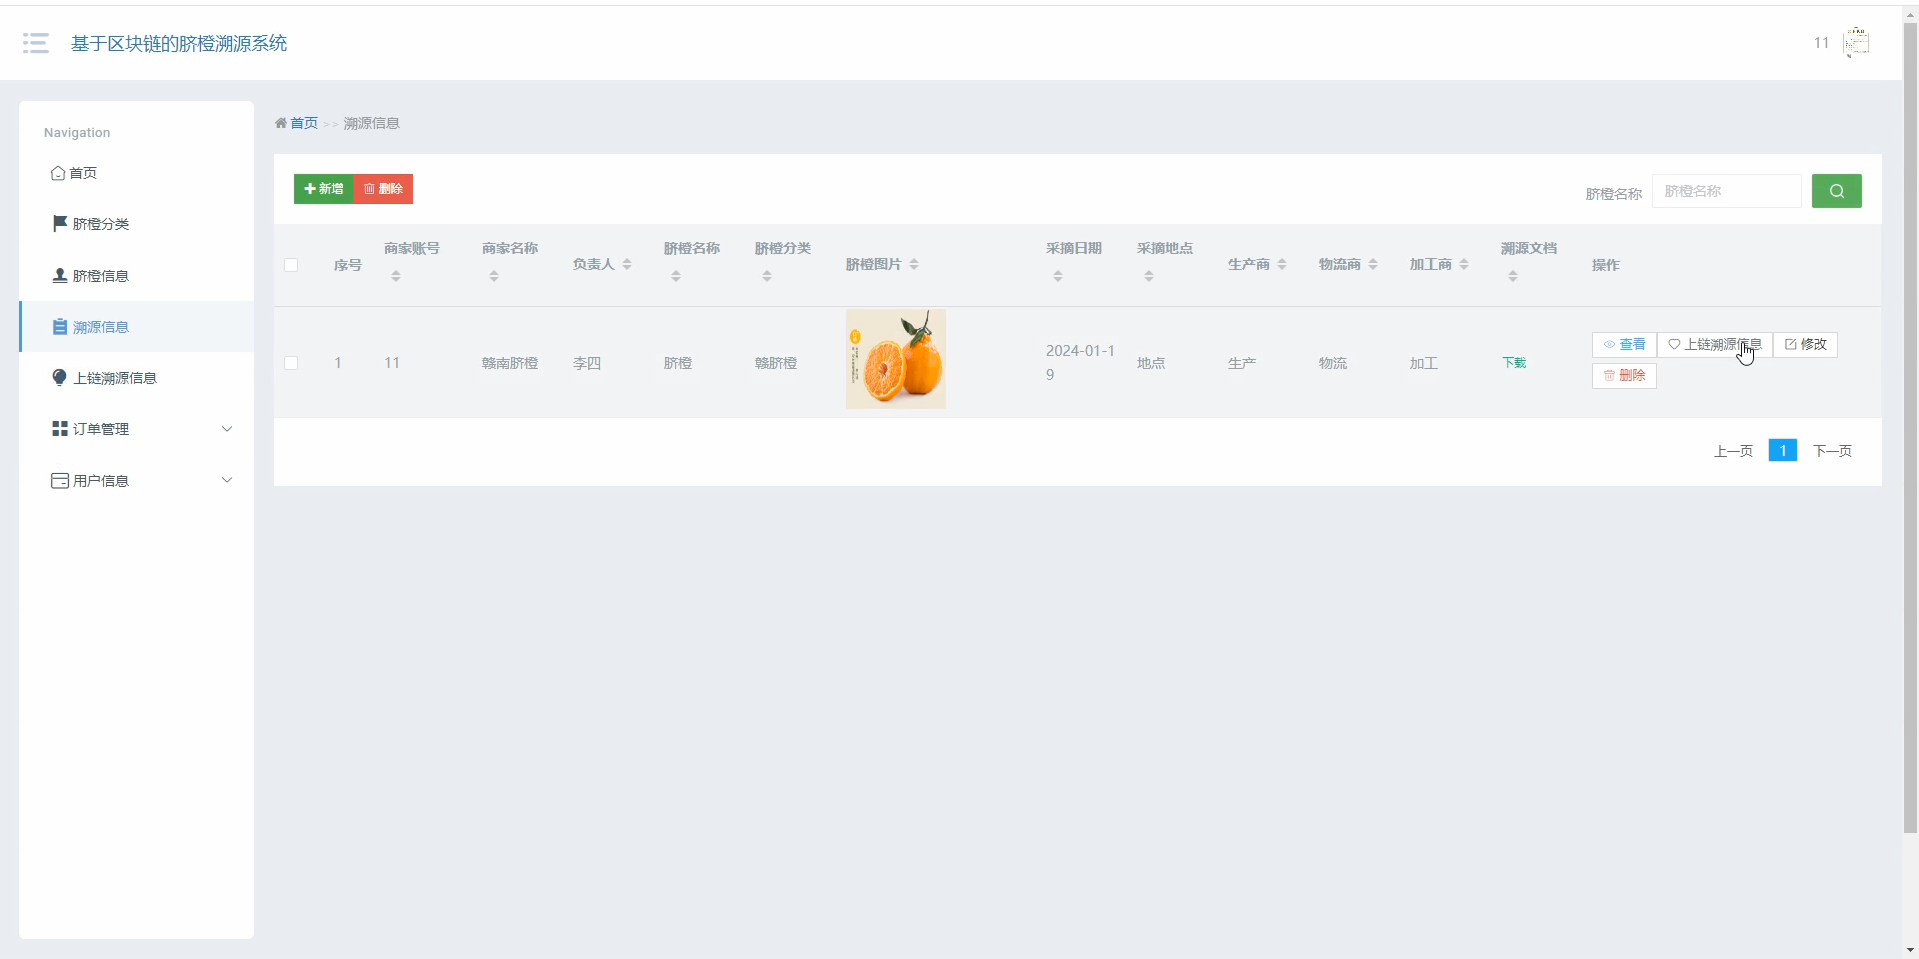
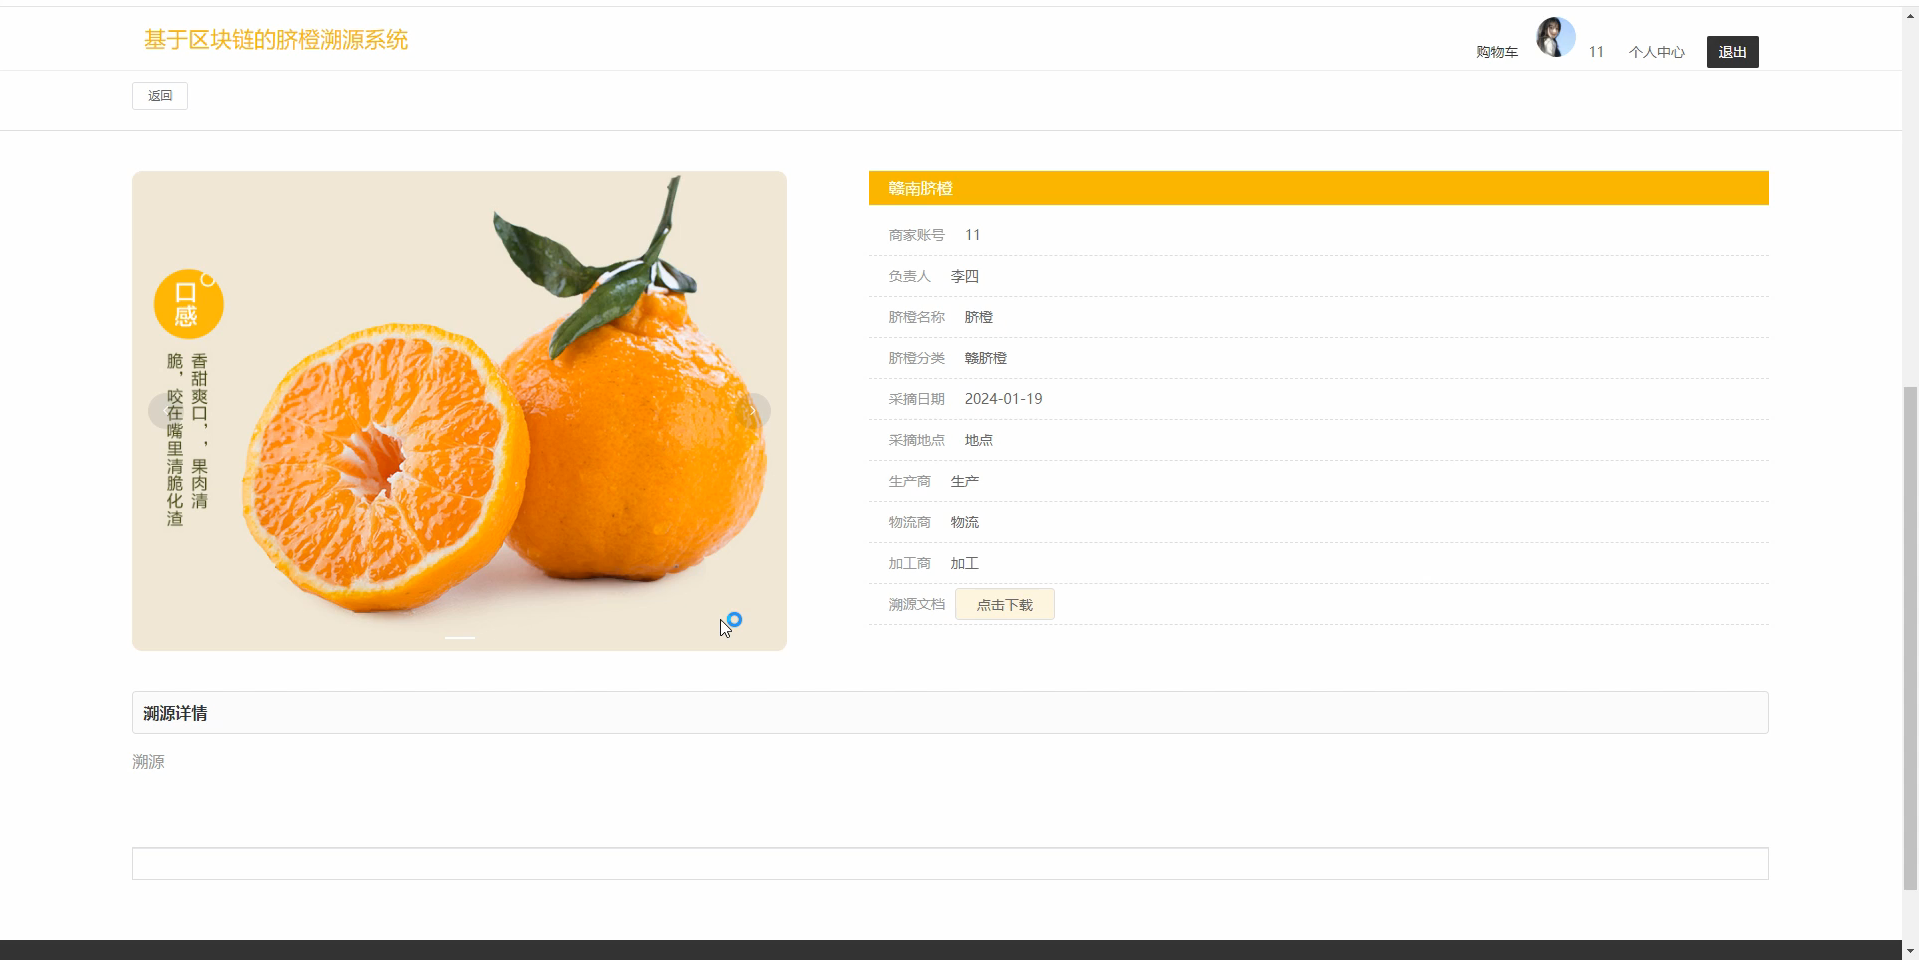
六、程序界面展示