一、前言
在微服务架构中,Java负载均衡器如同一个精密的交通指挥系统,将海量请求智能分发到后端服务器集群,确保系统在高并发场景下依然稳定、高效。从简单的轮询到复杂的一致性哈希,不同的算法策略应对着不同的业务挑战。
通过Spring Cloud LoadBalancer等框架,Java开发者能够轻松构建可扩展的分布式系统,实现99.99%的高可用性,将吞吐量提升400%,响应时间降低80%。
二、核心原理:流量如何被智能调度
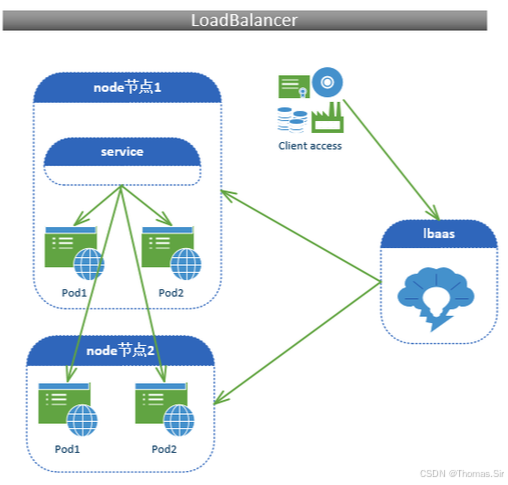
负载均衡器本质上是一个智能的流量分发代理。它位于用户与后端服务器集群之间,接收所有客户端请求,并根据预设的算法,将请求动态、合理地分配到多个可用的服务器上。
🚦 流量调度中枢
负载均衡器作为核心调度器,持续执行以下关键任务:
1、健康检查 (Health Checking)
定期探测后端服务器状态,自动剔除故障节点,确保流量只分发到健康实例。
2、算法决策 (Algorithm Decision)
根据配置的负载均衡算法(如轮询、最少连接等)选择最合适的服务器处理请求。
3、会话保持 (Session Persistence)
对于需要状态保持的请求,通过一致性哈希或源地址哈希确保同一用户请求始终路由到同一服务器。
以Spring Cloud LoadBalancer为例,其底层通过一个名为 LoadBalancerInterceptor 的拦截器工作,它会拦截如 RestTemplate 发出的HTTP请求,解析出服务名,再通过负载均衡客户端选择一个具体的服务实例进行调用。
三、六大核心算法详解
不同的负载均衡算法适用于不同的业务场景,Java中常见的实现包括以下六种:
📊 算法性能对比矩阵
| 轮询法 | 按顺序依次分配请求 | 服务器性能均匀的简单场景 | ⭐ |
| 加权轮询 | 根据服务器权重分配请求 | 服务器性能差异明显的场景 | ⭐⭐ |
| 随机法 | 完全随机选择服务器 | 测试环境或简单原型系统 | ⭐ |
| 加权随机 | 按权重概率随机选择 | 需要随机性但考虑权重的场景 | ⭐⭐ |
| 最少连接数 | 选择当前连接数最少的服务器 | 请求处理时间不均匀的长连接场景 | ⭐⭐⭐ |
| 一致性哈希 | 基于请求特征哈希映射到固定服务器 | 缓存服务器、需要会话保持的场景 | ⭐⭐⭐⭐ |
1. 轮询算法 (Round Robin)
最简单的负载均衡算法,按照服务器列表顺序依次分配请求。若有3台服务器,第1个请求到服务器1,第2个到服务器2,第3个到服务器3,第4个又回到服务器1,如此循环。
public class RoundRobinLoadBalancer {
private List<String> serverList;
private int currentIndex = 0;
public String getNextServer() {
if (serverList.isEmpty()) return null;
String nextServer = serverList.get(currentIndex);
currentIndex = (currentIndex + 1) % serverList.size();
return nextServer;
}
}
2. 加权轮询算法 (Weighted Round Robin)
在轮询基础上考虑服务器性能差异,为高性能服务器分配更高权重,使其获得更多请求。例如服务器A权重2,服务器B权重1,则每3个请求中,A处理2个,B处理1个。
import java.util.ArrayList;
import java.util.List;
import java.util.concurrent.atomic.AtomicInteger;
/**
* 服务器节点类
*/
class ServerNode {
private String name;
private int weight; // 固定权重
private int currentWeight; // 当前权重
public ServerNode(String name, int weight) {
this.name = name;
this.weight = weight;
this.currentWeight = 0;
}
// Getter和Setter方法
public String getName() { return name; }
public int getWeight() { return weight; }
public int getCurrentWeight() { return currentWeight; }
public void setCurrentWeight(int currentWeight) {
this.currentWeight = currentWeight;
}
@Override
public String toString() {
return name + "(权重:" + weight + ")";
}
}
/**
* 加权轮询负载均衡器
*/
public class WeightedRoundRobin {
private List servers;
private AtomicInteger index; // 用于记录上次选择的服务器索引
public WeightedRoundRobin() {
this.servers = new ArrayList<>();
this.index = new AtomicInteger(-1);
}
/**
* 添加服务器节点
*/
public void addServer(ServerNode server) {
servers.add(server);
}
/**
* 获取下一个服务器(核心算法)
*/
public ServerNode getNextServer() {
if (servers.isEmpty()) {
return null;
}
// 1. 计算总权重
int totalWeight = 0;
for (ServerNode server : servers) {
totalWeight += server.getWeight();
}
// 2. 增加当前权重
for (ServerNode server : servers) {
server.setCurrentWeight(server.getCurrentWeight() + server.getWeight());
}
// 3. 选择当前权重最大的服务器
ServerNode selected = servers.get(0);
for (ServerNode server : servers) {
if (server.getCurrentWeight() > selected.getCurrentWeight()) {
selected = server;
}
}
// 4. 减少选中服务器的当前权重
selected.setCurrentWeight(selected.getCurrentWeight() – totalWeight);
return selected;
}
/**
* 平滑加权轮询算法(优化版本)
*/
public ServerNode getNextServerSmooth() {
if (servers.isEmpty()) {
return null;
}
ServerNode best = null;
int total = 0;
// 遍历所有服务器,选择当前权重最大的
for (ServerNode server : servers) {
// 增加当前权重
server.setCurrentWeight(server.getCurrentWeight() + server.getWeight());
total += server.getWeight();
// 选择当前权重最大的服务器
if (best == null || server.getCurrentWeight() > best.getCurrentWeight()) {
best = server;
}
}
// 减少选中服务器的当前权重
if (best != null) {
best.setCurrentWeight(best.getCurrentWeight() – total);
}
return best;
}
/**
* 测试方法
*/
public static void main(String[] args) {
// 创建负载均衡器
WeightedRoundRobin lb = new WeightedRoundRobin();
// 添加服务器节点(权重代表处理能力)
lb.addServer(new ServerNode("Server-A", 5)); // 权重5
lb.addServer(new ServerNode("Server-B", 3)); // 权重3
lb.addServer(new ServerNode("Server-C", 2)); // 权重2
System.out.println("=== 加权轮询算法测试 ===");
System.out.println("服务器配置: A(5), B(3), C(2)");
System.out.println("请求分配序列:");
// 模拟20次请求
for (int i = 1; i <= 20; i++) {
ServerNode server = lb.getNextServerSmooth();
System.out.printf("请求%02d → %s%n", i, server.getName());
}
// 验证权重比例
System.out.println("\\n=== 权重比例验证 ===");
System.out.println("总权重: 10 (5+3+2)");
System.out.println("理论分配比例: A:50%, B:30%, C:20%");
System.out.println("实际20次请求中:");
System.out.println("- Server-A 应被选中约10次");
System.out.println("- Server-B 应被选中约6次");
System.out.println("- Server-C 应被选中约4次");
}
}
3. 一致性哈希算法 (Consistent Hashing)
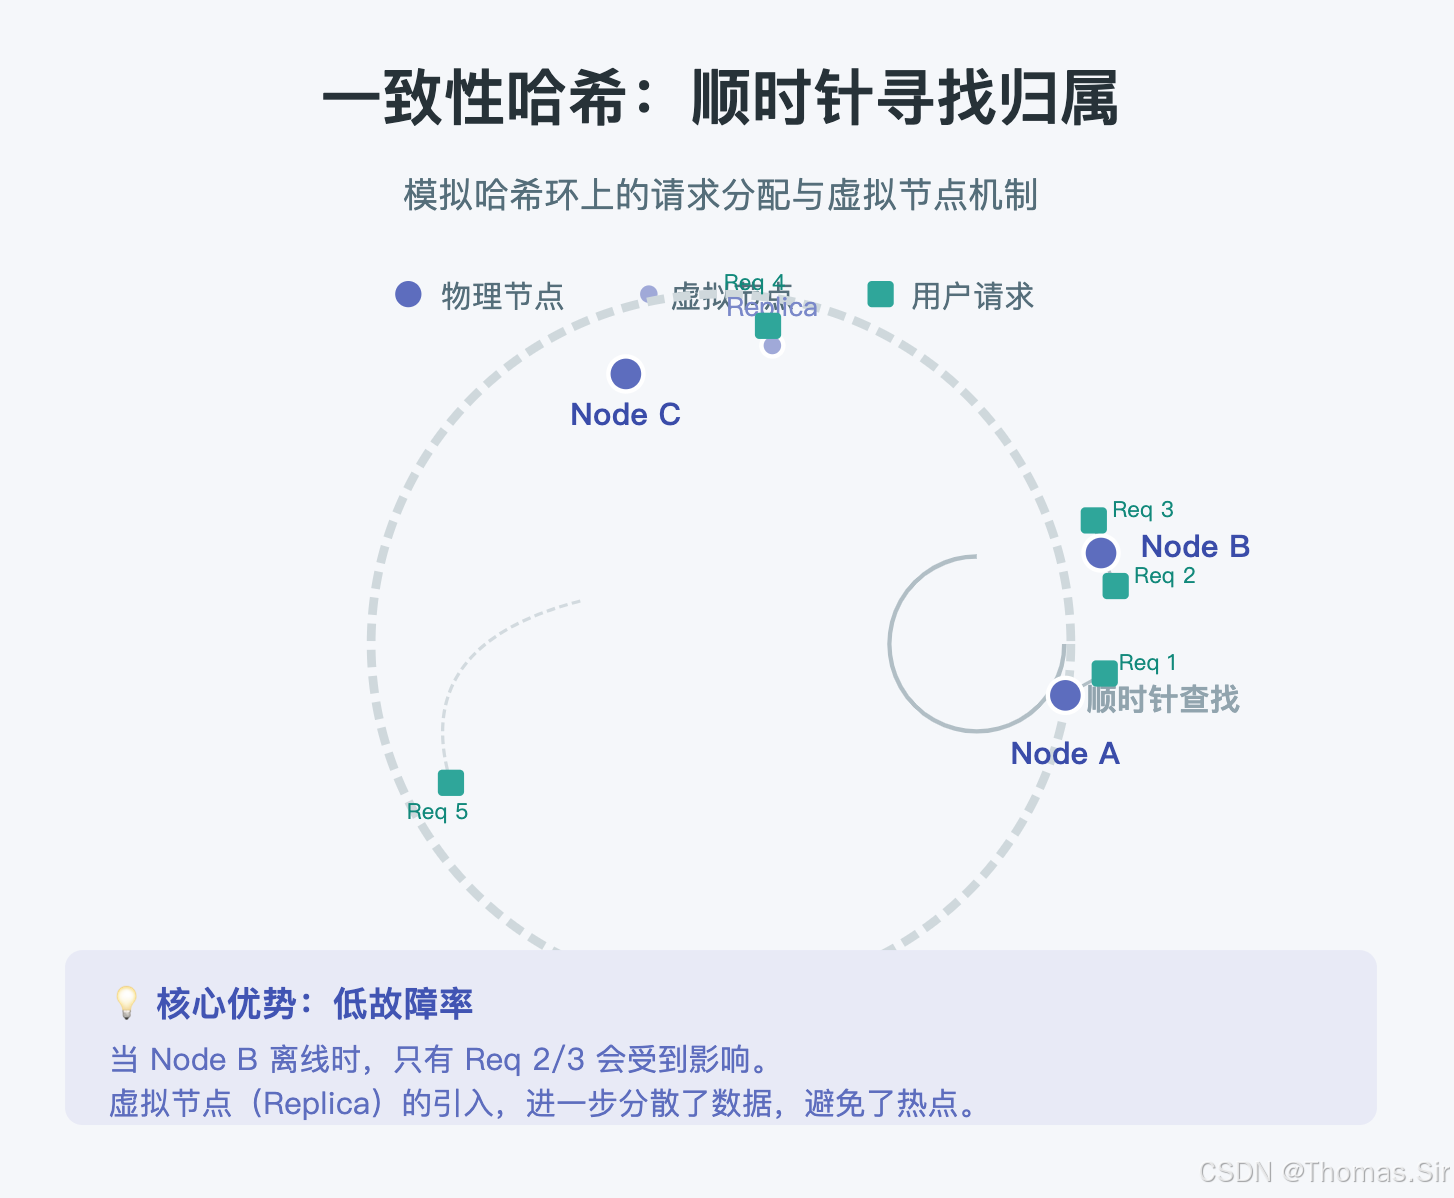
将服务器和请求都映射到一个哈希环上,请求根据哈希值顺时针查找遇到的第一个服务器。当服务器节点增减时,只有少量请求需要重新映射,特别适合缓存服务器集群。
import java.util.*;
import java.security.MessageDigest;
import java.security.NoSuchAlgorithmException;
/**
* 一致性哈希算法实现
*/
public class ConsistentHash {
// 虚拟节点到真实节点的映射
private final TreeMap<Long, String> virtualNodes = new TreeMap<>();
// 每个真实节点对应的虚拟节点数量
private final int virtualNodeCount;
// 真实节点列表
private final List<String> realNodes = new ArrayList<>();
/**
* 构造函数
* @param virtualNodeCount 每个真实节点的虚拟节点数量
*/
public ConsistentHash(int virtualNodeCount) {
this.virtualNodeCount = virtualNodeCount;
}
/**
* 添加真实节点
*/
public void addNode(String node) {
if (realNodes.contains(node)) {
return;
}
realNodes.add(node);
// 为节点创建虚拟节点
for (int i = 0; i < virtualNodeCount; i++) {
String virtualNodeName = node + "#VN" + i;
long hash = getHash(virtualNodeName);
virtualNodes.put(hash, node);
}
}
/**
* 删除真实节点
*/
public void removeNode(String node) {
if (!realNodes.contains(node)) {
return;
}
realNodes.remove(node);
// 删除该节点的所有虚拟节点
for (int i = 0; i < virtualNodeCount; i++) {
String virtualNodeName = node + "#VN" + i;
long hash = getHash(virtualNodeName);
virtualNodes.remove(hash);
}
}
/**
* 根据key获取对应的节点
*/
public String getNode(String key) {
if (virtualNodes.isEmpty()) {
return null;
}
long hash = getHash(key);
// 找到第一个大于等于该hash的虚拟节点
SortedMap<Long, String> tailMap = virtualNodes.tailMap(hash);
if (tailMap.isEmpty()) {
// 环回起点
return virtualNodes.firstEntry().getValue();
}
return tailMap.get(tailMap.firstKey());
}
/**
* 使用MD5哈希算法(也可用其他哈希函数)
*/
private long getHash(String str) {
try {
MessageDigest md = MessageDigest.getInstance("MD5");
md.update(str.getBytes());
byte[] digest = md.digest();
// 取前8字节作为64位哈希值
long hash = 0;
for (int i = 0; i < 8; i++) {
hash |= ((long) (digest[i] & 0xFF)) << (8 * i);
}
return hash & 0xffffffffL; // 取32位
} catch (NoSuchAlgorithmException e) {
// 降级到简单哈希
return str.hashCode() & 0xffffffffL;
}
}
/**
* 获取节点分布统计
*/
public Map<String, Integer> getDistributionStats(List<String> testKeys) {
Map<String, Integer> stats = new HashMap<>();
for (String node : realNodes) {
stats.put(node, 0);
}
for (String key : testKeys) {
String node = getNode(key);
stats.put(node, stats.get(node) + 1);
}
return stats;
}
/**
* 测试示例
*/
public static void main(String[] args) {
ConsistentHash ch = new ConsistentHash(150); // 每个节点150个虚拟节点
// 添加节点
ch.addNode("192.168.1.1:8080");
ch.addNode("192.168.1.2:8080");
ch.addNode("192.168.1.3:8080");
// 测试数据分布
List<String> testKeys = new ArrayList<>();
for (int i = 0; i < 10000; i++) {
testKeys.add("key_" + i);
}
Map<String, Integer> stats = ch.getDistributionStats(testKeys);
System.out.println("数据分布情况:");
for (Map.Entry<String, Integer> entry : stats.entrySet()) {
System.out.println(entry.getKey() + ": " + entry.getValue() + " 个key");
}
// 测试节点增减
System.out.println("\\n添加新节点 192.168.1.4:8080");
ch.addNode("192.168.1.4:8080");
// 计算数据迁移比例
int migrated = 0;
for (String key : testKeys) {
String oldNode = stats.keySet().iterator().next(); // 简化计算
String newNode = ch.getNode(key);
if (!oldNode.equals(newNode)) {
migrated++;
}
}
System.out.println("数据迁移比例: " + (migrated * 100.0 / testKeys.size()) + "%");
}
}
4. 随机算法
随机算法的核心思想极其直接:假设有 N 台服务器 S = {S₀, S₁, S₂, …, Sₙ},每次有新的请求到达时,负载均衡器会生成一个 0 到 N-1 之间的随机整数,将这个数字作为索引,从服务器列表中选出对应的那一台来处理当前请求。
📊 随机选择流程
Step 1(请求到达)→ Step 2(生成随机数)→ Step 3(映射服务器)→ Step 4(转发请求)
整个过程无需维护任何状态信息,决策在瞬间完成
// 服务器管理类
public class ServerManager {
public static Map<String, Integer> serverMap = new TreeMap<>();
static {
serverMap.put("192.168.1.1", 1);
serverMap.put("192.168.1.2", 2);
serverMap.put("192.168.1.3", 3);
serverMap.put("192.168.1.4", 4);
}
}
// 随机负载均衡类
public class RandomBalance {
public static String getServer() {
Set<String> serverSet = ServerManager.serverMap.keySet();
List<String> serverList = new ArrayList<>(serverSet);
Random random = new Random();
// 生成0到serverList.size()-1的随机整数
int index = random.nextInt(serverList.size());
return serverList.get(index);
}
public static void main(String[] args) {
// 测试10次请求分配
for (int i = 0; i < 10; i++) {
String server = getServer();
System.out.println("请求 " + (i+1) + " → " + server);
}
}
}
5、加权随机算法
加权随机算法的核心思想很简单:给每个服务器分配一个权重值,权重越高,被选中的概率就越大。但实现这个“概率映射”却有不同的方法,每种方法在性能、内存和适用场景上各有千秋。

四种实现方案对比
从最简单的列表复制到高效的前缀和二分查找,加权随机算法有多种实现方式,每种都有其适用场景。
| 列表复制法 | 按权重将服务器重复加入列表,随机选择索引 | 选择O(1),初始化O(∑W) | O(∑W) | 权重小且固定的场景 |
| 区间判断法 | 生成随机数后,依次减去权重判断区间 | 选择O(n) | O(1) | 服务器数量少的场景 |
| 排序优化法 | 按权重降序排序,减少平均比较次数 | 选择O(n),排序O(n log n) | O(1) | 权重差异大的场景 |
| 前缀和+二分查找 | 计算累积权重,二分查找随机数位置 | 选择O(log n),更新O(n) | O(n) | 服务器数量多、权重常变的场景 |
下面以Java语言展示前缀和+二分查找的实现,这是工程中最常用且高效的方法:
import java.util.*;
public class WeightedRandomBalancer {
private List<String> servers;
private List<Integer> weights;
private int[] prefixSum;
private int totalWeight;
private Random random;
public WeightedRandomBalancer(Map<String, Integer> serverWeights) {
this.servers = new ArrayList<>(serverWeights.keySet());
this.weights = new ArrayList<>(serverWeights.values());
this.random = new Random();
rebuildPrefixSum();
}
// 重建前缀和数组
private void rebuildPrefixSum() {
prefixSum = new int[weights.size()];
totalWeight = 0;
for (int i = 0; i < weights.size(); i++) {
totalWeight += weights.get(i);
prefixSum[i] = totalWeight;
}
}
// 加权随机选择服务器
public String selectServer() {
if (servers.isEmpty()) {
throw new IllegalStateException("No servers available");
}
// 生成[1, totalWeight]范围内的随机数
int r = random.nextInt(totalWeight) + 1;
// 二分查找找到第一个前缀和≥r的位置
int left = 0, right = prefixSum.length – 1;
while (left < right) {
int mid = left + (right – left) / 2;
if (prefixSum[mid] < r) {
left = mid + 1;
} else {
right = mid;
}
}
return servers.get(left);
}
// 更新服务器权重
public void updateServer(String server, int newWeight) {
int index = servers.indexOf(server);
if (index != -1) {
weights.set(index, newWeight);
rebuildPrefixSum();
}
}
// 测试代码
public static void main(String[] args) {
Map<String, Integer> config = new HashMap<>();
config.put("192.168.1.1:8080", 5); // 高性能服务器
config.put("192.168.1.2:8080", 3); // 中等性能
config.put("192.168.1.3:8080", 1); // 低性能服务器
WeightedRandomBalancer balancer = new WeightedRandomBalancer(config);
// 模拟10000次请求分布
Map<String, Integer> stats = new HashMap<>();
for (int i = 0; i < 10000; i++) {
String server = balancer.selectServer();
stats.put(server, stats.getOrDefault(server, 0) + 1);
}
System.out.println("请求分布统计:");
stats.forEach((server, count) -> {
double percentage = (count / 10000.0) * 100;
System.out.printf("%s: %d次 (%.1f%%)\\n", server, count, percentage);
});
}
}
这段代码的核心是前缀和数组和二分查找。假设权重为[5, 3, 1],前缀和数组就是[5, 8, 9]。生成1-9的随机数,通过二分查找快速定位到对应的服务器索引。
6、最少连接数算法
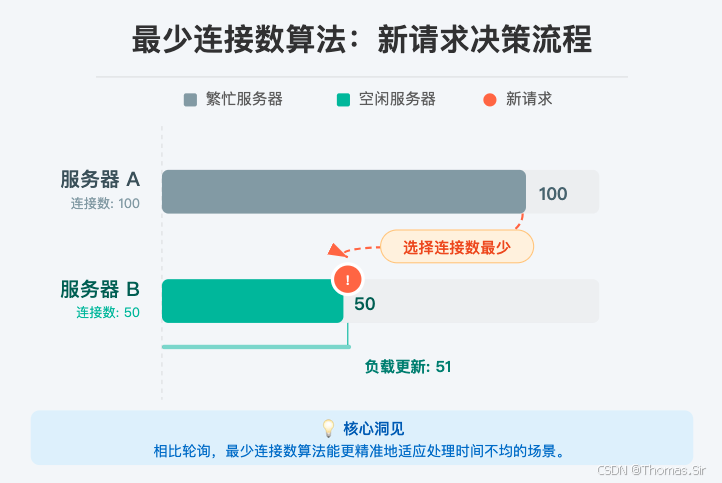
最少连接数算法的核心假设简单而有力:当前活跃连接数最少的服务器,其负载最轻,最有能力快速处理新请求。它把连接数当作服务器繁忙程度的“实时温度计”,每一次调度都是一次全新的“体温”测量。
import java.util.concurrent.atomic.AtomicInteger;
import java.util.List;
import java.util.ArrayList;
import java.util.concurrent.locks.ReentrantLock;
class Server {
String ip;
AtomicInteger activeConnections;
ReentrantLock lock;
public Server(String ip) {
this.ip = ip;
this.activeConnections = new AtomicInteger(0);
this.lock = new ReentrantLock();
}
public void incrementConnections() {
activeConnections.incrementAndGet();
}
public void decrementConnections() {
activeConnections.decrementAndGet();
}
public int getConnections() {
return activeConnections.get();
}
}
public class LeastConnectionsBalancer {
private List<Server> servers;
private final ReentrantLock lock = new ReentrantLock();
public LeastConnectionsBalancer(List<Server> servers) {
this.servers = new ArrayList<>(servers);
}
public Server getLeastLoadedServer() {
lock.lock();
try {
Server leastLoaded = null;
int minConnections = Integer.MAX_VALUE;
for (Server server : servers) {
int connections = server.getConnections();
if (connections < minConnections) {
minConnections = connections;
leastLoaded = server;
}
}
return leastLoaded;
} finally {
lock.unlock();
}
}
public void handleRequest(Runnable task) {
Server server = getLeastLoadedServer();
if (server != null) {
server.incrementConnections();
try {
// 模拟处理请求
task.run();
} finally {
server.decrementConnections();
}
}
}
public static void main(String[] args) {
List<Server> servers = List.of(
new Server("192.168.1.10"),
new Server("192.168.1.11"),
new Server("192.168.1.12")
);
LeastConnectionsBalancer balancer = new LeastConnectionsBalancer(servers);
// 模拟多个请求
for (int i = 0; i < 10; i++) {
balancer.handleRequest(() -> {
System.out.println("Handling request on " + Thread.currentThread().getName());
try {
Thread.sleep(100); // 模拟处理时间
} catch (InterruptedException e) {
Thread.currentThread().interrupt();
}
});
}
}
}
关键实现细节
线程安全
使用 ReentrantLock 确保并发环境下服务器列表和连接数的原子性操作。
原子操作
使用 AtomicInteger 避免连接数更新时的竞态条件。
异常安全
使用 try-finally 确保即使请求处理失败,连接数也能正确递减。
四、Java生态中的实现方案
Java生态提供了多种负载均衡实现方案,从传统框架到现代云原生工具链:
-
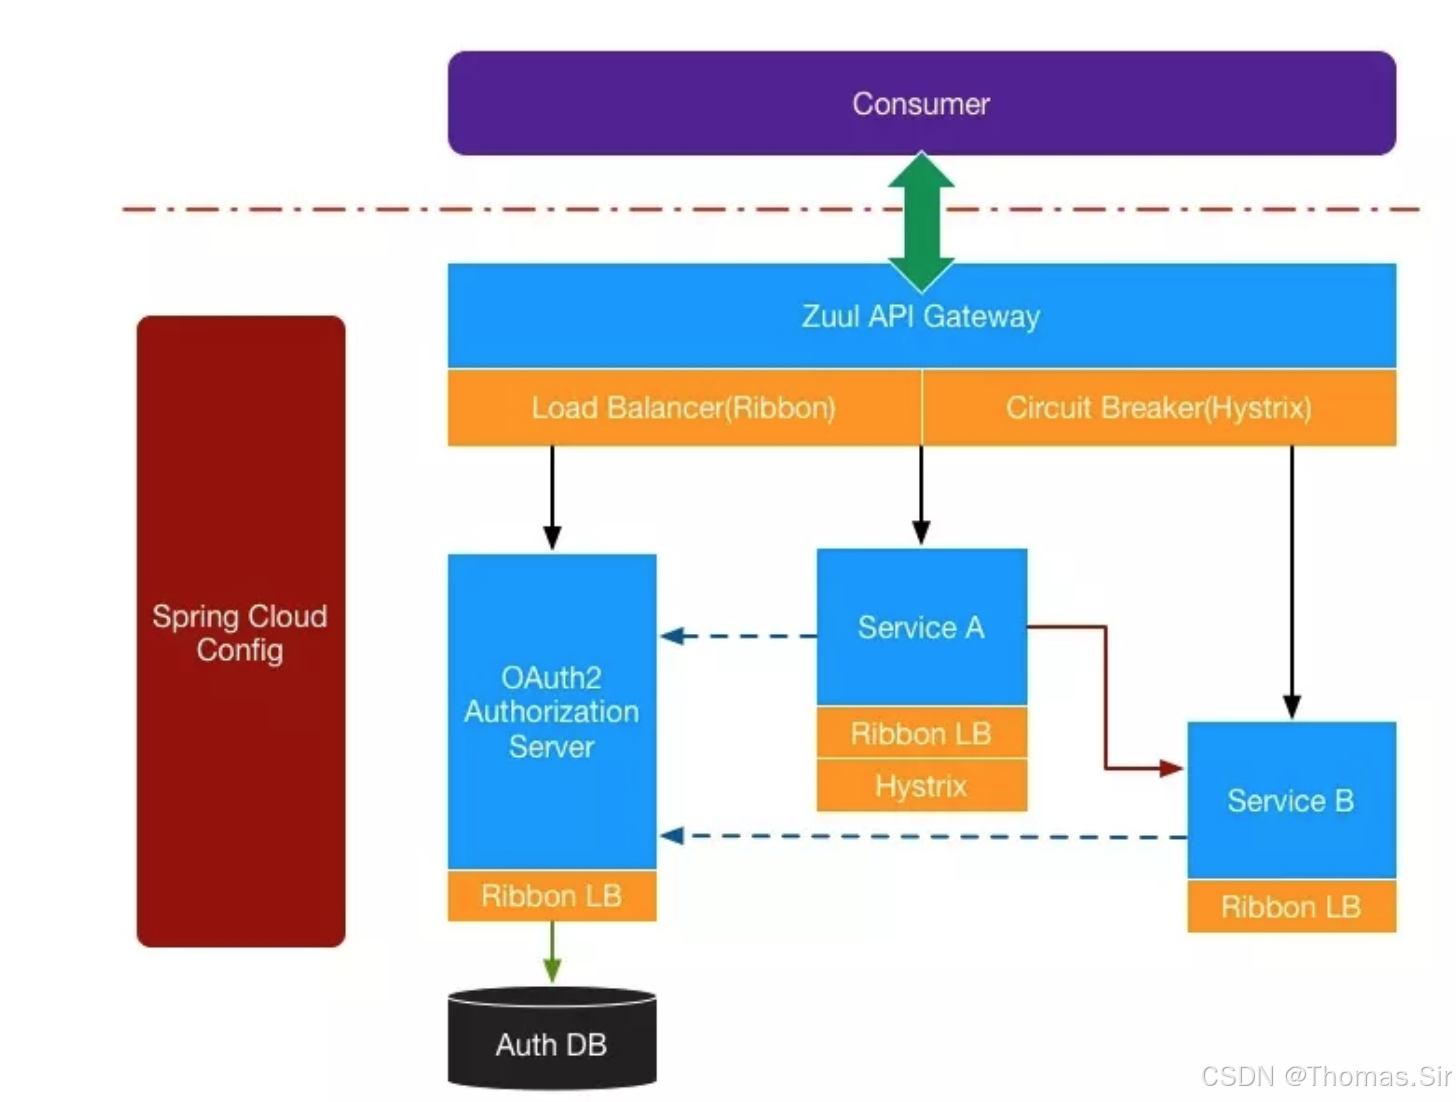
Spring Cloud LoadBalancer:Spring Cloud官方推荐的客户端负载均衡器,替代了Netflix Ribbon,支持轮询、随机等算法,与Spring生态深度集成。
-
Nginx:高性能的反向代理服务器,支持加权轮询、IP哈希、最少连接等多种算法,常用于服务端负载均衡。
-
Apache:通过mod_proxy_balancer模块提供负载均衡功能,支持轮询、加权轮询、最少连接数等算法。
-
HAProxy:专业的TCP/HTTP负载均衡器,支持丰富的算法包括最短响应时间法等。
-
Kubernetes Service:云原生时代的负载均衡方案,通过kube-proxy实现服务发现和负载均衡,支持会话保持和健康检查。
Spring Cloud LoadBalancer实战配置
在Spring Boot应用中,通过简单配置即可启用客户端负载均衡:
@Configuration
public class LoadBalancerConfig {
@Bean
@LoadBalanced
public RestTemplate restTemplate() {
return new RestTemplate();
}
}
// 使用负载均衡的RestTemplate调用服务
@RestController
public class ClientController {
@Autowired
private RestTemplate restTemplate;
@PostMapping("/seckill")
public String callSeckill(@RequestBody SeckillRequest request) {
return restTemplate.postForObject(
"http://seckill-service/seckill",
request,
String.class
);
}
}
五、高负载场景下的性能优化
在电商秒杀、实时流处理等高并发场景中,负载均衡的性能优化至关重要:

5.1、关键技术优化点
Java 21虚拟线程:利用虚拟线程的轻量级特性,大幅提升并发处理能力,减少线程上下文切换开销。
ZGC垃圾回收:使用ZGC降低GC暂停时间,确保在高负载下依然保持稳定的响应性能。
Resilience4j熔断限流:集成熔断器和限流器,防止雪崩效应,提升系统韧性。
Prometheus监控:实时监控QPS、延迟、命中率等关键指标,实现智能化运维。
六、架构演进与选型建议
负载均衡架构经历了从集中式到客户端再到服务网格的演进历程:
📋 方案选型指南
Nginx(集中式)
适合传统单体应用,成熟稳定易于监控,但存在单点风险。
Spring Cloud LoadBalancer(客户端)
适合微服务架构,无中间节点响应快,但需集成到应用中。
Istio(服务网格)
适合云原生架构,零代码侵入策略统一,但架构复杂。
选择负载均衡方案时,需要综合考虑后端服务器的性能特点、业务需求、系统的可扩展性和容错性等因素,甚至可以结合多种算法来构建更加灵活高效的负载均衡策略。
七、写在最后的话
架构师的思考:
负载均衡不仅是技术选型,更是系统设计的哲学。优秀的负载均衡策略如同精密的钟表,每个齿轮的转动都影响着整个系统的节奏。在分布式系统的世界里,没有最好的算法,只有最适合场景的选择。