本文最小任务 Hello AI
我们用最简单的 BP 神经网络,基于 输入层(1) → 隐藏层(4) → 输出层(1) ,以6个神经元实现学习 1是不是1,0是不是0;
函数及参数
最简单的BP神经网络有如下参数:
 |
输入层神经元数量 | 1 |
 |
隐藏层神经元数量 | 4 |
 |
输出层神经元数量 | 1 |
 |
输入层第 i 个神经元输入值 | x = 0 或 1 |
 |
隐藏层第 j 个神经元输出值 | h 的输出是对这个输入的“激活” |
 |
输出层第 k 个神经元输出值 | |
 |
输入层 i→ 隐藏层 j 的权重 | 在本程序中以w1表示 |
 |
隐藏层 j→ 输出层 k 的权重 | 在本程序中以w2表示 |
 |
隐藏层第 j 个神经元偏置 | 在本程序中以b1表示 |
 |
输出层第 k 个神经元偏置 | 在本程序中以b2表示 |
| f(⋅) | 隐藏层激活函数 | 在本程序中采用ReLU函数 |
| g(⋅) | 输出层激活函数 | 在本程序中采用Sigmoid函数 |
 |
输出层第 k 个神经元期望输出 | 正确答案,是个常数 |
| E | 单个样本损失函数 | MSE 均方差 mean-square error |
| η | 学习率 | 0.1 |
| m | 样本数 | 80 |
激活函数
激活函数是为神经网络引入非线性特性的关键组件,激活函数(如 ReLU、Sigmoid)通过非线性变换(如 h = ReLU(X·W1 + b1)),让网络能学习到输入和输出之间的非线性映射关系
| 无激活函数的纯线性网络 | ✅ 可以 | ❌ 不可以 |
| 带激活函数的非线性网络 | ✅ 可以 | ✅ 可以 |
ReLU
线性修正函数 Rectified Linear Unit, ReLU 又称整流函数,其函数本体及导数为:
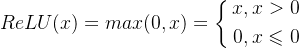
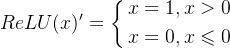
Sigmoid
Sigmoid函数常被用作神经网络的激活函数,将变量映射到0,1之间
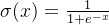
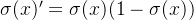
链式法则:
若函数 y 是 u 的函数,而 u 又是 x 的函数(即 y=f(u), u=g(x)),则 y 对 x 的导数等于 y 对 u 的导数 乘以 u 对 x 的导数
FNN 前馈神经网络(feedforward neural network,FNN)
FNN是一种无环的神经网络结构,信号从输入层开始,依次经过隐藏层,最终传递到输出层,结构是 “单向流动” 的,数据只能向前传播,不能向后传递,没有任何反馈连接(即信号不会从输出层返回输入层)。目标是通过调整网络参数(权重、偏置),让模型对输入数据做出准确预测或分类。
BP(Backpropagation)神经网络是最基础的神经网络,其输出结果采用前向传播,误差采用反向传播方式进行。
FNN 是“被训练的对象”,BP 是“训练 FNN 的工具”,二者是“载体” 与 “方法”的关系,缺一不可。
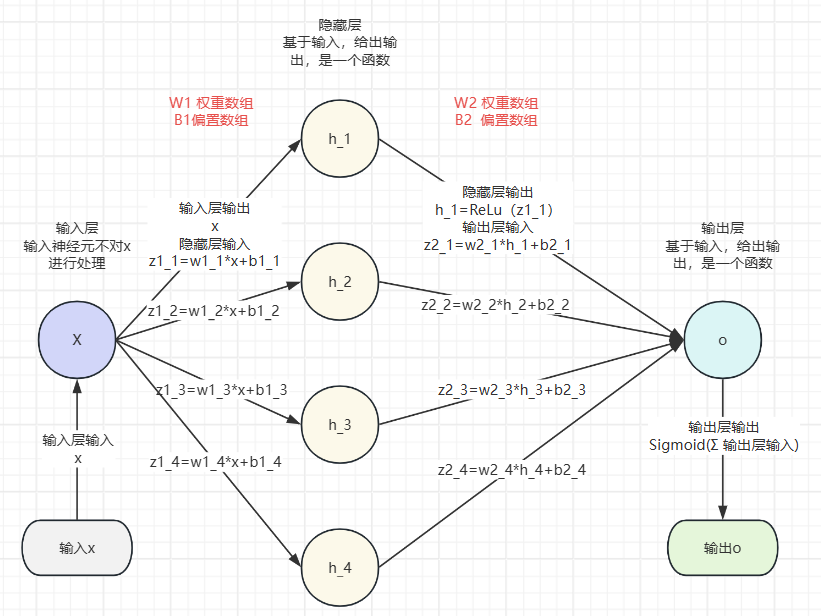
前向传播(Forward Propagation)
核心逻辑:输入信号逐层加权求和 + 激活函数变换,最终输出预测值,计算损失。
1. 隐藏层计算
-
隐藏层加权输入(输入与权重的点积 + 偏置, 在下方python代码中h用1表示):
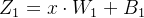
其中 ⋅ 表示矩阵乘法,偏置会自动广播到 m 个样本。
-
隐藏层输出(经过激活函数引入非线性):
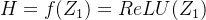
2. 输出层计算
-
输出层加权输入(隐藏层与权重的点积 + 偏置, 在下方python代码中o用2表示):
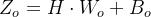
-
输出层预测值:
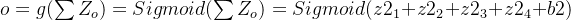
* 由于B1 在运算过程中对结果有影响,而B2 终归会加和在一起才产生影响,所以B2 可以退化成单个常数b2
输出对输出层输入求导:

隐藏层输出对隐藏层输入求导

3. 损失函数计算
以均方误差 MSE 为例,适用于回归任务,单样本损失扩展到批量样本:
MSE 多样本:

MSE 单样本:

在输出伸进元只有一个时,即 
 其中d是正确答案,是个常数
损失对输出的偏导:

误差表示好之后,我们就要求导数了。这里的参数包括权重和偏置。所以要求损失函数对权重和偏置的导数。
反向传播(Backward Propagation)
核心逻辑:利用链式法则,从输出层反向计算损失对权重与偏置的导数,再用梯度下降更新参数。
1.误差求导
 |
delta2 | 输出层误差项  |
(80, 1) |
 |
delta1 | 隐藏层误差项  |
(80, 4) |
| W2 | self.W2 | 隐藏层→输出层的权重矩阵 | (4, 1) |
| W2T | self.W2.T | W2 的转置矩阵 | (1, 4) |
| z1 | self.z1 | 隐藏层加权和(z1=x⋅W1+b1) | (80, 4) |
| ReLU′(z1) | self.relu_deriv(self.z1) | ReLU 激活函数的导数 | (80, 4) |
输出层误差

隐藏层误差

2. 输出层梯度计算
| dW1 |  |
(1, 4) | 损失对 W1 的梯度 |
| db1 |  |
(1, 4) | 损失对 b1 的梯度 |
| dW2 |  |
(4, 1) | 损失对 W2 的梯度 |
| db2 |  |
(1, 1) | 损失对 b2 的梯度 |
梯度可以理解为:在参数空间中,让损失函数 “下降最快” 的方向 + 下降的 “速度”(大小)。
用生活中的例子类比,你站在一座山上(损失函数的 “地形”),目标是走到山脚(损失最小),梯度就是 “你当前位置,往哪个方向走,下山最快?每走一步能下降多少?”
神经网络的参数(W1、b1、W2、b2)就是 “你在山上的坐标”,梯度就是 “调整坐标的方向和幅度”,让你一步步走到山脚。
这就是梯度下降法,核心逻辑是:
参数 = 参数 – 学习率 × 梯度
训练结果如下

计算模型的参数量与内存占用
现在AI 领域比较火的7B 大模型,是指70亿个参数,那我们这段代码是多大呢,这是个超轻量级模型,只有 13 个可训练参数
| W1 | self.W1 = np.random.randn(1, 4) * 0.1 | (1, 4) | 1×4 = 4 | 1 个输入神经元→4 个隐藏神经元,每个连接对应 1 个权重 |
| b1 | self.b1 = np.zeros((1, 4)) | (1, 4) | 1×4 = 4 | 4 个隐藏神经元,每个对应 1 个偏置 |
| W2 | self.W2 = np.random.randn(4, 1) * 0.1 | (4, 1) | 4×1 = 4 | 4 个隐藏神经元→1 个输出神经元,每个连接对应 1 个权重 |
| b2 | self.b2 = np.zeros((1, 1)) | (1, 1) | 1×1 = 1 | 1 个输出神经元,对应 1 个偏置 |
| 总计 | – | – | 13 个 | 4+4+4+1 = 13 |
算模型的内存占用(多少 B)
NumPy 中默认的浮点数类型是 float64(双精度浮点数),每个 float64 占用 8 字节(B);如果是 float32(单精度),每个占用 4B。我们分两种情况计算:
按默认的 float64 计算(代码中实际使用的类型)
| W1 | 4 | 8 | 4×8 = 32 |
| b1 | 4 | 8 | 4×8 = 32 |
| W2 | 4 | 8 | 4×8 = 32 |
| b2 | 1 | 8 | 1×8 = 8 |
| 总计 | 13 | – | 104 B |
Python 代码
代码如下
import numpy as np
import matplotlib.pyplot as plt
import tkinter as tk
from tkinter import simpledialog, messagebox
# ==================== 设置Matplotlib中文显示 ====================
plt.rcParams['font.sans-serif'] = ['SimHei'] # 用来正常显示中文标签
plt.rcParams['axes.unicode_minus'] = False # 用来正常显示负号
# 1. 定义神经网络类(三层:输入层1→隐藏层4→输出层1)
class ThreeLayerNN:
def __init__(self):
# 初始化权重
self.W1 = np.random.randn(1, 4) * 0.1
self.b1 = np.zeros((1, 4))
self.W2 = np.random.randn(4, 1) * 0.1
self.b2 = np.zeros((1, 1))
# 记录权重和损失变化
self.W1_history = []
self.W2_history = []
self.loss_history = []
# 新增:统计参数数量和内存大小
def get_params_info(self):
# 计算参数数量
w1_num = self.W1.size
b1_num = self.b1.size
w2_num = self.W2.size
b2_num = self.b2.size
total_params = w1_num + b1_num + w2_num + b2_num
# 计算内存大小
param_dtype = self.W1.dtype
bytes_per_param = param_dtype.itemsize
total_bytes = total_params * bytes_per_param
total_kb = total_bytes / 1024
return {
"total_params": total_params,
"bytes_per_param": bytes_per_param,
"total_bytes": total_bytes,
"total_kb": round(total_kb, 4)
}
# ReLU激活函数
def relu(self, x):
return np.maximum(0, x)
# ReLU导数
def relu_deriv(self, x):
return (x > 0).astype(np.float32)
# Sigmoid激活函数
def sigmoid(self, x):
return 1 / (1 + np.exp(-x))
# Sigmoid导数
def sigmoid_deriv(self, x):
return x * (1 – x)
# 前向传播
def forward(self, x):
self.z1 = np.dot(x, self.W1) + self.b1
self.h1 = self.relu(self.z1)
self.z2 = np.dot(self.h1, self.W2) + self.b2
self.o = self.sigmoid(self.z2)
return self.o
# 反向传播(梯度下降)
def backward(self, x, y, output, lr=0.2):
# 计算输出层误差
delta2 = (output – y) * self.sigmoid_deriv(output)
# 计算隐藏层误差
delta1 = np.dot(delta2, self.W2.T) * self.relu_deriv(self.z1)
# 计算梯度(按批次均值)
batch_size = x.shape[0]
dW2 = np.dot(self.h1.T, delta2) / batch_size
db2 = np.sum(delta2, axis=0, keepdims=True) / batch_size
dW1 = np.dot(x.T, delta1) / batch_size
db1 = np.sum(delta1, axis=0, keepdims=True) / batch_size
# 更新权重和偏置
self.W1 -= lr * dW1
self.b1 -= lr * db1
self.W2 -= lr * dW2
self.b2 -= lr * db2
# 记录权重均值
self.W1_history.append(np.mean(self.W1))
self.W2_history.append(np.mean(self.W2))
# 生成80组0/1数据(各40个,打乱顺序)
def generate_data(num_samples=80):
X = np.vstack([np.zeros((num_samples // 2, 1)), np.ones((num_samples // 2, 1))])
y = X.copy()
# 打乱顺序
indices = np.arange(num_samples)
np.random.shuffle(indices)
X = X[indices]
y = y[indices]
return X, y
# 训练神经网络
def train_nn():
nn = ThreeLayerNN()
X_train, y_train = generate_data(80)
epochs = 1000
learning_rate = 0.2
for epoch in range(epochs):
output = nn.forward(X_train)
nn.backward(X_train, y_train, output, learning_rate)
# 计算并记录损失
loss = np.mean((output – y_train) ** 2)
nn.loss_history.append(loss)
# 每50轮打印一次
if epoch % 50 == 0:
print(f"Epoch {epoch}, Loss: {loss:.6f}, W1均值: {np.mean(nn.W1):.4f}, W2均值: {np.mean(nn.W2):.4f}")
return nn
# 可视化(优化参数信息显示位置,无遮挡)
def plot_results(nn):
params_info = nn.get_params_info()
fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(12, 10))
# ==================== 1. 权重变化曲线(参数信息整合到标题,无遮挡) ====================
weight_title = (
f"神经网络权重随训练次数变化 | 模型参数:{params_info['total_params']}个 | "
f"内存占用:{params_info['total_bytes']}字节({params_info['total_kb']}KB)"
)
ax1.plot(nn.W1_history, label='隐藏层W1均值', color='blue')
ax1.plot(nn.W2_history, label='输出层W2均值', color='red')
ax1.set_xlabel('训练轮数', fontsize=10)
ax1.set_ylabel('权重均值', fontsize=10)
ax1.set_title(weight_title, fontsize=11, fontweight='bold', pad=15) # pad增加标题间距
ax1.legend(loc='upper right', fontsize=9) # 图例移到右上角
ax1.grid(True, alpha=0.3)
# ==================== 2. 损失变化曲线(最终损失移到右上角,无遮挡) ====================
ax2.plot(nn.loss_history, label='均方误差损失', color='green')
ax2.set_xlabel('训练轮数', fontsize=10)
ax2.set_ylabel('损失值', fontsize=10)
ax2.set_title('损失随训练次数变化', fontsize=12, fontweight='bold')
ax2.legend(loc='upper right', fontsize=9)
ax2.grid(True, alpha=0.3)
# 最终损失标注移到右上角(y轴0.8位置)
final_loss = nn.loss_history[-1]
ax2.text(0.98, 0.8, f"最终损失值:{final_loss:.6f}",
transform=ax2.transAxes,
fontsize=9,
horizontalalignment='right',
verticalalignment='center',
bbox=dict(boxstyle='round', facecolor='lightgreen', alpha=0.8))
plt.tight_layout()
plt.show()
# 弹窗交互预测
def predict_interactive(nn):
root = tk.Tk()
root.withdraw()
while True:
user_input = simpledialog.askstring("输入", "请输入0或1(输入q退出):")
if user_input is None or user_input.lower() == 'q':
messagebox.showinfo("提示", "退出预测程序!")
break
if user_input not in ['0', '1']:
messagebox.showerror("错误", "请输入有效的0或1!")
continue
x = np.array([[int(user_input)]])
prediction = nn.forward(x)
result = 1 if prediction > 0.5 else 0
messagebox.showinfo("识别结果",
f"输入:{user_input}\\n"
f"预测概率值:{prediction[0][0]:.4f}\\n"
f"识别结果:{result}")
root.destroy()
# 主程序执行
if __name__ == "__main__":
print("开始训练神经网络…")
trained_nn = train_nn()
print("训练完成!")
print("绘制权重和损失变化曲线(含参数信息)…")
plot_results(trained_nn)
print("启动交互预测窗口…")
predict_interactive(trained_nn)