
◆ 博主名称: 晓此方-CSDN博客
大家好,欢迎来到晓此方的博客。
⭐️C++系列个人专栏:
Re:从零开始的C++_晓此方的博客-CSDN博客
⭐️踏破千山志未空,拨开云雾见晴虹。 人生何必叹萧瑟,心在凌霄第一峰
目录
0.1概要&序論
一,接下来我们要讲什么
1.1一张图理清
1.2C++图书馆传送门
二,简述编码与string之间的关系
2.1编码的官方定义
2.2编码的分类
三,补充点关于编码实操的东西
3.1怎么表示&怎么打印
3.2存储规则
3.2.1UTF-8的存储规则
3.2.2编码设计的连续性
四,默认成员函数
4.1构造函数
4.1.1相关举例
4.2析构函数
4.3赋值运算符重载
4.3.1相关举例
五,三大遍历方案
5.1operator[]
5.1.1size()接口
5.1.2c_str()接口
5.1.3使用operator[]接口遍历
5.2iterator
5.2.1迭代器的定义与存在的原因
5.2.2string迭代器的使用与注意事项
5.2.2.1解释一下这一堆接口编辑
5.2.2.2尝试写一个迭代器
5.2.2.3迭代器的注意事项
5.3范围for
5.3.1获取类型名
5.3.2auto
5.3.3范围for的使用
六,容量相关接口
6.1获取具体容量数据
6.2resize()接口
6.3reserve()接口
6.4clear()接口
6.5empty()接口
6.6strink_to_fit()接口
七,获取字符相关接口
7.1at、back and front
0.1概要&序論
这里是此方,久しぶりです!。本文是本人C++核心语法三部曲的第二部分STL篇的第一章,在这里,我将为首先为大家介绍string的各种使用方法与底层剖析,内容由浅入深干货满满,千万不要错过。这里是「此方」。让我们现在开始吧!
一,接下来我们要讲什么
1.1string是什么
1.1.1string的定义
string可以理解为一个字符串数组,他是C++ 标准库里用来存放字符序列的类。实际上string出现的比stl早,但是从功能上讲我们愿意将string归类到stl。
但也正因此,string在设计过程当中出现了非常多的冗余接口,又因为“语言发展的向前兼容原则”持续存在至今,不过根据二八原则,我们实际上只需要掌握常用的20%即可,剩下的冷门接口在使用时查阅,不过本文我会尽可能多的讲全讲透。
1.1.2string有什么用
我们日常生活中的身份证号码等数据的数字大小早已超过了计算机的数字可存储上限。于是string的出现就变得不可避免。
1.1.3头文件
头文件叫:#include<string>(为了区分C语言的字符串函数头文件<string.h>)
1.2一张图理清
初见STL,大家什么都不明白,甚至对于模板还不是很清晰的时候,我觉得,在讲之前先捋一捋,我们要讲什么?知识的结构是什么?方便大家理解。
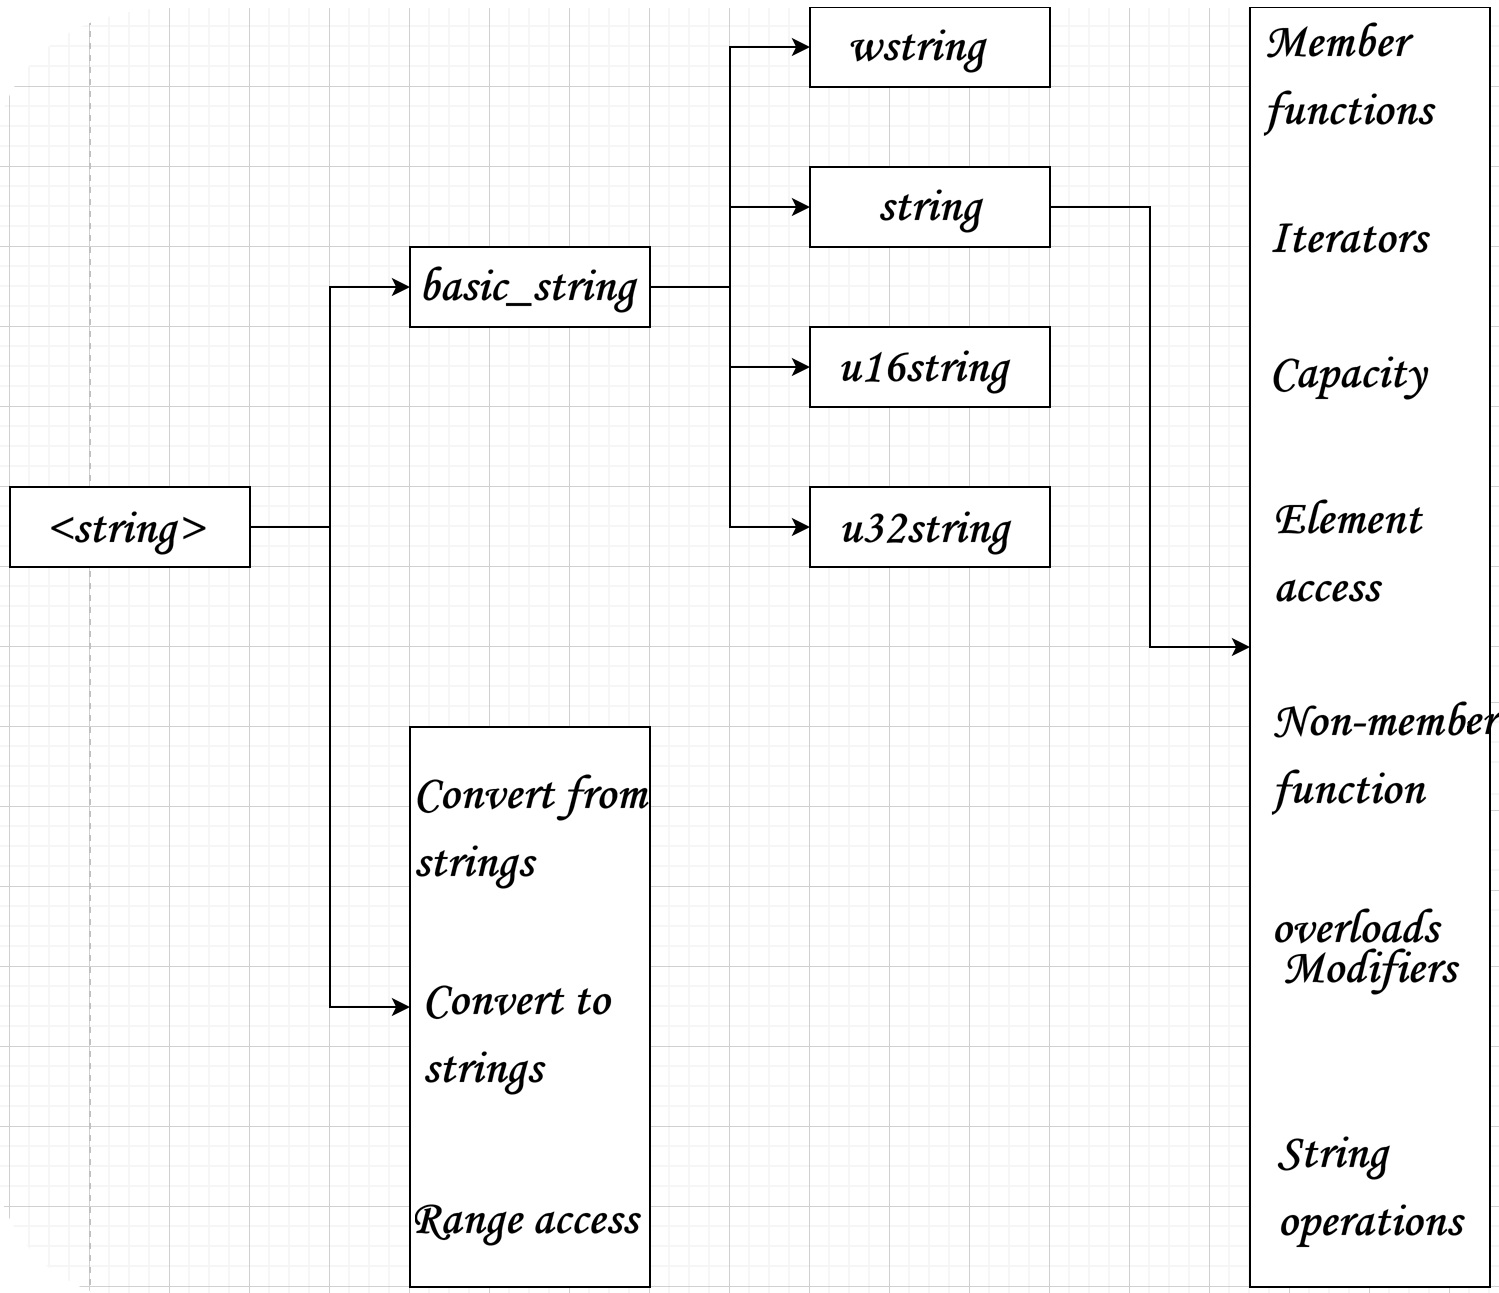
一张图清晰的概括以下要讲述的内容,我们来解释一下:
1.3C++图书馆传送门
– C++ Reference
 https://legacy.cplusplus.com/reference/string/
二,简述编码与string之间的关系
2.1编码的官方定义
编码:指按照预定规则将信息、数据或符号映射到另一种表示形式的 系统化集合 或 规则体系。在计算机中,通常特指 字符编码,即将字符集中的每个字符映射为唯一的二进制序列的规则集合。
2.2编码的分类
早期编码只有用于映射字母与各种简单符号的ASCLL码:

后来,为了存储和打印世界各国的语言文字,出现了unicode(统一码,又称为万国码),这其中有了UTF-8,UTF-16,UTF-32等多种编码规则。
各种编码在世界使用量占比:UTF-8在世界编码使用中占据主导地位,这也是本文的主角。

对于不同类型的编码,会产生不同类型的字符,虽然表面上一致,但是底层存在很大的差异,于是为了解决这种问题,C++在basic_string的基础上实例化出针对不同编码类型的字符串类,并将他们typedef形成下表的各种字符串类:

我们总结一下:
| 编码类型 | 字符串类 | 原型 |
| UTF-8 | string | typedef basic_string<char> string; |
| UTF-16(C++11新增) | u16string | typedef basic_string<char16_t> u16string; |
| UTF-32(C++11新增) | u32string | typedef basic_string<char32_t> u32string; |
| 宽字符 | wstring | typedef basic_string<wchar_t> wstring; |
三,补充点关于编码实操的东西
(这块儿可以直接跳过)
3.1怎么表示&怎么打印
char16_t b[] = u"哈吉米";
char32_t c[] = U"哈吉米";
wchar_t d[] = L"哈吉米";
如上,表示字符串的规则:char无特殊要求,char16_t 在字符串前面加u;char32_t 在字符串前面加U;wchar_t 在字符串前面加L;
打印方面,utf-16和utf-32的字符不能直接打印(C++的流插入没有重载相关函数),必须在程序内转化成utf-8才能打印。
cout << a << " " << b << " " << c << " " << d << endl;
结果:哈哈哈 0000009CAB6FFAC8 0000009CAB6FFAE8 0000009CAB6FFB18
3.2存储规则
3.2.1UTF-8的存储规则
UTF-8 是可变长度编码,根据码点大小使用 1~4 个字节存储字符。
|
1字节 |
0xxxxxxx |
7 |
0 ~ 127 |
|
2字节 |
110xxxxx 10xxxxxx |
11 |
128 ~ 2047 |
|
3字节 |
1110xxxx 10xxxxxx 10xxxxxx |
16 |
2048 ~ 65535 |
|
4字节 |
11110xxx 10xxxxxx 10xxxxxx 10xxxxxx |
21 |
65536 ~ 2097151 |
多字节结构中,首字节标明长度,后续字节均以 10 开头存储剩余编码位。这样既保证了前向兼容,也避免与 ASCII 冲突。

-
char[] 存放的是 UTF-8 编码。一个汉字在 UTF-8 中通常占 2个字节,所以你看到的是若干负数(因为最高位为 1)。
-
char16_t[] 存放 UTF-16。一个 BMP 区汉字占 2 字节,因此每个元素是一个 16 位的 Unicode 码点。
-
char32_t[] 和 wchar_t[](在大多数 Linux 上等价于 32 位) 都按 UTF-32 存,直接保存 Unicode 码点.
3.2.2编码设计的连续性
char a[] = "你好";cout << a << endl;
a[1]++;cout << a << " "; a[3]++; cout << a << endl;
a[1]++;cout << a << " "; a[3]++; cout << a << endl;
a[1]++;cout << a << " "; a[3]++; cout << a << endl;
你好
匿好 匿耗
腻耗 腻号
逆号 逆浩
如上,我们将a的两个编码的值反复++并打印得到这样一串文字。我们发现,在UTF-8中每个汉字的存储根据发音具有连续性。
以下正式开始讲解sring的各种接口
四,默认成员函数
4.1构造函数

由于历史问题,C++为我们提供了一大堆接口,这些接口中很多的实用性并不强。C++11新增了两个我们放在后面讲。
| (1) | 默认构造 | string(); | 创建一个空字符串。 |
| (2) | 拷贝构造 | string(const string& str); | 使用另一个 string 对象进行拷贝。 |
| (3) | 子串构造 | string(const string& str, size_t pos, size_t len = npos); | 从另一个字符串中提取子串(从位置 pos 开始,长度为 len)。如果 len 超出范围,则取到末尾。 |
| (4) | 从 C 风格字符串构造 | string(const char* s); | 用以 null 结尾的字符数组(C 字符串)初始化。 |
| (5) | 从字符序列构造 | string(const char* s, size_t n); | 使用字符数组的前 n 个字符构造,不依赖 null 结尾。 |
| (6) | 填充构造 | string(size_t n, char c); | 创建一个包含 n 个字符 c 的字符串。 |
| (7) | 迭代器范围构造 | template <class InputIterator> string(InputIterator first, InputIterator last); | 使用迭代器范围 [first, last) 构造字符串(例如从容器或数组中)。 |
4.1.1相关举例
string str1("abcdef");//从C风格字符串构造
string str11;//默认构造
string str111(str1);//拷贝构造
打印结果:
abcdef
abcdef
4.1.2稍微补充一下npos

nops表示size_t 的最大值这个常量被定义为-1,但由于size_t是无符号整型类型,-1会被转换为该类型所能表示的最大值。 npos是一个静态的成员变量,可以在类里面用不能改变它的值。
npos是一个静态成员常量,它的值等于size_t类型所能表示的最大值。当这个值被用作string成员函数参数时,它表示“直到字符串末尾”。作为返回值时,它通常用来表示“没有找到匹配项”。
4.2析构函数
略,实际上不用你管,析构的该析构的时候会自己调用

4.3赋值运算符重载

| (1) | 字符串赋值 | string& operator=(const string& str); | 将另一个 string 对象的内容复制到当前对象。 |
| (2) | C 风格字符串赋值 | string& operator=(const char* s); | 使用以 null 结尾的 C 字符串(如 "Hello")赋值。 |
| (3) | 单个字符赋值 | string& operator=(char c); | 将当前字符串设置为仅包含一个指定字符 c。 |
4.3.1相关举例
string str3("qwerty");
str3 = str1;
cout << str3 << endl;
str3 = "qwedhiwdji";
cout << str3 << endl;
str3 = 'k';
cout << str3 << endl;
打印结果:
abcdef
qwedhiwdji
k
五,三大遍历方案
5.1operator[]
咱们得先补充两个小东西
5.1.1size()接口

调用size()接口可以获得当前字符串的大小(字符个数,不包括\\0)。
string str1("abcdef");
cout << str1.size() << endl;
5.1.2c_str()接口

调用c_str()接口可以获取C风格的字符串,以指针形式返回。
string str1("abcdef");
cout << str1.c_str()<< endl;
5.1.3使用operator[]接口遍历

string支持两种operator[]重载,用于针对const/非const对象。string本质上可以理解为一个“字符数组”,那么我们就可以像调用数组那样调用string。
string str2("123465789");
for (int i = 0; i < str2.size(); i++)
{
cout << str2[i] << " ";
}
补充一下,这里的str2.size()可以用strlen(str2.c_str())代替。此外,值得一提的是:operator[]有越界检查(数组没有)你越界访问他会报错:

5.2iterator
5.2.1迭代器的定义与存在的原因
迭代器是一个抽象的访问器,用于以统一的方式顺序访问容器中的元素,而不暴露容器的底层存储结构。
迭代器是C++封装的一种体现,他的存在有利与程序员关注业务逻辑而不是调用每个容器所需要采取的不同遍历方式,提升了代码效率。
迭代器的使用与指针非常相似,但是其底层并不一定是指针,如string,由于其底层结构的简单性(数组)所以string迭代器的底层是指针,但是我们后面学习的map,list等容器的底层遍历显然不是指针。
5.2.2string迭代器的使用与注意事项
5.2.2.1解释一下这一堆接口 
| begin() | 返回指向容器第一个元素的正向迭代器 | iterator | 否(可修改) | 否 | C++98 |
| end() | 返回指向容器最后一个元素之后的正向迭代器(表示结束) | iterator | 否(可修改) | 否 | C++98 |
| rbegin() | 返回指向容器最后一个元素的反向迭代器(从后往前) | reverse_iterator | 否(可修改) | 是 | C++98 |
| rend() | 返回指向容器第一个元素之前的反向迭代器(表示反向结束) | reverse_iterator | 否(可修改) | 是 | C++98 |
| cbegin() | 返回指向容器第一个元素的常量正向迭代器(不可修改) | const_iterator | 是(只读) | 否 | C++11 |
| cend() | 返回指向容器最后一个元素之后的常量正向迭代器 | const_iterator | 是(只读) | 否 | C++11 |
| crbegin() | 返回指向容器最后一个元素的常量反向迭代器 | const_reverse_iterator | 是(只读) | 是 | C++11 |
| crend() | 返回指向容器第一个元素之前的常量反向迭代器 | const_reverse_iterator | 是(只读) | 是 | C++11 |
5.2.2.2尝试写一个迭代器
string::iterator sit = str3.begin();
while (sit != str3.end())
{
cout << *sit << " ";
sit++;
}
逐步分析:
同理我们写一个反向迭代器:
string::const_reverse_iterator crsit = str3.crbegin();
while (crsit != str3.crend())
{
cout << * crsit << " ";
crsit++;
}
这里的const_reverse_iterator表示只读反向迭代器。其中crbegin()获取字符串最后一个字符传递初始化给迭代器crsit,值得注意的是:crend()表示字符串首字符的前一个字符的地址。
5.2.2.3迭代器的注意事项
5.3auto与范围for
5.3.1获取类型名
- 运算符typeid(),获取表达式x的类型信息。
- 调用name(),取得此类型在当前编译器下的“类型名字符串”。
string::const_reverse_iterator crsit = str3.crbegin();
cout << typeid(crsit).name() << endl;
打印结果:
class std::reverse_iterator<class std::_String_const_iterator<class std::_String_val<struct std::_Simple_types<char> > > >
5.3.2auto的作用(C++11新增)
auto 是一种类型占位符,由编译器在编译期通过“类型推导规则”自动推导出变量的确切类型。crsit的类型名称异常的长。这个时候我们可以使用auto来代替这个类型名:
string::const_reverse_iterator crsit = str3.crbegin();
auto crsit = str3.crbegin();
上面两者等价,编译器会通过crbegin()推导出auto的类型名称。所以这也说明了auto不可以随意使用,最基本的要求是能够让编译器推导出auto是什么。
5.3.3auto的特性
- 早期C/C++中auto的含义是:使用auto修饰的变量,是具有自动存储器的局部变量,后来这个不重要了。C++11中,标准委员会变废为宝赋予了auto全新的含义即:auto不再是一个存储类型指示符,而是作为一个新的类型指示符来指示编译器,auto声明的变量必须由编译器在编译时期推导而得。
- 用auto声明指针类型时,用auto和auto*没有区别,但用auto声明引用类型时则必须加&。
- 当在同一行声明多个变量时,这些变量必须是相同的类型,否则编译器将会报错,因为编译器实际只对第一个类型进行推导,然后用推导出来的类型定义其他变量。
// 编译报错: error C3538: 在声明符号列表中,“auto”必须始终推导为同一类型
auto cc = 3, dd = 4.0;
- auto不能作为函数的参数,可以做返回值。(非常不建议使用)
void func2(auto a){}// 不能做参数
auto func3(){return 3;}// 可以做返回值,但是建议谨慎使用

如上举例,auto在编译上是可以通过的,但是降低了代码可读性,隐藏类型细节,影响代码的维护成本反而得不偿失。(实际上这里是抄了python的写法,但是没抄干净)
- auto不能直接用来声明数组。
// 编译报错: error C3318: “auto []”: 数组不能具有其中包含“auto”的元素类型
auto array[] = { 4, 5, 6 };
5.3.4范围for的使用
范围for是一种基于迭代器的衍生物。范围for在编译后会变成迭代器。如果说迭代器是半自动机,那么范围for就是全自动机。如下我们写一范围for:
string str99("asdfgh");
for(auto ch : str99)
{
cout<<ch<<endl;
}
auto ch : str99,将字符串str99接入范围for,auto自动推导转成str99的字符类型。自动完成遍历并结束。
5.3.5范围for的问题与解决
我们来看看这段代码:我进行了标红解释。

打印一下试试,出问题了:为什么在第二次我们使用范围for修改了字符串本身并打印但是根据第三次打印结果看字符串并没有变化?

原理很简单:这里将范围for编译时转换成迭代器,将*it给到了ch,ch实际上是迭代器的一份拷贝,而不是实际指向string的指针。
解决办法是把auto改成auto&,这样ch就是*it迭代器的别名,也就可以修改字符串了。再打印试试,问题解决。(值得注意的是:如果涉及对象比较大,也尽量把引用给加上)

六,容量相关接口
6.1获取具体容量数据

| size() | 返回当前字符串中有效字符的数量(即实际长度) | size_type(通常是 size_t) | 否(只读) | 获取当前内容长度 |
| length() | 功能与 size() 完全相同,返回字符串的有效长度 | size_type | 否(只读) | 与 size() 等价,历史兼容性保留 |
| max_size() | 返回该容器理论上能容纳的最大元素数量(受系统限制) | size_type | 否(只读) | 判断最大可能容量,避免溢出 |
| capacity() | 返回当前已分配内存空间的大小(可存储元素的总容量) | size_type | 否(只读) | 查看预留空间,了解是否需要扩容 |
不细讲。不过值得注意的是:max_size()在x86和x64环境下结果不同。只有size()和capacity使用较多,另外两个属于冗余接口(string有大量的冗余接口)。
6.2resize()接口

直接作用:将字符串调整为长度为 n 个字符。
测试代码:
cout << "resize测试1前str2.size():" << str2.size() << endl;
str2.resize(2);
cout << "resize测试1后str2.size():" << str2.size() << endl;
cout << "resize测试1:" << " ";
for (auto ch : str2)
{
cout << ch << " ";
}
cout << endl;
cout << "resize测试2前str2.size():" << str2.size() << endl;
str2.resize(6, 'x');
cout << "resize测试2后str2.size():" << str2.size() << endl;
cout << "resize测试2:" << " ";
for (auto ch1 : str2)
{
cout << ch1 << " ";
}
打印结果:

6.3reserve()接口

请求更改容量 请求将字符串的容量调整为可容纳最多 n 个字符的大小。
-
如果 n 大于当前字符串容量,则该函数会使容器将容量增加到 n 个字符(或更多)。(稍微解释一下:不同的平台会有不同的优化。如VS会有对齐操作,开辟超过100个字节空间。)
-
在其他情况下,该请求被视为非强制性请求,用于缩减字符串容量:容器实现可以自由优化,可能会保留比 n 更大的容量。(会不会缩容难说,得看编译器,VS是不缩容的,Linux又是缩容的。这两位工程师在设计的时候有不同的思路。)
这个非强制性请求我想用一张表说清楚:
| n < size | VS和g++都不缩容 |
| size < n < capacity | VS不缩容但是g++缩容 |
| n > capacity | 一定扩容 |
该函数不会影响字符串的长度,也不会修改其内容。
str1.reserve(100);
cout << "测试reserve预留100字节空间: " << str1.capacity() ;
cout << endl;
打印结果:111。(100字节+原有的11和字节)
6.3插曲,讲一讲VS的在这里的优化
reserve扩容这里VS下扩容与我们所想的不一样,它的底层实际上是经过编译器优化的。
我们想string的底层,它的成员变量是这样的:
class string{
priveate:
char* _str;
size_t _capacity;
size_t _size;
}
但是实际上编译器在其中还加上了buffer[]这个数组(这个名字的设计和这个功能有点缓冲区的意思)。这个数组的作用是,当开辟的数据个数在16个以内时(不包括16),将数据存入buffer[]中,否则才会开辟空间并让指针str指向开辟的空间,同时废弃buffer[]。
我们用事实来证明这个结论,这里有一段简短的代码:
int main(){
string str0("abcdefg");
str0.reserve(100);
return 0;
}
在VS编译器上,我们开始调试;首先,调试到达string str0(“abcdefg”)语句时,如下:

介绍一下,STL在监视窗口为了让程序员看起来更加舒服,进行了优化,但同时也有一个[原始视图]选项,以便观察底层原理。
_Bx下表示的是buf数组,_Mysize下表示的是_size,Myres下表示的是_capacity。这里看到buf数组中存放者“abcdef”字符串。

继续调试,运行到reserve语句时,开辟100个空间我们发现,buf数组被废弃了,_Myres数据被扩大,数据被存放在了堆中。因此,证明了前面的观点。
此外我还想讲的是VS的扩容逻辑。以下是一个测试代码:
#include<iostream>
using namespace std;
int main(){
string str0("a");
int n = 999;
int old_capacity = 0;
for (int i = 0; i < n; i++){
str0.push_back('b');
if (old_capacity != str0.capacity()){cout << "capacity: " << str0.capacity() << endl;}
old_capacity=str0.capacity();
}
return 0;}
打印结果如下;
capacity: 15
capacity: 31
capacity: 47
capacity: 70
capacity: 105
capacity: 157
capacity: 235
capacity: 352
capacity: 528
capacity: 792
capacity: 1188
非常显然capacity在15->31的过程中进行了2倍扩容,但是在此之后实行的是1.5倍扩容。
这是因为最初空间并不是在堆上,*2倍开辟是因为内存从buffer到堆的内存迁移需要。后续按照VS的规定来,进行1.5倍开辟。不过Linux下又是另外一套规则,没有buffer也没有1.5倍开辟,而是标准的2倍开辟:

6.4clear()接口

清空字符串:擦除字符串的内容,使其成为一个空字符串(长度为 0 个字符)。
string str4("123456");
str4.clear();
cout << "测试str4.clear(): " << str4.size();
打印结果是0。我们清空了字符串str4的所有内容。
6.5empty()接口

检测字符串是否为空 以布尔形式返回字符串是否为空(即长度是否为 0)。该函数不会以任何方式修改字符串的值。
6.6strink_to_fit()接口

收缩容量以适应大小 请求将字符串的容量缩减到刚好适合其当前大小。该请求是非强制性的,容器实现可以自由优化,也可能保留比字符串实际大小更大的容量。该函数不会影响字符串的长度,也不会修改其内容。
cout << "测试strink_to_fit: ";
string str5("asdfghjkl");
cout << str5.capacity() << " ";
str5.reserve(100);
cout << str5.capacity() << " ";
str5.shrink_to_fit();
cout << str5.capacity() << " ";
打印结果:9,我们为str5字符串保留了100个字节的空间,也就是说我们现在有105个字节的容量属于字符串str5,然后调用strink_to_fit()接口,使得容量缩小到9字节。
七,获取字符相关接口
前面讲过了operator[]这里不再提及
7.1at、back and front


| at(size_t pos) | 访问指定位置的字符(带边界检查) | char& / const char& | 是(有 const 版本) | 是(越界抛出异常) | C++98 |
| back() | 获取字符串最后一个字符 | char& / const char& | 是(有 const 版本) | 是(空字符串会抛异常) | C++11 |
| front() | 获取字符串第一个字符 | char& / const char& | 是(有 const 版本) | 是(空字符串会抛异常) | C++11 |
这个地方值得强调一下:operator[]越界是assert断言错误,at越界是抛异常。
测试代码:
string str6("987654321");
str6.at(5) = 'x';
cout << "测试at,back,front:" << str6 << " ";
str6.back() = 'y';
cout << str6 << " ";
str6.front() = 'z';
cout << str6 << " ";
打印结果:98765×321 98765x32y z8765x32y
好了,本期内容到此结束,我是此方,我们下期再见。バイバイ!





