一、背景介绍
业务场景:
需要从Kafka主题中消费Oracle GoldenGate(OGG)生成的JSON格式变更数据,通过Flink SQL实现统一、可配置的多表同步至目标数据源,避免为每个表独立创建作业。在Flink SQL中可以灵活管理源端与目标端的表映射关系。Kafka中同一主键的记录可保证被分配至同一分区,且源表与目标表的表结构完全一致。
核心需求:
OGG数据样例:
// 增
{
"table": "PRODUCTS",
"op_type": "I",
"op_ts": "2020-05-13 15:40:06.000000",
"current_ts": "2020-05-13 15:40:07.000000",
"pos": "00000000000000000000143",
"before": null,
"after": {
"ID": 111,
"name": "scooter",
"description": "Big 2-wheel scooter",
"weight": 5.18
}
}
//更新
{
"table": "ORCL.ESHOP.CUSTOMER_ORDER",
"op_type": "U",
"op_ts": "2019-05-31 06:22:07.000245",
"current_ts": "2019-05-31 06:22:11.233000",
"pos": "00000000020000004234",
"before": {
"ID": 8,
"CODE": null,
"CREATED": null,
"STATUS": "SHIPPING",
"UPDATE_TIME": null
},
"after": {
"ID": 8,
"CODE": null,
"CREATED": null,
"STATUS": "DELIVERED",
"UPDATE_TIME": null
}
}
//删除
{
"table": "ORCL.ESHOP.CUSTOMER_ORDER_ITEM",
"op_type": "D",
"op_ts": "2019-05-31 06:25:59.000916",
"current_ts": "2019-05-31 06:26:04.910000",
"pos": "00000000020000004432",
"before": {
"ID": 3,
"ID_CUSTOMER_ORDER": 1,
"DESCRIPTION": "Toy Story",
"QUANTITY": 1
},
"after": null
}
二、环境准备
pom依赖:
<dependencies>
<!– utils –>
<dependency>
<groupId>cn.hutool</groupId>
<artifactId>hutool-all</artifactId>
<version>5.8.28</version>
</dependency>
<!– hutool-all –>
<dependency>
<groupId>cn.hutool</groupId>
<artifactId>hutool-all</artifactId>
<version>5.8.9</version>
</dependency>
<!– Log4j-core dependency –>
<dependency>
<groupId>org.apache.logging.log4j</groupId>
<artifactId>log4j-core</artifactId>
<version>2.18.0</version>
</dependency>
<!– Flink Kafka –>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-connector-jdbc</artifactId>
<version>${flink.version}</version>
</dependency>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-json</artifactId>
<version>${flink.version}</version>
</dependency>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-connector-files</artifactId>
<version>${flink.version}</version>
</dependency>
<!– ecache–>
<dependency>
<groupId>org.ehcache</groupId>
<artifactId>ehcache</artifactId>
<version>3.8.1</version> <!– 版本可调整 –>
</dependency>
<!– Flink CDC –>
<!– 注释–>
<dependency>
<groupId>com.ververica</groupId>
<artifactId>flink-sql-connector-mysql-cdc</artifactId>
<version>3.0.0</version>
<exclusions>
<exclusion>
<artifactId>flink-shaded-guava</artifactId>
<groupId>org.apache.flink</groupId>
</exclusion>
</exclusions>
</dependency>
<!– Flink Java–>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-clients</artifactId>
<version>${flink.version}</version>
</dependency>
<dependency>
<groupId>org.springframework</groupId>
<artifactId>spring-web</artifactId>
<version>5.3.24</version>
</dependency>
<!– 注释–>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-table-runtime</artifactId>
<version>1.16.0</version>
<!– <scope>provided</scope>–>
</dependency>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-runtime-web</artifactId>
<version>${flink.version}</version>
<!– <scope>provided</scope>–>
</dependency>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-streaming-java</artifactId>
<version>${flink.version}</version>
</dependency>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-statebackend-rocksdb</artifactId>
<version>1.16.0</version>
</dependency>
<!– 注释–>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-table-planner-loader</artifactId>
<version>1.16.0</version>
<!– <scope>provided</scope>–>
</dependency>
<!– 注释–>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-table-api-java-bridge</artifactId>
<version>${flink.version}</version>
<!– <scope>provided</scope>–>
</dependency>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-connector-base</artifactId>
<version>${flink.version}</version>
</dependency>
<!– Mysql Connector –>
<dependency>
<groupId>mysql</groupId>
<artifactId>mysql-connector-java</artifactId>
<version>8.0.31</version>
</dependency>
<dependency>
<groupId>com.aliyun.dts</groupId>
<artifactId>dts-new-subscribe-sdk</artifactId>
<version>1.4.0</version>
</dependency>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-connector-kafka</artifactId>
<version>1.16.0</version>
</dependency>
<dependency>
<groupId>org.apache.flink</groupId>
<artifactId>flink-sql-connector-kafka</artifactId>
<version>1.16.3</version>
</dependency>
</dependencies>
三、实现方案(代码样例)
Flink sql:
1.映射关系灵活配置:
使用临时试图当做维表,存储映射关系,便于维护和扩展。
2.json解析外置:
将json解析放到sql中,为后期适配其他格式的json,只用修改sql就行。
3.将json的主键数据作为key值分区:
将json的主键数据作为key值分区,使用table.exec.sink.keyed-shuffle=FORCE配置 ,保证同一主键值分配到同一subtask,保证数据有序。(因为上游说保证kafka内数据有序,所以此处用处理时间。)
set table.exec.sink.keyed-shuffle=FORCE;
— 1. 创建临时视图,用于映射表名和主键信息
— 功能:定义源表与目标表的映射关系,以及主键字段的JSON路径
— 字段说明:
— otname: 原始表名 (Oracle表名格式: SCHEMA.TABLE)
— ttname: 目标表名
— pkname: 主键字段名
— bname: 更新前主键值的JSON路径 (对应Oracle的before镜像)
— aname: 更新后主键值的JSON路径 (对应Oracle的after镜像)
CREATE TEMPORARY VIEW table_pk_map (otname,ttname,pkname,bname,aname) AS
SELECT * FROM (
VALUES
('RESLTJT.TRS_CIRCUIT','trs_clrcuit','CIRCUIT_ID', '$.before.CIRCUIT_ID','$.after.CIRCUIT_ID')
) AS t(otname,ttname,pkname,bname,aname);
— 2. 创建Kafka源表
— 功能:从Kafka消费原始JSON格式的OGG(Oracle GoldenGate)变更数据
— 特性说明:
— – 使用raw格式直接读取字符串消息
— – 通过元数据字段获取Kafka分区和偏移量信息
— – 配置Kerberos认证
— – 从指定时间戳开始消费数据
CREATE TABLE kafka_json_table (
message_raw STRING, — 原始JSON消息
kafka_partition INTEGER METADATA FROM 'partition' VIRTUAL, — Kafka分区号
kafka_offset BIGINT METADATA FROM 'offset' VIRTUAL — Kafka消息偏移量
) WITH (
'connector' = 'kafka',
— kafka 配置信息
);
— 3. 创建目标输出表
— 功能:将处理后的数据写入自定义的MySQL连接器
— 说明:
— – 使用自定义的'Ogg_Jdbc'连接器(疑似Flink自定义连接器)
— – 配置批量写入和并发度以提高性能
— – 定义主键但NOT ENFORCED表示不强制约束
CREATE TABLE print_table (
tablename STRING, — 原始表名
ttname STRING, — 目标表名
pkname STRING, — 主键字段名
pk_vlue STRING, — 主键值
message_raw STRING, — 原始JSON消息
kafka_partition INTEGER, — Kafka分区
kafka_offset BIGINT, — Kafka偏移量
PRIMARY KEY (pk_vlue) NOT ENFORCED — 主键定义,用于upsert
) WITH (
'connector' = 'Ogg_Jdbc', — 自定义JDBC连接器名称
'jdbc.type' = 'mysql', — 数据库类型
'jdbc.url' = '*********', — 数据库连接URL
'jdbc.username' = '*********', — 数据库用户名
'jdbc.password' = '*********', — 数据库密码
'jdbc.batchSize'= '100', — 批量写入大小
'jdbc.parallelism'= '3' — 写入并发度
);
— 4. 主数据处理流程
— 功能:处理OGG变更数据并写入目标表
— 处理逻辑:
— 1. 从Kafka过滤特定表的变更数据
— 2. 关联表映射视图获取主键信息
— 3. 提取主键值(优先取before,不存在则取after)
— 4. 将处理结果写入目标表
INSERT INTO print_table
SELECT
JSON_VALUE(t1.message_raw, '$.table') AS otname, — 从JSON中提取表名
t2.ttname as ttname, — 映射后的目标表名
t2.pkname as pkname, — 主键字段名
— 提取主键值:优先使用更新前的值(before),如果不存在则使用更新后的值(after)
IFNULL(JSON_VALUE(t1.message_raw, t2.bname), JSON_VALUE(t1.message_raw, t2.aname)) AS pk_vlue,
t1.message_raw, — 原始消息
t1.kafka_partition, — Kafka分区
t1.kafka_offset — Kafka偏移量
FROM (
— 子查询:从Kafka表过滤出指定表的变更数据
SELECT message_raw, kafka_partition, kafka_offset
FROM kafka_json_table
WHERE JSON_VALUE(message_raw, '$.table') in ('RESLTJT.TRS_CIRCUIT')
) t1
— 关联表映射视图,获取主键信息
INNER JOIN table_pk_map t2
ON JSON_VALUE(t1.message_raw, '$.table') = t2.otname
— 整体流程总结:消费OGG变更数据 → 解析JSON → 关联表映射 → 提取主键 → 批量写入MySQL
Flink 动态表的 sink:
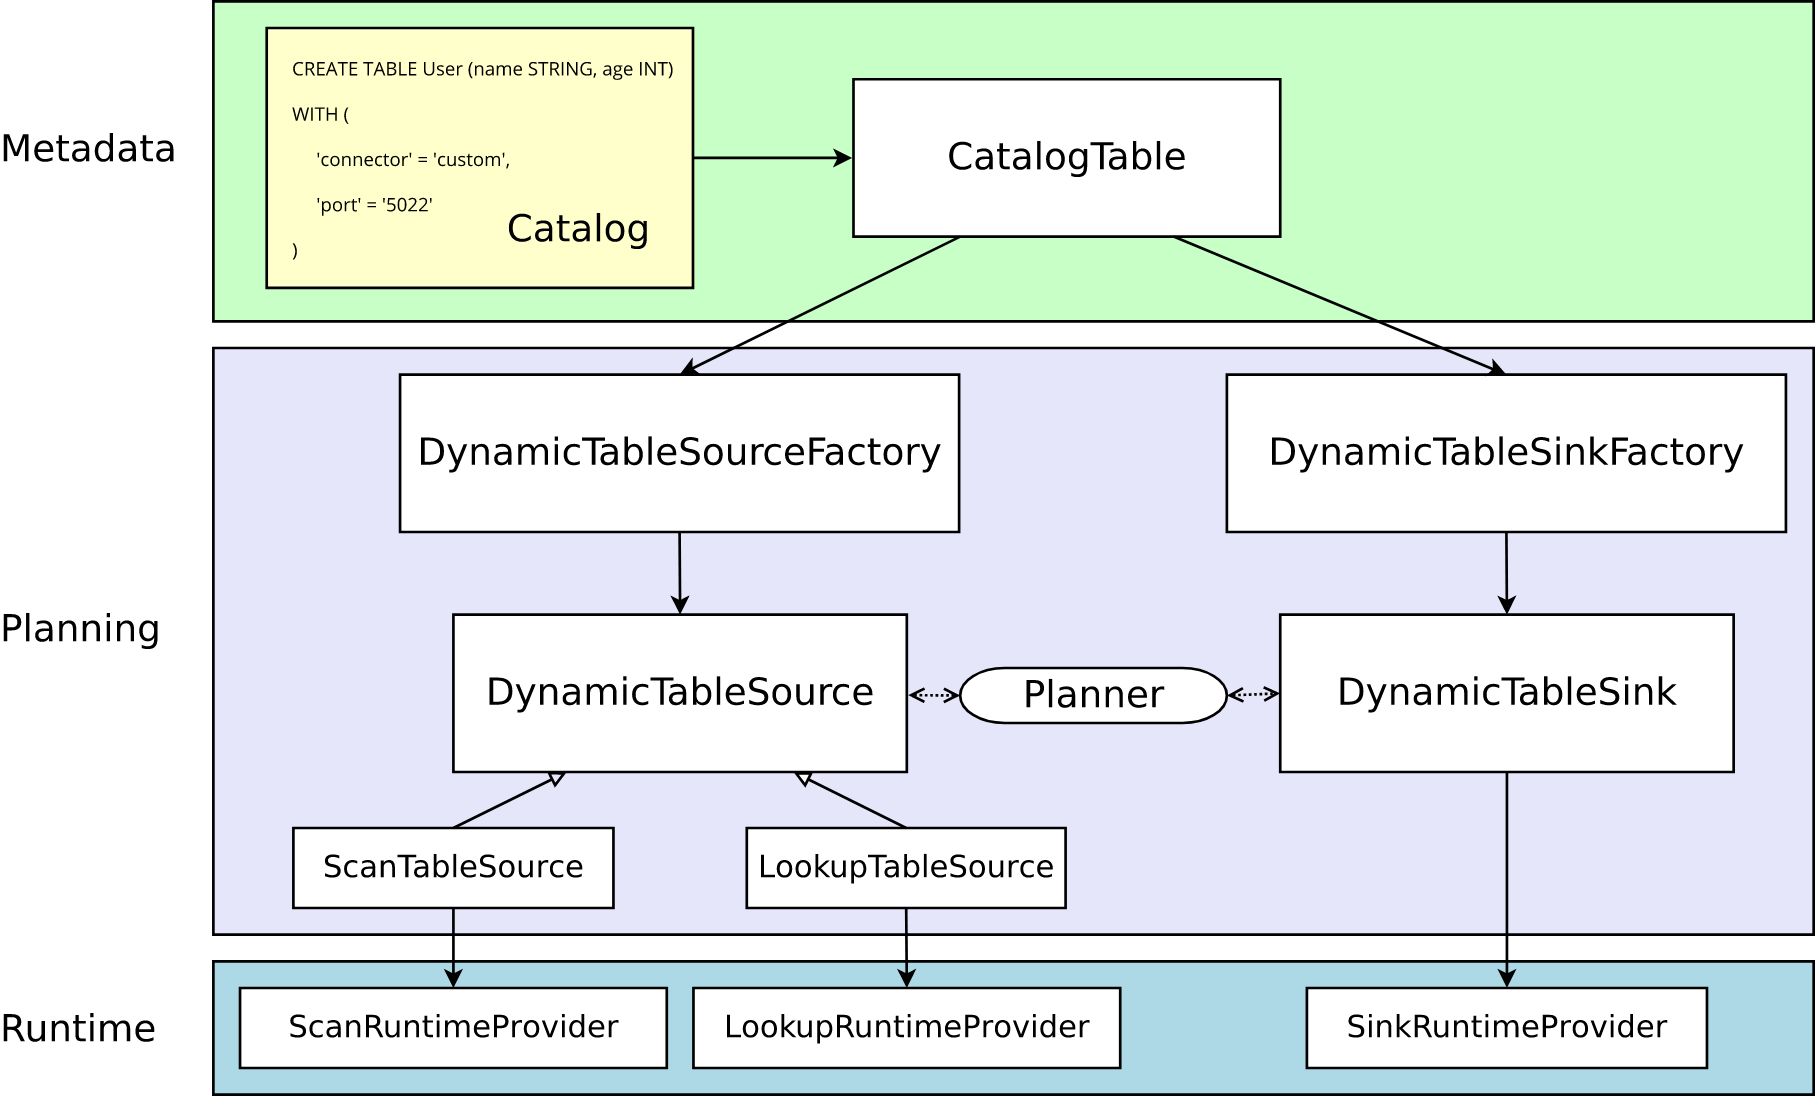
-
元数据转换:DynamicTableSinkFactory将 CatalogTable的元数据转换为 DynamicTableSink实例,负责参数验证和格式配置
-
工厂发现:通过 Java SPI 机制自动发现,连接器参数(如 'connector'='custom')需与工厂标识匹配
-
运行时生成:DynamicTableSink作为有状态工厂,最终生成具体的运行时实现
-
能力扩展:通过能力接口(如 SupportsOverwrite)支持覆盖写入等特性
DynamicTableSinkFactory
-
参数解析与验证:当你用 DDL 语句定义一张目标表时,Factory 会检查你提供的参数(如 'jdbc.type' = 'mysql')是否正确、完整。它会明确哪些参数是必须的(如 Kafka 的服务器地址),哪些是可选的(如批量写入的大小)。
-
创建连接器实例:在验证参数无误后,Factory 会生产一个 DynamicTableSink实例。这个实例可以看作是这张目标表的“蓝图”,它包含了所有必要的配置信息,但还不负责真正的写入动作。
-
服务发现:通过 Java 的 SPI 机制,Flink 能够自动识别并加载你自定义的 Factory。你只需要在 connector参数里写上工厂的“名字”(如 'connector' = 'Ogg_Jdbc'),Flink 就能找到它并调用其功能。
import org.apache.flink.configuration.ConfigOption;
import org.apache.flink.configuration.ReadableConfig;
import org.apache.flink.table.connector.sink.DynamicTableSink;
import org.apache.flink.table.factories.DynamicTableSinkFactory;
import org.apache.flink.table.factories.FactoryUtil;
import java.util.HashSet;
import java.util.Set;
import static org.apache.flink.configuration.ConfigOptions.key;
/**
* Ogg_Jdbc
*/
public class OggToSinkFactory implements DynamicTableSinkFactory {
public static final ConfigOption<String> jdbc_type = key("jdbc.type")
.stringType()
.noDefaultValue()
.withDescription("JDBC TYPE : mysql、oracle、pgsql");
public static final ConfigOption<String> jdbc_url = key("jdbc.url")
.stringType()
.noDefaultValue()
.withDescription("JDBC url");
public static final ConfigOption<String> jdbc_username = key("jdbc.username")
.stringType()
.noDefaultValue()
.withDescription("JDBC username");
public static final ConfigOption<String> jdbc_password = key("jdbc.password")
.stringType()
.noDefaultValue()
.withDescription("JDBC username");
public static final ConfigOption<Integer> jdbc_batchSize = key("jdbc.batchSize")
.intType()
.defaultValue(1000)
.withDescription("JDBC batchSize");
public static final ConfigOption<Integer> jdbc_parallelism = key("jdbc.parallelism")
.intType()
.defaultValue(1)
.withDescription("JDBC parallelism");
//连接器的唯一标识
@Override
public String factoryIdentifier() {
return "Ogg_Jdbc";
}
//必填参数
@Override
public Set<ConfigOption<?>> requiredOptions() {
Set<ConfigOption<?>> options = new HashSet<>();
options.add(jdbc_type);
options.add(jdbc_url);
options.add(jdbc_username);
options.add(jdbc_password);
return options;
}
//选填参数
@Override
public Set<ConfigOption<?>> optionalOptions() {
Set<ConfigOption<?>> options = new HashSet<>();
options.add(jdbc_batchSize);
options.add(jdbc_parallelism);
return options;
}
@Override
public DynamicTableSink createDynamicTableSink(Context context) {
FactoryUtil.TableFactoryHelper helper = FactoryUtil.createTableFactoryHelper(this, context);
helper.validate();
//获取配置的参数
ReadableConfig options = helper.getOptions();
String jdbctype = options.get(jdbc_type);
String jdbcurl = options.get(jdbc_url);
String jdbcusername = options.get(jdbc_username);
String jdbcpassword = options.get(jdbc_password);
int jdbcbatchSize = options.get(jdbc_batchSize);
int jdbcparallelism = options.get(jdbc_parallelism);
return new OggToSink(jdbctype, jdbcurl, jdbcusername, jdbcpassword, jdbcbatchSize, jdbcparallelism);
}
}
DynamicTableSink
import org.apache.flink.table.connector.ChangelogMode;
import org.apache.flink.table.connector.sink.DynamicTableSink;
import org.apache.flink.table.connector.sink.SinkFunctionProvider;
public class OggToSink implements DynamicTableSink {
private final String jdbctype;
private final String jdbcurl;
private final String jdbcusername;
private final String jdbcpassword;
private final int jdbcbatchSize;
private final int jdbcparallelism;
public OggToSink(String jdbctype, String jdbcurl, String jdbcusername, String jdbcpassword, int jdbcbatchSize, int jdbcparallelism) {
this.jdbctype = jdbctype;
this.jdbcurl = jdbcurl;
this.jdbcusername = jdbcusername;
this.jdbcpassword = jdbcpassword;
this.jdbcbatchSize = jdbcbatchSize;
this.jdbcparallelism = jdbcparallelism;
}
@Override
public ChangelogMode getChangelogMode(ChangelogMode requestedMode) {
return ChangelogMode.all();
}
@Override
public SinkRuntimeProvider getSinkRuntimeProvider(Context context) {
return SinkFunctionProvider.of(new OggToSinkFunction(jdbctype, jdbcurl, jdbcusername, jdbcpassword, jdbcbatchSize), jdbcparallelism);
}
@Override
public DynamicTableSink copy() {
return new OggToSink(jdbctype, jdbcurl, jdbcusername, jdbcpassword, jdbcbatchSize, jdbcparallelism);
}
@Override
public String asSummaryString() {
return "ogg_jdbc_sink";
}
}
SinkFunction
1.为避免“尾延迟”场景:当数据量达不到设定的批量阈值时,剩余数据会一直积压在内存中。使用CheckpointedFunction 在检查点时将缓存中的数据输出。
2.为减小数据库压力,同一表的同一sink,每次输出只做最后一执行最后一个sql。
import cn.hutool.json.JSONObject;
import cn.hutool.json.JSONUtil;
import org.apache.flink.api.common.state.ListState;
import org.apache.flink.api.common.state.ListStateDescriptor;
import org.apache.flink.configuration.Configuration;
import org.apache.flink.runtime.state.FunctionInitializationContext;
import org.apache.flink.runtime.state.FunctionSnapshotContext;
import org.apache.flink.streaming.api.checkpoint.CheckpointedFunction;
import org.apache.flink.streaming.api.functions.sink.RichSinkFunction;
import org.apache.flink.table.data.RowData;
import org.apache.flink.table.data.StringData;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.SQLException;
import java.sql.Statement;
import java.util.ArrayList;
import java.util.HashMap;
import java.util.Map;
import java.util.Set;
public class OggToSinkFunction extends RichSinkFunction<RowData> implements CheckpointedFunction {
private final Object lock = new Object();
private final String jdbctype;
private final String jdbcurl;
private final String jdbcusername;
private final String jdbcpassword;
private final int jdbcbatchSize;
private ArrayList<String> sqlElements;
private transient ListState<String> checkpointedState;
private Connection connection;
private Statement statement;
public OggToSinkFunction(String jdbctype, String jdbcurl, String jdbcusername, String jdbcpassword, int jdbcbatchSize) {
this.jdbctype = jdbctype;
this.jdbcurl = jdbcurl;
this.jdbcusername = jdbcusername;
this.jdbcpassword = jdbcpassword;
this.jdbcbatchSize = jdbcbatchSize;
if (null == sqlElements) {
sqlElements = new ArrayList<>();
}
}
public static String toSql(String jsonString, String ttname, String pk) {
// 把json 转换为 对应的sql
}
@Override
public void close() throws Exception {
synchronized (lock) {
flash("close");
}
super.close();
}
@Override
public void invoke(RowData value, Context context) throws Exception {
StringData tabelname = value.getString(0);
StringData ttname = value.getString(1);
StringData pkname = value.getString(2);
StringData pk_vlue = value.getString(3);
StringData message_raw = value.getString(4);
int partation = value.getInt(5);
long offset = value.getLong(6);
// 输出测试
// System.out.println(value.getRowKind() + " " + tabelname + " " + pk_vlue + " " + partation + " " + offset + " " + message_raw);
String sql = toSql(message_raw.toString(), ttname.toString(), pkname.toString());
synchronized (lock) {
if (null == sqlElements) {
sqlElements = new ArrayList<>();
}
sqlElements.add(partation + "." + offset + "###" + tabelname + "_" + pk_vlue + "###" + sql);
if (sqlElements.size() >= jdbcbatchSize) {
flash("invark");
}
}
}
private void flash(String s) throws SQLException, InterruptedException, ClassNotFoundException {
HashMap<String, String> map = new HashMap<>();
if (sqlElements == null || sqlElements.isEmpty()) {
return;
}
// 筛选最后一次操作
for (String sqlElement : sqlElements) {
String[] split = sqlElement.split("###");
map.put(split[1], split[2]);
}
Set<Map.Entry<String, String>> entries = map.entrySet();
checkConnect();
for (Map.Entry<String, String> entry : entries) {
String sql = entry.getValue();
statement.addBatch(sql);
}
int[] ints = statement.executeBatch();
connection.commit();
sqlElements.clear();
closeConnect();
}
@Override
public void finish() throws Exception {
synchronized (lock) {
flash("finish");
}
super.finish();
}
@Override
public void snapshotState(FunctionSnapshotContext context) throws Exception {
synchronized (lock) {
System.out.println("checkpoint 开始");
if (checkpointedState != null && sqlElements != null) {
checkpointedState.clear();
for (String element : sqlElements) {
checkpointedState.add(element);
}
flash("ck strat");
}
}
}
@Override
public void initializeState(FunctionInitializationContext context) throws Exception {
ListStateDescriptor<String> dataBufferList = new ListStateDescriptor<>("dataBufferList", String.class);
checkpointedState = context.getOperatorStateStore().getListState(dataBufferList);
synchronized (lock) {
// 确保sqlElements被初始化
if (sqlElements == null) {
sqlElements = new ArrayList<>();
}
// 从检查点恢复状态 – 修复空指针问题
if (context.isRestored()) {
try {
sqlElements.clear();
Iterable<String> elements = checkpointedState.get();
if (elements != null) {
for (String element : elements) {
if (element != null) {
sqlElements.add(element);
}
}
}
// 恢复后立即刷写数据
if (!sqlElements.isEmpty()) {
flash("ck init:");
}
} catch (Exception e) {
System.err.println("Error during state initialization: " + e.getMessage());
// 清空状态重新开始
sqlElements.clear();
}
}
}
}
}