只更新了 2500 个用户,却扫描了 5600 万行数据?这不是 Bug,这是"用大炮打蚊子"。
一、问题现象
早上打开调度平台,一片红——好几个任务齐刷刷报错,场面堪比双十一零点的服务器监控面板。
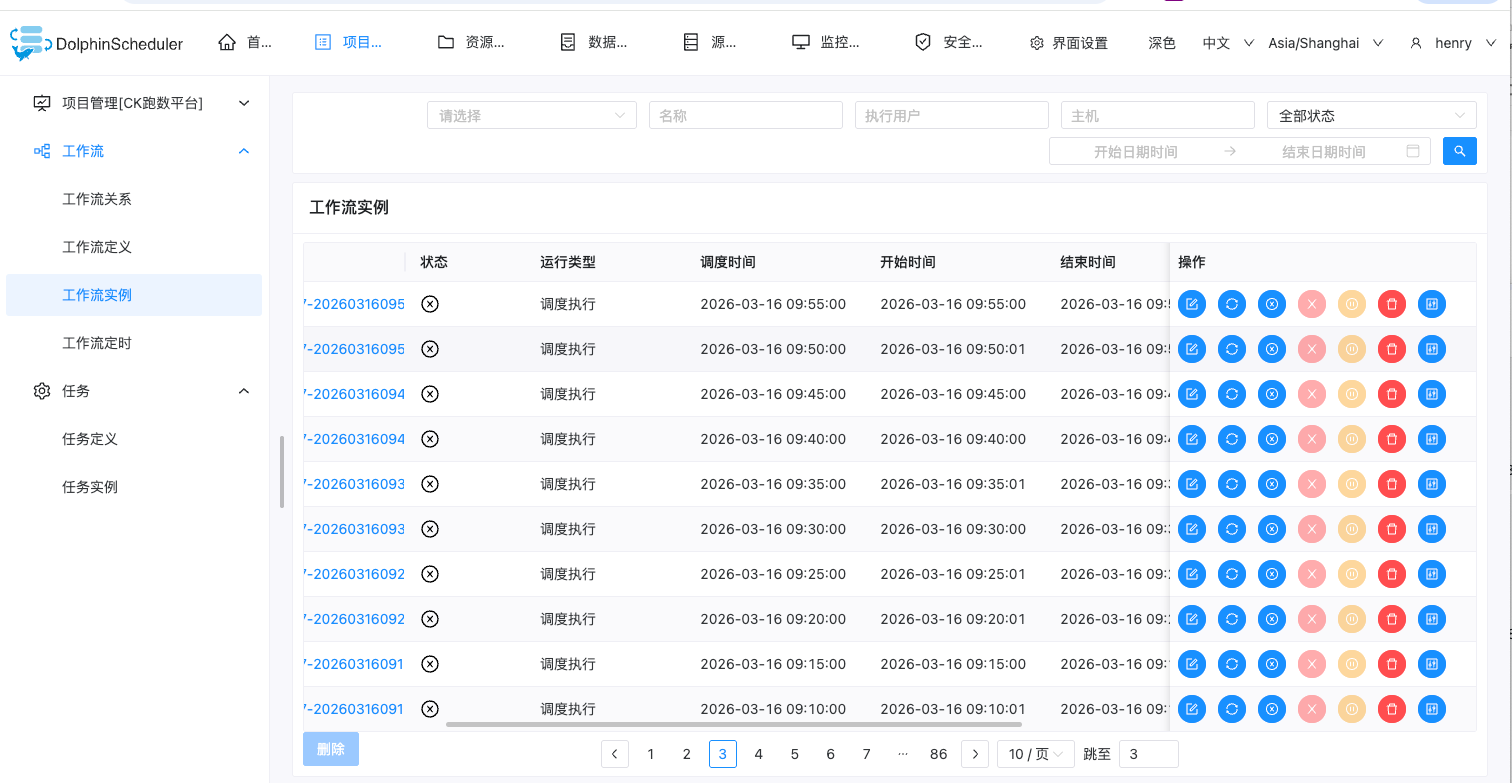
点开其中一个任务的报错节点日志,关键信息如下:
Code: 241. DB::Exception: (total) memory limit exceeded:
would use 27.59 GiB (attempt to allocate chunk of 4.05 MiB bytes),
current RSS: 9.06 GiB, maximum: 27.58 GiB.
就差 0.01 GiB,好家伙,差一口气没喘上来。
机器配置是 4C 32G,ClickHouse 内存上限设的 ~27.58 GiB,查询试图用 27.59 GiB —— 完美地"踩线翻车"。
而且这个任务有个诡异的特点:重启 ClickHouse 后,同样的 SQL 又能跑成功了。这到底是内存泄漏,还是查询本身的问题?
二、排查现场
1. 定位报错 SQL
从调度日志中提取出实际执行的 SQL(省略了 SELECT 字段列表):
INSERT INTO dim.dim_user_profile (...)
SELECT ...
FROM dw.dw_user_info AS ui
JOIN tmp.tmp_changed_users_202603160940 AS t1
ON ui.user_id = t1.user_id
LEFT JOIN dw.dw_user_ext_info AS uei
ON ui.user_id = uei.user_id
LEFT JOIN dw.dw_device_info AS di
ON ui.user_id = di.binduser_id
LEFT JOIN (
SELECT user_id,
toDateTime(argMax(start_time, tuple(update_time, id)), 'Asia/Shanghai') AS start_time,
toDateTime(argMax(end_time, tuple(update_time, id)), 'Asia/Shanghai') AS end_time
FROM dw.dw_user_membership
WHERE type = 1
GROUP BY user_id
) AS um_club ON ui.user_id = um_club.user_id
LEFT JOIN (
SELECT user_id,
toDateTime(argMax(start_time, tuple(update_time, id)), 'Asia/Shanghai') AS start_time,
toDateTime(argMax(end_time, tuple(update_time, id)), 'Asia/Shanghai') AS end_time
FROM dw.dw_user_membership
WHERE type IN (2,3,4,5,6,9)
GROUP BY user_id
) AS um_vip ON ui.user_id = um_vip.user_id
LEFT JOIN (
SELECT user_id,
toUInt8(if(argMax(active_type, tuple(start_time, update_time, id)) IN (1, 20), 0, 1))
AS is_current_vip_gift
FROM dw.dw_user_membership
WHERE type IN (2,3,4,5,6,9)
AND status = 1
AND now() BETWEEN start_time AND end_time
GROUP BY user_id
) AS um_vip_gift ON ui.user_id = um_vip_gift.user_id
LEFT JOIN (
SELECT user_id,
...
FROM dw.dw_user_key_node
GROUP BY user_id
) AS ukn ON ui.user_id = ukn.user_id
WHERE ui.user_category = 1
2. 理解业务背景
这条 SQL 属于一个用户维表增量更新工作流,分两步:
3. 用 EXPLAIN 分析执行计划
先看预估读取量(EXPLAIN ESTIMATE):
| dw | dw_user_key_node | 10 | 7,142,208 | 900 |
| dw | dw_user_info | 158 | 10,582,402 | 41,429 |
| dw | dw_device_info | 242 | 12,540,591 | 1,727 |
| dw | dw_user_ext_info | 234 | 10,611,232 | 41,603 |
| dw | dw_user_membership | 328 | 15,512,398 | 2,119 |
| tmp | tmp_changed_users_… | 1 | 2,501 | 1 |
看到了吗?临时表只有 2,501 行,但其他表全是千万级别。这就是问题的味道。
再看执行管道(EXPLAIN PIPELINE,太长了只摘关键部分):
(Join)
JoiningTransform × 4 2 → 1
…
FillingRightJoinSide ← 关键!RIGHT 侧被全量加载到内存
…
MergeTreeSelect(pool: ReadPool, algorithm: Thread) × 4
每个 FillingRightJoinSide 都意味着:RIGHT 侧表被完整读入内存,构建 Hash Table。千万级的表直接往内存里塞,不炸才怪。
4. 查看历史执行的真实内存消耗
EXPLAIN 只能看读取量,无法直接得知内存峰值。真正能看内存的是 system.query_log 中的 memory_usage 字段:
memory_usage 记录的是该查询在整个生命周期中占用内存的峰值(即最高水位线),不是结束时的内存,也不是平均值。它直接反映了查询最"吃内存"的那一刻用了多少,是判断查询是否会 OOM 的核心指标。
SELECT
query_id,
formatReadableSize(memory_usage) AS peak_memory,
read_rows,
formatReadableSize(read_bytes) AS read_size,
query_duration_ms / 1000 AS duration_sec
FROM system.query_log
WHERE type IN ('QueryFinish', 'ExceptionWhileProcessing')
AND query LIKE '%INSERT INTO dim.dim_user_profile%'
AND query NOT LIKE '%QueryFinish%'
ORDER BY event_time DESC
LIMIT 5;
结果:
| 8.62 GiB | 56,420,263 | 9.58 GiB | 5.9s |
| 8.73 GiB | 56,422,096 | 9.58 GiB | 8.9s |
| 8.63 GiB | 56,419,588 | 9.58 GiB | 5.9s |
| 8.62 GiB | 56,419,445 | 9.58 GiB | 5.9s |
| 8.64 GiB | 56,416,707 | 9.58 GiB | 10.9s |
稳定在 ~8.6 GiB 峰值内存,读取 5600 万行。
三、原因分析
1. 为什么更新 2500 人却要扫 5600 万行?
虽然主表通过 JOIN tmp_changed_users 缩小到了 2500 行,但 LEFT JOIN 的 RIGHT 侧表完全没有过滤:
- dw_user_ext_info:1061 万行,全量加载到 Hash Table
- dw_device_info:1254 万行,全量加载到 Hash Table
- dw_user_membership:1551 万行,扫了 3 次(um_club、um_vip、um_vip_gift)
- dw_user_key_node:714 万行,全表 GROUP BY
用一句话总结:为了找 2500 个人的信息,把整个城市的户籍档案从头翻到尾,翻了好几遍。
2. 为什么重启 ClickHouse 后又能跑?
这不是内存泄漏,而是安全余量不够。
查询本身需要 ~8.6 GiB,ClickHouse 总内存上限 27.58 GiB。刚启动时缓存几乎为空,剩余内存充足,查询能跑过去。但运行一段时间后,mark cache、uncompressed cache、后台 merge 任务等逐渐占用内存,剩余空间不够 8.6 GiB 时就会 OOM。
本质是查询太胖了,不是 ClickHouse 有毛病。
四、优化方案
1. 第一轮:子查询加 IN 过滤(效果有限)
最直觉的想法:在子查询里加 WHERE user_id IN (SELECT user_id FROM tmp_changed_users),让聚合只处理变更用户的数据。
LEFT JOIN (
SELECT user_id, ...
FROM dw.dw_user_membership
WHERE type = 1
AND user_id IN (SELECT user_id FROM tmp.tmp_changed_users_...) — 新增
GROUP BY user_id
) AS um_club ON ui.user_id = um_club.user_id
— um_vip、um_vip_gift、ukn 同理
跑完看 query_log:
| 7.91 GiB | 50,399,268 | 9.17 GiB | 优化后 |
| 8.62 GiB | 56,420,263 | 9.58 GiB | 优化前 |
从 8.6 GiB → 7.9 GiB,少了一点点,聊胜于无。
为什么效果不明显? IN 过滤对子查询(um_club、um_vip 等)确实生效了,但真正的内存大户是 直接 LEFT JOIN 的大表(dw_user_ext_info、dw_device_info),它们没有任何过滤条件,通过 FillingRightJoinSide 被全量加载到 Hash Table。只优化了"几个配菜",主菜纹丝未动。
2. 第二轮:全面优化(釜底抽薪)
两个核心改动:
改动 A:所有 RIGHT 侧 JOIN 都包子查询 + IN 过滤
不只是聚合子查询,直接表 JOIN 也要包一层:
— 优化前:全表 1061 万行加载到 Hash Table
LEFT JOIN dw.dw_user_ext_info AS uei
ON ui.user_id = uei.user_id
— 优化后:只加载 2500 行到 Hash Table
LEFT JOIN (
SELECT * FROM dw.dw_user_ext_info
WHERE user_id IN (SELECT user_id FROM tmp.tmp_changed_users_...)
) AS uei
ON ui.user_id = uei.user_id
dw_device_info 同理。
改动 B:合并 3 次 dw_user_membership 扫描为 1 次
用 argMaxIf / countIf 条件聚合,一次扫描提取所有需要的信息:
LEFT JOIN (
SELECT
user_id,
— Club 会员
toDateTime(argMaxIf(start_time, tuple(update_time, id), type = 1), 'Asia/Shanghai')
AS club_start_time,
toDateTime(argMaxIf(end_time, tuple(update_time, id), type = 1), 'Asia/Shanghai')
AS club_end_time,
— VIP 会员
toDateTime(argMaxIf(start_time, tuple(update_time, id), type IN (2,3,4,5,6,9)), 'Asia/Shanghai')
AS vip_start_time,
toDateTime(argMaxIf(end_time, tuple(update_time, id), type IN (2,3,4,5,6,9)), 'Asia/Shanghai')
AS vip_end_time,
— 当前 VIP 是否为赠送
if(
countIf(type IN (2,3,4,5,6,9) AND status = 1 AND now() BETWEEN start_time AND end_time) > 0,
toUInt8(if(argMaxIf(active_type, tuple(start_time, update_time, id),
type IN (2,3,4,5,6,9) AND status = 1 AND now() BETWEEN start_time AND end_time
) IN (1, 20), 0, 1)),
NULL
) AS is_current_vip_gift
FROM dw.dw_user_membership
WHERE user_id IN (SELECT user_id FROM tmp.tmp_changed_users_...)
GROUP BY user_id
) AS um ON ui.user_id = um.user_id
一次扫描,三个结果,优雅。
改动部署后,先看预估读取量的变化:
| dw | dw_user_key_node | 10 | 7,103,210 | 893 |
| dw | dw_user_info | 151 | 10,588,133 | 41,444 |
| dw | dw_user_membership | 56 | 1,756,307 | 246 |
| dw | dw_device_info | 136 | 4,384,704 | 653 |
| dw | dw_user_ext_info | 172 | 1,885,591 | 7,457 |
| tmp | tmp_changed_users_… | 2 | 4,874 | 2 |
对比优化前:dw_user_membership 从 1551 万 → 175 万(合并 3 次为 1 次 + IN 过滤),dw_user_ext_info 从 1061 万 → 188 万,dw_device_info 从 1254 万 → 438 万。预估读取量大幅下降。
再看实际执行的 query_log(最近 2 条为第二轮优化后,后 3 条为第一轮优化):
| 115.09 MiB | 44,168,129 | 5.05 GiB | 1.7s | 第二轮优化 |
| 134.17 MiB | 44,947,167 | 5.10 GiB | 1.7s | 第二轮优化 |
| 7.89 GiB | 49,971,974 | 9.15 GiB | 4.3s | 第一轮优化 |
| 7.91 GiB | 49,972,165 | 9.15 GiB | 7.1s | 第一轮优化 |
| 7.88 GiB | 49,971,372 | 9.15 GiB | 4.4s | 第一轮优化 |
从 7.9 GiB 直接干到 115 MiB,降了 98.6%。这才叫优化,前面那轮只能叫"意思意思"。
你可能注意到 read_rows 还有 4400 万,为什么内存却降了这么多?因为 read_rows 统计的是所有表扫描过的行数(dw_user_info 本身就有 1000 万行作为主表必须扫),但内存峰值取决于 Hash Table 的大小——RIGHT 侧从千万行压到几千行,Hash Table 自然从 GiB 级降到了 MiB 级。扫描多不可怕,往内存里塞多才可怕。
3. 优化效果对比
| peak_memory | ~8.6 GiB | ~7.9 GiB | ~115 MiB |
| read_size | 9.58 GiB | 9.15 GiB | 5.05 GiB |
| duration | ~6s | ~4s | ~1.7s |
4. 优化原理总结
| dw_user_ext_info 加 IN 过滤 | 1061 万行 → ~2500 行 |
| dw_device_info 加 IN 过滤 | 1254 万行 → ~2500 行 |
| 3 次 dw_user_membership 扫描合并为 1 次 | 1551万 × 3 = 4653 万行 → 1 次且仅变更用户 |
| dw_user_key_node 加 IN 过滤 | 714 万行 → 仅变更用户 |
五、补充:ClickHouse 内存排查工具箱
遇到 ClickHouse 内存问题时,这几个工具最常用:
1. 查看历史查询内存峰值
SELECT
query_id,
formatReadableSize(memory_usage) AS peak_memory,
read_rows,
formatReadableSize(read_bytes) AS read_size,
query_duration_ms / 1000 AS duration_sec
FROM system.query_log
WHERE type IN ('QueryFinish', 'ExceptionWhileProcessing')
AND query LIKE '%你的关键词%'
ORDER BY event_time DESC
LIMIT 10;
2. 实时监控正在跑的查询
SELECT
query_id,
formatReadableSize(memory_usage) AS current_memory,
formatReadableSize(peak_memory_usage) AS peak_memory,
elapsed
FROM system.processes
WHERE query LIKE '%你的关键词%';
3. 预估查询读取量
EXPLAIN ESTIMATE SELECT ...;
— 返回各表的 parts、rows、marks,帮助判断查询"贵不贵"
4. 应急:手动释放缓存(治标不治本)
SYSTEM DROP MARK CACHE;
SYSTEM DROP UNCOMPRESSED CACHE;
SYSTEM DROP COMPILED EXPRESSION CACHE;
⚠️ 这只是给 ClickHouse “续一口气”,根本解决方案还是优化查询本身。
六、总结
| 发现问题 | 查调度日志,定位报错 SQL | Code: 241 = 内存超限 |
| 分析原因 | EXPLAIN + query_log | FillingRightJoinSide = RIGHT 侧全量入内存 |
| 第一轮优化 | 子查询加 IN 过滤 | 只改子查询不够,直接 JOIN 的大表才是大头 |
| 第二轮优化 | 全部 RIGHT 侧加过滤 + 合并重复扫描 | 8.6 GiB → 115 MiB,降了 98.6% |
核心教训:
七、留个思考题
本文的优化是针对增量场景——有临时表做 IN 过滤,把右表数据量从千万级压到几千行。
但如果换成全量初始化呢?没有临时表,千万用户全量 JOIN 千万级的扩展表、设备表、会员表……内存照样会爆。这时候你会怎么优化?
欢迎评论区聊聊你的思路。
如果这篇文章帮你省下了一次"重启 ClickHouse"的操作,点赞收藏走一波 👍 下次 OOM 的时候少走弯路。