当AI推理迈入实时化、PB级数据访问的新阶段,存储IO正从“幕后支撑”变成“性能命脉”。NVIDIA最新提出的SCADA(Scaled Accelerated Data Access)方案,以GPU完全接管存储IO的控制路径与数据路径,在小数据块传输场景下实现对GPUDirect的超越,为下一代AI推理 workloads 打开了低延迟、高IOPS的全新可能。这不仅是存储架构的一次技术革命,更预示着“GPU主导、CPU辅助”的计算存储协同新时代已然到来。
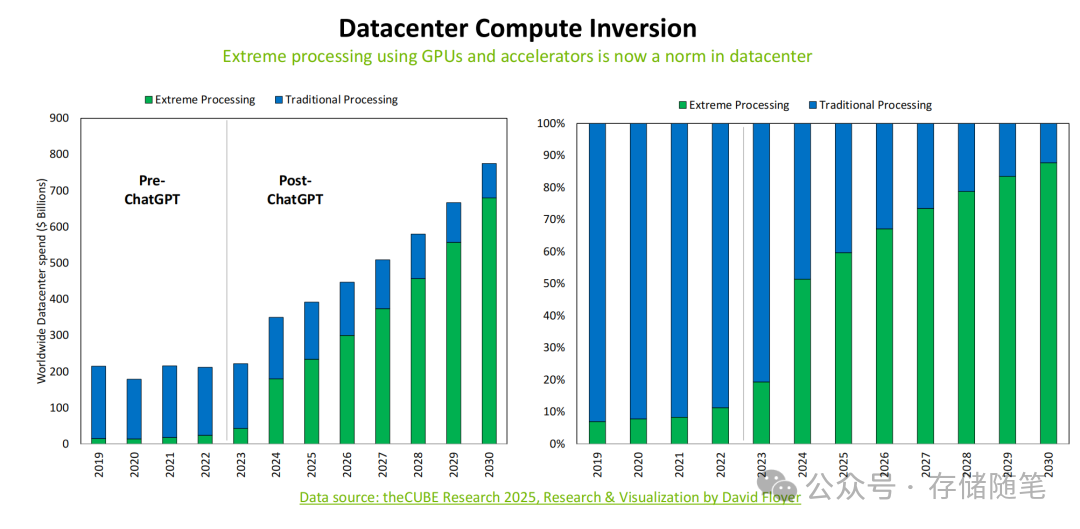
一、AI推理的存储IO之痛:被忽视的小数据块瓶颈
在AI算力竞赛中,我们往往聚焦于GPU的浮点运算能力,但对于AI推理而言,存储IO的效率才是决定实时性的关键——尤其是小数据块传输场景下的延迟与并发处理能力。
1. 推理与训练的IO需求天差地别
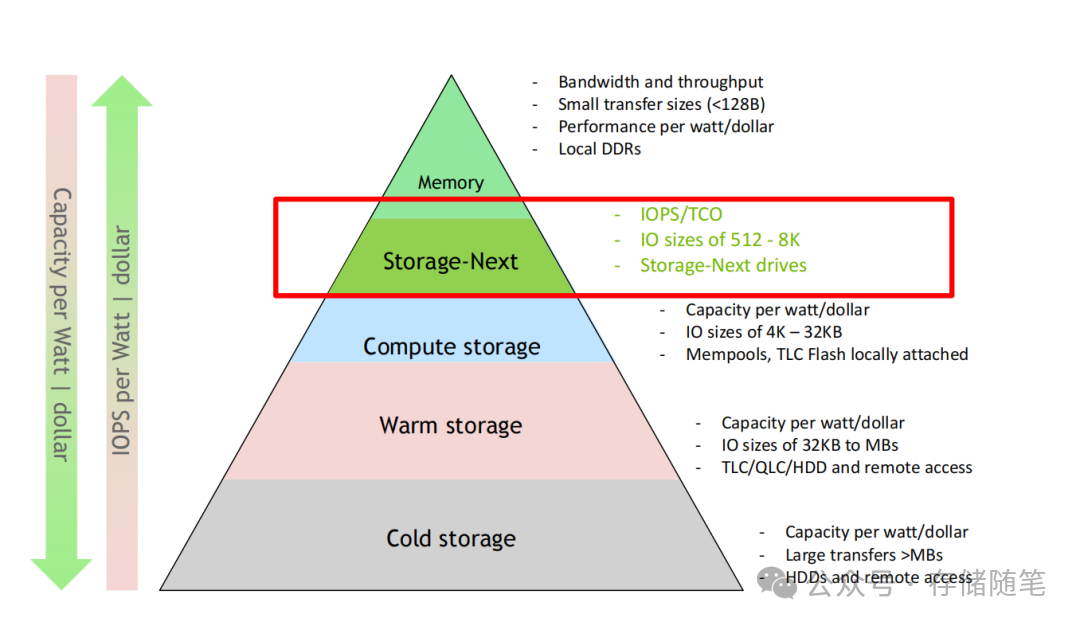
AI训练依赖海量数据的批量传输,单轮数据块尺寸通常在MB级以上,控制路径的延迟占比极低;而AI推理完全不同,LLM推理的KV缓存访问粒度仅8KB-4MB,向量数据库检索、推荐系统的特征读取更是低至64B-8KB,且需要支持数千条并行线程的并发请求。LLM推理的存储需求已突破10TB级,向量数据库和推荐系统的存储规模更是达到1TB-1PB,这种“小块高频”的访问模式,让传统存储架构不堪重负。
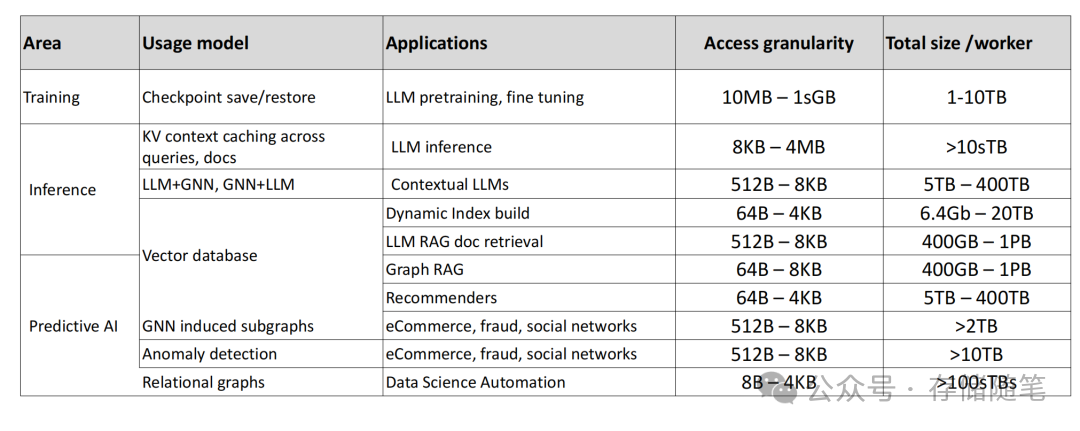
在 AI 算力竞赛中,GPU 性能持续飙升,但存储 IO 却成为推理场景的隐形枷锁。核心矛盾在于训练与推理的存储需求本质差异:
-
AI 训练:大数据块传输(GB 级),并行线程仅数十个,控制路径延迟占比低(<5%)
-
AI 推理:小数据块操作(<4KB),并行线程超 1000 个,控制路径延迟占比高达 30%+
2. CPU主导架构的致命短板
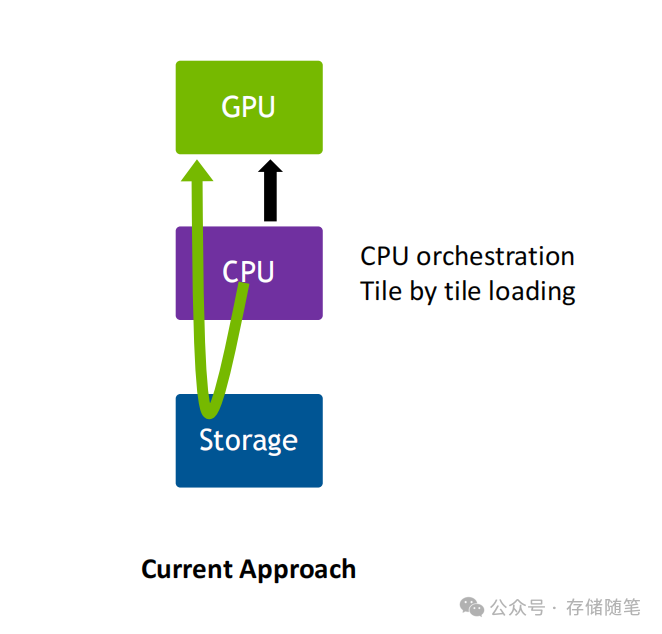
传统架构中,CPU同时掌控存储IO的控制路径(发起请求、调度资源)和数据路径(传输数据),GPU仅作为“辅助加速器”被动接收数据。
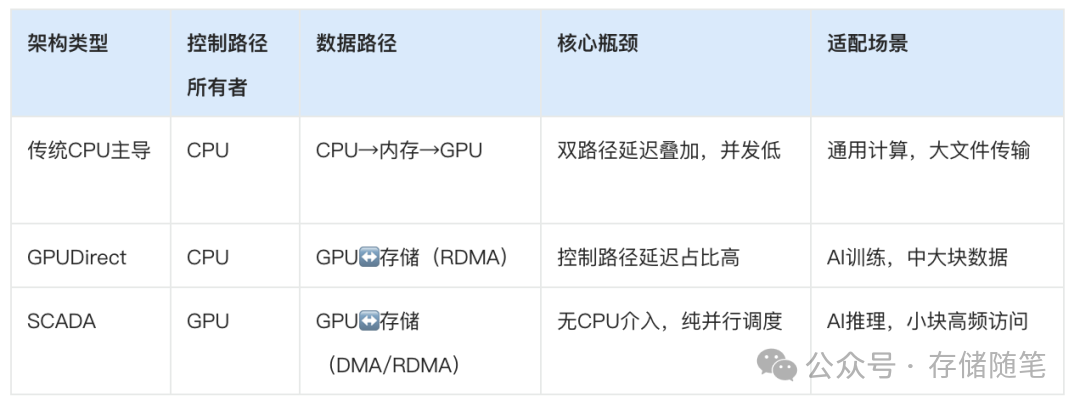
即便GPUDirect技术实现了GPU与存储的数据路径直连,但控制路径仍由CPU主导——这对于小数据块传输而言,控制延迟占比极高,导致PCIe总线利用率不足,GPU长期处于“数据饥饿”状态:GPU 需通过 CPU 发起存储请求、等待响应、调度传输,这个过程在高频小数据块场景下累积成致命延迟。Nvidia 研究显示,推理场景中 GPU 因等待数据导致的算力浪费超 40%,而 SCADA 技术正是为解决这一痛点而生。
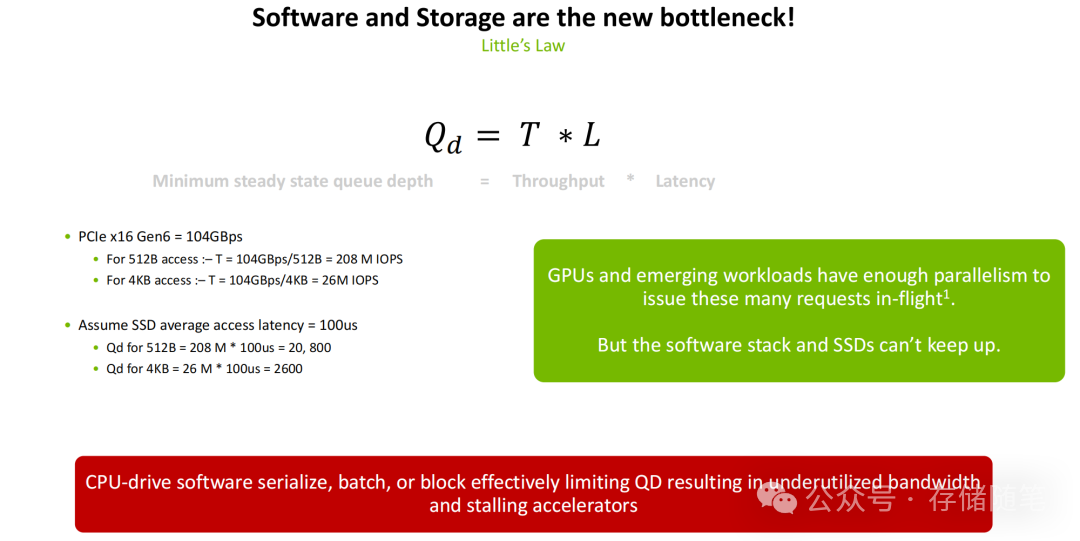
GPU的并行性足以支撑数千条并发IO请求,但CPU驱动的软件栈会序列化、批处理请求,严重限制队列深度(QD),最终导致带宽利用率低下,加速器频繁stall。数据显示,AI推理中4KB以下的小块IO占比超过70%,而CPU控制的存储架构在这类场景下的IOPS效率仅为GPU主导架构的1/2以下。
二、从GPUDirect到SCADA:存储IO的“控制权革命”
SCADA的核心创新,在于彻底打破了CPU对存储IO的垄断,实现了GPU对“控制路径+数据路径”的全接管——这是它与GPUDirect最本质的区别,也是其小块传输性能超越前者的关键。
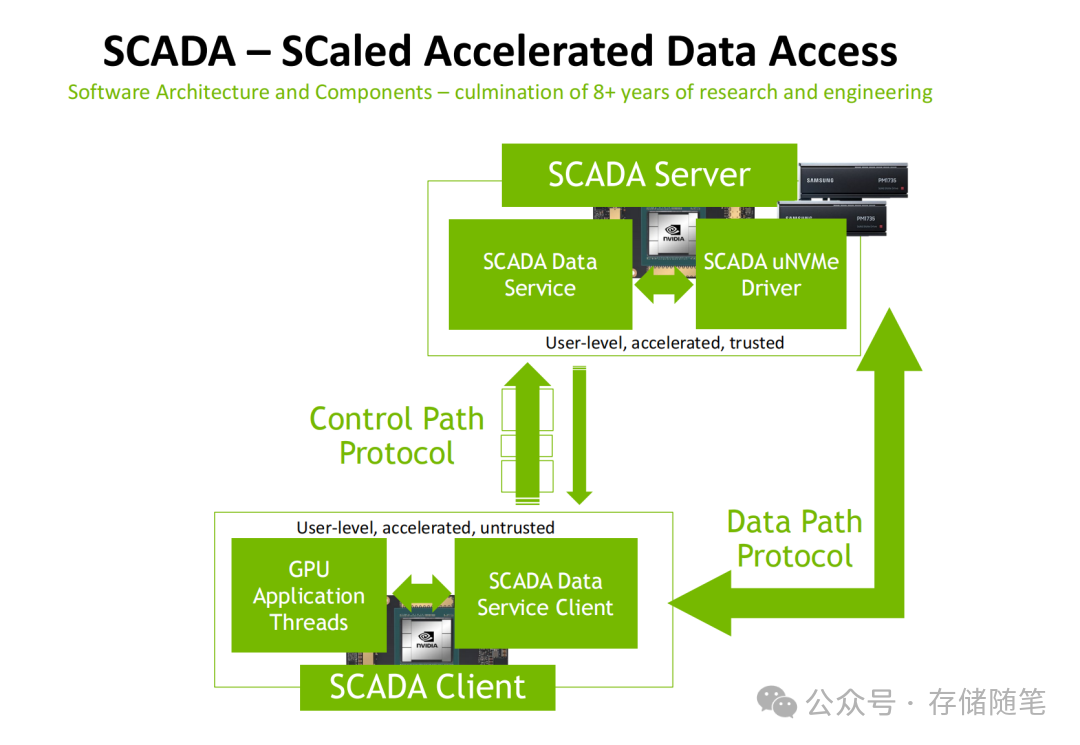
1. 三代存储IO架构的演进
扩展阅读:
-
浅析PCIe 6.0 ATS地址转换功能
-
PCIe 8.0协议规范0.3版本发布!