LabVIEW + 机器学习:GMM-KNN 双层框架实现中子-伽马射线实时甄别,准确率高达 99.3%
核辐射探测领域中,中子与伽马射线的精准甄别一直是技术难点。本文分享一种基于 LabVIEW + FPGA + GMM-KNN 双层框架的创新解决方案,将 248 维高维数据压缩至 2 维特征,甄别准确率达 99.317%,FOM 值最高提升 32%。
一、背景:核辐射甄别的技术挑战
在核辐射探测场景中,中子源(如 Am-Be 中子源)发射的粒子流通常同时包含中子和伽马射线。二者在探测器(如 EJ-301 有机闪烁体)中产生的脉冲信号形态相似,但其物理机制不同:
中子脉冲:与探测器中的质子发生弹性散射,脉冲衰减较慢
伽马脉冲:与电子发生康普顿散射,脉冲衰减较快
传统的甄别方法依赖脉冲形状分析,但随着探测环境日趋复杂(低剂量率、高噪声背景、多能量区间),单一算法难以兼顾精度与实时性。
针对上述问题,丁廷梦等人的研究提出了一种 GMM-KNN 双层机器学习框架,并基于 LabVIEW 与 FPGA 硬件实现了实时甄别系统。
二、传统方法的局限
传统的电荷比较法(CCM)是最常用的甄别方法之一。然而,其在实际应用中面临以下瓶颈:
|
问题 |
描述 |
|
能量依赖性 |
低能段(<25 keV)甄别能力急剧下降 |
|
手动阈值设定 |
需人工调整判决阈值,适应性差 |
|
噪声敏感 |
信噪比低时误判率显著上升 |
|
特征单一 |
仅利用单一波形特征,信息利用率低 |
相比之下,基于机器学习的 GMM-KNN 双层框架通过无监督聚类 + 有监督分类的组合策略,彻底规避了上述问题。
三、GMM-KNN 双层框架详解
该框架的核心思路是:先用无监督学习自动生成「伪标签」,再用有监督学习完成高精度分类。
训练阶段:
脉冲数据 → 特征提取(Qtail / Qtotal)→ 能量分段(0-25 / 25-100 / 100-2100 keV)→ GMM 无监督聚类 → 99%概率阈值筛选 → 伪标签 → KNN 分类器训练
推理阶段:
新脉冲 → 特征提取 → 能量分段 → 对应段 KNN 分类器 → 判决结果
3.1 GMM 无监督聚类(伪标签生成)
高斯混合模型(GMM)假设数据由多个高斯分布混合生成。相比于传统 CCM 的单一阈值,GMM 能够适应数据的多模态分布特性。
关键参数:
|
参数 |
取值 |
|
训练集 |
30000 个脉冲 |
|
测试集 |
30000 个脉冲 |
|
概率阈值 |
99%(仅保留高置信度样本) |
|
有效标签 |
26172 个(筛除 3828 个模糊样本) |
|
探测器 |
EJ-301 有机闪烁体 |
|
中子源 |
²⁴¹Am-Be |
|
数字化仪 |
DT5730B |
经过概率阈值筛选,低置信度样本被剔除,剩余的高质量伪标签为后续 KNN 训练奠定了坚实基础。
3.2 KNN 监督分类
K 近邻(KNN)算法根据特征空间中最近的 K 个邻居进行投票分类。
|
参数 |
取值 |
|
K 值 |
5(最优) |
|
验证方式 |
10 折交叉验证 |
|
判断逻辑 |
仅需 1 次比较(n₃ vs γ₃) |
优化后的判断逻辑大幅降低了计算开销:仅需对比第 3 近邻的中子与伽马概率,即可做出判决。
|
样本比例 |
耗时 |
与完整集准确率差异 |
|
1/4 样本集 |
约 2021 ms |
仅差 0.13% |
|
完整样本集 |
约 8084 ms |
– |
这意味着在保持高精度的同时,可将推理速度提升 4 倍,非常适合实时场景。
四、特征降维:从 248 维到 2 维
原始脉冲采样点为 248 个,直接在高维空间中做聚类/分类,存在维度灾难问题——计算量大、过拟合风险高。
该研究的特征降维策略极为巧妙:
原始信号(248 维)→ 提取 2 个关键特征:
|
特征 |
含义 |
物理意义 |
|
Qtotal |
脉冲总积分面积 |
反映粒子总能量 |
|
Qtail |
脉冲尾部积分面积 |
反映脉冲衰减速度(中子 vs 伽马的核心差异) |
能量分段聚类:进一步将样本按能量分为三段,每段独立训练 GMM 模型,以消除能量差异对甄别性能的影响:
|
能量段 |
范围 |
特点 |
|
低能段 |
0 – 25 keV |
噪声干扰最强,甄别难度最大 |
|
中能段 |
25 – 100 keV |
过渡区域,CCM 效果下降明显 |
|
高能段 |
100 – 2100 keV |
信号质量好,甄别相对容易 |
这一"两维特征 + 三分段"的策略,使模型复杂度大幅降低,同时显著提升了各能段的甄别性能。
五、LabVIEW 实现:数组 VI + FPGA 加速

5.1 软件实现
整个算法在 LabVIEW 环境中完成实现,充分利用 LabVIEW 在数据采集与信号处理方面的优势:
|
功能模块 |
核心 VI / 方法 |
|
数据读取 |
读取带分隔符的电子表格文件.vi |
|
脉冲索引 |
索引数组 |
|
数据截取 |
数组子集 |
|
特征排序 |
排序数组 |
|
数组合并 |
合并数组 |
|
特征计算 |
数组运算(积分/求积) |
LabVIEW 的图形化编程特性使得数据处理流程一目了然,同时数组 VI 的高效执行保证了处理速度。
5.2 FPGA 硬件加速
对于计算密集型的平方运算等操作,系统采用 FPGA 实现硬件加速:
|
硬件 |
型号 |
配置 |
|
FPGA 板卡 |
NI PXIe-7976R |
Kintex-7 FPGA, 2GB DRAM |
|
机箱 |
NI PXIe-1085 |
高速背板,低延迟通信 |
|
控制器 |
NI PXIe-8135 |
i7-3610QE 处理器 |
|
通信方式 |
FIFO 数据通道 |
HOST ↔ FPGA 双向通信 |
FPGA 处理流程:
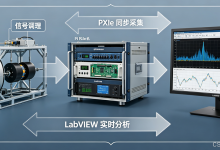
HOST 端 LabVIEW → 脉冲数据预处理 → 特征提取(Qtotal / Qtail)→ FIFO 数据通道 → FPGA (PXIe-7976R) → 平方运算加速 → 并行流水线处理 → FIFO 数据通道 → HOST 端 LabVIEW → GMM-KNN 推理 → 结果输出与显示
这种 LabVIEW + FPGA 的异构计算架构,将算法灵活性(LabVIEW)与计算加速(FPGA)有机结合,是实现实时甄别的关键。
六、实验数据对比
6.1 FOM 值对比:GMM-KNN vs CCM
FOM(Figure of Merit)是衡量甄别性能的核心指标,FOM 值越高,甄别效果越好。
|
能量段 |
GMM-KNN |
CCM(传统电荷比较法) |
提升幅度 |
|
0 – 25 keV |
0.877 |
0.664 |
▲ 32.08% |
|
25 – 100 keV |
1.262 |
1.053 |
▲ 19.85% |
|
100 – 2100 keV |
1.020 |
0.967 |
▲ 5.48% |
关键发现:在甄别最困难的低能段(0-25 keV),GMM-KNN 的提升最为显著,FOM 值提升了 32%。这说明机器学习方法在弱信号场景下具有传统方法无法比拟的优势。
6.2 KNN 分类准确率
总体准确率:99.317%
10 折交叉验证下的稳定性表现优异,未出现明显过拟合。
6.3 推理时间性能
|
模式 |
处理 30000 样本耗时 |
特点 |
|
完整 KNN 推理 |
约 8084 ms |
精度最高 |
|
1/4 样本 KNN 推理 |
约 2021 ms |
精度损失仅 0.13%,速度提升 4 倍 |
|
优化判断逻辑(n₃ vs γ₃) |
– |
大幅减少 KNN 距离比较次数 |
七、方案优势总结
技术维度
|
优势 |
说明 |
|
高精度 |
总体准确率 99.317%,低能段 FOM 提升 32% |
|
全自动 |
GMM 无监督聚类生成伪标签,无需人工标注 |
|
实时性强 |
优化后的 KNN 推理 + FPGA 硬件加速,满足实时甄别需求 |
|
抗噪声好 |
99% 概率阈值过滤低置信度样本,提升模型鲁棒性 |
|
跨能段适配 |
能量分段聚类策略覆盖 0 – 2100 keV 宽动态范围 |
|
特征简洁 |
248 维 → 2 维降维,避免维度灾难 |
工程维度
LabVIEW 生态集成:完整兼容 NI 数据采集硬件(PXIe 平台、数字化仪),打通从信号采集到算法推理的全链路
FPGA 加速:利用 NI PXIe-7976R 板卡实现硬件级并行加速,适用于嵌入式部署场景
可迁移性强:GMM-KNN 框架不仅适用于 n-γ 甄别,还可推广至其他脉冲形状甄别场景
八、总结
基于 LabVIEW + GMM-KNN 双层框架的中子-伽马射线甄别方案,通过无监督聚类生成伪标签 + 有监督 KNN 分类的组合策略,在 0-2100 keV 全能量范围内实现了 99.317% 的甄别准确率。在低能段(0-25 keV),其 FOM 值相比传统 CCM 方法提升了 32%,充分展示了机器学习在核辐射探测领域的巨大潜力。
LabVIEW 作为系统集成平台,凭借其丰富的数组处理 VI、便捷的 FPGA 编程接口以及成熟的 NI 硬件生态,为复杂的机器学习算法落地提供了高效的工程化路径。
需要 LabVIEW 开发支持?欢迎联系我们!