MEMS 惯性传感器要在划片之前做终测。一片晶圆上排着 3400 个传感器,每个都要测,每个都要判。测试节拍差一秒,整片就差将近一个小时——这不是效率问题,是产能问题。
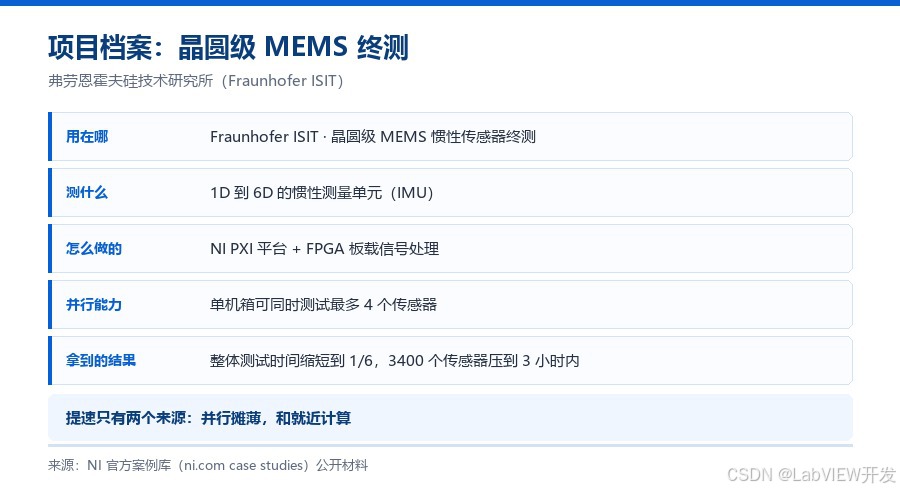
德国弗劳恩霍夫硅技术研究所(Fraunhofer ISIT)为这件事搭了一套基于 PXI 的晶圆级终测系统。结果是把整体测试时间压到原来的 1/6,一片晶圆的测试进了 3 小时以内,而且精度没有让步。
一、量产测试的三座山:时间、占地、成本
这三项在实验室里不是问题,在量产线上是命门。测试机台一小时的成本是固定的,节拍慢就等于烧钱;洁净室里每一平米都要钱,机柜堆得越多越亏;型号一多,一套系统只测一个型号,折旧根本摊不平。
所以量产测试的优化目标从来不是「测得更好」,而是在同样的精度下,单位时间测更多。
这个目标一旦定下来,技术路线就被限定了一半:所有能并行的先并行,所有能提前算的先提前算。
二、并行是最直觉的答案,也是最容易做坏的答案
直觉方案是多摆几台测试机。代价很直接:占地和成本一起涨,而且工位之间的结果要能互相比对,否则良率判定就没有统一口径。
ISIT 的做法是在一个机箱里做并行:这套系统可同时测试最多 4 个传感器。同一套机箱、同一套时钟、同一套判定规则,占地只有一个机柜的位置。
但并行度上去之后,新问题立刻出现:四路同时跑,任何一路的时序抖动都会被放大成判定差异。并行不是把程序复制四份,是让四路共享一套时间基准。
项目档案:晶圆级 MEMS 终测
三、提速的另一半,藏在「数据不用搬家」里
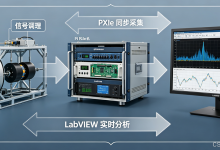
传统链路是这样的:采集卡把原始波形搬到 PC,PC 上做滤波、拟合、判据。数据量一大,搬运本身就吃掉大部分节拍,而且这部分开销随通道数线性增长。
ISIT 的原话是:这套 PXI 方案最大的优势,是能在不牺牲测量精度的前提下拿到更快的测量速度,这主要归功于 FPGA 板载信号处理能力。也就是说,该算的东西在模块上就算完了,PC 拿到的是结果,不是原始数据流。
这条经验很朴素:能让硬件算的,别让软件算。软件层每多一次搬运,就多一次内存拷贝和一次调度等待,量产线上这些开销会被放大成百上千倍。

四个瓶颈,四个解法
四、一套程序覆盖 1D 到 6D,靠配置不靠复制
惯性测量单元从单轴到六轴,测试项目、量程、激励方式都不一样。最容易走的路是每个型号写一套程序——然后你就有了六套要维护的代码,六套要分别验证的判据。
这套系统的做法是从 1D 到 6D 的 IMU 都用同一套程序覆盖,测试项通过配置组织。换型号是改配置,不是改代码。
背后是一个很实际的判断:型号会一直变,架构不该跟着变。
五、什么样的量产测试该这么改
如果你手上的活儿命中下面三条以上,这套思路可以直接搬:
● 量产测试环节是产能瓶颈,节拍直接决定成本
● 测试系统占地受限,需要高通道密度
● 同一套系统要覆盖多个型号与量程
● 提速的前提是不牺牲精度

这套做法,你的产线命中几条?
量产测试和实验室测试是两种手艺。实验室追求「这一次测得准」,量产线追求「第一万个和第一个一样准,而且快」。如果你手上的测试台正卡在节拍上,后台说说单片耗时和工位数,我们算算并行和 FPGA 各自能拿回多少。
—
注:本文案例信息来自 NI 官方案例库(ni.com case studies)公开材料,机构名称、装置背景与技术组合均可公开查证;文中未对原始指标作推算或外推,涉及时间、人力等数据均取原文口径。