重磅预告:本专栏将独家连载系列丛书《智能体视觉技术与应用》部分精华内容,该书是世界首套系统阐述“因式智能体”视觉理论与实践的专著,特邀美国 TypeOne 公司首席科学家、斯坦福大学博士 Bohan 担任技术顾问。Bohan先生师从美国三院院士、“AI教母”李飞飞教授,学术引用量在近四年内突破万次,是全球AI与机器人视觉领域的标杆性人物(www.type-one.com)。全书严格遵循“基础—原理—实操—进阶—赋能—未来”的六步进阶逻辑,致力于引入“类人智眼”新范式,系统破解从数字世界到物理世界“最后一公里”的世界级难题。该书精彩内容将优先在本专栏陆续发布,其纸质专著亦将正式出版。敬请关注!
前沿技术背景介绍:AI智能体视觉(TVA,Transformer-based Vision Agent)是依托Transformer架构与“因式智能体”理论所构建的颠覆性工业视觉技术,属于“物理AI” 领域的一种全新技术形态,实现了从“虚拟世界”到“真实世界”的历史性跨越。它区别于传统计算机视觉和常规AI视觉技术,代表了工业智能化转型与视觉检测模式的根本性重构(www.tianyance.cn)。 在实质内涵上,TVA是一种复合概念,是集深度强化学习(DRL)、卷积神经网络(CNN)、因式分解算法(FRA)于一体的系统工程框架,构建了能够“感知-推理-决策-行动-反馈”的迭代运作闭环,完成从“看见”到“看懂”的范式突破,不仅被业界誉为“AI视觉检测专家”,而且也被理解为“具身视觉智能体“,是智能机器人视觉与灵巧运动控制的关键技术支撑。
版权声明:本文系作者原创首发于 CSDN 的技术类文章,受《中华人民共和国著作权法》保护,转载或商用敬请注明出处。
闭环智能体范式:感知-决策-执行的工业系统建模与实践突破
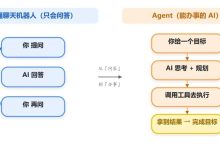
引言:在工业智能化浪潮中,闭环智能体范式因其具备自主感知环境、智能决策与精准执行的能力,正成为推动制造升级的核心引擎。该范式以强化学习(Reinforcement Learning, RL)为理论基础,构建了“状态感知-策略决策-动作执行-反馈学习”的完整闭环。其核心在于模拟人类或智能体在环境中通过交互学习最优行为策略的过程,并将其应用于复杂的工业场景。
1. 系统建模与理论基础
闭环智能体范式的数学模型建立在马尔可夫决策过程(Markov Decision Process, MDP)框架之上。一个标准的MDP可由元组 (S,A,P,R,γ)(S,A,P,R,γ) 定义:
-
SS:状态空间,代表系统或环境的可能状态集合。
-
AA:动作空间,代表智能体可执行的操作集合。
-
PP:状态转移函数,P(st+1∣st,at)P(st+1∣st,at),描述在状态 stst 下执行动作 atat 后转移到状态 st+1st+1 的概率。
-
RR:奖励函数,R(st,at,st+1)R(st,at,st+1),用于评估动作执行的效果。
-
γγ:折扣因子(0≤γ<10≤γ<1),用于权衡当前奖励与未来奖励的重要性。
智能体的目标是通过与环境交互,学习一个最优策略 π∗π∗,以最大化累积奖励(即回报)的期望值。策略 ππ 通常定义为从状态到动作的概率分布:at∼πϕ(st)at∼πϕ(st),其中 ϕϕ 是策略函数的参数(如神经网络的权重)。
状态转移是系统演化的核心:
st+1=f(st,at;θ)st+1=f(st,at;θ)
其中 ff 代表环境动力学模型,θθ 是模型参数。在已知模型的情况下(如某些仿真环境),可直接计算;在未知模型的情况下(如真实工业环境),智能体需通过经验学习近似模型或采用无模型RL方法。
价值函数用于评估策略的优劣。状态价值函数 Vπ(s)Vπ(s) 表示从状态 ss 开始,遵循策略 ππ 所能获得的期望累积回报:
Vπ(s)=Eπ[∑k=0∞γkrt+k+1∣st=s]Vπ(s)=Eπ[k=0∑∞γkrt+k+1∣st=s]
动作价值函数(Q函数)Qπ(s,a)Qπ(s,a) 则评估在状态 ss 下执行动作 aa 后,再遵循策略 ππ 的期望累积回报:
Qπ(s,a)=Eπ[∑k=0∞γkrt+k+1∣st=s,at=a]Qπ(s,a)=Eπ[k=0∑∞γkrt+k+1∣st=s,at=a]
最优策略 π∗π∗ 满足对所有状态 ss 和策略 ππ,都有 Vπ∗(s)≥Vπ(s)Vπ∗(s)≥Vπ(s)。目标回报 RtRt 即为 Vπ(st)Vπ(st) 或 Qπ(st,at)Qπ(st,at) 的估计值。
策略优化是学习的关键环节。策略梯度(Policy Gradient, PG)方法直接优化策略参数 ϕϕ 以最大化期望回报 J(ϕ)J(ϕ):
∇ϕJ(ϕ)=Eτ∼πϕ[∑t=0T∇ϕlogπϕ(at∣st)A^t]∇ϕJ(ϕ)=Eτ∼πϕ[t=0∑T∇ϕlogπϕ(at∣st)A^t]
其中 ττ 是轨迹(状态-动作序列),A^tA^t 是优势函数估计(如 Qπ(st,at)−Vπ(st)Qπ(st,at)−Vπ(st)),用于评估动作相对于平均水平的优劣。深度确定性策略梯度(DDPG)、近端策略优化(PPO)等算法是工业应用中的主流选择1。
2. 系统架构:感知-决策-执行闭环
闭环智能体的工业部署通常采用分层架构:
-
感知层 (Perception):
-
功能:利用传感器(视觉、声音、振动、温度、压力等)和工业物联网(IIoT)技术,实时采集环境与设备状态数据(stst)。
-
关键技术:计算机视觉(CV)、信号处理、多传感器融合、状态估计。例如,采用Transformer架构的视觉模型进行高精度质检,其状态 stst 包含了产品图像特征、历史检测结果等。
-
输出:高维、结构化的状态表征 stst。
-
-
决策层 (Decision):
-
功能:基于当前状态 stst,依据学习到的策略 πϕπϕ,生成最优动作指令 at∼πϕ(st)at∼πϕ(st)。
-
关键技术:深度强化学习(DRL)算法、在线/离线学习、安全约束处理、多智能体协调(Multi-Agent RL, MARL)。策略网络 πϕπϕ 可以是深度神经网络(DNN),接收 stst 并输出动作分布或确定性动作。
-
输出:控制指令 atat(如设定参数、调度指令、维护建议)。
-
-
执行层 (Execution):
-
功能:将决策层产生的动作 atat 转化为对物理世界或信息系统的具体操作(如调节阀门开度、启动机械臂、发送工单)。
-
关键技术:工业控制系统(PLC/DCS)、机器人控制、执行器驱动、消息队列。
-
效果:改变环境状态,驱动系统向 st+1st+1 转移。
-
-
反馈与学习回路:
-
功能:执行动作 atat 后,环境给出即时奖励 rt+1rt+1 和新状态 st+1st+1。这些经验 (st,at,rt+1,st+1)(st,at,rt+1,st+1) 被存储到经验回放池(Replay Buffer),用于后续的策略更新。
-
关键技术:经验回放、目标网络延迟更新(稳定训练)、奖励函数设计(核心难点!)。
-
目标:持续优化策略 πϕπϕ,最大化长期累积奖励 RtRt。
-
3. 场景突破案例
3.1 自优化智能质检系统
-
挑战:传统机器视觉质检需大量人工调参,对不同产品、光照、缺陷类型泛化能力差,且无法根据反馈动态优化阈值。
-
闭环方案:
-
感知:工业相机采集产品图像,视觉模型(如基于Transformer的缺陷分割网络)提取高维特征作为状态 stst(包含图像特征、历史良率)。
-
决策:策略网络 πϕπϕ 接收 stst,输出动作 atat。动作可包括:
-
调整检测模型的置信度阈值。
-
选择不同的图像预处理参数(对比度、亮度)。
-
决定是否触发更精细的复检流程。
-
-
执行:控制系统根据 atat 调整检测流水线参数,对当前产品进行判定(合格/不合格)。
-
反馈:
-
即时奖励 rt+1rt+1:结合判定结果(漏检/误报惩罚)、检测耗时(效率奖励)。
-
新状态 st+1st+1:下个产品的图像特征、更新后的良率统计。
-
-
-
成果:某半导体封装厂部署后,系统能自动适应晶圆批次差异和车间光照变化,误报率降低35%,漏检率降低28%,且减少了70%的阈值人工调整工作量。系统通过在线学习持续优化策略 πϕπϕ,提升了鲁棒性1。
3.2 预测性维护自主决策
-
挑战:设备突发故障导致停线损失巨大。传统基于阈值的告警或固定周期的预防性维护(PM)效率低下,或过度维护或维护不足。
-
闭环方案:
-
感知:振动传感器、温度传感器、电流传感器、SCADA系统实时采集设备运行数据(stst 包含时序特征、工况参数、历史维护记录)。
-
决策:策略网络 πϕπϕ 分析 stst,评估设备健康状态和剩余使用寿命(RUL),输出动作 atat:
-
“继续运行”(无动作)。
-
“建议巡检”(低优先级)。
-
“安排预防性维护”(中优先级)。
-
“立即停机检修”(高优先级)。
-
-
执行:维护指令 atat 通过MES/工单系统下达给维护团队或自动触发设备停机程序。
-
反馈:
-
奖励 rt+1rt+1:与维护成本(负奖励)、故障停机损失(大负奖励)、设备无故障运行时长(正奖励)强相关。例如,成功预警避免了停机,获得高奖励;过度维护产生成本,获得负奖励;漏报导致故障,获得极大负奖励。
-
新状态 st+1st+1:维护后的设备数据、更新的运行时长。
-
-
-
成果:某风电场对齿轮箱应用该闭环系统,基于LSTM+PPO的决策模型,相比固定周期维护,维护成本降低22%,非计划停机时间减少45%,设备可用率提升8%。系统通过不断学习不同工况下的最优维护时机,实现了效益最大化1。
3.3 柔性产线自主调度
-
挑战:多品种、小批量柔性生产模式下,订单动态到达、设备状态变化、物料供应波动,传统固定规则或人工调度难以实现全局最优。
-
闭环方案:
-
感知:MES/WMS系统提供实时状态 stst(包含:各工位设备状态、在制品队列、订单队列、物料库存、AGV位置)。
-
决策:多智能体强化学习(MARL)框架。每个调度决策点(如新订单到达、设备释放)视为一个智能体(或中央智能体),策略 πϕπϕ 输出动作 atat:
-
为订单分配加工路径(选择设备/工位)。
-
调度AGV运输物料/在制品。
-
设定设备加工优先级。
-
-
执行:调度指令 atat 下发给MES、AGV控制系统、设备控制器。
-
反馈:
-
奖励 rt+1rt+1:通常与订单准时交付率、设备利用率(OEE)、在制品库存水平、生产周期时间相关。最大化准时交付和OEE通常是核心目标。
-
新状态 st+1st+1:指令执行后的系统新状态。
-
-
-
成果:某汽车零部件柔性生产线采用基于QMIX(一种MARL算法)的调度系统,面对订单混合变化,相比基于规则调度,平均订单交付提前期缩短25%,设备OEE提升15%,在制品库存降低30%。系统能自适应订单波动和设备故障,实现动态最优调度1。
4. 技术挑战与未来方向
尽管闭环智能体范式展现出巨大潜力,工业落地仍面临挑战:
-
样本效率与安全性:真实环境交互成本高且风险大。解决方案:结合仿真预训练、离线强化学习(Offline RL)、安全约束策略优化(Safe RL)。
-
奖励函数设计:定义能准确反映复杂业务目标的奖励函数极其困难。需领域专家深度参与,并可能需结合逆强化学习(Inverse RL)。
-
可解释性与信任:深度神经网络的“黑箱”特性影响工业用户信任。方向:可解释AI(XAI)技术、结合符号规则的神经符号方法。
-
系统集成复杂度:与现有工业控制系统(PLC/DCS)、MES/ERP系统的无缝集成是工程难点。需要标准化接口和中间件支持。
-
多智能体协调:复杂产线涉及多个决策主体(如调度、物流、维护),协调策略设计难度大。MARL是主要研究方向。
未来发展方向包括:
-
世界模型学习:学习更准确的环境动力学模型 f(st,at;θ)f(st,at;θ),减少真实交互需求。
-
元学习与自适应:使智能体具备快速适应新产线、新产品、新工艺的能力。
-
人机协作:设计支持人类干预和指导的混合智能决策框架。
-
边缘智能:将轻量化模型部署到边缘设备,实现更低延迟的闭环控制。
5. 结论
闭环智能体范式以强化学习为核心,构建了“感知-决策-执行-反馈”的自主优化回路,为工业智能化提供了强大的方法论。从自优化质检到预测性维护,再到自主调度,其应用正在深刻改变工业生产的效率和灵活性。尽管存在样本效率、安全性、可解释性等挑战,但随着算法的进步、算力的提升以及与工业系统更深的融合,闭环智能体必将成为构建未来智能工厂的关键基石,驱动工业制造向更高水平的自主化和智能化迈进。持续优化策略 πϕπϕ 以最大化长期价值 RtRt 的过程,正是工业系统持续进化、追求卓越的智能体现1。
写在最后——以TVA重新定义视觉技术的能力边界
闭环智能体范式通过"感知-决策-执行-反馈"的自主优化回路,正在推动工业智能化变革。该范式基于强化学习理论,构建了包含状态感知、策略决策、动作执行和学习反馈的完整闭环系统。在工业应用中,该系统通过传感器实时采集数据(感知层),利用深度强化学习算法生成最优指令(决策层),并转化为具体操作(执行层)。典型案例包括自优化质检系统(误报率降低35%)、预测性维护(维护成本降低22%)和柔性产线调度(交付周期缩短25%)。尽管面临样本效率、安全性等挑战,但随着算法进步和系统融合,闭环智能体将成为智能工厂的核心技术,推动制造业向更高水平的自主化发展。