一、引言:时序数据,工业智能化的"新石油"
在工业4.0和智能制造的浪潮中,数据已经成为驱动企业决策的核心资产。然而,与传统结构化数据不同,工业场景中产生的数据绝大多数是时序数据——温度、压力、振动、电流、流量等指标随时间连续变化,形成一条条"数据曲线"。这些曲线蕴含着设备运行状态、工艺质量趋势、能源消耗规律等关键信息,是工业智能化的"新石油"。
然而,将时序数据转化为可指导业务的洞察,长期以来面临三大挑战:
建模门槛高:传统时序分析方法(如ARIMA、Prophet、LSTM等)需要深厚的统计学和机器学习功底,从数据清洗到模型调优的周期往往以周甚至月计。
场景泛化难:工业场景千差万别,一个产线的预测模型很难直接迁移到另一个产线,"造轮子"成本极高。
数据依赖重:传统深度学习模型需要大量标注数据,而工业场景中故障样本稀缺、标注成本高昂,小样本场景难以落地。
正是在这样的背景下,时序大模型应运而生。与通用大语言模型(LLM)不同,时序大模型是专门为时间序列数据设计的预训练模型,它通过在万亿级时间点数据上的预训练,掌握了时序数据的通用规律,能够以"零样本"或"少样本"的方式快速适配各类预测和分析任务。

本文将聚焦天谋科技推出的时序大模型服务平台 TimechoAI(基于清华大学 Timer 时序大模型),从原理到实践,深入探讨如何利用这一"懂时序的大模型"解决工业级时序分析难题。
二、TimechoAI 与 Timer:从学术前沿到工业落地

2.1 Timer:时序大模型的四代演进
要理解 TimechoAI,必须先了解它背后的核心引擎——Timer。Timer 发源于清华大学软件学院 THUML 团队,是目前国内外最具影响力的时序大模型之一。从2023年发布至今,Timer 经历了清晰的四代演进
| Timer 1.0 | 2023年 | 首次验证时序大模型可行性,实现少样本泛化和多任务适配 | 百万级 |
| Timer 2.0 | 2024年 | 创新二维注意力机制,同时建模时间维度和变量维度,实现"历史越长,预测越好" | 千万级 |
| Timer 3.0 | 2025年 | 采用生成式建模,支持多未来序列生成;万亿时间点预训练,推理速度达 Chronos 20倍 | 亿级 |
| Timer-3.5 | 2026年3月 | 首个十亿级时序基础模型,83亿总参数,11.5K上下文长度;GIFT-Eval基准SOTA | 83亿 |
Timer-3.5 的发布标志着时序大模型进入了"十亿参数时代"。在 GIFT-Eval(国际通用时序预测基准)上,Timer-3.5 取得了整体性能 SOTA(State-of-the-art),MASE 相较于前代降低 7.6%,CRPS 降低 13.2%。该模型在 Hugging Face 单月下载量超过 500 万次,充分证明了学术界和工业界对时序大模型的高度认可。
2.2 TimechoAI:让时序大模型触手可及
TimechoAI 是天谋科技将 Timer 时序大模型能力产品化、服务化的关键一步。它不是简单地把通用大语言模型"换个皮肤"套到时序场景,而是从底层就为时序而生——针对工业预测、设备异常、能源负荷、生产分析等真实业务场景进行大规模预训练和深度优化。
TimechoAI 的核心定位可以概括为:"把复杂的时序建模能力封装成企业可以直接使用的云服务"。用户无需理解 Transformer 架构、注意力机制或损失函数,只需上传历史数据,即可获得高精度的预测结果。
目前,TimechoAI 平台默认搭载 Timer-3.5,同时支持多种模型灵活选择:
-
Timer-3.5:最新一代 SOTA 时序大模型,覆盖多场景、多粒度预测
-
Timer-3.0:经典版本,适合对稳定性要求高的场景
-
Chronos-2:Amazon 开源的时序预训练大模型
-
AutoARIMA:经典统计模型,适合简单序列的快速预测
-
Holt-Winters:季节性分解方法,适合有明显周期规律的数据
平台还提供 Auto 模式,自动根据数据特征推荐最合适的模型,真正实现"一键智能预测"。
如果你对时序大模型 TimechoAI 感兴趣,可以通过以下方式开始探索:
-
企业版官网:https://timecho.com —— 了解 TimechoDB 企业版及全栈解决方案
-
时序大模型体验:https://ai.timecho.com —— 注册获取 API Key,上传你的数据,立即体验 Timer-3.5 的预测能力
三、TimechoAI 核心能力解析

3.1 时序预测:从"看历史"到"知未来"
时序预测是 TimechoAI 的核心能力。与传统方法相比,时序大模型的优势在于:
(1)长上下文建模能力
Timer-3.5 支持 11.5K 时间点的上下文长度,这意味着它可以同时分析长达数周甚至数月的历史数据,捕捉长期趋势、季节性周期和周期性波动。传统 LSTM 模型通常只能有效记忆几十个时间步,而时序大模型通过创新的二维注意力机制,实现了"历史信息越长,预测效果越好"的突破。
(2)多变量协同建模
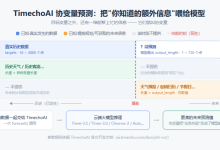
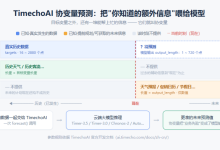
工业场景中,单一指标往往受多个因素影响。例如,电力变压器油温不仅与自身负载有关,还与环境温度、湿度、风速等协变量相关。TimechoAI 支持在预测时添加协变量,让模型综合考虑多因素交互影响,预测结果更贴近真实业务场景。
(3)不确定性量化
Timer 3.0 开始采用生成式建模,针对同一输入可以生成多个可能的未来序列。这在工业场景中尤为重要——设备故障预测不是简单的"是或否",而是需要给出"未来72小时故障概率为15%"这样的概率化输出,帮助运维人员合理安排检修计划。
3.2 异常检测:从"事后告警"到"事前预警"
异常检测是 TimechoAI 的另一大核心能力。传统阈值告警方法(如"温度超过80度报警")存在大量误报和漏报,而基于时序大模型的异常检测具有以下优势:
(1)动态基线生成
模型可以学习设备的正常运行模式,为每个时间点生成"预期值"。当实际值偏离预期值超过一定阈值时,才触发告警。这种动态基线能够适应设备老化、季节变化、工艺调整等因素,大幅降低误报率。
(2)多维度异常识别
不仅检测单点异常(如某个时刻温度突增),还能识别模式异常(如振动频谱从周期性变为随机性)、趋势异常(如设备性能缓慢衰退)和关联异常(如多个传感器同时异常,暗示系统性故障)。
(3)根因辅助定位
通过分析异常时刻各变量的贡献度,TimechoAI 可以辅助运维人员快速定位异常根因。例如,当检测到某台设备异常时,模型可以指出"温度异常贡献度45%,振动异常贡献度30%,电流异常贡献度25%",帮助工程师优先排查最可能的原因。
3.3 数据填补:让缺失数据"失而复得"
工业传感器数据常因网络中断、设备故障、采集异常等原因出现缺失。传统插值方法(如线性插值)只能处理简单缺失,而 TimechoAI 的数据填补能力可以:
-
上下文感知填补:利用缺失段前后数据以及协变量信息,生成符合业务逻辑的填补值
-
长段缺失修复:对于长达数小时甚至数天的数据缺失,仍能生成合理的填补序列
-
不确定性估计:给出填补值的置信区间,帮助用户判断填补结果的可靠性
这在能源计量、环境监测等场景中尤为重要——缺失的数据如果简单用均值填充,可能导致后续分析产生系统性偏差,而时序大模型的智能填补能最大程度保留数据的真实性。
四、实战演练:从控制台到代码的完整实践
4.1 场景设定:风力发电机轴承温度预测
假设我们管理一个风电场,需要预测某台风力发电机主轴承的未来温度趋势,以便提前安排维护,避免轴承过热导致的停机事故。我们拥有该轴承过去30天的温度数据(每小时一个采样点),以及同期的环境温度、风速、发电机功率等协变量数据。
4.2 方式一:Web 控制台快速体验
对于快速验证场景,TimechoAI 提供了直观的 Web 控制台界面,无需编写任何代码:
登录平台:访问 https://ai.timecho.com,注册并获取 API Key
选择模型:推荐选择 Auto 模式或 Timer-3.5
上传数据:支持 CSV 和 TsFile 格式。TsFile 是 Apache IoTDB 的原生数据文件格式,对于已使用时序数据库的用户可以直接导出上传
添加协变量:上传环境温度、风速、功率等协变量文件
设置预测参数:输入历史长度(如720小时),输出预测长度(如72小时)
运行预测:点击"开始预测",等待数秒即可获得结果
结果可视化:平台自动生成预测曲线、置信区间、与实际值的对比图
控制台还内置了多个示例数据集,包括空气质量、ETTh/ETTm 电力变压器数据、汇率、耶拿气候等,新用户可以直接下载体验,无需准备自己的数据。
4.3 方式二:Python SDK 深度集成
对于需要将预测能力集成到业务系统的场景,TimechoAI 提供了完整的 Python SDK 和 RESTful API。以下是完整的实战代码:
步骤 1:环境准
# 安装 TimechoAI Python SDK
pip install timecho-ai
# 安装数据分析依赖
pip install pandas numpy matplotlib
步骤 2:单变量时序预测
import pandas as pd
import numpy as np
from timecho_ai import TimechoAIClient
import matplotlib.pyplot as plt
# ============================================
# 场景:风力发电机轴承温度预测
# ============================================
# 1. 读取历史温度数据
# 数据格式:time, temperature
raw_df = pd.read_csv("bearing_temperature.csv")
raw_df["time"] = pd.to_datetime(raw_df["time"])
raw_df.set_index("time", inplace=True)
print("数据预览:")
print(raw_df.head(10))
print(f"\\n数据总量:{len(raw_df)} 条记录")
print(f"时间范围:{raw_df.index.min()} 至 {raw_df.index.max()}")
# 2. 定义预测任务参数
INPUT_LENGTH = 168 # 使用过去7天数据(168小时)作为输入
OUTPUT_LENGTH = 72 # 预测未来3天(72小时)
# 3. 初始化 TimechoAI 客户端
# 请替换为您的实际 API Key
client = TimechoAIClient(
api_key="your_timecho_ai_api_key",
base_url="https://ai.timecho.com" # 可选,默认即为此地址
)
# 4. 构建目标变量 DataFrame
# 取最近 INPUT_LENGTH 个数据点作为输入
target_df = raw_df[["temperature"]].tail(INPUT_LENGTH).reset_index()
target_df.columns = ["time", "temperature"]
print(f"\\n输入数据:最近 {INPUT_LENGTH} 个时间点")
print(target_df.head())
# 5. 执行预测任务
print("\\n正在调用 TimechoAI 进行预测…")
forecast_dfs = client.forecast(
targets=target_df,
output_length=OUTPUT_LENGTH,
model="timer-3.5" # 可选:auto, timer-3.5, timer-3.0, chronos-2 等
)
# 6. 解析预测结果
forecast_df = forecast_dfs[0]
print("\\n预测结果预览:")
print(forecast_df.head(10))
# 7. 可视化:历史数据 vs 预测数据
plt.figure(figsize=(14, 6))
# 绘制历史数据
historical_times = target_df["time"]
historical_values = target_df["temperature"]
plt.plot(historical_times, historical_values,
label="Historical Temperature", color="blue", linewidth=2)
# 生成预测时间点(假设每小时一个点)
last_time = historical_times.iloc[-1]
forecast_times = pd.date_range(
start=last_time + pd.Timedelta(hours=1),
periods=OUTPUT_LENGTH,
freq="H"
)
# 绘制预测数据
forecast_values = forecast_df["temperature"].values
plt.plot(forecast_times, forecast_values,
label="Forecasted Temperature", color="red",
linestyle="–", linewidth=2)
# 添加置信区间(如果模型支持)
if "lower_bound" in forecast_df.columns and "upper_bound" in forecast_df.columns:
plt.fill_between(
forecast_times,
forecast_df["lower_bound"].values,
forecast_df["upper_bound"].values,
color="red", alpha=0.2, label="Confidence Interval"
)
plt.axvline(x=last_time, color="gray", linestyle=":", alpha=0.7, label="Prediction Start")
plt.title("Wind Turbine Bearing Temperature Forecast (TimechoAI – Timer-3.5)", fontsize=14)
plt.xlabel("Time", fontsize=12)
plt.ylabel("Temperature (C)", fontsize=12)
plt.legend(loc="best")
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.savefig("temperature_forecast.png", dpi=150)
plt.show()
print("\\n预测完成!图表已保存为 temperature_forecast.png")
步骤 3:多变量预测(带协变量)
# ============================================
# 进阶:多变量预测——考虑环境温度、风速、功率
# ============================================
# 读取协变量数据
covariate_df = pd.read_csv("covariates.csv") # 包含 ambient_temp, wind_speed, power
covariate_df["time"] = pd.to_datetime(covariate_df["time"])
# 合并目标变量和协变量
merged_df = pd.merge(raw_df.reset_index(), covariate_df, on="time", how="inner")
# 构建带协变量的预测请求
target_with_cov = merged_df[["time", "temperature", "ambient_temp", "wind_speed", "power"]].tail(INPUT_LENGTH)
# 指定协变量列
covariate_columns = ["ambient_temp", "wind_speed", "power"]
forecast_dfs = client.forecast(
targets=target_with_cov,
output_length=OUTPUT_LENGTH,
model="timer-3.5",
covariates=covariate_columns # 告知模型哪些列是协变量
)
print("多变量预测完成,协变量已纳入模型考虑。")
步骤 4:批量预测与异常检测
# ============================================
# 批量预测:风电场多台风机同时预测
# ============================================
import time
turbine_ids = ["WT001", "WT002", "WT003", "WT004", "WT005"]
results = {}
for tid in turbine_ids:
# 读取单台风机数据
df = pd.read_csv(f"{tid}_temperature.csv")
df["time"] = pd.to_datetime(df["time"])
target = df[["time", "temperature"]].tail(INPUT_LENGTH)
# 调用预测
forecast = client.forecast(
targets=target,
output_length=OUTPUT_LENGTH,
model="auto" # 让平台自动选择最适合的模型
)
results[tid] = forecast[0]
print(f"[{tid}] 预测完成,未来72小时平均温度:{forecast[0]["temperature"].mean():.2f}C")
time.sleep(0.5) # 避免请求过于频繁
# 汇总分析:找出温度趋势异常的风机
print("\\n=== 风电场温度趋势汇总 ===")
for tid, forecast_df in results.items():
mean_temp = forecast_df["temperature"].mean()
max_temp = forecast_df["temperature"].max()
trend = "上升" if forecast_df["temperature"].iloc[-1] > forecast_df["temperature"].iloc[0] else "下降"
alert = ""
if max_temp > 85:
alert = " [警告:预测最高温度超过85C,建议安排检修]"
print(f"{tid}: 平均={mean_temp:.1f}C, 最高={max_temp:.1f}C, 趋势={trend}{alert}")
步骤 5:REST API 直接调用(适用于非 Python 环境)
# 使用 curl 直接调用 TimechoAI REST API
# 适用于 Java、Go、Node.js 等其他语言环境
curl -s -X POST https://ai.timecho.com/ai/api/v1/forecast \\
-H "Content-Type: application/json" \\
-H "Authorization: Bearer <your-api-key>" \\
-d "{
\\"targets\\": [{
\\"columns\\": [\\"temperature\\"],
\\"data\\": [
[65.2], [66.1], [67.5], [68.0], [69.2], [70.1], [71.5],
[72.0], [73.2], [74.1], [75.0], [76.2], [77.1], [78.5],
[79.0], [80.2], [81.1], [82.0], [83.2], [84.1], [85.0], [86.2]
]
}],
\\"output_length\\": [12],
\\"model\\": \\"timer-3.5\\"
}"
对应的 Python requests 版本:
import requests
import json
api_key = "your-api-key"
url = "https://ai.timecho.com/ai/api/v1/forecast"
payload = {
"targets": [{
"columns": ["temperature"],
"data": [
[65.2], [66.1], [67.5], [68.0], [69.2], [70.1], [71.5],
[72.0], [73.2], [74.1], [75.0], [76.2], [77.1], [78.5],
[79.0], [80.2], [81.1], [82.0], [83.2], [84.1], [85.0], [86.2]
]
}],
"output_length": [12],
"model": "timer-3.5"
}
headers = {
"Content-Type": "application/json",
"Authorization": f"Bearer {api_key}"
}
response = requests.post(url, headers=headers, data=json.dumps(payload))
result = response.json()
if result.get("code") == 200:
predictions = result["data"]["results"][0]["data"]
print("预测结果:")
for i, val in enumerate(predictions):
print(f" 未来第{i+1}小时: {val[0]:.2f}C")
else:
print(f"请求失败: {result.get("message")}")
五、TimechoAI + TimechoDB:"DB + AI" 的端到端解决方案

5.1 为什么需要"DB + AI"一体化?
在实际工业场景中,时序数据的"存储"和"分析"往往是割裂的:
-
数据孤岛:传感器数据存储在时序数据库中,分析时却需要导出到 Python 环境或第三方平台,数据流转成本高
-
实时性差:离线分析模式下,从数据采集到获得洞察的延迟可能长达数小时甚至数天,无法满足实时决策需求
-
工程复杂:数据导出、格式转换、模型部署、结果回写等环节需要维护大量 ETL 脚本,运维负担重
天谋科技提出的 "DB + AI" 架构,通过将时序数据库 TimechoDB(基于 Apache IoTDB)与时序大模型分析平台 TimechoAI 深度融合,构建了覆盖数据写入、存储、查询、时序大模型训练、推理、数据智能分析的全链路能力。
5.2 TimechoDB 核心特性
TimechoDB 是 Apache IoTDB 的企业发行版,具备以下核心优势:
(1)高性能存储与查询
-
支持千万级数据点/秒的写入吞吐量
-
自研 TsFile 列式存储格式,压缩比可达 90%+,显著降低存储成本
-
支持纳秒级时间戳精度,满足高频采集场景需求
-
内置近百种聚合与时序计算函数,支持查询时时间戳对齐
(2)工业原生数据模型
采用"设备-测点"的层次化树形结构,天然适配工业场景中设备多、测点多、层级复杂的特点。例如:
— 创建风力发电机的测点结构
CREATE TIMESERIES root.windfarm.turbine001.bearing.temperature
WITH DATATYPE=FLOAT, ENCODING=GORILLA, COMPRESSOR=LZ4;
CREATE TIMESERIES root.windfarm.turbine001.bearing.vibration
WITH DATATYPE=FLOAT, ENCODING=GORILLA, COMPRESSOR=LZ4;
CREATE TIMESERIES root.windfarm.turbine001.generator.power
WITH DATATYPE=DOUBLE, ENCODING=GORILLA, COMPRESSOR=LZ4;
(3)端边云协同
支持从边缘网关到云端集群的无缝数据同步,通过 TsFile 文件格式实现离线数据高效流转,避免重复计算和 ETL 开销。
(4)企业级增强
相较于开源版 IoTDB,TimechoDB 企业版提供了:
-
多级存储:根据数据访问频率自动划分冷温热数据,存储到 SSD/机械硬盘/云存储,降低成本
-
双活部署:两个独立集群实时镜像同步,保障高可用
-
数据同步:支持跨网闸穿透、加密传输、压缩传输,满足电力等安全敏感行业需求
-
安全增强:白名单、审计日志、细粒度权限控制
-
可视化工具:IoTDB Workbench 控制台、Grafana 监控面板、IoTD 集群管理工具
5.3 从 TimechoDB 到 TimechoAI 的无缝衔接
得益于统一的 TsFile 文件格式,TimechoDB 中的数据可以直接导出并上传到 TimechoAI 进行分析:
# ============================================
# 从 TimechoDB 导出数据,直接送入 TimechoAI 预测
# ============================================
from iotdb.Session import Session
import pandas as pd
from timecho_ai import TimechoAIClient
# 1. 连接 TimechoDB
session = Session("127.0.0.1", 6667, "root", "root")
session.open(False)
# 2. 查询历史数据
sql = """
SELECT temperature, ambient_temp, wind_speed, power
FROM root.windfarm.turbine001.bearing,
root.windfarm.turbine001.environment
WHERE time > 2026-05-01T00:00:00
"""
result = session.execute_query_statement(sql)
# 3. 转换为 DataFrame
data = []
columns = ["time", "temperature", "ambient_temp", "wind_speed", "power"]
while result.has_next():
row = result.next()
data.append([
row.get_timestamp(),
row.get_fields()[0].get_float_value(),
row.get_fields()[1].get_float_value(),
row.get_fields()[2].get_float_value(),
row.get_fields()[3].get_double_value()
])
df = pd.DataFrame(data, columns=columns)
df["time"] = pd.to_datetime(df["time"])
# 4. 直接送入 TimechoAI 预测
client = TimechoAIClient(api_key="your-api-key")
forecast = client.forecast(
targets=df[["time", "temperature"]].tail(168),
output_length=72,
covariates=["ambient_temp", "wind_speed", "power"],
model="timer-3.5"
)
# 5. 将预测结果写回 TimechoDB(用于后续监控和告警)
forecast_df = forecast[0]
for idx, row in forecast_df.iterrows():
insert_sql = f"""
INSERT INTO root.windfarm.turbine001.forecast (time, temperature_pred)
VALUES ({row["time"]}, {row["temperature"]})
"""
session.execute_non_query_statement(insert_sql)
session.close()
print("数据流闭环完成:从 TimechoDB 查询 -> TimechoAI 预测 -> 结果回写 TimechoDB")
这种"DB + AI"的闭环架构,实现了:
-
数据零搬运:无需导出 CSV、无需 FTP 传输,数据库内直接流转
-
实时分析:结合 IoTDB 的流处理能力,可实现近实时的预测和告警
-
全链路可追溯:从原始传感器数据到预测结果,全链路数据血缘清晰
六、典型应用场景深度解析

6.1 设备运维与预测性维护
场景痛点:某制造企业的关键数控机床,每年因非计划停机造成损失超千万元。传统定期保养模式存在"过度维护"(浪费资源)和"维护不足"(故障停机)的双重问题。
TimechoAI 方案:
数据采集:通过 IoTDB 采集机床主轴振动、温度、电流、进给速度等时序数据
基线学习:利用 Timer-3.5 学习设备正常运行模式,建立动态健康基线
趋势预测:预测未来7天关键指标趋势,提前识别性能衰退信号
异常预警:当预测值偏离基线超过阈值时,触发分级告警(提示->警告->紧急)
维护决策:结合预测结果和设备日历,自动生成维护工单
效果预期:非计划停机时间减少 40%+,维护成本降低 25%+。
6.2 能源管理与负荷预测
场景痛点:某区域电网调度中心,需要精准预测未来24小时电力负荷,偏差每增加1%,调度成本可能增加数百万元。新能源(风电、光伏)的波动性进一步增加了预测难度。
TimechoAI 方案:
多源数据融合:整合历史负荷数据、天气预报、节假日日历、新能源出力数据
多粒度预测:同时输出15分钟、1小时、1天粒度的负荷预测
不确定性量化:提供预测区间的概率分布,辅助调度员制定鲁棒调度策略
实时修正:每15分钟滚动更新预测,融入最新实测数据
效果预期:负荷预测精度提升至 98%+,新能源消纳率提升 10%+。
6.3 工业生产质量预测
场景痛点:某半导体晶圆厂,工艺参数(温度、压力、气体流量)的微小波动可能导致整批晶圆报废。传统 SPC(统计过程控制)方法只能检测已发生的异常,无法预测未来质量趋势。
TimechoAI 方案:
工艺参数建模:利用 Timer-3.5 建模数百个工艺参数的时间序列
质量关联分析:通过协变量机制,将工艺参数与最终良率关联
提前预警:在工艺参数偏离最优区间前数小时发出预警
参数优化建议:结合预测结果,推荐最优工艺参数调整方案
效果预期:良率提升 2-3 个百分点,报废批次减少 50%+。
七、性能对比与选型建议
7.1 时序大模型 vs 传统方法
| 建模门槛 | 中等(需统计知识) | 高(需深度学习经验) | 低(零样本/少样本) |
| 数据需求 | 数百至数千样本 | 数万至数十万样本 | 数十至数百样本即可微调 |
| 长序列建模 | 差(通常<100步) | 中等(<1000步) | 强(支持11.5K步) |
| 多变量处理 | 弱 | 中等 | 强(二维注意力机制) |
| 泛化能力 | 弱(场景迁移需重训) | 中等 | 强(预训练通用知识) |
| 推理速度 | 快 | 中等 | 快(优化后达Chronos 20倍) |
| 不确定性量化 | 弱 | 中等 | 强(生成式多序列输出) |
| 运维成本 | 高(需持续调参) | 高(需持续训练) | 低(预训练模型即插即用) |
7.2 TimechoAI 模型选型指南
| 通用场景,追求最高精度 | Timer-3.5 | SOTA性能,长上下文,多变量 |
| 生产环境,追求稳定性 | Timer-3.0 | 经典版本,经过充分验证 |
| 简单序列,快速验证 | AutoARIMA | 轻量快速,无需调参 |
| 强季节性数据 | Holt-Winters | 专为季节性设计 |
| 不确定选哪个 | Auto | 平台自动推荐最优模型 |
八、总结与展望

8.1 核心结论
TimechoAI 作为基于 Timer 时序大模型的云服务平台,代表了时序数据分析领域的重要演进方向:
从"造轮子"到"用平台":企业无需自建数据科学团队,即可获得顶尖的时序预测和异常检测能力
从"大数据"到"小样本":借助预训练模型的通用知识,小样本场景也能实现高质量预测
从"离线分析"到"实时智能":结合 TimechoDB 的"DB + AI"架构,实现端到端的实时时序智能
从"单点工具"到"全链路方案":覆盖数据采集、存储、分析、预测、决策的全生命周期
8.2 未来展望
时序大模型的发展仍在快速演进中,我们可以期待以下方向:
-
多模态融合:将时序数据与文本(设备手册、维修记录)、图像(红外热成像、振动频谱图)融合,实现更全面的设备健康评估
-
因果推理:不仅预测"会发生什么",还能解释"为什么会发生",辅助工程师进行根因分析
-
自主决策:从"预测 + 告警"进化到"预测 + 建议 + 自动执行",实现更高程度的智能化运维
-
边缘推理:将轻量化后的时序大模型部署到边缘网关,实现毫秒级本地推理,满足低延迟场景需求