PyTorch强化学习实战(19)——策略梯度法
-
- 0. 前言
- 1. 价值函数与策略
-
- 1.1 探索策略的必要性
- 1.2 策略表示
- 1.3 策略梯度
- 2. REINFORCE 算法
-
- 2.1 算法原理
- 2.2 实现 REINFORCE 算法
- 2.3 运行结果
- 2.4 对比基于策略的方法与基于价值的方法
- 3. REINFORCE方法的局限性
-
- 3.1 必须完整执行整个回合
- 3.2 高梯度方差
- 3.3 探索问题
- 3.4 样本高相关性
- 4. 策略梯度法在 CartPole 上的应用
-
- 4.1 实现
- 4.2 运行结果
- 小结
- 系列链接
0. 前言
在本节中,我们将探讨处理马尔可夫决策过程 (Markov Reward Process, MDP) 问题的另一种方法——策略梯度法。这类方法在某些场景下的表现优于基于价值函数的方法,因此掌握它们至关重要。
1. 价值函数与策略
在介绍策略梯度方法之前,我们首先回顾价值迭代法和Q学习法,价值迭代法和Q学习法的核心分别是状态价值
V
(
s
)
V(s)
V(s) 和状态-动作价值
Q
(
s
,
a
)
Q(s,a)
Q(s,a)。价值定义为从当前状态(或执行特定动作)可获得的折扣总奖励。若已知该数值,每一步决策将变得清晰明了:只需根据价值贪婪得到选择执行动作,即可保证在回合结束时获得可观的总奖励。 因此,状态价值(价值迭代法)或状态-动作价值(Q学习法)成为获取最佳奖励的关键桥梁。为计算这些价值,我们使用了贝尔曼方程,即通过下一步的价值推导当前步价值。 "策略"定义为指导每个状态决策的实体。在Q学习方法中,价值函数通过
π
(
s
)
=
a
r
g
m
a
x
a
Q
(
s
,
a
)
π(s)=\\underset {a}{arg max} Q(s,a)
π(s)=aargmaxQ(s,a) 的形式隐式定义策略,即在每个状态
s
s
s 下的策略
π
π
π 的结果是选择具有最大Q值的动作。 策略可以定义为在每个状态下告诉我们该做什么的实体。正如在Q学习方法中,Q值决定了我们的行为,它们实际上在定义我们的策略。从形式上讲,这可以写为
π
(
s
)
=
a
r
g
m
a
x
a
Q
(
s
,
a
)
π(s) = arg max a Q(s,a)
π(s)=argmaxaQ(s,a),这意味着我们在每个状态
s
s
s 下的策略
π
π
π 的结果是Q值最大的动作。由于策略与价值函数的关联性非常直观,此前我们未将策略作为独立实体强调,而是聚焦于价值函数的推导与逼近方法。在本节中,我们将深入探究这种关联机制及策略本身的特性。
1.1 探索策略的必要性
我们之所以探索策略,主要是由于策略本身就是强化学习问题的终极目标——当智能体获得观测状态并需要决策下一步动作时,它依赖的是策略而非状态或动作的价值函数。我们固然关注总奖励值,但在每个具体状态下,精确的状态价值往往并非决策重点。 假设,我们正在丛林中行走,突然意识到有一只饥饿的老虎藏在草丛中。我们可以选择奔跑、躲藏或投掷背包,但若纠结于"奔跑动作的精确价值是否高于静止不动"则显得荒诞。此时价值函数并非关键,迅速做出决策才是核心。Q学习方法通过逼近状态价值间接解决策略问题,但若我们本就不关注价值本身,就无须多此一举。 策略优先的另一重要场景在于动作空间庞大或连续的情况下。基于
Q
(
s
,
a
)
Q(s,a)
Q(s,a) 选择最优动作需要解决优化问题:寻找使Q值最大化的动作
a
a
a。在 Atari 游戏等离散动作场景中,只需比较有限动作的Q值即可;但当动作是连续值(如方向盘转角或奔跑速度)时,由于Q函数通常由高度非线性的神经网络表示,该优化将变得异常困难。这种情况下,绕过价值函数直接学习策略显然可行性更高。 策略学习的额外优势体现在随机环境中。在 categorical DQN 中,智能体通过处理Q值分布(而非期望均值)能更精准捕捉底层概率分布。策略天然以动作概率形式呈现,这与 categorical DQN 的设计方向不谋而合。
1.2 策略表示
了解了策略的优势后,接下来我们探讨其具体实现。在Q值方法中,我们通过神经网络参数化动作价值并输出标量值。若要使网络参数化动作本身,有多种方案。最简单的实现方式是直接返回动作标识符(适用于离散动作集),但这并非最优解。更常见的解决方案借鉴了分类任务的经典思路——返回动作的概率分布。具体而言:对于 N 个互斥动作,网络输出 N 个数值,分别代表在给定状态(作为网络输入)下选择对应动作的概率。这种表示方式如下图所示:
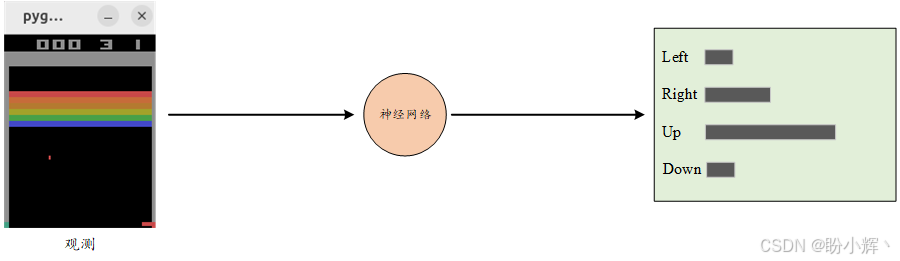
将动作表示为概率的方法还具有一个额外的优势,即平滑的表示:当网络权重发生微小调整时,输出概率分布仅会产生渐进式变化。若直接输出离散动作编号,即便权重细微变化也可能导致动作选择突变。然而,如果我们的输出是概率分布,权重的小幅变化通常只会导致输出分布的微小变化,例如略微增加某个动作相对于其他动作的概率。而概率分布的输出特性与梯度优化法的本质高度契合——通过小幅调整模型参数实现效果提升。
1.3 策略梯度
在确定策略表示方式后,核心问题转变为如何优化网络参数以改进策略。在交叉熵方法中,网络接收观测状态并输出动作概率分布。实际上,交叉熵法可视为策略梯度法的初级形态。接下来,我们从 REINFORCE 算法入手(该方法与交叉熵法仅有细微差别),首先建立相关的数学表述框架。 策略梯度定义为
∇
J
≈
𝔼
[
Q
(
s
,
a
)
∇
l
o
g
π
(
a
∣
s
)
]
∇J ≈ 𝔼[Q(s,a)∇logπ(a|s)]
∇J≈E[Q(s,a)∇logπ(a∣s)]。策略梯度指明了网络参数的优化方向,以提升策略在累积总奖励方面的表现。梯度幅度与动作价值
Q
(
s
,
a
)
Q(s,a)
Q(s,a) 成正比,方向取决于已执行动作的对数概率梯度。这意味着:系统将增强高奖励动作的出现概率,抑制低收益动作的选择倾向。公式中的期望运算符𝔼表示需对环境交互的多步梯度求取平均值。 从实现角度,策略梯度法可通过优化损失函数
L
=
−
Q
(
s
,
a
)
l
o
g
π
(
a
∣
s
)
\\mathcal L = − Q ( s,a )log π ( a | s )
L=−Q(s,a)logπ(a∣s) 实现。负号作用至关重要:由于随机梯度下降 (Stochastic Gradient Descent, SGD) 默认最小化损失函数,而我们需要最大化策略梯度,因此通过负号实现方向转换。
2. REINFORCE 算法
2.1 算法原理
前述策略梯度公式是多数策略基方法的基础,但具体实现存在差异。核心问题在于如何精确计算梯度缩放系数
Q
(
s
,
a
)
Q(s,a)
Q(s,a)。在交叉熵方法中,我们通过运行多个回合 (episode),计算每个回合的总奖励,并选取优于平均表现的回合中的状态转移进行训练——这种训练过程实际上就是一种策略梯度方法:对于优秀回合(高总奖励)中的状态-动作对设置
Q
(
s
,
a
)
=
1
Q(s,a)=1
Q(s,a)=1,较差回合中的状态-动作对则设置
Q
(
s
,
a
)
=
0
Q(s,a)=0
Q(s,a)=0。 尽管交叉熵方法在这种简单假设下也能工作,但显然可以通过使用连续Q值而非 0/1 二元值来改进模型。改进的原因在于:其一,能实现更精细的回合区分。例如总奖励为 10 的回合中的状态转移,其梯度贡献应该大于总奖励仅为 1 的回合。其二,采用
Q
(
s
,
a
)
Q(s,a)
Q(s,a) 动态值可以提升回合初期优质动作的概率,同时降低接近回合末段动作的概率。在交叉熵方法中,我们无差别地对待"精英回合"中的所有动作,并对其动作进行训练,而不管这些动作在回合中的位置,而使用包含折扣因子
γ
γ
γ 的
Q
(
s
,
a
)
Q(s,a)
Q(s,a) 能赋予回合初期优质动作(而不是回合结束时的动作)更高权重,这正是 REINFORCE 方法的核心思想。其步骤如下:
Q
k
,
t
=
∑
0
∞
γ
i
r
i
Q_{k,t}=\\sum_0^{\\infty}\\gamma^ir^i
Qk,t=0∑∞γiri
L
=
−
∑
k
,
t
Q
k
,
t
l
o
g
(
π
(
s
k
,
t
,
a
k
,
t
)
)
\\mathcal L=-\\sum_{k,t}Q_{k,t}log(\\pi(s_{k,t},a_{k,t}))
L=−k,t∑Qk,tlog(π(sk,t,ak,t))
与Q学习相比,该算法有几个重要区别:
- 无需显式探索机制:Q学习需要ε-贪婪策略进行环境探索以避免局部最优,而 REINFORCE 算法通过网络输出的概率分布自动实现探索。初始随机权重会输出均匀概率分布,对应随机智能体行为
- 无需经验回放缓冲区:作为同策略 (on-policy) 方法,策略梯度法不能使用旧策略数据训练。优势是通常收敛更快,劣势是相比深度Q网络 (Deep Q-Network, DQN) 等异策略 (off-policy) 方法需要更多环境交互
- 不需要目标网络:虽然使用Q值,但直接来自环境交互经验。DQN 需要目标网络切断Q值近似关联,而这里不再进行函数近似
2.2 实现 REINFORCE 算法
为了观察该方法的具体应用,我们在 CartPole 环境中实现 REINFORCE 算法 (cartpole_reinforce.py)。
(1) 首先,导入所需库并定义超参数:
GAMMA = 0.99
LEARNING_RATE = 0.01
EPISODES_TO_TRAIN = 4
EPISODES_TO_TRAIN 值指定了用于训练的完整回合数量。
(2) 定义网络结构:
class PGN(nn.Module):
def __init__(self, input_size: int, n_actions: int):
super(PGN, self).__init__()
self.net = nn.Sequential(
nn.Linear(input_size, 128),
nn.ReLU(),
nn.Linear(128, n_actions)
)
def forward(self, x: torch.Tensor) –> torch.Tensor:
return self.net(x)
需要注意的是,尽管我们的网络输出的是概率值,但我们并未对输出结果应用 softmax 非线性变换。这样做的原因是,我们将使用 PyTorch 的 log_softmax 函数一次性计算 softmax 输出的对数值。这种计算方式具有更好的数值稳定性——但需要注意:网络输出的并非概率值,而是原始评分(通常称为 logits)。
(3) 接下来,定义 calc_qvals() 函数:
def calc_qvals(rewards: tt.List[float]) –> tt.List[float]:
res = []
sum_r = 0.0
for r in reversed(rewards):
sum_r *= GAMMA
sum_r += r
res.append(sum_r)
res = list(reversed(res))
mean_q = np.mean(res)
return [q – mean_q for q in res]
该函数接收整个回合的奖励列表,需要为每个时间步计算折扣后的总奖励。为了高效实现这一计算,我们从奖励列表的末端开始逆向计算。实际上,回合最后一个时间步的总奖励就等于其即时奖励。而倒数第二个时间步的总奖励计算公式为
r
t
−
1
+
γ
⋅
r
t
r_{t-1} + γ·r_t
rt−1+γ⋅rt (其中
t
t
t 表示最后一步的索引)。变量 sum_r 存储了后续步骤的累计奖励,因此要计算当前步骤的总奖励,我们需要将 sum_r 乘以折扣因子
γ
γ
γ,再加上该步骤的即时奖励。
(4) 在训练循环之前,实例化环境、神经网络、智能体和优化器:
if __name__ == "__main__":
env = gym.make("CartPole-v1")
writer = SummaryWriter(comment="-cartpole-reinforce-baseline")
net = PGN(env.observation_space.shape[0], env.action_space.n)
print(net)
agent = lib.agent.PolicyAgent(net, preprocessor=lib.agent.float32_preprocessor,
apply_softmax=True)
exp_source = lib.experience.ExperienceSourceFirstLast(env, agent, gamma=GAMMA)
optimizer = optim.Adam(net.parameters(), lr=LEARNING_RATE)
智能体类使用 agent.PolicyAgent,它需要为每个观测状态做出动作决策。由于我们的网络现在返回的是动作概率形式的策略,为了选择要执行的动作,我们需要从网络获取概率分布,然后根据该分布进行随机采样。 当我们使用 DQN 时,网络输出的是Q值,因此如果一个动作的值为 0.4,另一个动作的值为 0.5,那么第二个动作会 100% 被优先选择。而在概率分布的情况下,如果第一个动作的概率为 0.4,第二个为 0.5,我们的智能体应该有 40% 的概率选择第一个动作,50% 的概率选择第二个动作。当然,我们的网络也可以决定 100% 选择第二个动作,在这种情况下,它会返回第一个动作的概率为 0,第二个动作的概率为 1。 理解这个区别很重要,但实现上的变化并不大。我们的 PolicyAgent 内部调用 NumPy 的 random.choice() 函数,并使用网络输出的概率值。apply_softmax 参数指示它先通过调用 softmax 将网络输出转换为概率值。第三个参数 preprocessor 用于解决 Gymnasium 中 CartPole 环境返回 float64 类型观测值(而非 PyTorch 所需的 float32 类型)的问题。
(5) 在开始训练循环之前,定义所需变量:
total_rewards = []
step_idx = 0
done_episodes = 0
batch_episodes = 0
batch_states, batch_actions, batch_qvals = [], [], []
cur_states, cur_actions, cur_rewards = [], [], []
变量 total_rewards 和 done_episodes 用于数据记录,分别存储每个回合的总奖励值和已完成的回合数。随后的几个变量用于收集训练数据:cur_rewards 列表包含当前正在进行回合的即时奖励。当该回合结束时,我们使用 calc_qvals() 函数根据即时奖励计算折扣总奖励,并将其添加到 batch_qvals 列表中。batch_states 和 batch_actions 列表则包含最近训练过程中观测到的状态和动作。
(6) 实现训练循环:
for step_idx, exp in enumerate(exp_source):
cur_states.append(exp.state)
cur_actions.append(int(exp.action))
cur_rewards.append(exp.reward)
if exp.last_state is None:
batch_states.extend(cur_states)
batch_actions.extend(cur_actions)
batch_qvals.extend(calc_qvals(cur_rewards))
cur_states.clear()
cur_actions.clear()
cur_rewards.clear()
batch_episodes += 1
从经验源获取的每个经验条目都包含状态、动作、即时奖励和下一状态。当回合结束时,下一状态会返回 None 值。对于非终止的经验条目,我们只需将状态、动作和即时奖励保存到对应列表中。在回合结束时,我们将即时奖励转换为Q值并递增回合计数器。
(7) 在回合结束时,记录当前训练进度并向 TensorBoard 写入指标:
new_rewards = exp_source.pop_total_rewards()
if new_rewards:
done_episodes += 1
reward = new_rewards[0]
total_rewards.append(reward)
mean_rewards = float(np.mean(total_rewards[–100:]))
print("%d: reward: %6.2f, mean_100: %6.2f, episodes: %d" % (
step_idx, reward, mean_rewards, done_episodes))
writer.add_scalar("reward", reward, step_idx)
writer.add_scalar("reward_100", mean_rewards, step_idx)
writer.add_scalar("episodes", done_episodes, step_idx)
if mean_rewards > 450:
print("Solved in %d steps and %d episodes!" % (step_idx, done_episodes))
break
(8) 当距离上次训练已收集足够多的回合数据后,我们就可以对积累的样本进行优化。首先需要将状态、动作和Q值转换为PyTorch所需的张量格式:
if batch_episodes < EPISODES_TO_TRAIN:
continue
states_v = torch.as_tensor(np.asarray(batch_states))
batch_actions_t = torch.as_tensor(batch_actions)
batch_qvals_v = torch.as_tensor(batch_qvals)
optimizer.zero_grad()
(9) 然后,计算损失:
logits_v = net(states_v)
log_prob_v = F.log_softmax(logits_v, dim=1)
log_prob_actions_v = batch_qvals_v * log_prob_v[range(len(batch_states)), batch_actions_t]
loss_v = –log_prob_actions_v.mean()
loss_v.backward()
optimizer.step()
batch_episodes = 0
batch_states.clear()
batch_actions.clear()
batch_qvals.clear()
writer.close()
此处,我们要求网络将状态转换为 logits (原始输出值),并计算其对数与 softmax 值。第三行代码选取已执行动作对应的对数概率,并使用Q值进行缩放。最后一行对这些缩放后的值求平均并取负,得到需要最小化的损失值。需要强调的是,这个负号至关重要——因为策略梯度需要通过最大化来优化策略,而 PyTorch 的优化器默认最小化损失函数,因此必须对策略梯度取负。 然后,执行反向传播以收集变量梯度,并使用优化器执行 SGD 更新。在训练循环结束时,重置回合计数器并清空列表以准备收集新数据。
2.3 运行结果
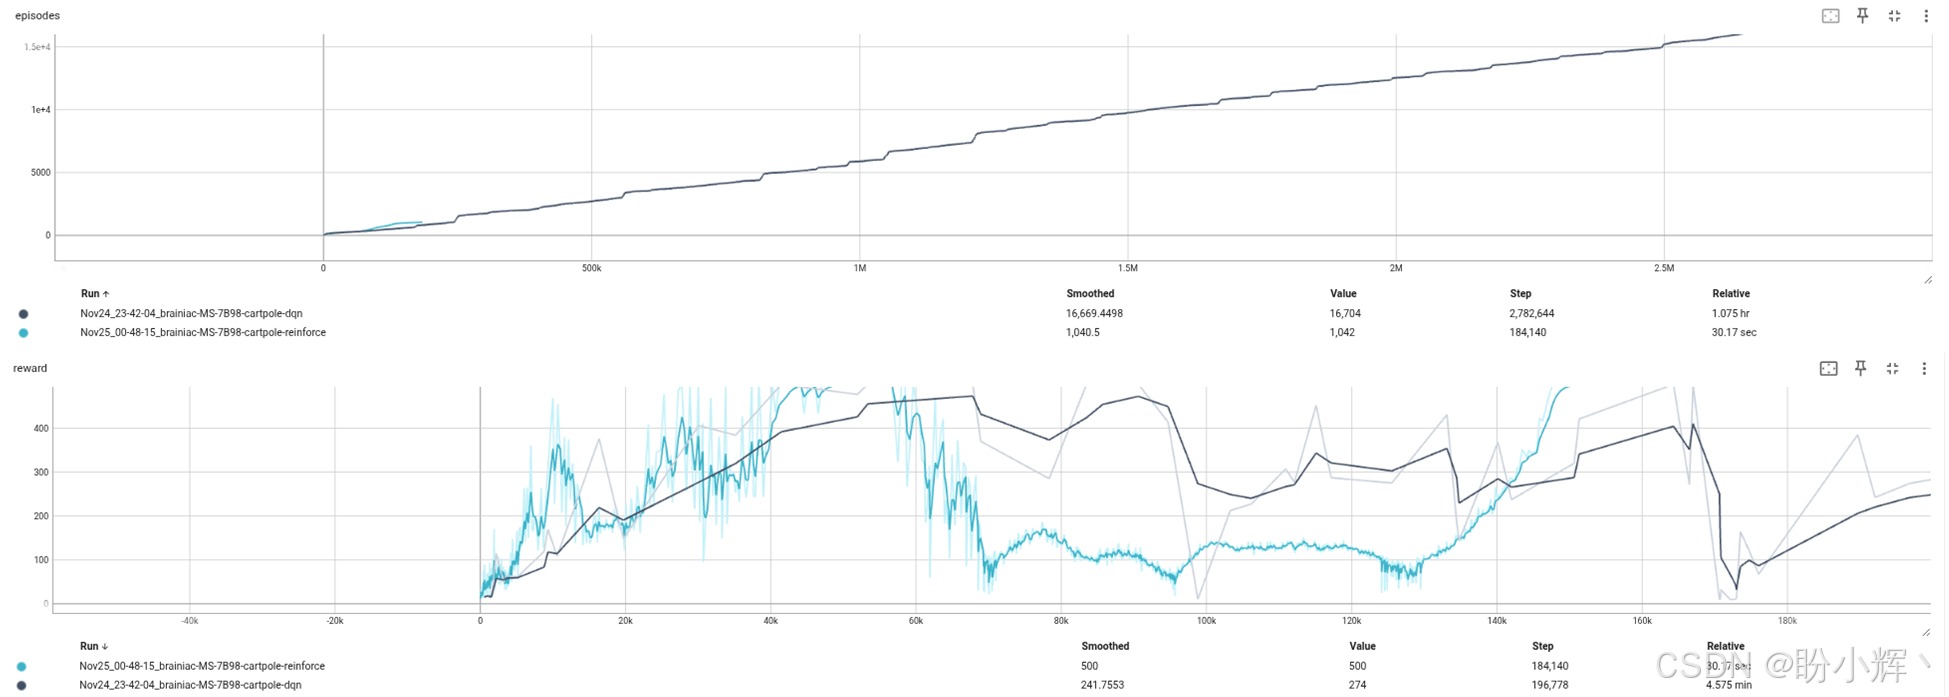
作为对比,在 CartPole 环境中实现了 DQN 算法 (cartpole_dqn.py),并使用几乎与本节所实现的 REINFORCE 相同的超参数。两种方法都能在一分钟内完成收敛:
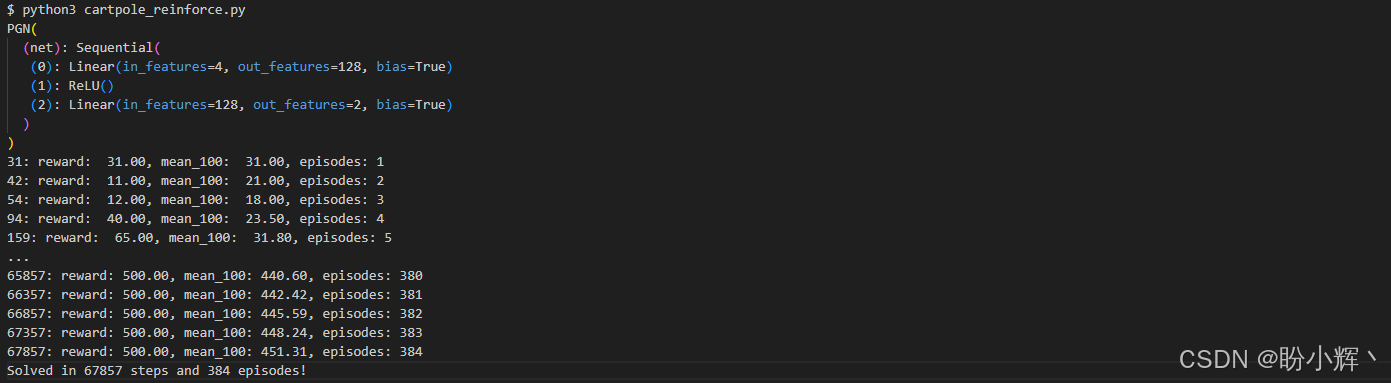
DQN 与 REINFORCE 算法的收敛动态如下图所示,这两张图分别对比了随时间推移和随训练步数增加所完成的回合数量。
下图对比了已运行回合的平滑奖励值:
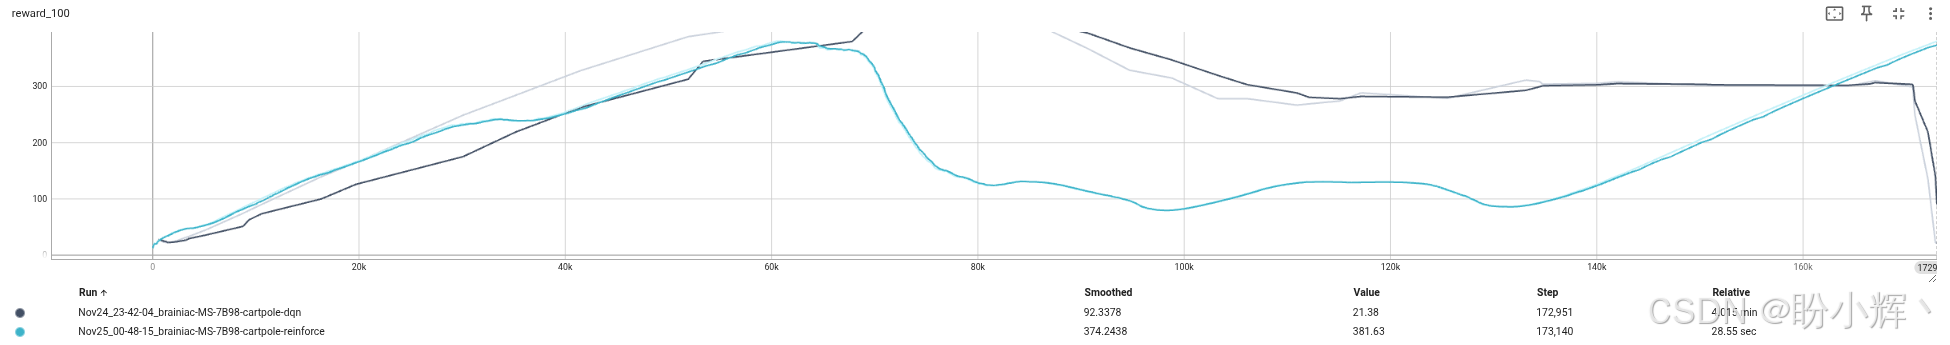
如图所示,两种方法的收敛过程几乎完全一致( REINFORCE 略快一些),但当平均奖励值突破 400 后,DQN 出现了问题并几乎需要重新开始训练。 交叉熵方法解决 CartPole 环境大约需要 40 批次的训练,每批次 16 个回合,共 640 个回合。而 REINFORCE 方法在不到 400 个回合内就完成了相同的任务,这是一个显著的改进。
2.4 对比基于策略的方法与基于价值的方法
基于策略的方法与基于价值的方法之间的区别在于:
- 基于策略的方法直接优化我们关注的目标:行为策略。而基于价值的方法(如 DQN )则通过间接方式实现,先学习价值函数再基于价值推导策略
- 基于策略的方法属于同策略类,需要从环境获取最新样本。基于价值的方法可以利用旧策略数据、人类示范数据等多种来源的历史数据
- 基于策略的方法通常样本效率较低,意味着需要更多环境交互。基于价值的方法则能受益于大型经验回放池。但需注意,样本效率高并不代表计算效率更高,实际情况往往相反
- 在前述示例中,训练期间我们仅需访问神经网络一次来获取动作概率。而 DQN 需要处理两批状态数据:一批用于当前状态,另一批用于贝尔曼更新中的下一状态
由此可见,两类方法并无绝对优劣之分。在某些场景下(如连续控制问题或环境交互成本较低时),基于策略的方法更为自然适用;而在另一些场景中(例如 DQN 在 Atari 游戏上取得优异性能),基于价值的方法更具优势。我们应该同时熟悉这两类方法,并深刻理解各自的优势与局限。 接下来,我们将探讨 REINFORCE 方法的局限性、改进方案,以及如何将策略梯度方法应用于 Pong 游戏。
3. REINFORCE方法的局限性
在前一节中,我们讨论了 REINFORCE 方法,它是交叉熵方法的扩展。但 REINFORCE 和交叉熵方法都存在若干缺陷,使得它们只能用于简单环境。
3.1 必须完整执行整个回合
首先,我们仍然需要等待整个回合结束后才能开始训练。而且,REINFORCE 和交叉熵方法都需要大量回合数据进行训练才能表现良好(因为更多回合意味着更多训练数据,从而带来更精确的策略梯度)。对于 CartPole 这种早期仅能维持 10 余步的短回合环境尚可接受,但在 Pong 游戏中情况截然不同:每个回合可能持续数百甚至数千帧。这不仅会导致训练批次过大影响训练效率,同时从样本效率角度看也存在问题,单次训练步骤就需要大量环境交互。 要求完整回合在本质上是为了获得尽可能精确的Q值估计。在 DQN 方法中我们看到,实践中完全可以使用单步贝尔曼方程
Q
(
s
,
a
)
=
r
a
+
γ
V
(
s
′
)
Q(s,a)=r_a+γV(s′)
Q(s,a)=ra+γV(s′) 的估计值来替代精确折扣奖励值。虽然我们使用自身的Q值估计来估算
V
(
s
)
V(s)
V(s),但策略梯度方法中并不直接使用
V
(
s
)
V(s)
V(s) 或
Q
(
s
,
a
)
Q(s,a)
Q(s,a)。 为了克服这个问题,有两种方法:
- 让网络直接估计
V
(
s
)
V(s)
V(s) 并推导出Q值。这种方法称为"演员-评论家"方法 (actor-critic),它是策略梯度方法中最流行的一种方法 - 采用贝尔曼方程进行 N 步展开,充分利用
γ
<
1
γ<1
γ<1 时价值贡献递减的特性。当γ
=
0.9
γ=0.9
γ=0.9 时,第 10 步的价值系数为0.9
10
≈
0.35
0.9^{10}≈0.35
0.910≈0.35;到第 50 步时系数降至0.9
5
0
≈
0.00515
0.9^50≈0.00515
0.950≈0.00515,对总奖励的贡献微乎其微。即使γ
=
0.99
γ=0.99
γ=0.99,虽然所需步数会增加,但这种展开方式仍然可行。
3.2 高梯度方差
在策略梯度公式
∇
J
≈
𝔼
[
Q
(
s
,
a
)
∇
l
o
g
π
(
a
∣
s
)
]
∇J ≈ 𝔼[Q(s,a)∇logπ(a|s)]
∇J≈E[Q(s,a)∇logπ(a∣s)] 中,梯度大小与给定状态的折扣奖励成正比。但这种奖励的范围高度依赖于具体环境。以 CartPole 环境为例:每保持杆垂直一个时间戳就获得 1 点奖励。若能维持5步,总奖励(未折扣)为 5;若智能体表现优异能维持 100 步,总奖励则达 100。两种场景的数值差异达 20 倍,这意味着失败样本的梯度规模将比成功样本低 20 倍。如此巨大的差异会严重影响训练动态,因为一个幸运的回合可能会在最终的梯度中占主导地位。 用数学术语来说,策略梯度存在高方差问题。在复杂环境中必须对此进行处理,否则训练过程将变得不稳定。常规处理方法是使用基线值 (baseline) 对Q值进行修正,可选基线方案包括:
- 常数值(通常取折扣奖励的均值)
- 折扣奖励的移动平均值
- 状态价值
V
(
s
)
V(s)
V(s)
为展示基线对训练的影响,在 cartpole_reinforce_baseline.py 中实现第二种基线计算方式(奖励均值法)。该方法与前述方法的唯一区别在于 calc_qvals() 函数的具体实现。
3.3 探索问题
即使策略以概率分布形式表示,智能体仍很可能收敛到局部最优策略并停止环境探索。在 DQN 中,我们通过ε-贪婪策略解决该问题:以
ε
ε
ε 概率随机选择动作而非遵循当前策略。虽然同样可采用此方法,但策略梯度法提供了更优路径——熵奖励机制 (entropy bonus)。 信息论中,熵是系统不确定性的度量指标。应用于智能体策略时,熵值反映其对动作选择的不确定程度。用数学符号表示,策略的熵定义为
H
(
π
)
=
−
∑
π
(
a
∣
s
)
l
o
g
π
(
a
∣
s
)
H ( π ) = − ∑ π ( a | s ) log π ( a | s )
H(π)=−∑π(a∣s)logπ(a∣s)。熵值恒为正,当策略呈均匀分布(即所有动作概率相同)时达到最大值;当策略对某个动作赋予概率1而其他动作概率为0时(智能体完全确定行动选择),熵值最小。为防止智能体陷入局部最优,我们从损失函数中减去熵值,对过度确定的策略进行惩罚。
3.4 样本高相关性
单个回合中的训练样本通常存在高度相关性,这对 SGD 训练十分不利。DQN 通过建立 10 万至数百万观测值规模的经验回放池解决该问题。但此方案不适用于策略梯度方法,因为策略梯度方法属于同策略类别。这意味着:使用旧策略生成的样本只能得到旧策略的梯度,而非当前策略梯度。 减少回放缓冲区的大小在某些简单场景可能有效,但总体而言我们需要当前策略生成的新鲜训练数据。真正有效的解决方案是采用并行环境:通过同时与多个环境交互,利用它们产生的状态转移数据作为训练样本。
4. 策略梯度法在 CartPole 上的应用
虽然演员-评论家方法是更稳定的方法,但实现原始策略梯度,能够建立评估策略梯度方法性能的重要概念和指标体系。
4.1 实现
首先在简单的 CartPole 环境中实现策略梯度法 (cartpole_pg.py)。
(1) 定义超参数:
GAMMA = 0.99
LEARNING_RATE = 0.001
ENTROPY_BETA = 0.01
BATCH_SIZE = 8
REWARD_STEPS = 10
ENTROPY_BETA 值表示熵奖励的权重系数,REWARD_STEPS 值指定贝尔曼方程向前展开的步数,用于估算每个状态转移的折扣总奖励。
(2) 网络架构如下所示:
class PGN(nn.Module):
def __init__(self, input_size: int, n_actions: int):
super(PGN, self).__init__()
self.net = nn.Sequential(
nn.Linear(input_size, 128),
nn.ReLU(),
nn.Linear(128, n_actions)
)
def forward(self, x: torch.Tensor) –> torch.Tensor:
return self.net(x)
(3) 使用一个两层网络,隐藏层有 128 个神经元。经验源对贝尔曼方程进行 10 步展开:
exp_source = lib.experience.ExperienceSourceFirstLast(
env, agent, gamma=GAMMA, steps_count=REWARD_STEPS)
(4) 在训练循环中,我们维护每个转移的折扣奖励和,并以此计算策略缩放基线 (baseline):
for step_idx, exp in enumerate(exp_source):
reward_sum += exp.reward
baseline = reward_sum / (step_idx + 1)
writer.add_scalar("baseline", baseline, step_idx)
batch_states.append(exp.state)
batch_actions.append(int(exp.action))
batch_scales.append(exp.reward – baseline)
(5) 在损失计算环节,计算策略损失,即取负后的策略梯度:
optimizer.zero_grad()
logits_t = net(states_t)
log_prob_t = F.log_softmax(logits_t, dim=1)
act_probs_t = log_prob_t[range(BATCH_SIZE), batch_actions_t]
log_prob_actions_t = batch_scale_t * act_probs_t
loss_policy_t = –log_prob_actions_t.mean()
(6) 然后,我们通过计算批次的熵,并将其从损失中减去,从而添加熵奖励项。由于均匀概率分布下熵值最大,而我们需要推动训练向该最大值靠拢,因此应从损失中减去熵值:
prob_t = F.softmax(logits_t, dim=1)
entropy_t = –(prob_t * log_prob_t).sum(dim=1).mean()
entropy_loss_t = –ENTROPY_BETA * entropy_t
loss_t = loss_policy_t + entropy_loss_t
loss_t.backward()
optimizer.step()
(7) 接着我们计算新策略与旧策略之间的 KL 散度 (Kullback-Leibler divergence)。信息论中的 KL 散度用于衡量一个概率分布与另一个预期概率分布的差异程度,在本节中,该指标用于比较模型在优化步骤前后所返回策略的差异:
new_logits_t = net(states_t)
new_prob_t = F.softmax(new_logits_t, dim=1)
kl_div_t = –((new_prob_t / prob_t).log() * prob_t).\\
sum(dim=1).mean()
writer.add_scalar("kl", kl_div_t.item(), step_idx)
KL 散度的急剧飙升通常是不良征兆,这表明我们的策略与先前策略偏离过远——在大多数情况下这都是不可取的(由于神经网络是高维空间中的高度非线性函数,模型权重的如此巨大变化可能会对策略产生非常强烈的影响)。
(8) 最后,我们计算该训练步骤中梯度的统计量。通常最佳实践是展示梯度的最大值和L2范数(即向量长度)的变化曲线,以便了解训练动态:
grad_max = 0.0
grad_means = 0.0
grad_count = 0
for p in net.parameters():
grad_max = max(grad_max, p.grad.abs().max().item())
grad_means += (p.grad ** 2).mean().sqrt().item()
grad_count += 1
(9) 在训练循环结束时,我们将所有需要监控的数值记录到 TensorBoard 中:
writer.add_scalar("baseline", baseline, step_idx)
writer.add_scalar("entropy", entropy, step_idx)
writer.add_scalar("loss_entropy", l_entropy, step_idx)
writer.add_scalar("loss_policy", l_policy, step_idx)
writer.add_scalar("loss_total", l_total, step_idx)
writer.add_scalar("grad_l2", grad_means / grad_count, step_idx)
writer.add_scalar("grad_max", grad_max, step_idx)
writer.add_scalar("batch_scales", bs_smoothed, step_idx)
batch_states.clear()
batch_actions.clear()
batch_scales.clear()
4.2 运行结果
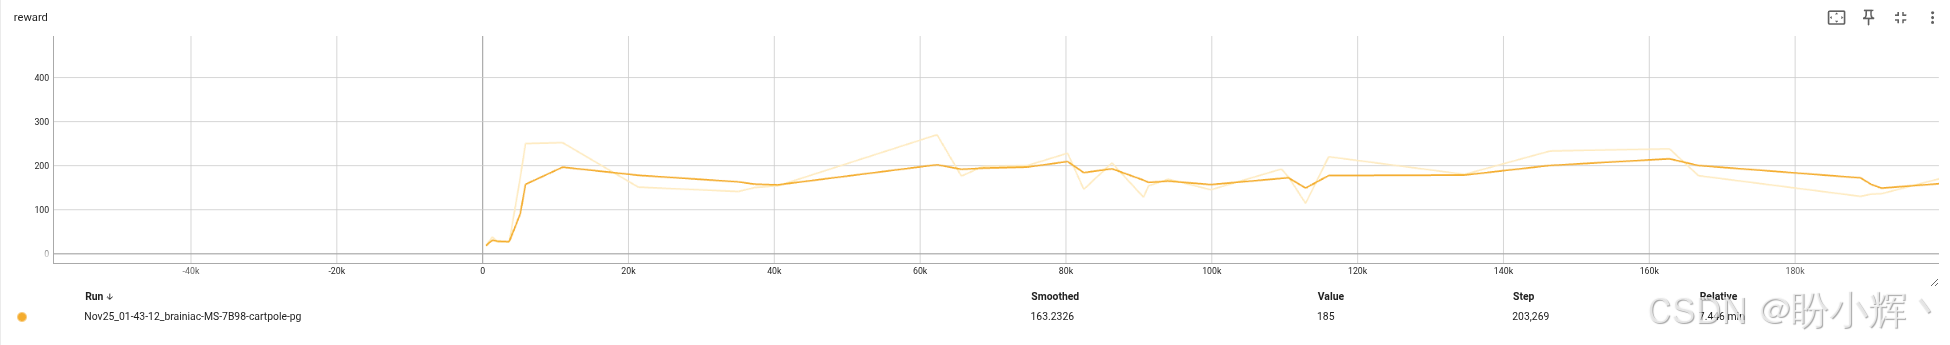
在本节中,我们通过 TensorBoard 绘制图表。首先从奖励值图表开始,如下图所示,其动态变化和性能表现与 REINFORCE 方法差异不大:
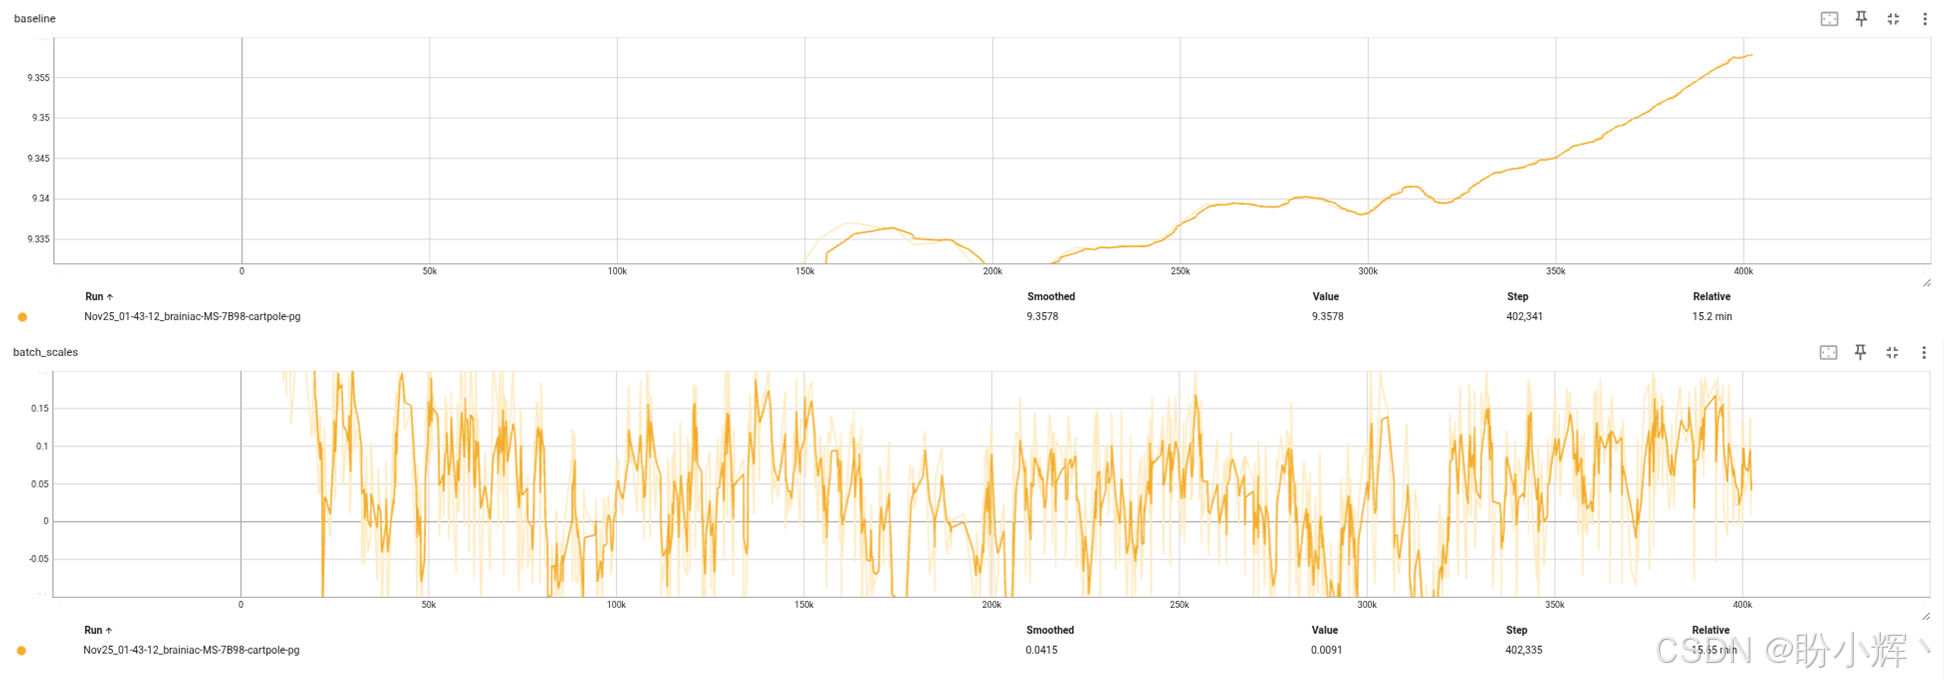
接下来的两个图与基线值和策略梯度规模有关。我们预期基线值会收敛至
1
+
0.99
+
0.99
2
+
.
.
.
+
0.99
9
1+0.99+0.99^2+…+0.99^9
1+0.99+0.992+…+0.999 (约等于 9.56),而策略梯度规模应在零值附近波动。如下图所示:
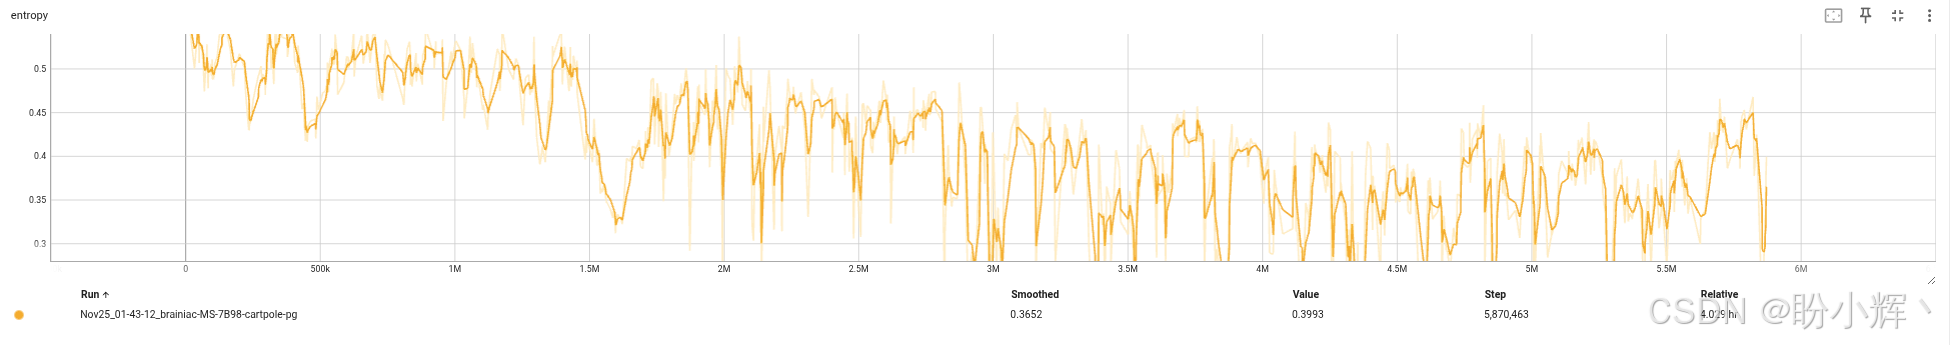
熵值随时间从 0.69 逐渐下降至 0.52。起始值 0.69 对应于具有两个动作的最大熵:
H
(
π
)
=
−
∑
a
π
(
a
∣
s
)
l
o
g
π
(
a
∣
s
)
=
−
(
1
2
l
o
g
(
1
2
)
+
1
2
l
o
g
(
1
2
)
)
≈
0.69
H(\\pi)=-\\sum_a\\pi(a|s)log\\pi(a|s)=-(\\frac 12 log(\\frac 12)+\\frac 12 log(\\frac 12))\\approx 0.69
H(π)=−a∑π(a∣s)logπ(a∣s)=−(21log(21)+21log(21))≈0.69 如下图所示,熵值在训练过程中持续下降,表明我们的策略正从均匀分布转向更具确定性的动作选择:
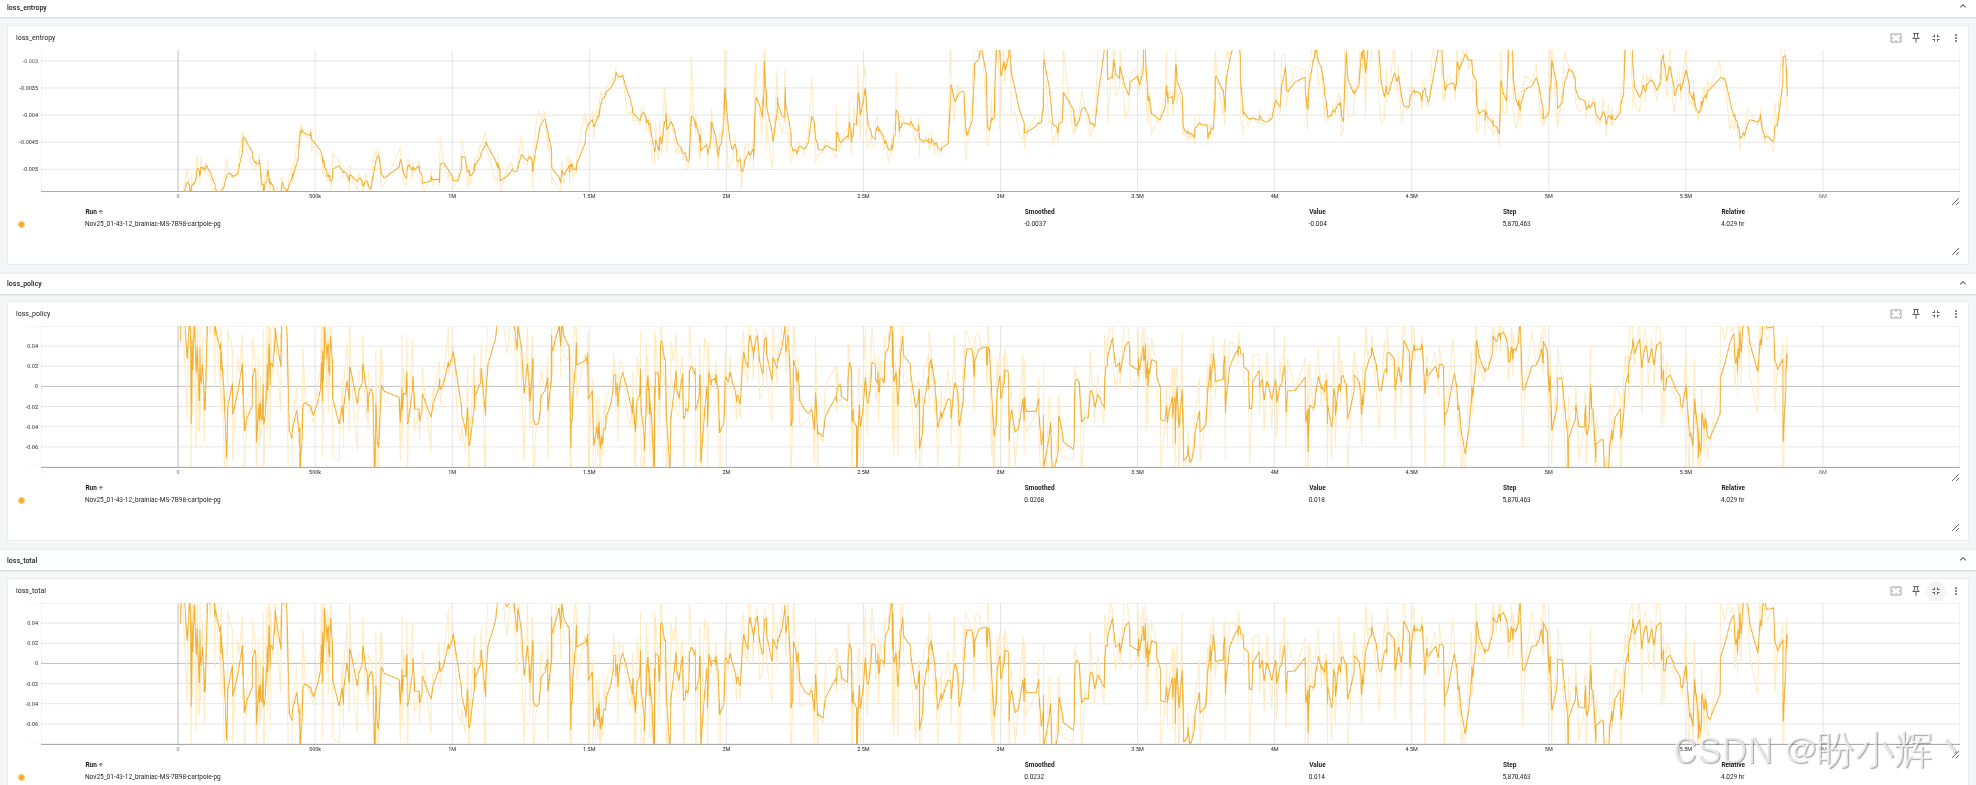
下图与损失有关,包括策略损失、熵损失及其总和。经过缩放的熵损失曲线是前述熵值图的镜像。策略损失显示批次计算所得策略梯度的平均规模与方向。在这里,此处需要关注两者的相对规模,以防止熵损失占据过大主导地位。
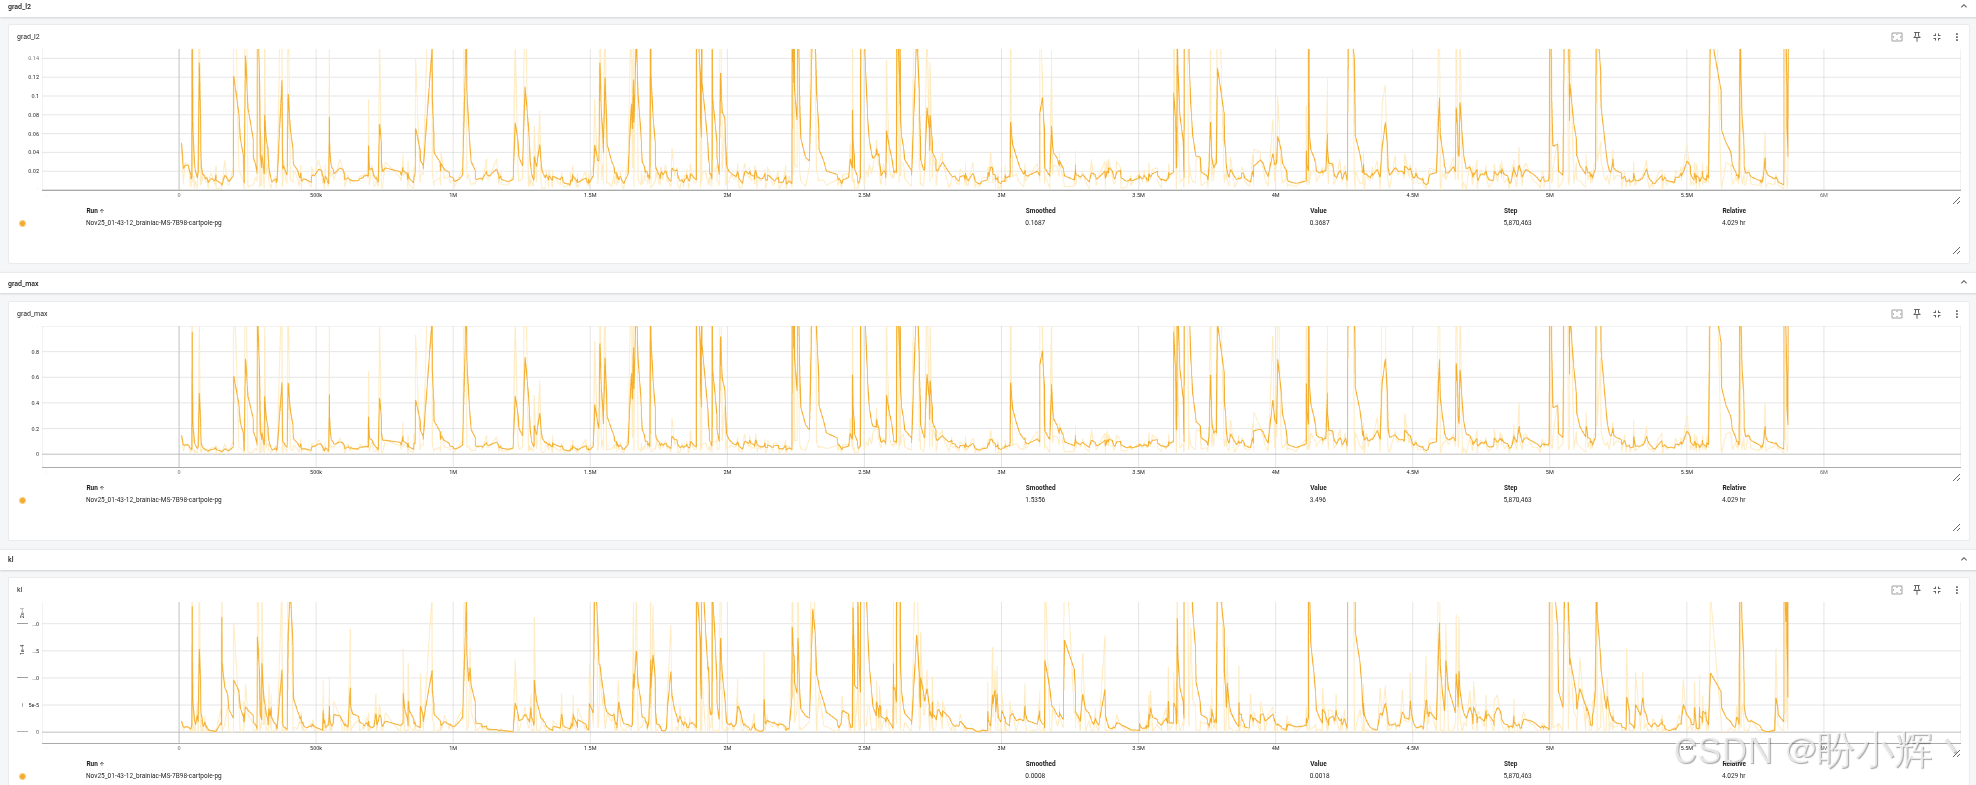
下图显示了梯度的 L2 范数值、L2 最大值以及 KL 散度。在整个训练过程中,梯度表现正常,既不过大也不过小,且未出现剧烈峰值。KL 散度图表也呈现正常状态,虽然存在一些波动峰值,但幅度较小:
小结
在本节中,介绍了另一种解决强化学习问题的方式:策略梯度方法,该方法与 DQN 方法在多方面存在显著差异。与基于价值的方法不同,策略梯度直接优化行为策略,适用于连续动作空间和随机环境。策略通常表示为动作的概率分布,通过最大化策略梯度来更新网络参数。REINFORCE 利用完整回合的折扣奖励计算损失函数,无需显式探索机制或经验回放。然而,该方法存在高梯度方差、需完整回合、样本相关性高等局限。改进方案包括引入基线减少方差、使用熵奖励促进探索、采用多步贝尔曼展开以及并行环境。在 CartPole 环境中的实验表明,REINFORCE 收敛速度优于交叉熵法,且与 DQN 性能相当。
系列链接
PyTorch强化学习实战(1)——强化学习(Reinforcement Learning,RL)详解 PyTorch强化学习实战(2)——强化学习环境库Gymnasium PyTorch强化学习实战(3)——Gymnasium API扩展功能 PyTorch强化学习实战(4)——PyTorch基础 PyTorch强化学习实战(5)——PyTorch Ignite 事件驱动机制与实践 PyTorch强化学习实战(6)——交叉熵方法详解与实现 PyTorch强化学习实战(7)——表格学习与贝尔曼方程 PyTorch强化学习实战(8)——Q学习详解与实现 PyTorch强化学习实战(9)——深度Q学习 PyTorch强化学习实战(10)——强化学习高级组件 PyTorch强化学习实战(11)——N步DQN(N-step DQN) PyTorch强化学习实战(12)——Double DQN(DDQN) PyTorch强化学习实战(13)——噪声网络(NoisyNet-DQN) PyTorch强化学习实战(14)——优先经验回放机制 PyTorch强化学习实战(15)——Dueling DQN PyTorch强化学习实战(16)——Categorical DQN PyTorch强化学习实战(17)——强化学习训练加速 PyTorch强化学习实战(18)——基于DQN处理股票交易问题