Pytorch实现卷积神经网络,实现自己的图像分类模型,图像分类,一篇就够了(适合想做图像分类应用或者入门科研)
- 1、卷积神经网络
-
- 1.1 从全连接网络到卷积神经网络
- 1.2 卷积层的参数
- 1.3 Pytorch实现卷积神经网络
-
- 1.3.1 Conv2d 构造函数
- 1.3.2 常用参数详解
- 1.3.3 输入输出尺寸计算公式
- 1.3.4 代码示例
- 1.3.5 常用变体
- 2 图像分类任务
-
- 2.1 任务定义与数学描述
- 2.2 图像分类的基本原理
- 2.3 损失函数设计
-
- 2.3.1 交叉熵损失
- 2.3.2 为什么选择交叉熵
- 2.3.3 PyTorch 中的实现
- 2.3.4 类别不平衡的处理
- 3 图像分类数据集制作
-
- 3.1 数据集的基本结构及其预处理
- 3.2 数据集的制作全程
- 4 图像分类模型的训练和保存
-
- 4.1 构建一个简单的CNN模型
- 4.2 训练和保存模型
- 4.3 完整代码
- 5 调用训练好的图像分类模型
- 喜欢的话可以给个关注,后续还会继续更新其他内容。
- 这篇文章中,我随意写的模型测试集上的准确率能到72.59,大家可以在这个框架下修改CNN结构,创造更高性能的模型!!!
1、卷积神经网络
卷积神经网络(Convolutional Neural Network,CNN)是一类专门用于处理网格结构数据(如图像)的深度学习模型。与传统的全连接网络不同,CNN 通过卷积层自动提取图像的局部特征,再借助池化层降低特征维度,最后通过全连接层完成分类或回归等任务。这种「局部连接 + 权值共享」的设计大幅减少了参数量,使网络更容易训练,也更具泛化能力。
一个典型的卷积神经网络通常由以下几部分组成:
- 卷积层(Convolutional Layer):使用卷积核在图像上滑动,提取边缘、纹理、形状等局部特征。
- 激活函数(Activation Function):如 ReLU,引入非线性,增强网络的表达能力。
- 池化层(Pooling Layer):对特征图进行下采样,降低计算量并保留主要特征。
- 全连接层(Fully Connected Layer):将提取到的特征映射到最终的分类结果。
下图展示了卷积神经网络处理图像的基本流程:
 区别于之前讲过的全连接网络,卷积神经网络可以理解为就是具有卷积层的全连接网络。得益于卷积运算的特性,卷积神经网络通过卷积层提取输入图像特征,然后再依据特征进行分类输出,CNN 通过层层抽象,从低级的边缘纹理逐步组合出高级的语义信息,这也是它在图像分类、目标检测、语义分割等任务中表现优异的原因。 从上面的图可以看出,卷积神经网络后半部分仍然是一个全连接网络。
1.1 从全连接网络到卷积神经网络
让我们来回顾一下全连接网络的由来。全连接网络接受的输入数据类型是一个向量,通过向量与权重矩阵的乘法
y
=
σ
(
W
X
+
B
)
y=\\sigma(WX+B)
y=σ(WX+B)得到输出,这个过程在拓扑逻辑上实际上就是每一个输入都与所有的神经元相连接,因此得名全连接网络。对于全连接网络不清楚的同学可以去看我之前写的博文:
显然,全连接网络有其不足之处。
-
参数爆炸:每层神经元两两相连,参数随输入维度平方级增长。比如一张256×256的彩色照片,输入就有近20万维,单层参数量轻松破亿。
-
空间结构丢失:处理图像时必须把二维像素阵拉成一维向量,像素间的邻域关系、位置布局全被打乱,相当于把照片剪成纸带。
-
难以平移不变:图像里的猫稍微挪个位置,网络就认不出来了,因为目标位置一变,所有连接关系都跟着变。
-
容易过拟合:参数太多,模型容易把训练数据背下来,却无法泛化到新数据,在小数据集上尤其严重。
-
训练困难:参数多导致计算慢、收敛难,还可能陷入局部极小值。
-
不擅长序列数据:对时间顺序不敏感,无法建模上下文语义,处理文本、语音这类时序数据很吃力。
因此,针对全连接网络的缺点,“不全连接”也就是部分连接网络出现了,最具代表性的就是卷积神经网络。 顾名思义,卷积神经网络就是具有卷积层的网络,卷积层的计算规则是:
y
=
σ
(
X
∗
W
+
B
)
y=\\sigma(X*W+B)
y=σ(X∗W+B) 其中,
∗
*
∗表示卷积运算,
X
,
W
,
B
X,W,B
X,W,B仍然表示输入数据、权重和偏置。这里的权重有个新的名字,叫做卷积核。 卷积的运算过程在这里就不详细描述了,简单说一下。卷积的运算过程示意图如下: 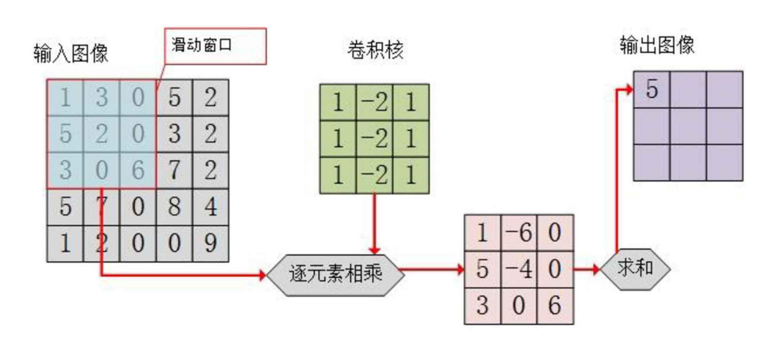 结合上图,卷积的计算过程可以这样理解:
B
B
B,得到该位置的线性输出。
σ
\\sigma
σ(如 ReLU),引入非线性,得到该位置最终的输出值。
简单来说,卷积核就像一台「特征扫描仪」,它每次只看图像的一小块局部区域,通过加权求和的方式提取该区域的局部特征(如边缘、纹理),然后不断滑动扫描整张图像,最终把原始图像转换成一张能突出某种特征的特征图。多个不同的卷积核叠加,就能提取出多种不同的特征,这也是卷积神经网络能够层层抽象、逐步理解图像内容的核心原因。
友情提示,下方内容比较硬核,如果不打算深入研究,那么可以忽略。 实际上,这一节将卷积称为“不全连接”是非常科学,甚至更好理解的——卷积运算实际上是可以等价转换成矩阵乘法的,也就是说,卷积和全连接之间是可以等价转换的。下面给出推理过程。 考虑我们要使用一个2×2大小的卷积核卷积一个3×3的单通道图像,卷积过程可以由下式表示。
[
a
00
a
01
a
02
a
10
a
11
a
12
a
20
a
21
a
22
]
∗
[
w
00
w
01
w
10
w
11
]
=
[
z
00
z
01
z
10
z
11
]
\\begin{bmatrix} a_{00}&a_{01}&a_{02} \\\\ a_{10}&a_{11}&a_{12} \\\\ a_{20}&a_{21}&a_{22} \\end{bmatrix} * \\begin{bmatrix} w_{00}&w_{01} \\\\ w_{10}&w_{11} \\end{bmatrix}= \\begin{bmatrix} z_{00}&z_{01} \\\\ z_{10}&z_{11} \\end{bmatrix}
a00a10a20a01a11a21a02a12a22
∗[w00w10w01w11]=[z00z10z01z11] 按照卷积的规则,我们可以知道:
z
00
=
a
00
⋅
w
00
+
a
01
⋅
w
01
+
a
10
⋅
w
10
+
a
11
⋅
w
11
z
01
=
a
01
⋅
w
00
+
a
02
⋅
w
01
+
a
11
⋅
w
10
+
a
12
⋅
w
11
z
10
=
a
10
⋅
w
00
+
a
11
⋅
w
01
+
a
20
⋅
w
10
+
a
21
⋅
w
11
z
11
=
a
11
⋅
w
00
+
a
12
⋅
w
01
+
a
21
⋅
w
10
+
a
22
⋅
w
11
z_{00}=a_{00}·w_{00}+a_{01}·w_{01}+a_{10}·w_{10}+a_{11}·w_{11}\\\\ z_{01}=a_{01}·w_{00}+a_{02}·w_{01}+a_{11}·w_{10}+a_{12}·w_{11}\\\\ z_{10}=a_{10}·w_{00}+a_{11}·w_{01}+a_{20}·w_{10}+a_{21}·w_{11}\\\\ z_{11}=a_{11}·w_{00}+a_{12}·w_{01}+a_{21}·w_{10}+a_{22}·w_{11}\\\\
z00=a00⋅w00+a01⋅w01+a10⋅w10+a11⋅w11z01=a01⋅w00+a02⋅w01+a11⋅w10+a12⋅w11z10=a10⋅w00+a11⋅w01+a20⋅w10+a21⋅w11z11=a11⋅w00+a12⋅w01+a21⋅w10+a22⋅w11 上述式子,实际上可以拼凑成如下的矩阵乘法:
[
z
00
z
01
z
10
z
11
]
=
[
w
00
w
01
0
w
10
w
11
0
0
0
0
0
w
00
w
01
0
w
10
w
11
0
0
0
0
0
w
00
w
01
0
w
10
w
11
0
0
0
0
0
w
00
w
01
0
w
10
w
11
0
]
⋅
[
a
00
a
01
a
02
a
10
a
11
a
12
a
20
a
21
a
22
]
T
\\begin{bmatrix} z_{00}\\\\z_{01}\\\\z_{10}\\\\z_{11} \\end{bmatrix}= \\begin{bmatrix} w_{00}&w_{01}&0&w_{10}&w_{11}&0&0&0&0\\\\ 0&w_{00}&w_{01}&0&w_{10}&w_{11}&0&0&0\\\\ 0&0&w_{00}&w_{01}&0&w_{10}&w_{11}&0&0\\\\ 0&0&0&w_{00}&w_{01}&0&w_{10}&w_{11}&0 \\end{bmatrix}· \\begin{bmatrix} a_{00}&a_{01}&a_{02}&a_{10}&a_{11}&a_{12}&a_{20}&a_{21}&a_{22} \\end{bmatrix}^T
z00z01z10z11
=
w00000w01w00000w01w000w100w01w00w11w100w010w11w10000w11w10000w110000
⋅[a00a01a02a10a11a12a20a21a22]T 可以看出,卷积运算实际上是稀疏矩阵乘法,因此速度更快。 并且,卷积运算的空间特性使其非常善于处理图像特征。 并且,当卷积核大小等于图像大小的时候,就相当于全连接运算。
1.2 卷积层的参数
卷积层是卷积神经网络的核心组件,其参数决定了特征提取的方式和效果。下面这张图直观展示了卷积层的主要参数:
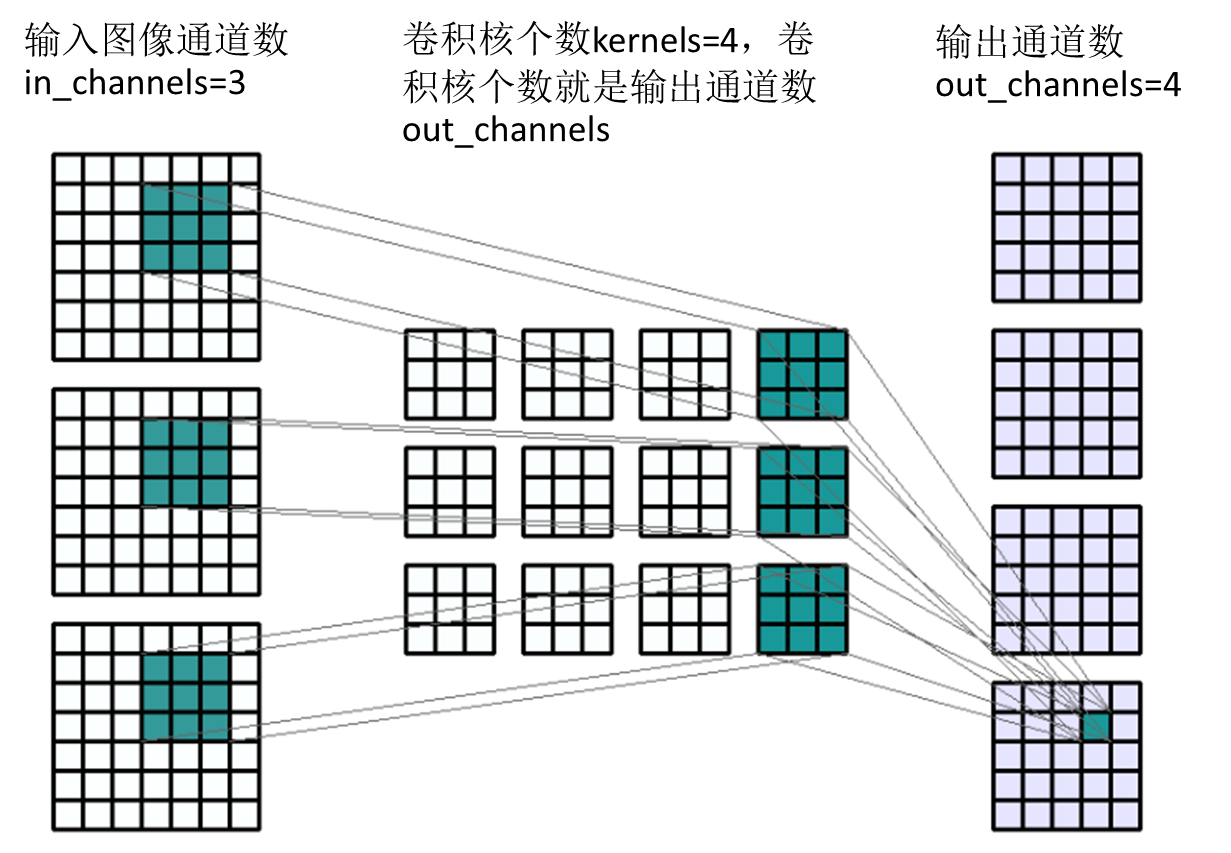
卷积层的参数主要分为两类:可学习参数和超参数。
可学习参数(在训练过程中自动更新):
- 卷积核权重(Weights):每个卷积核是一个小矩阵,如 3×3、5×5,其数值在训练中不断调整,用于提取特定特征,实际上等同于全连接层的权重参数。
- 偏置项(Bias):每个输出通道对应一个偏置标量,用于调整输出的偏移。
超参数(在搭建网络时手动设定):
- 卷积核大小(Kernel Size):决定感受野的大小,常见的有 3×3、5×5、7×7。
- 步长(Stride):卷积核每次滑动的像素数,步长越大,输出特征图越小。
- 填充(Padding):在输入图像边缘补零,用于控制输出尺寸,常见的有 valid(不填充)和 same(保持尺寸不变)。
- 输入通道数(In Channels):输入特征图的通道数,如 RGB 图像为 3。
- 输出通道数(Out Channels):卷积核的数量,决定输出特征图的通道数,也决定了提取特征的种类数。 上图中,卷积运算输入的图像(最左边)是3通道,因此,对应的卷积核(中间)必须是三通道的。图中有4个卷积核,每个卷积核输出一个通道,4个卷积核输出4通道。上图所示的卷积padding=0,也就是没有向图像四周填充0,因此输出的尺寸变小了。 一般而言,卷积输出的尺寸和输入尺寸关系如下:
 在一般卷积中,卷积输出的通道数=卷积核个数。 更加具体的,我们在1.3中通过实验进行探索分析。
1.3 Pytorch实现卷积神经网络
在 PyTorch 中,卷积层主要通过 torch.nn.Conv2d 来实现,它是构建卷积神经网络最核心的模块。下面详细介绍它的 API 用法。
1.3.1 Conv2d 构造函数
Conv2d 的构造函数签名如下:
torch.nn.Conv2d(
in_channels, # 输入特征图的通道数
out_channels, # 输出特征图的通道数(即卷积核的个数)
kernel_size, # 卷积核大小,可以是 int(如 3)或 tuple(如 (3, 5))
stride=1, # 步长,默认 1
padding=0, # 填充,默认 0
dilation=1, # 空洞卷积的膨胀率,默认 1
groups=1, # 分组卷积的组数,默认 1
bias=True, # 是否使用偏置项,默认 True
padding_mode='zeros' # 填充方式,默认补零
)
1.3.2 常用参数详解
- in_channels(输入通道数):输入特征图的通道数。对于 RGB 彩色图像,第一层卷积的 in_channels=3;对于灰度图像则为 1。后续层的 in_channels 必须等于上一层的 out_channels。
- out_channels(输出通道数):卷积核的个数,决定了输出特征图的通道数。每个卷积核负责提取一种特征,因此输出通道数越多,网络能提取的特征种类越丰富。
- kernel_size(卷积核大小):卷积核的尺寸,常见的有 3×3、5×5、7×7。它决定了感受野的大小,即每次卷积操作能「看到」的局部区域范围。
- stride(步长):卷积核每次滑动的像素数。步长越大,输出特征图的尺寸越小,计算量也越小。
- padding(填充):在输入图像四周补零的层数。padding=1 配合 kernel_size=3 可以保持输出尺寸不变,这是 ResNet 等经典网络常用的配置。
- bias(偏置项):是否在卷积结果上加上可学习的偏置。默认 True,通常保持默认即可。
1.3.3 输入输出尺寸计算公式
给定输入尺寸
H
i
n
×
W
i
n
H_{in} \\times W_{in}
Hin×Win,输出特征图的尺寸由下式决定:
H
o
u
t
=
⌊
H
i
n
+
2
×
p
a
d
d
i
n
g
−
d
i
l
a
t
i
o
n
×
(
k
e
r
n
e
l
_
s
i
z
e
−
1
)
−
1
s
t
r
i
d
e
+
1
⌋
H_{out} = \\left\\lfloor \\frac{H_{in} + 2 \\times padding – dilation \\times (kernel\\_size – 1) – 1}{stride} + 1 \\right\\rfloor
Hout=⌊strideHin+2×padding−dilation×(kernel_size−1)−1+1⌋
宽度
W
o
u
t
W_{out}
Wout 的计算方式完全相同。当 dilation=1 时,公式可简化为:
H
o
u
t
=
⌊
H
i
n
+
2
×
p
a
d
d
i
n
g
−
k
e
r
n
e
l
_
s
i
z
e
s
t
r
i
d
e
+
1
⌋
H_{out} = \\left\\lfloor \\frac{H_{in} + 2 \\times padding – kernel\\_size}{stride} + 1 \\right\\rfloor
Hout=⌊strideHin+2×padding−kernel_size+1⌋
1.3.4 代码示例
下面通过一个具体例子演示 Conv2d 的用法,并验证输出尺寸:
import torch
import torch.nn as nn
# 定义一个卷积层:输入 3 通道,输出 16 通道,卷积核 3×3,padding=1
conv = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, stride=1, padding=1)
# 模拟一个输入张量:batch_size=4, 通道数=3, 高=32, 宽=32
x = torch.randn(4, 3, 32, 32)
# 前向传播
y = conv(x)
# 查看输入输出形状
print(f"输入形状:{x.shape}") # torch.Size([4, 3, 32, 32])
print(f"输出形状:{y.shape}") # torch.Size([4, 16, 32, 32])
# 查看卷积核权重和偏置的形状
print(f"卷积核权重形状:{conv.weight.shape}") # torch.Size([16, 3, 3, 3])
print(f"偏置形状:{conv.bias.shape}") # torch.Size([16])
代码说明:
- 卷积核权重形状为 [out_channels, in_channels, kernel_h, kernel_w],即 [16, 3, 3, 3],表示有 16 个 3×3 的卷积核,每个卷积核有 3 个通道。
- 由于设置了 padding=1 且 kernel_size=3,输出尺寸与输入保持一致,均为 32×32。
- 输出通道数为 16,与 out_channels 一致,验证了「输出通道数 = 卷积核个数」的结论。
我们还需要特别注意,这里输入x的shape是[4,3,32,32],分别是[batch,channels,width,height]四个维度。Pytorch中第一个维度恒为batch_size,表示送入神经网络的样本个数。例如此处,相当于向这个卷积层送入了4张图,每张图都是32×32像素的3通道图像。
1.3.5 常用变体
除了 Conv2d,PyTorch 还提供了其他常用卷积模块:
- nn.Conv1d:一维卷积,常用于处理序列数据(如文本、音频)。
- nn.Conv3d:三维卷积,常用于处理视频或医学影像等三维数据。
- nn.ConvTranspose2d:转置卷积(反卷积),常用于上采样,在生成对抗网络(GAN)和语义分割中广泛应用。
- nn.MaxPool2d:最大池化层,对特征图进行下采样,保留局部最大值,降低计算量。
- nn.AvgPool2d:平均池化层,对特征图进行下采样,取局部平均值。
2 图像分类任务
图像分类是计算机视觉中最基础、最核心的任务之一,其目标是根据图像的视觉内容,将其自动划分到预定义的类别中。例如,判断一张图片是猫还是狗、是飞机还是汽车、是良性还是恶性肿瘤等。它是目标检测、图像分割、图像检索等更高级视觉任务的基础。
2.1 任务定义与数学描述
从数学角度看,图像分类可以形式化为一个函数映射问题。给定一张输入图像
X
X
X(通常表示为一个
H
×
W
×
C
H \\times W \\times C
H×W×C 的张量,其中
H
H
H、
W
W
W 为图像的高和宽,
C
C
C 为通道数),我们希望学习一个映射函数
f
f
f,使其输出一个类别标签
y
y
y:
y
=
f
(
X
)
,
y
∈
{
0
,
1
,
2
,
…
,
K
−
1
}
y = f(X), \\quad y \\in \\{0, 1, 2, \\dots, K-1\\}
y=f(X),y∈{0,1,2,…,K−1}
其中
K
K
K 表示类别总数。例如在猫狗分类任务中,
K
=
2
K=2
K=2,
y
=
0
y=0
y=0 表示猫,
y
=
1
y=1
y=1 表示狗。 简单来看,图像分类任务就是给计算机输入一张图片,然后计算机输出这个图像中的物品属于哪个分类。 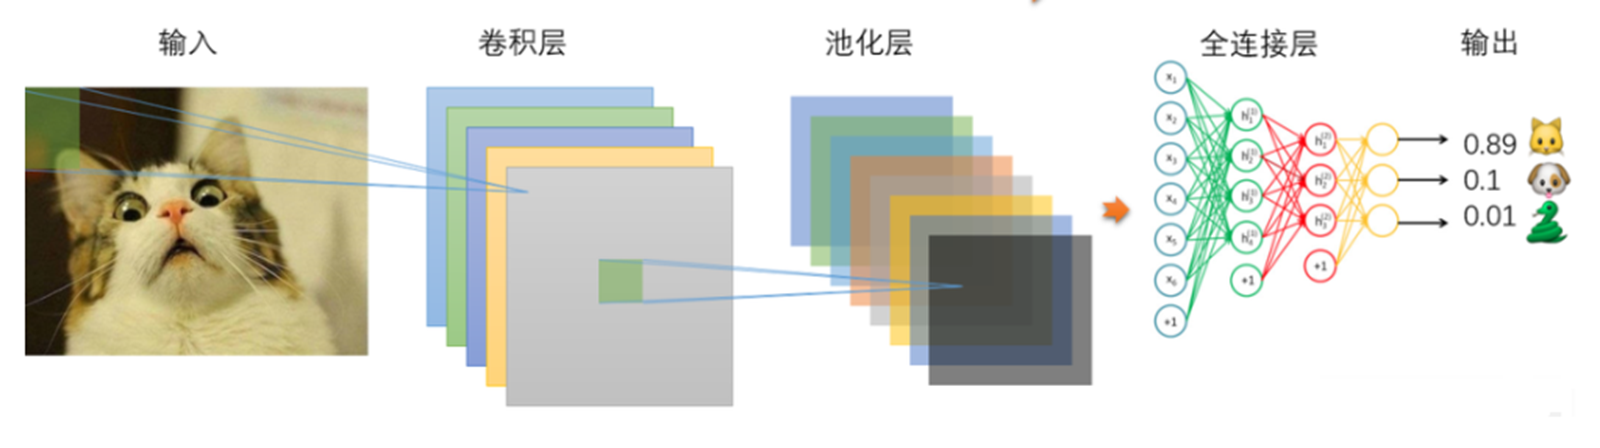 注意,最后分类的输出向量元素个数等于分类数量。 例如,分类数量为3,那么输出向量的元素个数就是3,3个数分别表示属于每一种分类的概率。由于经过softmax函数,因此其概率之和为1。
2.2 图像分类的基本原理
从上面的图我们可以看出,图像分类的核心思想是特征提取 + 分类决策,整个流程可以概括为以下三步:
K
K
K 个类别的得分(Logits),再通过 Softmax 函数将得分转换为概率分布,取概率最大的类别作为预测结果。
下图展示了图像分类的完整流程:
#mermaid-svg-UkUa98Cev8dMuloi{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-UkUa98Cev8dMuloi .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-UkUa98Cev8dMuloi .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-UkUa98Cev8dMuloi .error-icon{fill:#552222;}#mermaid-svg-UkUa98Cev8dMuloi .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-UkUa98Cev8dMuloi .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-UkUa98Cev8dMuloi .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-UkUa98Cev8dMuloi .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-UkUa98Cev8dMuloi .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-UkUa98Cev8dMuloi .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-UkUa98Cev8dMuloi .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-UkUa98Cev8dMuloi .marker{fill:#333333;stroke:#333333;}#mermaid-svg-UkUa98Cev8dMuloi .marker.cross{stroke:#333333;}#mermaid-svg-UkUa98Cev8dMuloi svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-UkUa98Cev8dMuloi p{margin:0;}#mermaid-svg-UkUa98Cev8dMuloi .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-UkUa98Cev8dMuloi .cluster-label text{fill:#333;}#mermaid-svg-UkUa98Cev8dMuloi .cluster-label span{color:#333;}#mermaid-svg-UkUa98Cev8dMuloi .cluster-label span p{background-color:transparent;}#mermaid-svg-UkUa98Cev8dMuloi .label text,#mermaid-svg-UkUa98Cev8dMuloi span{fill:#333;color:#333;}#mermaid-svg-UkUa98Cev8dMuloi .node rect,#mermaid-svg-UkUa98Cev8dMuloi .node circle,#mermaid-svg-UkUa98Cev8dMuloi .node ellipse,#mermaid-svg-UkUa98Cev8dMuloi .node polygon,#mermaid-svg-UkUa98Cev8dMuloi .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-UkUa98Cev8dMuloi .rough-node .label text,#mermaid-svg-UkUa98Cev8dMuloi .node .label text,#mermaid-svg-UkUa98Cev8dMuloi .image-shape .label,#mermaid-svg-UkUa98Cev8dMuloi .icon-shape .label{text-anchor:middle;}#mermaid-svg-UkUa98Cev8dMuloi .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-UkUa98Cev8dMuloi .rough-node .label,#mermaid-svg-UkUa98Cev8dMuloi .node .label,#mermaid-svg-UkUa98Cev8dMuloi .image-shape .label,#mermaid-svg-UkUa98Cev8dMuloi .icon-shape .label{text-align:center;}#mermaid-svg-UkUa98Cev8dMuloi .node.clickable{cursor:pointer;}#mermaid-svg-UkUa98Cev8dMuloi .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-UkUa98Cev8dMuloi .arrowheadPath{fill:#333333;}#mermaid-svg-UkUa98Cev8dMuloi .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-UkUa98Cev8dMuloi .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-UkUa98Cev8dMuloi .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-UkUa98Cev8dMuloi .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-UkUa98Cev8dMuloi .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-UkUa98Cev8dMuloi .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-UkUa98Cev8dMuloi .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-UkUa98Cev8dMuloi .cluster text{fill:#333;}#mermaid-svg-UkUa98Cev8dMuloi .cluster span{color:#333;}#mermaid-svg-UkUa98Cev8dMuloi div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-UkUa98Cev8dMuloi .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-UkUa98Cev8dMuloi rect.text{fill:none;stroke-width:0;}#mermaid-svg-UkUa98Cev8dMuloi .icon-shape,#mermaid-svg-UkUa98Cev8dMuloi .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-UkUa98Cev8dMuloi .icon-shape p,#mermaid-svg-UkUa98Cev8dMuloi .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-UkUa98Cev8dMuloi .icon-shape .label rect,#mermaid-svg-UkUa98Cev8dMuloi .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-UkUa98Cev8dMuloi .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-UkUa98Cev8dMuloi .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-UkUa98Cev8dMuloi :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
输入图像 X
卷积层提取特征
池化层降维
展平特征向量
全连接层映射得分
Softmax 概率分布
输出预测类别 y
2.3 损失函数设计
损失函数(Loss Function)用于衡量模型预测结果与真实标签之间的差异,是训练过程中梯度下降的优化目标。在图像分类任务中,最常用的损失函数是交叉熵损失(Cross-Entropy Loss)。
2.3.1 交叉熵损失
对于单标签多分类任务,交叉熵损失的定义如下:
L
=
−
1
N
∑
i
=
1
N
∑
k
=
1
K
y
i
k
log
(
p
i
k
)
L = -\\frac{1}{N} \\sum_{i=1}^{N} \\sum_{k=1}^{K} y_{ik} \\log(p_{ik})
L=−N1i=1∑Nk=1∑Kyiklog(pik)
其中:
-
N
N
N 为批次中的样本数量; -
K
K
K 为类别总数; -
y
i
k
y_{ik}
yik 为第i
i
i 个样本的真实标签的 one-hot 编码(若真实类别为k
k
k,则y
i
k
=
1
y_{ik}=1
yik=1,否则为 0); -
p
i
k
p_{ik}
pik 为模型预测第i
i
i 个样本属于类别k
k
k 的概率。
由于 one-hot 编码中只有一个位置为 1,上式可以简化为:
L
=
−
1
N
∑
i
=
1
N
log
(
p
i
,
y
i
)
L = -\\frac{1}{N} \\sum_{i=1}^{N} \\log(p_{i, y_i})
L=−N1i=1∑Nlog(pi,yi)
其中
p
i
,
y
i
p_{i, y_i}
pi,yi 表示模型对第
i
i
i 个样本真实类别
y
i
y_i
yi 的预测概率。直观理解就是:模型对正确类别的预测概率越高,损失越小;预测概率越低,损失越大。
2.3.2 为什么选择交叉熵
相比均方误差(MSE)损失,交叉熵在分类任务中有两个显著优势:
- 梯度更合理:交叉熵配合 Softmax 输出,其梯度形式简洁,不会像 MSE 那样在输出饱和区出现梯度消失问题,训练更稳定、收敛更快。
- 概率解释自然:交叉熵直接度量两个概率分布之间的差异,与 Softmax 输出的概率语义天然契合。
2.3.3 PyTorch 中的实现
在 PyTorch 中,nn.CrossEntropyLoss 已经将 Softmax 和交叉熵计算融合在一起,使用时不需要在模型最后一层额外添加 Softmax,直接输入原始得分(Logits)即可:
import torch
import torch.nn as nn
# 模拟一个批次:4 个样本,3 个类别
# logits 形状为 [batch_size, num_classes]
logits = torch.randn(4, 3)
# 真实标签:每个样本的类别索引(0、1 或 2)
labels = torch.tensor([0, 2, 1, 2])
# 定义交叉熵损失
criterion = nn.CrossEntropyLoss()
# 计算损失
loss = criterion(logits, labels)
print(f"交叉熵损失:{loss.item():.4f}")
代码说明:
- nn.CrossEntropyLoss 的输入 logits 是模型最后一层全连接输出的原始得分,形状为 [batch_size, num_classes]。
- labels 是每个样本的真实类别索引,形状为 [batch_size],取值在 [0, num_classes-1] 之间。
- 该损失函数内部会自动对 logits 施加 Softmax,再计算交叉熵,因此模型输出层不需要再手动添加 Softmax。
2.3.4 类别不平衡的处理
当数据集中各类别样本数量差异较大时(如罕见病诊断),直接使用交叉熵会导致模型偏向多数类。常用的解决方案有:
- 类别权重(Class Weight):为少数类分配更高的损失权重,nn.CrossEntropyLoss(weight=…) 支持该参数。
- Focal Loss:在交叉熵基础上引入调制因子,降低易分类样本的权重,使模型更关注难分类的少数类样本。
3 图像分类数据集制作
3.1 数据集的基本结构及其预处理
下面是一段完整的 PyTorch 代码示例,演示如何使用 torchvision.datasets.ImageFolder 加载自定义图像数据集,并配合 transforms.Compose 完成随机裁剪、水平翻转、归一化等预处理操作:
import torch
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
# 1. 定义数据预处理流程
# transforms.Compose 将多个预处理操作按顺序组合成一个整体
transform = transforms.Compose([
# 随机裁剪:将图像随机裁剪为 224×224 大小
# 这不仅能统一输入尺寸,还能起到数据增强的作用,提升模型泛化能力
transforms.RandomResizedCrop(224), #也可以用resize替代
# 随机水平翻转:以 50% 的概率将图像左右翻转
# 适用于大多数自然图像分类任务,可进一步扩充训练样本的多样性,不用可以注释掉
transforms.RandomHorizontalFlip(),
# 转换为张量:将 PIL 图像或 numpy 数组转为 PyTorch 的 Tensor
# 同时会将像素值从 [0, 255] 缩放到 [0.0, 1.0]
transforms.ToTensor(),
# 归一化:使用均值 mean 和标准差 std 对每个通道进行标准化
# 使数据分布接近标准正态分布,有助于模型更快收敛
# 这里的数值是 ImageNet 数据集的统计值,适用于大多数预训练模型,如果不确定是否需要,可以尝试一下不使用归一化的训练效果是否会更好
transforms.Normalize(mean=[0.485, 0.456, 0.406],
std=[0.229, 0.224, 0.225])
])
# 2. 使用 ImageFolder 加载自定义图像数据集
# 要求数据目录结构如下:
# dataset/
# ├── train/
# │ ├── cat/ (类别文件夹,存放猫的图片)
# │ └── dog/ (类别文件夹,存放狗的图片)
# └── val/
# ├── cat/
# └── dog/
# ImageFolder 会自动根据子文件夹名称生成类别标签
train_dataset = datasets.ImageFolder(root='dataset/train', transform=transform)
val_dataset = datasets.ImageFolder(root='dataset/val', transform=transform)
# 3. 创建 DataLoader 数据加载器
# batch_size:每批加载的样本数量
# shuffle:训练集设为 True 打乱顺序,验证集设为 False 保持顺序
# num_workers:使用多进程加载数据,加快数据读取速度
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True, num_workers=4)
val_loader = DataLoader(val_dataset, batch_size=32, shuffle=False, num_workers=4)
# 4. 查看数据集基本信息
print(f"训练集样本数:{len(train_dataset)}")
print(f"验证集样本数:{len(val_dataset)}")
print(f"类别名称:{train_dataset.classes}")
print(f"类别索引映射:{train_dataset.class_to_idx}")
代码说明:
- RandomResizedCrop(224) 会先随机裁剪图像的一部分,再缩放到 224×224,既能统一尺寸又能增强数据。
- RandomHorizontalFlip() 以 50% 概率翻转图像,适合猫狗分类等对称性较强的任务。
- ToTensor() 将图像从 HWC 格式转为 CHW 格式,并把像素值缩放到 [0, 1]。
- Normalize 使用 ImageNet 的均值与标准差做标准化,若使用预训练模型(如 ResNet、VGG)则必须保持一致。
- ImageFolder 要求每个类别的图片放在以类别名命名的子文件夹中,它会自动生成从 0 开始的整数标签。
这里数据集结构的核心原则是:
下面,我们以一个实例讲解如何制作一个自己的图像分类数据集。
3.2 数据集的制作全程
这里,假设我们要制作一个脑肿瘤数据集(这个数据集的图像来自公共数据集,我假装是我自己收集的,毕竟一张张的收集图像太慢了)。按照3.1中的要求,数据集的制作过程如下。
数据集目录构建 脑肿瘤数据集分为四类,分别是glioma_tumor(胶质瘤)、meningioma_tumor(脑膜瘤)、no_tumor(无肿瘤)和pituitary_tumor(垂体瘤)。那么我们可以建立如下目录。 brain_tumor |—-glioma_tumor |—-meningioma_tumor |—-no_tumor |—-pituitary_tumor
收集图像 目录建立好之后,我们可以通过互联网、拍摄等方式获取图像,然后放入对应的文件夹中。
数据集划分 接下来,我们将数据集划分为训练集、验证集和测试集。当然,如果数据集样本数量较少,那么验证集和测试集可以用同一份。 提示:数据集一般按照比例划分,最简单的方式就是手动复制粘贴,专业一点的方式是使用os.listdir操作遍历目录,加上shutil.copy进行复制。 最终数据集目录结构如下:
brain_tumor
|––––train
|––––glioma_tumor
|––––meningioma_tumor
|––––no_tumor
|––––pituitary_tumor
|––––test
|––––glioma_tumor
|––––meningioma_tumor
|––––no_tumor
|––––pituitary_tumor
由于收集到的图像太少,因此验证集和测试集用同一个。
import torch
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
if __name__=="__main__":
# 1. 定义数据预处理流程
# transforms.Compose 将多个预处理操作按顺序组合成一个整体
transform = transforms.Compose([
transforms.Resize((224,224)), # 也可以用resize替代
transforms.ToTensor(),
transforms.Normalize(mean=[0.485, 0.456, 0.406],
std=[0.229, 0.224, 0.225])
])
train_dataset = datasets.ImageFolder(root='brain_tumor/train', transform=transform)
test_dataset = datasets.ImageFolder(root='brain_tumor/test', transform=transform)
# 3. 创建 DataLoader 数据加载器
# batch_size:每批加载的样本数量
# shuffle:训练集设为 True 打乱顺序,验证集设为 False 保持顺序
# num_workers:使用多进程加载数据,加快数据读取速度
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True, num_workers=1)
val_loader = DataLoader(test_dataset, batch_size=32, shuffle=False, num_workers=1)
# 4. 查看数据集基本信息
print(f"训练集样本数:{len(train_dataset)}")
print(f"测试集集样本数:{len(test_dataset)}")
print(f"类别名称:{train_dataset.classes}")
print(f"类别索引映射:{train_dataset.class_to_idx}")
# 5. 从DataLoader中取出一个数据
data_iter = iter(train_loader)
imag, labels = next(data_iter)
print(imag.shape,labels.shape)
4 图像分类模型的训练和保存
4.1 构建一个简单的CNN模型
注意到我们的数据集中每张图片被规定化到224×224大小,因此输入要从这里开始设计。 大家在设计神经网络的时候,建议使用下面这样一张表:
| 1 | 224×224×3 | Conv k3s1@64 | 224×224×64 |
| 2 | – | Conv k3s2@64 | 112×112×64 |
| 3 | – | Conv k3s1@128 | 112×112×128 |
| 4 | – | Conv k3s2@128 | 56×56×128 |
| 5 | – | Conv k3s1@256 | 56×56×256 |
| 6 | – | Conv k3s2@256 | 28×28×256 |
| 7 | – | Conv k3s2@512 | 14×14×512 |
| 8 | – | GAP | 1×1×512 |
| 9 | – | Dense | 256 |
| 10 | – | Dense | 4 |
由于没设计经验,我们直接按照卷积提取特征,然后全连接层分类的思想进行设计。这里的网络卷积层数量、全连接层数量都是我随意写的,只要前层输出与后层输入形状对等就行。 上面的网络结构描述如下:首先通过三组3×3卷积(1-6层)对图像特征进行提取。每组3×3卷积由两个卷积组成,第一个卷积kernel_size=3,stride=1,padding=1,输出通道数是64,其目的是进行特征提取,提升特征图的通道数,并且维持输出尺寸和输入一致(仅改变通道,不改变尺寸);第二个卷积是kernel_size=3,stride=2,padding=0,输出通道数维持和输入一致,其目的是进行降采样(仅改变输出尺寸,不改变通道数)。这种卷积组合是一种比较有效的特征提取手段,即一边提升通道数,一边降低特征图尺寸,以前用的比较多的组合是卷积+池化。第7层目的是再次降低特征图尺寸,然后第8层使用全局平均池化将二维特征图变为一个向量,以便送入后面第9、10层的全连接层。 上面的卷积层参数中,Conv表示卷积,k后面的数字表示卷积核大小(kernel size),s后面的数字表示卷积步幅(stride),@之后的数字表示卷积核的数量,这也决定了卷积的输出通道数。至于Padding参数则没有写出来,通过前后的输出尺寸变化,可以推算出padding的情况。例如上表的第一行,Conv k3s1@64表示卷积核大小为3的卷积,步幅为1,卷积核数量(Pytorch中也称为输出通道数)为64。由于卷积前后输出尺寸没变,因此这的padding=1。 会看上表了之后,我们就能够使用Pytorch将这个网络写出来,代码如下。
class brain_tumor_cnn(Module):
def __init__(self):
super().__init__()
self.conv1=Conv2d(3,32,3,1,padding=1)
self.conv2=Conv2d(32,32,3,2,padding=0)
self.conv3=Conv2d(32,64,3,1,padding=1)
self.conv4=Conv2d(64,64,3,2,padding=0)
self.conv5=Conv2d(64,128,3,1,padding=1)
self.conv6=Conv2d(128,128,3,2,padding=0)
self.conv7 = Conv2d(128, 256, 3, 1, padding=1)
self.conv8 = Conv2d(256, 256, 3, 2, padding=0)
self.conv9 = Conv2d(256, 512, 3, 2, padding=0) #28,28,512
self.avg=AdaptiveAvgPool2d(1)
self.dense1=Linear(512,256)
self.dense2=Linear(256,4) #最终4分类
def forward(self,x):
x = ReLU()(self.conv1(x))
x = ReLU()(self.conv2(x))
x = ReLU()(self.conv3(x))
x = ReLU()(self.conv4(x))
x = ReLU()(self.conv5(x))
x = ReLU()(self.conv6(x))
x = ReLU()(self.conv7(x))
x = ReLU()(self.conv8(x))
x = ReLU()(self.conv9(x))
x=self.avg(x)
x=torch.squeeze(x)
x=ReLU()(self.dense1(x))
out=self.dense2(x) #最后一层不用激活
return out
需要注意的是,在送入全连接前,张量必须变为一维,也就是向量形式,以上面的网络为例,在全局平均池化后,数据维度变为[1,1,512],如果直接送入全连接层,会报错。要把[1,1,512]转换为[512],因此在后面调用了squeeze()方法去除大小为1的维度。 另外,由于最后一层是要送入损失函数的,pytorch的交叉熵损失中包括了将分数转换为概率的softmax激活函数,因此最后一层不需要输出。
4.2 训练和保存模型
数据和模型准备好之后,我们就可以开始训练模型了。 训练模型的逻辑和之前房价预测的例子是一样的:前向传播->计算误差->更新梯度,代码如下。
#损失函数,分类用交叉熵
criterion = CrossEntropyLoss()
optimizer = torch.optim.Adam(cnn.parameters(), lr=0.001)
print("开始训练")
for epoch in range(num_epochs):
cnn.train()
epoch_loss=0
for inputs, labels in train_loader:
inputs, labels = inputs.to(device), labels.to(device)
optimizer.zero_grad()
outputs = cnn(inputs)
loss = criterion(outputs, labels)
loss.backward()
optimizer.step()
print(f'Epoch {epoch + 1}, Loss: {loss.item():.4f}')
如果间隔一定的epoch想要看一下模型的准确率,可以这样写:
if (epoch+1)%eval_period==0:
total=0
correct=0
with torch.no_grad():
for images, labels in val_loader:
images, labels = images.to(device), labels.to(device)
outputs = cnn(images)
_, predicted = torch.max(outputs.data, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print("准确率:"+str(accuracy)+"%")
如果希望在训练过程中,每次验证的时候保存准确率最高的模型,可以这样写:
if best_acc<accuracy:
best_acc=accuracy
torch.save(cnn,"trained_model/epoch"+str(epoch)+"_model_acc_"+str(accuracy))
Pytorch中的模型保存有两种方法:
- 方法一:torch.save(model.state_dict(), PATH) 是推荐做法。
- 方法二:torch.save(model, PATH) 保存整个模型对象。避免使用 torch.save(model, PATH) 保存整个模型对象,因为这会依赖具体的类定义路径,导致在不同项目或重构代码后无法加载。 方法一是简便方法,保存模型的权重,但是如果类名或者项目路径发生变化,容易出错;方法二仅保存了权重,需要模型类实例化之后再调用对象方法加载。
4.3 完整代码
import torch
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
from torch.nn import Module,Conv2d,Flatten,Linear,ReLU,AdaptiveAvgPool2d,CrossEntropyLoss
class brain_tumor_cnn(Module):
def __init__(self):
super().__init__()
self.conv1=Conv2d(3,32,3,1,padding=1)
self.conv2=Conv2d(32,32,3,2,padding=0)
self.conv3=Conv2d(32,64,3,1,padding=1)
self.conv4=Conv2d(64,64,3,2,padding=0)
self.conv5=Conv2d(64,128,3,1,padding=1)
self.conv6=Conv2d(128,128,3,2,padding=0)
self.conv7 = Conv2d(128, 256, 3, 1, padding=1)
self.conv8 = Conv2d(256, 256, 3, 2, padding=0)
self.conv9 = Conv2d(256, 512, 3, 2, padding=0) #28,28,512
self.avg=AdaptiveAvgPool2d(1)
self.dense1=Linear(512,256)
self.dense2=Linear(256,4) #最终4分类
def forward(self,x):
x = ReLU()(self.conv1(x))
x = ReLU()(self.conv2(x))
x = ReLU()(self.conv3(x))
x = ReLU()(self.conv4(x))
x = ReLU()(self.conv5(x))
x = ReLU()(self.conv6(x))
x = ReLU()(self.conv7(x))
x = ReLU()(self.conv8(x))
x = ReLU()(self.conv9(x))
x=self.avg(x)
x=torch.squeeze(x)
x=ReLU()(self.dense1(x))
out=self.dense2(x) #最后一层不用激活
return out
if __name__=="__main__":
# 1. 定义数据预处理流程
# transforms.Compose 将多个预处理操作按顺序组合成一个整体
transform = transforms.Compose([
transforms.Resize((224,224)), # 也可以用resize替代
transforms.ToTensor(),
transforms.Normalize(mean=[0.485, 0.456, 0.406],
std=[0.229, 0.224, 0.225])
])
train_dataset = datasets.ImageFolder(root='brain_tumor/train', transform=transform)
test_dataset = datasets.ImageFolder(root='brain_tumor/test', transform=transform)
# 3. 创建 DataLoader 数据加载器
# batch_size:每批加载的样本数量
# shuffle:训练集设为 True 打乱顺序,验证集设为 False 保持顺序
# num_workers:使用多进程加载数据,加快数据读取速度
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True, num_workers=1)
val_loader = DataLoader(test_dataset, batch_size=32, shuffle=False, num_workers=1)
# 4. 查看数据集基本信息
print(f"训练集样本数:{len(train_dataset)}")
print(f"测试集集样本数:{len(test_dataset)}")
print(f"类别名称:{train_dataset.classes}")
print(f"类别索引映射:{train_dataset.class_to_idx}")
# 5. 从DataLoader中取出一个数据
data_iter = iter(train_loader)
imag, labels = next(data_iter)
print(imag.shape,labels.shape)
#训练的超参数
num_epochs = 100 #总训练轮数
eval_period=10 #验证间隔轮数
best_acc=0.0
#实例化模型
# 有 GPU 就用 GPU,否则用 CPU(最常用写法)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
cnn=brain_tumor_cnn()
cnn.to(device)
#损失函数,分类用交叉熵
criterion = CrossEntropyLoss()
optimizer = torch.optim.Adam(cnn.parameters(), lr=0.001)
print("开始训练")
for epoch in range(num_epochs):
cnn.train()
epoch_loss=0
for inputs, labels in train_loader:
inputs, labels = inputs.to(device), labels.to(device)
optimizer.zero_grad()
outputs = cnn(inputs)
loss = criterion(outputs, labels)
loss.backward()
optimizer.step()
print(f'Epoch {epoch + 1}, Loss: {loss.item():.4f}')
if (epoch+1)%eval_period==0:
total=0
correct=0
with torch.no_grad():
for images, labels in val_loader:
images, labels = images.to(device), labels.to(device)
outputs = cnn(images)
_, predicted = torch.max(outputs.data, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print("准确率:"+str(accuracy)+"%")
if best_acc<accuracy:
best_acc=accuracy
torch.save(cnn,"trained_model/epoch"+str(epoch)+"_model_acc_"+str(accuracy))
5 调用训练好的图像分类模型
import torch
from torchvision import transforms,datasets
from torch.utils.data import DataLoader
from cnn import brain_tumor_cnn
if __name__=="__main__":
model=torch.load("trained_model/epoch69_model_acc_72.58883248730965",weights_only=False)
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model.to(device)
#测试一下准确率
total=0
correct=0
transform = transforms.Compose([
transforms.Resize((224, 224)), # 也可以用resize替代
transforms.ToTensor(),
transforms.Normalize(mean=[0.485, 0.456, 0.406],
std=[0.229, 0.224, 0.225])
])
train_dataset = datasets.ImageFolder(root='brain_tumor/train', transform=transform)
test_dataset = datasets.ImageFolder(root='brain_tumor/test', transform=transform)
# 3. 创建 DataLoader 数据加载器
# batch_size:每批加载的样本数量
# shuffle:训练集设为 True 打乱顺序,验证集设为 False 保持顺序
# num_workers:使用多进程加载数据,加快数据读取速度
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True, num_workers=1)
val_loader = DataLoader(test_dataset, batch_size=32, shuffle=False, num_workers=1)
with torch.no_grad():
for images, labels in val_loader:
images, labels = images.to(device), labels.to(device)
outputs = model(images)
_, predicted = torch.max(outputs.data, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print("准确率:" + str(accuracy) + "%")
需要注意,尽管这里没有使用brain_tumor_cnn类实例化对象,但是仍然需要import。如果使用的是state_dict存储模型,那就不需要了。
import torch
from torchvision import transforms
from PIL import Image
from cnn import brain_tumor_cnn
import os
if __name__=="__main__":
model=torch.load("trained_model/epoch69_model_acc_72.58883248730965",weights_only=False)
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model.to(device)
#测试单张图片
transform = transforms.Compose([
transforms.Resize((224, 224)), # 调整大小
transforms.ToTensor(), # 转换为 Tensor (H,W,C) -> (C,H,W) 且值范围变为 0-1
transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]) # ImageNet 标准归一化
])
image_path=input("请输入图片路径:")
try:
image = Image.open(image_path).convert('RGB') # 确保是 RGB 模式,防止灰度图报错
except Exception as e:
print(f"无法读取图片 {image_path}: {e}")
exit(0)
# 2. 应用预处理
input_tensor = transform(image)
# 3. 增加 Batch 维度
# 模型期望输入形状为 [Batch_Size, Channel, Height, Width]
# 单张图片形状为 [Channel, Height, Width],需用 unsqueeze(0) 变为 [1, C, H, W]
input_batch = input_tensor.unsqueeze(0).to(device)
# 4. 推理 (禁用梯度计算以加速)
with torch.no_grad():
outputs = model(input_batch)
# 获取概率最高的类别索引
_, predicted_idx = torch.max(outputs, 0)
# 获取置信度 (可选)
probabilities = torch.softmax(outputs, dim=–1)
print(probabilities)
confidence = probabilities[predicted_idx.item()].item()
# 5. 输出结果
class_names=["胶质瘤","脑膜瘤","无肿瘤","垂体瘤"]
predicted_class = class_names[predicted_idx.item()]
print(f"图片: {os.path.basename(image_path)}")
print(f"预测类别: {predicted_class}")
print(f"置信度: {confidence:.4f}")