车端AI(三)——嵌入式AI全栈开发(MCU):从需求到代码实现、自动HIL测试
系列导读:本系列聚焦车端AI落地实践。上一篇介绍了AI需求管理。本文(第三篇)将分享一个嵌入式AI全栈开发平台的架构设计与实现思路,探讨如何打通"从需求到硬件验证"的自动化闭环。
目录
- 一、为什么嵌入式开发需要一个"AI全栈"平台?
- 1.1 一个被忽视的真相:嵌入式开发的反馈回路比 Web 长两个数量级
- 1.2 行业级痛点:工具链碎片化——"万能插座"缺失
- 1.3 团队级痛点:知识碎片化——“新人的两周沉默期”
- 1.4 个人级痛点:验证黑洞——“改完代码后的 20 分钟真空”
- 1.5 所以,需要什么样的平台?
- 二、Lattice架构总览
- 2.1 一句话定位
- 2.2 OmniPort——多传输层混合架构
- 三、DriverRegistry——嵌入式驱动的"万能插座"
- 3.1 设计思想
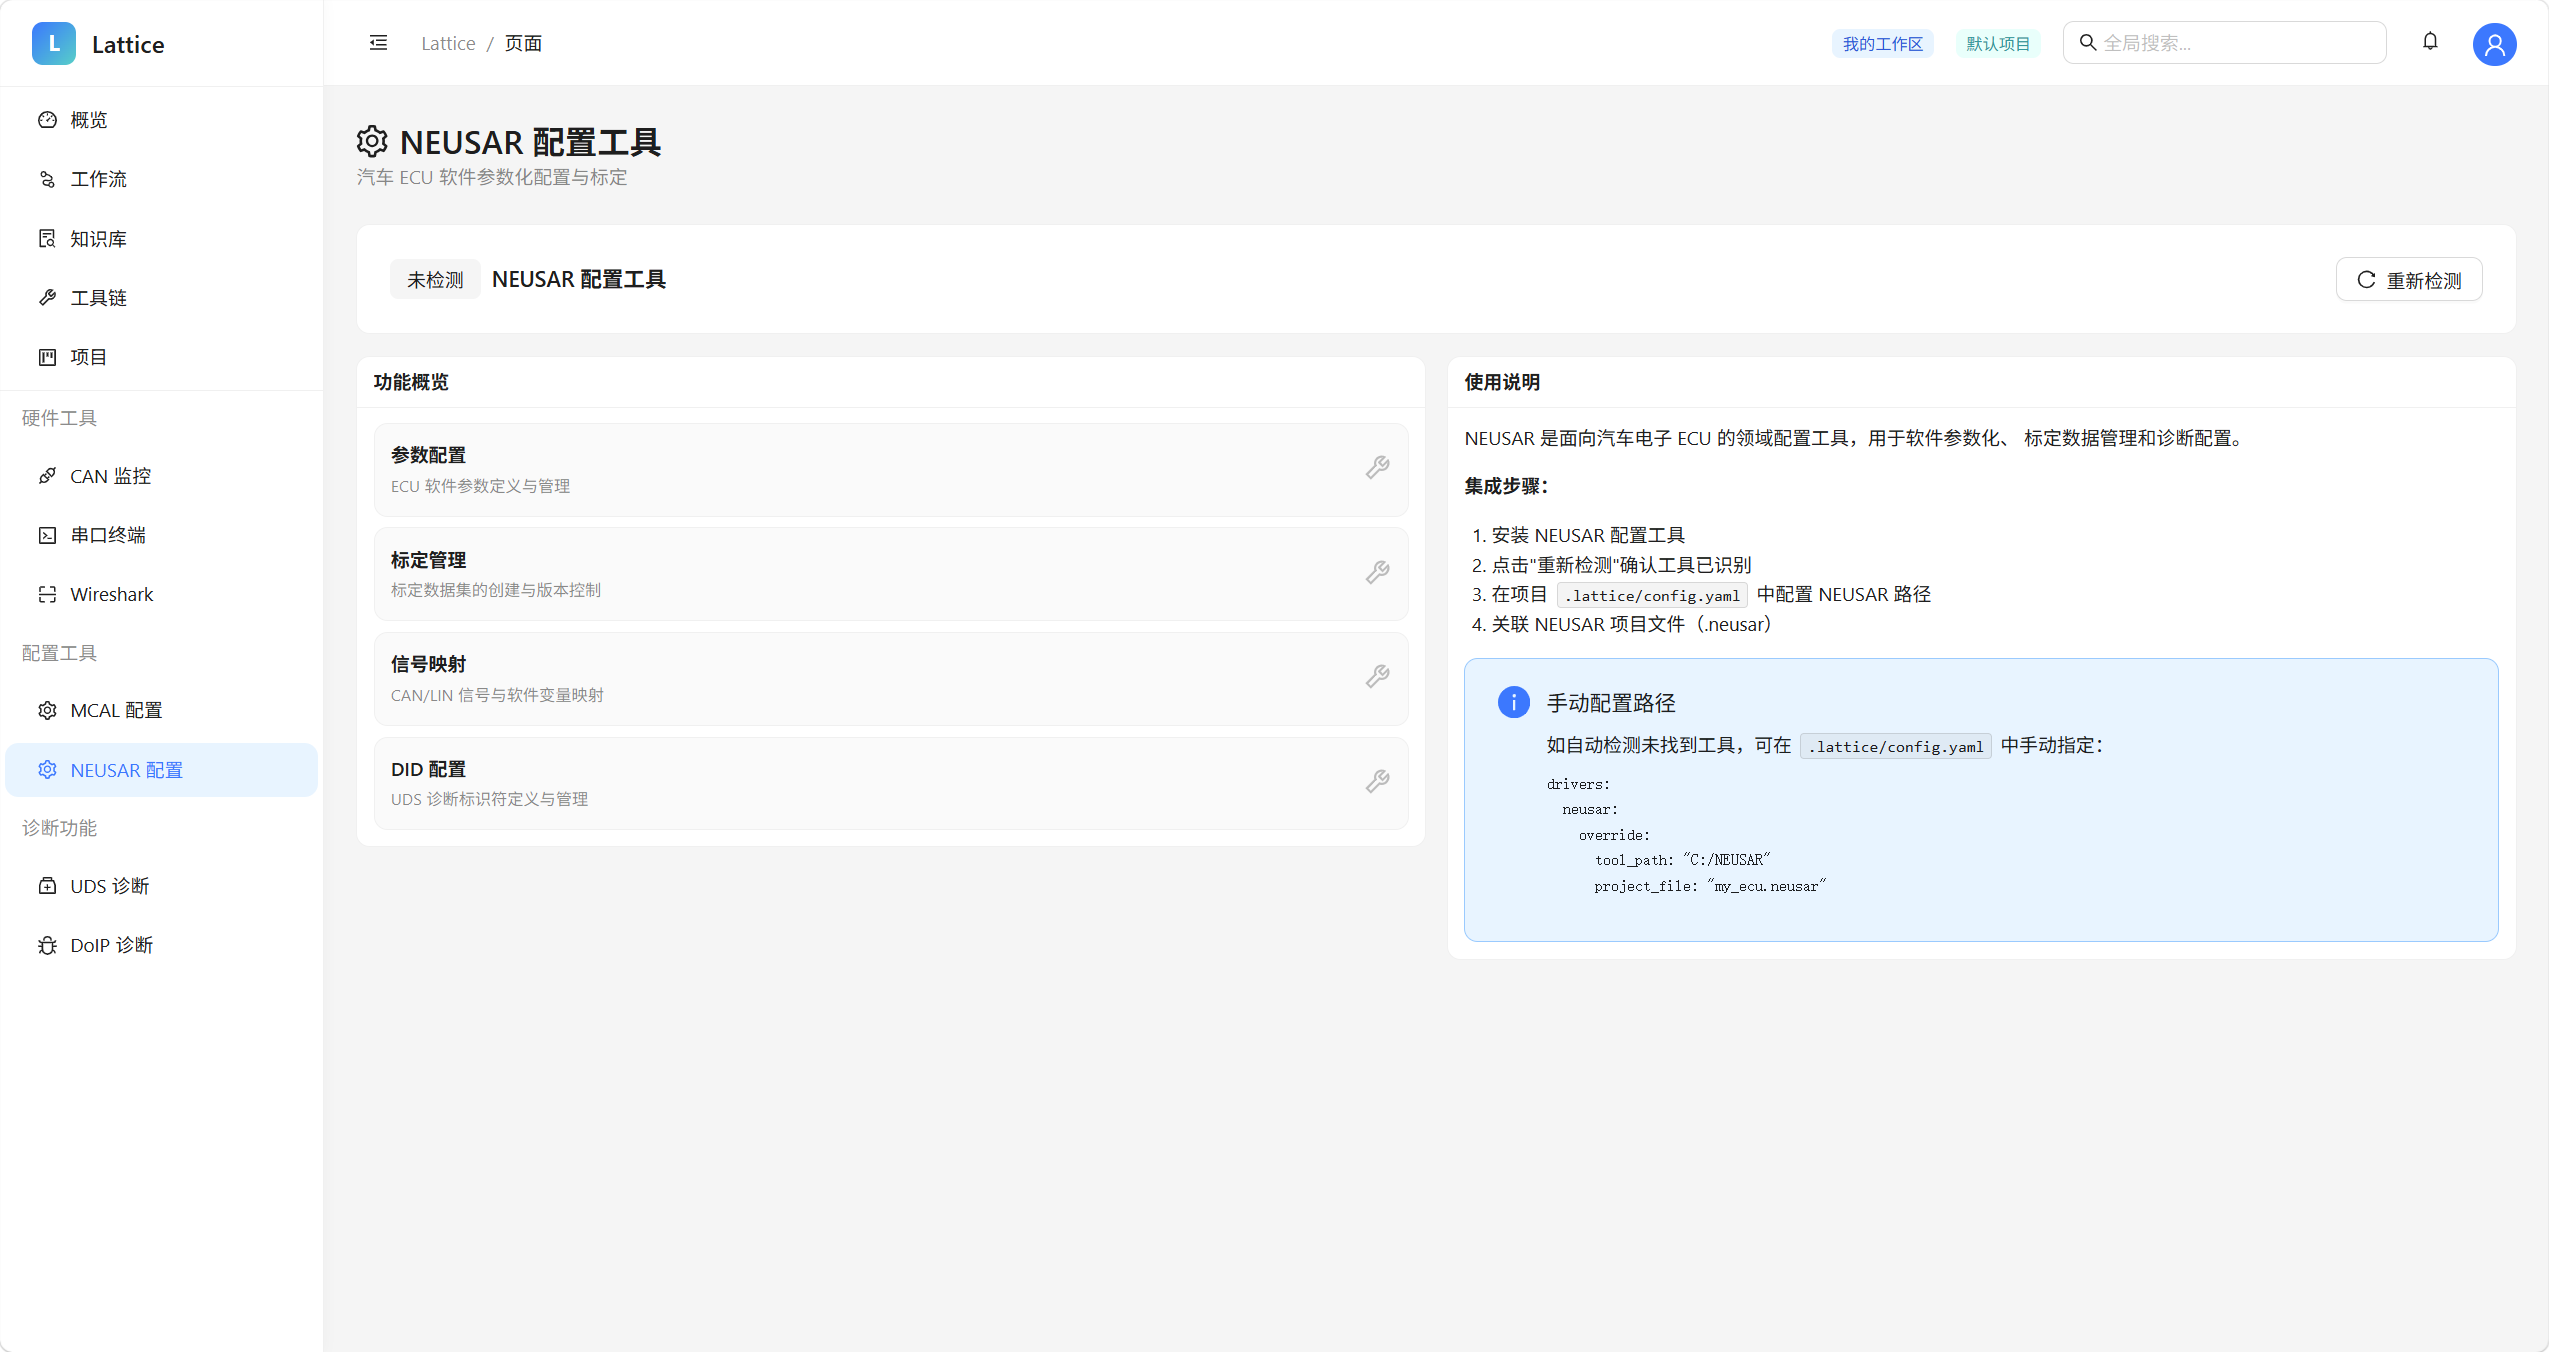
- 3.2 当前注册的9大驱动
- 3.3 自动发现 + 手动覆盖
- 四、AI工作流引擎——从需求到代码的7阶段
- 4.1 工作流7阶段
- 4.2 五种预设工作流
- 4.3 关键技术实现
- 五、AI Coding——从自然语言到精确代码变更
- 5.1 不是"生成整个文件",而是"精确补丁"
- 5.2 安全应用机制
- 5.3 RAG注入项目上下文
- 5.4 Demo模式——离线也能用
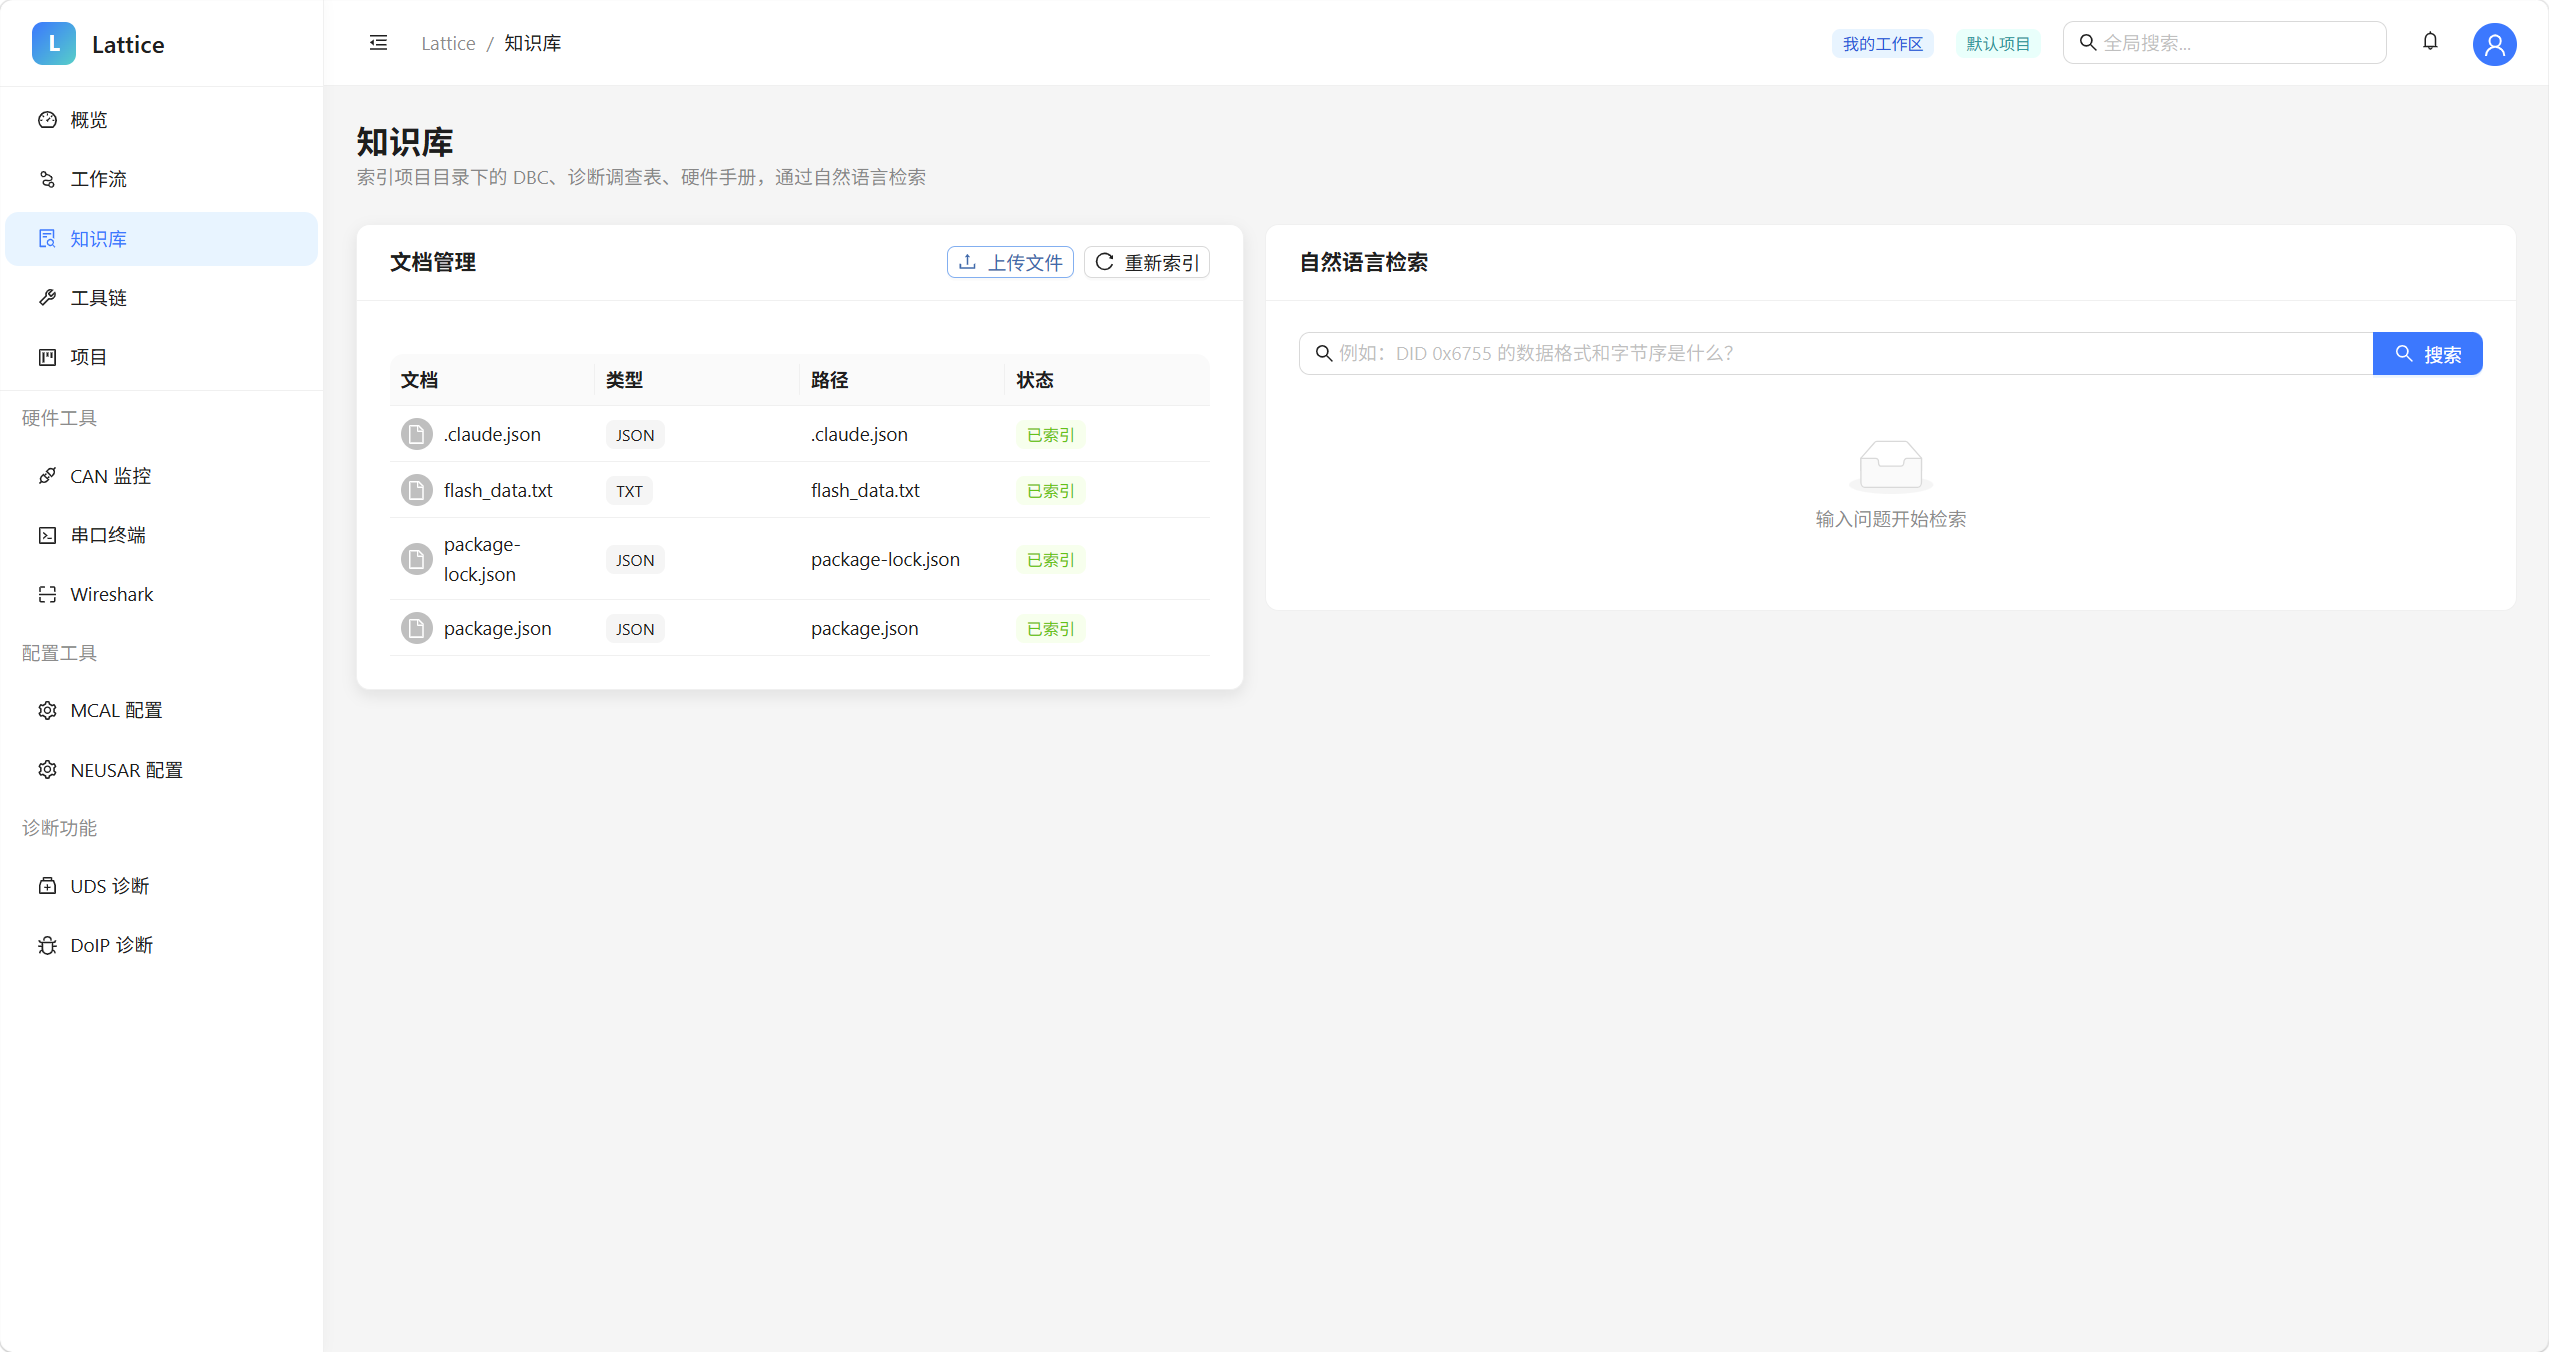
- 六、RAG知识库——让AI"读懂"你的项目
- 6.1 问题
- 6.2 ChromaDB向量检索
- 6.3 检索增强规划
- 七、自动化HIL测试——从LLM测试用例到YAML执行
- 7.1 测试框架设计原则
- 7.2 LLM生成测试用例
- 7.3 自动转换为YAML测试套件
- 7.4 Verify阶段——双重测试策略
- 八、过程文档——全链路自动记录与追溯
- 8.1 实时日志——每一步都有据可查
- 8.2 计划快照——LLM输出完整保留
- 8.3 通知系统——状态变更实时推送
- 8.4 归档系统——运行数据持久化到磁盘
- 九、版本控制——Git集成与变更追溯
- 9.1 .lattice目录结构——版本控制友好设计
- 9.2 工作流与Git的集成架构
- 9.3 自动提交策略
- 9.4 变更追溯——从需求到代码到测试的完整链路
- 十、工具链管理——内置+自定义合并展示
- 10.1 自动检测
- 10.2 自定义工具扩展
- 10.3 合并展示
- 十一、技术栈一览
- 十二、两个完整场景:从需求到验证
- 场景A:信号处理Bug修复
- 场景B:新功能全流程开发
- 十三、设计亮点与工程反思
- 13.1 "平台能力 vs 项目产物"的边界
- 13.2 LLM同时生成代码和测试
- 13.3 “精确补丁"优于"整文件重写”
- 十四、总结
车端AI(三)——嵌入式AI全栈开发(MCU):从需求到代码实现、自动HIL测试
系列导读:本系列聚焦车端AI落地实践。第一篇探讨了车端AI的技术选型与挑战,第二篇介绍了AI辅助诊断协议设计。本文(第三篇)将完整呈现一个真实的嵌入式AI全栈开发平台——Lattice,从架构设计到代码实现,再到自动化HIL测试,带你走进"AI写MCU代码、AI做硬件测试"的工程实践。
一、为什么嵌入式开发需要一个"AI全栈"平台?
1.1 一个被忽视的真相:嵌入式开发的反馈回路比 Web 长两个数量级
如果你来自 Web 或移动端开发背景,你的日常工作流大概是这样的:
改代码 → 保存 → 热更新/自动重载 → 浏览器秒级呈现 → 断点调试 → 修复
整个反馈回路以秒为单位。即使出 bug,改完立刻能看到结果。
但在嵌入式 MCU 开发中,同样的"改一行代码"过程是这样的:
改代码 → 交叉编译(5~15min) → 连接调试器烧录(2~5min) → 硬件上电初始化 →
总线通信验证 → 发现异常 → 回去改 → 再来一遍
整个反馈回路以十分钟为单位,而且每一步都可能因为硬件连接、总线状态、工具配置等因素引入非代码层面的干扰。
更关键的是:Web 开发者的验证环境就是自己的电脑,而嵌入式开发者的验证环境是一块必须物理连接的硬件板卡。 这意味着你不能并行跑十个验证任务,也不能在 CI 里轻松地 spin up 一个"硬件容器"。
这不是体验问题,是结构性差异。
1.2 行业级痛点:工具链碎片化——"万能插座"缺失
嵌入式开发的工具链天然是碎片化的。一次完整的需求交付,至少要跨越以下领域:
| 编译 | 专用交叉编译器 | CLI / GUI |
| 烧录 | 硬件调试器 | CLI / GUI |
| 总线通信 | CAN/LIN 分析工具 | GUI / COM 接口 |
| 诊断验证 | UDS 诊断工具 | GUI |
| 串口监控 | 串口助手 | GUI |
| 配置管理 | AUTOSAR 配置工具 | GUI |
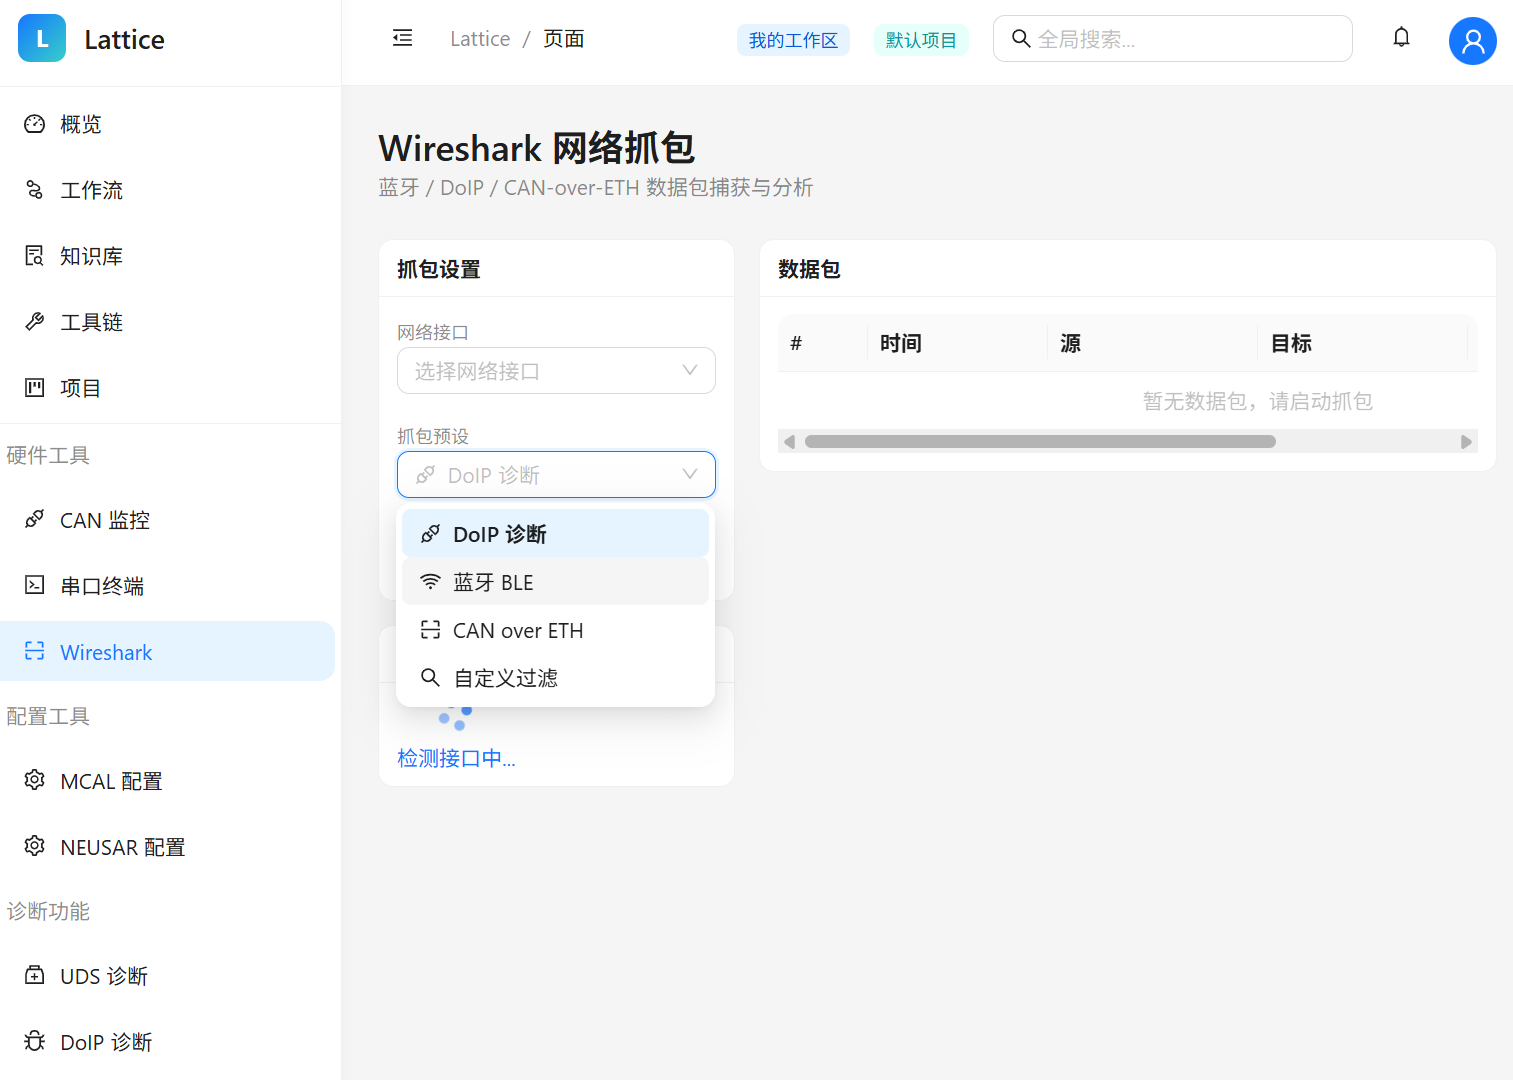
| 抓包分析 | 网络协议分析器 | CLI / GUI |
这些工具没有统一的调用接口。每个工具有自己的安装路径、命令行参数、输出格式、错误编码。开发者不得不在五六个窗口之间反复切换,手动搬运信息:从编译器抄错误行号到 IDE,从诊断工具读数据到 Excel,从总线工具截信号到测试报告……
在 Web 开发中,这个问题已经被 DevOps 工具链解决:CI/CD Pipeline 把编译、测试、部署串联成一条自动化流水线。但在嵌入式领域,"编译→烧录→硬件验证"这条流水线至今是断的——因为没人愿意为烧录器和示波器写 Jenkins Plugin。
关键判断:嵌入式 AI 工具化的第一步不是"让 AI 写更好的代码",而是"让 AI 能调用这些碎片化的工具"。需要一个统一的驱动抽象层,把编译器、调试器、总线接口、诊断协议全部封装为标准化的可调用方法。
1.3 团队级痛点:知识碎片化——“新人的两周沉默期”
嵌入式项目的知识分散在令人绝望的角落里:
- 信号定义藏在二进制格式的数据库文件里
- 诊断规范躺在 Excel 调查表和 PDF 技术文档中
- 硬件参数散落在引脚配置表、数据手册的某个章节
- 变更历史存在于老工程师的脑子里和邮件线程中
Web 开发者遇到问题可以 Stack Overflow,可以读代码注释,可以跑单元测试。但嵌入式开发者遇到"这个诊断数据标识符的含义是什么"时,需要去翻一个可能已经过期的 Excel 文件——如果还能找到的话。
这直接导致了一个团队级的灾难性后果:新成员的上手周期长达 2-4 周。不是因为他们不会写 C 代码,而是因为他们不知道去哪里找该改哪个文件、信号定义是什么、总线报文格式怎么解析。
而且,这种知识从未被结构化沉淀。工程师离职后,知识随之消失。
关键判断:嵌入式 AI 工具化的前提是"让 AI 能读懂项目上下文"。不是通用知识,而是你的项目的具体知识——哪个信号在哪个报文里、哪个诊断参数的合法范围是什么、上次改了什么。这就需要 RAG(检索增强生成)来让 AI 理解项目私有知识。
1.4 个人级痛点:验证黑洞——“改完代码后的 20 分钟真空”
回到个人开发者的日常体验。一个典型的修改-验证循环是这样的:
这个循环每天重复 5-10 次。
核心矛盾是:AI 可以帮你写代码,但谁来帮你编译、烧录、接硬件、跑测试?
GitHub Copilot 可以在你写完代码的瞬间给出下一行建议,但它不知道你的编译器装在哪里,不会帮你启动烧录流程,更不会帮你读一个诊断数据标识符来验证改动是否生效。它只覆盖了"编码"这一个环节,而嵌入式开发最耗时的恰恰是编码之后的验证环节。
Cursor 的 Agent 模式可以自动执行终端命令和文件操作,但它不理解嵌入式硬件的通信协议,无法发送诊断请求,无法解析总线信号,更无法判断一个返回值是否在规格书定义的合法范围内。
通用 AI 工具在嵌入式场景的"够不着",不是能力问题,是架构问题——它们缺少三个关键能力:
| 领域知识注入 | 不知道你的信号定义、诊断参数、硬件规格,生成的代码无法精确到项目级 |
| 工具链执行 | 无法调用编译器、烧录器、总线接口,停留在"文字输出"层面 |
| 硬件验证闭环 | 无法自动执行"编译→烧录→发送诊断请求→校验返回值"的验证链路 |
这三个缺失恰好构成了一条从"理解"到"执行"到"验证"的完整能力缺口。
1.5 所以,需要什么样的平台?
如果把上面的三层痛点反过来,就得到了嵌入式 AI 全栈平台的核心需求定义:
行业痛点:工具链碎片化 → 需要:统一的驱动抽象层,让所有工具可编程调用
团队痛点:知识碎片化 → 需要:RAG 知识库,让 AI 理解项目私有上下文
个人痛点:验证黑洞 → 需要:端到端工作流引擎,从需求到硬件验证自动化闭环
通用AI缺口:执行+验证 → 需要:AI 不仅生成代码,还要生成测试、调用工具、执行验证
基于这些痛点分析,我们设计了一个嵌入式AI全栈开发平台的架构方案,旨在打通"需求理解 → 代码生成 → 编译 → 烧录 → 硬件验证"的全链路自动化闭环。 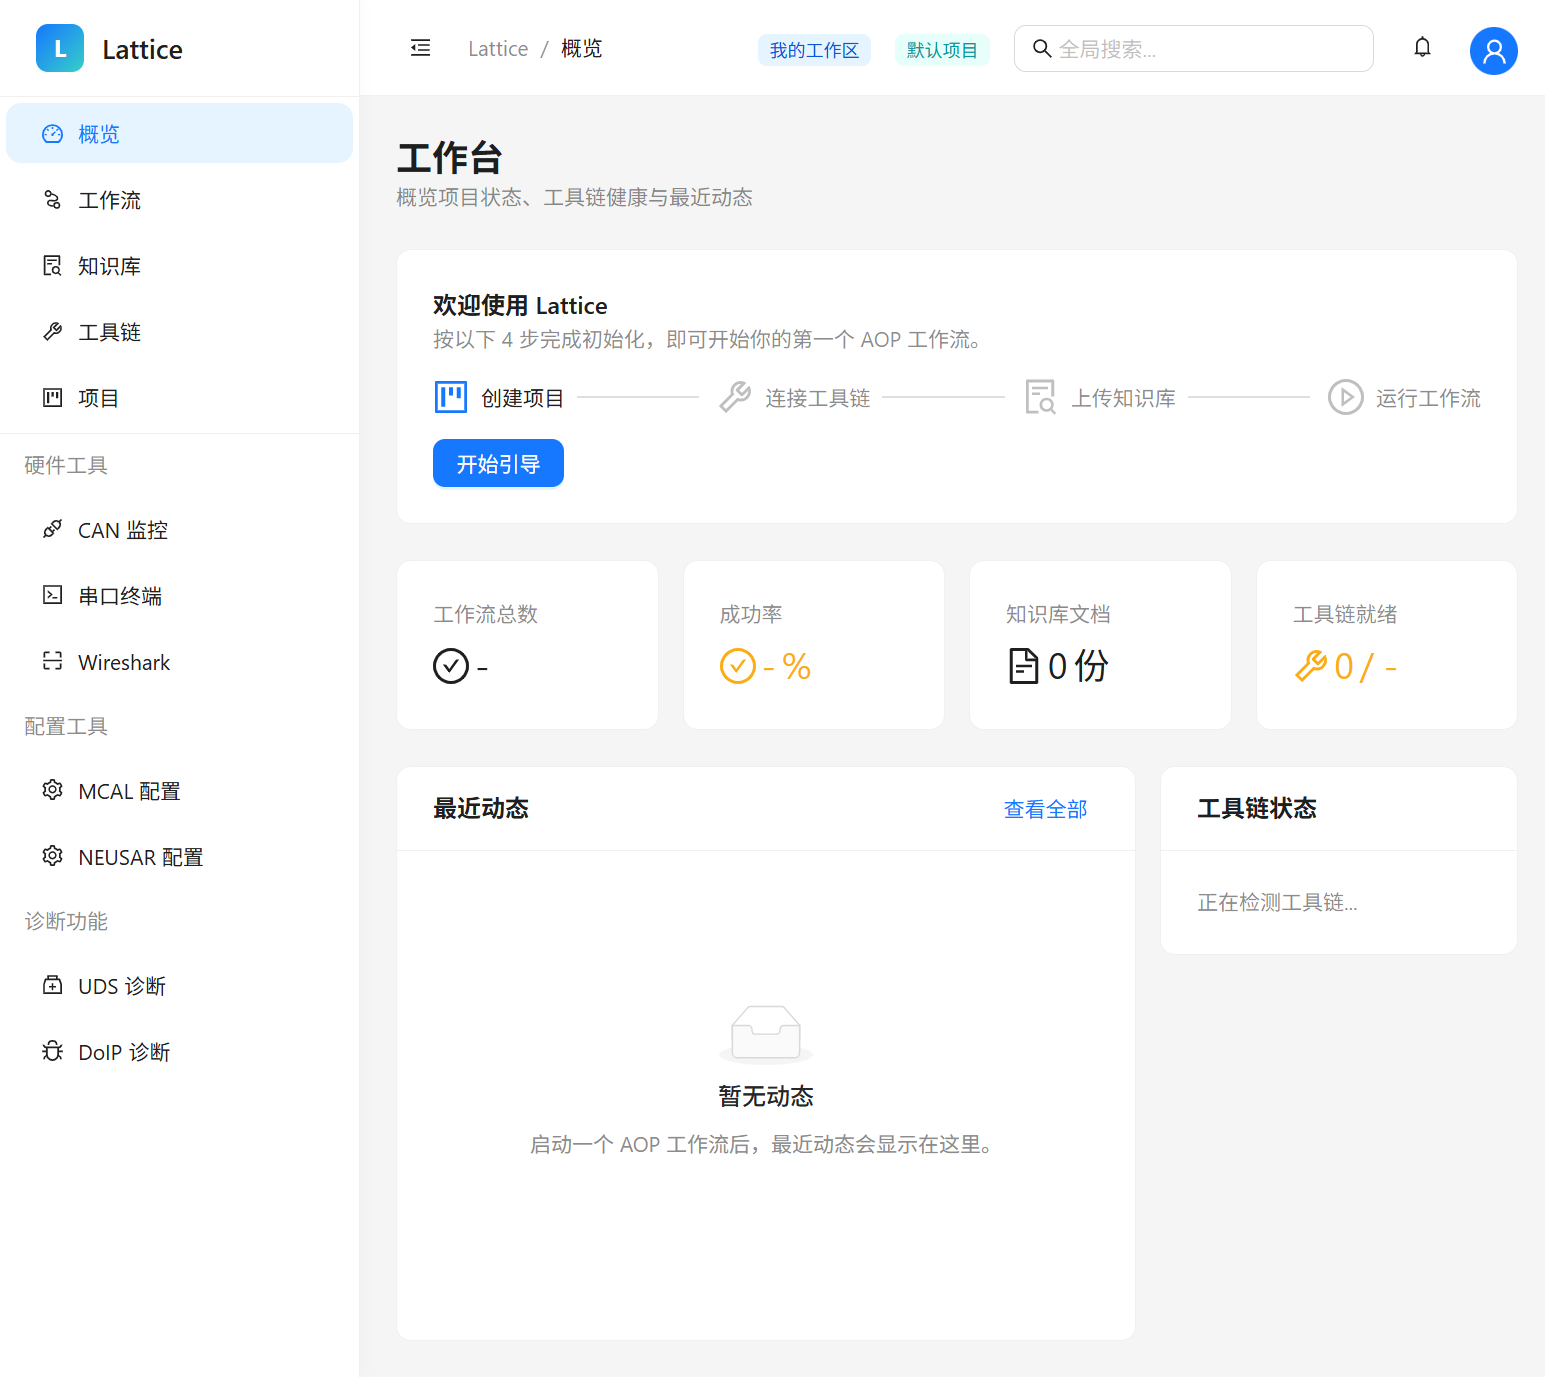
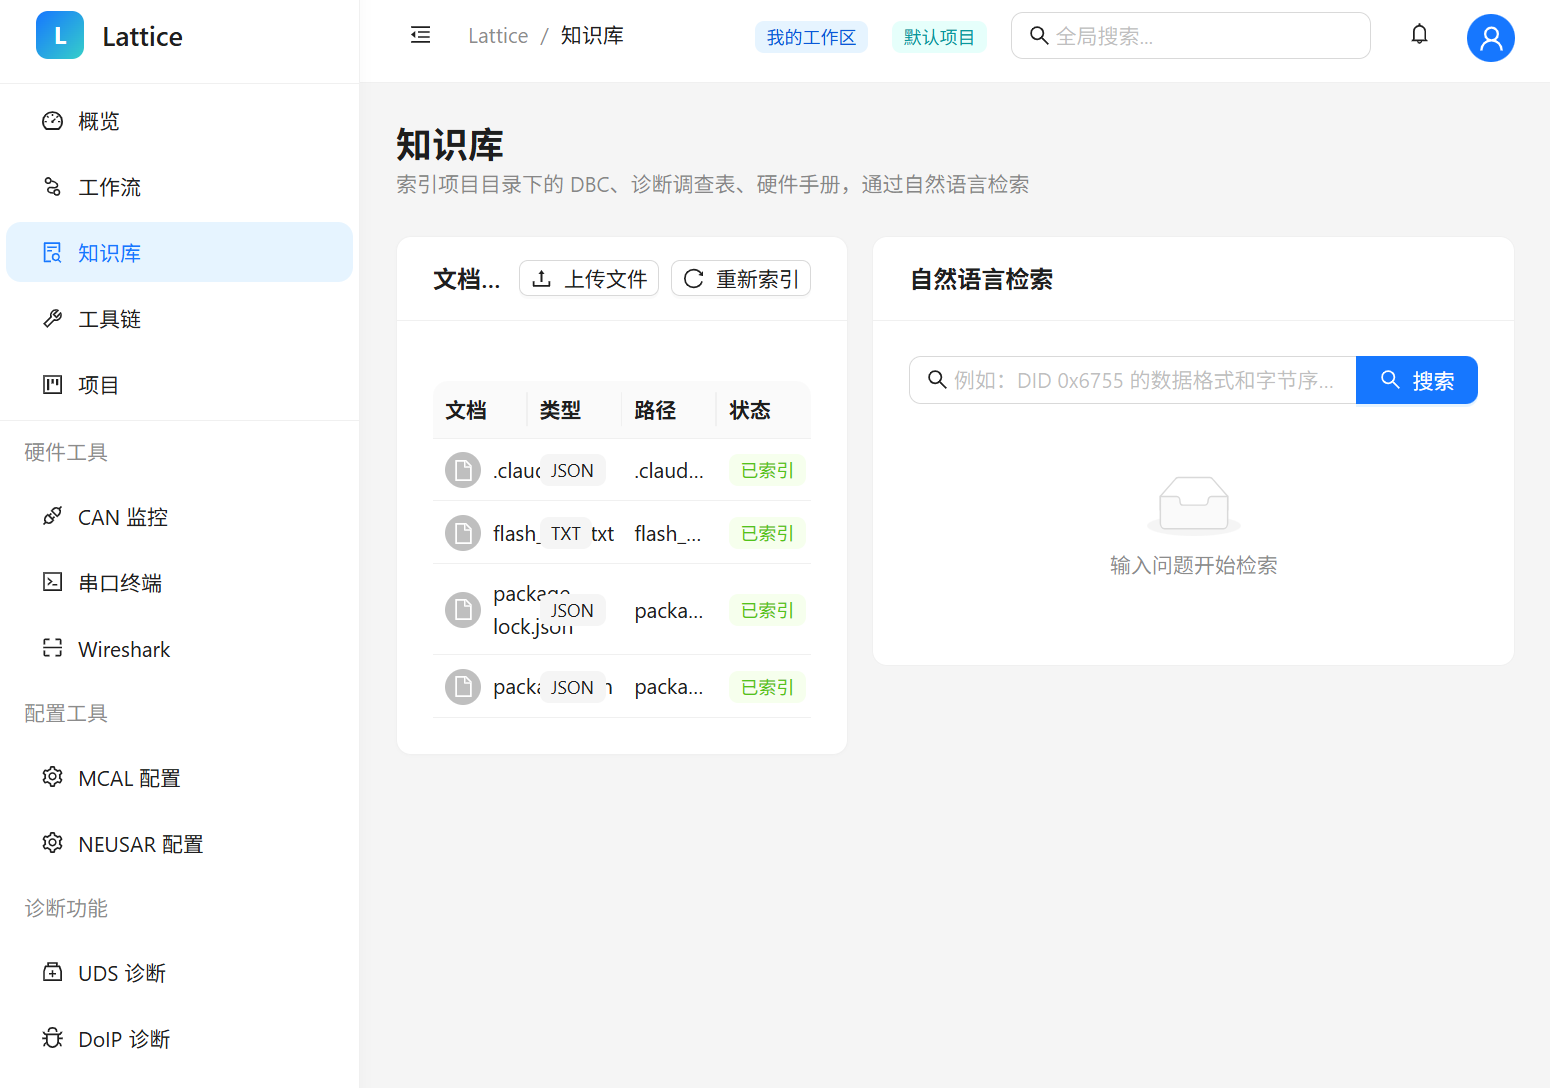
该架构的核心设计包含四个关键组件:
接下来的章节将详细探讨这一架构的设计思路与实现方案。
二、Lattice架构总览
2.1 一句话定位
Lattice是一个AI驱动的嵌入式全栈开发平台,将编译器、调试器、总线分析工具、诊断协议、串口监控等工具统一到一个AI Agent可调度、可编排、可自动验证的工作流引擎中。
2.2 OmniPort——多传输层混合架构
该架构的核心组件是OmniPort(“统一所有端口”)设计,采用四层传输架构:
┌─────────────────────────────────────────────────────────────┐
│ AI IDE / Cursor / VS Code │
├──────────┬──────────┬──────────────┬────────────────────────┤
│ MCP │ REST │ CLI │ IDE Plugin │
│ (AI协议) │ (Web) │ (命令行) │ (编译器/调试器) │
├──────────┴──────────┴──────────────┴────────────────────────┤
│ Service Registry (统一调度层) │
├─────────────────────────────────────────────────────────────┤
│ DriverRegistry │
│ ┌──────┐ ┌──────┐ ┌──────┐ ┌──────┐ ┌──────┐ ┌────────┐ │
│ │ 编译 │ │ 烧录 │ │ 总线 │ │ 诊断 │ │ 串口 │ │ 抓包 │ │
│ └──────┘ └──────┘ └──────┘ └──────┘ └──────┘ └────────┘ │
│ ┌──────┐ ┌──────┐ ┌──────┐ │
│ │COM控制│ │ 配置 │ │ 标定 │ │
│ └──────┘ └──────┘ └──────┘ │
└─────────────────────────────────────────────────────────────┘
四层传输架构对应不同使用场景:
- MCP(Model Context Protocol):AI IDE零配置直连,AI Agent可直接调用全部能力——这是解决"通用AI工具够不着"的关键通道
- REST API:Web 前端和第三方集成
- CLI:命令行与 CI/CD 集成
- IDE Plugin:嵌入式 IDE 原生集成
所有传输层共享同一个Service Registry,调度同一套DriverRegistry——这正是解决"工具链碎片化"的架构手段。
三、DriverRegistry——嵌入式驱动的"万能插座"
3.1 设计思想
传统嵌入式开发中,IAR编译、J-Link烧录、CAN诊断、串口调试都是独立的工具,各有各的CLI、GUI和API。Lattice将它们抽象为统一驱动接口:
class BaseDriver(ABC):
"""所有嵌入式驱动的统一抽象"""
name: str # 驱动标识符,如 "iar", "jlink", "uds"
display_name: str # 显示名称
category: str # "hardware" 或 "software"
capabilities: list # 能力声明,如 ["build", "compile"]
@abstractmethod
def detect(self) –> DetectionResult:
"""自动检测驱动是否安装、路径、版本"""
...
async def initialize(self, config): ...
async def execute(self, method, params): ...
async def shutdown(self): ...
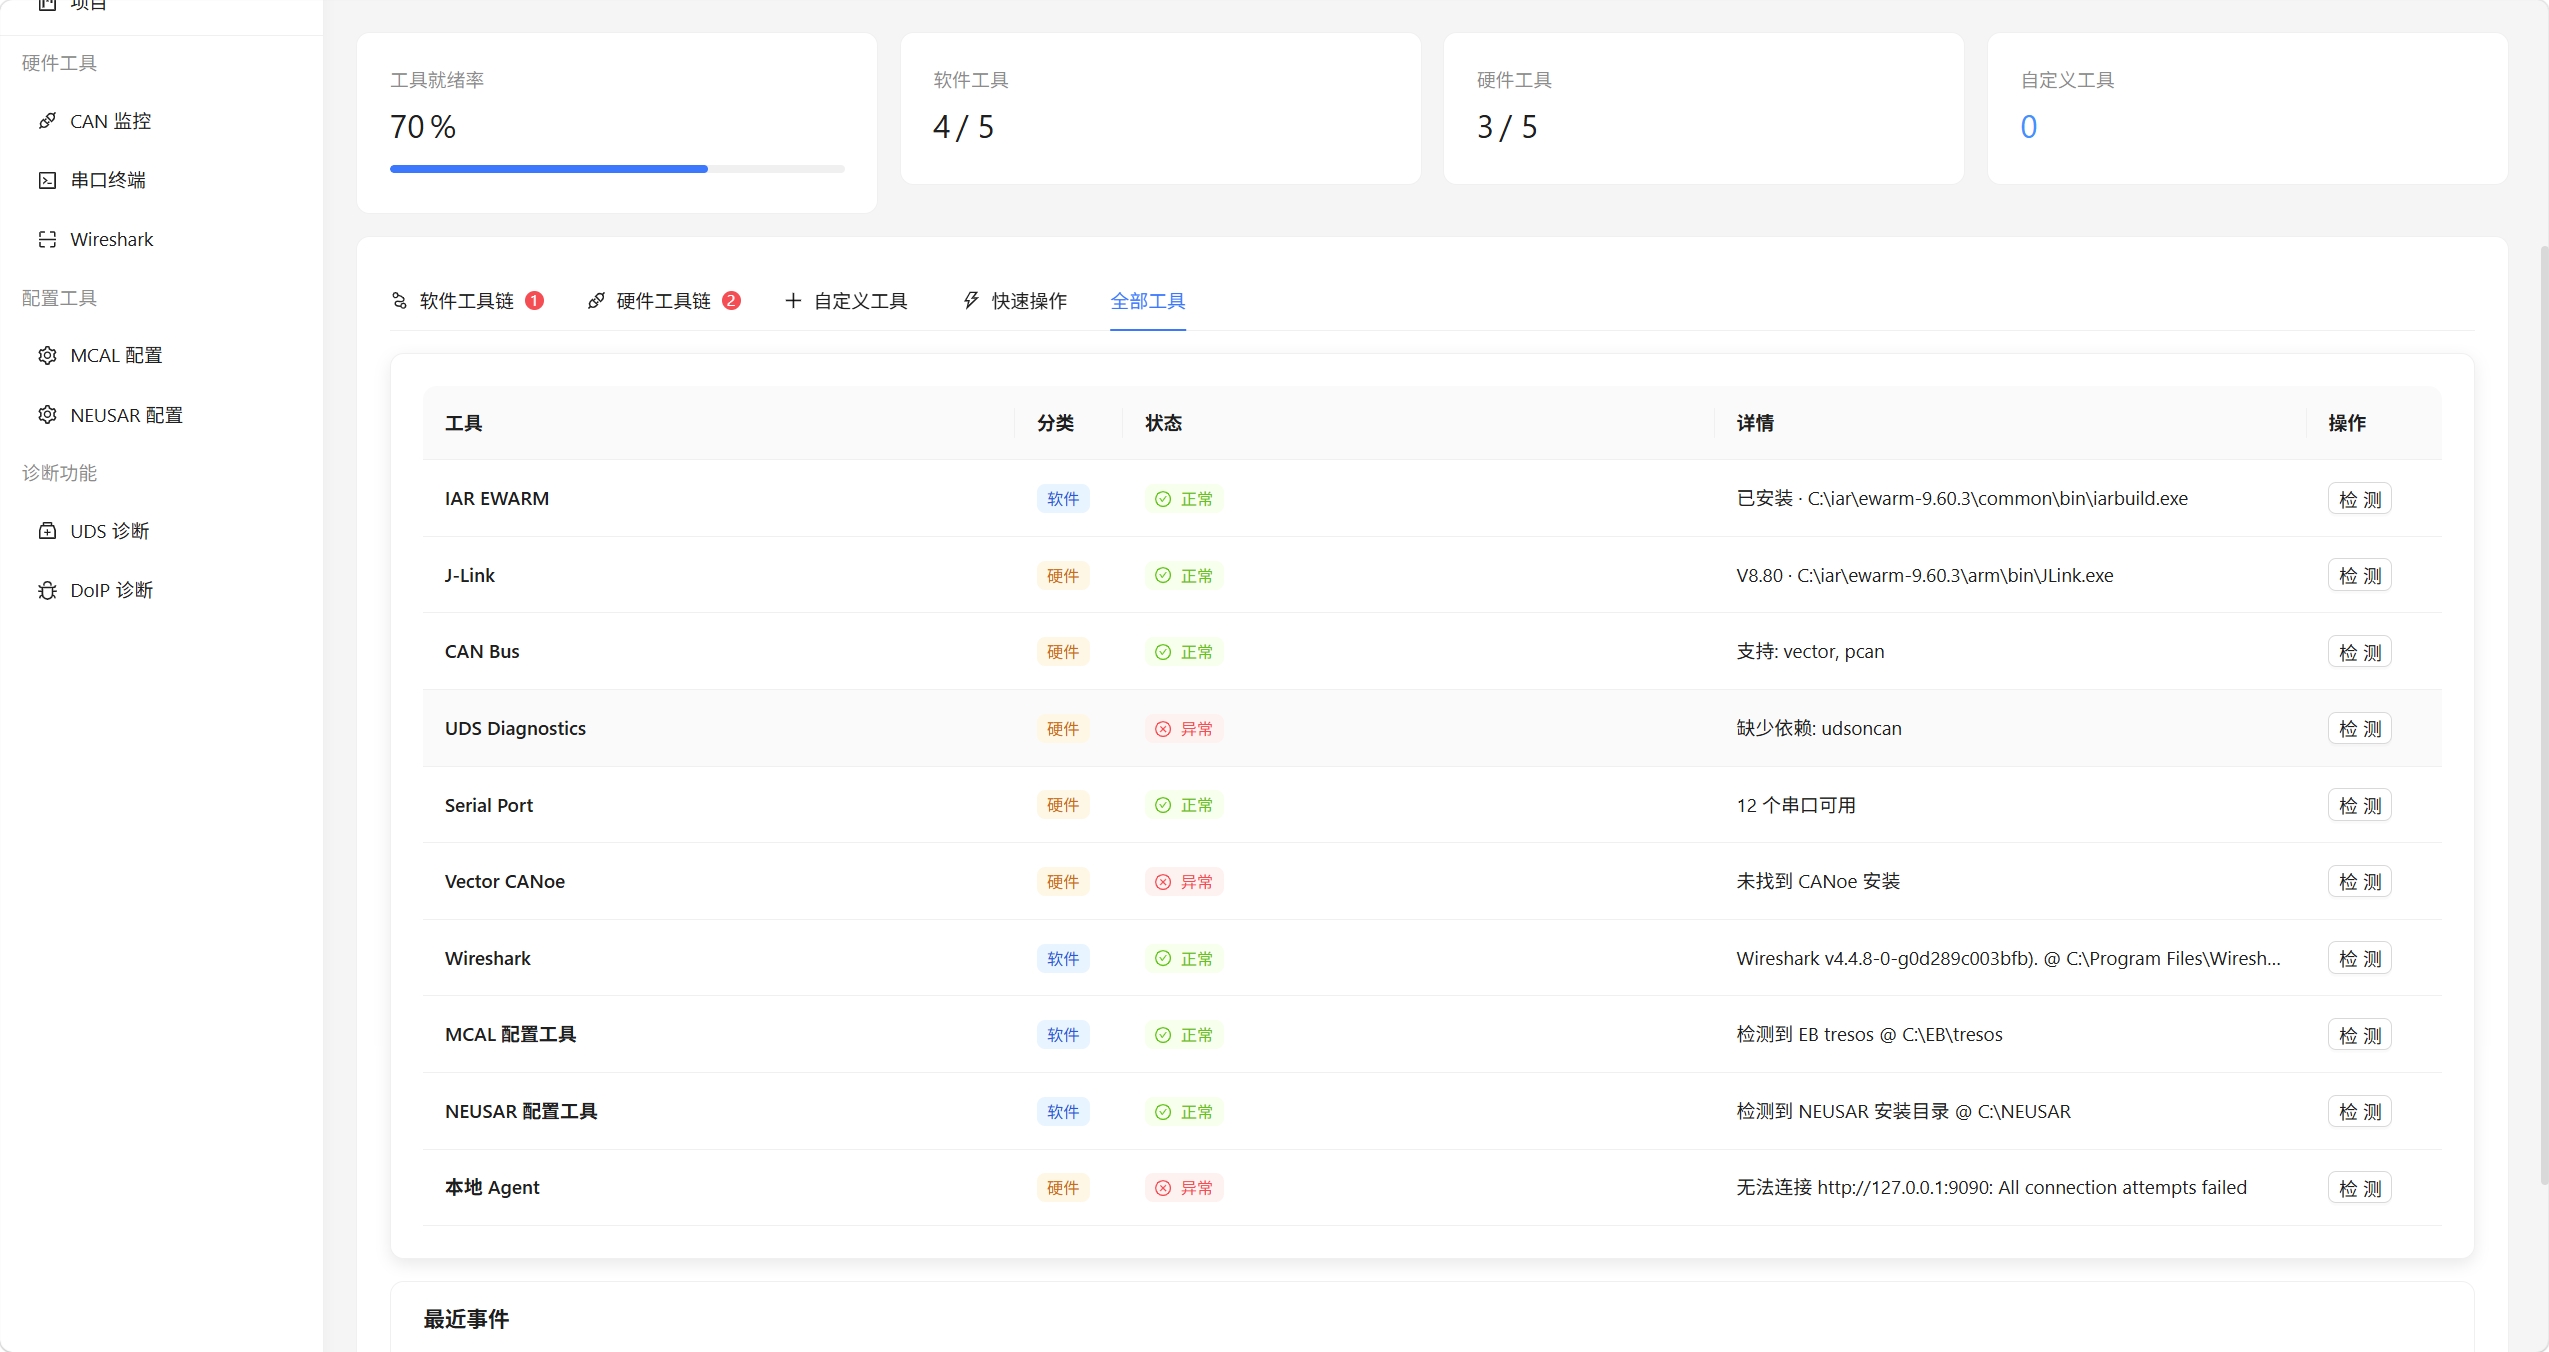
3.2 当前注册的9大驱动
| IAR EWARM | software | iarbuild.exe 编译 | 扫描 Program Files + 版本探测 |
| J-Link | hardware | JLink.exe 烧录/调试 | 路径扫描 + -version |
| CAN | hardware | CAN总线收发/信号解析 | python-can 适配器枚举 |
| UDS | hardware | 诊断会话/DID读写 | 基于python-can的ISO 14229实现 |
| Serial | hardware | 串口收发/日志 | pyserial 端口枚举 |
| Vector | hardware | CANoe/CANalyzer COM控制 | 安装路径扫描 |
| Wireshark | software | tshark抓包(DoIP/BLE/CAN-over-ETH) | 路径扫描 + 版本探测 |
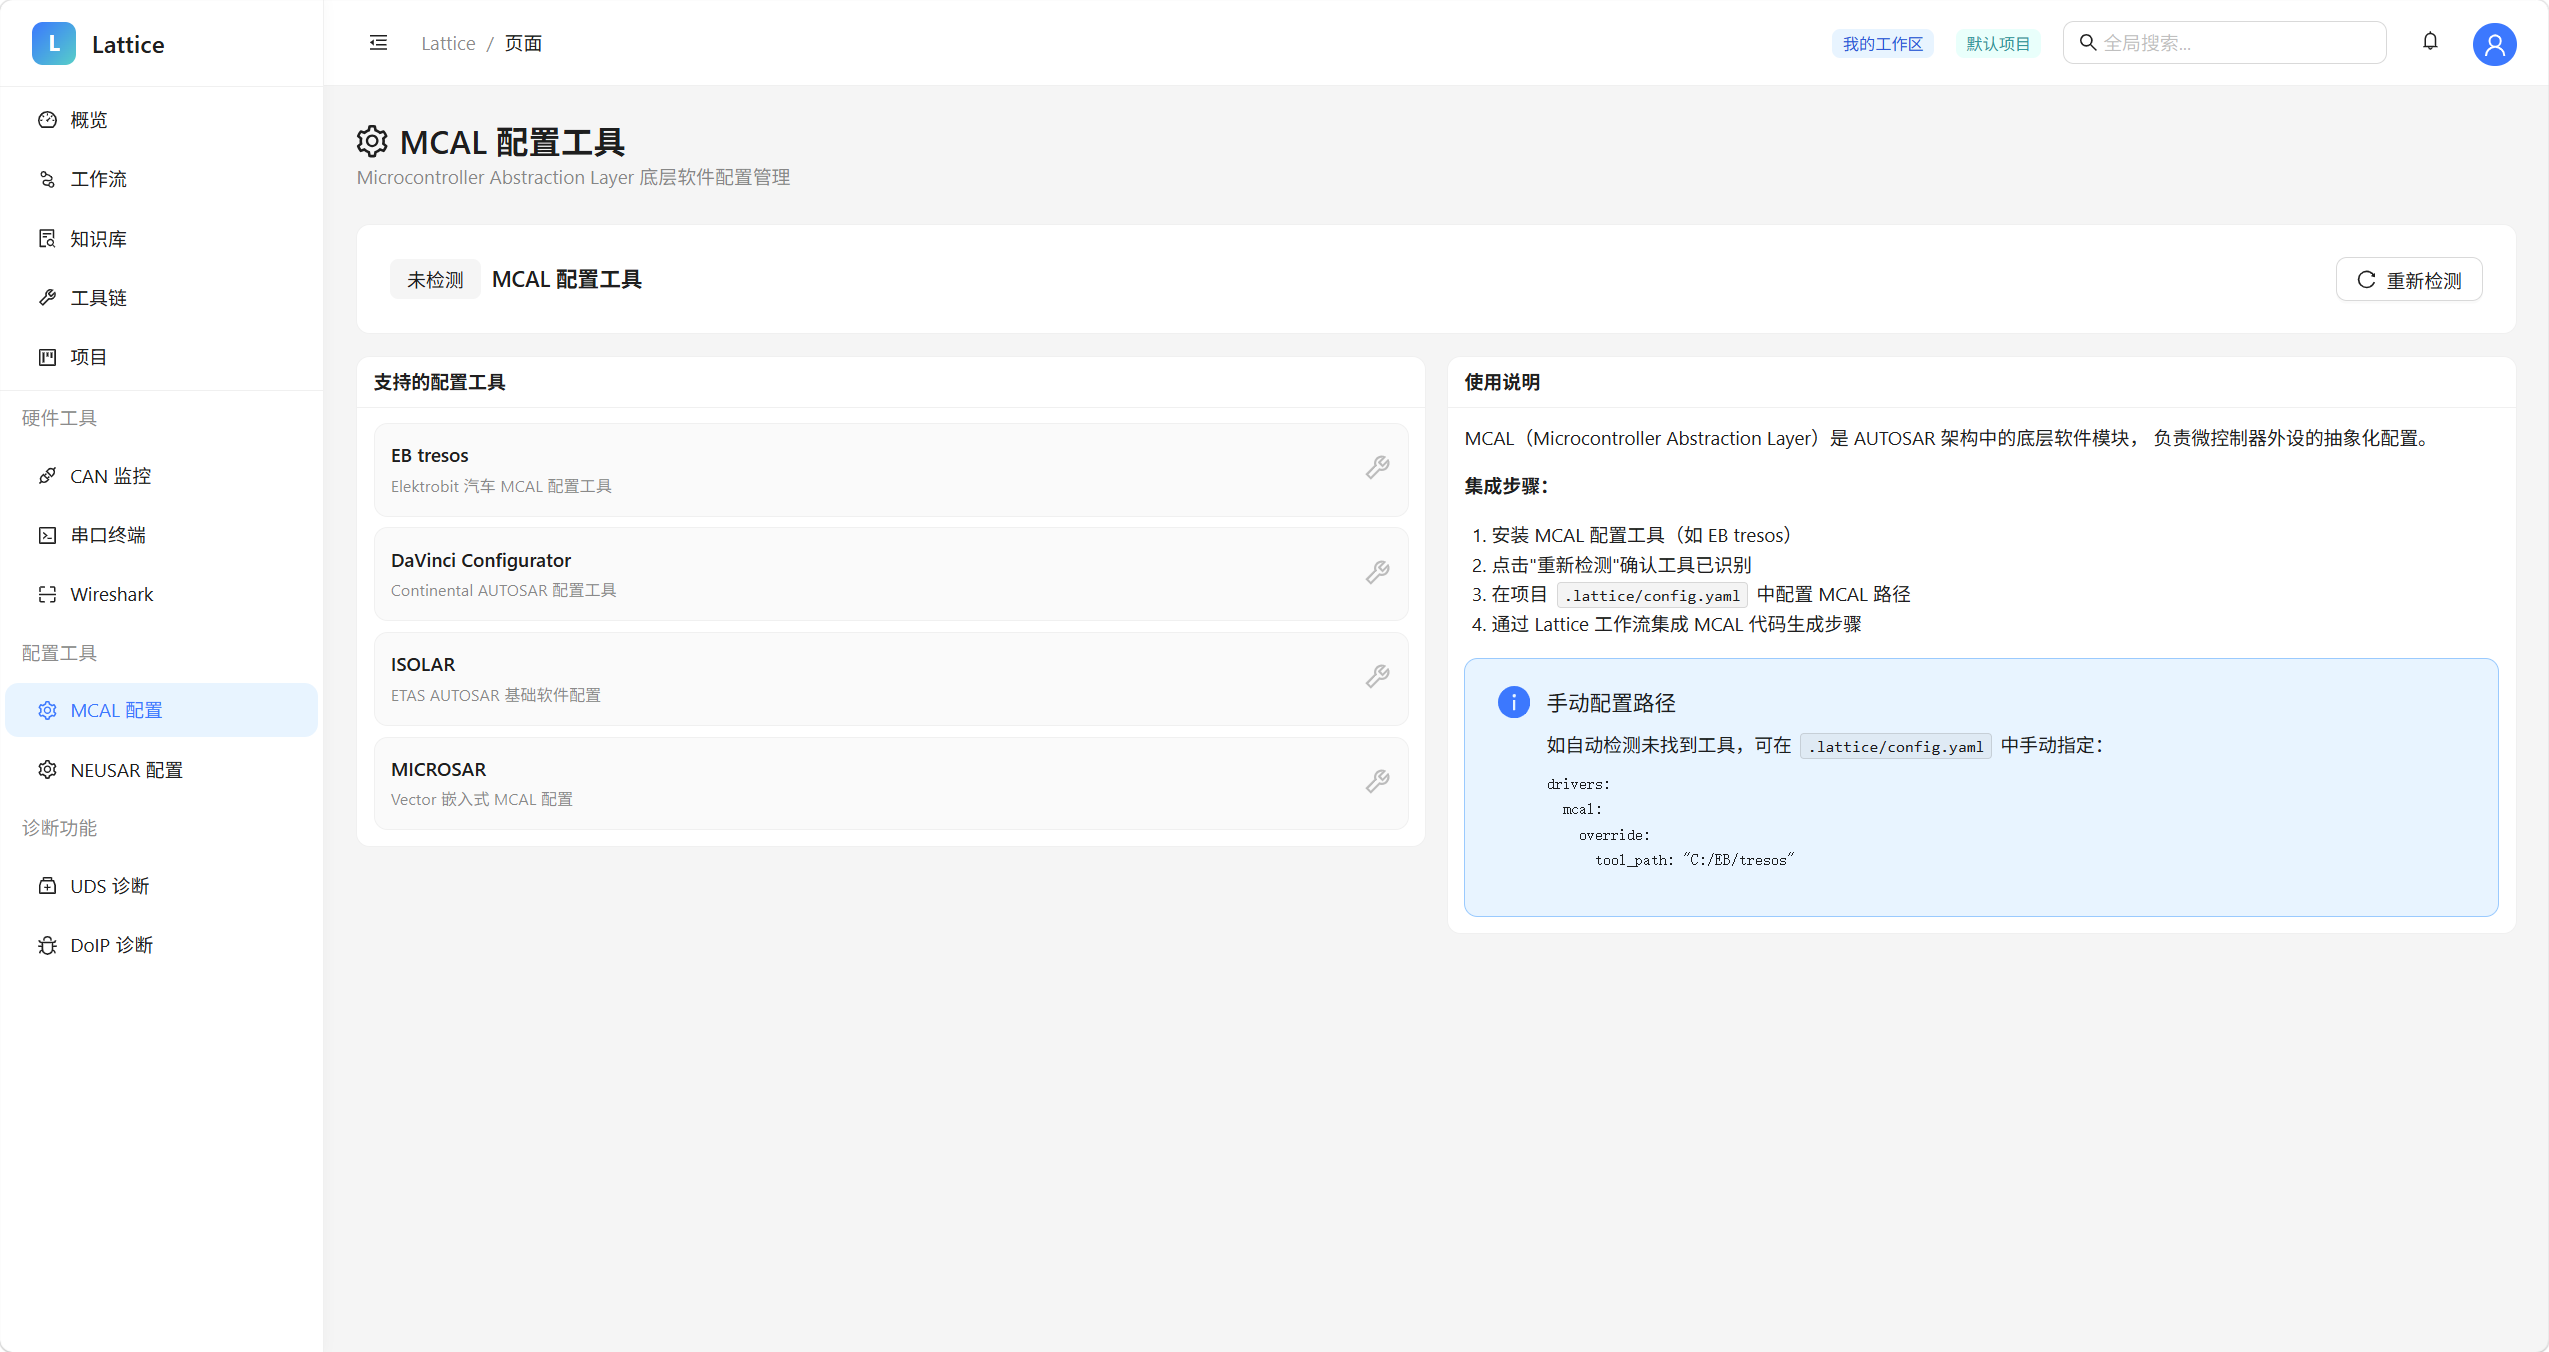
| MCAL | software | AUTOSAR配置(EB tresos/DaVinci/ISOLAR) | 安装路径扫描 |
| NEUSAR | software | ECU参数化配置 | 安装路径扫描 |
3.3 自动发现 + 手动覆盖
class DriverRegistry:
"""单例模式的驱动注册表"""
def detect_all(self):
"""遍历所有已注册驱动,执行自动检测"""
for name, driver in self._drivers.items():
result = driver.detect()
if result.found:
driver._status = DriverStatus.READY
else:
driver._status = DriverStatus.NOT_INSTALLED
def apply_project_overrides(self, project_path):
"""从 .lattice/config.yaml 读取项目级覆盖配置"""
cfg = load_project_config(project_path)
for name, driver in self._drivers.items():
override = cfg.get("drivers", {}).get(name, {}).get("override", {})
if override:
driver.apply_override(override)
工程意义:
- 新成员拿到项目后,Lattice自动检测本地工具链环境
- 项目特定的诊断ID(如0x730/0x7B0)通过YAML覆盖,不硬编码
- 所有驱动即插即用,不需要任何手动配置
四、AI工作流引擎——从需求到代码的7阶段
这是Lattice最核心的能力。一条需求描述进去,编译好的固件烧录到MCU并自动验证通过出来。
4.1 工作流7阶段
orient → plan → implement → build → flash → verify → close
│ │ │ │ │ │ │
│ │ │ │ │ │ └─ 归档+知识库增量索引
│ │ │ │ │ └─ 自动HIL测试(LLM生成用例+默认套件)
│ │ │ │ └─ J-Link烧录(支持暂停确认)
│ │ │ └─ IAR编译(0 errors验证)
│ │ └─ 代码变更应用(search/replace + 自动备份)
│ └─ LLM生成实施计划 + 测试用例
└─ RAG检索项目知识库(DBC/规格书/历史变更)
4.2 五种预设工作流
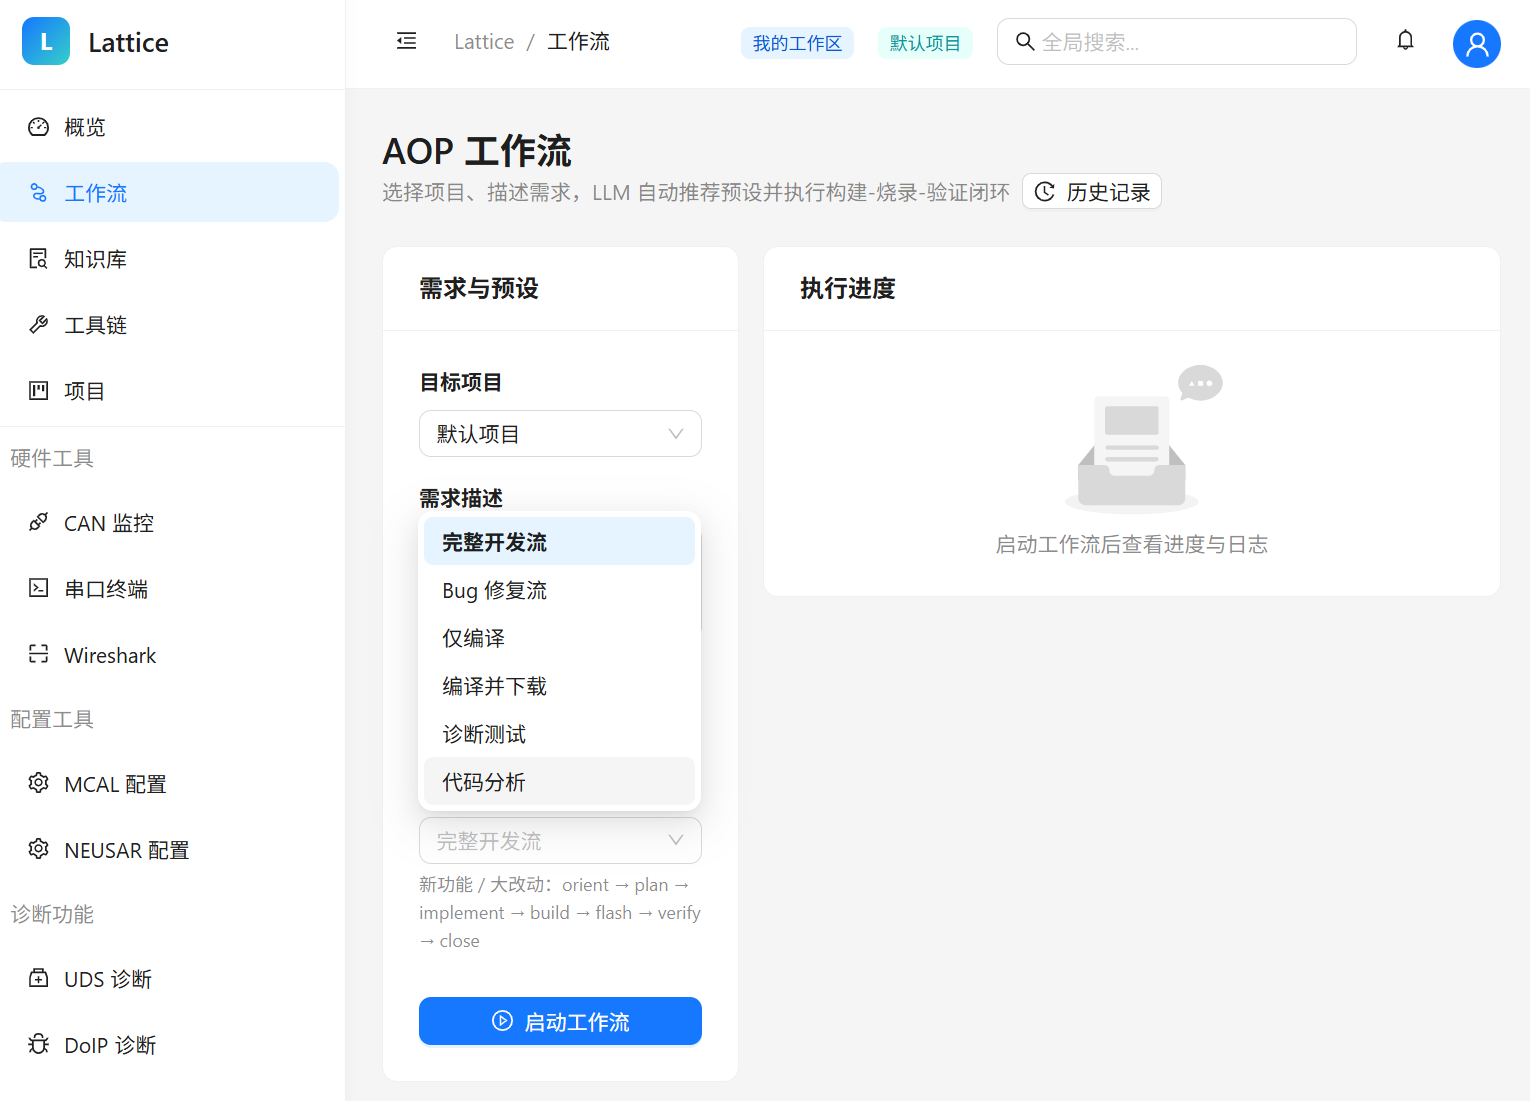
PRESETS = {
"full": ["orient", "plan", "implement", "build", "flash", "verify", "close"],
"bugfix": ["orient", "plan", "implement", "build", "close"],
"build_flash": ["build", "flash", "close"],
"verify_only": ["orient", "verify", "close"],
"build_only": ["build", "close"],
}
- full:完整开发循环,适合新功能开发
- bugfix:跳过烧录和硬件验证,快速修复
- build_flash:纯编译+烧录,不做代码改动
- verify_only:只跑验证测试,不改代码
- build_only:只编译,验证编译是否通过
4.3 关键技术实现
Plan阶段——LLM理解嵌入式需求
SYSTEM_PROMPT = """You are Lattice, an expert embedded software engineer for MCU projects.
Given a user requirement and project context, produce a structured implementation plan WITH test cases.
Respond ONLY with a JSON object:
{
"intent": "feature" | "bugfix" | "verify" | "refactor" | "build",
"steps": ["步骤1", "步骤2"],
"files": [
{
"path": "src/SignalProcessor.c",
"action": "modify",
"patches": [{"search": "原代码片段", "replace": "新代码片段"}]
}
],
"tests": [
{
"id": "TC-001",
"type": "uds_read" | "can_signal" | "serial_check" | "functional",
"params": { … },
"expected": "期望结果"
}
]
}
"""
注意这里的关键设计:LLM不仅生成代码变更计划,还同时生成测试用例。测试类型覆盖多种验证手段——诊断读取、总线信号校验、串口输出检查、编译验证等——确保"改了什么就用最合适的方式验证什么"。
Implement阶段——安全代码应用
def apply_plan(plan, project_path):
for item in files:
full = _safe_path(project_path, rel) # 防路径穿越
if action == "modify":
shutil.copy2(full, f"{full}.lattice.bak") # 自动备份
for patch in item["patches"]:
new_text = new_text.replace(search, replace, 1) # 精确替换
每次修改前自动创建.lattice.bak备份,支持任意回滚。
Flash阶段——人机协作
elif phase == "flash":
run.status = "paused"
_push_notification(db, run, "workflow_paused", "等待烧录确认")
event = _get_event(run.id)
event.clear()
await event.wait() # 异步等待用户确认
# 用户点击"确认烧录"后才执行
result = await flash_firmware(run.project.path)
烧录是唯一需要人工确认的环节——毕竟这涉及真实硬件。
五、AI Coding——从自然语言到精确代码变更
上一章介绍了工作流引擎的7阶段编排,本章聚焦其中最核心的环节:AI如何理解嵌入式需求、生成精确代码变更、安全地应用到项目文件。
5.1 不是"生成整个文件",而是"精确补丁"
通用AI编码工具(如GitHub Copilot、Cursor)的代码生成模式是逐行补全或整文件重写。这在Web开发中可行——一个React组件通常不超过200行,重写成本很低。
但嵌入式C代码有不同的现实:
- 一个.c文件动辄2000-5000行,包含复杂的条件编译、宏定义、AUTOSAR生成的代码框架
- 修改往往只涉及其中3-5行——一个校准系数、一个信号解析公式、一个诊断数据长度
- 整文件重写会丢失手工维护的代码风格、注释、条件编译分支
Lattice的Plan阶段让LLM生成的是结构化补丁(Patches),而非整文件:
{
"files": [
{
"path": "src/SignalProcessor.c",
"action": "modify",
"reason": "增加信号校准系数",
"patches": [
{"search": "#define SIGNAL_SCALE 1.0", "replace": "#define SIGNAL_SCALE 0.95"},
{"search": "raw_value = adc_read(ch);", "replace": "raw_value = (uint16_t)(adc_read(ch) * SIGNAL_SCALE);"}
]
},
{
"path": "src/SignalConfig.h",
"action": "create",
"content": "/* Auto-generated by Lattice */\\n#ifndef SIGNAL_CONFIG_H\\n#define SIGNAL_CONFIG_H\\n…"
},
{
"path": "src/LegacyHandler.c",
"action": "delete",
"reason": "该功能已迁移到新模块"
}
]
}
三种动作对应三种工程场景:
- modify:精确search/replace补丁,不碰文件其他部分——占实际变更的80%+
- create:生成全新文件,适用于新增模块——LLM输出完整文件内容
- delete:删除废弃文件——先备份,再删除
5.2 安全应用机制
代码变更从LLM输出到落盘,经过四层安全保障:
LLM输出 → _safe_path()防路径穿越 → 文件存在性校验 → .lattice.bak自动备份 → search/replace精确应用
def apply_plan(plan, project_path):
for item in files:
# 安全层1:防路径穿越
full = _safe_path(project_path, rel)
# 如果 full 不在 project_path 下,直接拒绝
if not full.startswith(os.path.normpath(project_path)):
raise ValueError(f"Invalid path: {rel}")
if action == "modify":
# 安全层2:文件必须存在才能修改
if not os.path.isfile(full):
errors.append(f"{rel}: 文件不存在,无法修改")
continue
# 安全层3:自动备份
shutil.copy2(full, f"{full}.lattice.bak")
# 安全层4:精确替换,不重写整个文件
for patch in patches:
if search not in new_text:
errors.append(f"找不到匹配片段,跳过该 patch")
else:
new_text = new_text.replace(search, replace, 1)
关键设计决策:
- search必须精确匹配:如果LLM生成的search片段在文件中找不到,该patch会被跳过并记录错误,而不是模糊匹配
- 每个patch只替换1次:replace(search, replace, 1) 确保不会误改文件中其他相同代码
- 备份自动创建:每个被修改/删除的文件都会创建.lattice.bak副本,支持一行命令回滚
5.3 RAG注入项目上下文
通用LLM不知道你的项目中:
- SIGNAL_SCALE宏定义在哪个头文件里
- adc_read()函数的返回值范围是0-4095还是0-65535
- 信号处理模块的代码结构是按功能分组还是按信号类型分组
Lattice在Plan阶段将这些信息注入LLM上下文:
async def generate_plan(requirement, project_id, project_path):
# 1. RAG检索项目知识库
kb_results = await rag.search_project(project_id, requirement, n_results=5)
kb_context = "\\n\\n".join(f"[{r['source']}]\\n{r['content']}" for r in kb_results)
# 2. 扫描项目源文件列表
source_files = _list_source_files(project_path) # .c/.h/.cpp
# 3. 组装上下文
user_content = f"""项目路径:{project_path}
现有源文件列表:
{chr(10).join(source_files)}
知识库检索结果:
{kb_context}
用户需求:
{requirement}"""
三重上下文让LLM的代码生成从"通用建议"变成"项目级精确补丁":
- 源文件列表:让LLM知道项目有哪些文件,不会虚构不存在的文件路径
- 知识库检索:提供信号定义、硬件参数、规格要求等精确上下文
- 需求描述:用户意图的直接输入
5.4 Demo模式——离线也能用
if not settings.lattice_llm_api_key:
return _demo_plan(requirement, project_path)
没有LLM API Key时,Lattice基于关键词匹配生成确定性计划:
- 需求中包含"编译"“build” → 选择build_only预设
- 需求中包含"修复"“fix”“bug” → 选择bugfix预设
- 需求中包含CAN ID模式 → 生成can_signal测试用例
- 需求中包含DID模式 → 生成uds_read测试用例
这不是"降级",而是让系统在离线环境、CI/CD、演示场景下依然可用。Demo模式的输出格式与LLM模式完全一致,下游阶段无需区分来源。
六、RAG知识库——让AI"读懂"你的项目
6.1 问题
LLM不直接知道你的MCU项目里:
- 总线数据库文件定义了哪些信号、每个信号的物理含义是什么
- 规格书中各个诊断参数的合法范围和数据格式
- 硬件原理图上某个引脚复用配置、外设时钟树是怎么分频的
- AUTOSAR配置中哪些模块已经启用、哪些参数被裁剪了
- 上一次改了什么、为什么改、谁审核的
这些信息分散在几十个不同格式的文件中(PDF、Excel、二进制数据库、YAML、C头文件……),LLM无法直接读取。
6.2 ChromaDB向量检索
async def index_project(project_id, project_path):
"""将项目文档分块向量化入库"""
collection = client.get_or_create_collection(name=f"project_{project_id}")
for file_path in _list_kb_files(project_path):
text = _extract_text(file_path) # 支持 .pdf/.xlsx/.docx/.dbc/.c/.h/.yaml
chunks = _chunk_text(text, chunk_size=500, overlap=100)
embs = await embeddings.embed_texts(chunks)
collection.upsert(ids=..., documents=chunks, embeddings=embs)
6.3 检索增强规划
async def generate_plan(requirement, project_id, project_path):
kb_results = await rag.search_project(project_id, requirement, n_results=5)
# 将知识库匹配结果注入LLM上下文
user_content = f"""
知识库检索结果:
{kb_context}
用户需求:
{requirement}
"""
当用户说"某个信号采集值偏低",RAG会检索到:
- 总线数据库中该信号所在的报文定义、周期和解析公式
- 硬件规格书中该通道的量程、精度和校准要求
- 上次修复类似问题的变更记录和测试结果
当用户说"增加一个新的CAN信号转发功能",RAG会检索到:
- 现有信号处理模块的代码结构和接口定义
- AUTOSAR配置中该通信矩阵的当前状态
- 相关的编译配置和依赖关系
这些上下文让LLM生成精准到具体模块、具体信号、具体配置参数的代码变更和测试用例。
七、自动化HIL测试——从LLM测试用例到YAML执行
7.1 测试框架设计原则
Lattice遵循一个核心原则:平台提供能力,项目定义测试。
| 平台层 | 驱动基础设施(编译器调用、烧录器控制、总线读写、诊断方法) | compiler.build(project) / bus.read_signal(name) |
| 项目层 | 具体测试序列(编译哪个配置、读哪个信号、期望什么值) | .lattice/tests/signal_check.yaml |
| 测试框架 | 执行YAML测试套件,不暴露原子操作 | test_run(suite="signal_check") |
7.2 LLM生成测试用例
工作流的Plan阶段不仅生成代码计划,还生成结构化测试用例: 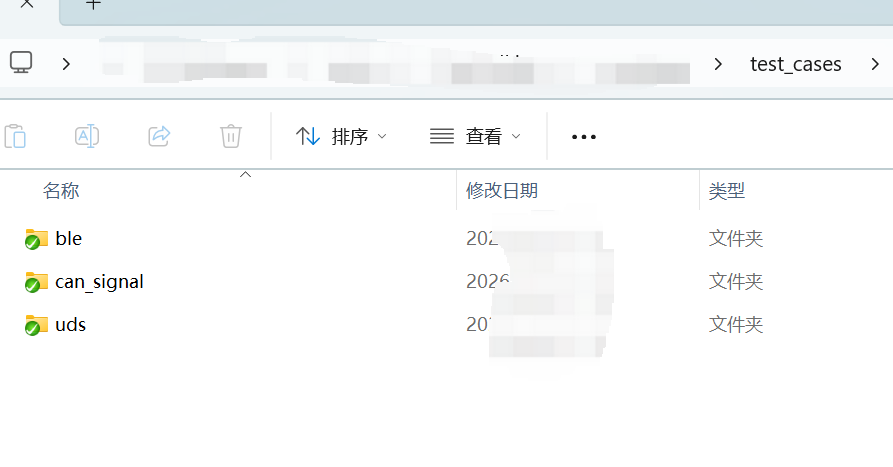
{
"tests": [
{
"id": "TC-001",
"name": "编译零错误验证",
"type": "functional",
"params": {"check": "build_zero_errors"},
"expected": "交叉编译 0 errors",
"priority": "high"
},
{
"id": "TC-002",
"name": "CAN信号周期校验",
"type": "can_signal",
"params": {"signal_name": "EngineSpeed", "check_period": true},
"expected": "目标报文按预期周期发送",
"priority": "high"
},
{
"id": "TC-003",
"name": "诊断参数读取校验",
"type": "uds_read",
"params": {"identifier": "目标数据标识符", "check_range": true},
"expected": "返回值在规格书定义的有效范围内",
"priority": "medium"
},
{
"id": "TC-004",
"name": "串口输出验证",
"type": "serial_check",
"params": {"pattern": "INIT OK", "timeout": 5},
"expected": "上电后串口输出初始化成功标志",
"priority": "medium"
}
]
}
四种测试类型对应四种不同的验证手段:
- functional:编译验证、功能逻辑检查(不依赖硬件通信)
- can_signal:通过总线接口读取信号值和周期(硬件在环验证)
- uds_read/uds_write:通过诊断协议读写参数(硬件在环验证)
- serial_check:通过串口输出验证启动流程和运行状态(硬件在环验证)
7.3 自动转换为YAML测试套件
async def _run_llm_test_cases(run, test_cases, db):
"""将LLM生成的测试用例转为临时YAML套件并执行"""
yaml_tests = []
for tc in test_cases:
if tc["type"] == "uds_read":
steps = [{
"driver": "uds",
"method": "read_did",
"params": {"did": tc["params"]["did"]},
"expect": {"ok": True},
}]
elif tc["type"] == "can_signal":
steps = [{
"driver": "can",
"method": "get_signals",
"params": {},
"expect": {"ok": True},
}]
yaml_tests.append({"id": tc["id"], "name": tc["name"], "steps": steps})
# 写入 .lattice/tests/ 目录
suite = {"schema_version": "1.0", "tests": yaml_tests}
with open(f".lattice/tests/_workflow_{run.id}.yaml", "w") as f:
yaml.dump(suite, f)
# 通过TestRunner执行
runner = TestRunner()
result = await runner.run_suite(
project_path=run.project.path,
suite_name=f"_workflow_{run.id}",
)
7.4 Verify阶段——双重测试策略
elif phase == "verify":
# 策略1:执行LLM生成的测试用例(需求针对性测试)
if test_cases:
suite_result = await _run_llm_test_cases(run, test_cases, db)
_add_log(run, "info", f"LLM 测试: {passed}/{total} 通过")
# 策略2:执行默认连通性测试套件(基线回归)
result = await invoke("test_run", {
"project_path": run.project.path,
"suite": "connectivity", # 默认套件:UDS Session + CAN + Serial
})
每次验证同时跑两套测试:
八、过程文档——全链路自动记录与追溯
嵌入式开发中,过程记录的缺失是一个被忽视但致命的问题。一个需求从提出到验证通过,中间经历了什么?改了哪个文件?测试结果如何?谁确认的?——这些信息在传统流程中要么不存在,要么分散在不同人的记忆和邮件里。
Lattice从架构层面保证了:每一个工作流的每一步操作都自动记录、自动归档、可追溯。
8.1 实时日志——每一步都有据可查
工作流引擎在每个阶段的执行过程中,通过_add_log持续记录结构化日志:
def _add_log(run, level, message):
now = datetime.utcnow().strftime("%H:%M:%S")
logs = list(run.logs or [])
logs.append({"level": level, "time": now, "message": message})
run.logs = logs
日志示例:
{"level": "info", "time": "14:23:01", "message": "[orient] 读取项目上下文与知识库"}
{"level": "info", "time": "14:23:03", "message": "[orient] SignalSpec.pdf: 传感器通道定义,量程0-5V…"}
{"level": "info", "time": "14:23:08", "message": "[plan] 意图: bugfix | 预设: bugfix"}
{"level": "info", "time": "14:23:08", "message": "[plan] 文件: modify src/SignalProcessor.c — 增加校准系数"}
{"level": "info", "time": "14:23:10", "message": "[implement] 应用 1 个文件变更"}
{"level": "success", "time": "14:25:30", "message": "[build] PASS, 45s: 0 errors, 0 warnings"}
{"level": "success", "time": "14:26:01", "message": "[close] 完成"}
结构化日志不是"打印调试信息",而是工作流的法定记录。每条日志包含级别(info/warn/error/success)、精确时间戳和人类可读的描述。
8.2 计划快照——LLM输出完整保留
工作流的Plan阶段不仅执行计划,还把LLM的完整输出持久化到数据库:
# 持久化完整计划
run.plan_snapshot = plan
# 提取LLM生成的测试用例
run.test_cases = _extract_test_cases(plan)
plan_snapshot保留了LLM输出的完整JSON:意图判断、步骤列表、文件变更详情、测试用例、原始回复。这确保了:
- 可审计:任何时候都可以回溯"当时AI是怎么想的"
- 可复现:相同需求+相同上下文,输出一致
- 可调试:如果计划不符合预期,可以从快照中定位是RAG检索结果的问题还是LLM推理的问题
8.3 通知系统——状态变更实时推送
工作流的状态变更通过Notification系统实时推送:
def _push_notification(db, run, kind, title, detail):
notif = Notification(
type=kind, # workflow_started / workflow_completed / workflow_failed / workflow_paused
title=title,
detail=detail,
run_id=run.id,
read=False,
)
db.add(notif)
db.commit()
通知类型对应工作流的关键状态:
- workflow_started:工作流启动,包含需求描述
- workflow_paused:等待烧录确认,包含项目名称
- workflow_completed:工作流完成,包含执行摘要
- workflow_failed:工作流失败,包含失败原因
- workflow_cancelled:用户取消
前端通过轮询/SSE接收通知,实现无需盯着进度条——烧录等待确认时会有通知,编译失败了会有弹窗,完成后会有摘要。
8.4 归档系统——运行数据持久化到磁盘
工作流完成后,Close阶段将完整的运行数据序列化为JSON归档:
archive_data = {
"run_id": run.id,
"project_name": run.project.name,
"requirement": run.requirement,
"preset_key": run.preset_key,
"intent": run.plan_snapshot.get("intent"),
"phases": run.phases,
"logs": run.logs, # 全部结构化日志
"plan_snapshot": run.plan_snapshot, # LLM完整输出
"test_cases": run.test_cases, # 测试用例
"test_results": run.test_results, # 测试结果
"summary": run.summary, # 自动生成的摘要
}
with open(f"data/runs/run_{run.id}.json", "w") as f:
json.dump(archive_data, f, ensure_ascii=False, indent=2)
归档文件保存在data/runs/目录下,每个工作流一个JSON文件,包含从需求到结果的完整信息链。
工程价值:
- 无需额外工具,直接cat run_3.json就能看到任何一次历史运行的完整过程
- 归档文件是纯文本JSON,天然可版本控制、可diff、可grep
- 知识库的增量索引也在此阶段完成,确保下次运行时RAG能检索到本次变更的相关上下文
九、版本控制——Git集成与变更追溯
嵌入式项目的版本控制有一个独特的痛点:代码变更只是整个交付物的一部分。编译配置、AUTOSAR参数、测试套件、工作流日志——这些都应该和代码一起被版本化管理,但传统Git工作流只关注源码文件。
9.1 .lattice目录结构——版本控制友好设计
Lattice的项目配置结构天然支持Git管理:
project_root/
├── .lattice/
│ ├── config.yaml # 项目级驱动配置(编译器路径、诊断ID等)
│ └── tests/
│ ├── connectivity.yaml # 默认连通性测试套件
│ ├── signal_check.yaml # 信号校验测试套件
│ └── _workflow_*.yaml # 工作流自动生成的测试套件
├── src/ # 源代码
├── .git/
└── …
关键设计决策:
- config.yaml是项目产物,不是平台配置——不同项目的诊断ID、编译器版本、烧录参数不同,应该随项目一起版本化
- tests/*.yaml是项目产物——测试用例定义了"验证什么",与代码同等重要
- workflow*.yaml由工作流自动生成——LLM生成的测试用例自动写入,可追踪每次需求的验证方式
# .gitignore 建议
.lattice/*.bak # Lattice备份文件,不纳入版本控制
.lattice/cache/ # 本地缓存
9.2 工作流与Git的集成架构
Lattice的OmniPort架构天然支持Git操作——通过CLI传输层封装git命令:
┌─────────────────────────────────────────────┐
│ Workflow Engine │
│ orient → plan → implement → build → … │
├─────────────────────────────────────────────┤
│ Service Registry │
├──────────┬──────────┬───────────────────────┤
│ git │ IAR │ J-Link │ CAN │ …│
│ driver │ driver │ driver │ driver│ │
└──────────┴──────────┴───────────────────────┘
Git作为Service Registry中的一个驱动,提供以下能力:
| status | 查看当前工作区状态(哪些文件被Lattice修改) |
| diff | 查看LLM生成的代码变更差异 |
| commit | 将工作流变更提交(自动生成commit message) |
| log | 查看历史提交,关联工作流运行ID |
| revert | 回滚到指定版本(配合.lattice.bak备份) |
9.3 自动提交策略
工作流的Close阶段可以扩展为自动Git提交:
# Close阶段扩展:自动提交
if git_driver.available:
# 1. 查看哪些文件被Lattice修改
status = await git_driver.execute("status", {"short": True})
# 2. 暂存所有.lattice相关变更
await git_driver.execute("add", {"files": [".lattice/", status.modified_files]})
# 3. 生成结构化commit message
commit_msg = f"""[lattice] {run.preset_key}: {run.requirement}
Workflow Run #{run.id}
Intent: {run.plan_snapshot.get('intent')}
Tests: {test_passed}/{len(test_cases)} passed
Files: {', '.join(summary['backups'])}"""
await git_driver.execute("commit", {"message": commit_msg})
自动生成的commit message包含:
- 工作流类型和需求描述
- 运行ID,可直接关联到归档JSON
- 意图判断和测试结果
- 变更文件列表
9.4 变更追溯——从需求到代码到测试的完整链路
结合过程文档归档和Git集成,Lattice实现了嵌入式开发中罕见的全链路变更追溯:
需求描述 → Run #3 (archive JSON)
├── Plan快照: LLM输出的完整推理过程
├── 代码变更: git diff 可查,.lattice.bak 可回滚
├── 测试用例: .lattice/tests/_workflow_3.yaml
├── 测试结果: archive JSON 中的 test_results
└── Git commit: [lattice] bugfix: 增加信号校准系数
这意味着:
- 谁改了什么:Git commit关联Run ID,点击可查看完整上下文
- 为什么改:Plan快照中保留了LLM的意图判断和推理过程
- 改了什么:search/replace补丁精确记录了变更的每一行
- 验证了吗:测试用例和结果与需求绑定,不会"改了但没测"
- 能回滚吗:.lattice.bak + git revert双重保障
传统流程中,这些信息分布在5个以上的工具和人的脑子里。Lattice让它们变成一条可查询、可追溯、可审计的数据链。
十、工具链管理——内置+自定义合并展示
10.1 自动检测
Lattice启动时自动扫描本地工具链环境:
def detect_all(self):
"""遍历9大驱动,逐一检测"""
results = {}
for name, driver in self._drivers.items():
result = driver.detect() # 检查安装路径、版本、连通性
if result.found:
driver._status = DriverStatus.READY
else:
driver._status = DriverStatus.NOT_INSTALLED
results[name] = result
10.2 自定义工具扩展
除了内置驱动,Lattice支持用户注册自定义工具——MCP Server、REST API、CLI命令、外部应用程序:
class CustomTool(Base):
"""用户自定义工具,与内置驱动合并展示"""
__tablename__ = "custom_tools"
name = Column(String) # "My CAN Analyzer"
tool_type = Column(String) # mcp | api | cli | external
endpoint = Column(String) # "http://localhost:8090/mcp"
category = Column(String) # software | hardware
config = Column(JSON) # 自定义配置
连通性测试按类型分支:
- MCP:HTTP GET探测MCP端点
- REST API:调用/health验证
- CLI:执行–version检查
- External:检查路径是否存在
10.3 合并展示
async def detect_toolchain():
# 1. 内置驱动检测结果
detection_results = registry.detect_all()
tools = [...] # 9个内置驱动
# 2. 合并数据库中的自定义工具
custom_tools = db.query(CustomTool).all()
for ct in custom_tools:
tools.append({
"id": f"custom_{ct.id}",
"name": ct.name,
"is_custom": True,
"tool_type": ct.tool_type,
})
前端统一展示所有工具的状态——无论是内置的IAR/J-Link,还是用户自建的MCP Server,都在同一个面板里。
十一、技术栈一览
| 前端 | React + Ant Design + Vite + Electron |
| 后端 | FastAPI + SQLAlchemy + SQLite |
| AI引擎 | OpenAI API + RAG(ChromaDB) |
| 驱动层 | python-can / pyserial / subprocess / tshark |
| 传输层 | MCP / REST / CLI / IDE Plugin |
| 数据库 | SQLite + ChromaDB(向量) |
| 项目配置 | .lattice/config.yaml + .lattice/tests/*.yaml |
十二、两个完整场景:从需求到验证
场景A:信号处理Bug修复
需求:“某个传感器信号经ADC采集后通过总线发送的值偏高,需要在软件中增加校准逻辑”
Step 1 — Orient(RAG检索项目知识库)
- 自动检索项目规格书中该传感器通道的定义、量程、分辨率
- 匹配到对应驱动模块的源码文件
- 关联历史变更记录中类似问题的修复方案
Step 2 — Plan(LLM规划 + 测试用例生成)
- 意图识别:bugfix → 选择 bugfix 工作流预设
- 代码变更:定位ADC转换模块,增加校准系数
- 同时生成4个测试用例:
- TC-001:编译零错误验证
- TC-002:CAN信号周期校验 → 期望目标报文按预期周期发送
- TC-003:诊断参数读取校验 → 期望返回值在规格书定义的有效区间内
- TC-004:串口输出验证 → 期望上电后输出初始化成功标志
Step 3 — Implement(代码应用)
- 应用1个文件变更(search/replace精确修改)
- 自动创建.lattice.bak备份,支持任意回滚
Step 4 — Build(编译器自动调用)
[build] PASS: 0 errors, 0 warnings
Step 5 — Close(归档 + 知识沉淀)
- 知识库增量索引本次变更涉及的文档
- 完整运行日志归档为JSON,支持后续审计
全程耗时:约2分钟。无需烧录,快速修复验证。
场景B:新功能全流程开发
需求:“增加一个新的CAN信号转发功能,从报文A读取信号X,转换后通过报文B发送”
Step 1 — Orient(RAG检索项目知识库)
- 检索总线数据库中报文A和报文B的定义、周期、信号X的解析公式
- 找到现有信号处理模块的代码结构和接口定义
- 匹配AUTOSAR配置中该通信矩阵的当前状态
Step 2 — Plan(LLM规划 + 测试用例生成)
- 意图识别:feature → 选择 full 完整工作流预设
- 代码变更:在信号处理模块中增加转发逻辑,更新通信矩阵配置
- 同时生成4个测试用例:
- TC-001:编译零错误验证
- TC-002:源信号接收校验 → 期望报文A中的信号X可正常读取
- TC-003:目标信号发送校验 → 期望报文B按预期周期发送转换后的信号值
- TC-004:诊断参数读取 → 期望新增配置项返回正响应
Step 3 — Implement(代码应用)
- 应用2个文件变更(信号处理模块 + 配置更新)
- 自动备份原始文件
Step 4 — Build(编译器自动调用)
[build] PASS: 0 errors, 0 warnings
Step 5 — Flash(调试器烧录)
[flash] 等待烧录确认…(唯一需要人工点击的步骤)
[flash] 用户确认 → 开始烧录 → PASS
Step 6 — Verify(自动化HIL测试)
- LLM针对性测试:4/4 通过(直接验证本次需求的改动)
- 默认回归套件:全部通过(确保基础连通性未被破坏)
- 测试结果自动写入项目级YAML文件,可版本控制
Step 7 — Close(归档 + 知识沉淀)
- 知识库增量索引本次变更涉及的文档
- 完整运行日志归档为JSON,支持后续审计
全程耗时:约3分钟。人工操作:点击1次“确认烧录”。
注意:以上为脱敏后的通用场景描述。实际项目中,RAG会检索到总线数据库中的精确信号定义、规格书中的参数范围等上下文,LLM据此生成可直接执行的测试参数。两种场景展示了Lattice的不同工作流预设——bugfix跳过烧录环节快速修复,full则走完从需求到硬件验证的全链路。
十三、设计亮点与工程反思
13.1 "平台能力 vs 项目产物"的边界
这是Lattice架构中最关键的设计决策:
- 平台能力(不可变):驱动抽象、工作流引擎、RAG、测试框架
- 项目产物(可变):测试用例YAML、配置文件、生成代码
读取一个总线信号不是一个"操作",而是一个"驱动方法"。"读哪个信号、期望什么值"才是测试用例——它应该下沉到项目层,可版本控制、可追溯。同样的原则适用于诊断读写、串口校验、编译验证等所有项目化能力。
13.2 LLM同时生成代码和测试
传统流程中,测试是开发之后写的。Lattice让LLM在Plan阶段就同时输出代码变更和测试用例,确保需求-代码-测试三者绑定。
13.3 “精确补丁"优于"整文件重写”
嵌入式C文件动辄数千行,整文件重写既低效又危险。Lattice的search/replace精确补丁机制让AI只改需要改的那3-5行,不碰文件其他部分——这是AI编码工具在嵌入式场景必须做出的架构选择。
十四、总结
Lattice证明了一件事:嵌入式开发的AI化不是"让AI帮你写代码"这么简单,而是要打通从需求到硬件验证的全链路闭环。
| 需求理解 | 人工翻阅规格书/原理图/数据库 | RAG自动检索项目知识库,跨格式统一检索 |
| 代码生成 | 手动编写,逐文件修改 | LLM生成search/replace精确补丁,不碰无关代码 |
| 代码应用 | 手动粘贴复制,难以回滚 | 四层安全保障:防穿越+存在性校验+自动备份+精确替换 |
| 编译 | 手动打开编译器→Build | 自动调用交叉编译工具链 |
| 烧录 | 手动打开调试器→Download | 一键确认 → 自动烧录 |
| 信号验证 | 手动打开总线工具→逐信号检查 | LLM生成测试用例 → YAML自动执行 |
| 诊断校验 | 手动发送诊断请求→读返回值 | 自动化HIL测试,需求针对性+回归基线双策略 |
| 串口调试 | 手动连接串口助手→观察输出 | 自动化串口校验,匹配预期模式 |
| 抓包分析 | 手动启动抓包工具→过滤分析 | tshark集成,支持DoIP/蓝牙/CAN-over-ETH |
| 配置管理 | 手动打开AUTOSAR工具→逐项配置 | MCAL/NEUSAR驱动集成,自动检测+项目级覆盖 |
| 回归测试 | 手动重跑所有用例 | 默认连通性套件自动回归 |
| 过程记录 | 散落在邮件/聊天记录/脑子里 | 结构化日志+计划快照+归档JSON,全程可追溯 |
| 版本控制 | 仅源码入Git,配置/测试/日志靠人工管理 | .lattice/目录随项目版本化,工作流自动提交 |
| 知识沉淀 | 存在工程师脑子里 | ChromaDB向量索引 + JSON归档,可检索可追溯 |
下一篇预告:车端AI(四)——AI驱动的AUTOSAR/MCAL配置
本文中的代码和架构均来自Lattice项目的真实实现,非概念设计。项目采用Python(FastAPI) + React技术栈,支持Windows本地部署。