如果你在 Python 里写下这一行:
c = torch.add(a, b) # a, b 是 CUDA Tensor,且 requires_grad=True
它最终会落在 GPU 上跑一段 CUDA kernel。但中间发生了什么?
很多人会含糊地说"Python 调了 C++,C++ 调了 CUDA"。这不算错,但远远不够——PyTorch 实际上经过了至少七层抽象才完成这次调用,而其中真正决定"走哪条路"的,是一个叫做 Dispatcher 的东西。
这篇文章把这一路彻底走一遍。读完你会知道:
- at::Tensor 为什么这么"轻",真正的数据结构在哪里
- Dispatcher 凭什么能优雅地处理 CPU/CUDA/Autograd/Sparse 这些维度的组合爆炸
- 为什么在源码里 grep "add_kernel_cuda" 经常什么都找不到
- Autograd 看起来很神秘,本质上其实只是 Dispatcher 的一个 key
- 自己怎么去探索、调试和验证这一切
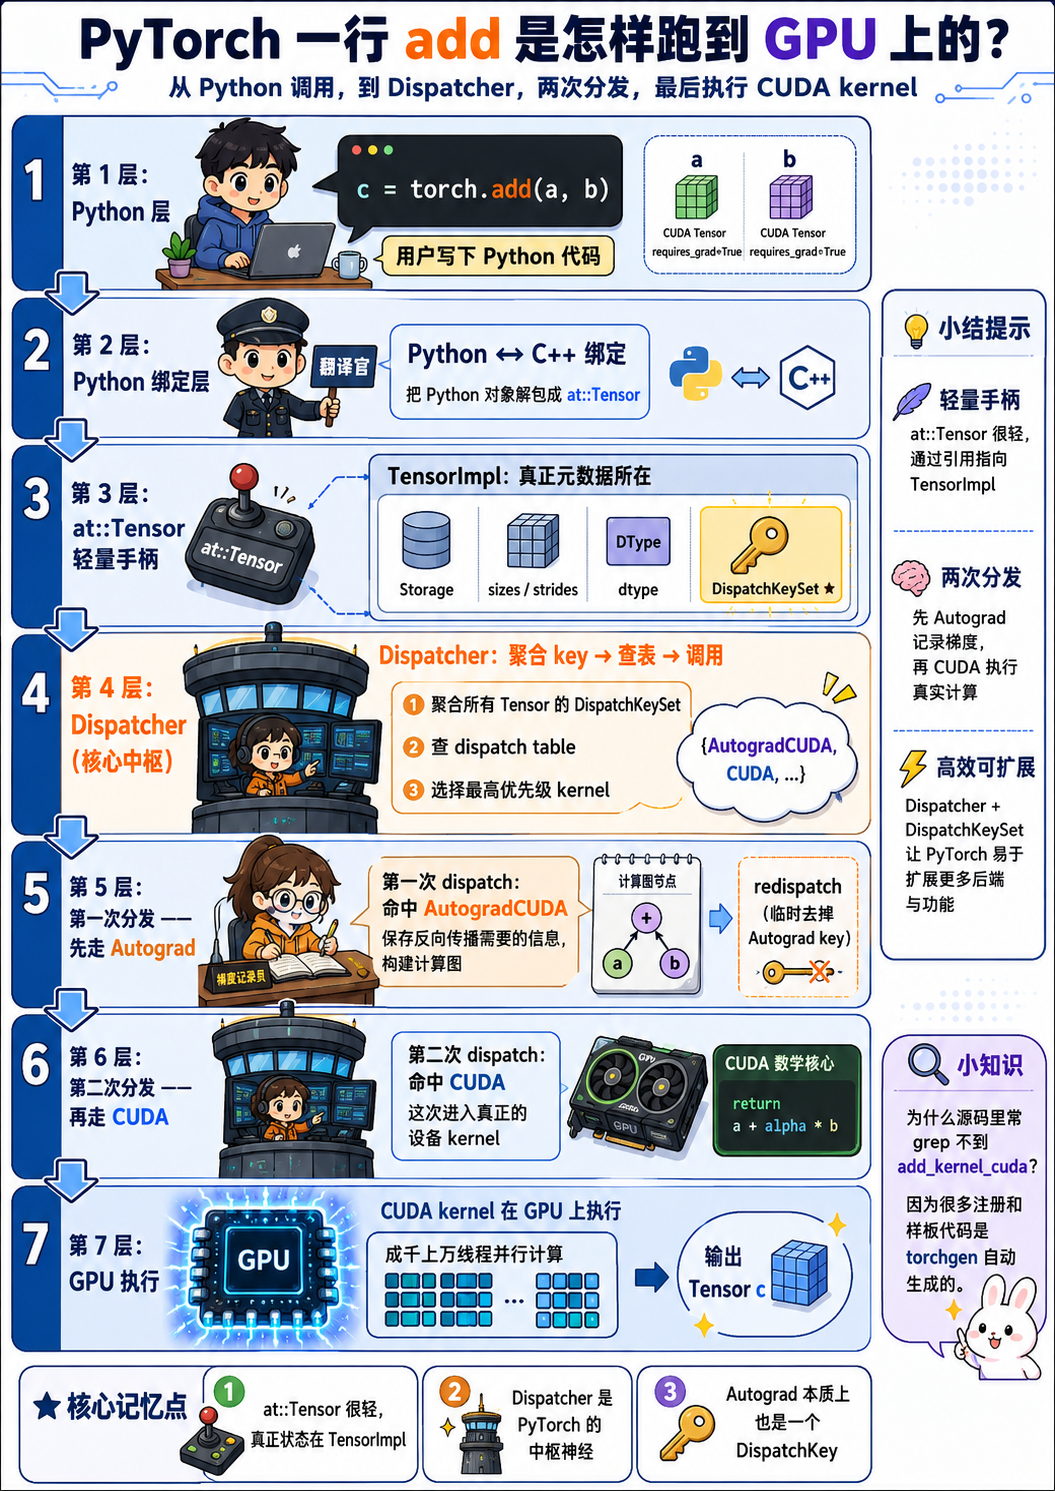
一、三层架构:c10 / ATen / torch
读 PyTorch 源码之前必须先认清这三个目录,它们职责完全不同:
| c10/ | 最底层基础设施 | TensorImpl、Storage、Device、DispatchKey |
| aten/src/ATen/ | 张量算子库 | 算子实现、TensorIterator、代码生成产物 |
| torch/ | 上层框架 | Python 绑定、Autograd 引擎、nn、torch.compile |
记住这个分层很重要:当一个 Python 调用进来,它自上而下穿过 torch → ATen → c10,最后再调起 CUDA Runtime。每一层都有自己的关注点,互不耦合。
二、Tensor 的真身:一个"轻量手柄"
Python 里的 torch.Tensor 看起来像是个 numpy array,但底层是这样一条引用链:
Python: x (THPVariable 对象)
│ cdata 字段
▼
C++ at::Tensor ← 这只是一个 intrusive_ptr,几乎没分量
│ impl_
▼
TensorImpl ← 元数据全在这里
├── Storage (data_ptr, 设备无关的内存句柄)
├── sizes_strides (形状)
├── dtype
└── DispatchKeySet ★ 决定算子走哪条路!
at::Tensor 本身只持有一个引用计数指针,可以随便按值传递。所有重要的状态都在 TensorImpl 上,而其中最关键的字段——也是这篇文章的主角——是 key_set_:一个 64-bit 的 bitmask。
一个普通的 CPU Tensor,它的 key_set 里有 CPU bit。 一个 CUDA Tensor,里面有 CUDA bit。 如果还带梯度,再加一个 AutogradCUDA bit。 如果它被某个 __torch_dispatch__ 包住,再加一个 Python bit。
这个 bitmask 完全决定了 Dispatcher 把这次调用送去哪个 kernel。
三、Dispatcher:PyTorch 的中枢神经
打开 aten/src/ATen/core/dispatch/Dispatcher.h,最热的那条路径其实只有几行:
template <class Return, class… Args>
inline Return Dispatcher::call(
const TypedOperatorHandle<Return(Args…)>& op,
Args… args) const {
// 1. 从所有 Tensor 参数里聚合 DispatchKeySet(按位 OR)
auto dispatchKeySet = op.operatorDef_->op.dispatchKeyExtractor()
.template getDispatchKeySetUnboxed<Args…>(args…);
// 2. 在 op 的 dispatch table 里查表,取最高优先级 key 对应的 kernel
const KernelFunction& kernel = op.operatorDef_->op.lookup(dispatchKeySet);
// 3. 直接调用(unboxed 快路径)
return kernel.template call<Return, Args…>(op, dispatchKeySet, args…);
}
三步:聚合 key → 查表 → 调用。整个 PyTorch 几千个算子、几十种后端,调度逻辑就压缩在这么几行里。
为什么能这么干净?因为它把"决策"和"实现"彻底解耦了:
- 决策靠 DispatchKeySet:调用现场动态决定走哪条路
- 实现靠各路 kernel 在静态初始化时往全局注册表里注册自己
注册的语法是这样:
TORCH_LIBRARY_IMPL(aten, CUDA, m) {
m.impl("add.Tensor", TORCH_FN(at::native::add_cuda));
}
每个 .cu / .cpp 文件里都散落着这种宏。它们在二进制加载时把自己挂到全局 Dispatcher 上,运行时按需查找。这是一种**开放注册(open registration)**模式——你想加一个新后端(比如 XPU、MPS、自定义加速器),不需要改任何核心代码,只要往里注册新 kernel 即可。
四、DispatchKey:64 位决定一切
c10/core/DispatchKey.h 定义了这个 enum,按优先级从高到低大致是:
FuncTorchDynamicLayerFrontMode ← torch.func 函数变换的最外层
Python ← __torch_dispatch__ 的入口
Autograd / AutogradCUDA ← 梯度跟踪
CUDA ← GPU 原生 kernel
CPU ← CPU 原生 kernel
CompositeImplicitAutograd ← 跨设备复合实现
DispatchKeySet 的核心操作只有一个:highestPriorityTypeId(),取出最高位作为本次调度的目标。
这里有个非常巧妙的设计——优先级排序本身就编码了语义:
这就解释了 Autograd 是怎么"无感插入"的:它不是装饰器,也不是猴子补丁,它就是一个比 CUDA 优先级高的 dispatch key。一个带 requires_grad=True 的 CUDA Tensor,它的 key_set 里既有 AutogradCUDA 又有 CUDA,Dispatcher 第一次查表先命中 AutogradCUDA,跑完构图逻辑后通过 redispatch 把这个 key 临时排除,重新查表,这次就命中 CUDA 了。
第一次 dispatch:
key_set = {AutogradCUDA, CUDA, …}
→ highest = AutogradCUDA → 跑 VariableType kernel(保存反向所需的输入)
VariableType kernel 内部 redispatch:
key_set = {AutogradCUDA, CUDA, …} & ~AutogradKeys
= {CUDA, …}
→ highest = CUDA → 跑真正的 CUDA kernel
整个 Autograd 的"魔法",归结起来就是一个临时位运算。
五、算子注册的真相:为什么 grep 不到 add 的实现
新人读 PyTorch 源码时常常困惑:
我想看 torch.add 的 CUDA 实现,grep "add_kernel_cuda"、grep "REGISTER_DISPATCH(add_stub",怎么源码里找不到?
答案是:它根本没在源码里手写。
PyTorch 有一个非常重要的事实:大量代码是构建时由 torchgen 自动生成的。生成的产物在 build/aten/src/ATen/ 下,包括 RegisterCUDA.cpp、Operators_*.cpp 等等。不构建一次,这些文件不存在;不知道这件事,就永远找不到 add 的真身。
生成的入口在哪?aten/src/ATen/native/native_functions.yaml——一个 1.8 万行的 YAML 文件,每个算子都在里面声明 schema 和分派规则。
以 add.out 为例(这是 add 的真正实现入口,add.Tensor 通过 structured_delegate 委托给它):
– func: add.out(Tensor self, Tensor other, *, Scalar alpha=1, Tensor(a!) out) -> Tensor(a!)
device_check: NoCheck
structured: True
structured_inherits: TensorIteratorBase
ufunc_inner_loop:
Generic: add (AllAndComplex, BFloat16, Half, ComplexHalf)
ScalarOnly: add (Bool)
dispatch:
SparseCPU, SparseMeta: add_out_sparse_cpu
SparseCUDA: add_out_sparse_cuda
MPS: add_out_mps
tags: pointwise
注意一个关键点:dispatch 块里没有 CPU、没有 CUDA。为什么?因为 ufunc_inner_loop 这个声明告诉 codegen:
"这是个 elementwise 算子,CPU 和 CUDA 的代码你自己生成,向量化和 kernel launch 都不用我管。"
开发者实际手写的代码只有两段:
① META 函数——只算形状和 dtype,不碰数据(BinaryOps.cpp):
TORCH_META_FUNC2(add, Tensor)(
const Tensor& self, const Tensor& other, const Scalar& alpha) {
build_borrowing_binary_op(maybe_get_output(), self, other);
native::alpha_check(dtype(), alpha);
}
② elementwise 内层逻辑——一行数学公式:
template <typename scalar_t>
struct add_functor {
scalar_t operator()(scalar_t a, scalar_t b, scalar_t alpha) {
return a + alpha * b; // 就这一行
}
};
剩下的 codegen 全包了:
- CPU 路径:套上 cpu_kernel_vec,吐出 AVX2 / AVX-512 向量化代码
- CUDA 路径:套上 gpu_kernel,生成 CUDA kernel launch
- 注册:在 RegisterCPU.cpp / RegisterCUDA.cpp 里完成 TORCH_LIBRARY_IMPL 注册
所以 add 的全部"实现",开发者写了大约 10 行代码。对于卷积、attention 这类复杂算子,才需要老老实实手写完整的 TORCH_IMPL_FUNC 和 CUDA kernel 文件。
这套机制是 PyTorch 能稳定支持几千个算子 × 十几种后端 × dtype 组合的根本原因——把样板代码外包给编译期。
六、完整链路:c = torch.add(a, b) 的七层旅行
把所有东西串起来,假设 a、b 是 CUDA Tensor 且 requires_grad=True:
① Python 层
c = torch.add(a, b)
↓
② Python ↔ C++ 绑定 (生成代码)
torch/csrc/autograd/python_torch_functions.cpp
THPVariable_add() —— 解包 PyObject 拿到 at::Tensor
↓
③ 算子入口 (生成代码)
build/aten/src/ATen/Operators_*.cpp
at::add() —— 查到 op handle,进入 Dispatcher
↓
④ Dispatcher.call()
aten/src/ATen/core/dispatch/Dispatcher.h
聚合参数 key_set = {AutogradCUDA, CUDA, …}
最高位 → AutogradCUDA → 查到 VariableType kernel
↓
⑤ Autograd kernel (生成代码)
– 保存 self/other 到 AddBackward0 节点
– AutoDispatchBelowADInplaceOrView 守护
– redispatch (排除 Autograd key)
↓
⑥ 再次进入 Dispatcher
key_set = {CUDA, …}
最高位 → CUDA → 查到 CUDA kernel
↓
⑦ CUDA kernel (生成 + 手写 lambda)
gpu_kernel(iter, [] __device__ (scalar_t a, scalar_t b) {
return a + alpha * b;
});
↓
⑧ GPU 硬件执行
整个流程里,Dispatcher 出场了两次。第一次走 Autograd(构图),第二次走 CUDA(计算)。没有什么神秘的"反向钩子",只有一次 key 的临时屏蔽和重新分发。
七、自己动手探索
最后给几个亲手验证的入口,比读多少文章都管用:
1. 打开 Dispatcher 调度跟踪
TORCH_SHOW_DISPATCH_TRACE=1 python -c "
import torch
a = torch.ones(2).cuda().requires_grad_(True)
b = torch.ones(2).cuda()
c = a + b
"
你会看到调度链一层一层地打印出来,AutogradCUDA → CUDA 看得清清楚楚。
2. 查看一个 Tensor 的 DispatchKeySet
import torch
x = torch.randn(3, device='cuda', requires_grad=True)
print(torch._C._dispatch_key_set(x))
# DispatchKeySet(CUDA, AutogradCUDA, ADInplaceOrView, …)
3. 用 __torch_dispatch__ 拦截任意算子
from torch.utils._python_dispatch import TorchDispatchMode
class Tracer(TorchDispatchMode):
def __torch_dispatch__(self, func, types, args=(), kwargs=None):
print(f"→ {func}")
return func(*args, **(kwargs or {}))
with Tracer():
a = torch.randn(3, device='cuda')
b = torch.randn(3, device='cuda')
c = a + b
# 输出: → aten.randn.default
# → aten.randn.default
# → aten.add.Tensor
这就是为什么 PyTorch 在 Python 这个 DispatchKey 上专门挂了一个 fallback——它让 Python 用户拥有了拦截整个框架任何算子的能力,构成了 torch.compile、functorch、量化、各种自定义后端的底层基础。
写在最后
如果说要总结 PyTorch 的核心设计哲学,我会说是这两条:
理解了这两点,你再去读 PyTorch 任何一个角落——量化、稀疏、MPS 后端、torch.compile——都会发现是同一套机制的不同应用。
PyTorch 不是"用 C++ 包装的 numpy",它是一个以 Dispatcher 为中心的、可扩展的张量计算调度系统。Python 只是它最常见的前端,CUDA 只是它最常见的后端。