导语
一株鼠源抗体获得良好的结合活性,并不意味着它已经接近药物候选物。
在真实研发流程中,发现阶段获得的抗体可能来自小鼠免疫、杂交瘤筛选、噬菌体展示或其他非人源抗体库。这些抗体能够识别靶点,却可能因为包含较多非人源序列,在人体内引起抗药抗体反应。研发团队因此需要对其进行人源化,在降低潜在免疫原性风险的同时,尽量保留亲和力、特异性、表达、稳定性和功能。
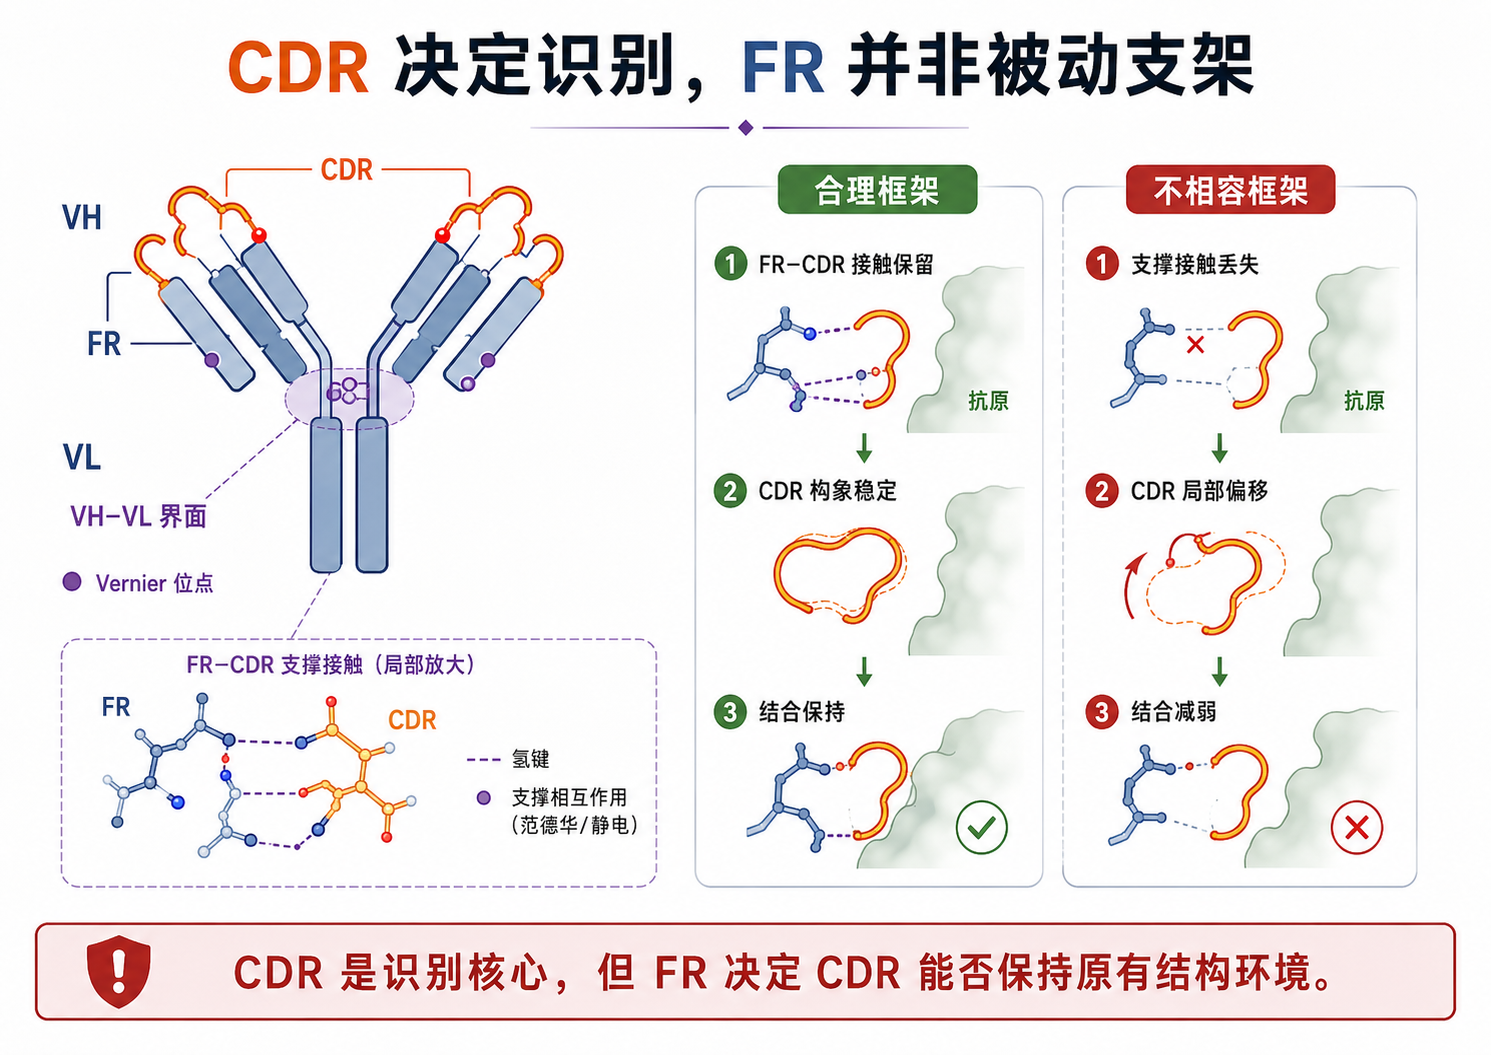
困难在于,抗体框架区并不是一个可以随意替换的惰性支架。
传统 CDR grafting 通常把非人源抗体的互补决定区移植到人抗体框架上。理论上,CDR 保留了主要的抗原识别信息,FR 则可以被人源框架替代。但在真实抗体中,部分 FR 残基会影响 CDR 主链构象、VH–VL 相对取向、局部氢键网络以及抗原结合界面。过度替换框架区,可能提高序列的人源性,却同时破坏原有结合活性。
因此,传统人源化往往需要经过多轮模板选择、CDR 移植、结构检查、回突变、表达和实验验证。流程低效的根源不只是计算速度慢,而是候选空间受少数模板限制,许多判断依赖专家经验,不同工具产生的结果又难以形成统一证据链。
HuDiff 试图改变的正是候选序列的产生方式。
它不要求研究人员先选择一个确定的人胚系模板,也不以亲本框架为基础逐位提出突变,而是保留 CDR,将完整 FR 视为需要重新生成的序列空间。模型通过学习大量天然抗体序列,尝试回答一个更开放的问题:
给定这一组 CDR,哪些人源框架可能与之相容?
这使抗体人源化从“选择一个模板并不断修补”,转向“生成多组框架候选,再通过多目标评价和实验验证完成收敛”。
HuDiff 解决的主要是候选生成问题,而不是完整的药物开发问题。它能够扩大可探索空间,却不能直接证明生成序列具有低临床免疫原性、稳定表达、良好制剂性质或可靠的体内功能。
从抗体在体内如何成熟,到为什么需要工程人源化
要理解 HuDiff,首先需要区分抗体的天然成熟与工程人源化。
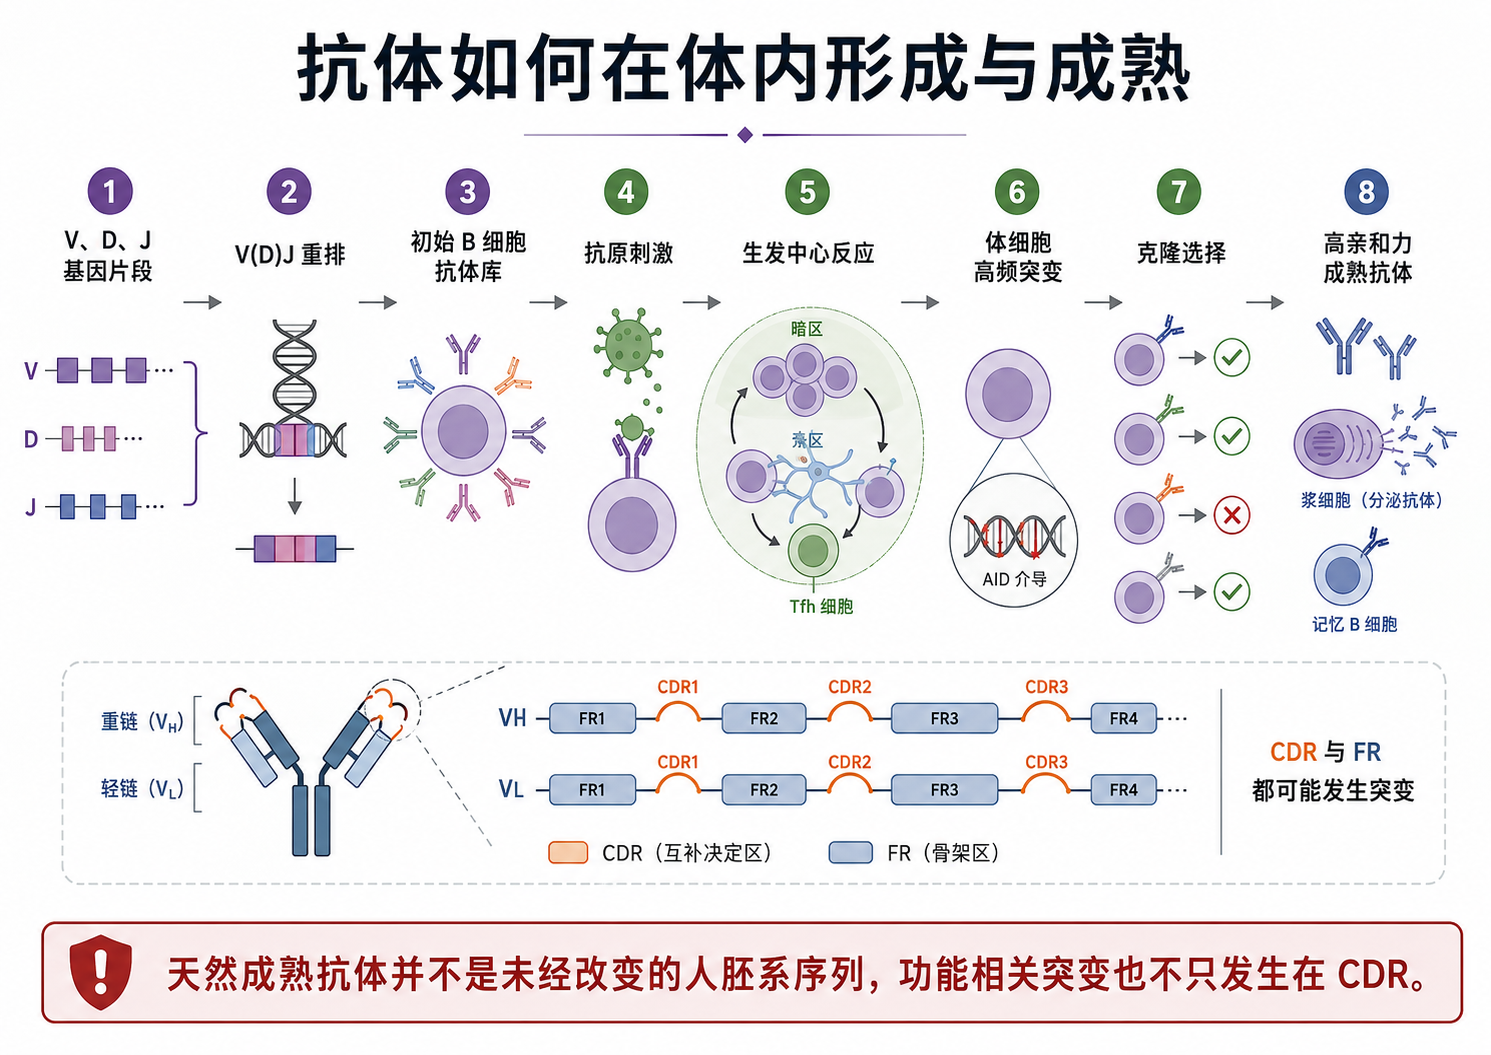
B 细胞发育过程中,免疫球蛋白可变区首先通过 V、D、J 基因片段的重排形成。不同基因片段的组合,加上连接区域的插入和缺失,使机体能够在接触抗原前形成极其多样的初始抗体库。
当 B 细胞识别抗原并进入生发中心后,其免疫球蛋白可变区会发生体细胞高频突变。突变产生大量亲缘序列,能够获得更多抗原并接受更强辅助信号的 B 细胞被选择和扩增,亲和力较差的克隆则逐渐被淘汰。经过多轮突变和选择,抗体群体的平均亲和力不断提升,这一过程即亲和力成熟。V(D)J 重排建立初始多样性,而体细胞高频突变与克隆选择进一步塑造高亲和力抗体。
这个过程说明了两个重要事实。
首先,成熟的人抗体并不等于未经突变的人胚系序列。天然人抗体同样可能积累大量突变,因此,Germline Identity 越高并不一定越接近真实成熟抗体,更不必然意味着功能更好。
其次,亲和力成熟产生的突变并不只发生在 CDR。部分 FR 突变同样可能参与 CDR 支撑、链间配对和结构稳定。框架区不能被简单理解为与功能无关的填充区域。
工程人源化与天然成熟的目标并不相同。
天然成熟是在抗原选择压力下提高亲和力和功能;工程人源化则是在保留既有结合能力的前提下,减少非人源序列特征。前者允许 CDR 和 FR 共同演化,后者通常需要尽量保留亲本 CDR,并谨慎调整框架区。
HuDiff 并没有模拟完整的生发中心反应,也没有以抗原结合为直接选择压力。它学习的是天然人抗体序列分布,并据此生成更具人源特征的框架。因此,它更接近“数据驱动的框架重建”,而不是体内亲和力成熟的数字复制。
文献速递
| 标题 | An adaptive autoregressive diffusion approach to design active humanized antibodies and nanobodies |
| 作者 | Jian Ma、Fandi Wu、Tingyang Xu、Shaoyong Xu、Wei Liu、Liang Yan、Minghao Qu、Xiaoke Yang、Qifeng Bai、Junyu Xiao、Jianhua Yao |
| 发表期刊 | Nature Machine Intelligence |
| 发表时间 | 2025 年 |
| 卷页 | Volume 7,1698—1712 |
| DOI | 10.1038/s42256-025-01120-9 |
| 预印本 DOI | 10.1101/2024.10.22.619416 |
| 主要训练数据 | OAS、PLAbDab、ABSD |
| 主要评价数据 | Humab25、HuAb348、Putative152、Nanobert18、Nano300 |
| GitHub 链接 | TencentAI4S/HuDiff |
| 数据与模型 | cloud77/HuDiff |
| 相关工具 | BioPhi/Sapiens、AbNatiV、Llamanade、AbNumber、OASis |
5分钟速览
研究任务
HuDiff 要解决的是抗体和纳米抗体的人源化候选生成:在保持 CDR 不变的前提下,为鼠源抗体或 VHH 重新生成更接近人抗体分布的框架区。
核心方法
模型在序列空间中逐步掩码 FR,再学习从保留的 CDR 和区域信息中恢复框架。HuDiff-Ab 联合处理配对 VH/VL;HuDiff-Nb 同时优化人源性与 VHH nativeness。
主要输入
常规抗体输入配对 VH 和 VL 序列,纳米抗体输入 VHH 序列。序列经过 IMGT 编号和区域划分,CDR 作为固定条件,FR 作为生成目标。
主要输出
输出为一组 CDR 不变、FR 不同的人源化候选序列。模型不直接输出最终药物候选,也不直接给出亲和力、稳定性或临床免疫原性结论。
关键结果
在公开数据集上,HuDiff 的人源性指标接近实验人源化抗体。最佳 2B04 人源化候选的 (K_D) 为 0.15 nM,接近亲本的 0.12 nM;最佳纳米抗体候选由 5.47 nM 改善至 2.52 nM。
文章判断
HuDiff 的价值在于把人源化从单模板改造转为多候选生成。它扩大了设计空间,但候选排序、结构复核、可开发性分析和实验验证仍然决定最终成功率。
核心术语
| CDR | 主要参与抗原识别的互补决定区 | 在 HuDiff 生成过程中保持不变 |
| FR | 支撑抗体折叠和 CDR 构象的框架区 | 模型主要重新生成的区域 |
| HuDiff-Ab | 面向配对 VH/VL 的人源化模型 | 联合生成重链和轻链框架 |
| HuDiff-Nb | 面向 VHH 的人源化模型 | 平衡人源性与纳米抗体 nativeness |
| 自回归扩散 | 按一定顺序逐步掩码并恢复离散残基 | 用于从 CDR 条件生成 FR |
| Humanness | 序列与天然人抗体分布的相似程度 | 训练引导和候选评价信号 |
| Germline Identity | 生成 FR 与最近人胚系框架的序列一致性 | 衡量生成框架是否接近合理人源框架 |
| Preservation | 人源化序列保留亲本残基的程度 | 判断人源化是否过度改变亲本 |
| Mutation Precision | 模型突变与实验人源化突变一致的程度 | 衡量模型是否改到了实验中常被修改的位置 |
| Vernier 残基 | 位于 FR、能够支撑或调节 CDR 构象的关键残基 | 回突变和结构复核的重要对象 |
方法是如何工作的
模型真正接收了什么
HuDiff-Ab 的输入是配对的抗体重链和轻链可变区序列。
模型并不是直接读取原始实验文件后自动识别所有生物学问题。输入序列需要先被正确截取,去除信号肽和恒定区,确认 VH/VL 配对关系,并识别轻链属于 κ 还是 λ 类型。
作者使用 IMGT 编号体系对序列进行对齐。重链被映射到固定长度 152,轻链映射到固定长度 139,两条链拼接后形成长度为 291 的模型输入。
每个位置不仅包含氨基酸 token,还带有三类附加信息:
-
它位于序列中的什么位置;
-
它属于 CDR 还是 FR;
-
它属于重链、κ 轻链还是 λ 轻链。
这些信息使模型能够区分相同氨基酸在不同结构区域和不同链中的含义。
需要特别强调的是,抗原并不是 HuDiff-Ab 核心生成模型的直接条件。
GitHub 脚本可以读取包含多条序列的 FASTA,但实际人源化脚本只提取描述中含有 heavy chain 和 light chain 的序列。模型没有利用抗原结构对每一个框架残基进行亲和力约束。抗原—抗体结构预测属于生成后的下游分析,而不是模型训练时的直接监督。
正向扩散:只保留 CDR,逐步抹去框架信息
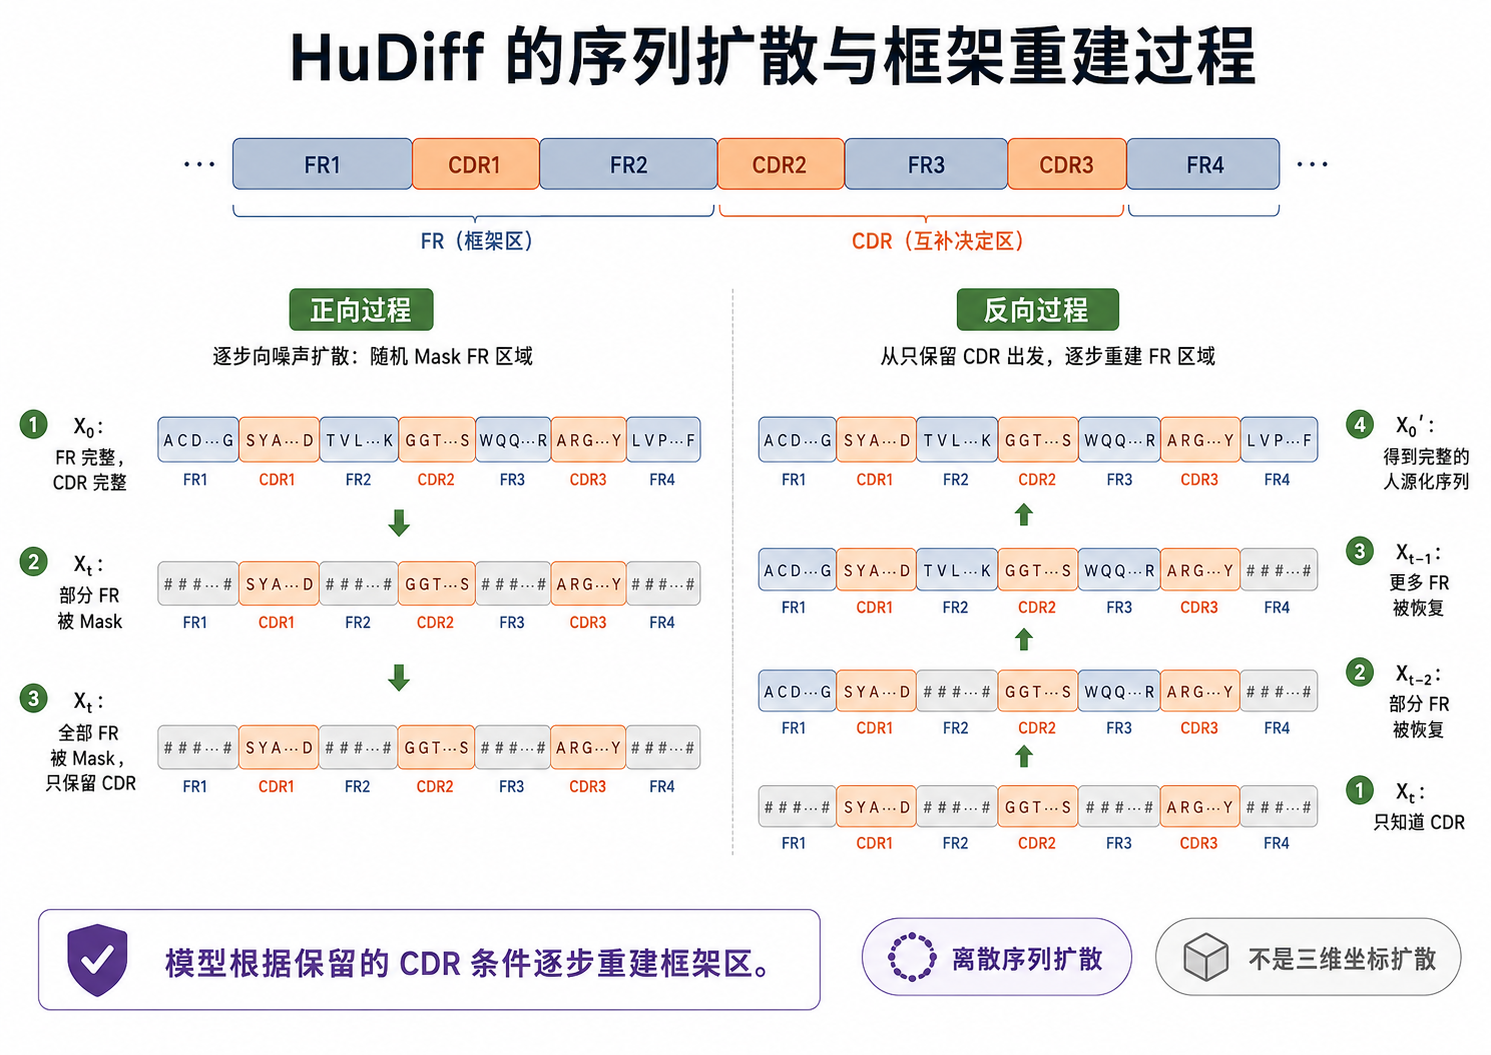
HuDiff 使用的是离散序列扩散,不是三维坐标扩散。
在训练开始时,模型拥有一条完整抗体序列。随着扩散时间步增加,FR 中越来越多的氨基酸被替换为特殊掩码 token,而 CDR 始终保持不变。
在最终时间步,原始 FR 信息几乎完全消失,模型只能看到:
-
完整 CDR;
-
残基所在区域;
-
残基位置;
-
重链与轻链类型;
-
尚待恢复的框架位置。
反向过程要求模型从这些信息中逐步恢复 FR。
从条件概率角度看,模型学习的是:
在天然人抗体序列中,给定这一组重轻链 CDR,什么样的框架残基组合更可能出现?
论文把这种终点状态称为 absorbing state。模型学习作为 denoiser,从掩码状态恢复完整的人抗体序列。
模型内部如何处理序列
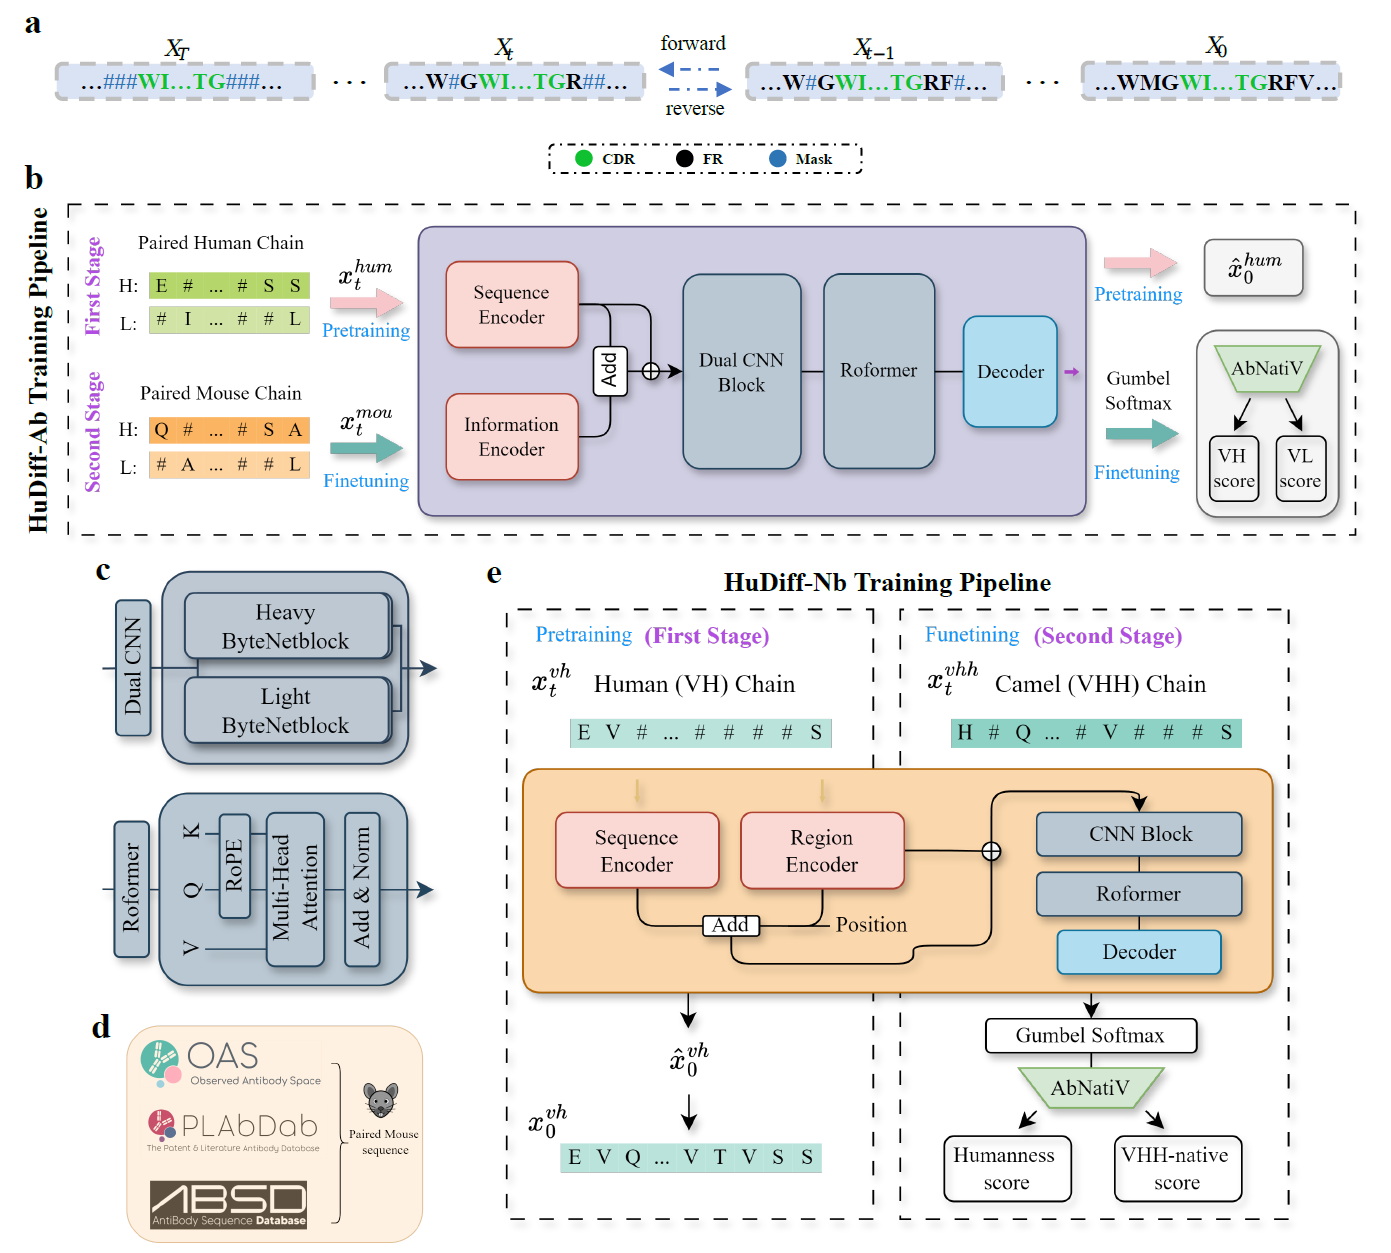
HuDiff-Ab 首先通过序列编码器把氨基酸 token 转换成隐藏向量。
随后,位置编码、区域编码和链类型编码被加入序列表征。单独使用氨基酸序列只能告诉模型“这个位置是什么残基”,附加编码则进一步说明“这个残基位于哪里、属于什么区域、来自哪条链”。
模型使用两条并行的 CNN 路径分别处理重链和轻链。论文将其称为 Dual CNN block,其内部使用 ByteNetBlock 提取链内局部模式。
局部特征重新拼接后,进入 RoFormer block。该模块通过自注意力学习更长距离的关系,使模型有机会捕捉:
-
同一条链不同 FR 与 CDR 之间的依赖;
-
重链与轻链之间的配对关系;
-
六个 CDR 之间的联合背景;
-
FR 对其他区域的统计约束。
最后,MLP 解码器把隐藏表示转换为每个待生成位置上 20 种氨基酸的概率分布。
需要克制理解“联合建模重轻链”的意义。
配对训练使模型能够学习天然序列中的跨链统计关系,但这不等同于显式理解 VH–VL 三维界面。模型并没有直接以链间距离、取向角或界面能量作为训练目标。
第一阶段训练:学习天然人抗体分布
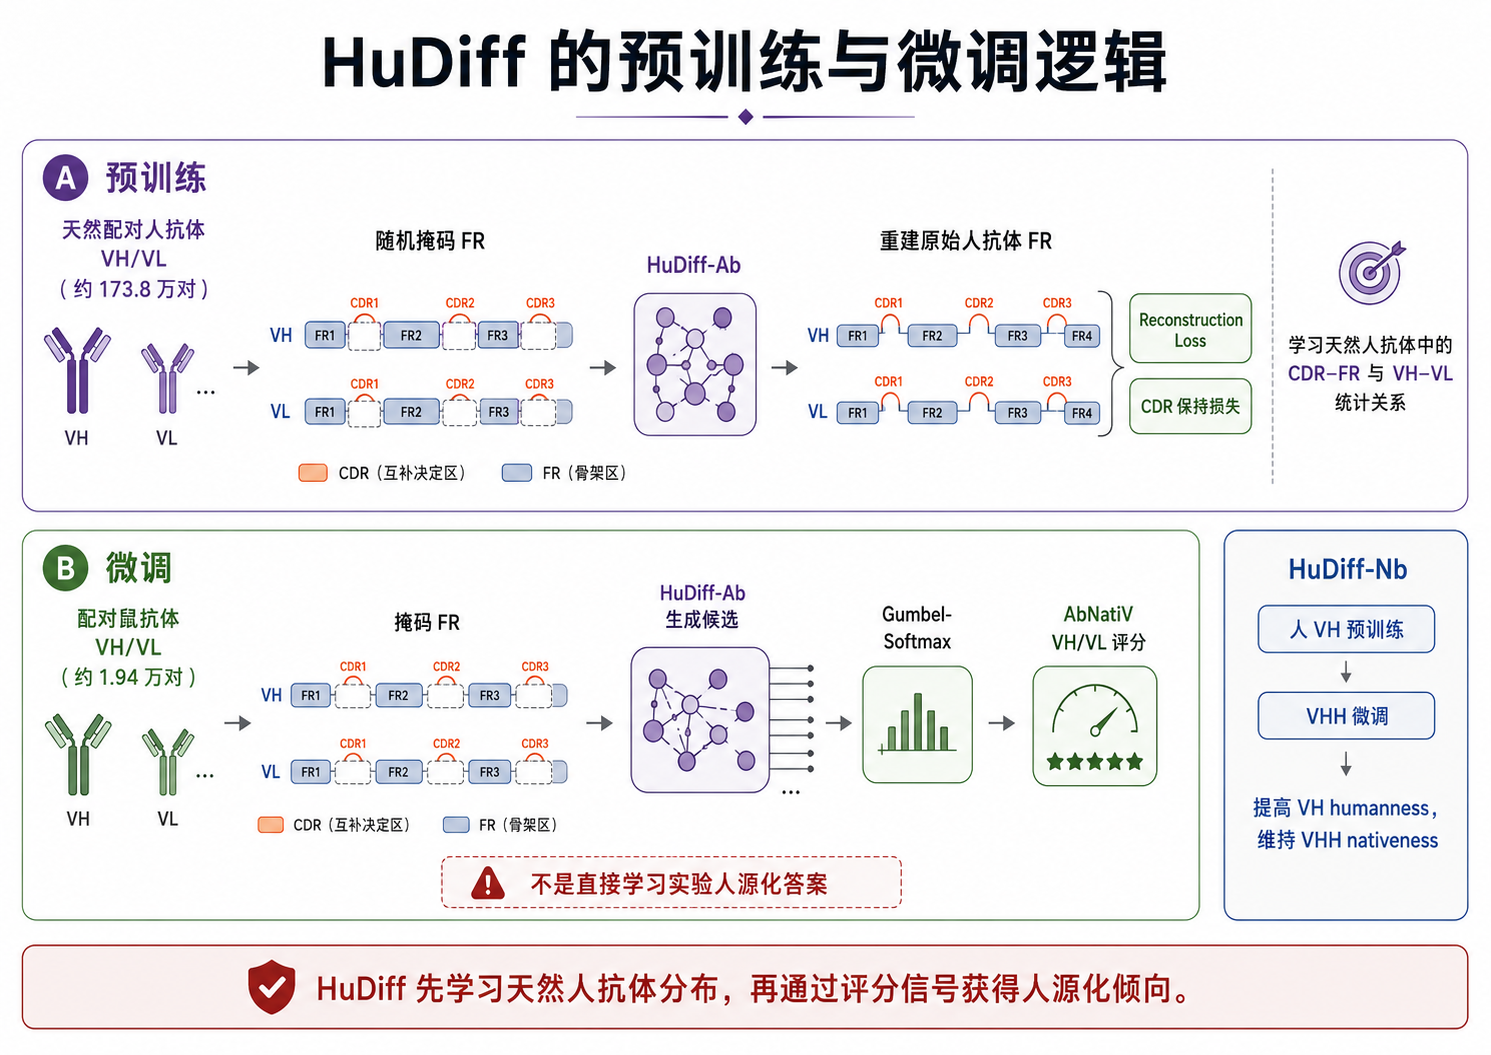
HuDiff-Ab 的预训练数据来自 OAS 中的天然配对人抗体序列。
作者最初获得约 195.4 万对序列,在去除 FR1 缺失、含未知残基和重复序列后,保留约 173.8 万对,并按照 19:1 划分训练集和验证集。
预训练时,模型接收处于不同扩散时间步的人抗体序列。部分 FR 已被掩码,CDR 仍然保留。模型需要预测原始未掩码的人抗体序列。
与固定从左到右生成的传统自回归模型不同,HuDiff 随机选择 FR 残基的恢复顺序。模型因此需要适应多种已知位置与未知位置组合。
这一阶段学习的不是“如何把鼠抗体变成人抗体”,而是“天然人抗体框架通常如何与 CDR 和另一条链共同出现”。
模型还加入辅助损失,要求输出中的 CDR 与输入保持一致。这样可以避免模型在重建 FR 时同时修改 CDR。
第二阶段训练:让模型具备人源化倾向
HuDiff-Ab 的微调数据来自 OAS、PLAbDab 和 ABSD,共约 1.94 万对鼠抗体序列。
这里需要注意一个容易被误解的问题:微调数据并不是近两万对严格对应的“鼠源亲本—实验人源化抗体”。
模型接收被部分掩码的鼠抗体序列,生成候选框架。输出 logits 经过 Gumbel-Softmax 转化为可微近似的 one-hot 表示,再输入 AbNatiV 的 VH 和 VL 模型计算 humanness。
训练目标是提高重链和轻链的人源性分数,同时通过辅助损失保持 CDR 不变。
Gumbel-Softmax 的作用,是解决离散氨基酸选择无法直接反向传播的问题。如果直接对 logits 使用 argmax,残基选择是离散操作,AbNatiV 分数的梯度无法回传到 HuDiff。Gumbel-Softmax 使用连续近似,使评分器能够参与模型微调。
因此,HuDiff-Ab 更准确的定义是:
一个在天然配对人抗体上预训练,再由 AbNatiV humanness 信号引导微调的条件框架生成模型。
它并没有直接学习亲和力,也没有从大量实验人源化项目中监督学习每一个正确突变。
推理阶段:候选是如何被生成的
推理时,输入的 VH 和 VL 首先经过 IMGT 编号。
程序保留六个 CDR,并为 FR 构建待生成状态。模型按照指定采样顺序,逐个位置计算氨基酸概率,再从概率分布中抽样得到一个残基。
已经生成的残基会进入下一时间步,成为后续预测的条件。经过完整反向过程后,模型得到一对完整的人源化 VH/VL。
由于每一步采用概率采样,同一亲本可以得到不同候选。论文比较了 shuffled order 和 left-to-right order,两种顺序的总体性能接近。作者也采用多次运行后按照 OASis、T20 或亲本相似度选择候选的方式,而不是把第一次生成结果视为唯一答案。
GitHub 推理脚本默认:
-
batch_size=10;
-
sample_number=10;
-
sample_order=shuffle;
-
输出为 sample_humanization_result.csv。
输出文件同时记录亲本序列和生成后的重轻链序列。
HuDiff-Nb 为什么需要另一套策略
纳米抗体只有 VHH,没有配对轻链。
普通 VH 中原本埋藏在 VH–VL 界面的部分残基,在 VHH 中会直接暴露于溶剂。因此,天然 VHH 的 FR2 往往具有与普通 VH 不同的残基组成,以维持可溶性和稳定性。
VHH 的 CDR,尤其 CDR3,在长度和组成上也与普通人 VH 存在明显差异。若模型只在人 VH 上训练,再直接处理 VHH,会产生分布外问题。
HuDiff-Nb 因此采用两阶段训练:
先在人 VH 序列上学习人抗体的 CDR–FR 关系,再使用 VHH 数据微调。微调时,AbNatiV VH 模型评价 humanness,VHH 模型评价 nativeness。
其主要目标不是简单同时最大化两个分数,而是在提高 VH humanness 的同时,避免 VHH nativeness 出现过大下降。
论文提供两种采样方式。
de 模式仅保留 CDR,重新生成完整 FR,能够产生更多样化的框架;inp 模式保留部分与 VHH 表达和稳定性相关的 FR2 残基,对其他位置进行 inpainting。
前者探索更充分,后者约束更强。它们代表不同的风险偏好,而不是简单的优劣关系。
数据和评价能证明什么
核心数据应如何阅读
论文表 1 的 OASis 和 T20 数值表示人源化序列相对于亲本的绝对分数提升,不是相对百分比增长。
| HuAb348 实验人源化 | 29.91% | 11.30% | 89.51% | 91.72% |
| HuAb348 Sapiens1 | 29.67% | 9.85% | 86.06% | 89.43% |
| HuAb348 straight graft | 35.13% | 14.55% | 94.71% | 96.37% |
| HuAb348 Vernier graft | 30.35% | 12.15% | 90.79% | 94.49% |
| HuAb348 HuDiff-Ab | 31.93% | 11.32% | 91.44% | 87.43% |
| Humab25 实验人源化 | 33.82% | 13.10% | 89.36% | 94.47% |
| Humab25 Sapiens1 | 29.70% | 10.20% | 84.61% | 89.75% |
| Humab25 straight graft | 36.17% | 14.56% | 94.59% | 96.27% |
| Humab25 Vernier graft | 32.00% | 12.12% | 91.00% | 94.88% |
| Humab25 HuDiff-Ab | 33.07% | 11.46% | 90.32% | 87.96% |
这些数据最值得关注的不是哪一行最高,而是 straight graft 往往获得最高 humanness 和 Germline Identity,却未必最接近实验人源化结果。
这支持了一个重要判断:人源化不是把所有 FR 尽可能替换成人胚系残基,而是在降低非人源特征与保持原有结构之间寻找平衡。
Preservation 的结果进一步表明,HuDiff-Ab 的整体亲本保留程度比 Sapiens1 更接近实验人源化抗体;但在 Vernier 残基保留和 Mutation Precision 上,HuDiff-Ab 弱于 Sapiens。
这与其模型机制一致。Sapiens 以亲本 FR 为输入,更容易沿亲本序列进行局部修改;HuDiff 不依赖原始 FR 生成框架,因此能够产生更高多样性,却也更可能改变真实项目中通常会保留的 Vernier 位点。
数据是否存在泄漏和选择偏差风险
HuDiff-Ab 使用约 173.8 万对人抗体进行预训练,并使用约 1.94 万对鼠抗体进行微调。HuDiff-Nb 使用约 339.6 万条人 VH 预训练和约 84.1 万条 VHH 微调。
论文报告了去重,但公开方法没有充分展示按照高序列相似度、克隆型、CDR3 聚类、胚系家族或专利家族进行严格跨数据集去污染的结果。
抗体数据库中常存在高度近似序列。完全重复序列被去除,并不意味着训练集和测试集之间不存在高 identity 近邻。
随机 19:1 的训练—验证划分也主要证明同分布重建能力,不能充分证明模型面对新胚系、新型 CDR 组合或极端长 CDR3 时的外推性能。
Humab25 只有 25 对实验人源化抗体,样本量较小。HuAb348 虽包含 348 对序列,却主要来自专利。专利更容易披露成功或具有保护价值的候选,失败设计往往不完整,因此存在明显的成功案例选择偏差。
评价指标是否与真实任务匹配
OASis、T20、AbNatiV、H score、AbLSTM 和 Germline Identity 都主要衡量序列的人源特征。
它们不能直接回答以下问题:
-
是否正确折叠;
-
是否维持原亲和力;
-
是否稳定表达;
-
是否容易聚集;
-
是否产生非特异性结合;
-
是否在人体内具有较低免疫原性。
还需要注意,HuDiff 微调阶段已经使用 AbNatiV 作为优化信号,论文又使用 AbNatiV 评价结果,存在一定程度的“按照评价器优化”问题。
作者同时引入 OASis、T20、H score、AbLSTM、Germline Identity 和湿实验,降低了单一评分器循环验证的影响,但不能完全消除这一风险。
论文的湿实验是最重要的证据。
作者表达并检测了少量人源化候选。最佳 2B04 候选保持了接近亲本的 BLI 亲和力,最佳 3-2A2-4 纳米抗体候选的亲和力有所提高。正式版本还增加了第二个纳米抗体案例和病毒中和验证。
不过,这些实验只能证明 HuDiff 能够产生成功候选,不能证明所有新项目都具有稳定成功率。论文没有完整公开从全部生成序列到最终实验候选的淘汰漏斗,也没有通过前瞻性盲测估计整体命中率。
最小MVP:安装、验证 并测试HuDiff
MVP 的目标不是证明某条序列已经完成人源化,而是验证四件事:
环境能够建立,checkpoint 能够加载,输入能够正确解析,模型能够输出保持 CDR 的候选序列。
建立运行环境
官方仓库提供 environment.yaml,其主要环境包括 Python 3.9、PyTorch 1.13.0、CUDA 11.6、LMDB、AbNumber、sequence-models、pandas 和 scikit-learn 等。
git clone https://github.com/TencentAI4S/HuDiff.git
cd HuDiff
conda env create -f environment.yaml
conda activate hudiff
可以先检查 PyTorch 和 GPU 是否可见:
python – <<'PY'
import torch
from abnumber import Chain
print("PyTorch:", torch.__version__)
print("CUDA available:", torch.cuda.is_available())
print("GPU:", torch.cuda.get_device_name(0) if torch.cuda.is_available() else "CPU")
PY
推理脚本会在 CUDA 可用时使用 GPU,否则退回 CPU。官方环境主要围绕 CUDA 11.6 配置,因此 MVP 更适合在兼容 NVIDIA GPU 的 Linux 环境中测试。
准备模型文件
作者通过 Hugging Face 发布了预处理 LMDB 数据和 HuDiff-Ab、HuDiff-Nb 微调 checkpoint。发布包不包含预训练阶段 checkpoint,但完成普通推理只需要微调后的模型。
可以通过支持 Git LFS 的方式获取:
git lfs install
git clone https://huggingface.co/cloud77/HuDiff HuDiff_release
下载完成后解压发布包,并寻找模型:
tar -xzf HuDiff_release/release_data_dir.tar.gz
find . -name "hudiffab.pt"
find . -name "hudiffnb.pt"
若解压后的路径与 README 示例不同,只需在运行时通过 –ckpt 指向真实文件位置。
准备最小 FASTA 输入
对于抗体 MVP,建议优先使用 FASTA 文件,而不是直接传递 –heavy_seq 和 –light_seq。
当前脚本根据 FASTA 描述中的字符串识别链:
>mvp antibody heavy chain
EVQL…
>mvp antibody light chain
DIQMT…
描述中必须包含小写形式的 heavy chain 和 light chain。脚本不会根据序列本身自动推断哪条是重链或轻链。
虽然 README 提供了直接输入重链和轻链参数的方式,但当前脚本把 anti_complex_fasta 的默认值设置为一个非空路径,并优先读取 FASTA。若不修改代码,直接序列参数可能被默认 FASTA 分支覆盖。
因此,MVP 阶段使用 FASTA 更稳妥。若确实需要直接序列输入,应将脚本中的默认值改为:
default=None
并确保只有在用户明确提供 –anti_complex_fasta 时才进入 FASTA 分支。README 与当前脚本在这一点上存在实现不完全一致的问题。
执行最小推理
python antibody_scripts/sample_for_anti_cdr.py \\
–ckpt /path/to/hudiffab.pt \\
–anti_complex_fasta mvp_antibody.fasta \\
–batch_size 10 \\
–sample_number 10 \\
–sample_order shuffle \\
–log_dirpath mvp_output
脚本会创建带时间信息的结果目录,并保存:
sample_humanization_result.csv
可以定位输出:
find mvp_output -name "sample_humanization_result.csv" -print
CSV 中第一行候选通常是标准化后的亲本序列,后续为模型生成的人源化序列。脚本会尝试去除完全重复的 VH/VL 组合。
MVP 不能只检查“程序没有报错”
最小验收至少应确认:
输入重链和轻链被正确识别;输出中没有 X、异常截断或长度错误;每条候选可以被 IMGT 编号;六个 CDR 与亲本一致;FR 确实发生变化;输出数量和唯一序列数量符合预期。
还应特别注意随机种子。
脚本接受 –seed 参数并把种子写入日志,但当前代码中的 seed_all(args.seed) 被注释掉。这意味着仅修改 –seed 未必能够获得严格可复现的采样结果。企业或严谨复现项目应恢复种子初始化,并同时固定 NumPy、PyTorch CPU 和 CUDA 随机状态。
因此,MVP 验证通过的标准不应只是“生成了 CSV”,而应是:
输入可追溯、CDR 未被改变、模型版本明确、随机过程可控、结果可以重复检查。
企业如果要构建这样的系统,需要做哪些改动
开源 HuDiff 解决了候选生成,却没有直接提供企业级的人源化决策系统。
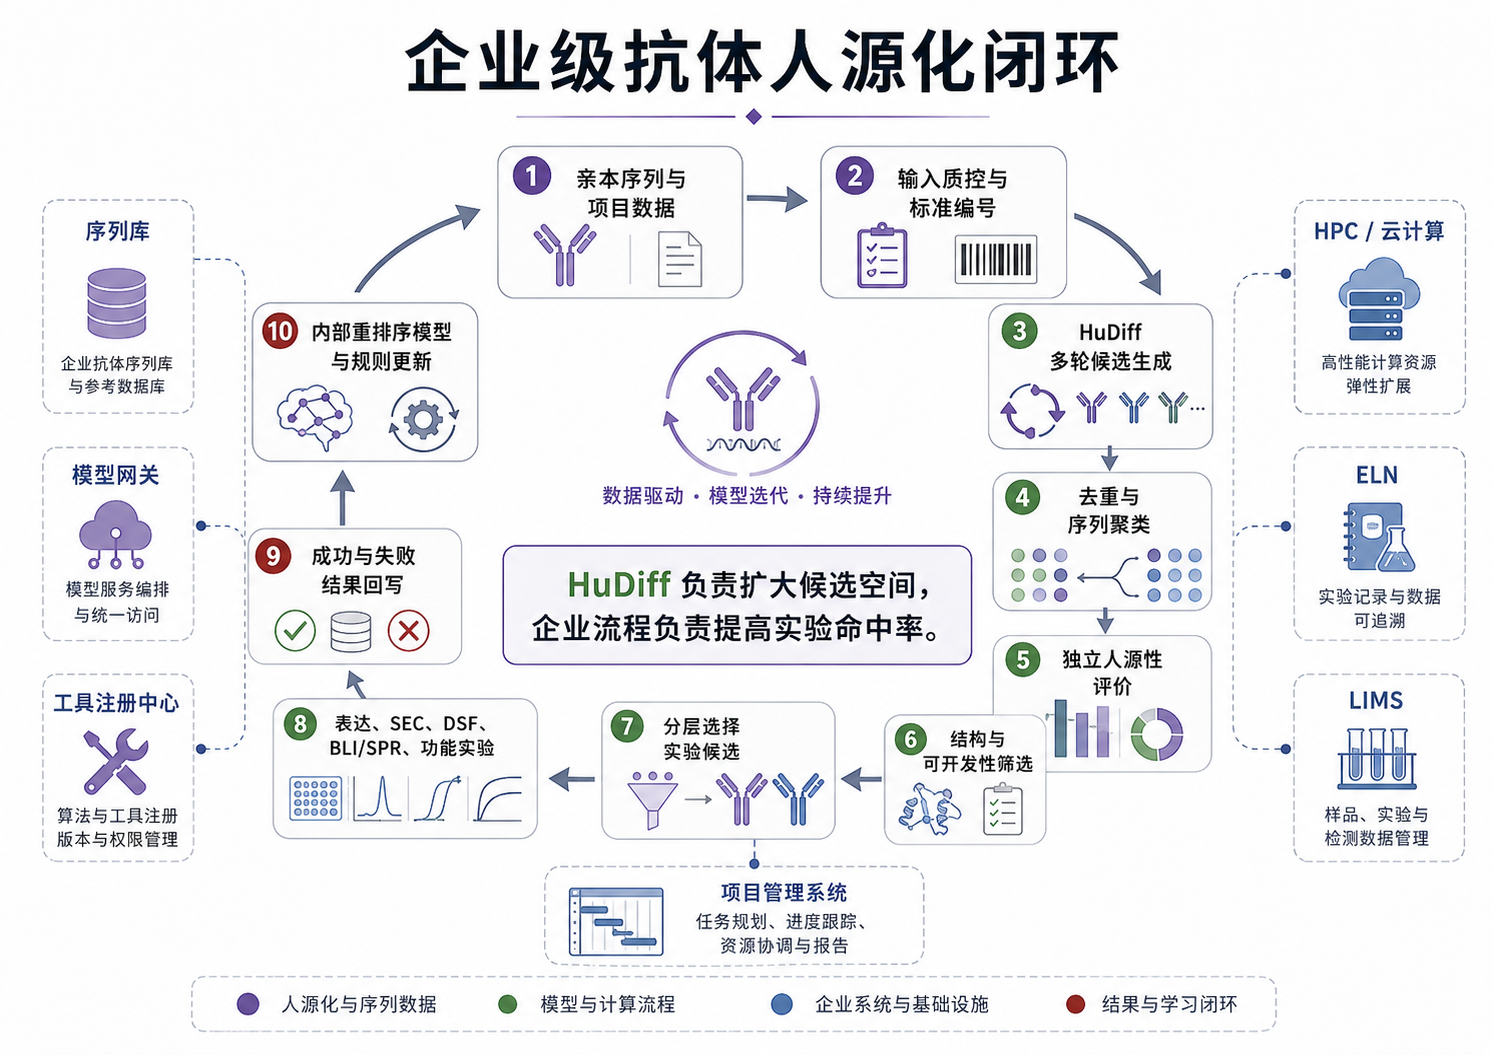
企业侧真正需要建立的是“输入质控—多样化生成—独立筛选—结构复核—实验验证—结果回流”的闭环。模型只是其中一个节点。
先把序列输入变成受控数据对象
企业内部常同时存在原始测序序列、成熟可变区序列、表达构建序列和完整 IgG 序列。HuDiff 的输入必须明确是哪一个版本。
每次任务都应绑定:
-
项目和分子编号;
-
亲本序列版本;
-
VH/VL 配对关系;
-
κ/λ 链类型;
-
CDR 定义与编号体系;
-
输入文件哈希;
-
模型和 checkpoint 版本。
这些信息决定后续回突变、结构分析和实验样品能否被准确追溯。编号体系不明确,可能导致计算人员、抗体工程师和实验人员讨论的并不是同一个残基。
不要把 HuDiff 分数直接当成实验排序
提升实验验证命中率的关键,不是让 HuDiff 一次只生成“最优候选”,而是先生成足够多样的候选,再使用彼此独立的标准收敛。
候选筛选至少需要同时考虑四个方向:
人源性是否提高,亲本关键区域是否得到保留,结构环境是否合理,以及基础可开发性是否出现明显风险。
AbNatiV 已经参与 HuDiff 微调,因此企业不应仅使用 AbNatiV 对生成结果排序。更稳妥的方式是同时引入未参与模型训练的评分、Germline Identity、OASis、T20、亲本 Preservation、序列 liabilities 和结构评价。
这不是为了堆叠更多分数,而是减少模型针对单一评价器取得高分却失去真实功能的风险。
把候选分组,而不是只取总分前几名
如果模型生成 50—200 条候选,企业不宜把多个指标简单加权成一个综合分数,再选择排名前五。
更合理的做法是先进行序列聚类和多目标分层,使实验面板覆盖不同设计逻辑。例如可以保留:
-
人源性较高但框架变化较大的候选;
-
人源性与亲本保留较平衡的候选;
-
Vernier 和 VH–VL 界面保存较好的候选;
-
经过结构指导回突变的候选。
实验面板的目的不仅是寻找一条最好序列,还要区分失败来自人源化幅度、特定框架位点、链间配对,还是结构支撑网络。
这种分层设计通常比表达一组高度相似的“综合分最高候选”更有信息价值,也更有利于提高第二轮设计的准确性。
用结构模型排除明显不相容候选
HuDiff 不以抗原为直接条件,因此企业侧应增加独立的结构复核层。
对候选进行抗体单体或复合物结构预测时,不应只查看全局 RMSD。更重要的是比较:
-
CDR 主链构象;
-
VH–VL 相对取向;
-
抗原界面接触;
-
Vernier 位点;
-
FR–CDR 氢键;
-
埋藏极性残基;
-
新增空间冲突;
-
局部置信度。
结构模型适合排除明显风险,而不适合精确预测候选间很小的亲和力差异。关键候选可以采用多个结构模型或多个随机种子,避免依据单次预测做决定。
对于可能影响 CDR 构象的 FR 突变,可进一步使用局部分子动力学、接触频率分析或定点回突变验证。计算深度应与决策重要性匹配,而不是对全部生成候选执行高成本模拟。
通过实验面板提高命中率,而不是要求模型保证成功
企业要提升的不是单次检测仪器的“准确率”,而是进入实验的候选命中率以及实验结果的可解释性。
第一轮实验应保留亲本作为基准,并加入传统 graft、HuDiff 原始候选和结构指导回突变候选。这样才能判断 HuDiff 的增益来自哪里。
实验评价不宜只做一个终点 ELISA。至少应把表达与纯化质量、SEC 单体比例、热稳定性、BLI/SPR 动力学和功能检测连接起来。
某条候选可能保留终点结合信号,却因为表达低、聚集高或解离速度明显变快而不适合继续开发。只有多维实验数据才能帮助企业建立真正有效的候选排序模型。
把失败结果写回系统
企业长期优势不会来自永久使用同一个公开 checkpoint,而来自内部人源化数据闭环。
每个候选都应保存:
-
生成来源和模型版本;
-
各项序列与结构评分;
-
人工修改和回突变理由;
-
是否进入表达;
-
表达、纯化和检测结果;
-
淘汰原因。
失败候选不能被删除。
如果内部数据库只保存最终成功序列,后续模型会形成严重的幸存者偏差。低表达、聚集、亲和力下降和回突变无效的数据,才是训练企业内部排序模型和校准风险阈值的重要材料。
随着项目积累,企业可以使用历史实验数据训练轻量级重排序模型。HuDiff 负责扩大候选空间,企业模型负责根据自身表达体系、靶点类型和开发标准进行选择。
企业构建此类系统的风险和问题
人源性高不等于实验成功
HuDiff 最容易被误用的方式,是把 humanness 或 Germline Identity 最高的候选直接送入实验。
传统 straight graft 往往能得到更高的人源性分数,却可能损害亲和力。企业应把人源性视为约束之一,而不是唯一优化目标。
更稳妥的策略是设置合理下限,候选达到基本人源性要求后,优先比较结构保持、亲本关键残基、可开发性和候选多样性。
模型没有看到抗原
HuDiff 的生成目标没有直接包含抗原结构和结合能,因此它无法保证新 FR 一定维持原有界面。
企业可以通过复合物建模、界面分析和实验动力学降低这一风险,但不能把结构预测结果重新包装成确定的亲和力结论。
如果某个项目高度依赖特殊 CDR 构象、pH 敏感机制或框架参与抗原接触,HuDiff 候选应接受更严格的结构复核,而不是沿用普通人源化阈值。
评分器之间并不独立
AbNatiV 参与 HuDiff 微调,再用 AbNatiV 评价生成结果,会高估模型在这一指标上的独立证据强度。
企业应保留独立评分器,并使用自身实验数据校准模型输出。不同评分器一致时可以增强信心;评分冲突时,应进入人工复核,而不是强行计算综合分。
工具错误可能伪装成生物学结果
错误的链识别、CDR 划分、编号转换和 checkpoint 路径,都可能产生看似正常的序列。
企业系统必须对每个工具设置输入校验和失败状态。编号失败不应自动进入下一步,结构预测失败也不能被解释为候选结构不稳定。
每次运行需要记录代码 commit、容器镜像、模型哈希、参数、随机种子、日志和输出文件。
生成结果的可复现性不足
当前脚本中的种子初始化被注释,采样又包含随机多项式抽样。若企业不修复这一问题,同一参数下可能无法严格复现历史候选。
生产系统应固定随机状态,并保存每轮候选,而不是只保存筛选后的最终序列。模型升级后还需要使用固定亲本集合执行回归测试,比较候选分布和排序是否发生漂移。
内部专有序列可能泄漏
VH/VL 序列、未公开靶点和实验结果都是企业核心知识产权。
HuDiff 可以本地运行,企业没有必要把专有序列发送至公共 Notebook 或在线分析服务。需要使用外部结构预测或大模型服务时,应明确数据是否离开内网、是否被保留,以及是否可能用于服务方训练。
开源并不等于可直接商业使用
HuDiff GitHub 仓库当前使用 PolyForm Noncommercial License 1.0.0,许可文本把允许目的限制在非商业用途等范围;Hugging Face 模型页面则标注 AFL-3.0。代码、checkpoint 和数据的授权范围需要分别核实。商业药物研发团队不应因为资源可以下载,就默认能够直接用于商业项目。
实验结果也可能产生选择偏差
如果企业只表达综合分最高的少数候选,后续可能无法判断模型究竟在哪类序列上有效。
实验批次应保留一定设计多样性和对照,包括亲本、传统 graft、HuDiff 候选和回突变候选。这样获得的数据不仅用于挑选当前项目,也能够评估模型本身。
对药物研发有什么价值
HuDiff 最直接的价值,是把人源化设计从单一模板扩展为多候选框架探索。
对于传统流程,一个模板选择错误可能导致整轮设计都围绕错误框架展开。HuDiff 能够在相同 CDR 条件下产生多种 FR 组合,为团队提供更大的初始设计空间。
它也改变了回突变的使用方式。
传统回突变通常是在 CDR grafting 后恢复亲本关键残基。HuDiff 中,研究人员可以比较多个独立生成框架,识别哪些亲本位点在高质量候选中被反复保留,哪些 FR–CDR 接触可能需要恢复。
在研发知识沉淀方面,每一条生成序列都可以被连接到人源性、亲本保留、结构分析、表达和功能结果。长期积累后,企业可以从“依赖个别专家经验”逐步转向“专家判断与内部证据共同驱动”。
但 HuDiff 不适合直接替代正式免疫原性分析、亲和力确认、功能实验、安全性评价和临床判断。
它改变的是候选如何被提出,而不是药物研发如何建立最终证据。
论文没有解决什么
HuDiff 没有直接预测人体免疫原性。Humanness 反映序列是否接近人抗体分布,却不能直接预测抗药抗体发生率、T 细胞表位呈递或不同 HLA 人群风险。
它没有把抗原和三维结构纳入生成目标。模型能够学习序列统计关系,却无法显式保证 CDR 构象、VH–VL 几何和抗原界面得到保持。
它没有统一优化表达、热稳定性、聚集、黏度、非特异性结合和化学修饰风险。保持亲和力并不等于保持全部可开发性质。
它没有提供经过校准的成功概率。多次采样能够产生不同候选,却不能直接告诉研究人员某一候选保持活性的概率。
它没有完整披露所有生成序列到实验候选的淘汰过程,因此无法从论文直接估算新项目的平均实验命中率。
它没有形成自动实验闭环。湿实验用于证明候选有效,但结果没有进一步回流模型并完成下一轮自动优化。
它也没有解决企业级权限、审计、版本管理、ELN/LIMS 集成和商业授权问题。
模型启发
技术价值
HuDiff 的技术意义,在于把框架区人源化从逐位突变推荐转化为条件序列生成。
模型不必围绕一个固定模板搜索,而是可以根据 CDR 生成多种 FR。配对 VH/VL 建模也说明,抗体设计不应始终把两条链作为完全独立的对象。
未来更值得关注的方向,是把抗原条件、结构几何、可开发性和实验反馈纳入生成与重排序,而不是只继续扩大序列模型。
研发价值
HuDiff 更适合被放在候选生成层。
模型生成多样化序列,独立工具完成多目标筛选,结构计算排除明显风险,专家提出回突变与实验面板,湿实验负责最终裁决。
这种流程不会消除专家,而是把专家工作从手工枚举序列转向制定评价标准、解释结构风险和设计高信息量实验。
产业价值
HuDiff 所代表的未来产品形态,不是一个输入序列后返回“最佳答案”的网页,而是抗体工程工作台中的生成模块。
企业真正需要建设的,是模型、序列库、结构工具、实验数据库、审批流程和项目知识之间的连接。
通用模型可以降低候选生成门槛,企业自己的“亲本—设计—表达—性质—功能”数据闭环,才是长期难以复制的资产。
总体判断
HuDiff 没有终结传统 CDR grafting,也没有证明生成模型可以独立完成抗体人源化。
它真正展示的是一种新的设计方式:不再把人源化限定为在少数人胚系模板上逐位修补,而是根据 CDR 生成多个可能的框架,再通过人源性、亲本保持、结构、可开发性和实验共同完成选择。
这项工作已经从计算评价推进到湿实验验证,证明 HuDiff 能够产生具有活性的候选。但现有证据仍主要回答“能不能生成成功候选”,尚未回答“面对任意新项目时成功率有多稳定”。
对企业而言,合理的应用方式不是让 HuDiff 直接决定实验序列,而是让它负责扩大候选空间。
真正能够提高实验验证命中率的,不是模型给出的某一个最高分,而是企业能否建立严格的输入质控、独立评价、多样化候选面板、结构复核、实验对照和结果回流机制。
HuDiff 最值得关注的地方,也不是它能否一次性替代抗体工程师,而是它是否能够成为一个可追踪、可复核、能够持续从实验中学习的人源化研发系统的起点。
参考文献
[1] MA J, WU F, XU T, et al. An adaptive autoregressive diffusion approach to design active humanized antibodies and nanobodies[J]. Nature Machine Intelligence, 2025, 7: 1698–1712. DOI: 10.1038/s42256-025-01120-9.
[2] PRIHODA D, MAAMARY J, WAIGHT A, et al. BioPhi: A platform for antibody design, humanization, and humanness evaluation based on natural antibody repertoires and deep learning[J]. mAbs, 2022, 14(1): 2020203. DOI: 10.1080/19420862.2021.2020203.
[3] RAMON A, ALI M, ATKINSON M, et al. Assessing antibody and nanobody nativeness for hit selection and humanization with AbNatiV[J]. Nature Machine Intelligence, 2024, 6: 74–91. DOI: 10.1038/s42256-023-00778-3.
[4] FOOTE J, WINTER G. Antibody framework residues affecting the conformation of the hypervariable loops[J]. Journal of Molecular Biology, 1992, 224(2): 487–499. DOI: 10.1016/0022-2836(92)91010-M.。
[5] CHEN H, ZHANG Y, YE A Y, et al. BCR selection and affinity maturation in Peyer’s patch germinal centres[J]. Nature, 2020, 582: 421–425. DOI: 10.1038/s41586-020-2262-4.