第一节:呼吸健康预测机器学习预警模型
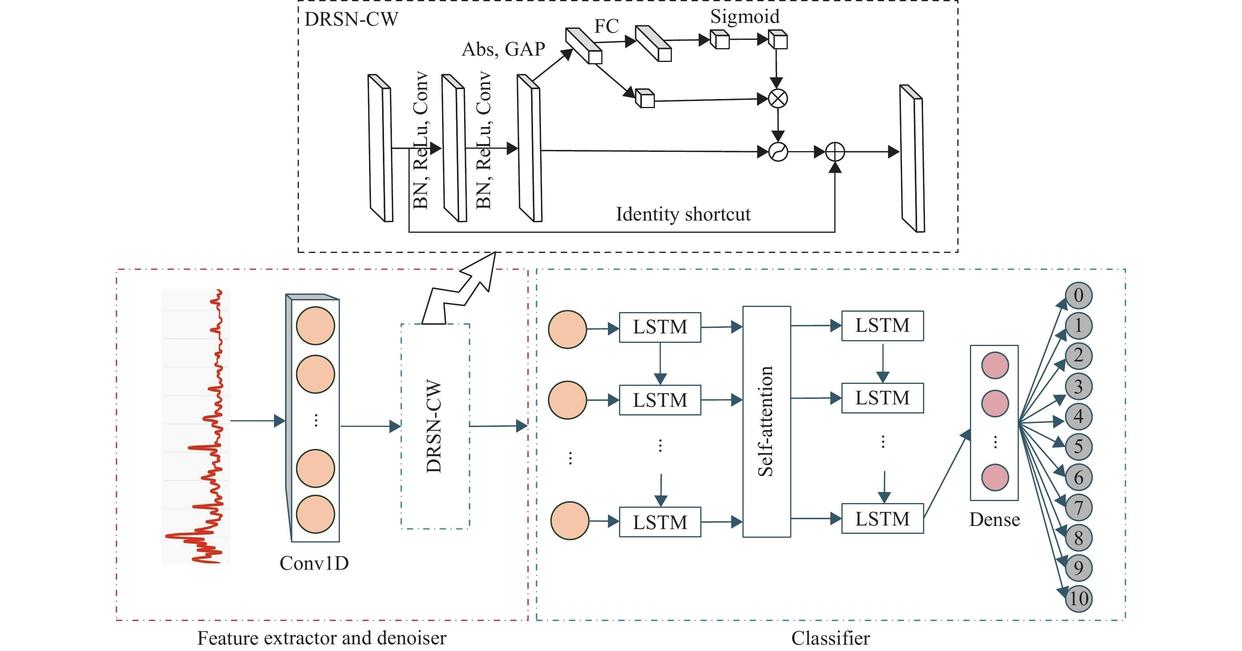
一、系统架构设计
python
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.preprocessing import StandardScaler, LabelEncoder
from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier
from sklearn.svm import SVC
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix, roc_auc_score
from sklearn.impute import SimpleImputer
import warnings
warnings.filterwarnings('ignore')
class RespiratoryHealthPredictor:
"""
呼吸健康预测预警模型
"""
def __init__(self):
self.models = {}
self.scalers = {}
self.feature_importance = {}
self.results = {}
def generate_sample_data(self, n_samples=5000):
"""
生成模拟的呼吸健康数据集
在实际应用中应替换为真实数据
"""
np.random.seed(42)
data = {
'age': np.random.normal(45, 15, n_samples),
'gender': np.random.choice([0, 1], n_samples),
'smoking_status': np.random.choice([0, 1, 2], n_samples, p=[0.6, 0.3, 0.1]),
'bmi': np.random.normal(24, 4, n_samples),
'air_quality_index': np.random.lognormal(2.5, 0.8, n_samples),
'respiratory_rate': np.random.normal(16, 4, n_samples),
'oxygen_saturation': np.random.normal(97, 2, n_samples),
'cough_frequency': np.random.poisson(2, n_samples),
'allergy_history': np.random.choice([0, 1], n_samples, p=[0.7, 0.3]),
'family_history': np.random.choice([0, 1], n_samples, p=[0.8, 0.2]),
'exercise_frequency': np.random.choice([0, 1, 2, 3], n_samples),
'sleep_quality': np.random.choice([1, 2, 3, 4, 5], n_samples),
'stress_level': np.random.choice([1, 2, 3, 4, 5], n_samples)
}
df = pd.DataFrame(data)
# 生成目标变量(呼吸健康风险等级)
risk_score = (
df['age'] * 0.1 +
df['smoking_status'] * 0.3 +
(df['bmi'] – 22) * 0.05 +
df['air_quality_index'] * 0.02 +
(18 – df['respiratory_rate']).abs() * 0.1 +
(98 – df['oxygen_saturation']) * 0.2 +
df['cough_frequency'] * 0.15 +
df['allergy_history'] * 0.1 +
df['family_history'] * 0.08 +
(3 – df['exercise_frequency']) * 0.05 +
(5 – df['sleep_quality']) * 0.03 +
df['stress_level'] * 0.04 +
np.random.normal(0, 1, n_samples)
)
# 将风险分数转换为健康等级
conditions = [
risk_score < 2,
(risk_score >= 2) & (risk_score < 4),
(risk_score >= 4) & (risk_score < 6),
risk_score >= 6
]
choices = [0, 1, 2, 3] # 0:健康, 1:低风险, 2:中风险, 3:高风险
df['health_risk'] = np.select(conditions, choices, default=0)
return df
def preprocess_data(self, df):
"""数据预处理"""
# 复制数据
processed_df = df.copy()
# 处理缺失值
imputer = SimpleImputer(strategy='median')
numeric_columns = processed_df.select_dtypes(include=[np.number]).columns
processed_df[numeric_columns] = imputer.fit_transform(processed_df[numeric_columns])
# 分离特征和目标变量
X = processed_df.drop('health_risk', axis=1)
y = processed_df['health_risk']
return X, y
def train_models(self, X_train, y_train):
"""训练多个机器学习模型"""
models = {
'Random Forest': RandomForestClassifier(n_estimators=100, random_state=42),
'Gradient Boosting': GradientBoostingClassifier(n_estimators=100, random_state=42),
'SVM': SVC(probability=True, random_state=42),
'Logistic Regression': LogisticRegression(random_state=42, max_iter=1000)
}
for name, model in models.items():
print(f"训练 {name}…")
model.fit(X_train, y_train)
self.models[name] = model
# 计算特征重要性(基于随机森林)
self.feature_importance = dict(zip(
X_train.columns,
self.models['Random Forest'].feature_importances_
))
def evaluate_models(self, X_test, y_test):
"""评估模型性能"""
results = {}
for name, model in self.models.items():
y_pred = model.predict(X_test)
y_pred_proba = model.predict_proba(X_test)
# 多分类AUC
auc_score = roc_auc_score(y_test, y_pred_proba, multi_class='ovr')
results[name] = {
'accuracy': model.score(X_test, y_test),
'auc': auc_score,
'classification_report': classification_report(y_test, y_pred),
'confusion_matrix': confusion_matrix(y_test, y_pred)
}
self.results = results
return results
def plot_feature_importance(self):
"""可视化特征重要性"""
importance_df = pd.DataFrame({
'feature': list(self.feature_importance.keys()),
'importance': list(self.feature_importance.values())
}).sort_values('importance', ascending=False)
plt.figure(figsize=(10, 6))
sns.barplot(data=importance_df, x='importance', y='feature')
plt.title('呼吸健康风险特征重要性')
plt.tight_layout()
plt.show()
return importance_df
def plot_model_comparison(self):
"""模型性能比较"""
model_names = list(self.results.keys())
accuracies = [self.results[name]['accuracy'] for name in model_names]
auc_scores = [self.results[name]['auc'] for name in model_names]
x = np.arange(len(model_names))
width = 0.35
fig, ax = plt.subplots(figsize=(10, 6))
bars1 = ax.bar(x – width/2, accuracies, width, label='准确率')
bars2 = ax.bar(x + width/2, auc_scores, width, label='AUC得分')
ax.set_xlabel('模型')
ax.set_ylabel('得分')
ax.set_title('模型性能比较')
ax.set_xticks(x)
ax.set_xticklabels(model_names)
ax.legend()
# 在柱状图上显示数值
for bar in bars1:
height = bar.get_height()
ax.annotate(f'{height:.3f}',
xy=(bar.get_x() + bar.get_width() / 2, height),
xytext=(0, 3),
textcoords="offset points",
ha='center', va='bottom')
for bar in bars2:
height = bar.get_height()
ax.annotate(f'{height:.3f}',
xy=(bar.get_x() + bar.get_width() / 2, height),
xytext=(0, 3),
textcoords="offset points",
ha='center', va='bottom')
plt.tight_layout()
plt.show()
def predict_health_risk(self, patient_data):
"""预测单个患者的健康风险"""
best_model = self.models['Random Forest'] # 使用最佳模型
# 确保输入数据格式正确
if isinstance(patient_data, pd.DataFrame):
prediction = best_model.predict(patient_data)[0]
probability = best_model.predict_proba(patient_data)[0]
else:
prediction = best_model.predict([patient_data])[0]
probability = best_model.predict_proba([patient_data])[0]
risk_levels = {0: '健康', 1: '低风险', 2: '中风险', 3: '高风险'}
result = {
'risk_level': risk_levels[prediction],
'confidence': max(probability),
'probabilities': {
risk_levels[i]: f"{prob*100:.2f}%" for i, prob in enumerate(probability)
}
}
return result
def generate_early_warning(self, patient_data, threshold=0.7):
"""生成早期预警"""
prediction = self.predict_health_risk(patient_data)
warning_messages = {
'健康': "当前呼吸健康状况良好,请继续保持健康生活方式。",
'低风险': "存在轻微呼吸健康风险,建议关注生活方式改善。",
'中风险': "存在中度呼吸健康风险,建议进行专业检查并采取干预措施。",
'高风险': "存在严重呼吸健康风险,请立即就医并进行全面检查。"
}
warning = {
'risk_level': prediction['risk_level'],
'confidence': prediction['confidence'],
'message': warning_messages[prediction['risk_level']],
'urgent': prediction['risk_level'] in ['中风险', '高风险'],
'recommendations': self.generate_recommendations(prediction['risk_level'])
}
return warning
def generate_recommendations(self, risk_level):
"""根据风险等级生成个性化建议"""
recommendations = {
'健康': [
"保持规律运动",
"均衡饮食,多摄入蔬果",
"保证充足睡眠",
"定期进行呼吸健康检查"
],
'低风险': [
"减少吸烟或戒烟",
"改善室内空气质量",
"增加有氧运动",
"学习呼吸训练技巧"
],
'中风险': [
"立即进行专业呼吸功能检查",
"避免空气污染环境",
"遵医嘱进行药物治疗",
"定期监测呼吸指标"
],
'高风险': [
"立即就医进行全面检查",
"严格遵医嘱治疗",
"避免所有呼吸道刺激物",
"建立紧急医疗联系方案"
]
}
return recommendations.get(risk_level, [])
二、模型训练与评估
python
def main():
# 初始化预测器
predictor = RespiratoryHealthPredictor()
# 生成示例数据
print("生成呼吸健康数据集…")
df = predictor.generate_sample_data(5000)
print(f"数据集形状: {df.shape}")
print(f"健康风险分布:\\n{df['health_risk'].value_counts().sort_index()}")
# 数据预处理
print("\\n数据预处理…")
X, y = predictor.preprocess_data(df)
# 划分训练测试集
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42, stratify=y
)
# 训练模型
print("\\n训练机器学习模型…")
predictor.train_models(X_train, y_train)
# 评估模型
print("\\n评估模型性能…")
results = predictor.evaluate_models(X_test, y_test)
# 显示结果
for model_name, metrics in results.items():
print(f"\\n{model_name} 结果:")
print(f"准确率: {metrics['accuracy']:.4f}")
print(f"AUC得分: {metrics['auc']:.4f}")
print("分类报告:")
print(metrics['classification_report'])
# 可视化
print("\\n生成可视化结果…")
importance_df = predictor.plot_feature_importance()
predictor.plot_model_comparison()
# 示例预测
print("\\n示例预测:")
sample_patient = X_test.iloc[0:1] # 取测试集第一个样本
prediction = predictor.predict_health_risk(sample_patient)
warning = predictor.generate_early_warning(sample_patient)
print(f"预测结果: {prediction}")
print(f"预警信息: {warning}")
return predictor, results
# 运行主程序
if __name__ == "__main__":
predictor, results = main()
三、实时预警系统
python
class RealTimeMonitoringSystem:
"""
实时呼吸健康监测预警系统
"""
def __init__(self, predictor):
self.predictor = predictor
self.patient_history = {}
def add_patient_data(self, patient_id, patient_data):
"""添加患者数据"""
if patient_id not in self.patient_history:
self.patient_history[patient_id] = []
self.patient_history[patient_id].append({
'timestamp': pd.Timestamp.now(),
'data': patient_data,
'prediction': self.predictor.predict_health_risk(patient_data),
'warning': self.predictor.generate_early_warning(patient_data)
})
def get_patient_trend(self, patient_id):
"""获取患者健康趋势"""
if patient_id not in self.patient_history:
return None
history = self.patient_history[patient_id]
risk_scores = []
timestamps = []
for record in history:
risk_level = record['prediction']['risk_level']
risk_map = {'健康': 0, '低风险': 1, '中风险': 2, '高风险': 3}
risk_scores.append(risk_map[risk_level])
timestamps.append(record['timestamp'])
return pd.DataFrame({
'timestamp': timestamps,
'risk_score': risk_scores
})
def generate_population_report(self):
"""生成群体健康报告"""
all_risks = []
for patient_id, history in self.patient_history.items():
latest = history[-1]
all_risks.append(latest['prediction']['risk_level'])
risk_counts = pd.Series(all_risks).value_counts()
report = {
'total_patients': len(self.patient_history),
'risk_distribution': risk_counts.to_dict(),
'high_risk_patients': risk_counts.get('高风险', 0),
'medium_risk_patients': risk_counts.get('中风险', 0)
}
return report
# 使用示例
def demo_real_time_system():
# 初始化系统
predictor = RespiratoryHealthPredictor()
df = predictor.generate_sample_data(1000)
X, y = predictor.preprocess_data(df)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
predictor.train_models(X_train, y_train)
# 创建实时监测系统
monitoring_system = RealTimeMonitoringSystem(predictor)
# 模拟实时数据输入
for i in range(10):
patient_data = X_test.iloc[i:i+1]
monitoring_system.add_patient_data(f"patient_{i}", patient_data)
# 生成报告
report = monitoring_system.generate_population_report()
print("群体健康报告:")
print(report)
# 获取单个患者趋势
trend = monitoring_system.get_patient_trend("patient_0")
print(f"\\n患者0的健康趋势:\\n{trend}")
# 运行实时系统演示
demo_real_time_system()
四、模型部署建议
1. 数据安全与隐私
医疗数据加密存储,匿名化处理患者信息,符合HIPAA等医疗数据法规。
2. 系统集成
RESTful API接口,与医院信息系统集成,移动端应用支持。
3. 持续学习
定期更新模型,增量学习新数据,模型性能监控。
第二节:时序预测:LSTM神经网络
一、基于LSTM的呼吸健康时序预测预警模型
(一)系统架构设计
python
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.preprocessing import StandardScaler, MinMaxScaler
from sklearn.metrics import mean_squared_error, mean_absolute_error, accuracy_score, classification_report
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import LSTM, Dense, Dropout, Bidirectional
from tensorflow.keras.optimizers import Adam
from tensorflow.keras.callbacks import EarlyStopping, ReduceLROnPlateau
import warnings
warnings.filterwarnings('ignore')
class RespiratoryLSTMPredictor:
"""
基于LSTM的呼吸健康时序预测预警模型
"""
def __init__(self, sequence_length=30, prediction_horizon=7):
self.sequence_length = sequence_length
self.prediction_horizon = prediction_horizon
self.model = None
self.scalers = {}
self.history = None
def generate_temporal_data(self, n_patients=200, time_steps=365):
"""
生成模拟的呼吸健康时序数据
"""
np.random.seed(42)
data = []
for patient_id in range(n_patients):
# 基础特征
base_features = {
'patient_id': patient_id,
'age': np.random.normal(45, 15),
'gender': np.random.choice([0, 1]),
'smoking_status': np.random.choice([0, 1, 2], p=[0.6, 0.3, 0.1]),
'bmi': np.random.normal(24, 4),
'allergy_history': np.random.choice([0, 1], p=[0.7, 0.3]),
'family_history': np.random.choice([0, 1], p=[0.8, 0.2])
}
# 生成时序数据
for t in range(time_steps):
date = pd.Timestamp('2023-01-01') + pd.Timedelta(days=t)
# 季节性因素
seasonal_factor = 1 + 0.2 * np.sin(2 * np.pi * t / 365)
# 空气质量(有季节性变化)
air_quality = np.random.lognormal(2.5, 0.5) * seasonal_factor
# 呼吸率(受多种因素影响)
base_resp_rate = 16 + base_features['smoking_status'] * 2
resp_rate = base_resp_rate + np.random.normal(0, 1) + 0.1 * air_quality # 血氧饱和度
base_oxygen = 98 – base_features['smoking_status'] * 1
oxygen_sat = base_oxygen + np.random.normal(0, 0.5) – 0.05 * air_quality
# 咳嗽频率(有趋势性)
cough_trend = 0.001 * t # 轻微恶化趋势
base_cough = 2 + base_features['smoking_status'] * 3
cough_freq = max(0, base_cough + np.random.poisson(1) + cough_trend)
# 症状评分
symptom_score = (
(resp_rate – 16) * 0.1 +
(98 – oxygen_sat) * 0.3 +
cough_freq * 0.2 +
air_quality * 0.05 +
np.random.normal(0, 0.5)
)
# 风险等级(基于症状评分)
if symptom_score < 1:
risk_level = 0 # 健康
elif symptom_score < 2:
risk_level = 1 # 低风险
elif symptom_score < 4:
risk_level = 2 # 中风险
else:
risk_level = 3 # 高风险
record = {
'patient_id': patient_id,
'date': date,
'respiratory_rate': resp_rate,
'oxygen_saturation': oxygen_sat,
'cough_frequency': cough_freq,
'air_quality_index': air_quality,
'symptom_score': symptom_score,
'risk_level': risk_level,
**base_features
}
data.append(record)
df = pd.DataFrame(data)
return df
def prepare_sequences(self, df, features, target):
"""
准备LSTM序列数据
"""
sequences = []
targets = []
patient_ids = df['patient_id'].unique()
for patient_id in patient_ids:
patient_data = df[df['patient_id'] == patient_id].sort_values('date')
# 标准化特征
feature_data = patient_data[features].values
# 创建序列
for i in range(len(patient_data) – self.sequence_length – self.prediction_horizon + 1):
seq = feature_data[i:(i + self.sequence_length)]
target_val = patient_data[target].iloc[i + self.sequence_length + self.prediction_horizon – 1]
sequences.append(seq)
targets.append(target_val)
return np.array(sequences), np.array(targets)
def build_lstm_model(self, input_shape, num_classes=4):
"""
构建LSTM模型架构
"""
model = Sequential([
Bidirectional(LSTM(128, return_sequences=True, input_shape=input_shape)),
Dropout(0.2),
Bidirectional(LSTM(64, return_sequences=True)),
Dropout(0.2),
Bidirectional(LSTM(32)),
Dropout(0.2),
Dense(64, activation='relu'),
Dropout(0.2),
Dense(32, activation='relu'),
Dropout(0.1),
Dense(num_classes, activation='softmax') # 多分类输出
])
model.compile(
optimizer=Adam(learning_rate=0.001),
loss='sparse_categorical_crossentropy',
metrics=['accuracy']
)
return model
def build_lstm_regression_model(self, input_shape):
"""
构建回归LSTM模型(预测症状评分)
"""
model = Sequential([
Bidirectional(LSTM(128, return_sequences=True, input_shape=input_shape)),
Dropout(0.2),
Bidirectional(LSTM(64, return_sequences=True)),
Dropout(0.2),
Bidirectional(LSTM(32)),
Dropout(0.2),
Dense(64, activation='relu'),
Dropout(0.2),
Dense(32, activation='relu'),
Dropout(0.1),
Dense(1, activation='linear') # 回归输出
])
model.compile(
optimizer=Adam(learning_rate=0.001),
loss='mse',
metrics=['mae']
)
return model
def train_model(self, X_train, y_train, X_val, y_val, model_type='classification'):
"""
训练LSTM模型
"""
if model_type == 'classification':
self.model = self.build_lstm_model((X_train.shape[1], X_train.shape[2]))
else:
self.model = self.build_lstm_regression_model((X_train.shape[1], X_train.shape[2]))
callbacks = [
EarlyStopping(patience=15, restore_best_weights=True),
ReduceLROnPlateau(patience=10, factor=0.5, min_lr=1e-6)
]
self.history = self.model.fit(
X_train, y_train,
validation_data=(X_val, y_val),
epochs=100,
batch_size=32,
callbacks=callbacks,
verbose=1
)
return self.history
def predict_risk(self, sequences):
"""
预测风险
"""
if self.model is None:
raise ValueError("模型尚未训练")
predictions = self.model.predict(sequences)
return predictions
def plot_training_history(self):
"""
绘制训练历史
"""
if self.history is None:
raise ValueError("没有训练历史可显示")
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(15, 5))
# 损失曲线
ax1.plot(self.history.history['loss'], label='训练损失')
ax1.plot(self.history.history['val_loss'], label='验证损失')
ax1.set_title('模型损失')
ax1.set_xlabel('Epoch')
ax1.set_ylabel('Loss')
ax1.legend()
# 准确率曲线
if 'accuracy' in self.history.history:
ax2.plot(self.history.history['accuracy'], label='训练准确率')
ax2.plot(self.history.history['val_accuracy'], label='验证准确率')
ax2.set_title('模型准确率')
else:
ax2.plot(self.history.history['mae'], label='训练MAE')
ax2.plot(self.history.history['val_mae'], label='验证MAE')
ax2.set_title('模型MAE')
ax2.set_xlabel('Epoch')
ax2.set_ylabel('Score')
ax2.legend()
plt.tight_layout()
plt.show()
def evaluate_model(self, X_test, y_test):
"""
评估模型性能
"""
if self.model is None:
raise ValueError("模型尚未训练")
# 预测
y_pred = self.model.predict(X_test)
# 分类任务评估
if len(y_pred.shape) > 1 and y_pred.shape[1] > 1:
y_pred_classes = np.argmax(y_pred, axis=1)
accuracy = accuracy_score(y_test, y_pred_classes)
print(f"测试集准确率: {accuracy:.4f}")
print("\\n分类报告:")
print(classification_report(y_test, y_pred_classes,
target_names=['健康', '低风险', '中风险', '高风险'])) # 混淆矩阵
cm = tf.math.confusion_matrix(y_test, y_pred_classes)
plt.figure(figsize=(8, 6))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
xticklabels=['健康', '低风险', '中风险', '高风险'],
yticklabels=['健康', '低风险', '中风险', '高风险'])
plt.title('混淆矩阵')
plt.xlabel('预测标签')
plt.ylabel('真实标签')
plt.show()
return accuracy
# 回归任务评估
else:
y_pred = y_pred.flatten()
mse = mean_squared_error(y_test, y_pred)
mae = mean_absolute_error(y_test, y_pred)
print(f"测试集MSE: {mse:.4f}")
print(f"测试集MAE: {mae:.4f}")
# 预测 vs 真实值散点图
plt.figure(figsize=(10, 6))
plt.scatter(y_test, y_pred, alpha=0.6)
plt.plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()], 'r–', lw=2)
plt.xlabel('真实值')
plt.ylabel('预测值')
plt.title('预测值 vs 真实值')
plt.show()
return mse, mae
class AdvancedRespiratoryMonitor:
"""
高级呼吸健康监测预警系统
"""
def __init__(self, predictor):
self.predictor = predictor
self.patient_profiles = {}
def add_patient_profile(self, patient_id, historical_data):
"""添加患者档案"""
self.patient_profiles[patient_id] = {
'historical_data': historical_data,
'predictions': [],
'warnings': [],
'risk_trend': []
}
def generate_future_predictions(self, patient_id, future_days=30):
"""生成未来预测"""
if patient_id not in self.patient_profiles:
raise ValueError(f"患者 {patient_id} 不存在")
patient_data = self.patient_profiles[patient_id]['historical_data']
features = ['respiratory_rate', 'oxygen_saturation', 'cough_frequency', 'air_quality_index']
# 使用最后 sequence_length 天的数据
recent_data = patient_data[features].tail(self.predictor.sequence_length).values
recent_data = recent_data.reshape(1, self.predictor.sequence_length, len(features))
# 预测未来风险
future_risks = []
current_sequence = recent_data.copy()
for day in range(future_days):
prediction = self.predictor.predict_risk(current_sequence)
risk_level = np.argmax(prediction[0])
future_risks.append(risk_level)
# 更新序列(在实际应用中需要真实数据,这里使用模拟更新)
# 这里简化处理,实际应该基于预测值和其他因素更新序列
current_sequence = np.roll(current_sequence, -1, axis=1)
# 用最后一个值填充新的时间步(实际应用中应该使用预测的特征值)
current_sequence[0, -1, :] = current_sequence[0, -2, :] * 0.95 + np.random.normal(0, 0.1, len(features))
self.patient_profiles[patient_id]['future_predictions'] = future_risks
return future_risks
def analyze_risk_trend(self, patient_id):
"""分析风险趋势"""
if patient_id not in self.patient_profiles:
raise ValueError(f"患者 {patient_id} 不存在")
historical_data = self.patient_profiles[patient_id]['historical_data']
# 计算风险趋势
risk_values = historical_data['risk_level'].values
trend = np.convolve(risk_values, np.ones(7)/7, mode='valid') # 7天移动平均
# 趋势分析
if len(trend) > 1:
slope = (trend[-1] – trend[0]) / len(trend)
if slope > 0.1:
trend_direction = "恶化"
elif slope < -0.1:
trend_direction = "改善"
else:
trend_direction = "稳定"
else:
trend_direction = "数据不足"
self.patient_profiles[patient_id]['risk_trend'] = {
'values': trend,
'direction': trend_direction,
'slope': slope if len(trend) > 1 else 0
}
return trend_direction
def generate_early_warnings(self, patient_id):
"""生成早期预警"""
if patient_id not in self.patient_profiles:
raise ValueError(f"患者 {patient_id} 不存在")
current_risk = self.patient_profiles[patient_id]['historical_data']['risk_level'].iloc[-1]
trend_direction = self.analyze_risk_trend(patient_id)
warnings = []
# 基于当前风险和趋势生成警告
if current_risk >= 2 or (current_risk == 1 and trend_direction == "恶化"):
if current_risk == 3:
warnings.append({
'level': '紧急',
'message': '高风险状态检测到,建议立即就医',
'actions': ['立即联系医生', '进行详细检查', '避免外出']
})
elif current_risk == 2:
warnings.append({
'level': '警告',
'message': '中风险状态,健康状况正在恶化',
'actions': ['预约医生检查', '加强监测频率', '注意休息']
})
elif current_risk == 1 and trend_direction == "恶化":
warnings.append({
'level': '注意',
'message': '低风险但趋势恶化,需要关注',
'actions': ['增加监测', '改善生活习惯', '注意症状变化']
})
# 基于未来预测生成预警
if 'future_predictions' in self.patient_profiles[patient_id]:
future_risks = self.patient_profiles[patient_id]['future_predictions']
if any(risk >= 2 for risk in future_risks):
warnings.append({
'level': '预测预警',
'message': f'预测未来{len(future_risks)}天内可能出现中高风险',
'actions': ['提前预防', '调整治疗方案', '加强监测']
})
self.patient_profiles[patient_id]['warnings'] = warnings
return warnings
def plot_patient_timeline(self, patient_id):
"""绘制患者时间线"""
if patient_id not in self.patient_profiles:
raise ValueError(f"患者 {patient_id} 不存在")
data = self.patient_profiles[patient_id]['historical_data']
fig, ((ax1, ax2), (ax3, ax4)) = plt.subplots(2, 2, figsize=(15, 10))
# 呼吸率趋势
ax1.plot(data['date'], data['respiratory_rate'], label='呼吸率', color='blue')
ax1.axhline(y=20, color='red', linestyle='–', label='警戒线')
ax1.set_title('呼吸率趋势')
ax1.set_ylabel('次/分钟')
ax1.legend()
# 血氧饱和度趋势
ax2.plot(data['date'], data['oxygen_saturation'], label='血氧饱和度', color='green')
ax2.axhline(y=95, color='red', linestyle='–', label='警戒线')
ax2.set_title('血氧饱和度趋势')
ax2.set_ylabel('%')
ax2.legend()
# 咳嗽频率趋势
ax3.plot(data['date'], data['cough_frequency'], label='咳嗽频率', color='orange')
ax3.set_title('咳嗽频率趋势')
ax3.set_ylabel('次数/天')
ax3.legend()
# 风险等级趋势
risk_colors = {0: 'green', 1: 'yellow', 2: 'orange', 3: 'red'}
for risk_level in range(4):
risk_data = data[data['risk_level'] == risk_level]
ax4.scatter(risk_data['date'], risk_data['risk_level'],
color=risk_colors[risk_level], label=f'风险{risk_level}', alpha=0.6)
ax4.set_title('风险等级变化')
ax4.set_ylabel('风险等级')
ax4.set_yticks([0, 1, 2, 3])
ax4.legend()
plt.tight_layout()
plt.show()
(未完待续)