你的 ZooKeeper 还在"裸奔"吗?搭完集群就扔在那里,既没有 UI 查看数据,也没有监控告警,出了问题全靠 echo ruok | nc?这篇文章带你用 Docker 一条龙搞定 ZooKeeper 的搭建、可视化管理、Prometheus 监控、告警规则和 Grafana 看板——从此告别"ZK 挂了半天才发现"的社死现场。
网上相关文章大多比较零散,搭建归搭建、监控归监控,想要完整走通一遍得开好几个标签页来回跳。本文把这些环节全部整合到一起,照着做就能一次跑通。
一、集群搭建
1. 方案选择
部署 ZooKeeper 集群一般两种方案:
| HA 集群 | 3 台机器各部署 1 个 ZK | 生产环境、测试环境 | ✅ |
| 单机模式 | 1 台机器 1 个 ZK | 本地开发、资源紧张 | ❌ |
🤔 网上有些教程教你在 1 台机器上跑 3 个 Docker 容器来"模拟集群"——听起来很热闹,但机器一挂,三个容器手拉手一起走,跟单节点没什么本质区别。花里胡哨,不如老老实实单机模式。
2. HA 集群搭建(推荐)
三台机器,每台跑一个 ZooKeeper 实例,互相通信组成集群。
前置准备(三台机器都执行):
mkdir -p /data/zookeeper/data /data/zookeeper/datalog
节点 1(zk-node1):
echo "1" > /data/zookeeper/data/myid
docker run -d \\
–name zk1 \\
–hostname zk1 \\
–restart always \\
-p 2181:2181 \\
-p 2888:2888 \\
-p 3888:3888 \\
-e TZ=Asia/Shanghai \\
-e ZOO_MY_ID=1 \\
-e 'ZOO_SERVERS=server.1=0.0.0.0:2888:3888;2181 server.2=zk-node2:2888:3888;2181 server.3=zk-node3:2888:3888;2181' \\
-e ZOO_4LW_COMMANDS_WHITELIST=mntr,ruok,conf,srvr \\
-v /data/zookeeper/data:/data \\
-v /data/zookeeper/datalog:/datalog \\
zookeeper:3.9
节点 2(zk-node2):
echo "2" > /data/zookeeper/data/myid
docker run -d \\
–name zk2 \\
–hostname zk2 \\
–restart always \\
-p 2181:2181 \\
-p 2888:2888 \\
-p 3888:3888 \\
-e TZ=Asia/Shanghai \\
-e ZOO_MY_ID=2 \\
-e 'ZOO_SERVERS=server.1=zk-node1:2888:3888;2181 server.2=0.0.0.0:2888:3888;2181 server.3=zk-node3:2888:3888;2181' \\
-e ZOO_4LW_COMMANDS_WHITELIST=mntr,ruok,conf,srvr \\
-v /data/zookeeper/data:/data \\
-v /data/zookeeper/datalog:/datalog \\
zookeeper:3.9
节点 3(zk-node3):
echo "3" > /data/zookeeper/data/myid
docker run -d \\
–name zk3 \\
–hostname zk3 \\
–restart always \\
-p 2181:2181 \\
-p 2888:2888 \\
-p 3888:3888 \\
-e TZ=Asia/Shanghai \\
-e ZOO_MY_ID=3 \\
-e 'ZOO_SERVERS=server.1=zk-node1:2888:3888;2181 server.2=zk-node2:2888:3888;2181 server.3=0.0.0.0:2888:3888;2181' \\
-e ZOO_4LW_COMMANDS_WHITELIST=mntr,ruok,conf,srvr \\
-v /data/zookeeper/data:/data \\
-v /data/zookeeper/datalog:/datalog \\
zookeeper:3.9
📌 注意:每个节点的 ZOO_SERVERS 中,自己的地址要写 0.0.0.0,其他节点写对方的主机名或 IP。这是 ZooKeeper Docker 镜像的约定,别问为什么,问就是规矩。
🔧 网络模式选择:生产环境建议直接使用 –network host,容器共享宿主机网络栈,省去端口映射的烦恼。如果是测试环境用的桥接网络(未加 –network host),那每个节点的 ZOO_SERVERS 里自己必须绑定 0.0.0.0,否则节点之间握不上手。
3. 单机模式搭建
资源有限或者只是本地开发,一行命令搞定:
docker run -d \\
–name zookeeper \\
–hostname zookeeper \\
–restart always \\
-p 2181:2181 \\
-e TZ=Asia/Shanghai \\
-e ZOO_MY_ID=1 \\
-e ZOO_4LW_COMMANDS_WHITELIST=mntr,ruok,conf,srvr \\
-e 'ZOO_SERVERS=server.1=zookeeper:2888:3888' \\
-v /data/zookeeper/data:/data \\
-v /data/zookeeper/datalog:/datalog \\
zookeeper:3.9
二、可视化管理
集群跑起来了,总不能每次都 zkCli.sh 敲命令看数据吧?那体验跟用记事本写代码差不多。我们需要一个 Web UI。
1. 方案对比
市面上常见的两个 ZooKeeper Web UI:
| GitHub Stars | ~2k | ~444 |
| 最后活跃 | 多年未更新,需要 Java 7 | 2023 年,支持 ZK 3.5.x ~ 3.9.x |
| Docker 镜像 | 5 年+ 未更新 | 持续维护 |
| UI 风格 | 传统 Jetty + Freemarker,有年代感 | 现代 Web UI,体验流畅 |
| 功能 | CRUD、导入导出、变更历史、搜索、REST API | CRUD、节点编辑/浏览、HTTPS、Auto Connect |
| 认证 | 内置用户名密码(admin/readonly) | 连接时输入 ZK 地址,可配置 Auth |
| 配置方式 | 需要挂载 config.cfg | 纯环境变量,对 Docker 更友好 |
Stars 多不代表好用。zkui 的 Stars 是历史积累,但 Docker 镜像 5 年没更新了,基础镜像的安全漏洞怕是能凑一副扑克牌。推荐 ZooNavigator。
2. 部署 ZooNavigator
docker run -d \\
–name zoonavigator \\
–restart always \\
-p 9002:9000 \\
-e TZ=Asia/Shanghai \\
-e HTTP_PORT=9000 \\
elkozmon/zoonavigator
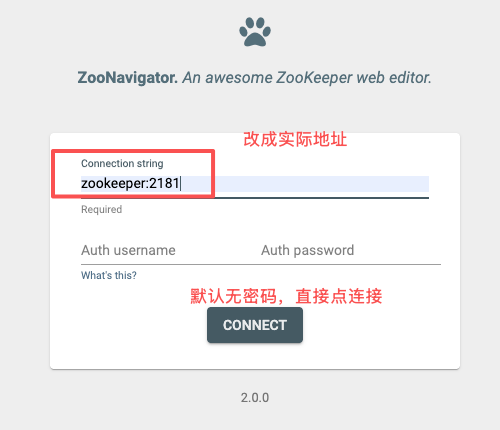
浏览器访问 http://<你的服务器IP>:9002/,输入 ZK 连接串(如 zk-node1:2181,zk-node2:2181,zk-node3:2181),点击 Connect 即可。
连接界面:
数据浏览:
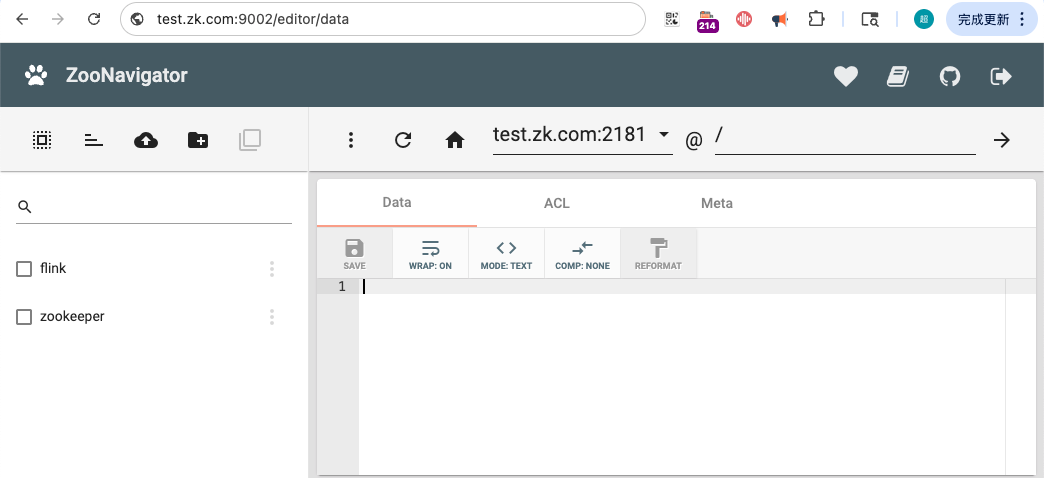
简洁清爽,节点树一目了然,CRUD 操作点点鼠标就行。
三、Prometheus 监控
光搭不监控,等于买了车不装仪表盘——跑多快、油还剩多少、发动机有没有冒烟,全靠感觉。
1. Exporter 选型
Docker Hub 上拉取量超过 100 万的 ZooKeeper Exporter 有 3 个:
| Docker 拉取量 | ~194 万 | ~210 万(最高) | ~108 万 |
| 采集方式 | 4LW: mntr + ruok | 4LW: mntr(推测) | 4LW: mntr + srst |
| 多节点支持 | ✅ 逗号分隔 | ❓ 未知 | ❌ 仅单节点 |
| 默认端口 | 9141 | 8080 | 9141 |
| Docker 镜像更新 | 2022-11-13 | 2018-10-15 | 2018-03-30 |
| 源码可用性 | ✅ GitHub 可访问 | ❌ 404 已删除 | 上游 carlpett 可访问 |
| 采集后重置 ZK 统计 | ❌ 不会 | ❓ 未知 | ⚠️ 会(默认开启) |
| 配套 Grafana 看板 | ✅ ID 11442 | ❌ | ❌ |
| 镜像大小 | ~7 MB | ~4.2 MB | ~4.7 MB |
javsalgar 拉取量最高,但源码 404 了,属于"人走茶凉"型选手。josdotso 默认采集完会重置 ZK 统计数据,有点"阅后即焚"的意思。综合推荐 dabealu/zookeeper-exporter——支持多节点、有配套看板、不搞破坏。
2. 部署 Exporter
docker run -d \\
–name zk-exporter \\
-p 9141:9141 \\
–restart=always \\
dabealu/zookeeper-exporter \\
-zk-hosts "zk-node1:2181,zk-node2:2181,zk-node3:2181" \\
-timeout 5 \\
-listen "0.0.0.0:9141"
一个 Exporter 实例就能采集全部 3 个 ZK 节点的指标,不用每台机器都部署。
3. Prometheus 配置
在 prometheus.yml 中添加:
scrape_configs:
– job_name: 'zookeeper'
static_configs:
– targets: [ 'exporter-host:9141' ]
metric_relabel_configs:
– source_labels: [ zk_host ]
target_label: instance
⚠️ 关键配置:metric_relabel_configs 这段不能省!因为 3 个 ZK 节点的指标都从同一个 Exporter 端口出来,Prometheus 默认会把 instance 标签都标记为 Exporter 的地址。加上这段 relabel,Prometheus 会用 Exporter 返回的 zk_host 标签覆盖 instance,这样 Grafana 里才能区分出 3 个节点。
配置完后重载 Prometheus:
curl -X POST http://prometheus-host:9090/-/reload
四、告警规则
监控不配告警 = 装了摄像头但不看录像。下面是一套经过实践验证的 ZooKeeper 告警规则,覆盖了从"服务挂了"到"快要挂了"的各种场景。
1. 规则总览
| 服务不可用 | 🔴 critical | up == 0 | Exporter 本身挂了 |
| 健康检查失败 | 🔴 critical | zk_ruok == 0 | ZK 进程在但不健康 |
| 无 Leader 节点 | 🔴 critical | 集群中检测不到 leader | 集群脑裂或全部挂掉 |
| 平均延迟过高 | 🟡 warning | zk_avg_latency > 100ms | 响应变慢,该查原因了 |
| 最大延迟过高 | 🟡 warning | zk_max_latency > 5000ms | 偶发慢请求 |
| 未完成请求堆积 | 🟡 warning | outstanding_requests > 50 | 处理不过来了 |
| 连接数过高 | 🟡 warning | alive_connections > 500 | 连接泄漏?客户端太多? |
| 临时节点过多 | 🟡 warning | ephemerals_count > 10000 | 服务注册过多 |
| Watch 数过多 | 🟡 warning | watch_count > 50000 | Watch 泄漏风险 |
| 文件描述符不足 | 🟡 warning | FD 使用率 > 85% | 再不处理就要 Too many open files 了 |
| Follower 同步延迟 | 🟡 warning | pending_syncs > 5 | 主从同步跟不上 |
2. 告警规则文件
将以下内容保存为 Prometheus 的 rules 文件(如 zookeeper-alerts.yml):
groups:
– name: zookeeper–alerts
rules:
# — Critical 级别 —
– alert: ZooKeeper服务不可用
expr: up{job="zookeeper"} == 0
for: 1m
labels:
severity: critical
group: zookeeper
annotations:
summary: "ZooKeeper 服务不可用"
description: "ZooKeeper {{ $labels.instance }} 已停止响应"
– alert: ZooKeeper健康检查失败
expr: zk_ruok == 0
for: 1m
labels:
severity: critical
group: zookeeper
annotations:
summary: "ZooKeeper 健康检查失败"
description: "ZooKeeper {{ $labels.instance }} ruok 返回异常"
– alert: ZooKeeper无Leader节点
expr: sum(zk_server_leader) == 0
for: 1m
labels:
severity: critical
group: zookeeper
annotations:
summary: "ZooKeeper 集群无 Leader"
description: "ZooKeeper 集群中没有 Leader 节点,服务可能不可用"
# — Warning 级别 —
– alert: ZooKeeper平均延迟过高
expr: zk_avg_latency > 100
for: 5m
labels:
severity: warning
group: zookeeper
annotations:
summary: "ZooKeeper 平均延迟过高"
description: "ZooKeeper {{ $labels.instance }} 平均延迟: {{ $value }}ms,超过 100ms"
– alert: ZooKeeper最大延迟过高
expr: zk_max_latency > 5000
for: 5m
labels:
severity: warning
group: zookeeper
annotations:
summary: "ZooKeeper 最大延迟过高"
description: "ZooKeeper {{ $labels.instance }} 最大延迟: {{ $value }}ms,超过 5000ms"
– alert: ZooKeeper未完成请求堆积
expr: zk_outstanding_requests > 50
for: 3m
labels:
severity: warning
group: zookeeper
annotations:
summary: "ZooKeeper 未完成请求堆积"
description: "ZooKeeper {{ $labels.instance }} 排队请求数: {{ $value }},超过 50"
– alert: ZooKeeper连接数过高
expr: zk_num_alive_connections > 500
for: 5m
labels:
severity: warning
group: zookeeper
annotations:
summary: "ZooKeeper 连接数过高"
description: "ZooKeeper {{ $labels.instance }} 活跃连接数: {{ $value }}"
– alert: ZooKeeper临时节点过多
expr: zk_ephemerals_count > 10000
for: 5m
labels:
severity: warning
group: zookeeper
annotations:
summary: "ZooKeeper 临时节点过多"
description: "ZooKeeper {{ $labels.instance }} 临时节点数: {{ $value }}"
– alert: ZooKeeperWatch数过多
expr: zk_watch_count > 50000
for: 5m
labels:
severity: warning
group: zookeeper
annotations:
summary: "ZooKeeper Watch 数过多"
description: "ZooKeeper {{ $labels.instance }} Watch 数: {{ $value }},超过 50000"
– alert: ZooKeeper文件描述符不足
expr: zk_open_file_descriptor_count / zk_max_file_descriptor_count * 100 > 85
for: 5m
labels:
severity: warning
group: zookeeper
annotations:
summary: "ZooKeeper 文件描述符使用率过高"
description: "ZooKeeper {{ $labels.instance }} FD 使用率: {{ printf \\"%.1f\\" $value }}%"
– alert: ZooKeeper同步延迟
expr: zk_pending_syncs > 5
for: 3m
labels:
severity: warning
group: zookeeper
annotations:
summary: "ZooKeeper Follower 同步延迟"
description: "ZooKeeper {{ $labels.instance }} 待同步数: {{ $value }}"
配置完成后,访问 Prometheus 的 Alerts 页面,可以看到所有规则已加载:
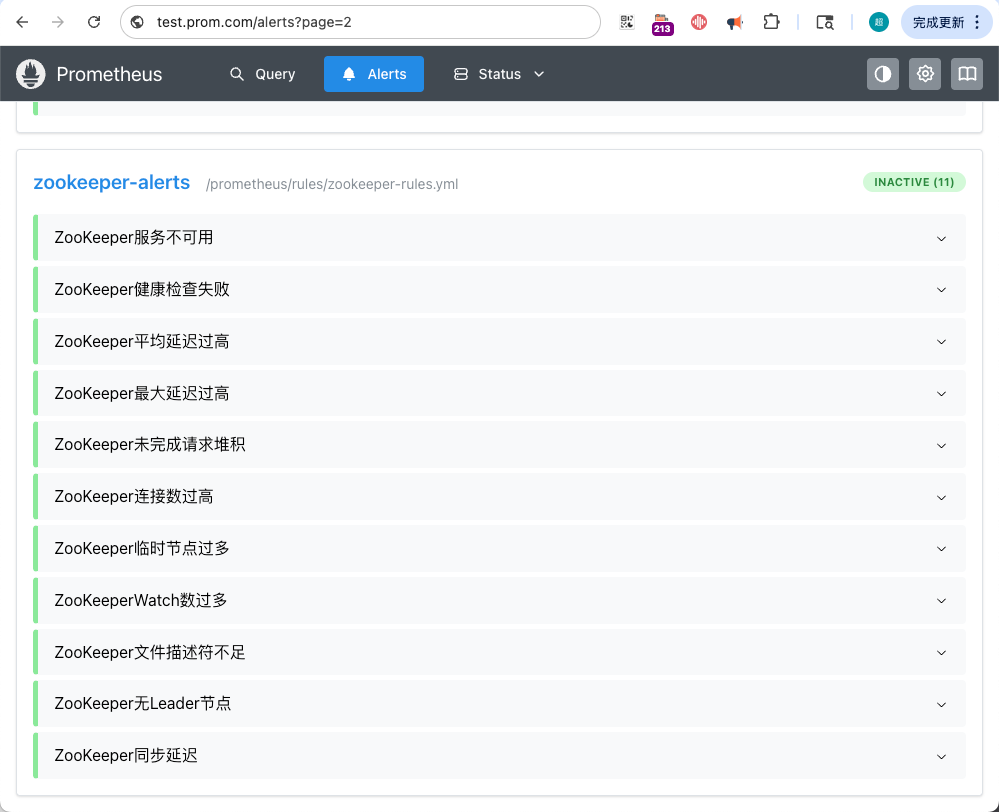
绿色表示正常,红色/黄色表示触发告警——一眼就能看出集群有没有"闹情绪"。
五、Grafana 看板
最后一步,让数据变成好看的图表。
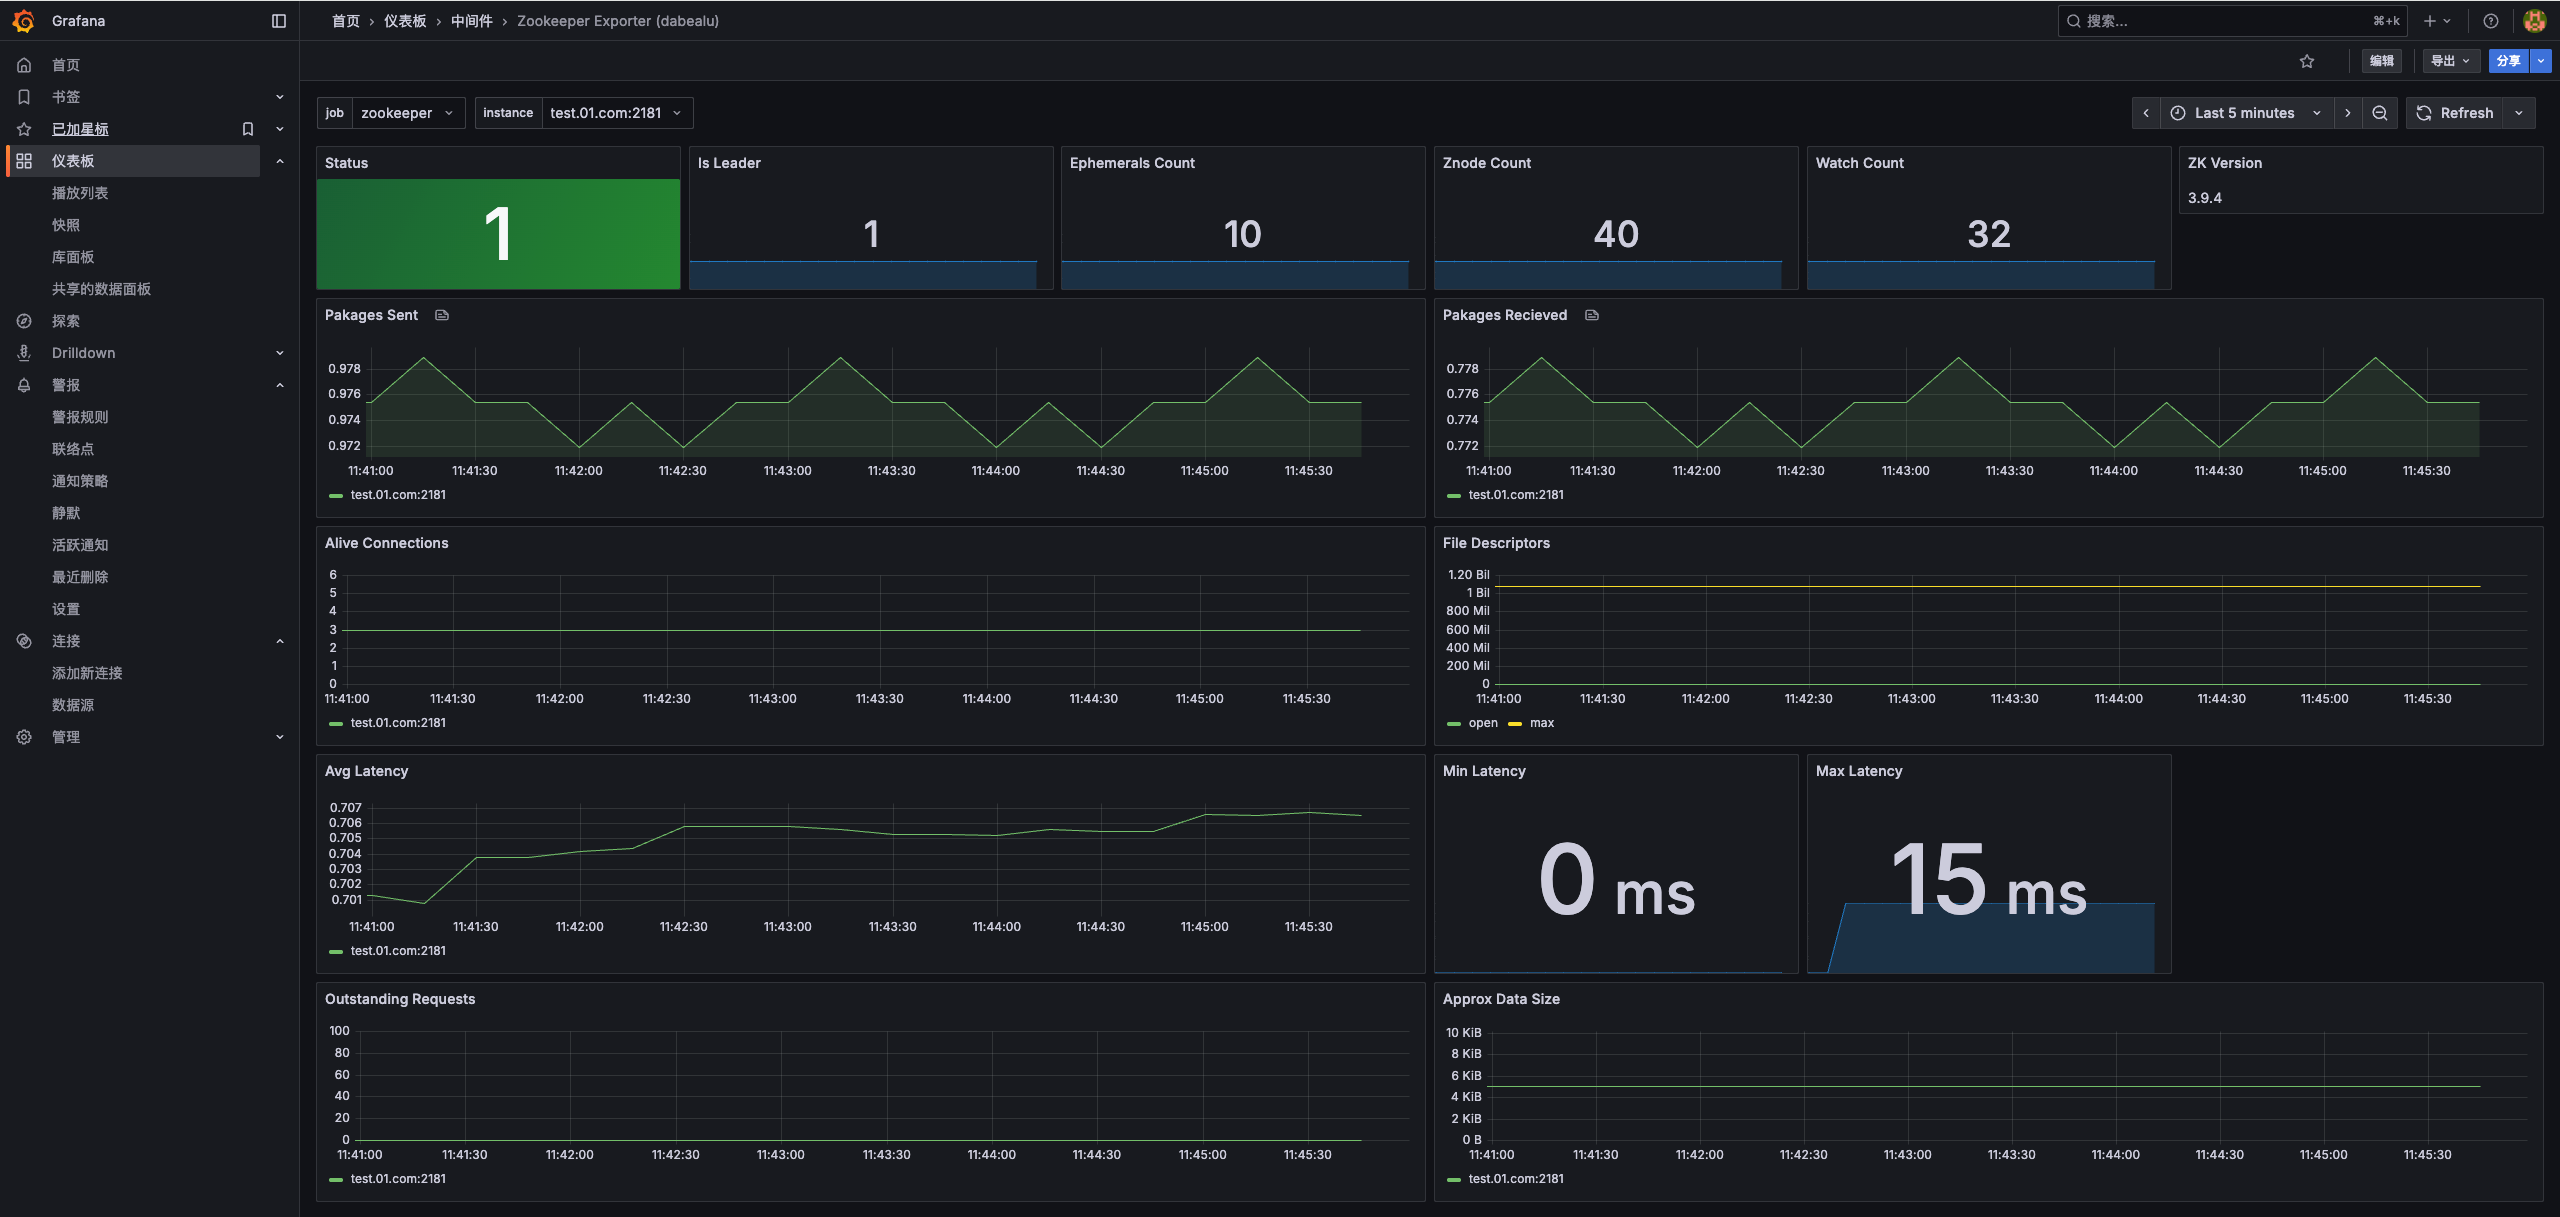
导入 Grafana 看板 ID: 11442,这个看板是专门为 dabealu/zookeeper-exporter 设计的。
⚠️ 注意:Grafana 上其他 ZooKeeper 看板大多是为不同 Exporter 设计的,直接导入会出现"一片空白,数据全无"的尴尬场面。认准 11442。
导入方式:Grafana → 左侧 + → Import → 输入 11442 → Load → 选择 Prometheus 数据源 → Import。
效果如下:
六、总结
一张图回顾整条链路:
ZooKeeper 集群(3 节点)
↓ 四字命令(mntr / ruok)
zk-exporter(dabealu)
↓ /metrics
Prometheus(采集 + 告警规则)
↓
Grafana(看板 11442)+ AlertManager(告警通知)
↓
ZooNavigator(日常查看数据)
| 搭建 | zookeeper:3.9 | 3 台机器,每台一个容器,稳如老狗 |
| 可视化 | elkozmon/zoonavigator | 现代 UI,告别 zkCli.sh 盲敲 |
| 采集 | dabealu/zookeeper-exporter | 一个 Exporter 管 3 个节点 |
| 监控 | Prometheus + Grafana 11442 | 指标可视化,一眼看穿集群状态 |
| 告警 | Prometheus Rules | 11 条规则,从"挂了"到"快挂了"全覆盖 |
从此,你的 ZooKeeper 不再裸奔。🎉
如果这篇文章帮你省下了半天折腾时间,点个赞就是对我最大的鼓励。有问题欢迎评论区交流,看到必回。