本章对应的官网文档出处:
英文文档:https://docs.langchain.com/oss/python/langchain/models
中文文档:https://docs.langchain.org.cn/oss/python/langchain/models
一、ChatOpenAI 兼容用法
1.1 兼容接口的使用背景
一方面,LangChain没有为所有大模型厂商提供专用接口,见Langchain大模型集成列表。如果选用的 平台没有专用接口,可以通过兼容接口调用。
另一方面,专用接口的对接方式五花八门,如腾讯混元的ChatHunyuan需要单独的APP_ID + SecretId
- SecretKey ,配置繁琐,用户不友好。
结论:大多数API平台都支持OpenAI API接口规范,所以基本都可以通过 ChatOpenAI 集成。
1.2 通过 ChatOpenAI 调用 DeepSeek
1 from langchain_openai import ChatOpenAI
2
3 load_dotenv(override=True)
4
5 # 通过ChatOpenAI 连接deepseek模型
6 DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
7 DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")
8
9 deepseek_llm2 = ChatOpenAI(
10 api_key=DEEPSEEK_API_KEY,
11 base_url=DEEPSEEK_BASE_URL,
12 model="deepseek-v4-flash",
13 )
14
15 response = deepseek_llm2.invoke("1 + 1 = ?")
16 print(response)
1.3 通过 ChatOpenAI 调用智谱与通义千问
1 load_dotenv(override=True)
2
3
4 #通过ChatOpenAI 连接智谱AI模型
5 ZHIPUAI_API_KEY = os.getenv("ZHIPUAI_API_KEY")
6 ZHIPUAI_BASE_URL = os.getenv("ZHIPUAI_BASE_URL")
7
8 zhipu_llm2 = ChatOpenAI(
9 api_key=ZHIPUAI_API_KEY,
10 base_url=ZHIPUAI_BASE_URL,
11 model="glm-5.1",
12 )
13
14 #通过ChatOpenAI 连接通义千问模型
15 DASHSCOPE_API_KEY = os.getenv("DASHSCOPE_API_KEY")
16 DASHSCOPE_BASE_URL = os.getenv("DASHSCOPE_BASE_URL")
17
18 tongyi_llm2 = ChatOpenAI(
19 api_key=DASHSCOPE_API_KEY,
20 base_url=DASHSCOPE_BASE_URL,
21 model="qwen-plus",
22 )
二、init_chat_model 统一初始化接口
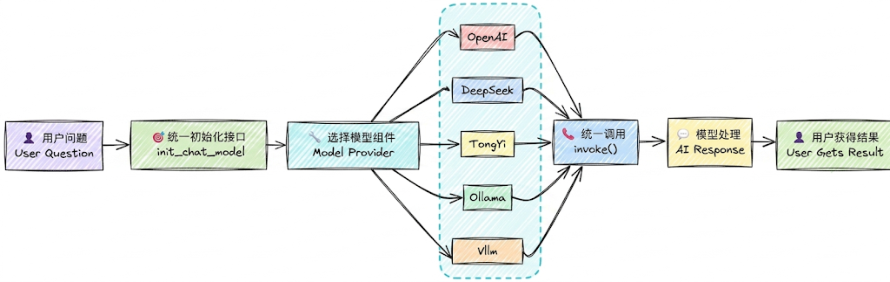
init_chat_model 是 LangChain 1.x 中推出的用于初始化聊天模型的统一接口。只要是LangChain支持的模型都可以处理,它会根据模型名称自动选择对应的模型类初始化实例。
2.1 基本语法
1 from langchain.chat_models import init_chat_model
2
3 model = init_chat_model(
4 "provider:model_name", # 提供商:模型名称
5 api_key="your-api-key", # API 密钥(可选,可从环境变量读取)
6 temperature=0.7, # 温度参数(可选)
7 max_tokens=1000, # 最大 token 数(可选)
8 **kwargs # 其他模型特定参数
9 )
2.2 与直接使用模型类的区别
回答: init_chat_model 是 LangChain 1.0 的统一接口,优势包括:
-
统一接口:无需记住每个提供商的不同初始化方式(以一致的方式初始化)
-
易于切换:简化了智能体系统中模型切换策略(只需修改模型字符串)
-
简洁明了:更简洁的语法,减少样板代码
-
自动适配:内部根据模型标识自动选择对应的驱动类(ChatOpenAI、ChatDeepSeek)
图示:
三、init_chat_model 使用示例
3.1 调用 DeepSeek 官网的大模型
1 import os
2 from langchain.chat_models import init_chat_model
3 from dotenv import load_dotenv
4
5 # 从.env文件中加载环境变量
6 load_dotenv(override=True)
7
8 # 从环境变量读取配置
9 DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
10 DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")
11
12
13 model = init_chat_model(model="deepseek:deepseek-v4-flash",
14 #model_provider="deepseek",
15 api_key=DEEPSEEK_API_KEY,
16 base_url=DEEPSEEK_BASE_URL)
17 # 向模型发送单条数据
18 response = model.invoke("你好,用一句话回答")
19 # 打印响应
20 print(response)
当我们传递的模型名称为deepseek-v4-flash 时,init_chat_model会自动调用ChatDeepSeek初始化模型实例,和直接通过ChatDeepSeek初始化的效果完全一致。
3.2 调用阿里百炼大模型
环境变量
1 DASHSCOPE_BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
2 DASHSCOPE_API_KEY=<YOUR_API_KEY>
代码:
1 from langchain.chat_models import init_chat_model
2 from dotenv import load_dotenv
3 import os
4
5 load_dotenv(override=True)
6
7 DASHSCOPE_API_KEY=os.getenv("DASHSCOPE_API_KEY")
8 DASHSCOPE_BASE_URL=os.getenv("DASHSCOPE_BASE_URL")
9
10 model = init_chat_model(model="qwen-plus",
11 model_provider="openai",
12 api_key=DASHSCOPE_API_KEY,
13 base_url=DASHSCOPE_BASE_URL)
14
15 print(model.invoke("你好,用一句话回答"))
3.3 调用 CloseAI 中转平台大模型
环境变量
1 CLOSEAI_API_KEY=<YOUR_API_KEY>
2 CLOSEAI_BASE_URL=https://api.openai-proxy.org/v1
代码:
1 from langchain.chat_models import init_chat_model
2 from dotenv import load_dotenv
3 import os
4
5 load_dotenv(override=True)
6
7 CLOSEAI_API_KEY=os.getenv("CLOSEAI_API_KEY")
8 CLOSEAI_BASE_URL=os.getenv("CLOSEAI_BASE_URL")
9
10 model = init_chat_model(model="deepseek-v4-flash",
11 model_provider="openai",
12 api_key=CLOSEAI_API_KEY,
13 base_url=CLOSEAI_BASE_URL)
14
15 print(model.invoke("你好,用一句话回答"))
3.4 model_provider 与模型提供商
3.4.1 model_provider 支持哪些 provider?
model_provider 表示模型的提供者,支持的providers有:anthropic , anthropic_bedrock,
azure_ai, azure_openai, bedrockbedrock_converse, cohere, deepseek , fireworks, google_anthropic_vertex, google_genai, google_vertexaigrog, huggingface, ibm, mistralai, nvidia,
ollama , openai , openrouter , perplexity, together, upstage, xai。
- 如果 model_provider=“openai” ,会自动加载langchain-openai 的依赖包,底层调用的是
ChatOpenAI 类。
-
如果 model_provider=“deepseek” ,会自动加载langchain-deepseek 的依赖包,底层调用的 是ChatDeepSeek 类。
-
像阿里的dashscope 尚未被LangChain官方纳入模型的统一注册体系,暂时不知 道"dashscope"的提供者是谁。此时可以将model_provider设置为openai,底层将会用openai的 规范处理请求,这就要求我们调用的模型服务是OpenAI Compatible的。
3.4.2 模型提供商的指定与自动推断
可以在model参数中通过前缀指定模型供应商,和模型名称之间用冒号分割,等价于通过 model_provider参数指定供应商。如果两个位置都没有指明供应商,LangChain底层会按照内置规则自动推断。
但是,并非所有的模型都支持自动推断,如model名称qwen-plus 不支持自动推断,没有指明供应商会报错。
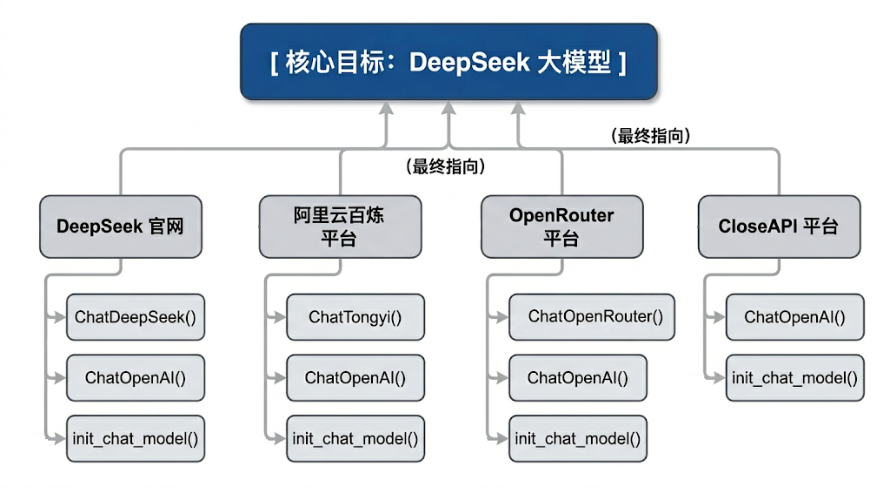
四、模型创建方式小结
1 DeepSeek官网的DeepSeek模型:可以调用ChatDeepSeek()、ChatOpenAI()、
init_chat_model()三种方式
2
3 阿里云百炼平台的DeepSeek模型:可以调用ChatTongyi()、ChatOpenAI()、init_chat_model()
三种方式
4
5 OpenRouter平台的DeepSeek模型:可以调用ChatOpenRouter()、ChatOpenAI()、
init_chat_model()三种方式
6
7 CloseAPI平台的DeepSeek模型:可以调用ChatOpenAI()、init_chat_model() 两种方式
五、常用模型初始化参数
在LangChain中,Model Class 和init_chat_model初始化模型共同的参数及解释。
API文档:https://docs.langchain.org.cn/oss/python/langchain/models#parameters
| model | str | 使用的特定提供商的模型名称(必需)。比如:openai:gpt-4o、groq:gemma2-9b-it | 无 |
| model_provider | str | 模型提供商名称 | 无 |
| api_key | str | API 密钥。如果不提供,会从环境变量中读取(如DEEPSEEK_API_KEY ) | None |
| base_url | str | 大模型供应商API请求地址。 | None |
| temperature | float | 控制输出随机性,范围 0.0-2.0,温度越高输出越随机。- 0.0 :最确定性,输出几乎不变- 1.0 :平衡创造性和一致性- 2.0 :最随机,最有创造性 | 0.7 |
| max_tokens | int | 限制模型输出的最大 token 数量 | None |
| timeout | float | 超时时间(秒),超时未响应,请求会被取消。 | None |
| max_retries | int | 请求失败(如网络问题、速率限制)时的最大重试次数 | 6 |
说明:
六、temperature 与 Token 实例
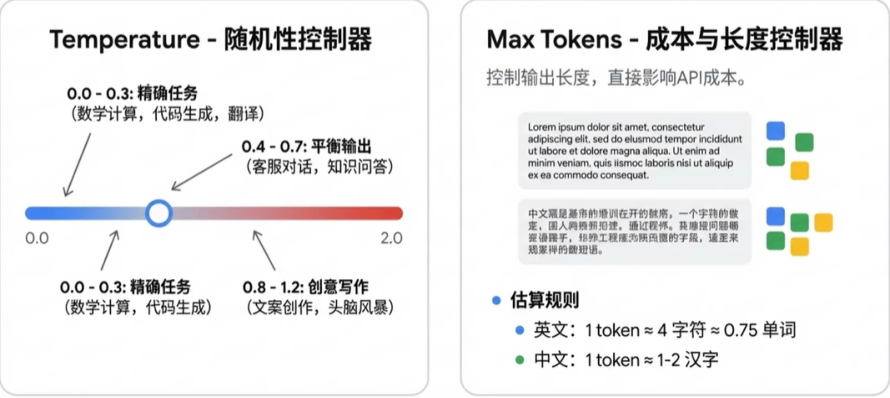
6.1 temperature 参数与使用场景
-
0.0-0.3:需要一致性、准确性的任务(数学计算、数据提取、分类、代码生成)
-
0.5-0.7:平衡创造性和一致性(聊天、问答)
-
0.8-1.5:创造性任务(写作、头脑风暴)
-
1.5-2.0:高度创造性(诗歌、故事创作)
6.1.1 低温度生成结果示例
1 from langchain.chat_models import init_chat_model
2 from dotenv import load_dotenv
3 import os
4 # 从.env文件中加载环境变量
5 load_dotenv(override=True)
6
7 model = init_chat_model(
8 # model="gpt-5.4-mini",
9 model="deepseek-v3.2",
10 model_provider="openai",
11 temperature=0,
12 api_key=os.getenv("CLOSEAI_API_KEY"),
13 base_url=os.getenv("CLOSEAI_BASE_URL"),
14 )
15 # 向模型发送单条数据
16 for i in range(3):
17 response = model.invoke("帮我写一首描述春天的七言绝句诗")
18 # 打印响应
19 print(response.content)
1 《春晓》
2 东君巡野过青岑,一岭云霞一岭金。
3 最是多情溪畔柳,偷藏莺语送行人。
4
5 注:我的创作思路是通过“东君巡野”、“云霞鎏金”等意象展现春日山川的瑰丽,以拟人手法赋予
自然灵性。后两句聚焦溪柳藏莺的细节,以“偷”字点破春的俏皮,结句“送行人”将画面延伸至画
外,留有余韵。全诗色彩明丽,动静相生,试图在传统春景题材中注入轻盈的巧思。
6 《春晓》
7 东君巡野过青岑,一岭云霞一岭金。
8 最是多情溪畔柳,偷藏莺语送行人。
9
10 注:我的创作思路是通过“东君巡野”、“云霞鎏金”等意象展现春日山川的瑰丽,以拟人手法赋予
溪柳灵性,借“偷藏莺语”传递春日的生机与含蓄情韵。诗中“巡”、“藏”、“送”等动词的运用,使
静态春景流动起来,末句以行人视角收束,留有余味。
11 《七绝·春晓》
12 一夜东风万树花,清溪破冻响琵琶。
13 莺啼柳浪云烟湿,人在春山第几家。
14
15 注:诗中“东风”、“万树花”展现春的蓬勃,“清溪破冻”以动衬静,暗喻生机复苏。后两句以莺啼
柳浪、云烟湿翠勾勒朦胧春色,尾句以问作结,平添寻春之趣与悠然余韵,全篇动静相宜,远近交
叠,尽显春之生意。
此时,设置为 后,模型会始终选择概率最高的 Token,确保字段准确、不胡乱发挥。
6.1.2 高温度生成结果对比
1 from langchain.chat_models import init_chat_model
2 from dotenv import load_dotenv
3 import os
4 # 从.env文件中加载环境变量
5 load_dotenv(override=True)
6
7 model = init_chat_model(
8 # model="gpt-5.4-mini",
9 model="deepseek-v3.2",
10 model_provider="openai",
11 temperature=1.5,
12 api_key=os.getenv("CLOSEAI_API_KEY"),
13 base_url=os.getenv("CLOSEAI_BASE_URL"),
14 )
15 # 向模型发送单条数据
16 for i in range(3):
17 response = model.invoke("帮我写一首描述春天的七言绝句诗")
18 # 打印响应
19 print(response.content)
1 《壬寅仲春即事》
2 东君醉酒泼彤云,一岭胭脂一岭曛。
3 怪道莺声啼不彻,枝头烧作石榴裙。
4
5 注:诗中“东君”代指春神,以其醉意泼洒彩霞为喻,形象展现春色之浓郁灵动。后两句通过莺啼
不绝与石榴裙的巧妙联想,以火焰比喻花海翻腾之势,全诗在传统春景描绘中融入奇幻色彩,浪漫
笔法间尽显春之热烈与生机盎然。
6 《春溪行》
7 东君遣暖润青苔,波光潋滟载云回。
8 莫道残寒犹料峭,一枝红蕊过溪来。
9
10 注:全诗以碧溪破冰、波光载云的视觉变化,展现初春的流动生机。后两句用“残寒料峭”与“红蕊
过溪”形成冷峻与热烈的鲜明对比,通过拟人化技法使春色具有冲破束缚的动势,暗合人生际遇中
希望常在的哲思。
11 《仲春野行》
12 东君遣煦渥郊乡,粉李绯桃竞试妆。
13 最赏青畴酥雨足,一犁烟水伴牛驮。
14
15 注:本诗以传统笔法勾勒春景,通过“东君遣煦”、“桃李试妆”展现春神的雍容与百花的娇媚。后
两句转写田园,以“酥雨”、“犁烟”意象突出春耕时节泥土的润泽与生机,牛驮微雨中缓行的画
面,传递出深邃而醇厚的自然生趣。
6.1.3 严格的结构化数据提取
1 from langchain.chat_models import init_chat_model
2 from dotenv import load_dotenv
3 import os
4 # 从.env文件中加载环境变量
5 load_dotenv(override=True)
6
7 model = init_chat_model(
8 model="deepseek-v3.2",
9 model_provider="openai",
10 temperature=0,
11 api_key=os.getenv("CLOSEAI_API_KEY"),
12 base_url=os.getenv("CLOSEAI_BASE_URL"),
13 )
14 # 向模型发送单条数据
15 response = model.invoke("张三,男,30岁,拥有8年编程开发经验,目前在某互联网大厂担任技
术专家。帮我从上文中提取数据,返回JSON格式")
16 print(response.content)
1 {
2 "name": "张三",
3 "gender": "男",
4 "age": 30,
5 "programming_experience_years": 8,
6 "current_position": "技术专家",
7 "current_company_type": "互联网大厂"
8 }
6.1.4 创意文案与头脑风暴
1 from langchain.chat_models import init_chat_model
2 from dotenv import load_dotenv
3 import os
4 # 从.env文件中加载环境变量
5 load_dotenv(override=True)
6
7 model = init_chat_model(
8 model="deepseek-v3.2",
9 model_provider="openai",
10 temperature=1.5,
11 api_key=os.getenv("CLOSEAI_API_KEY"),
12 base_url=os.getenv("CLOSEAI_BASE_URL"),
13 )
14 # 向模型发送单条数据
15 response = model.invoke("请为一款极致静音的机械键盘写3个充满诗意且极具张力的广告语。")
16 print(response.content)
1 1. **「指尖落下无声诗,每个字都沉入深海」**
2 *奔赴思绪的静谧领域,让敲击成为心流的涟漪*
3
4 2. **「在银桦雪原上耕种文字,唯留耕者的呼吸」**
5 *以失声的机械之齿,驯服每一次破晓的灵感*
6
7 3. **「当键盘学会芭蕾,世界只剩文案绽放的轻重音」**
8 *精密弹力悬浮于声学悬空层,触感在寂静中震耳欲聋*
9
10 —
11
12 注:广告语核心将“静音”属性诗化为**创作禅境、自然隐喻与艺术比拟**,通过矛盾张力(如
“失声的机械”“寂静中震耳欲聋”)强化产品颠覆性,适用于高端文创/科技消费场景。
6.2 Token 是什么?
基本单位: 大模型通过分词器(Tokenizer)将文本拆分后的最小语义单元是token(相当于自然语言中
的词或字)。不同的模型采用不同的分词算法(如BPE、WordPiece),因此同一段文本在不同模型中 的Token数量可能不同。
收费依据:大语言模型通常也是以token的数量作为其计量(或收费)的依据。
-
1个中文Token≈1-1.8个汉字,1个英文Token≈3-4个字符
-
Token与字符转化的可视化工具:
OpenAI提供:https://platform.openai.com/tokenizer 百度智能云提供:https://console.bce.baidu.com/support/#/tokenizer
6.2.1 限制输出 Token 的示例
1 from langchain.chat_models import init_chat_model
2 from dotenv import load_dotenv
3 import os
4 # 从.env文件中加载环境变量
5 load_dotenv(override=True)
6
7 model = init_chat_model(
8 # model="gpt-5.4-nano",
9 model="gpt-5.4-mini",
10 # temperature=0.7,
11 api_key=os.getenv("CLOSEAI_API_KEY"),
12 base_url=os.getenv("CLOSEAI_BASE_URL"),
13 max_tokens=15,
14 )
15 # 向模型发送单条数据
16 response = model.invoke("请用中文详细介绍什么是AI")
17 # 打印响应
18 print(response)
19
20 # print(response.content)
21 # print(response.response_metadata["finish_reason"])
1 content='当然可以。下面我用中文尽量系统、通' additional_kwargs={'refusal':
None} response_metadata={'token_usage': {'completion_tokens': 15,
'prompt_tokens': 14, 'total_tokens': 29, 'completion_tokens_details':
{'accepted_prediction_tokens': 0, 'audio_tokens': 0, 'reasoning_tokens':
0, 'rejected_prediction_tokens': 0}, 'prompt_tokens_details':
{'audio_tokens': 0, 'cached_tokens': 0}, 'latency_checkpoint':
{'engine_tbt_ms': 5, 'engine_ttft_ms': 29, 'engine_ttlt_ms': 109,
'pre_inference_ms': 83, 'service_tbt_ms': 4, 'service_ttft_ms': 279,
'service_ttlt_ms': 336, 'total_duration_ms': 261,
'user_visible_ttft_ms': 196}}, 'model_provider': 'openai', 'model_name':
'gpt-5.4-mini-2026-03-17', 'system_fingerprint': None, 'id': 'chatcmpl-
Dg3tYDOZ1xWSR3EaTX8jlM58yUSq2', 'service_tier': 'default',
'finish_reason': 'length', 'logprobs': None} id='lc_run–019e2fb9-11b0-
7901-9076-a45fc0b41125-0' tool_calls=[] invalid_tool_calls=[]
usage_metadata={'input_tokens': 14, 'output_tokens': 15, 'total_tokens':
29, 'input_token_details': {'audio': 0, 'cache_read': 0},
'output_token_details': {'audio': 0, 'reasoning': 0}}