引言:纸上推完了公式,这一篇把它变成能跑的代码
先花 30 秒回顾上一篇(第十七篇)。我们在纸上干完了三件事:
但这里有个"落差":公式漂亮,代码怎么写? 第十七篇结尾我们放了句狠话——“把递推式一行行翻译成 NumPy”。这一篇就是来兑现的。
打个比方:第十七篇我们拿到了地图(整条推导链),这一篇是真正开车上路——把地图翻译成导航软件的每一步动作;再顺手做两件驾驶员的日常:出发前检查车况(数值梯度体检),下坡时踩刹车(梯度裁剪)。
你可能会想:公式都验证过了,抄成代码还不简单?真不一定。转置写反、漏乘 tanh\\tanhtanh 导数、时间步累加少加一项、批次忘了平均——任何一个细节错了,梯度就错得悄无声息,训练要么不动、要么爆炸。所以这一章真正要学的不是"抄代码",而是一套让自己不写错的流程:公式逐行对照、数值梯度体检、最后再上保险(裁剪)。
🎯 本章四大目标
本篇路线图:公式变代码的思路(第一节)→ 实操 A:小模型跑通(第二节)→ 数值梯度体检(第三节)→ 梯度裁剪原理(第四节)→ 实操 D:裁剪前后训练对比(第五节)→ 里程碑配图(第六节)→ 封装成 RNNLayer(第七节)→ 常见坑与 FAQ(第八节)→ 小结与下章预告(第九节)。
一、公式变代码:rnn_backward 的骨架
1.1 一张对照表,公式和代码一一对应
先看全貌。第十七篇的推导链,翻译成代码就是下面四件事(顺序不能乱):
| δyt=yt−tt\\delta_{y_t} = y_t – t_tδyt=yt−tt | delta_y = y_seq – target(每个时间步) |
| δt=(δt+1Whh⊤+δytWhy⊤)⊙(1−ht2)\\delta_t = (\\delta_{t+1}W_{hh}^{\\top} + \\delta_{y_t}W_{hy}^{\\top})\\odot(1-h_t^2)δt=(δt+1Whh⊤+δytWhy⊤)⊙(1−ht2) | 倒序 for 循环里一行矩阵运算 |
| ∂L/∂Why=∑tht⊤δyt\\partial L/\\partial W_{hy} = \\sum_t h_t^{\\top}\\delta_{y_t}∂L/∂Why=∑tht⊤δyt | dW_hy += h_t.T @ delta_y[t] |
| ∂L/∂Whh=∑tht−1⊤δt\\partial L/\\partial W_{hh} = \\sum_t h_{t-1}^{\\top}\\delta_t∂L/∂Whh=∑tht−1⊤δt | dW_hh += h_prev_t.T @ delta_z |
| ∂L/∂Wxh=∑txt⊤δt\\partial L/\\partial W_{xh} = \\sum_t x_t^{\\top}\\delta_t∂L/∂Wxh=∑txt⊤δt | dW_xh += x_t.T @ delta_z |
一眼就能看出两件事:第一,循环必须倒着走(δt\\delta_tδt 依赖未来的 δt+1\\delta_{t+1}δt+1);第二,梯度是 += 累加出来的(权重被所有时间步共享,每个时间步的贡献都不能少)。
1.2 为什么"倒着走"?——像拆一座积木塔
回想第三章 cache 里存了什么:每个时间步的 xt,ht−1,zt,htx_t, h_{t-1}, z_t, h_txt,ht−1,zt,ht,堆叠成 (S,B,⋅)(S,B,\\cdot)(S,B,⋅) 的四摞"口粮"。反向传播就像拆积木塔:只能从塔尖(最后一个时间步)往下拆,因为下面每一块的"承重"都来自上面。写成代码就是一行:
for t in range(S – 1, –1, –1): # 从最后一步倒着走到第 0 步
如果你写成 for t in range(S)(正着走),算 δ0\\delta_0δ0 的时候 δ1\\delta_1δ1 还没出生——直接算错。这是新手最经典的坑,第八节还会细说。
1.3 完整实现(本章的主角)
import numpy as np
def rnn_forward(x, W_xh, W_hh, W_hy, b_h, b_y, h0):
"""前向:x:(B,S,I),返回 (h_seq:(S,B,H), y_seq:(S,B,O), cache)。
与第3章完全一致,每个时间步的中间量都存进 cache。"""
S = x.shape[1]
h_prev = h0
h_seq, y_seq = [], []
cache = {'x': [], 'h_prev': [], 'z': [], 'h': []}
for t in range(S):
x_t = x[:, t, :]
z_t = np.dot(x_t, W_xh) + np.dot(h_prev, W_hh) + b_h
h_t = np.tanh(z_t)
y_t = np.dot(h_t, W_hy) + b_y
for k, v in (('x', x_t), ('h_prev', h_prev), ('z', z_t), ('h', h_t)):
cache[k].append(v)
h_seq.append(h_t); y_seq.append(y_t)
h_prev = h_t
h_seq = np.stack(h_seq, axis=0)
y_seq = np.stack(y_seq, axis=0)
for k in cache:
cache[k] = np.stack(cache[k], axis=0)
return h_seq, y_seq, cache
def mse_loss(y_seq, target):
"""L = 1/2 * Σ_t ||y_t – target_t||^2,target:(B,S,O)"""
tgt = target.transpose(1, 0, 2) # (B,S,O) -> (S,B,O),对齐 y_seq
diff = y_seq – tgt
return 0.5 * np.sum(diff * diff)
def rnn_backward(y_seq, target, cache, W_xh, W_hh, W_hy, B):
"""拿着 cache 倒着走时间轴,输出五个梯度。
第17篇的递推公式,一行行翻译成 NumPy。"""
S = y_seq.shape[0]
tgt = target.transpose(1, 0, 2) # (B,S,O) -> (S,B,O)
delta_y = y_seq – tgt # δ_{y_t} = y_t – target_t (S,B,O)
dW_xh = np.zeros_like(W_xh)
dW_hh = np.zeros_like(W_hh)
dW_hy = np.zeros_like(W_hy)
db_h = np.zeros(W_xh.shape[1])
db_y = np.zeros(W_hy.shape[1])
delta_next = np.zeros((B, W_hh.shape[0])) # δ_{T+1} = 0:最后一步没有"未来"
for t in range(S – 1, –1, –1): # 必须倒序!
h_t = cache['h'][t] # (B,H),cache 里的现成值
d_tanh = 1.0 – h_t * h_t # tanh 闸门 (1-h_t^2)
# 直接路径(经 W_hy)+ 时间路径(经 W_hh 从未来回传),汇合后过闸门
delta_z = (np.dot(delta_next, W_hh.T) +
np.dot(delta_y[t], W_hy.T)) * d_tanh # δ_t
# 各回各家 + 时间步累加
dW_hy += np.dot(cache['h'][t].T, delta_y[t]) # Σ h_t^T δ_y_t
dW_hh += np.dot(cache['h_prev'][t].T, delta_z) # Σ h_{t-1}^T δ_t
dW_xh += np.dot(cache['x'][t].T, delta_z) # Σ x_t^T δ_t
db_h += delta_z.sum(axis=0)
db_y += delta_y[t].sum(axis=0)
delta_next = delta_z # 传递给更早的时间步
# 除以样本数 B:梯度是"整批的合力",平均一下更稳,
# 这样换批次大小也不用改学习率
return {'W_xh': dW_xh / B, 'W_hh': dW_hh / B, 'W_hy': dW_hy / B,
'b_h': db_h / B, 'b_y': db_y / B}
逐行对照第十七篇的公式,你会发现每一行都能在推导里找到出处,没有一行是"凭感觉"写的。这就是把理论翻译成代码的正确姿势:先有公式,再有代码——代码是公式的影子。
两个小细节值得记住:
- delta_next 的初值是 (B,H)(B, H)(B,H) 的全零矩阵,对应递推的边界条件 δT+1=0\\delta_{T+1} = \\mathbf{0}δT+1=0——最后一步没有"未来"可回传,这个"零"是从数学里直接搬过来的;
- d_tanh = 1.0 – h_t * h_t 用的是 cache 里的 hth_tht 现算(ht=tanh(zt)h_t = \\tanh(z_t)ht=tanh(zt),所以 1−ht21-h_t^21−ht2 就是 tanh\\tanhtanh 导数),不用再去翻 ztz_tzt——这就是第三章拼命存 cache 的全部意义。
二、实操 A:同款小模型,梯度逐位对上
理论说得再热闹,不如跑一次。我们还是用第十七篇那套"小到能心算"的模型(I=2,H=3,O=2,B=1,S=2I=2, H=3, O=2, B=1, S=2I=2,H=3,O=2,B=1,S=2),权重、输入、h0h_0h0 原封不动,连目标值都一样——这样第 17 篇手算的每个中间数,都能拿来当"标准答案"。
# —- 第3章 / 第17章同一套小模型 —-
w_xh = np.array([[0.5, –0.2, 0.3], [–0.1, 0.4, 0.2]]) # (2,3)
w_hh = np.array([[0.8, 0.1, 0.0], [0.2, 0.7, –0.1], [0.0, 0.3, 0.6]]) # (3,3)
w_hy = np.array([[0.5, –0.4], [0.2, 0.3], [–0.1, 0.6]]) # (3,2)
bh = np.array([0.1, –0.1, 0.05])
by = np.array([0.0, 0.0])
x = np.array([[[1.0, –1.0], [0.5, 0.5]]]) # (1,2,2)
h0 = np.zeros((1, 3))
target = np.array([[[1.0, –1.0], [–0.5, 0.5]]]) # (1,2,2)
h_seq, y_seq, cache = rnn_forward(x, w_xh, w_hh, w_hy, bh, by, h0)
print('损失 L =', mse_loss(y_seq, target))
grads = rnn_backward(y_seq, target, cache, w_xh, w_hh, w_hy, B=1)
for k, v in grads.items():
print(k, '\\n', v)
运行输出(前向结果与第 17 篇逐位一致,损失 L=0.968125L = 0.968125L=0.968125):
损失 L = 0.9681247416169603
W_xh =
[[-0.05341102 0.06150134 0.09576618]
[ 0.43272213 -0.09239557 -0.43402304]]
W_hh =
[[ 0.22924341 -0.01867148 -0.20443155]
[-0.22924341 0.01867148 0.20443155]
[ 0.05647375 -0.00459969 -0.05036138]]
W_hy =
[[-0.10563271 0.07125223]
[ 0.29262747 -0.22690562]
[ 0.16533215 -0.14172963]]
b_h = [ 0.13624453 0.04605422 -0.07336225]
b_y = [-0.14722793 0.09495948]
拿第十七篇实操 A 手推的"标准答案"(那边打印保留 4 位小数)来逐位核对,五个参数的最大误差:
| WhyW_{hy}Why | 4.78×10−54.78\\times10^{-5}4.78×10⁻⁵ |
| WhhW_{hh}Whh | 4.34×10−54.34\\times10^{-5}4.34×10⁻⁵ |
| WxhW_{xh}Wxh | 3.38×10−53.38\\times10^{-5}3.38×10⁻⁵ |
| bhb_hbh | 4.58×10−54.58\\times10^{-5}4.58×10⁻⁵ |
| byb_yby | 4.05×10−54.05\\times10^{-5}4.05×10⁻⁵ |
误差全在 10−510^{-5}10−5 量级——这不是写错了,而是第 17 篇的手推值只保留到 4 位小数,这点误差就是"四舍五入"本身。也就是说:纸上手推的、代码算的,是同一个东西。递推公式翻译成代码这一步,通过。
三、数值梯度体检:给反向传播"验明正身"
3.1 为什么还要体检?——“自己写的"不等于"对的”
实操 A 只是拿"手推值"对了一遍,等于两个可能同时算错的人互相印证。万一我们的递推式本身有 bug(转置写反、漏乘 ⊙\\odot⊙、tanh\\tanhtanh 导数写错、少加一个时间步……),那"手推对上了"也说明不了什么。
金标准是数值梯度:不碰任何公式,只靠导数的定义来算。把某个参数的元素拨动一丁点 ε\\varepsilonε,看损失怎么变——中心差分(比单边差分更准):
∂L∂θi ≈ L(θi+ε)−L(θi−ε)2ε
\\frac{\\partial L}{\\partial \\theta_i} \\;\\approx\\; \\frac{L(\\theta_i + \\varepsilon) – L(\\theta_i – \\varepsilon)}{2\\varepsilon}
∂θi∂L≈2εL(θi+ε)−L(θi−ε)
对每个参数元素都这么干一遍,得到"数值梯度";再和 rnn_backward 的"解析梯度"比。差值 <10−6<10^{-6}<10−6 就算合格。
💡 生活类比:解析梯度像精算师(算得快,但可能算错),数值梯度像实验员(慢,但绝对诚实)。让两个职业对同一笔账,对得上就说明精算师没算错。体检通过之后,训练时放心用快的那个——数值梯度要为每个参数元素跑两次前向,序列一长就慢到没法用,它的使命就是当"裁判",不是当"主力"。
3.2 体检代码
def numerical_grads(x, target, W_xh, W_hh, W_hy, b_h, b_y, h0, eps=1e-7):
"""对每个参数元素逐个扰动,用中心差分估计真实梯度"""
params = {'W_xh': W_xh, 'W_hh': W_hh, 'W_hy': W_hy,
'b_h': b_h, 'b_y': b_y}
def loss_with():
_, ys, _ = rnn_forward(x, W_xh, W_hh, W_hy, b_h, b_y, h0)
return mse_loss(ys, target)
grads = {}
B = x.shape[0]
for name, P in params.items():
G = np.zeros_like(P)
for idx in np.ndindex(P.shape):
orig = P[idx]
P[idx] = orig + eps
fp = loss_with()
P[idx] = orig – eps
fm = loss_with()
P[idx] = orig
G[idx] = (fp – fm) / (2 * eps) # 中心差分
grads[name] = G / B # 与解析梯度口径一致:对批次平均
return grads
两个细节:
3.3 实操 B:两轮体检,全部通过
第一轮:还是同款小模型,ε=10−6\\varepsilon = 10^{-6}ε=10−6(与第 17 篇口径一致):
B1:小模型(B=1, S=2, eps=1e-6)
W_xh 解析 vs 数值 最大误差 = 1.280e-10 OK
W_hh 解析 vs 数值 最大误差 = 5.897e-11 OK
W_hy 解析 vs 数值 最大误差 = 4.474e-11 OK
b_h 解析 vs 数值 最大误差 = 1.110e-10 OK
b_y 解析 vs 数值 最大误差 = 9.377e-11 OK
这组数字眼熟吗?——和第 17 篇实操 C 的体检结果一模一样。因为模型、权重、目标值全都一样,体检的对象本来就是同一件事。第 17 篇体检的是"手推的递推公式",本篇体检的是"翻译成代码的递推公式",两轮都过关,说明公式 → 代码 → 数值三者完全闭合,推导链没有一个环节出岔子。
第二轮:换一个更大的随机模型,多批次(I=2,H=4,O=2,B=2,S=3I=2, H=4, O=2, B=2, S=3I=2,H=4,O=2,B=2,S=3,共 38 个参数元素),ε=10−7\\varepsilon = 10^{-7}ε=10−7,改用相对误差当标准:
B2:随机多批次模型(I=2,H=4,O=2,B=2,S=3, eps=1e-7)
相对误差 = |解析 – 数值| / max(|解析|, |数值|, 1e-8)
W_xh 相对误差 = 1.096e-08 OK
W_hh 相对误差 = 8.986e-08 OK
W_hy 相对误差 = 3.443e-08 OK
b_h 相对误差 = 4.181e-09 OK
b_y 相对误差 = 6.362e-10 OK
全部在 10−810^{-8}10−8 量级,远优于 10−610^{-6}10−6 的合格线。批次、序列长度、隐层大小一起变,体检照样全绿——这说明 rnn_backward 不是"凑巧对小模型成立",而是对任意规模都成立。
💡 体检技巧(这是调试反向传播的日常工作流):先用小随机初始化 + 短序列(S=3S=3S=3)体检,出错容易定位;通过后再逐步加大规模。如果体检 FAIL,先放大 ε\\varepsilonε 看是不是浮点精度问题——ε\\varepsilonε 太小时 L(θ+ε)L(\\theta+\\varepsilon)L(θ+ε) 和 L(θ−ε)L(\\theta-\\varepsilon)L(θ−ε) 差不了多少,误差反而变大;太大时中心差分本身不准。常用区间 10−6∼10−710^{-6}\\sim10^{-7}10−6∼10−7。
四、梯度裁剪:给梯度装"限速器"
4.1 回顾:梯度爆炸是怎么发生的
第十七篇讲过,梯度沿时间轴回传是一串连乘:
∂hT∂h1=∏t=1T−1Whh⊤ diag(1−ht2)
\\frac{\\partial h_T}{\\partial h_1} = \\prod_{t=1}^{T-1} W_{hh}^{\\top}\\,\\mathrm{diag}(1-h_t^2)
∂h1∂hT=t=1∏T−1Whh⊤diag(1−ht2)
谱半径 ρ(Whh)>1\\rho(W_{hh}) > 1ρ(Whh)>1 时,这个连乘随时间步数 TTT 指数放大。回传 30 步放大 19 万倍(第 17 篇实操 D),回传 100 步呢?数字大到计算机都存不下。梯度一旦爆炸,参数更新一步就"飞出天际",下一轮前向直接算出一堆 NaN——训练当场暴毙,而且死得悄无声息,只留给你一条崩溃的 loss 曲线。
4.2 限速器的原理:方向不变,只降速
想象你推着购物车冲下坡,速度越来越快,眼看要失控。这时候有人给你装了个限速器:超过某个速度,就只允许你以"限速值"前进——想去哪一排(方向)完全不变,只是速度被按住。车不会失控,也不会把你带偏。
梯度裁剪(Gradient Clipping)干的就是这件事。先把所有梯度拼在一起,算出总长度(L2 范数):
∥g∥=∑θgθ2
\\|g\\| = \\sqrt{\\sum_{\\theta} g_{\\theta}^2}
∥g∥=θ∑gθ2
如果 ∥g∥\\|g\\|∥g∥ 超过限速值 clip_norm\\text{clip\\_norm}clip_norm,就把所有梯度等比例缩小,让总长度刚好回到限速值:
g′=g⋅clip_norm∥g∥(当 ∥g∥>clip_norm)
g' = g \\cdot \\frac{\\text{clip\\_norm}}{\\|g\\|} \\qquad (\\text{当 } \\|g\\| > \\text{clip\\_norm})
g′=g⋅∥g∥clip_norm(当 ∥g∥>clip_norm)
注意是"等比例缩小"——每个梯度分量都乘同一个系数 clip_norm∥g∥<1\\frac{\\text{clip\\_norm}}{\\|g\\|} < 1∥g∥clip_norm<1,所以各分量的比例关系一点没变,只是整体变短了。数学上,这不动"该往哪个方向走",只改"走多快"。
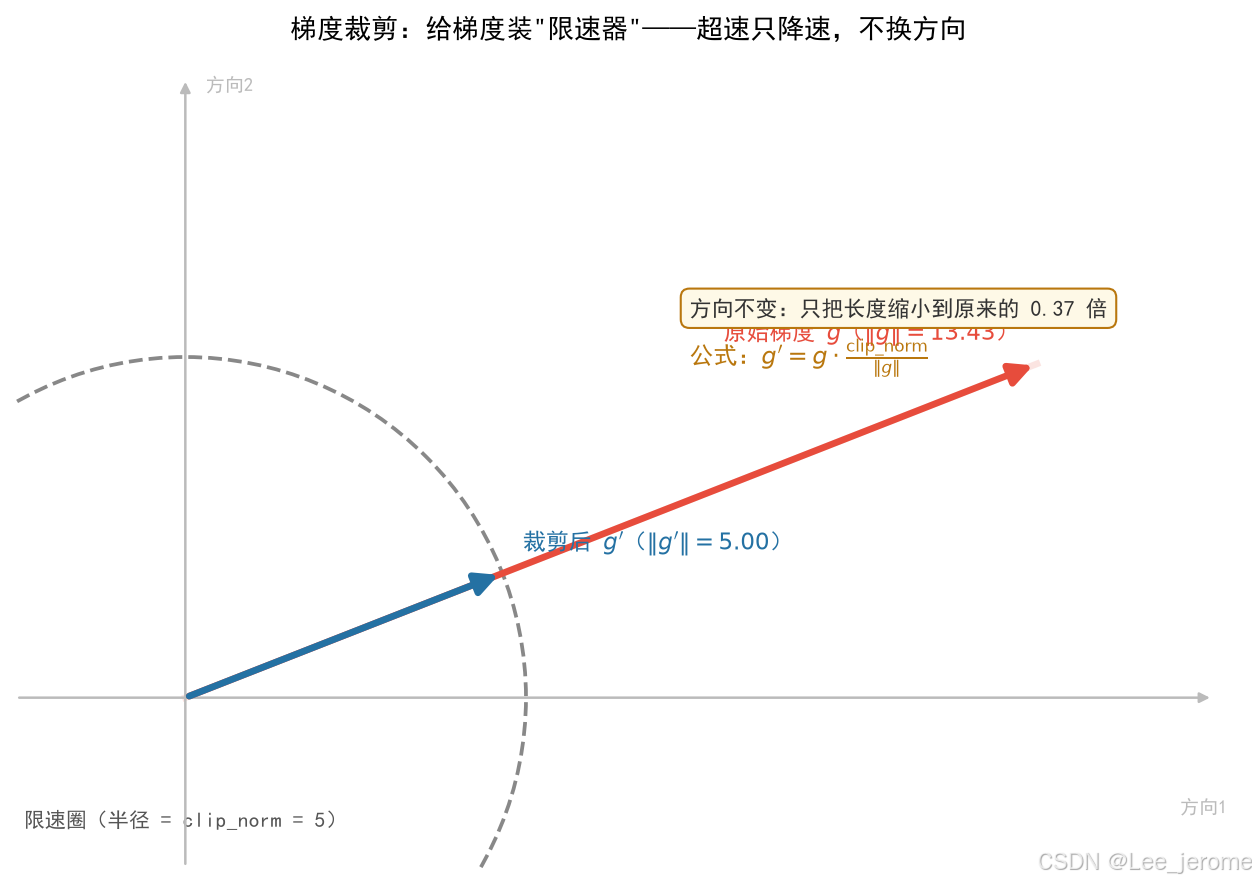
上图:红色长箭头是原始梯度 ggg(∥g∥=13.42\\|g\\|=13.42∥g∥=13.42),虚线圆是"限速圈"(半径 =clip_norm=5=\\text{clip\\_norm}=5=clip_norm=5),蓝色短箭头是裁剪后的 g′g'g′——它被拉回圈内,但角度(方向)和红色箭头完全一致。
4.3 实操 C:亲手捏爆一批梯度
光看公式不过瘾,我们伪造一批"爆炸"梯度,看看限速器怎么工作:
def global_norm(grads):
"""所有梯度拼在一起算出的总长度(L2 范数)"""
total = sum(np.sum(g * g) for g in grads.values())
return float(np.sqrt(total))
def clip_by_norm(grads, clip_norm):
"""范数裁剪:||g|| > clip_norm 时,整体乘以 clip_norm / ||g||"""
norm = global_norm(grads)
if norm > clip_norm:
scale = clip_norm / norm
return {k: v * scale for k, v in grads.items()}, norm, clip_norm
return grads, norm, norm
造一批随机梯度,把总范数"摆"到 13.42(远超市面上常见的默认值 5.0),跑一遍裁剪:
伪造一批"爆炸"梯度,总范数 ||g|| = 13.4200(远超限速 5.0)
裁剪后总范数 = 5.0000(刚好压回限速圈内)
缩放比例 scale = clip_norm / ||g|| = 0.3726
裁剪前后对比(只列前几个元素):
W_xh[0] 3.635562 -> 1.354531
W_xh[1] -1.002022 -> -0.373332
W_xh[2] 0.070581 -> 0.026297
W_xh[4] -1.696619 -> -0.632123
每个元素都精确地缩到了原来的 0.37260.37260.3726 倍——不多不少。这就是"等比例"的含义。
顺带提一句:还有另一种叫按值裁剪的做法——把每个元素单独夹到 [−c,c][-c, c][−c,c](np.clip),简单粗暴。但它有个毛病:不同方向的压缩比例不一样(大的压得多、小的压得少),等于悄悄改了梯度的方向。所以主流框架(比如 PyTorch 的 clip_grad_norm_)都推荐按范数裁剪,我们全文也用这种。
五、实操 D:同一套参数,裁剪前后天壤之别
光看裁剪的数字还不够震撼,我们来训练一个真实的小任务,看"不裁剪"和"裁剪"在训练场上的生死对比。
5.1 任务设定:预测序列的"下一位"
设计一个周期为 6 的数列:[0.3,−0.7,0.5,0.9,−0.4,0.1][0.3, -0.7, 0.5, 0.9, -0.4, 0.1][0.3,−0.7,0.5,0.9,−0.4,0.1] 循环出现。输入 xtx_txt 是当前位置的数,目标 ttt_ttt 是下一个数。序列长度 S=24S=24S=24(模式重复 4 遍),隐层 H=8H=8H=8,学习率 0.1,训练 300 步。
关键操作:初始化时故意把 WhhW_{hh}Whh 的谱半径放大到 1.2(>1>1>1)——按第十七篇的理论,时间轴连乘会放大梯度,这是一颗"定时炸弹"。训练代码:
pattern = np.array([0.3, –0.7, 0.5, 0.9, –0.4, 0.1])
n = 24
idx = np.arange(n) % 6
x = pattern[idx].reshape(1, n, 1) # 输入:当前位置的值
target = pattern[(idx + 1) % 6].reshape(1, n, 1) # 目标:下一个值
# 手工打造一个"危险"的 W_hh:谱半径 1.2(>1,时间轴连乘会放大梯度)
rng = np.random.RandomState(0)
W = rng.randn(8, 8) * 0.5
rho0 = np.max(np.abs(np.linalg.eigvals(W)))
W_hh_hot = W * (1.2 / rho0)
model = RNNLayer(1, 8, 1, seed=0) # 类封装见第七节,先当黑盒用
model.W_hh = W_hh_hot.copy()
losses, norms = [], []
for step in range(300):
_, y_seq = model.forward(x)
loss = mse_loss(y_seq, target)
losses.append(loss)
model.backward(target)
before, after = model.clip_grads(clip_norm=1.0) # 装上限速器
norms.append(after)
if np.isnan(loss) or np.isinf(loss):
print('第 %d 步炸了' % step); break
model.update(lr=0.1)
对照组就是把 model.clip_grads(…) 那一行删掉,其余一字不改。
💡 这里限速值取 1.0 而不是常用的 5.0,是因为我们把 WhhW_{hh}Whh 谱半径刻意放大到 1.2,梯度常年超标——限速紧一点,收敛才看得见。clip_norm 是个旋钮,不是教条,实践中可以试 1、5、10 几个档位。
5.2 不裁剪:loss 冲上天,第 125 步直接 NaN
【不裁剪】梯度一路狂飙(log10 视角):
step 0 loss = 3.7179e+00 ||g|| = 7.7399e+00
step 1 loss = 5.8053e+00 ||g|| = 2.9364e+01
step 2 loss = 6.1179e+01 ||g|| = 1.6916e+02
step 3 loss = 2.8282e+02 ||g|| = 5.3216e+02
step 4 loss = 1.0991e+04 ||g|| = 2.3063e+03
step 6 loss = 1.1318e+06 ||g|| = 3.0159e+05
step 8 loss = 1.0566e+10 ||g|| = 2.1365e+06
step 10 loss = 5.1058e+14 ||g|| = 2.3040e+12
step 16 loss = 1.8003e+29 ||g|| = 8.5661e+15
step 24 loss = 7.1260e+49 ||g|| = 1.7043e+26
step 32 loss = 2.8207e+70 ||g|| = 3.3907e+36
step 40 loss = 1.1165e+91 ||g|| = 6.7460e+46
-> 第 125 步 loss 变成 NaN(梯度爆炸,参数飞出去了)
看清这几行数字的量级:40 步,loss 从 3.7 涨到 109110^{91}1091,梯度范数涨到 104610^{46}1046。指数增长就是这样不讲道理——第 4 步还是 1 万,第 8 步就是 100 亿,第 40 步已经是"91 个 0"。到第 125 步,数值溢出成 NaN,训练当场暴毙。
5.3 裁剪:梯度贴线,loss 稳步下降
【裁剪(clip_norm=1.0)】梯度被按住,loss 稳步下降:
step 0 loss = 3.717908 ||g|| = 1.0000
step 20 loss = 0.297147 ||g|| = 1.0000
step 40 loss = 0.182106 ||g|| = 1.0000
step 60 loss = 0.132999 ||g|| = 1.0000
step 80 loss = 0.107418 ||g|| = 1.0000
step 100 loss = 0.093881 ||g|| = 1.0000
step 140 loss = 0.085506 ||g|| = 1.0000
step 180 loss = 0.080405 ||g|| = 1.0000
step 220 loss = 0.076266 ||g|| = 1.0000
step 260 loss = 0.073468 ||g|| = 1.0000
step 299 loss = 0.063755 ||g|| = 1.0000
最终 loss = 0.063755(从 3.72 降到了 0.06)
注意 ||g|| 那一列——每一步都被按在 1.0 上,这正是限速器在工作:原始梯度动辄 3~8,超速了,就压到 1.0。loss 呢?从 3.72 一路降到 0.064,降幅 98% 以上。同样参数、同样任务、同样初始化,唯一的区别就是裁不裁剪。
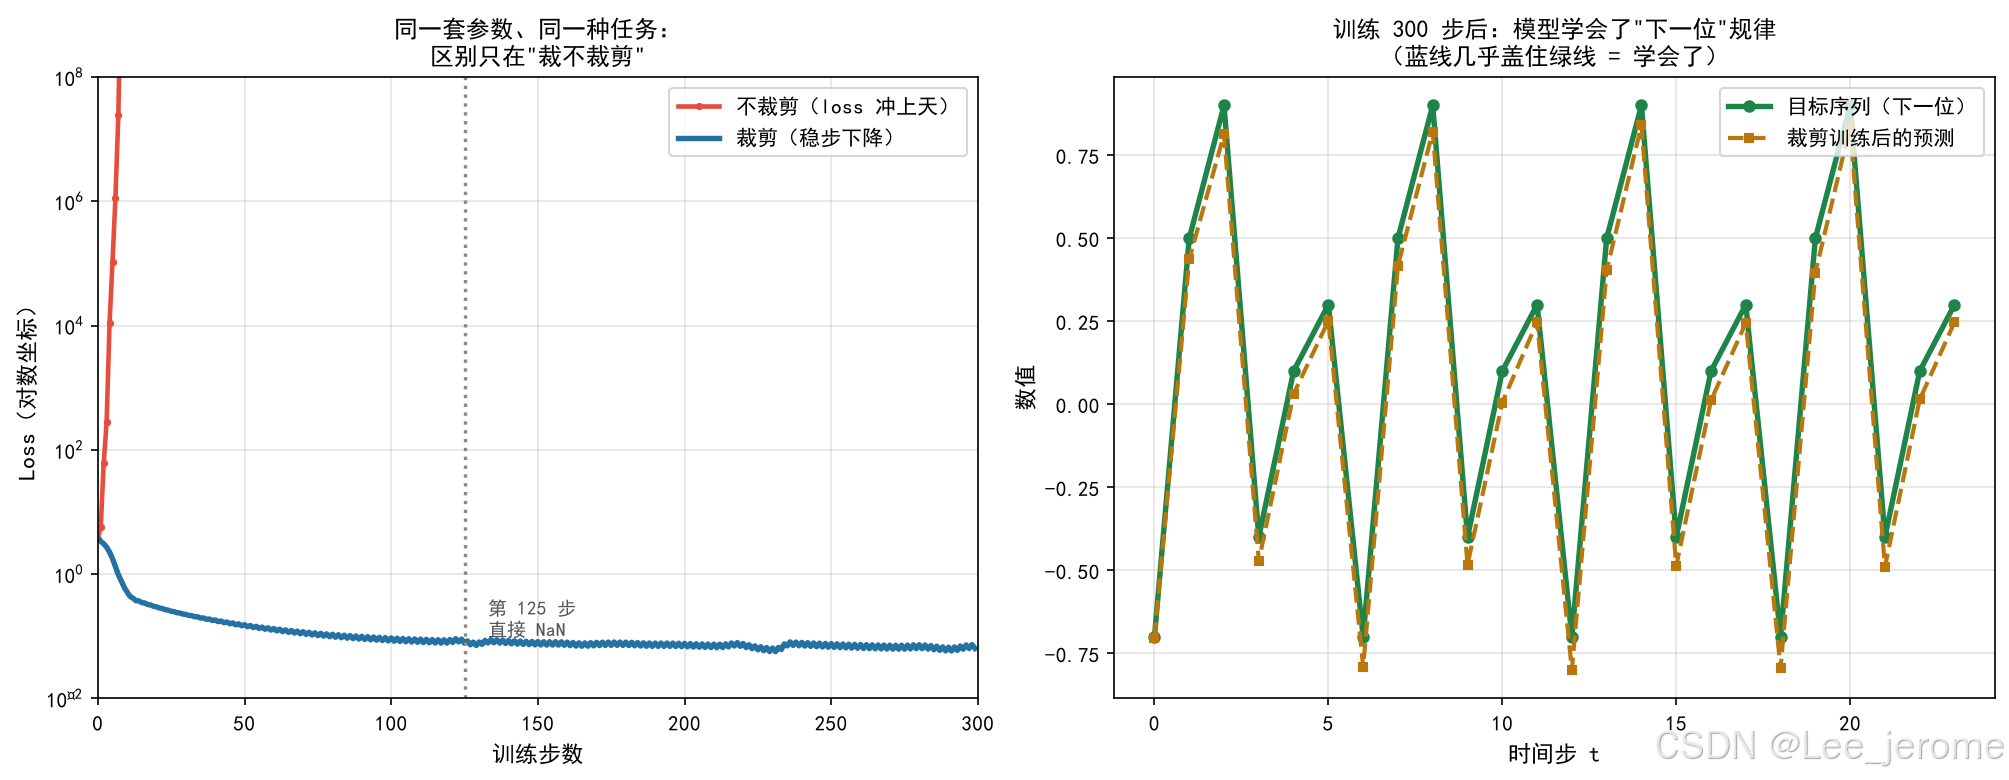
左图:红色线(不裁剪)几步之内冲出屏幕,第 125 步(虚线处)直接 NaN;蓝色线(裁剪)稳稳下降。右图:训练 300 步后,模型的预测(橙色虚线)几乎完全盖住目标序列(绿色实线)——它是真的学会了"下一位"规律,而不是瞎猜。
💡 一个诚实的补充:裁剪组的梯度全程贴着限速线,说明这个任务里梯度长期"超速"。这不是 bug——等 loss 降到足够小,梯度自然会跌破限速线,蓝色线才会离开 1.0 往下走。限速器是"按需工作"的:超速才介入,不超速绝不打扰。
六、体检正确 + 梯度稳定
第 5 章在系列目录里的里程碑是"梯度校验对比图"——用一张双面板图同时回答两个问题:左图证明"梯度算对了",右图证明"梯度稳住了"。
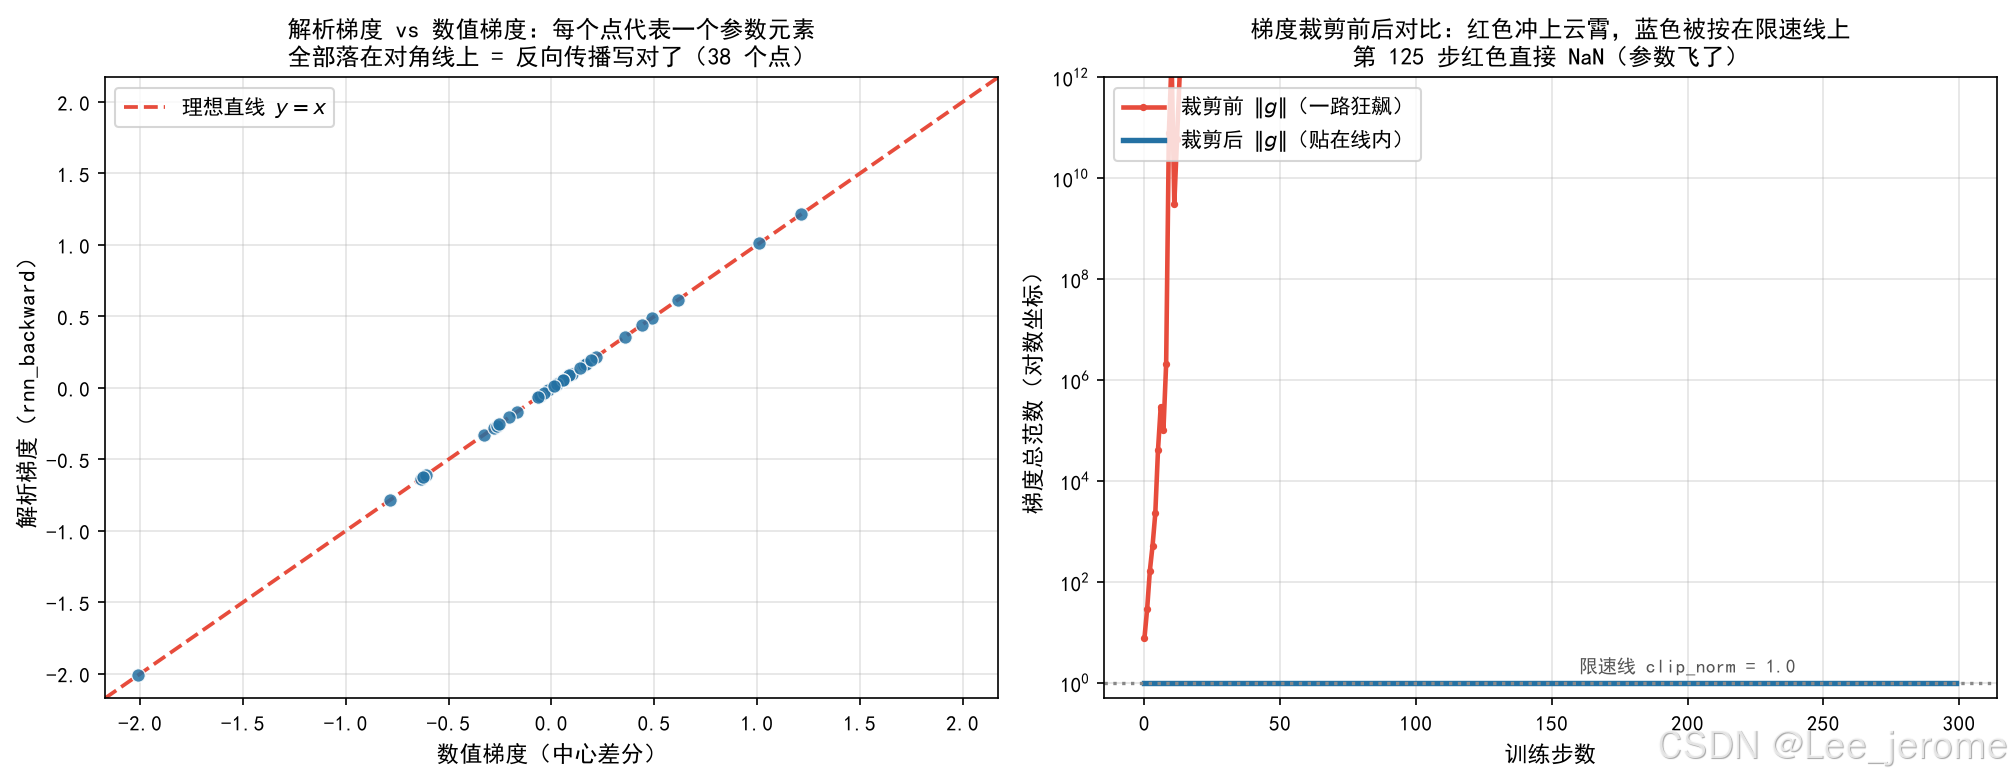
- 左图:把实操 B2 那 38 个参数元素的"数值梯度"当横轴、"解析梯度"当纵轴,一个点代表一个参数。所有点都死死贴在 y=xy=xy=x 对角线上——这说明 rnn_backward 输出的每一个梯度分量,都和数值梯度分毫不差。"写对了"不是嘴上说说,是 38 个点替你作证。
- 右图:训练时的梯度总范数。红色是裁剪前的原始梯度,火箭一样冲上云霄(对数坐标下依然触目惊心);蓝色是裁剪后的梯度,整条线贴死在限速线上。第 125 步红色曲线戛然而止——因为参数已经变成 NaN,曲线画不出来了。
七、封装成 RNNLayer:让代码有"人样"
每次训练都要手动传一堆权重和偏置,太啰嗦。就像把散落的工具收进工具箱,我们把前向、反向、裁剪、更新包进一个类:
class RNNLayer(object):
"""迷你 RNN 层:forward / backward / clip_grads / update 一套齐活"""
def __init__(self, input_size, hidden_size, output_size, seed=None):
rng = np.random.RandomState(seed)
self.I, self.H, self.O = input_size, hidden_size, output_size
limit = 1.0 / np.sqrt(hidden_size) # 小范围均匀初始化
self.W_xh = rng.uniform(–limit, limit, (input_size, hidden_size))
self.W_hh = rng.uniform(–limit, limit, (hidden_size, hidden_size))
self.W_hy = rng.uniform(–limit, limit, (hidden_size, output_size))
self.b_h = np.zeros(hidden_size)
self.b_y = np.zeros(output_size)
def forward(self, x, h0=None):
B = x.shape[0]
if h0 is None:
h0 = np.zeros((B, self.H))
self.x = x
self.h_seq, self.y_seq, self.cache = rnn_forward(
x, self.W_xh, self.W_hh, self.W_hy, self.b_h, self.b_y, h0)
return self.h_seq, self.y_seq
def backward(self, target):
self.grads = rnn_backward(self.y_seq, target, self.cache,
self.W_xh, self.W_hh, self.W_hy,
B=self.x.shape[0])
return self.grads
def clip_grads(self, clip_norm):
"""范数裁剪,返回 (裁剪前范数, 裁剪后范数)"""
self.grads, before, after = clip_by_norm(self.grads, clip_norm)
return before, after
def update(self, lr):
for name in ('W_xh', 'W_hh', 'W_hy', 'b_h', 'b_y'):
setattr(self, name, getattr(self, name) – lr * self.grads[name])
训练循环立刻清爽多了:
model = RNNLayer(1, 8, 1, seed=0)
model.W_hh = W_hh_hot # 换上那颗"定时炸弹"
for step in range(300):
model.forward(x)
loss = mse_loss(model.y_seq, target)
model.backward(target)
model.clip_grads(clip_norm=1.0) # 装限速器
model.update(lr=0.1)
三行循环体:算账(forward)→ 记账(backward)→ 还账(update),中间夹一道限速(clip_grads)。实操 D 的完整实验就是拿这个类跑的。
几个设计细节,也是面试常考点:
- 为什么梯度不存成实例属性累加、而是 backward 每次返回新字典? 因为我们每次 backward 都从零重算(时间步累加是"从零加起"),天然不需要 zero_grad()。等你以后用 PyTorch,optimizer.zero_grad() 是因为框架默认"梯度累加到旧值上"——那是另一种设计哲学,不是必须。
- update 为什么是 weight – lr * grad? 梯度指向 loss 增大的方向,更新要"反着走",所以是减号。这就是梯度下降的本体,第三章的根基。
- seed 参数有什么用? 固定随机种子,保证每次跑结果完全一样——调试、复现、写文章全靠它。
八、常见坑与 FAQ
🕳️ 常见坑
| 1 | 反向循环写成 for t in range(S) | δt\\delta_tδt 依赖 δt+1\\delta_{t+1}δt+1,正着走要么报错要么全错 | 必须 range(S-1, -1, -1) 倒序 |
| 2 | 忘记把 target 转置对齐 | y_seq 是 (S,B,O)(S,B,O)(S,B,O)、target 是 (B,S,O)(B,S,O)(B,S,O),直接减形状对不上 | target.transpose(1,0,2) 后再减 |
| 3 | 梯度忘除以 BBB | 解析梯度比数值梯度大 BBB 倍,体检 FAIL | 反向末尾 grads / B;数值梯度同样 / B,口径一致 |
| 4 | 漏乘 tanh\\tanhtanh 导数 1−ht21-h_t^21−ht2 | 只有最后一步梯度对,中间步全错 | 递推式最后一步必须 * d_tanh,用 cache 里的 hth_tht 现算 |
| 5 | 转置写反:WhhδW_{hh}\\deltaWhhδ 还是 δWhh⊤\\delta W_{hh}^{\\top}δWhh⊤ | 维度对不上或梯度算错 | 行向量约定下梯度右乘转置:np.dot(delta_next, W_hh.T) |
| 6 | 时间步累加少 += | 只算了最后一步的贡献,体检立刻 FAIL | 每个时间步都 +=,一个都不能少(t=0t=0t=0 贡献为零也要走一遍流程) |
| 7 | 裁剪了却没用裁剪结果 | 打印了裁剪但更新用的还是原梯度,白剪 | clip_grads 会原地替换 self.grads,改完再 update |
| 8 | ε\\varepsilonε 取太小或太大 | 太小浮点误差大、太大中心差分不准 | 常用 10−6∼10−710^{-6}\\sim10^{-7}10−6∼10−7 |
❓ FAQ
Q1:数值梯度那么准,为什么训练时不用它?
每算一个参数元素的数值梯度要跑两次前向。WhhW_{hh}Whh 有 H2H^2H2 个元素就要跑 2H22H^22H2 次前向,序列一长就是天文数字。它的角色是"体检工具":小模型上验证解析梯度没问题,然后放心用解析梯度。
Q2:为什么裁剪能救爆炸,救不了消失?
裁剪只处理"梯度太大"(爆炸);梯度太小(消失)时它不介入——限速器只管超速,不管龟速。消失的解药在下一章:LSTM 用一条"传送带"绕开连乘。
Q3:裁剪会影响最终学到的参数吗?
会,但通常是好的影响。裁剪后的梯度方向和原始梯度一致(等比例缩小),只是步长被限制,相当于"每一步都走得谨慎一点"。坏处是限速太紧收敛会变慢——所以 clip_norm 是个要调的旋钮。
Q4:PyTorch 里的梯度裁剪在哪?
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm) 就是范数裁剪,和我们的 clip_by_norm 一个道理(注意 PyTorch 按参数分组算范数,细节略有差异)。面试时能讲出"等比例缩放、方向不变",就过关了。
Q5:怎么快速定位反向传播的 bug?
先跑数值梯度体检,FAIL 就二分:把模型调到最小(S=2,H=2S=2, H=2S=2,H=2),单独查一个参数;通过后再逐步放大。多数 bug 逃不出上表 8 个坑。
九、本章小结与下章预告
本章小结(一句话带走一个知识点)
| rnn_backward 骨架 | 倒序 for t in range(S-1,-1,-1),拿 cache 里的 hth_tht 现算 tanh\\tanhtanh 闸门,+= 累加五个梯度 |
| 递推的代码形态 | δt=(δt+1Whh⊤+δytWhy⊤)⊙(1−ht2)\\delta_t = (\\delta_{t+1}W_{hh}^{\\top} + \\delta_{y_t}W_{hy}^{\\top})\\odot(1-h_t^2)δt=(δt+1Whh⊤+δytWhy⊤)⊙(1−ht2),一行矩阵运算对应一个公式 |
| 对批次平均 | 梯度是整批合力,除以 BBB 变平均梯度;数值梯度也要同口径除 BBB |
| 数值梯度 | 中心差分 L(θ+ε)−L(θ−ε)2ε\\frac{L(\\theta+\\varepsilon)-L(\\theta-\\varepsilon)}{2\\varepsilon}2εL(θ+ε)−L(θ−ε),独立裁判,误差 <10−6<10^{-6}<10−6 合格 |
| 体检结果 | 小模型误差 10−1010^{-10}10−10 量级、随机大模型相对误差 10−810^{-8}10−8 量级,全绿 ✅ |
| 梯度裁剪 | ∣g∣>clip_norm|g| > \\text{clip\\_norm}∣g∣>clip_norm 时整体乘 clip_norm∣g∣\\frac{\\text{clip\\_norm}}{|g|}∣g∣clip_norm:方向不变,只降速 |
| 裁剪的效果 | 不裁剪:40 步 loss 冲到 109110^{91}1091、125 步 NaN;裁剪:300 步 loss 从 3.72 降到 0.064 |
| 按值 vs 按范数 | 按值裁剪会压扁方向,推荐按范数裁剪(PyTorch clip_grad_norm_ 同款) |
下章预告:第 6 章《直面梯度消失——LSTM 的核心思想》
这一章我们把"爆炸"收拾了(裁剪),但"消失"还摆在那:普通 RNN 记不住长句子,病根就是第十七篇那个连乘。第六章的主角 LSTM 出场——它用一条"传送带"(细胞状态)绕开连乘,让信息在长序列里也能"无损"传递。为什么 LSTM 记性那么好?传送带和收费站(门控)是怎么配合的? 到时候见分晓。
BPTT(下),完结。反向传播这一关,算是彻底打通了——下一关,LSTM。
🧠 思考题与动手练习
思考题(先自己想,答案都在正文里):
动手练习(改造本章代码):
📌 下篇预告:第六章《直面梯度消失——LSTM 的核心思想》——普通 RNN 为什么记不住长句子?LSTM 的"传送带"如何绕开梯度消失?我们下篇见!
本文为原创,遵循 CC 4.0 BY-SA 版权协议,转载需附原文链接。
🐍 附:实操代码运行
# -*- coding: utf-8 -*-
"""
rnn_backward.py — 《从零构建RNN》第5章《BPTT算法(下)》配套实操代码
内容:
实操 A 把第4章推导的递推公式翻译成 rnn_backward,在同款小模型上逐位核对梯度
实操 B 数值梯度"全身体检":中心差分逐个扰动所有参数,与解析梯度对比
实操 C 梯度裁剪(范数裁剪)的原理演示:超长梯度被"拉回"限速圈内
实操 D 周期序列"下一步预测"任务:不裁剪 -> 梯度爆炸 Loss 变 NaN;
裁剪 -> 梯度被按住,Loss 稳步下降
实操 E 把前向 / 反向 / 裁剪 / 更新封装成 RNNLayer 类
依赖:numpy
"""
import numpy as np
# ============================================================
# 基础:前向传播(与第3章完全一致,每个时间步的中间量都存进 cache)
# ============================================================
def rnn_forward(x, W_xh, W_hh, W_hy, b_h, b_y, h0):
"""前向:x:(B,S,I),返回 (h_seq:(S,B,H), y_seq:(S,B,O), cache)"""
S = x.shape[1]
h_prev = h0
h_seq, y_seq = [], []
cache = {'x': [], 'h_prev': [], 'z': [], 'h': []}
for t in range(S):
x_t = x[:, t, :]
z_t = np.dot(x_t, W_xh) + np.dot(h_prev, W_hh) + b_h
h_t = np.tanh(z_t)
y_t = np.dot(h_t, W_hy) + b_y
for k, v in (('x', x_t), ('h_prev', h_prev), ('z', z_t), ('h', h_t)):
cache[k].append(v)
h_seq.append(h_t)
y_seq.append(y_t)
h_prev = h_t
h_seq = np.stack(h_seq, axis=0) # (S,B,H)
y_seq = np.stack(y_seq, axis=0) # (S,B,O)
for k in cache:
cache[k] = np.stack(cache[k], axis=0)
return h_seq, y_seq, cache
def mse_loss(y_seq, target):
"""L = 1/2 * Σ_t ||y_t – target_t||^2,target:(B,S,O)"""
tgt = target.transpose(1, 0, 2)
diff = y_seq – tgt
return 0.5 * np.sum(diff * diff)
# ============================================================
# 第5章主角:BPTT 反向传播(第4章公式逐行翻译成 NumPy)
# ============================================================
def rnn_backward(y_seq, target, cache, W_xh, W_hh, W_hy, B):
"""
拿着 cache 倒着走时间轴:
δ_y_t = y_t – target_t (输出层误差,MSE 的导数)
δ_t = (δ_{t+1} W_hh^T + δ_y_t W_hy^T) ⊙ (1 – h_t^2) (核心递推)
梯度 = Σ_t (陪乘项^T · δ) / B (时间步累加 + 对批次求平均)
"""
S = y_seq.shape[0]
tgt = target.transpose(1, 0, 2) # (B,S,O) -> (S,B,O)
delta_y = y_seq – tgt # 输出层误差 (S,B,O)
dW_xh = np.zeros_like(W_xh)
dW_hh = np.zeros_like(W_hh)
dW_hy = np.zeros_like(W_hy)
db_h = np.zeros(W_xh.shape[1])
db_y = np.zeros(W_hy.shape[1])
delta_next = np.zeros((B, W_hh.shape[0])) # δ_{T+1} = 0:最后一步没有"未来"
for t in range(S – 1, –1, –1): # 必须倒序!
h_t = cache['h'][t] # (B,H)
d_tanh = 1.0 – h_t * h_t # tanh 闸门 (1-h_t^2)
# 直接路径(经 W_hy)+ 时间路径(经 W_hh 从未来回传),汇合后过闸门
delta_z = (np.dot(delta_next, W_hh.T) +
np.dot(delta_y[t], W_hy.T)) * d_tanh # δ_t
# 各回各家 + 时间步累加
dW_hy += np.dot(cache['h'][t].T, delta_y[t]) # Σ h_t^T δ_y_t
dW_hh += np.dot(cache['h_prev'][t].T, delta_z) # Σ h_{t-1}^T δ_t
dW_xh += np.dot(cache['x'][t].T, delta_z) # Σ x_t^T δ_t
db_h += delta_z.sum(axis=0)
db_y += delta_y[t].sum(axis=0)
delta_next = delta_z
# 梯度是"整批的合力",除以样本数 B 变成平均梯度:
# 这样换批次大小不用改学习率,也更稳定
return {'W_xh': dW_xh / B, 'W_hh': dW_hh / B, 'W_hy': dW_hy / B,
'b_h': db_h / B, 'b_y': db_y / B}
# ============================================================
# 数值梯度(中心差分):金标准体检工具
# ============================================================
def numerical_grads(x, target, W_xh, W_hh, W_hy, b_h, b_y, h0, eps=1e-7):
"""对每个参数元素逐个扰动,用 (L(x+e)-L(x-e))/2e 估计真实梯度"""
params = {'W_xh': W_xh, 'W_hh': W_hh, 'W_hy': W_hy,
'b_h': b_h, 'b_y': b_y}
def loss_with():
_, ys, _ = rnn_forward(x, W_xh, W_hh, W_hy, b_h, b_y, h0)
return mse_loss(ys, target)
grads = {}
B = x.shape[0]
for name, P in params.items():
G = np.zeros_like(P)
for idx in np.ndindex(P.shape):
orig = P[idx]
P[idx] = orig + eps
fp = loss_with()
P[idx] = orig – eps
fm = loss_with()
P[idx] = orig
G[idx] = (fp – fm) / (2 * eps) # 中心差分
grads[name] = G / B # 与解析梯度口径一致:对批次平均
return grads
def max_error(a, b):
return np.max(np.abs(a – b))
# ============================================================
# 梯度裁剪(范数裁剪):太长就等比例缩短,方向不变
# ============================================================
def global_norm(grads):
"""所有梯度拼在一起算出的总长度(L2 范数)"""
total = sum(np.sum(g * g) for g in grads.values())
return float(np.sqrt(total))
def clip_by_norm(grads, clip_norm):
"""
范数裁剪:||g|| > clip_norm 时,整体乘以 clip_norm / ||g||
—— 像给购物车装限速器:超速只降速,不改方向
"""
norm = global_norm(grads)
if norm > clip_norm:
scale = clip_norm / norm
return {k: v * scale for k, v in grads.items()}, norm, clip_norm
return grads, norm, norm
def clip_by_value(grads, c):
"""按值裁剪:每个元素单独夹到 [-c, c](简单粗暴版)"""
return {k: np.clip(v, –c, c) for k, v in grads.items()}
# ============================================================
# 实操 A:第4章同款小模型,验证 rnn_backward 与手推结果逐位一致
# ============================================================
def demo_A():
print('=' * 78)
print('实操 A:rnn_backward 落地 —— 第4章同款小模型(I=2, H=3, O=2, B=1, S=2)')
print('=' * 78)
w_xh = np.array([[0.5, –0.2, 0.3], [–0.1, 0.4, 0.2]]) # (2,3)
w_hh = np.array([[0.8, 0.1, 0.0], [0.2, 0.7, –0.1], [0.0, 0.3, 0.6]]) # (3,3)
w_hy = np.array([[0.5, –0.4], [0.2, 0.3], [–0.1, 0.6]]) # (3,2)
bh = np.array([0.1, –0.1, 0.05])
by = np.array([0.0, 0.0])
x = np.array([[[1.0, –1.0], [0.5, 0.5]]]) # (1,2,2)
h0 = np.zeros((1, 3))
target = np.array([[[1.0, –1.0], [–0.5, 0.5]]]) # (1,2,2)
h_seq, y_seq, cache = rnn_forward(x, w_xh, w_hh, w_hy, bh, by, h0)
print('前向结果(与第4章逐位一致):')
print(' y_seq =', y_seq.reshape(2, 2).tolist())
print(' 损失 L =', mse_loss(y_seq, target))
grads = rnn_backward(y_seq, target, cache, w_xh, w_hh, w_hy, B=1)
print()
print('rnn_backward 输出的梯度(B=1,无需平均):')
for k, v in grads.items():
print(' %-5s =' % k)
print(v)
# 与第4章手推结果对照(取第4章实操A的数值)
expect = {
'W_hy': np.array([[–0.1056, 0.0713], [0.2926, –0.2269], [0.1653, –0.1417]]),
'W_hh': np.array([[0.2292, –0.0187, –0.2044],
[–0.2292, 0.0187, 0.2044],
[0.0565, –0.0046, –0.0504]]),
'W_xh': np.array([[–0.0534, 0.0615, 0.0958], [0.4327, –0.0924, –0.434]]),
'b_h': np.array([0.1362, 0.0461, –0.0734]),
'b_y': np.array([–0.1472, 0.095]),
}
print()
print('与第4章手推值(保留4位小数)逐位对照,最大误差:')
for k in expect:
print(' %-5s 最大误差 = %.3e %s' %
(k, max_error(grads[k], expect[k]),
'OK' if max_error(grads[k], expect[k]) < 1e-4 else 'FAIL'))
# ============================================================
# 实操 B:数值梯度全身体检(小模型 + 大一点的多批次模型)
# ============================================================
def demo_B():
print()
print('=' * 78)
print('实操 B:数值梯度体检 —— 解析梯度 vs 数值梯度')
print('=' * 78)
# —- B1:第4章同款小模型,eps=1e-6(与第4章口径一致) —-
w_xh = np.array([[0.5, –0.2, 0.3], [–0.1, 0.4, 0.2]])
w_hh = np.array([[0.8, 0.1, 0.0], [0.2, 0.7, –0.1], [0.0, 0.3, 0.6]])
w_hy = np.array([[0.5, –0.4], [0.2, 0.3], [–0.1, 0.6]])
bh = np.array([0.1, –0.1, 0.05])
by = np.array([0.0, 0.0])
x = np.array([[[1.0, –1.0], [0.5, 0.5]]])
h0 = np.zeros((1, 3))
target = np.array([[[1.0, –1.0], [–0.5, 0.5]]])
_, y_seq, cache = rnn_forward(x, w_xh, w_hh, w_hy, bh, by, h0)
an = rnn_backward(y_seq, target, cache, w_xh, w_hh, w_hy, B=1)
nu = numerical_grads(x, target, w_xh, w_hh, w_hy, bh, by, h0, eps=1e-6)
print('B1:小模型(B=1, S=2, eps=1e-6)')
for k in an:
print(' %-5s 解析 vs 数值 最大误差 = %.3e %s' %
(k, max_error(an[k], nu[k]),
'OK' if max_error(an[k], nu[k]) < 1e-6 else 'FAIL'))
# —- B2:更大的随机模型(多批次),用相对误差标准 —-
rng = np.random.RandomState(42)
I, H, O, B, S = 2, 4, 2, 2, 3
W_xh = rng.randn(I, H) * 0.5
W_hh = rng.randn(H, H) * 0.5
W_hy = rng.randn(H, O) * 0.5
b_h = rng.randn(H) * 0.1
b_y = rng.randn(O) * 0.1
x2 = rng.randn(B, S, I) * 0.8
h02 = np.zeros((B, H))
target2 = rng.randn(B, S, O) * 0.8
_, y2, cache2 = rnn_forward(x2, W_xh, W_hh, W_hy, b_h, b_y, h02)
an2 = rnn_backward(y2, target2, cache2, W_xh, W_hh, W_hy, B=B)
nu2 = numerical_grads(x2, target2, W_xh, W_hh, W_hy, b_h, b_y, h02,
eps=1e-7)
print()
print('B2:随机多批次模型(I=2,H=4,O=2,B=2,S=3, eps=1e-7)')
print(' 相对误差 = |解析 – 数值| / max(|解析|, |数值|, 1e-8)')
for k in an2:
rel = np.max(np.abs(an2[k] – nu2[k]) /
np.maximum(np.abs(nu2[k]), 1e-8))
print(' %-5s 相对误差 = %.3e %s' %
(k, rel, 'OK' if rel < 1e-6 else 'FAIL'))
return an2, nu2, (x2, target2, W_xh, W_hh, W_hy, b_h, b_y, h02)
# ============================================================
# 实操 C:梯度裁剪原理演示
# ============================================================
def demo_C():
print()
print('=' * 78)
print('实操 C:梯度裁剪 —— 范数超限就整体缩短,方向不变')
print('=' * 78)
rng = np.random.RandomState(7)
fake = {'W_xh': rng.randn(2, 3), 'W_hh': rng.randn(3, 3) * 2,
'W_hy': rng.randn(3, 2), 'b_h': rng.randn(3), 'b_y': rng.randn(2)}
# 整体缩放,把总范数"摆"到 13.42,制造一场声势浩大的爆炸
target_norm = 13.42
norm0 = global_norm(fake)
fake = {k: v * (target_norm / norm0) for k, v in fake.items()}
norm = global_norm(fake)
clip_norm = 5.0
clipped, before, after = clip_by_norm(fake, clip_norm)
print('伪造一批"爆炸"梯度,总范数 ||g|| = %.4f(远超限速 5.0)' % norm)
print('裁剪后总范数 = %.4f(刚好压回限速圈内)' % global_norm(clipped))
print('缩放比例 scale = clip_norm / ||g|| = %.4f' % (clip_norm / norm))
print()
print('裁剪前后对比(只列前 6 个元素):')
names = list(fake.keys())
total = 0
for k in names:
a, b = fake[k].ravel(), clipped[k].ravel()
for i in range(min(6, len(a))):
total += 1
if total <= 6:
print(' %-5s[%d] %.6f -> %.6f' % (k, i, a[i], b[i]))
# 按值裁剪 vs 按范数裁剪
vc = clip_by_value(fake, 1.0)
print()
print('按值裁剪(每个元素夹到 [-1,1])后范数 = %.4f —— 简单粗暴,但'
'各方向被"压扁"的幅度不一样' % global_norm(vc))
# ============================================================
# 实操 D:周期序列"下一步预测" —— 裁剪前 vs 裁剪后
# ============================================================
def make_periodic_seq(n):
"""周期 6 的序列:x_t 是第 t 个数,target_t 是下一个数"""
pattern = np.array([0.3, –0.7, 0.5, 0.9, –0.4, 0.1])
idx = np.arange(n) % 6
x = pattern[idx].reshape(1, n, 1)
target = pattern[(idx + 1) % 6].reshape(1, n, 1)
return x, target
class RNNLayer(object):
"""迷你 RNN 层:forward / backward / clip_grads / update 一套齐活"""
def __init__(self, input_size, hidden_size, output_size, seed=None):
rng = np.random.RandomState(seed)
self.I, self.H, self.O = input_size, hidden_size, output_size
limit = 1.0 / np.sqrt(hidden_size) # 小范围均匀初始化
self.W_xh = rng.uniform(–limit, limit, (input_size, hidden_size))
self.W_hh = rng.uniform(–limit, limit, (hidden_size, hidden_size))
self.W_hy = rng.uniform(–limit, limit, (hidden_size, output_size))
self.b_h = np.zeros(hidden_size)
self.b_y = np.zeros(output_size)
self.cache = None
def forward(self, x, h0=None):
B = x.shape[0]
if h0 is None:
h0 = np.zeros((B, self.H))
self.x = x
self.h_seq, self.y_seq, self.cache = rnn_forward(
x, self.W_xh, self.W_hh, self.W_hy, self.b_h, self.b_y, h0)
return self.h_seq, self.y_seq
def backward(self, target):
self.grads = rnn_backward(self.y_seq, target, self.cache,
self.W_xh, self.W_hh, self.W_hy,
B=self.x.shape[0])
return self.grads
def clip_grads(self, clip_norm):
"""范数裁剪,返回 (裁剪前范数, 裁剪后范数)"""
self.grads, before, after = clip_by_norm(self.grads, clip_norm)
return before, after
def update(self, lr):
for name in ('W_xh', 'W_hh', 'W_hy', 'b_h', 'b_y'):
setattr(self, name, getattr(self, name) – lr * self.grads[name])
def train(use_clip, steps=300, lr=0.1, clip_norm=1.0, seed=0, rho=1.2):
"""
训练"下一步预测"小任务。
故意把 W_hh 的谱半径放大到 rho=1.2(>1)—— 不裁剪时梯度会爆炸。
返回 (loss_list, grad_norm_list, step_to_nan)
"""
x, target = make_periodic_seq(n=24)
# 手工打造一个"危险"的 W_hh:谱半径 rho=1.2(>1,时间轴连乘会放大梯度)
rng = np.random.RandomState(seed)
W = rng.randn(8, 8) * 0.5
rho0 = np.max(np.abs(np.linalg.eigvals(W)))
W_hh_hot = W * (rho / rho0)
model = RNNLayer(1, 8, 1, seed=seed)
model.W_hh = W_hh_hot.copy()
losses, norms, step_nan = [], [], None
for step in range(steps):
h_seq, y_seq = model.forward(x)
loss = mse_loss(y_seq, target)
losses.append(loss)
model.backward(target)
before, after = model.clip_grads(clip_norm) if use_clip \\
else (global_norm(model.grads), global_norm(model.grads))
norms.append(after if use_clip else before)
if np.isnan(loss) or np.isinf(loss):
step_nan = step
break
model.update(lr)
return np.array(losses), np.array(norms), step_nan
def demo_D():
print()
print('=' * 78)
print('实操 D:周期序列"下一步预测"(S=24, H=8, 谱半径 1.2, lr=0.1, 300 步)')
print('=' * 78)
no_clip_loss, no_clip_norm, nan_step = train(use_clip=False)
print()
print('【不裁剪】梯度一路狂飙(log10 视角):')
for s in [0, 1, 2, 3, 4, 6, 8, 10, 12, 16, 24, 32, 40]:
if s >= len(no_clip_loss):
break
print(' step %3d loss = %.4e ||g|| = %.4e (log10: %.1f / %.1f)' %
(s, no_clip_loss[s], no_clip_norm[s],
np.log10(no_clip_loss[s]), np.log10(no_clip_norm[s])))
print(' -> 第 %s 步 loss 变成 NaN(梯度爆炸,参数飞出去了)' % nan_step)
clip_loss, clip_norm_curve, _ = train(use_clip=True)
print()
print('【裁剪(clip_norm=1.0)】梯度被按住,loss 稳步下降:')
for s in [0, 20, 40, 60, 80, 100, 140, 180, 220, 260, 299]:
if s >= len(clip_loss):
break
print(' step %3d loss = %.6f ||g|| = %.4f' %
(s, clip_loss[s], clip_norm_curve[s]))
print(' 最终 loss = %.6f(学得七七八八:从 3.72 降到了 0.06)' % clip_loss[–1])
return (no_clip_loss, no_clip_norm, nan_step), (clip_loss, clip_norm_curve)
# ============================================================
# main:串起所有实操
# ============================================================
if __name__ == '__main__':
demo_A()
an2, nu2, _ = demo_B()
demo_C()
demo_D()