前言
string是 C++ 中处理字符串的核心工具,比 C 语言char*更安全高效,这篇文章从string的基础概念出发,聚焦构造、访问、容量、修改等核心接口,搭配测试、案例(如分割网址)讲清用法与场景,最后补充编译器差异,帮你系统掌握string的高效使用。
一、string 类的使用
1.1什么是 string
C语言中,字符串是以’\\0’结尾的若干个字符的集合,为了操作方便,C语言 string.h 头文件提供了一些系列的库函数,但是这些库函数与字符串是分离开的,不符合面向对象的思想,而且底层空间需要用户自己管理,稍不留神可能还会越界访问。
基于上面这些原因,C++标准库提供了 string 类,string 类中提供了各种函数接口,比如类的六个默认成员函数、字符串插入删除、运算符重载等等,我们可以使用 string 来实例化对象,然后通过 string 的各种接口来完成对该对象的各种操作。
string 类的实现框架大概如下:
namespace std {
template<class T>
class string {
public:
// string 的各种成员函数
private:
T* _str;
size_t _size;
size_t _capacity;
//string 的其他成员变量,比如npos
};
}
我们打开 cplusplus.com 搜索 string 会发现,string 其实是 basic_string 类模板使用字符类型 char 实例化得到的一个类: 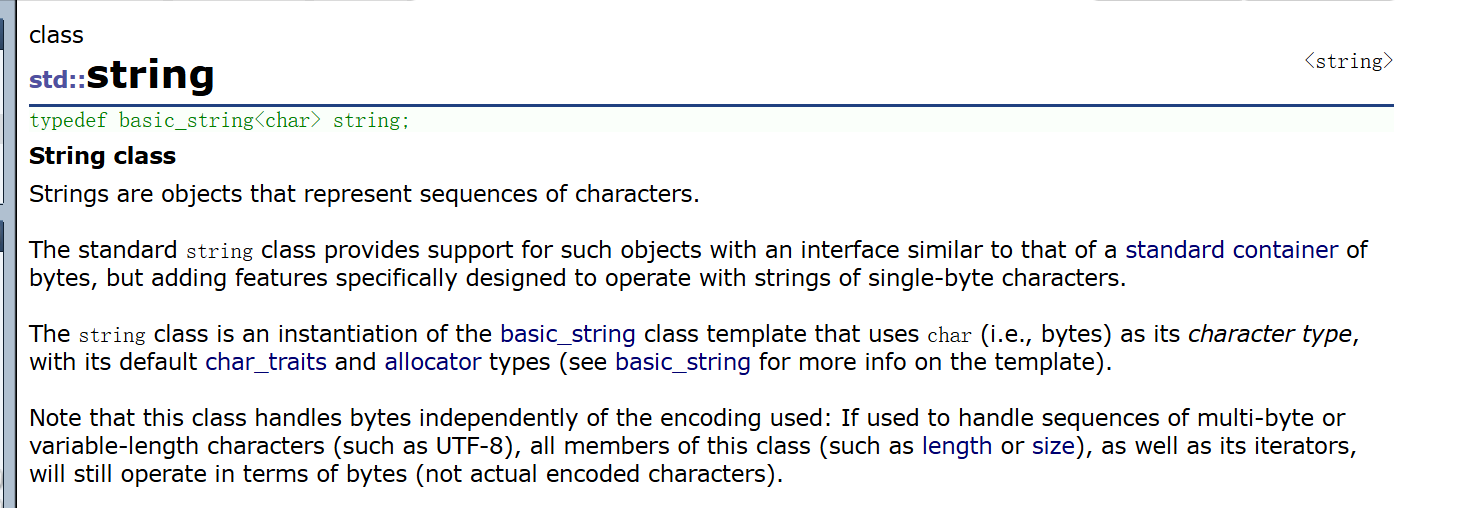 前面我们说了string是管理字符的指针,那么 string 为什么要设计成模板呢?因为编码不同,存储一个字符所需要的空间也不同;现如今常见的编码有如下三类:
- ASCII 编码
ASCII 全称为美国信息交换标准代码,这是我们接触到的第一种编码,由于英语所有的英文字母 (包括大小写) 加上各种标点符号以及特殊字符一共只有一百多种,所以我们使用一个字节即可表示所有字符;但是根据 ASCII 编码设计出的计算机不能表示其他国家的语言,比如中文、日文、韩文等等。
- Unicode
Unicode 就是我们的统一码,也叫万国码;它是为了解决传统的字符编码方案的局限而产生的,它为每种语言中的每个字符设定了统一并且唯一的二进制编码,以满足跨语言、跨平台进行文本转换、处理的要求。Unicode 主要包括 utf-8,utf-16 与 utf-32,其中的8、16与32分别代表了字符的最小空间为1、2以及4字节。
由于 utf-8 支持 ASCII,且字符最小单位为一字节,节省了空间,所以现在使用率最高的编码方式就是它。
- GBK
GBK 即 “国标”,是我国专门为汉字设计的一套编码,其中一个字符最小占用空间为两个字节。
1.2使用前的准备
用string类时,代码里必须加这两句:
#include <string> // 包含头文件
using namespace std; // 引入std命名空间
二、string构造函数
| string() | 无参默认构造:创建空字符串 | string s; |
| string(const string& str) | 拷贝构造:用已有 string 对象构造新对象 | string s1(s0); |
| string(const string& str, size_t pos, size_t len = npos) | 子串构造:从 pos 开始截取 len 个字符 | string s(s0, 2, 4); |
| string(const char* s) | C 风格字符串构造:用 char* 初始化 | string s(“hello”); |
| string(const char* s, size_t n) | 截取 C 串前 n 个字符 | string s(“hello”, 3); |
| string(size_t n, char c) | 重复字符填充构造 | string s(5, ‘A’); |
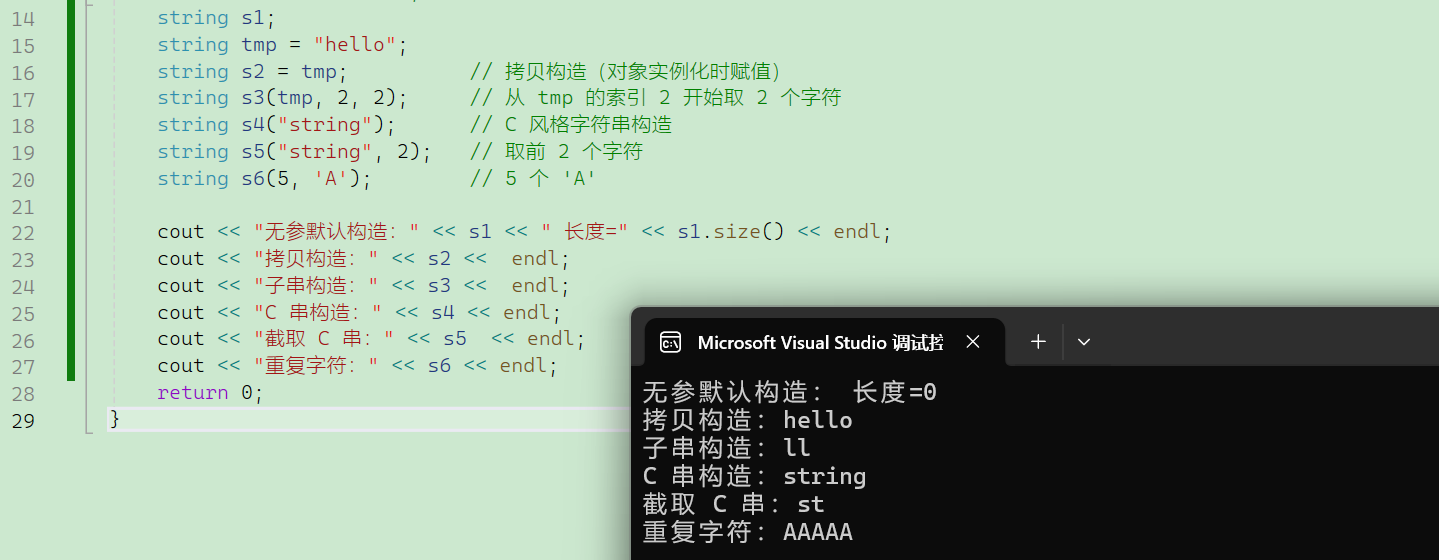
string s1;
string tmp = "hello";
string s2 = tmp; // 拷贝构造(对象实例化时赋值)
string s3(tmp, 2, 2); // 从 tmp 的索引 2 开始取 2 个字符
string s4("string"); // C 风格字符串构造
string s5("string", 2); // 取前 2 个字符
string s6(5, 'A'); // 5 个 'A'
cout << "无参默认构造:" << s1 << " 长度=" << s1.size() << endl;
cout << "拷贝构造:" << s2 << endl;
cout << "子串构造:" << s3 << endl;
cout << "C 串构造:" << s4 << endl;
cout << "截取 C 串:" << s5 << endl;
cout << "重复字符:" << s6 << endl;
2.1、参数详解
string (const char* s)用于通过 C 语言风格的字符串构造 string 对象;string (const string& str, size_t pos, size_t len = npos) 则是从已有 string 对象对应的字符串中,截取从 pos 下标开始的 len 个字符来构造新的 string 对象。
-
参数规则:
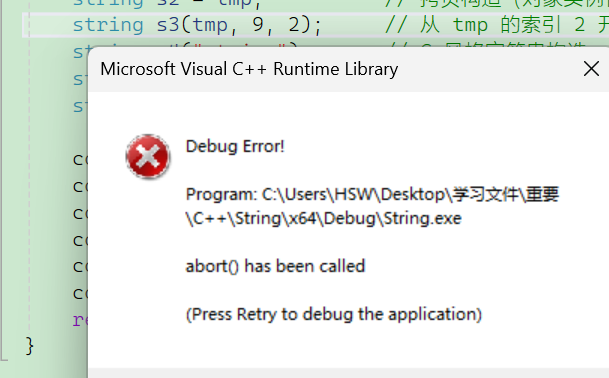
若 pos 超过字符串的最大下标,会触发断言错误;
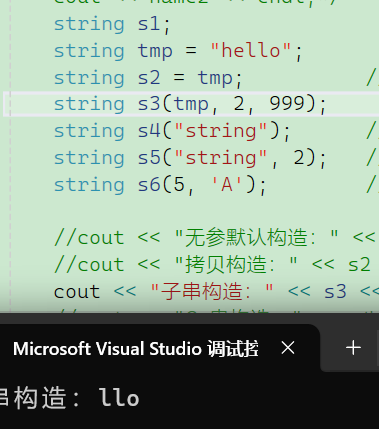
若原字符串 str 长度不足,或 len 取值为sstring::npos,则会从 pos 位置开始复制到字符串末尾。
-
pos越界:
-
-
使用npos缺省值:
-
string对应字符串后面有没有 ‘\\0’
string test1 ="hello";
string test2(test1, 5);
cout << test2 << endl;
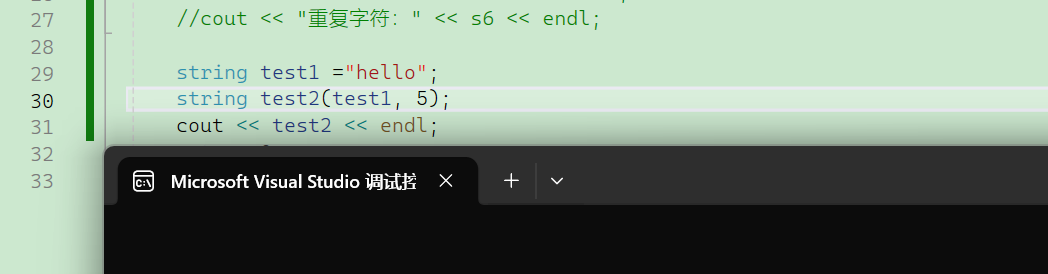 运行后控制台无输出,且未触发断言警告。
这个现象可以说明:string 内部会在存储的字符串末尾维护\\0,但由于\\0是不可打印字符,所以输出时不会显示;而我们从原字符串的末尾位置(下标 5)截取字符时,刚好取到了这个\\0,因此控制台没有打印出可见内容。
string::npos 定义为 -1,在赋值给 size_t 类型时,触发有符号 int 到无符号 size_t 的算数转换,-1的补码(全 1)被解释为size_t的最大值。
若平台是 32 位系统,size_t是 32 位无符号整数,此时npos的值为2³² – 1;
若平台是 64 位系统,size_t是 64 位无符号整数,此时npos的值为2⁶⁴ – 1。
我之所以能直接用cout打印string对象,是因为标准库中为string重载了<<(配合cout)和>>(配合cin)这两个输入输出运算符(具体接口介绍后面讲)。 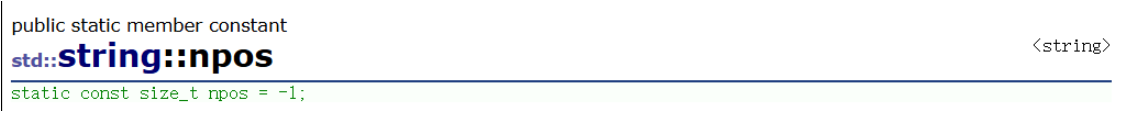
2.2、单参数构造的隐式类型转换
// 单参数构造函数支持隐式类型转换:
// "张三"是 const char* 类型,会先调用 string(const char* s) 构造一个临时 string 对象,
// 再通过拷贝构造,把这个临时对象的内容复制给 s。
// 但实际编译时,编译器会自动优化这个过程,直接用 "张三" 构造 s,只调用 1 次构造函数
// (省去了临时对象和拷贝的开销)。
string s = "张三";
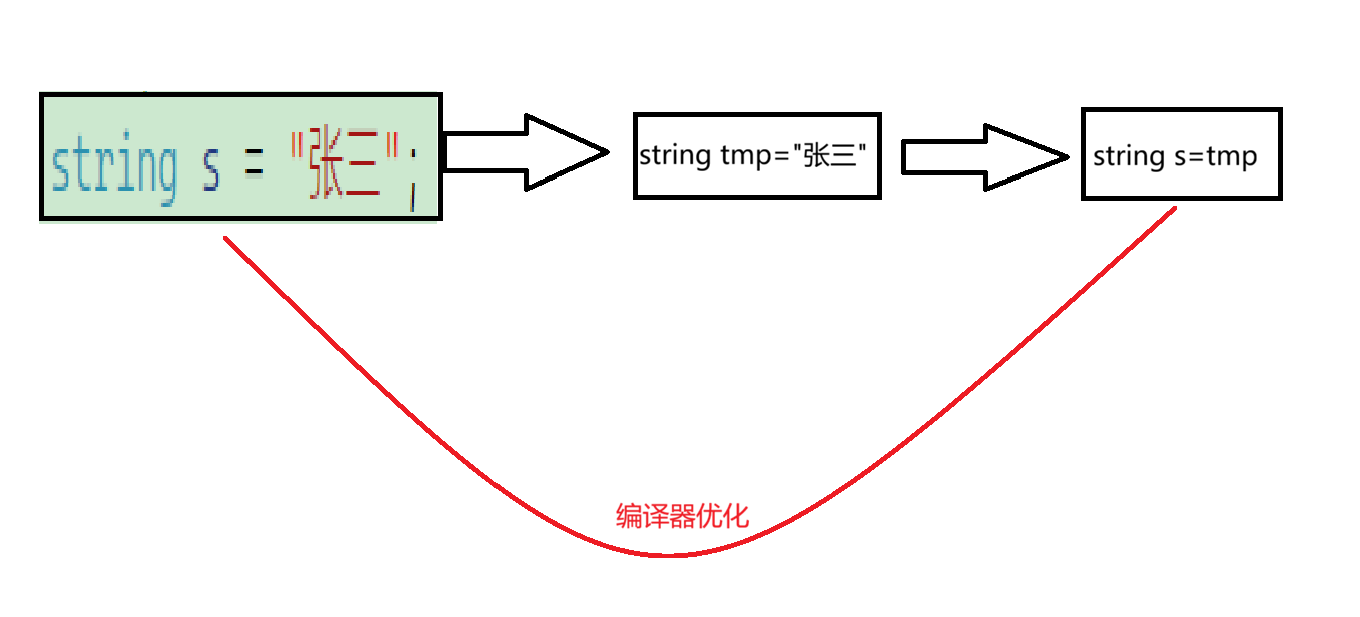 如果想禁止这种隐式转换,可以给单参数构造函数加explicit关键字(比如explicit string(const char* s)),这样就不能直接用string s = “张三”,得显式写string s(“张三”)。
三、string类对象的访问及遍历操作
| begin() | 返回指向字符串第一个字符的迭代器 | cbegin() |
| end() | 返回指向最后一个字符的下一个位置的迭代器 | cend() |
| rbegin() | 反向迭代器,返回指向最后一个字符的迭代器 | crbegin() |
| rend() | 反向迭代器,返回指向第一个字符的前一个位置的迭代器 | crend() |
补充:operator[]
- 非 const 版本:char& operator[](size_t pos) —— 可读写
- const 版本:const char& operator[](size_t pos) const —— 仅读
3.1、operator[]
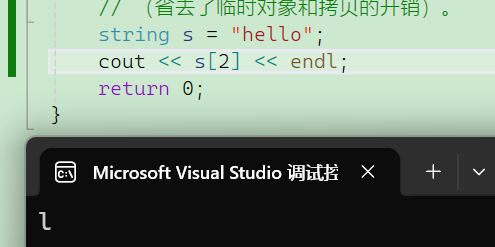
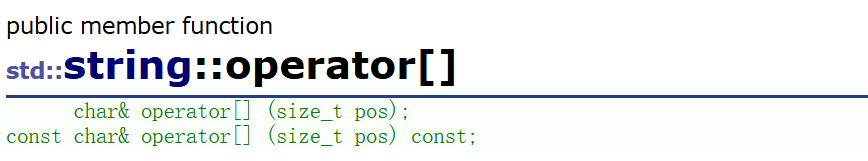 功能:返回pos位置的字符
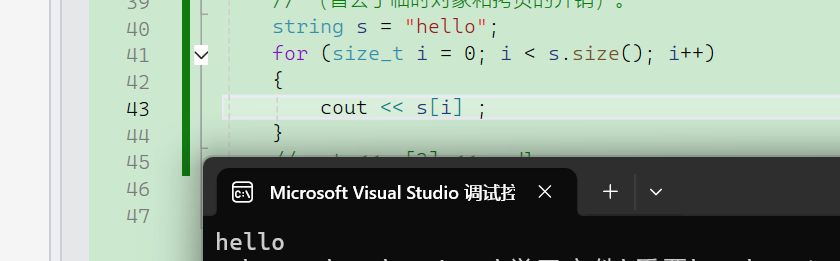
 这里先提前预告一下string里面有一个成员函数是size获取有效字符的个数 那么我们就这样看这样写遍历了。
3.3、begin+ end
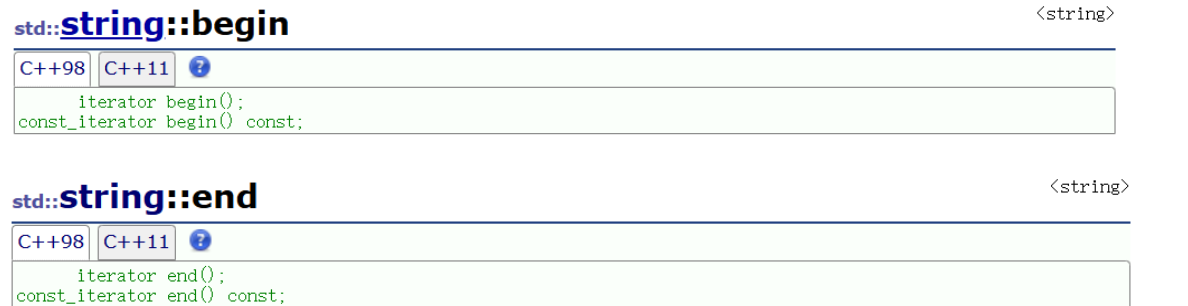
功能: begin 获取第一个字符的迭代器 + end 获取最后一个字符下一个位置的迭代器
迭代器是 C++ 容器(如 string、vector、map)的 “通用访问工具”,本质是封装了指针的对象,作用是:✅ 遍历容器中的元素(读 / 写);✅ 屏蔽不同容器的底层实现差异(比如数组、链表遍历方式不同,但迭代器用法统一)。 核心特点:
用法像指针:支持*it(取元素)、++it(移动)、it->(取成员)等操作; 分类适配场景:比如begin()返回指向第一个元素的迭代器,end()返回 “最后一个元素的下一个位置的迭代器”;
注意失效:容器扩容 / 缩容 / 删除元素时,迭代器可能失效(指向无效内存),需重新获取(后面实现时讲解)。
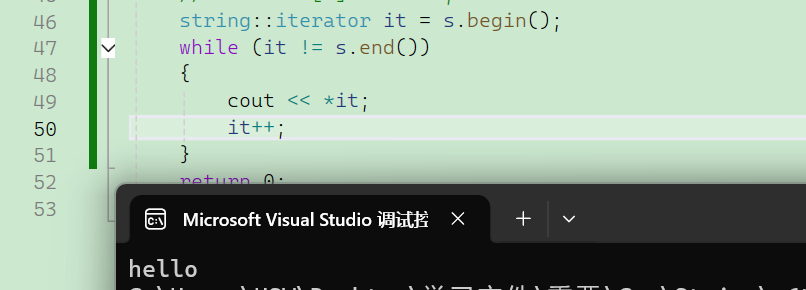
大家可以把string这个容器中迭代器就是指针,begin返回的是指向第一个字符的指针,end返回的是指向最后一个字符下一个位置的指针,这是因为string容器存储的是字符串,可以直接通过指针对字符串进行接引用操作等当然,并不是所有迭代器的底层都是用指针实现的:
- 遍历
3.4、rbegin + rend
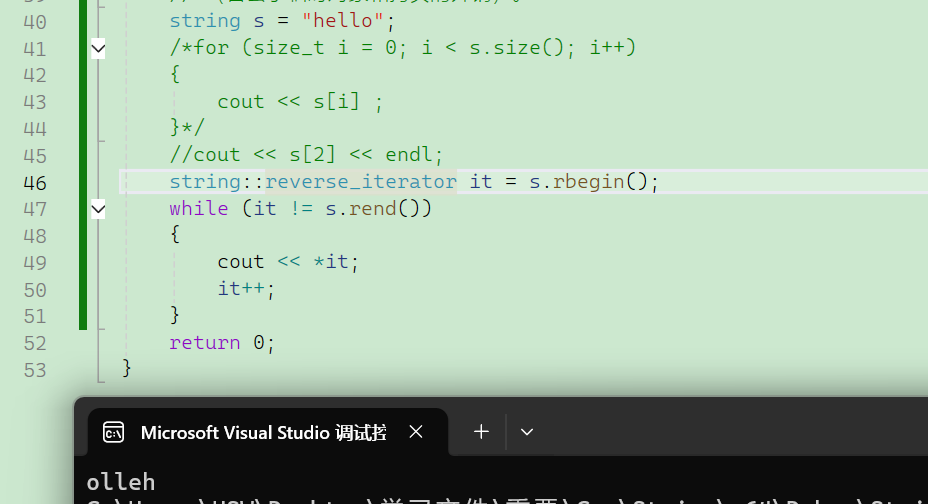
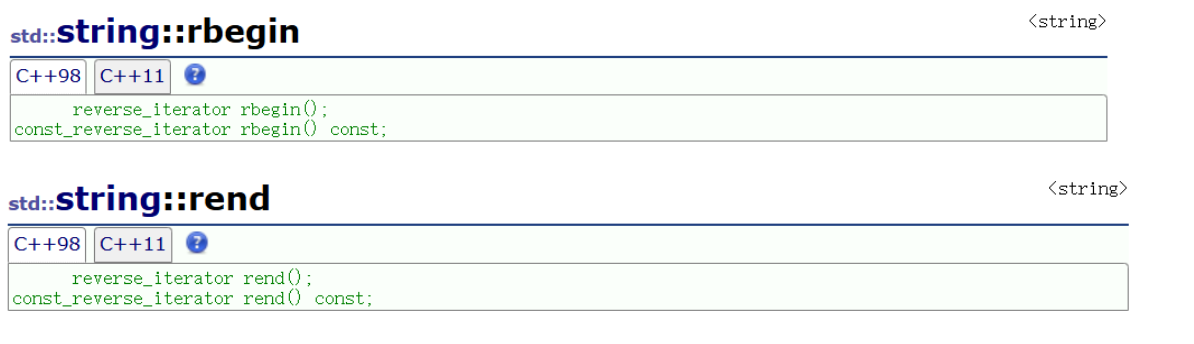 功能:和begin/end的区别是,rbegin/rend是反向遍历,rbegin指向的是最后一个数据的位置,rend指向的是第一个元素
3.5、const迭代器
这个和上述介绍的迭代器没本质区别,不同的就是const迭代器指向的对象不能被修改 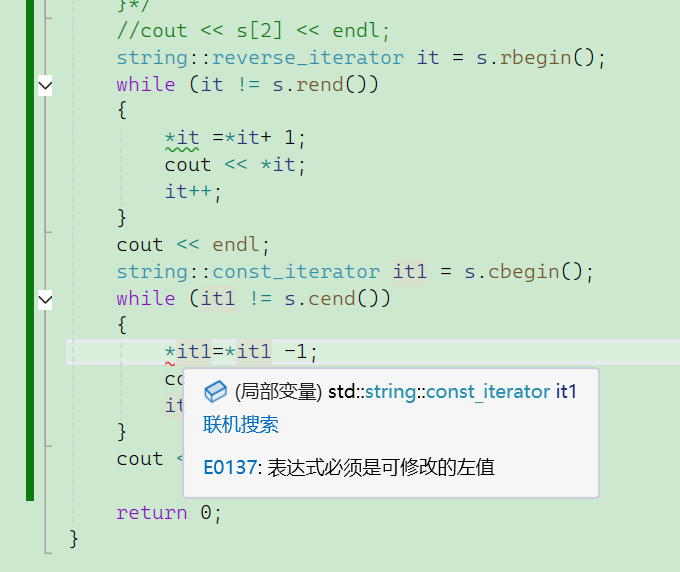
四、 string类对象的容量操作
4.1、size
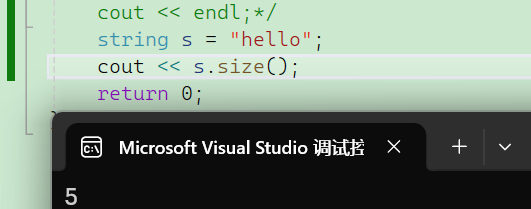
 功能:返回字符串有效大小(不包含末尾的\\0)
4.2、length
 功能:返回字符串有效长度(不包含末尾的\\0)
注:length和size的功能完全一致(返回结果相同),只是命名来源不同 ——length是早期为字符串设计的接口,size是后续为了统一所有容器(如vector)的接口风格新增的,二者在string中是等价的。 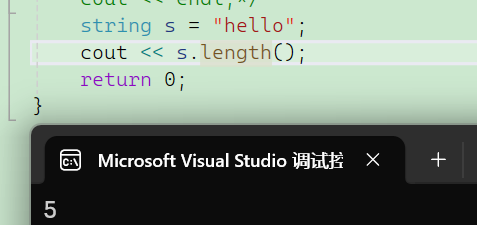
4.3、capacity
 功能:返回空间总大小

string 的自动扩容规则在插入数据且当前空间不足时,string 会自动扩容,不同编译器的扩容策略不同:
- VS 环境下:第一次扩容为当前容量的 2 倍,后续扩容为当前容量的 1.5 倍;
- g++ 环境下:每次扩容均为当前容量的 2 倍。
4.4 empty
 功能:检测字符串是否为空串,是返回true,否则返回false

4.5、clear
 功能:清空有效字符

4.6、reserve(重要)
 功能:提前给字符串分配好指定大小的内存空间(不会改变size)
- 【场景1】:reverse要求100个字节空间,但却开辟了111个字节空间,为啥呢?

这是 VS 编译器的内存对齐 / 容量对齐策略导致的:因为string是一个类就会有内存对齐。reserve(100)只是要求 “至少 100 字节”,VS 会在满足需求的基础上,额外多分配一些空间(比如按特定规则对齐),所以实际开辟了 111 字节。
- 【场景2】:reserve 请求空间小于当前容量时的容量变化(缩容)

当reserve(n)中n小于当前字符串容量时:标准将 “缩小容量” 定义为非约束请求—— 编译器 / 容器实现可以自主决定是否缩容,但通常会选择 “不缩容”(比如本示例中当前容量 15>请求的 10,容量保持 15 不变),最终保证容量不小于n即可。 reserve在新版 VS 里的行为:
✅ 当 n > 当前容量:正常扩容(满足容量≥n); ❌ 当 n < 当前容量:完全不缩容,容量保持原样(仅保证不低于 n,但不会主动减小)。
4.7、resize(重要)

功能:将有效字符的个数改成n个,多出的空间用 “字符c” 或者 “/0” 填充
- 【场景1】:n > size

 字符串会被扩展到 n 个字符,新增的位置默认填充 ‘\\0’(空字符);如果显式传第二个参数(比如 resize(n, ‘a’)),则用指定字符填充。
- 【场景2】:n < size
 字符串会被截断,只保留前 n 个字符,超出部分直接丢弃(不可逆)。
ps:以上内容我是一个一个讲的并加入实例,下面开始我会把他们做成一个表格来讲,重要的我会把他单独拎出来讲
五、string类对象的修改操作
| push_back(char c) | 在字符串尾部插入一个字符 | 仅支持单字符 |
| append(const string& str) | 在字符串尾部追加一个字符串 | 支持 string / C 串 |
| operator+=(const string& str) | 在字符串尾部追加字符串 | 最常用,支持单字符、C 串、string 等重载 |
| c_str() | 返回 const char* 形式的 C 风格字符串 | 末尾含 \\0,方便与 C 接口交互 |
| find(const string& str, size_t pos = 0) | 从 pos 开始向后查找目标首次出现位置 | 找不到返回 sstring::npos |
| rfind(const string& str, size_t pos = npos) | 从 pos 开始向前查找目标最后一次出现位置 | 找不到返回 sstring::npos |
| substr(size_t pos = 0, size_t n = npos) | 从 pos 开始截取 n 个字符并返回新 string | 越界自动截断,不抛异常 |
string s1;
s1.push_back('s');
cout << s1 << endl;
s1.append("tring:");
cout << s1 << endl;
s1 += " hello world";
cout << s1 << endl;
cout << s1.c_str() << endl;
cout << s1.find("hello") << endl;
cout << s1.find("ljm") << endl;
cout << s1.rfind("hello") << endl;
cout << s1.rfind("ljm") << endl;
string tmp = s1.substr(8, 999);
cout << tmp << endl;

5.1、operator+=
 【功能】:在字符串后追加字符串str

5.2、c_str
 功能:返回C格式的字符串
- 验证
string s1;
s1 += " hello world";
s1[5] = '\\0';
cout << s1 << endl;
cout << s1.c_str() << endl;

5.3、find和rfind
 功能:从字符串pos位置开始往后找字符c,返回该字符在字符串中的位置


功能:从指定位置开始,从后往前搜索目标内容在字符串中最后一次出现的位置
5.4、substr

功能:在str中从pos位置开始,截取n个字符,然后将其返回 
5.5、insert

功能:任意位置插入内容 
- 注意 对于非法插入操作,程序一般会抛出异常来提示错误。不过我现在还没学到异常处理的相关内容,所以这里就不写异常捕获的代码了(之前用到的几个插入接口,遇到非法插入时也会以抛异常的方式报错)。
5.6、erase
 功能:删除字符串中任意位置的内容

这个接口用起来确实挺灵活,但得谨慎使用 —— 它底层的效率比较低,会涉及大量的数据移动操作。
5.7、问题
- find+substr 小案例:分割网址 前置知识

//https://blog.csdn.net/HSWLJM?type=blog
string url= "https://blog.csdn.net/HSWLJM?type=blog";
size_t pos1 = url.find(":");
cout << "协议:" << url.substr(0, pos1)<<endl;
size_t pos2= url.find("/",pos1+3);
cout << "域名:" << url.substr(pos1+3,pos2–pos1–3)<<endl;
cout << "资源名:" << url.substr(pos2+1)<<endl;
- += 小案例:所有空格替换成%20
//https://mp.csdn.%20%20%20%20%20%20%20net/
string s = "https://mp.csdn. net/";
string ret;
for (auto& c: s)
{
if (c != ' ')
{
ret += c;
}
else
{
ret += "%20";
}
}
cout << ret << endl;
六、string类非成员函数
6.1、operator+
 功能:拼接字符串(不会修改原字符串)

尽量少用,因为传值返回,导致深拷贝效率低
6.2、operator>>和operator<<

operator>>功能:流提取运算符重载 operator<<功能:流插入运算符重载 
6.3、getline
 功能:获取一行字符串(和>>不同的是,它仅仅以换行为结束标识) 如果想读取包含空格的整行字符串,得用getline(cin, s)


6.4、relational operators
 功能:大小比较,比的是ASCII 编码