🔥草莓熊Lotso:个人主页
❄️个人专栏: 《C++知识分享》 《Linux 入门到实践:零基础也能懂》
✨生活是默默的坚持,毅力是永久的享受!
🎬 博主简介:
文章目录
- 前言:
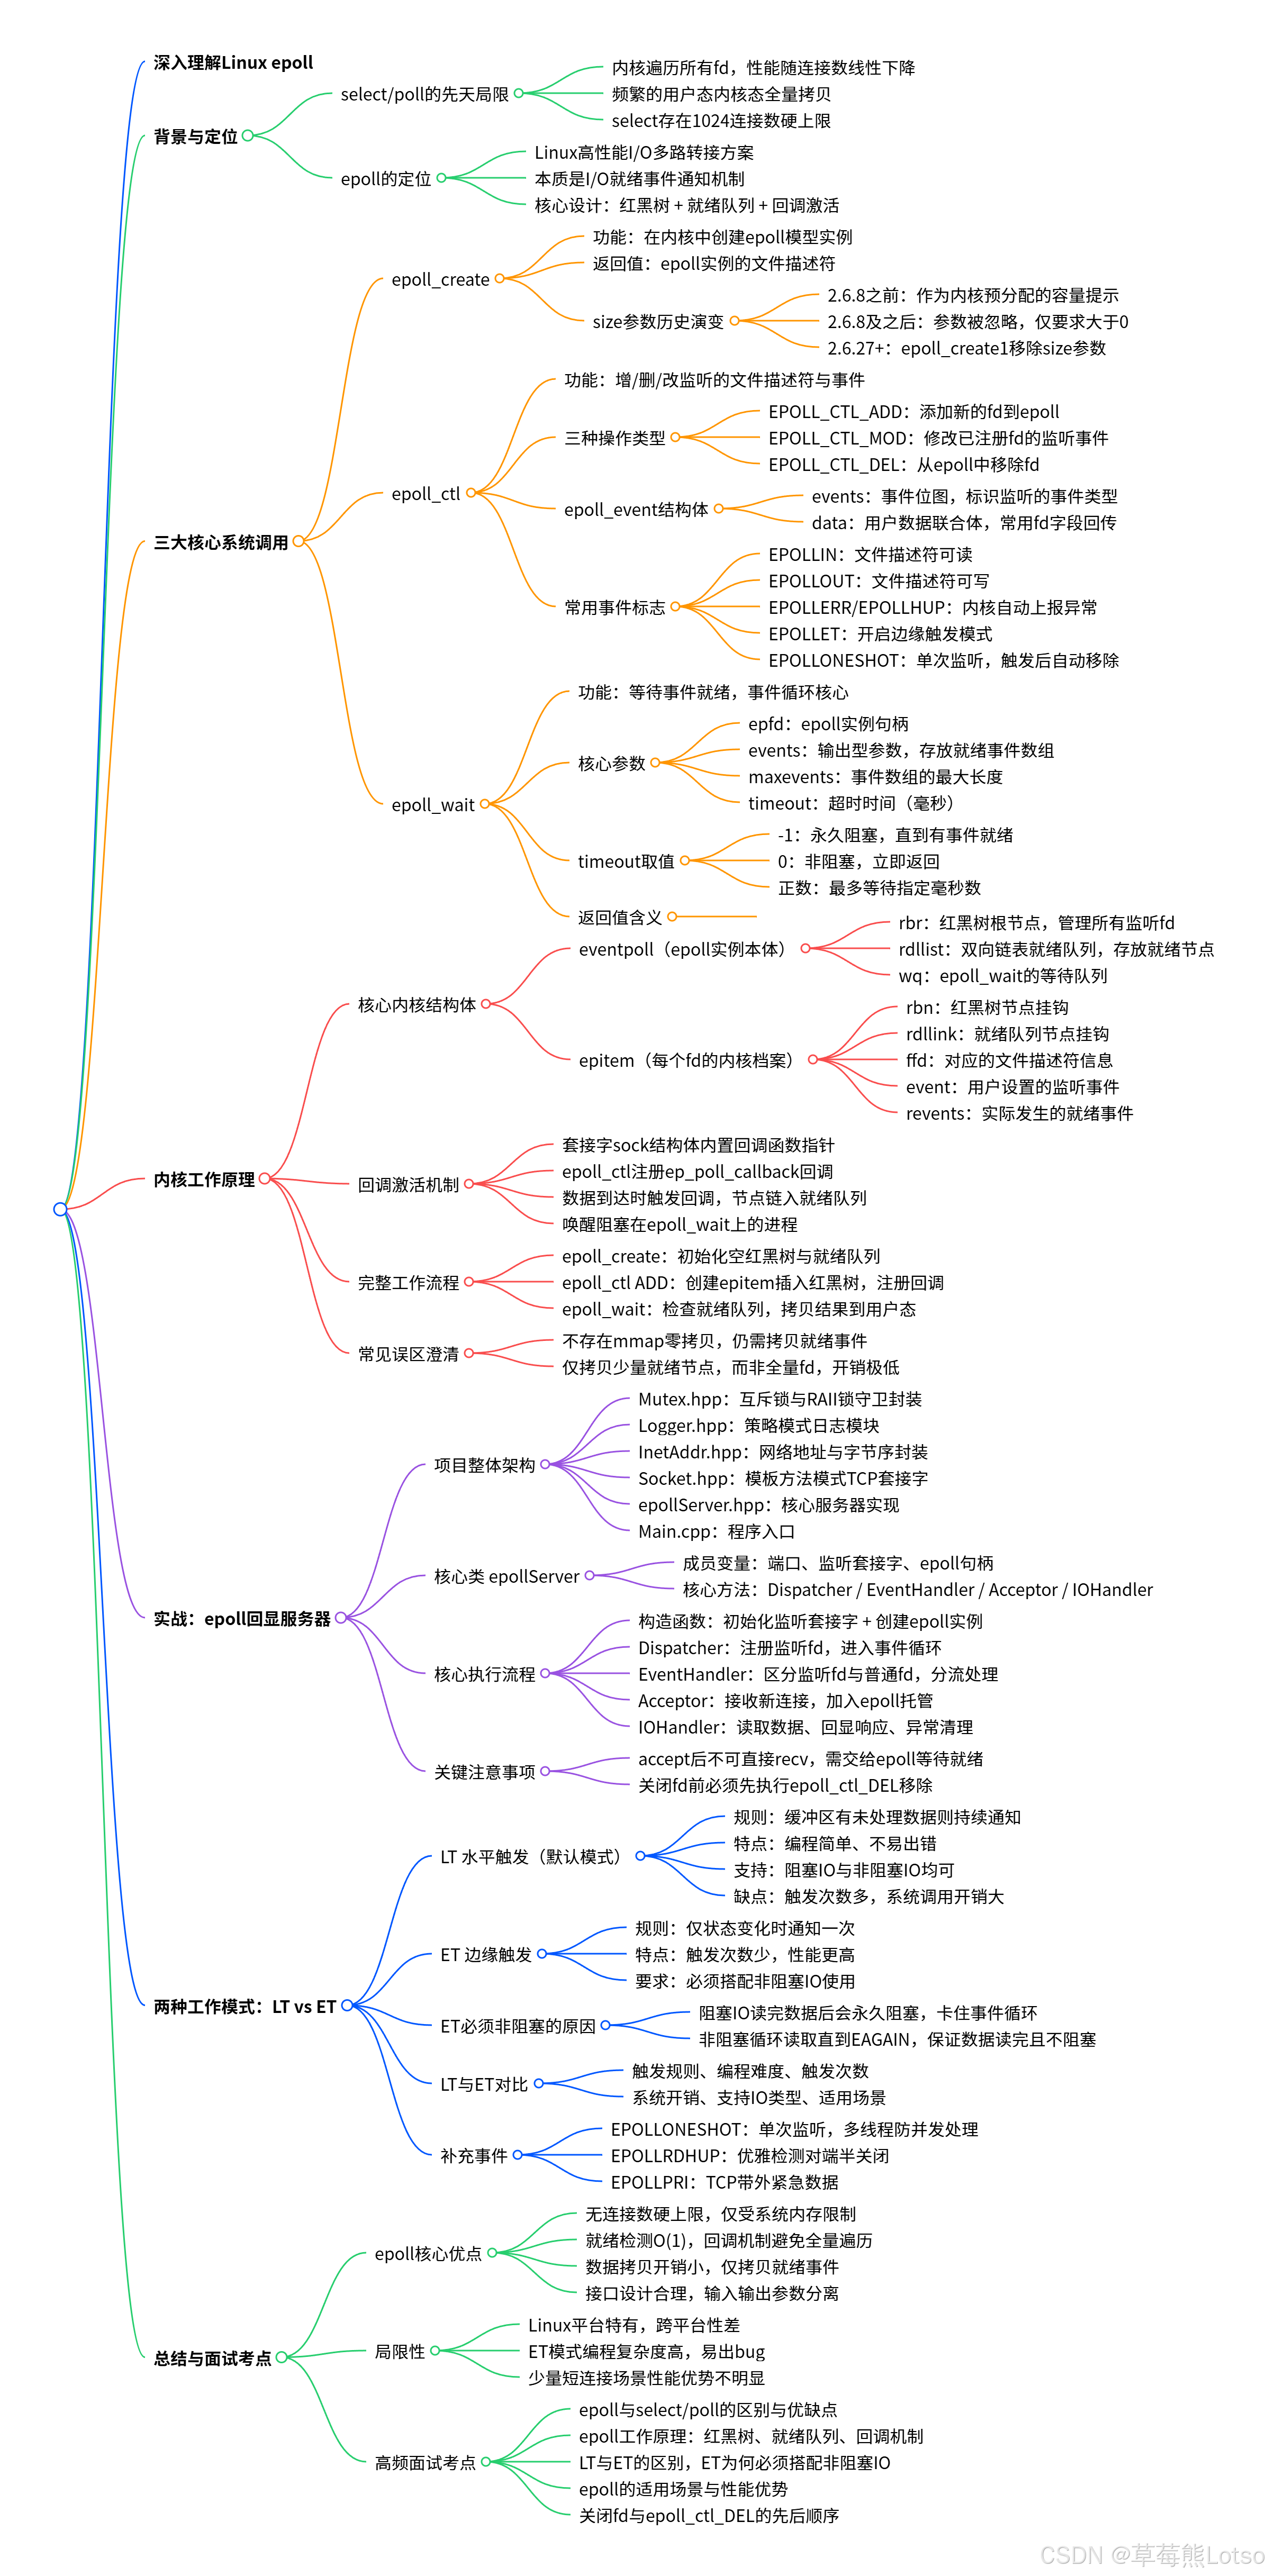
- 一. 为什么要有 epoll?epoll 到底是什么?
-
- 1.1 select 与 poll 的先天局限
- 1.2 epoll 的定位
- 二. epoll 的三个核心系统调用
-
- 2.1 epoll_create:创建 epoll 实例
- 2.2 epoll_ctl:管理监听事件
- 2.3 epoll_wait:等待就绪事件
- 三. epoll 内核工作原理
-
- 3.1 两个核心结构体
- 3.2 回调机制:谁来把节点放进就绪队列?
- 3.3 完整工作流程总结
- 四. 实战:基于 epoll 的回显服务器实现
-
- 4.1 项目整体架构
- 4.2 服务器核心类定义
- 4.3 构造函数:初始化监听套接字与 epoll 模型
- 4.4 Dispatcher:事件循环主入口
- 4.5 EventHandler:事件分发逻辑
- 4.6 Acceptor:处理新连接接入
- 4.7 IOHandler:数据读写与连接清理
- 4.8 主函数入口
- 4.9 完整代码和运行测试(epollServer.hpp)
- 五. 深入:epoll 的两种工作模式 LT vs ET
-
- 5.1 水平触发(Level Triggered)
- 5.2 边缘触发(Edge Triggered)
- 5.3 为什么 ET 模式必须用非阻塞 IO?
- 5.4 LT 与 ET 对比总结
- 5.5 其他补充事件
- 结尾:
前言:
在 Linux 高性能网络编程的世界里,I/O 多路转接是绕不开的核心技术。从早期的 select 到 poll,再到如今几乎成为行业标准的 epoll,每一次演进都是为了解决高并发场景下的效率痛点。很多同学都用过 epoll,但对它的理解往往停留在 “三个系统调用” 的表面,对内核里红黑树、就绪队列、回调机制的工作逻辑一知半解,面试时被问到 LT/ET 模式、epoll 高效的本质也常常答不透彻。这篇文章我们就从 “为什么需要 epoll” 讲起,深入内核拆解它的工作原理,再结合一套完整的 C++ 封装代码,带你从零实现一个基于 epoll 的回显服务器,最后梳理清楚水平触发与边缘触发的核心区别。全文兼顾理论与实战,不管是入门学习还是面试复盘都能有所收获。
一. 为什么要有 epoll?epoll 到底是什么?
1.1 select 与 poll 的先天局限
在 epoll 出现之前,Linux 下主流的 I/O 多路转接方案是 select 和 poll。它们解决了 “单线程等待多个文件描述符” 的问题,但都存在无法忽视的性能瓶颈:
- 内核层面需要遍历所有 fd:每次检测就绪事件,内核都要轮询一遍所有被监听的文件描述符。当连接数成千上万时,大部分连接并不活跃,这种遍历就成了无效开销,性能随连接数线性下降。
- 频繁的用户态内核态拷贝:select 和 poll 每次调用都需要把完整的 fd 集合从用户态拷贝到内核态,调用结束后再把结果拷贝回来,连接越多拷贝开销越大。
- select 还有额外的文件描述符数量上限(默认 1024),无法支撑大规模并发。
1.2 epoll 的定位
按照 Linux 手册的说法,epoll 是 “为处理大批量句柄而改进的 poll”。它在 2.5.44 版本内核中被引入,在 Linux 2.6 之后成为高性能服务器的标配,也是目前 Linux 平台应用最广泛、公认性能最好的 I/O 多路转接方案。
本质上,epoll 和 select、poll 一样,都是I/O 就绪事件通知机制—— 它不负责数据的读写,只负责告诉你 “哪个文件描述符可以读 / 可以写了”,真正的读写操作还是由业务代码完成。
epoll 的核心改进,就是用红黑树管理监听集合 + 就绪队列 + 回调激活的设计,彻底解决了遍历和频繁拷贝的问题。
二. epoll 的三个核心系统调用
和 select/poll 只用一个函数不同,epoll 把 “创建实例、管理监听集合、等待事件” 拆成了三个独立的系统调用,职责更清晰,使用也更灵活。
2.1 epoll_create:创建 epoll 实例
#include <sys/epoll.h>
int epoll_create(int size);
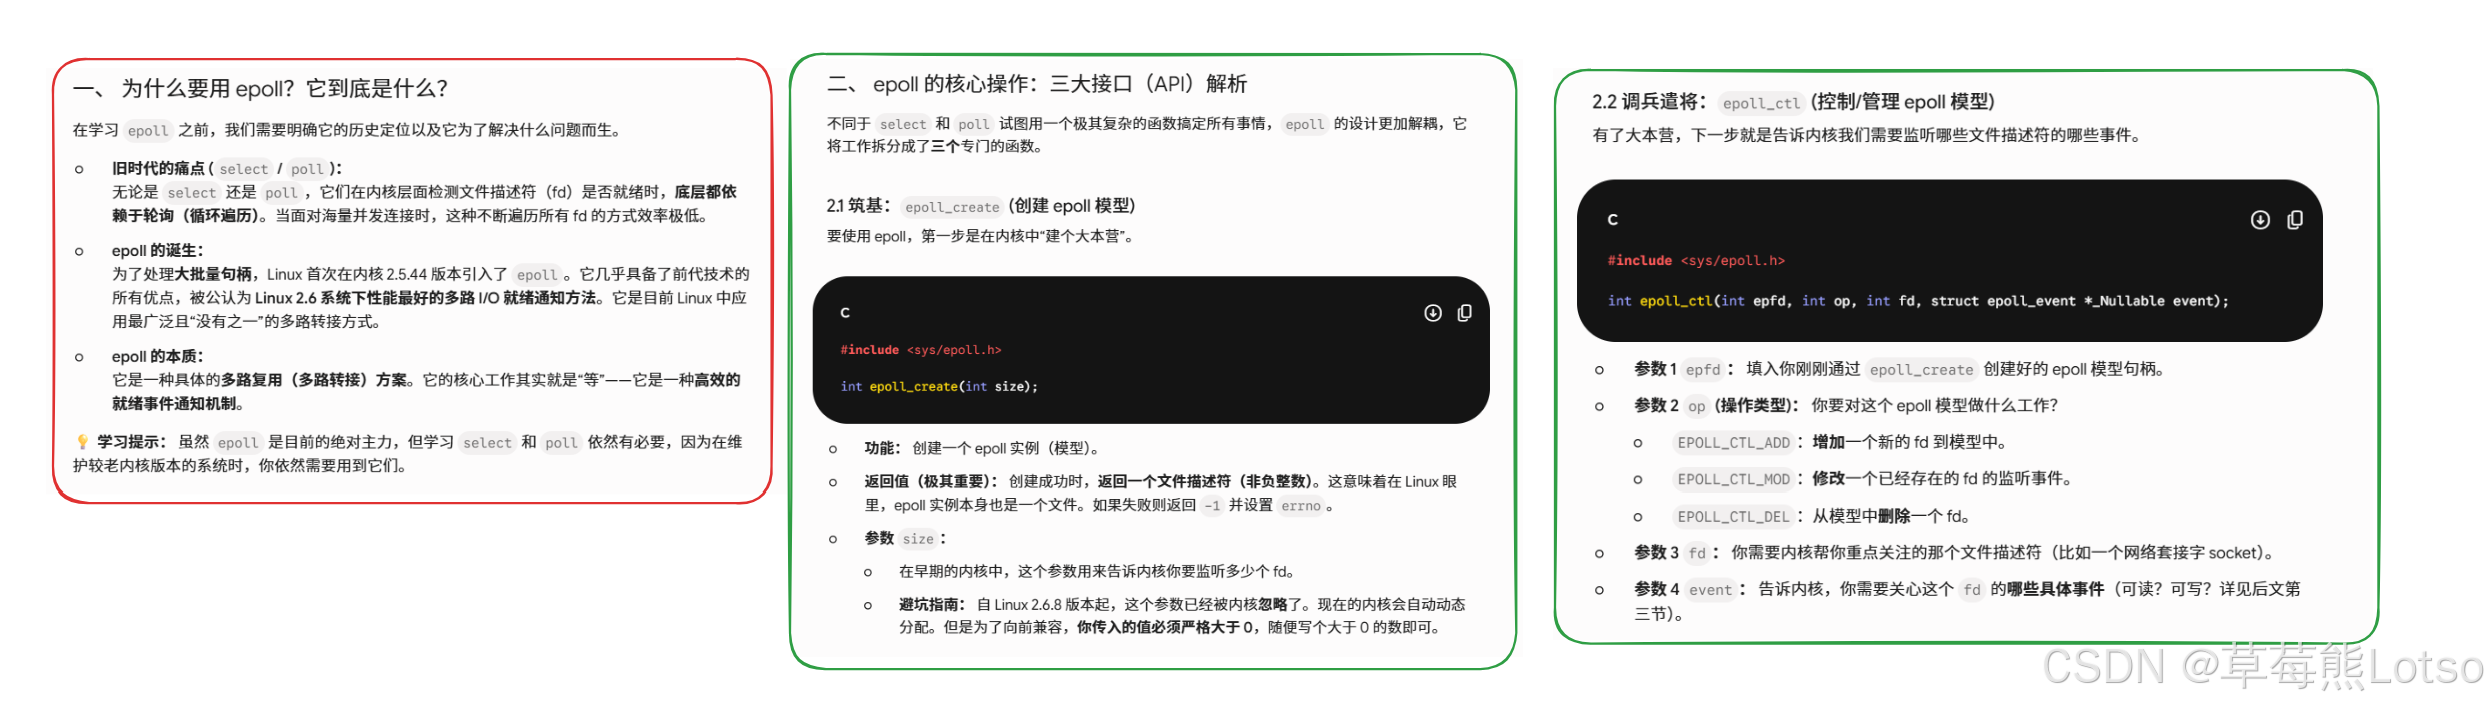
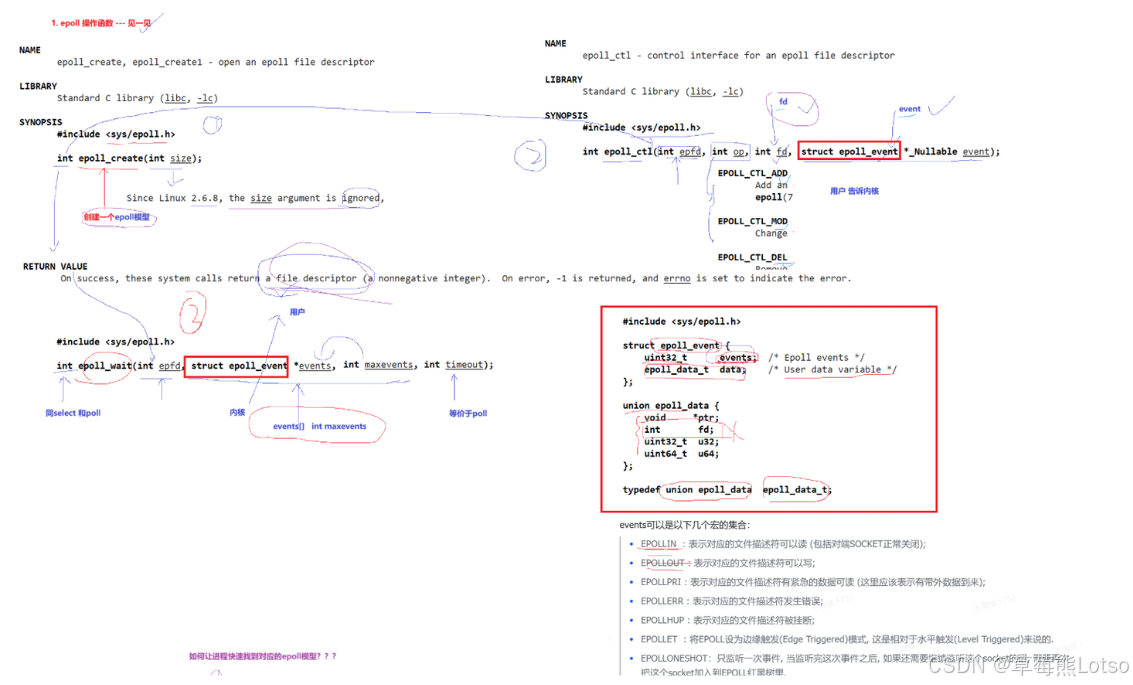
这个函数用来在内核中创建一个 epoll 模型实例,返回值是一个文件描述符,用来标识这个 epoll 实例。
关于size参数有一段历史演变:
- 在 Linux 2.6.8 之前,size 是给内核的预分配提示,告诉内核预计要监听多少个 fd,内核以此预分配内部数据结构的空间。
- 2.6.8 及之后,内核可以动态扩容红黑树,size 参数已经被忽略,但为了向后兼容,仍然要求传入一个大于 0 的整数。
- 2.6.27 之后新增了epoll_create1,直接去掉了 size 参数,通过 flags 设置行为,是更推荐的写法。
为什么 epoll 的返回值也是文件描述符?因为 Linux 的设计哲学是 “一切皆文件”,epoll 实例本身也会被抽象成一个文件,通过文件描述符可以被进程唯一标识和访问。
2.2 epoll_ctl:管理监听事件
int epoll_ctl(int epfd, int op, int fd, struct epoll_event *event);
这是 epoll 的事件控制接口,用来向 epoll 模型中添加、修改、删除对某个文件描述符的监听。可以理解为对内核里的红黑树做增删改操作。
参数说明:
- epfd:epoll_create 返回的 epoll 实例句柄
- op:操作类型,有三个宏可选:
- EPOLL_CTL_ADD:添加新的 fd 到 epoll 中
- EPOLL_CTL_MOD:修改已注册 fd 的监听事件
- EPOLL_CTL_DEL:从 epoll 中移除一个 fd
- fd:要操作的目标文件描述符
- event:告诉内核要监听这个 fd 的哪些事件
核心的epoll_event结构体长这样:
struct epoll_event {
uint32_t events; // 事件位图,用比特位表示要监听的事件
epoll_data_t data; // 用户数据,联合体
};
typedef union epoll_data {
void *ptr;
int fd;
uint32_t u32;
uint64_t u64;
} epoll_data_t;
常用的事件标志:
- EPOLLIN:文件描述符可读(包括对端正常关闭)
- EPOLLOUT:文件描述符可写
- EPOLLERR:文件描述符发生错误(内核自动上报,不需要手动设置)
- EPOLLHUP:文件描述符被挂断(内核自动上报)
- EPOLLET:设置为边缘触发模式
- EPOLLONESHOT:只监听一次事件,触发后自动移除,需要重新注册
data是一个联合体,最常用的是data.fd,用来在事件就绪时带回对应的文件描述符。
2.3 epoll_wait:等待就绪事件
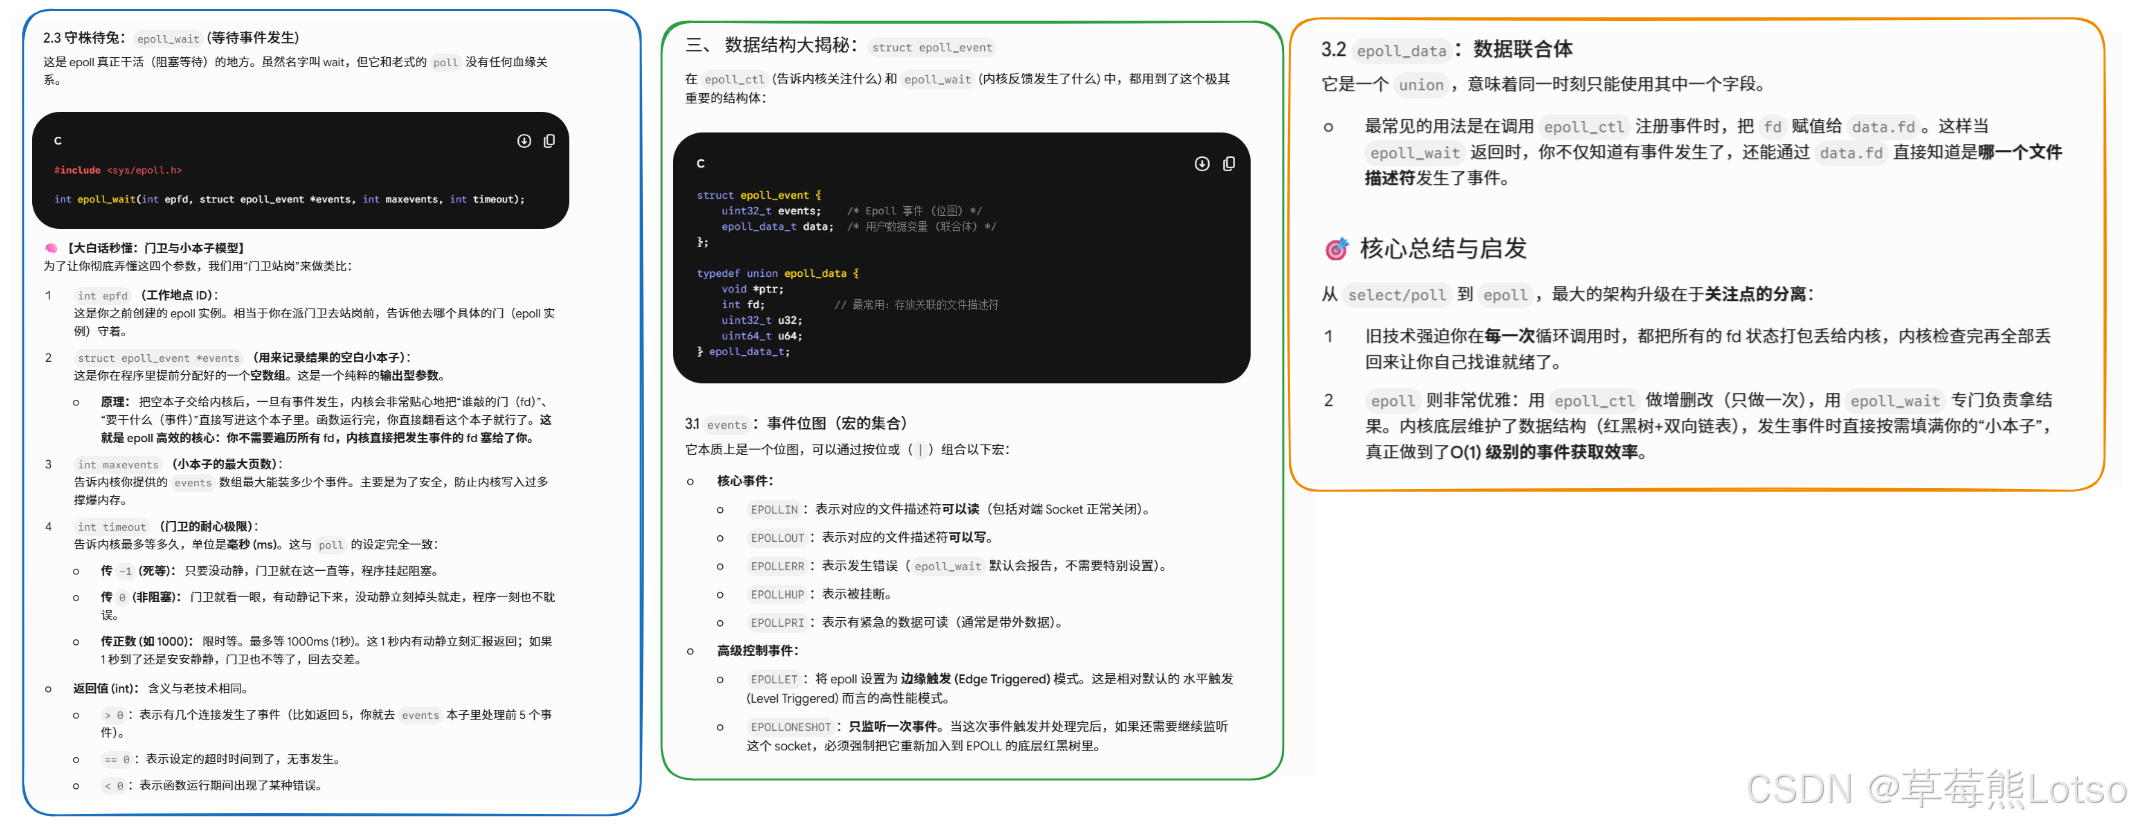
int epoll_wait(int epfd, struct epoll_event *events, int maxevents, int timeout);
这个函数用来等待事件就绪,是我们事件循环的核心。
参数说明:
- epfd:epoll 实例句柄
- events:输出型参数,用户提前分配好的数组,内核会将就绪的事件填充到这个数组里
- maxevents:告诉内核 events 数组的最大长度,防止内核写越界
- timeout:超时时间,单位毫秒
- 传-1:永久阻塞,直到有事件就绪
- 传0:非阻塞,立刻返回,没有事件就返回 0
- 传正数:最多等待指定毫秒数,超时返回 0
返回值:
- 大于 0:就绪的文件描述符数量
- 等于 0:超时
- 小于 0:调用出错
这里要特别理解 “输出型参数” 的含义:调用前你只需要准备一块空内存,不需要填任何内容;调用后内核会把结果写进去。这和 select 需要每次都重新设置 fd 集合有本质区别,也是 epoll 更高效的原因之一。
三. epoll 内核工作原理
只看 API 只能学会怎么用,要理解 epoll 为什么快,必须深入内核看它的数据结构和工作流程。
3.1 两个核心结构体
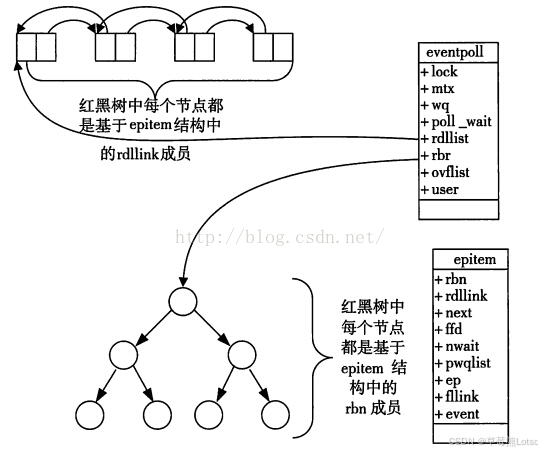
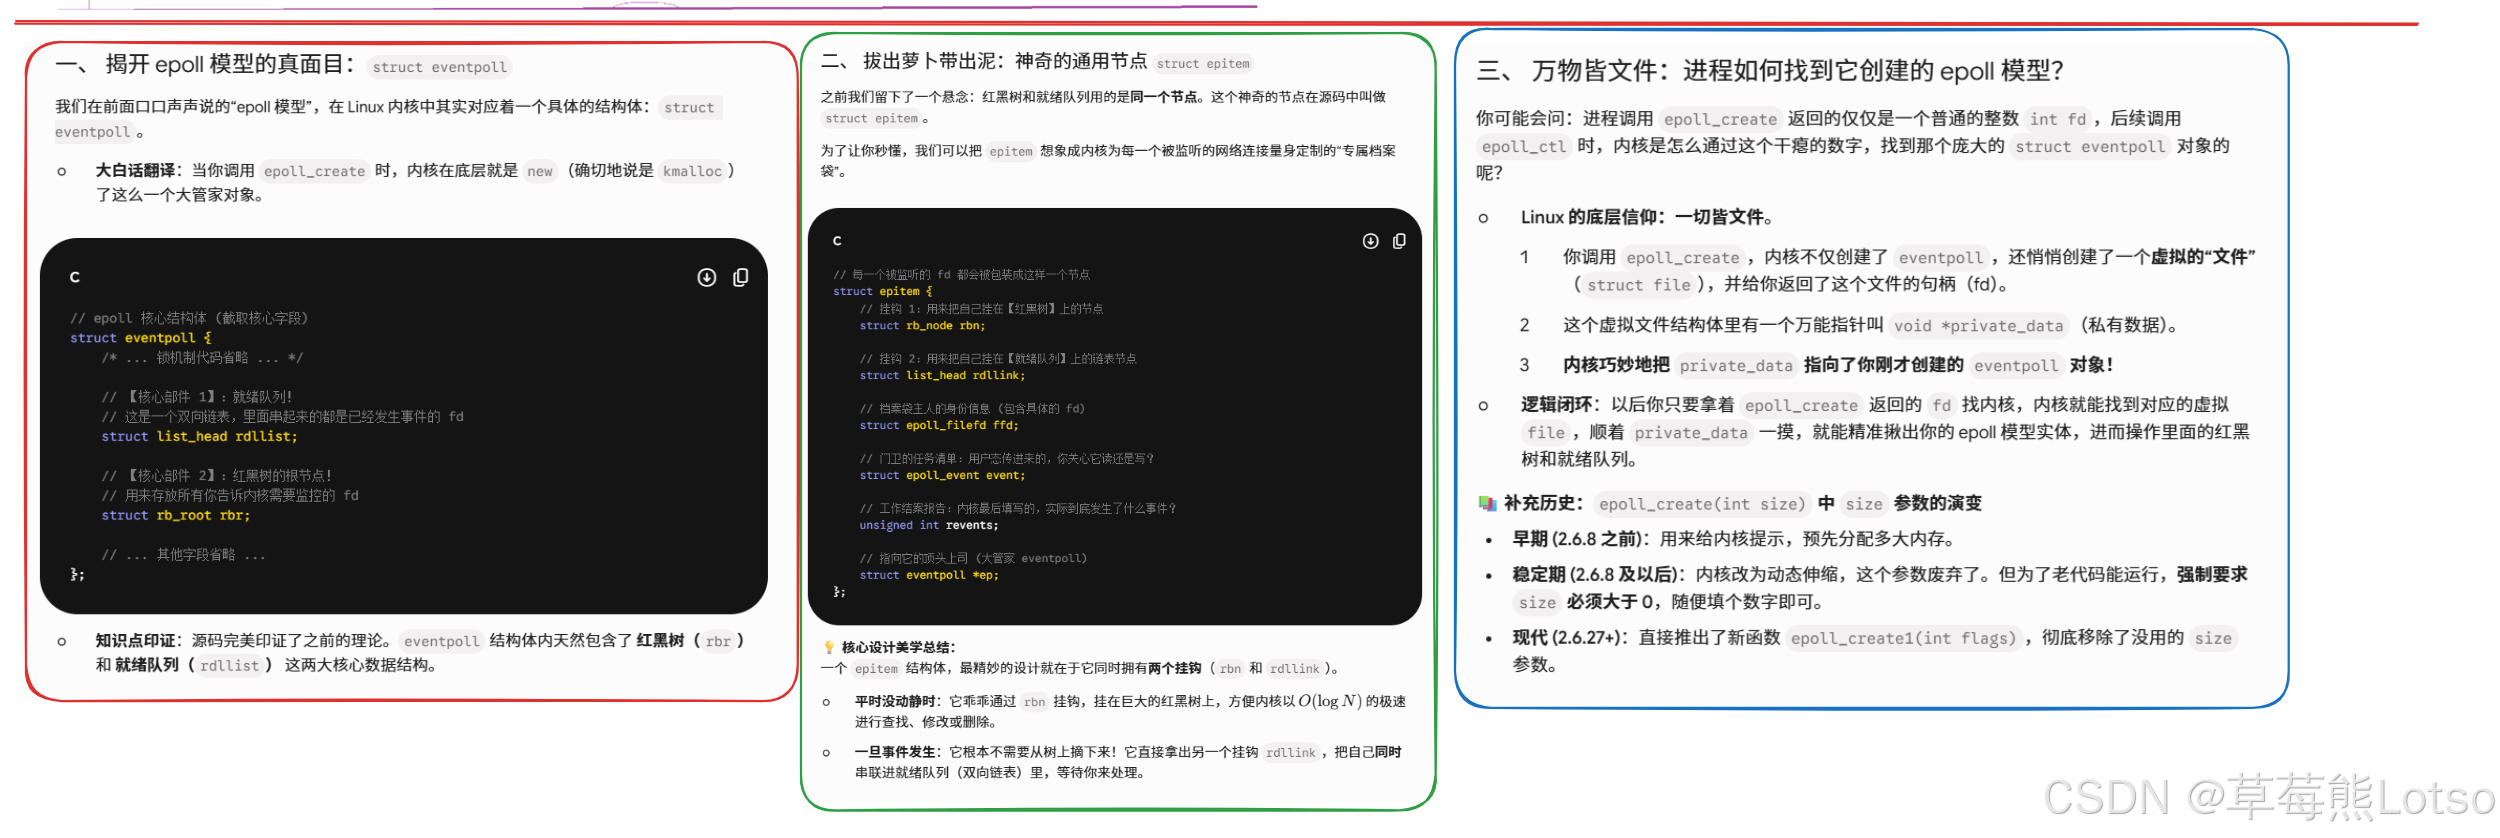
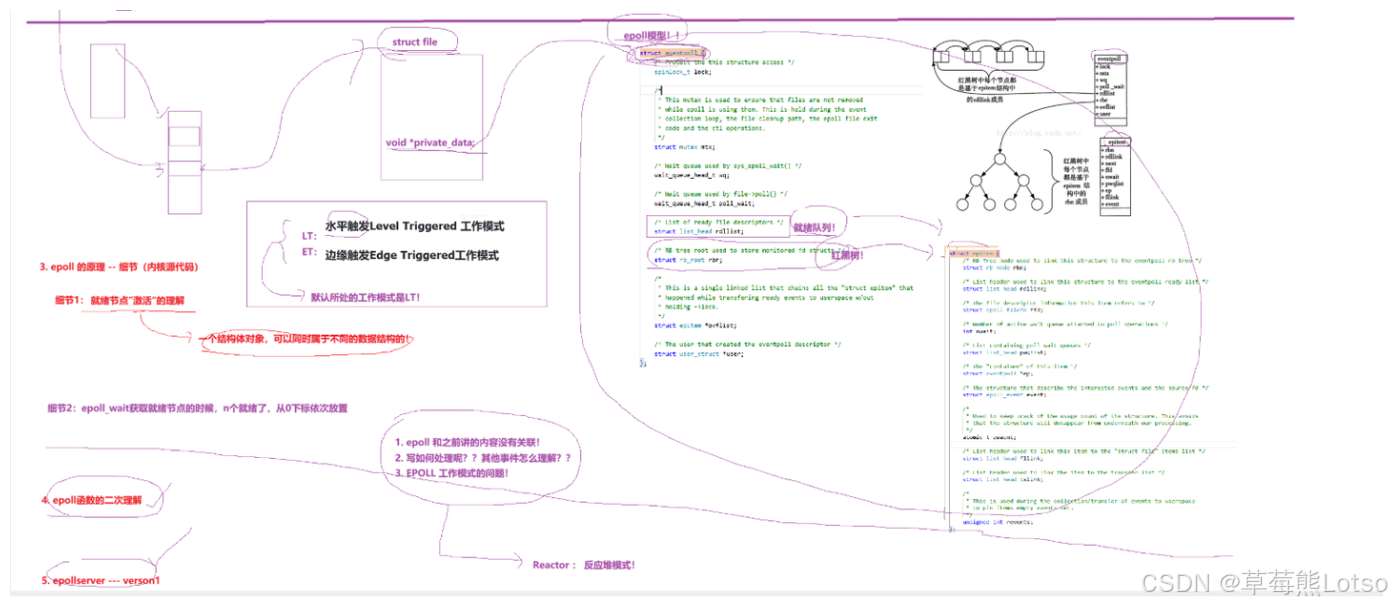
epoll 在内核里的实现围绕两个关键结构体展开:eventpoll和epitem。
eventpoll:epoll 实例本体
每个 epoll 文件描述符对应一个eventpoll结构体,它就是 epoll 模型的本体:
struct eventpoll {
spinlock_t lock;
struct mutex mtx;
wait_queue_head_t wq; // epoll_wait的等待队列
struct list_head rdllist; // 就绪队列(双向链表)
struct rb_root rbr; // 红黑树根节点
struct epitem *ovflist; // 溢出链表
struct user_struct *user;
};
核心是两个数据结构:
epitem:每个 fd 的 “档案”
每一个被添加到 epoll 的文件描述符,内核都会为它创建一个epitem结构体:
struct epitem {
struct rb_node rbn; // 红黑树节点,挂在红黑树上
struct list_head rdllink; // 链表节点,挂在就绪队列上
struct epoll_filefd ffd; // 对应的文件描述符信息
struct eventpoll *ep; // 所属的epoll实例
struct epoll_event event; // 用户设置的监听事件
unsigned int revents; // 实际发生的就绪事件
// … 其他字段
};
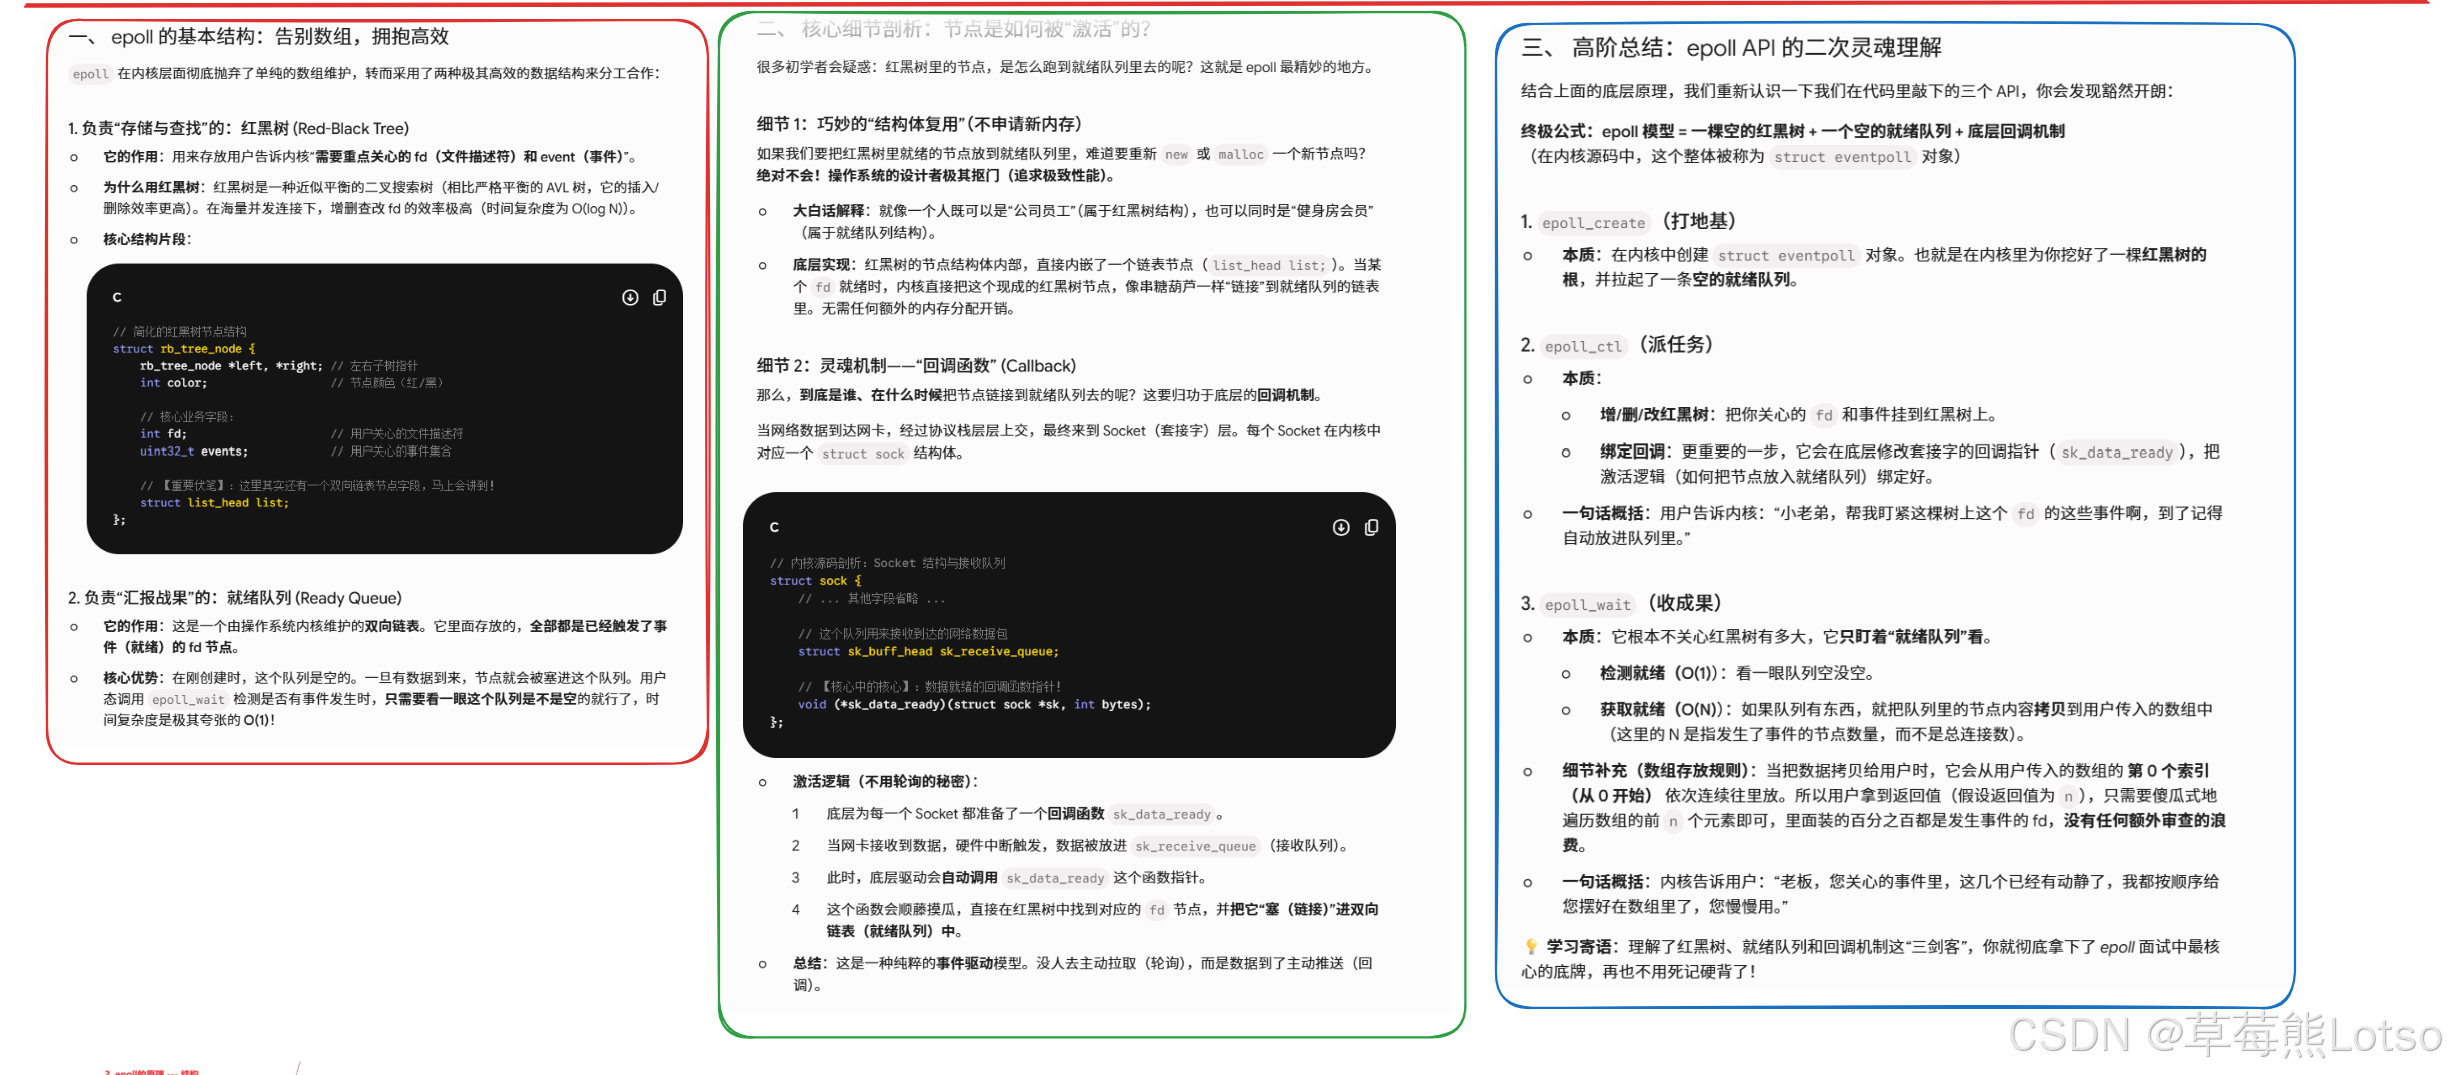
这个设计非常精妙:同一个 epitem 节点,同时属于红黑树和就绪队列两个数据结构。平时它安静地挂在红黑树上等待被管理;一旦对应的 fd 上有事件发生,就通过rdllink链入就绪队列,等待被 epoll_wait 取走。
打个通俗的比方:
- 红黑树就是档案室的文件柜,所有客户的档案都按编号存好,查找很快。
- 就绪队列就是前台的加急处理台,有业务要办的档案直接放到这里。
- 你调用 epoll_wait,就是直接去前台加急台拿档案处理,不用一个个文件柜去翻。
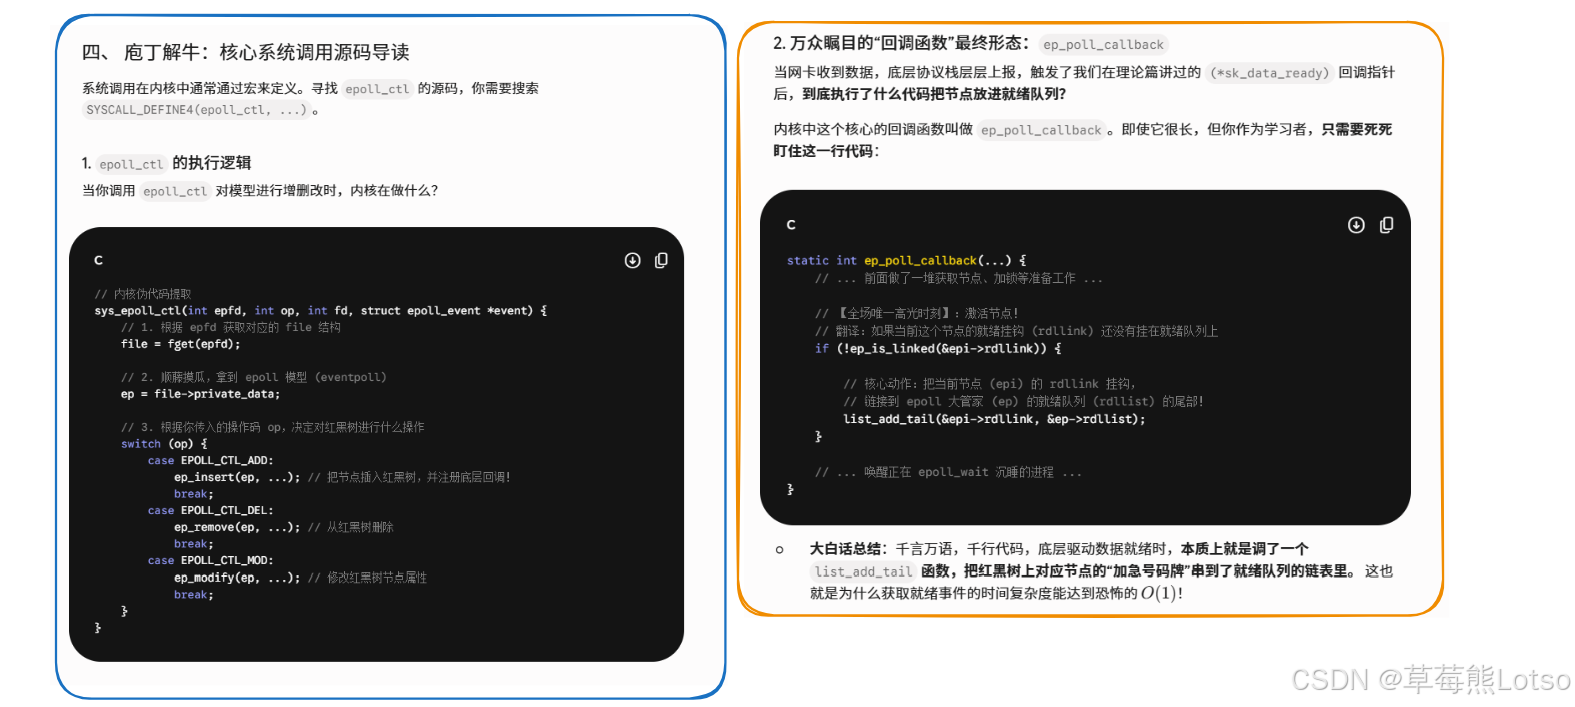
3.2 回调机制:谁来把节点放进就绪队列?
你可能会问:内核怎么知道哪个 fd 就绪了?是谁把 epitem 放到就绪队列里的?
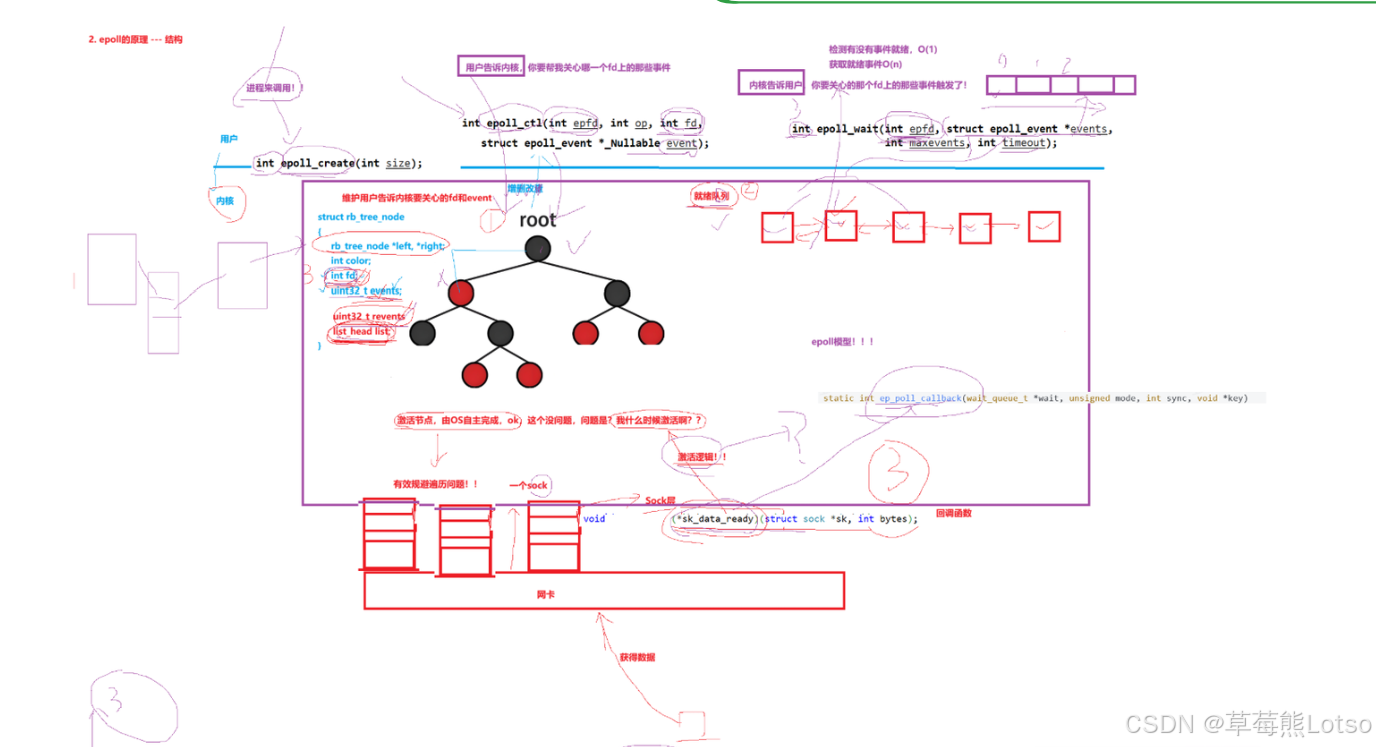
答案是回调机制。 每个套接字在内核里都对应一个sock结构体,里面有一系列函数指针,比如sk_data_ready(读数据就绪时调用)、sk_write_space(写缓冲区可用时调用)。默认情况下这些函数只会唤醒等待在套接字上的进程。
当我们用epoll_ctl把一个套接字加入 epoll 时,内核会做两件事:
当网卡收到数据,经过协议栈处理后放到套接字的接收缓冲区,就会调用sk_data_ready回调,最终触发ep_poll_callback。这个回调函数做的事情非常简单: 把对应的 epitem 节点链入 eventpoll 的就绪队列,然后唤醒阻塞在 epoll_wait 上的进程。
整个过程完全由事件驱动,不需要内核遍历所有 fd 去检查状态。这就是 epoll 在高并发下依然高效的核心秘密 ——用回调代替遍历。
3.3 完整工作流程总结
我们把三个系统调用和内核结构对应起来:
整个过程中,检测是否有就绪事件是 O (1),获取就绪事件是 O (N)(N 是就绪的数量,不是总监听数)。在大部分连接不活跃的场景下,每次就绪的数量很少,效率远高于 select/poll 的全量遍历。
补充一个常见误区:网上有说法称 epoll 用了 mmap 内存映射实现零拷贝,这是不准确的。用户传入的 events 数组是用户空间内存,内核还是需要把就绪事件拷贝进去。但拷贝的只是少量就绪节点,而不是全部监听的 fd,开销已经非常小了。
四. 实战:基于 epoll 的回显服务器实现
讲完原理,我们结合一套完整的 C++ 代码,动手实现一个基于 epoll 的 echo 回显服务器,看看 epoll 在实际工程中是怎么封装和使用的。
4.1 项目整体架构
代码分为几个模块,都是 Linux 网络编程常用的基础设施:
- Mutex.hpp:封装 POSIX 互斥锁和 RAII 风格的 LockGuard,保证临界资源操作的原子性。
- Logger.hpp:日志模块,采用策略模式支持控制台 / 文件输出,利用 RAII 临时对象析构自动刷新日志。
- InetAddr.hpp:封装 sockaddr_in 地址结构,处理字节序转换、IP 字符串与整数转换。
- Socket.hpp:用模板方法模式封装 TCP 套接字,统一了服务器和客户端的启动流程。
- epollServer.hpp:核心的 epoll 服务器类,完成事件循环和分发逻辑。
- Main.cpp:程序入口。
前面几个组件是通用工具,我们重点解读核心的 epollServer 实现。
4.2 服务器核心类定义
class epollServer
{
public:
epollServer(int port);
void Dispatcher(); // 事件分发主循环
~epollServer();
private:
void EventHandler(struct epoll_event revs[], int ready_num);
void Acceptor(); // 处理新连接接入
void IOHandler(int fd); // 处理普通套接字的读写事件
private:
uint16_t _port;
std::unique_ptr<Socket> _listensockfd; // 监听套接字智能指针
int _epfd; // epoll实例句柄
};
4.3 构造函数:初始化监听套接字与 epoll 模型
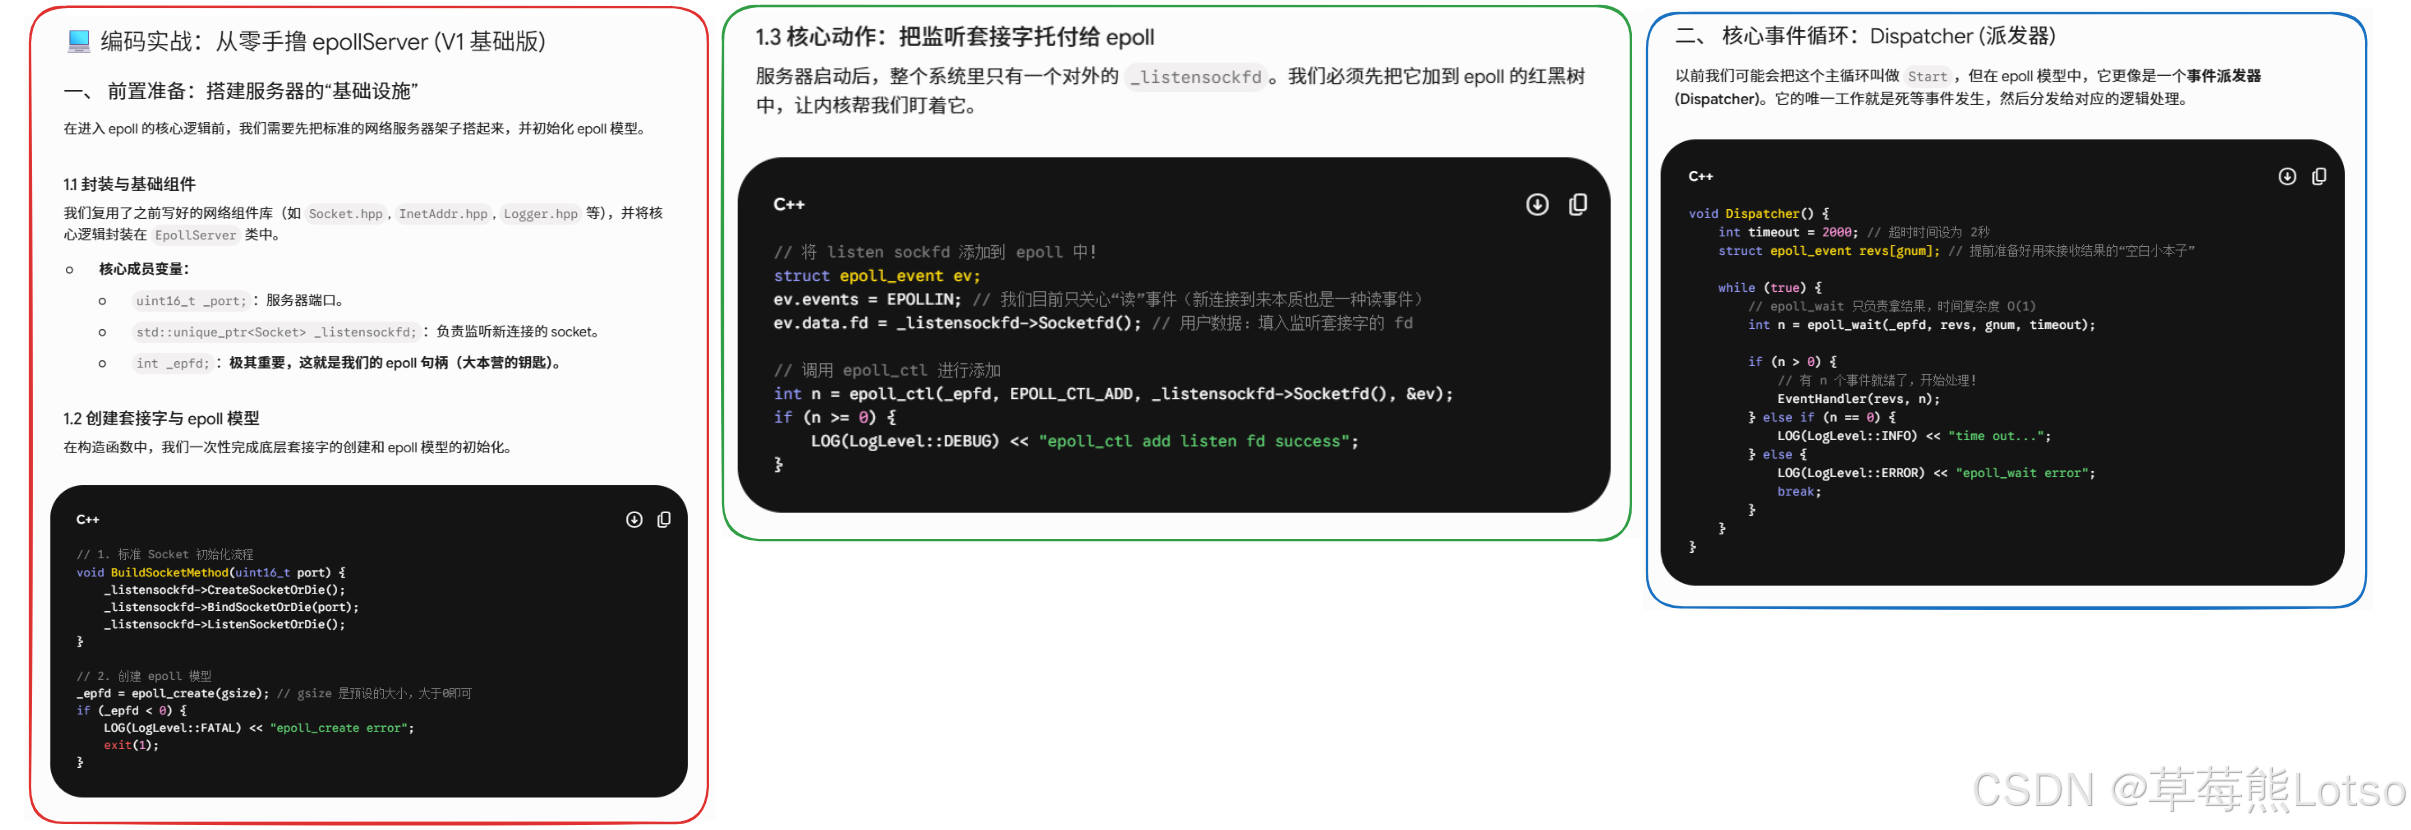
构造函数完成两项核心初始化:启动监听套接字,创建 epoll 实例。
epollServer(int port)
:_port(port)
,_listensockfd(std::make_unique<TcpSocket>())
{
// 模板方法:一键完成socket创建、绑定、监听三步
_listensockfd->BulidSocketMethod(_port);
// 创建epoll模型
_epfd = epoll_create(gsize);
if(_epfd < 0)
{
LOG(LogLevel::FATAL) << "epoll_create error";
exit(1);
}
LOG(LogLevel::INFO) << "listen sockfd : " << _listensockfd->Socketfd()
<< " epfd: " << _epfd;
}
这里复用了之前封装的 TcpSocket,BulidSocketMethod按顺序执行创建、绑定、监听,失败直接终止进程,符合服务器 “启动失败不继续运行” 的工程习惯。
4.4 Dispatcher:事件循环主入口
Dispatcher是服务器的主循环,负责把监听套接字注册进 epoll,然后不断调用 epoll_wait 派发事件。
void Dispatcher()
{
// 第一步:将监听套接字加入epoll,监听读事件
struct epoll_event evn;
evn.events = EPOLLIN;
evn.data.fd = _listensockfd->Socketfd();
int n = epoll_ctl(_epfd, EPOLL_CTL_ADD, _listensockfd->Socketfd(), &evn);
if(n == 0)
{
LOG(LogLevel::DEBUG) << "epoll_ctl add : "
<< _listensockfd->Socketfd() << " success";
}
int timeout = 2000; // 超时时间2秒
struct epoll_event revs[gnum]; // 存放就绪事件的用户态数组
while(true)
{
int n = epoll_wait(_epfd, revs, gnum, timeout);
if(n == 0)
{
LOG(LogLevel::INFO) << "time out…";
}
else if(n < 0)
{
LOG(LogLevel::ERROR) << "epoll_wait error…";
break;
}
else
{
LOG(LogLevel::DEBUG) << "有事件就绪…";
EventHandler(revs, n); // 分发处理就绪事件
}
}
}
这是 epoll 编程的标准骨架:注册监听 fd → 进入循环等待 → 分发处理事件。
4.5 EventHandler:事件分发逻辑
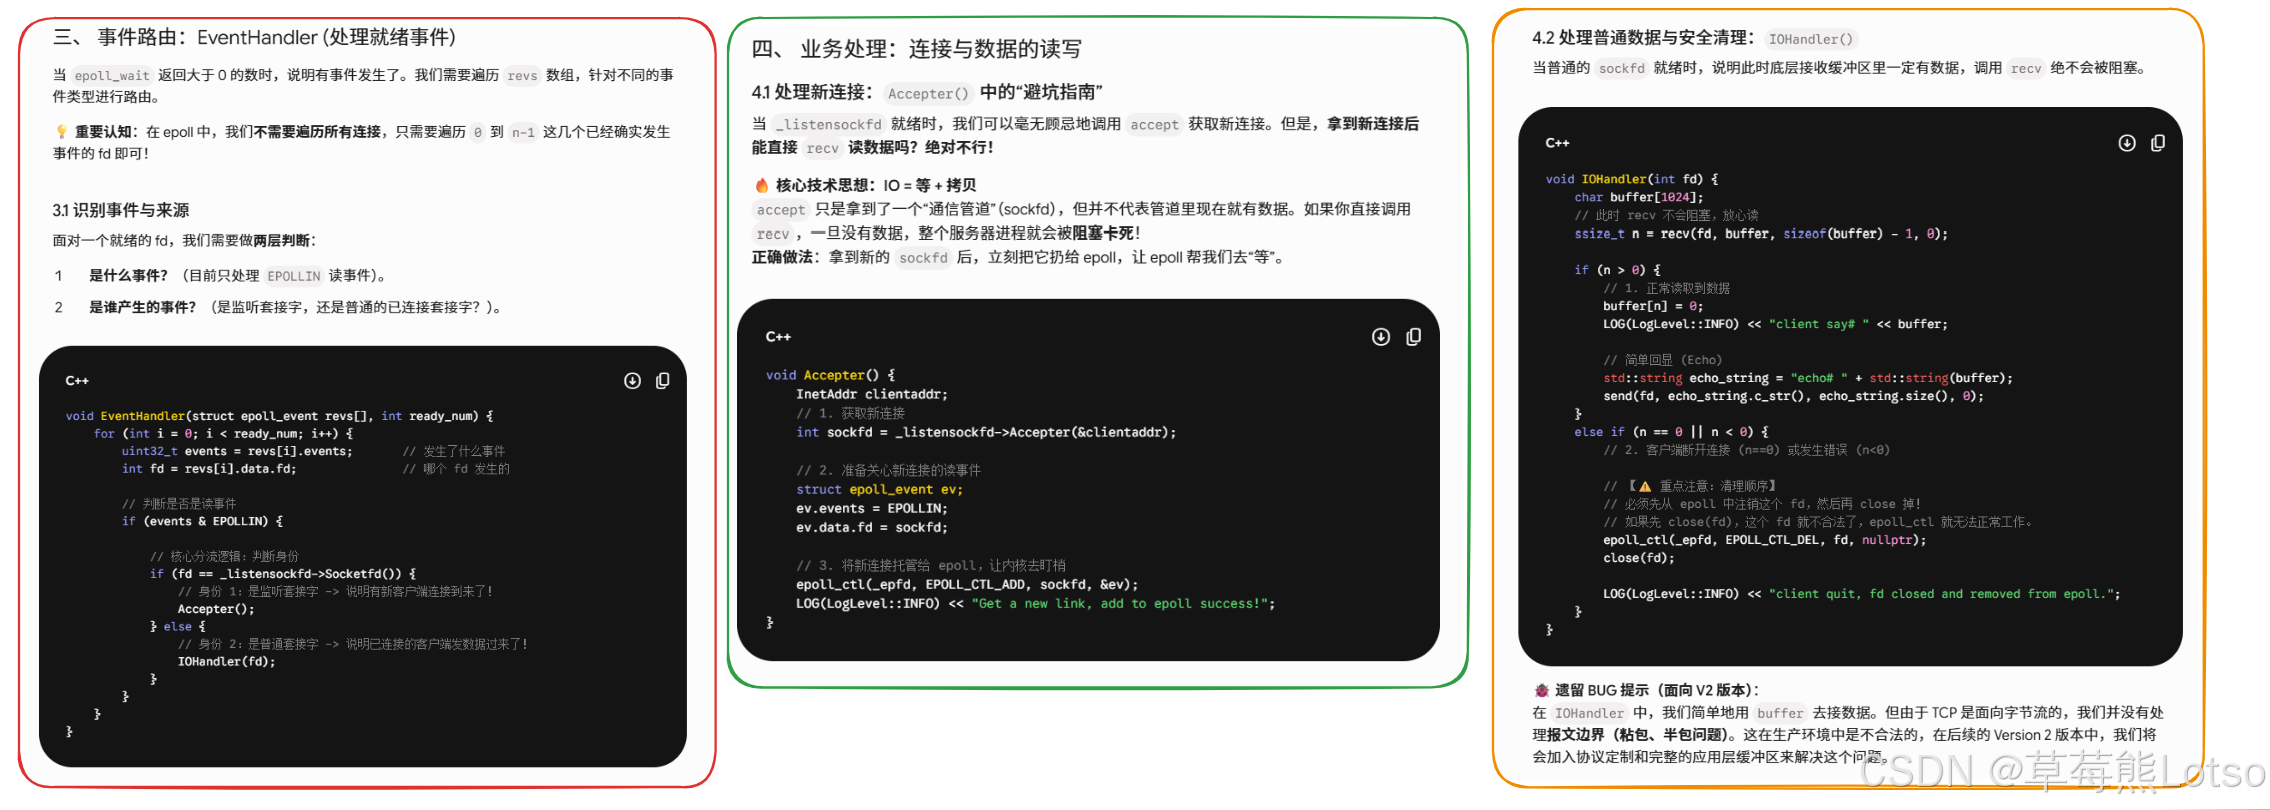
事件就绪后,我们需要区分是 “新连接就绪” 还是 “数据可读就绪”,分别走不同的处理分支。
void EventHandler(struct epoll_event revs[], int ready_num)
{
for(int i = 0; i < ready_num; i++)
{
uint32_t events = revs[i].events;
int fd = revs[i].data.fd;
if(events & EPOLLIN)
{
// 通过fd对比,区分是监听套接字还是普通通信套接字
if(fd == _listensockfd->Socketfd())
{
Acceptor(); // 处理新连接
}
else
{
IOHandler(fd); // 处理数据读写
}
}
}
}
这是 epoll 编程的固定套路:通过 fd 和监听套接字对比,将连接事件和 IO 事件分流处理。
4.6 Acceptor:处理新连接接入
当监听套接字可读,说明有客户端完成了三次握手,调用 accept 取出连接,并将新连接交给 epoll 托管。
void Acceptor()
{
InetAddr clientaddr;
int sockfd = _listensockfd->Accepter(&clientaddr);
LOG(LogLevel::INFO) << "sockfd is: " << sockfd
<< " client addr: " << clientaddr.StringAddress();
if(sockfd >= 0)
{
// 将新连接的fd加入epoll,监听读事件
struct epoll_event evn;
evn.events = EPOLLIN;
evn.data.fd = sockfd;
epoll_ctl(_epfd, EPOLL_CTL_ADD, sockfd, &evn);
LOG(LogLevel::INFO) << "epoll_ctl add event: " << sockfd;
}
else
{
LOG(LogLevel::ERROR) << "Accept error…";
}
}
注意:accept 拿到新 fd 之后,绝对不能直接调用 recv 读数据。连接建立不代表对方立刻发送了数据,直接读会阻塞整个事件循环。正确做法是把 fd 交给 epoll,等数据就绪后由 epoll 通知再读取。
4.7 IOHandler:数据读写与连接清理
普通套接字可读时,读取客户端数据并回显;如果对端关闭或读取出错,则清理对应资源。
void IOHandler(int fd)
{
char inbuffer[1024];
ssize_t n = recv(fd, inbuffer, sizeof(inbuffer) – 1, 0);
if(n > 0)
{
inbuffer[n] = 0;
LOG(LogLevel::INFO) << "client say# " << inbuffer;
// 回显消息
std::string echo_string = "echo# ";
echo_string += inbuffer;
send(fd, echo_string.c_str(), echo_string.size(), 0);
}
else if(n == 0)
{
// 对端正常关闭:先从epoll移除,再关闭文件描述符
LOG(LogLevel::INFO) << "client quit, epoll_ctl del event: " << fd;
epoll_ctl(_epfd, EPOLL_CTL_DEL, fd, nullptr);
close(fd);
}
else
{
LOG(LogLevel::ERROR) << "recv error…";
epoll_ctl(_epfd, EPOLL_CTL_DEL, fd, nullptr);
close(fd);
}
}
这里有一个非常重要的细节:必须先调用 epoll_ctl 删除 fd,再调用 close 关闭 fd。因为 epoll_ctl_DEL 操作要求 fd 是合法有效的,如果先 close 了,文件描述符就会失效,删除操作可能失败。
4.8 主函数入口
#include "epollServer.hpp"
#include <cstdint>
#include <memory>
const uint16_t gport = 8080;
int main()
{
std::unique_ptr<epollServer> select_server= std::make_unique<epollServer>(gport);
select_server->Dispatcher();
return 0;
}
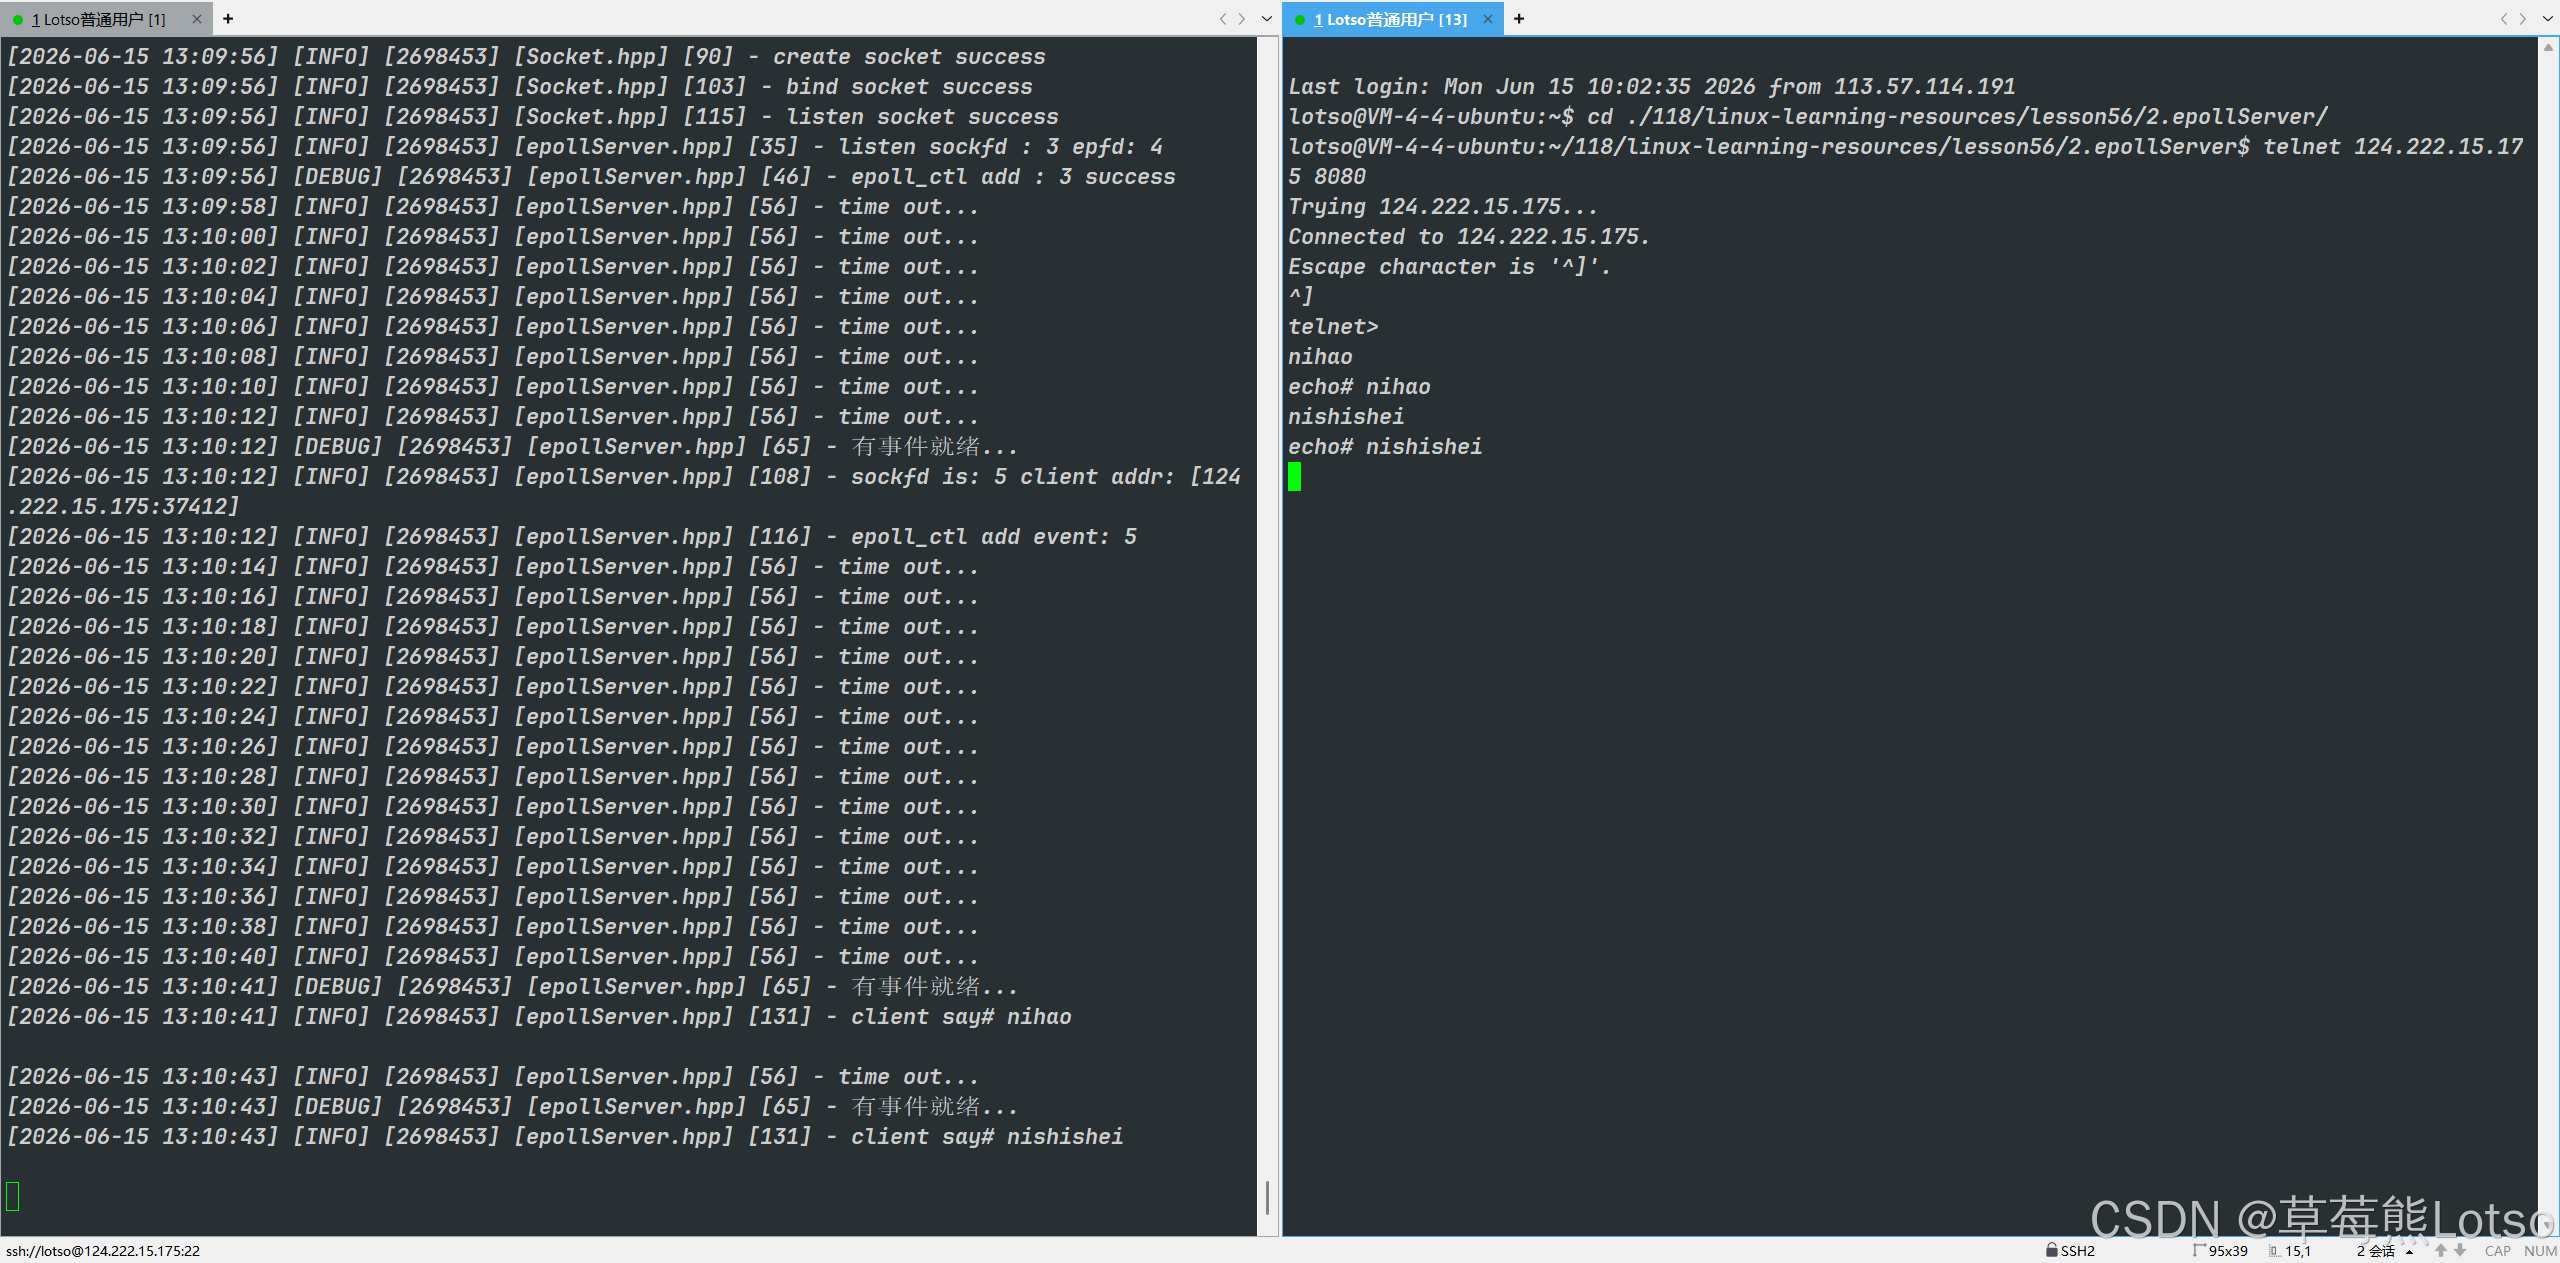
编译运行后,服务器会在 8080 端口监听,支持多个客户端同时连接并回显消息。
4.9 完整代码和运行测试(epollServer.hpp)
#ifndef __EPOLLSERVER__HPP
#define __EPOLLSERVER__HPP
#include "Logger.hpp"
#include "InetAddr.hpp"
#include "Socket.hpp"
#include <cstdint>
#include <sys/epoll.h>
#include <memory>
#include <sys/socket.h>
#include <sys/types.h>
#include <unistd.h>
using namespace LogModule;
static const int gsize = 128;
static const int gnum = 64;
class epollServer
{
public:
epollServer(int port)
:_port(port)
,_listensockfd(std::make_unique<TcpSocket>())
{
// 创建监听套接字
_listensockfd->BulidSocketMethod(_port);
// 创建epoll模型
// [核心注释] 这一步在内核中创建了 eventpoll 结构体(包含一棵空的红黑树和一个空的就绪队列双向链表)
// 参数 gsize 在现代 Linux 中已被忽略,只要大于 0 即可。
_epfd = epoll_create(gsize);
if(_epfd < 0)
{
LOG(LogLevel::FATAL) << "epoll_create error";
exit(1);
}
LOG(LogLevel::INFO) << "listen sockfd : " << _listensockfd->Socketfd() << " " << "epfd: " << _epfd;
}
void Dispatcher()
{
// 先将 listensockfd 加进去
struct epoll_event evn;
evn.events = EPOLLIN;
evn.data.fd = _listensockfd->Socketfd();
// [核心注释] EPOLL_CTL_ADD 本质:
// 1. 在内核红黑树中新增一个节点(存放 _listensockfd 及其关心的 EPOLLIN 事件)。
// 2. 建立底层网卡驱动到该 fd 的回调机制(当有新连接到来时,自动将该节点推入就绪队列)。
int n = epoll_ctl(_epfd, EPOLL_CTL_ADD, _listensockfd->Socketfd(), &evn);
if(n == 0)
{
LOG(LogLevel::DEBUG) << "epoll_ctl add : " << _listensockfd->Socketfd() << " success";
}
int timeout = 2000;
struct epoll_event revs[gnum]; // 用来记录结果的
while(true)
{
// [核心注释] epoll 的性能核心:
// 这里的时间复杂度是 O(1) 检测。内核只检查就绪队列是否为空。
// 如果不为空,将就绪队列中的节点事件依次“拷贝”到用户态传入的 revs 数组中,返回值 n 就是实际发生事件的数量。
int n = epoll_wait(_epfd, revs, gnum, timeout);
if(n == 0)
{
LOG(LogLevel::INFO) << "time out…";
}
else if(n < 0)
{
LOG(LogLevel::ERROR) << "epoll_wait error…";
break;
}
else
{
LOG(LogLevel::DEBUG) << "有事件就绪…";
EventHandler(revs, n); // 事件处理
}
}
}
~epollServer()
{
if(_epfd >= 0)
close(_epfd);
// _listensockfd 会自动释放
}
private:
void EventHandler(struct epoll_event revs[], int ready_num)
{
// [核心注释] 性能碾压 select/poll 的地方:
// 我们不需要遍历所有被监听的 fd,只需要遍历确切发生事件的 ready_num 个 fd。
// revs 数组的前 ready_num 个元素,百分之百都是有效的就绪事件。
for(int i = 0; i < ready_num; i++)
{
uint32_t events = revs[i].events; // 那些事件就绪了
int fd = revs[i].data.fd; // 那一个 fd
// 其实这里是可以不需要判断就绪了的, 但是为了健壮性我们还是判断一下
if(events & EPOLLIN)
{
// 再来判断是 listensockfd 还是 normal sockfd
// [核心注释] 身份路由:通过检查就绪的 fd 是谁,来决定做什么业务
if(fd == _listensockfd->Socketfd())
{
// litensockfd
// [核心注释] 监听套接字就绪,说明底层全连接队列有新的 TCP 连接可以 accept 了
Acceptor();
}
else
{
// normal sockfd
// [核心注释] 普通通信套接字就绪,说明对端发送的数据已经到达了本机的 TCP 接收缓冲区
IOHandler(fd);
}
}
else if(events & EPOLLOUT)
{
// TODO — 大家可以自己扩展
}
}
}
void Acceptor()
{
InetAddr clientaddr;
int sockfd = _listensockfd->Accepter(&clientaddr); // 获取新连接
LOG(LogLevel::INFO) << "sockfd is: " << sockfd << " client addr: " << clientaddr.StringAddress();
// [核心注释] 极其重要:拿到新连接后,绝对不能直接读写!
// 必须立刻将其托付给 epoll 模型,让内核帮你监控它后续的读写动作。
if(sockfd >= 0)
{
struct epoll_event evn;
evn.events = EPOLLIN;
evn.data.fd = sockfd;
// [核心注释] 将新的通信 socket 加入内核的红黑树中
int m = epoll_ctl(_epfd, EPOLL_CTL_ADD, sockfd, &evn);
(void)m;
LOG(LogLevel::INFO) << "epoll_ctl add event: " << sockfd;
}
else
{
LOG(LogLevel::ERROR) << "Accept error…";
}
}
void IOHandler(int fd)
{
// normal fd — 直接读就行了
// [核心注释] 因为是 epoll 通知我们 EPOLLIN 的,所以这里调用 recv 绝对不会阻塞,一定会读到数据或感知到断开。
char inbuffer[1024];
ssize_t n = recv(fd, inbuffer, sizeof(inbuffer) – 1, 0);
if(n > 0)
{
inbuffer[n] = 0;
LOG(LogLevel::INFO) << "client say# " << inbuffer;
// 我们回显回去
std::string echo_string = "echo# ";
echo_string += inbuffer;
send(fd, echo_string.c_str(), echo_string.size(), 0);
}
else if(n == 0)
{
// 对端关闭了
LOG(LogLevel::INFO) << "client quit, epoll_ctl del event: " << fd;
// 要删除fd, 首先这个fd得是合法的, 所以我们close一定是在删除之后执行
// [核心注释] 安全清理双步骤顺序:
// 1. EPOLL_CTL_DEL:将该 fd 的节点从内核红黑树上摘除,并注销底层的回调机制。
// 2. close(fd):归还系统文件描述符资源。如果先 close,fd 失效,epoll_ctl 会报错。
epoll_ctl(_epfd, EPOLL_CTL_DEL, fd, nullptr);
close(fd);
}
else
{
LOG(LogLevel::ERROR) << "recv error…";
// 要删除fd, 首先这个fd得是合法的, 所以我们close一定是在删除之后执行
epoll_ctl(_epfd, EPOLL_CTL_DEL, fd, nullptr);
close(fd);
}
}
private:
uint16_t _port;
std::unique_ptr<Socket> _listensockfd;
// epoll 句柄
int _epfd;
};
#endif
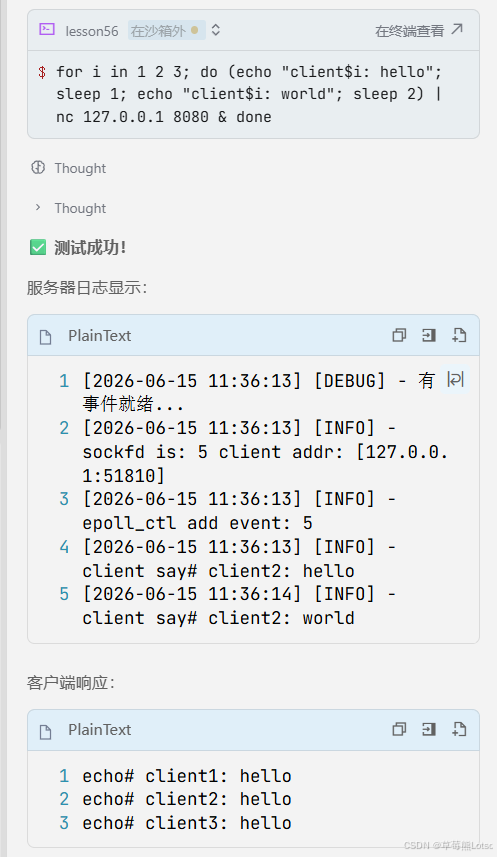
- 多个客户端也没问题
五. 深入:epoll 的两种工作模式 LT vs ET
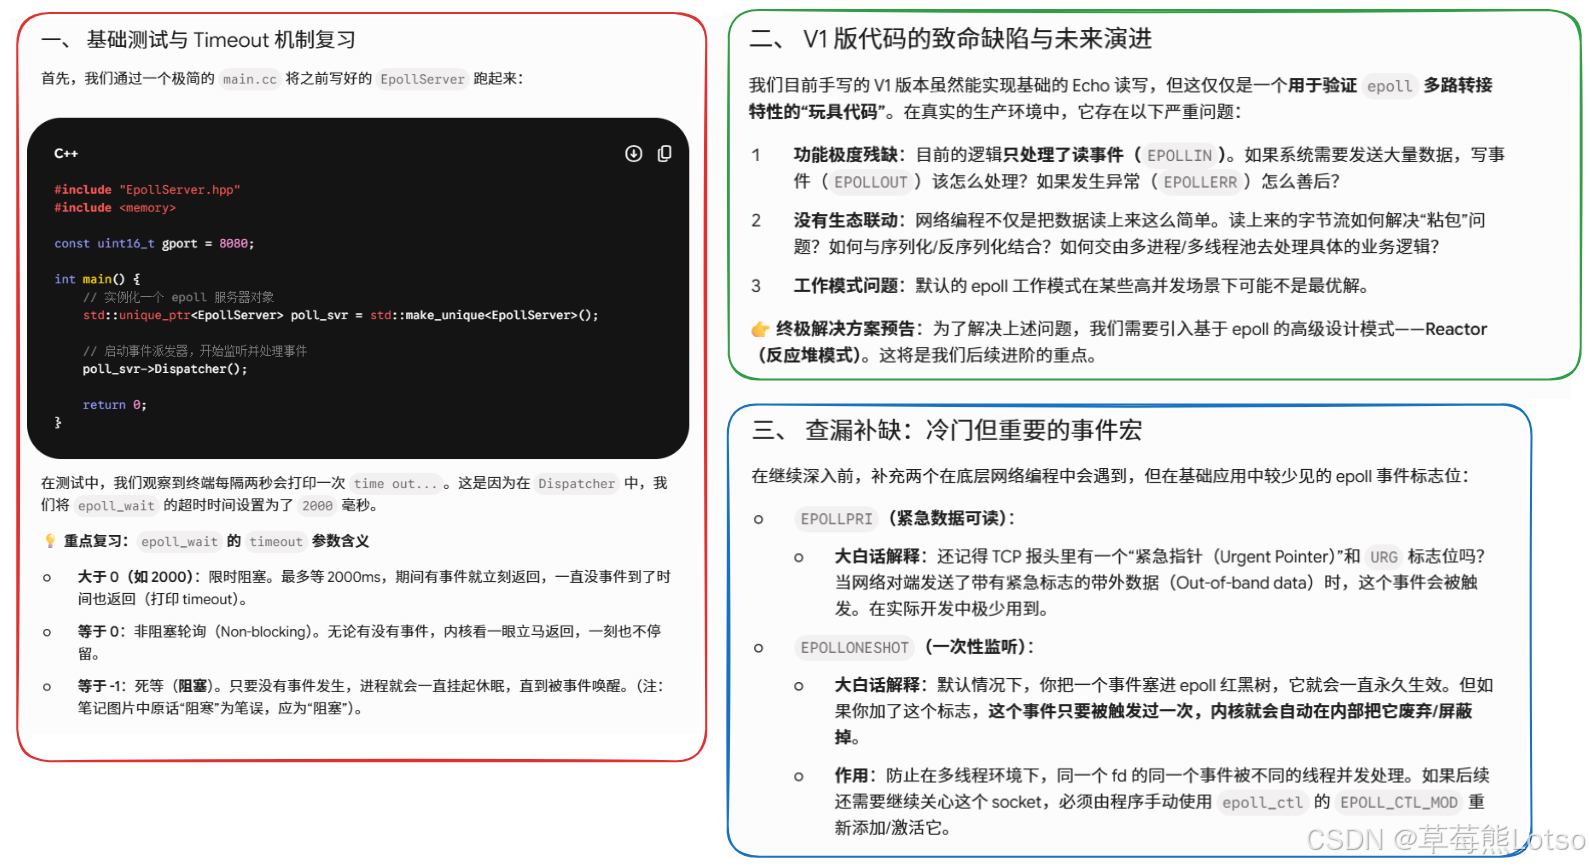
epoll 最经典的面试考点,就是水平触发(LT)和边缘触发(ET)的区别。上面我们实现的代码使用的是 epoll 默认的 LT 模式。
5.1 水平触发(Level Triggered)
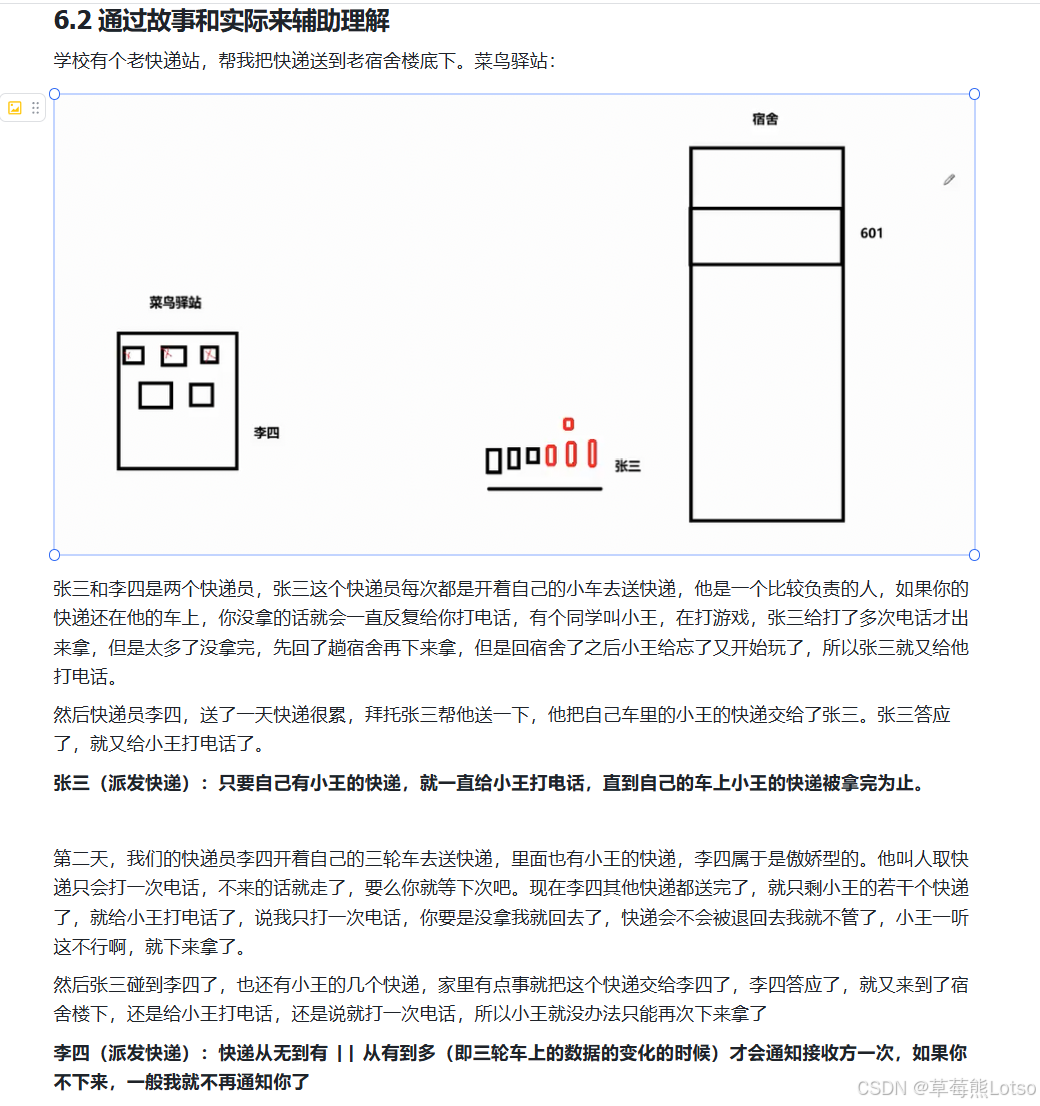
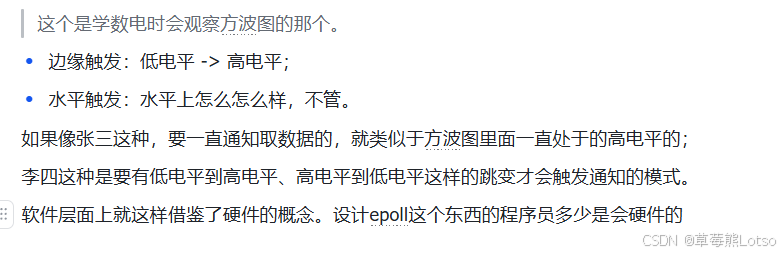
LT 是 epoll 的默认工作模式。它的规则很简单:只要文件描述符的缓冲区里还有未处理的数据,epoll_wait 就会持续通知该事件就绪。
打个通俗的比方:就像妈妈喊你吃饭,你坐在那儿不动,她就会一遍一遍地喊,直到你起身去吃为止。
举个具体例子: 套接字接收缓冲区来了 2KB 数据,epoll 通知可读;你只读了 1KB,缓冲区还剩 1KB。那么下一次调用 epoll_wait 时,它会立刻返回,继续通知这个 fd 可读,直到缓冲区里的数据被全部读完。
LT 模式的特点:
- 编程简单,逻辑直观,不容易出 bug。
- 同时支持阻塞 IO 和非阻塞 IO。
- 缺点是触发次数多,高并发场景下会产生一定的系统调用开销。
5.2 边缘触发(Edge Triggered)
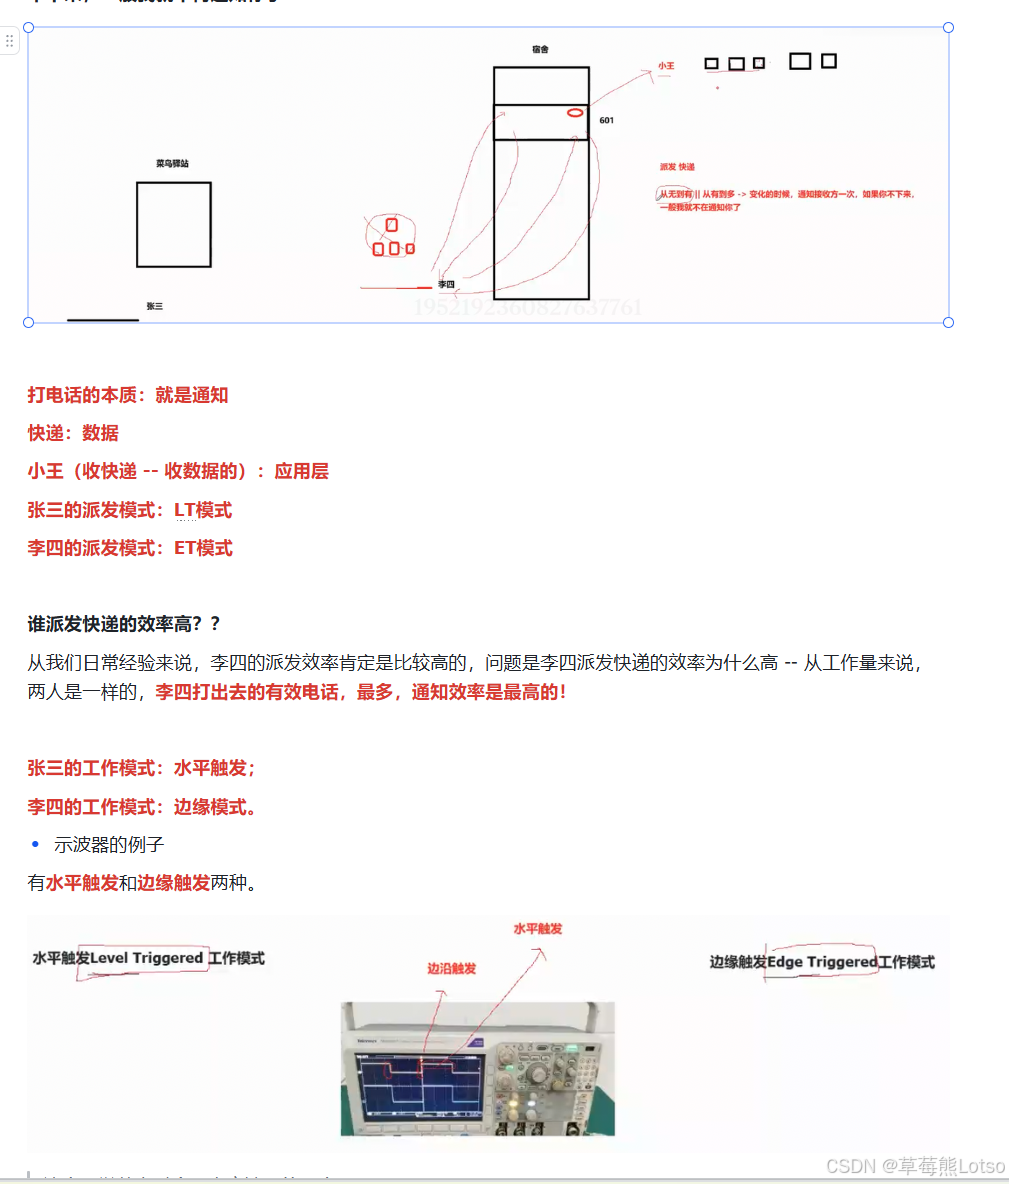
ET 模式需要手动加上EPOLLET标志位才会开启。它的规则是:只有当文件描述符的状态发生变化的那一刻,才通知一次;哪怕缓冲区还有数据没读完,也不会再重复通知,直到下一次新事件到来。
还是那个比方:妈妈只喊你一次,你不来她就再也不喊了,等下一顿饭做好了才会再喊一次。
对应到刚才的例子: 缓冲区来了 2KB 数据,epoll 通知一次可读。如果你只读了 1KB,剩下 1KB 留在缓冲区,接下来调用 epoll_wait 不会再返回这个事件。只有当对方又发送了新数据,状态再次变化时,才会再触发一次通知。
ET 模式的特点:
- 触发次数少,减少了 epoll_wait 的系统调用次数,性能更高。Nginx 默认就采用 ET 模式。
- 编程复杂度高,必须一次性把缓冲区数据读完,否则数据就会留在缓冲区里无法被处理。
- 必须搭配非阻塞 IO 使用。
5.3 为什么 ET 模式必须用非阻塞 IO?
这是面试高频问题,也是工程上的硬性要求。
假设我们用阻塞 IO + ET 模式: 事件就绪后,我们调用 read 循环读取数据,当缓冲区的数据被读完后,阻塞的 read 会一直挂起等待新数据。但 ET 模式下没有新事件就不会再通知,于是整个线程就阻塞在这个 read 上,其他连接的事件都无法得到处理,整个服务器就卡住了。
而用非阻塞 IO + ET 模式: 事件就绪后,我们循环调用 read,一直读到返回 – 1,并且 errno 为EAGAIN或EWOULDBLOCK,这说明缓冲区已经空了,就可以停止读取,转头去处理其他事件。这样既保证了数据全部读完,又不会阻塞事件循环。


5.4 LT 与 ET 对比总结
| 触发规则 | 缓冲区有数据就持续触发 | 仅状态变化时触发一次 |
| 编程难度 | 低,逻辑简单不易出错 | 高,需非阻塞循环读写 |
| 触发次数 | 多 | 少 |
| 系统调用开销 | 相对较高 | 更低 |
| 支持的 IO 类型 | 阻塞 / 非阻塞均可 | 必须非阻塞 |
| 适用场景 | 通用场景,追求代码可靠性 | 高性能场景,追求极致效率 |


5.5 其他补充事件
- EPOLLONESHOT:只监听一次事件,触发后该 fd 就不再被 epoll 监听,需要重新执行 EPOLL_CTL_MOD 注册。常用于多线程场景,防止多个线程同时处理同一个连接的事件。
- EPOLLRDHUP:TCP 连接被对端关闭写半连接时触发,比 EPOLLHUP 更精细,可以用来优雅检测对端关闭。
- EPOLLPRI:紧急数据可读,对应 TCP 的带外数据,实际工程中使用很少。

总结与面试考点梳理
epoll 核心优点
局限性
- Linux 平台特有,跨平台性差,跨平台项目一般使用 libevent、libuv 等库做封装。
- ET 模式编程门槛高,处理不当容易出现数据残留、阻塞等 bug。
- 短连接、少量连接的场景下,epoll 的优势不明显,甚至因为初始化开销而不如 select。
高频面试考点
结尾:
🍓 我是草莓熊 Lotso!若这篇技术干货帮你打通了学习中的卡点:
👀 【关注】跟我一起深耕技术领域,从基础到进阶,见证每一次成长
❤️ 【点赞】让优质内容被更多人看见,让知识传递更有力量
⭐ 【收藏】把核心知识点、实战技巧存好,需要时直接查、随时用
💬 【评论】分享你的经验或疑问(比如曾踩过的技术坑?),一起交流避坑
🗳️ 【投票】用你的选择助力社区内容方向,告诉大家哪个技术点最该重点拆解
技术之路难免有困惑,但同行的人会让前进更有方向~愿我们都能在自己专注的领域里,一步步靠近心中的技术目标!
结语:epoll 是 Linux 高性能网络编程的基石,也是后端开发必须吃透的知识点。它用红黑树管理连接、用回调机制响应事件、用就绪队列交付结果,这套设计思想不仅造就了 epoll 本身的高性能,也影响了后续很多事件驱动框架的设计。这篇文章里我们实现的还只是一个最基础的 LT 模式回显服务器,真实的工业级服务器还会在此基础上引入 Reactor 反应堆模式、线程池、序列化协议、异常处理等机制。但万变不离其宗,epoll 的核心逻辑永远是那棵红黑树、那条就绪队列,和那三个系统调用。如果觉得有帮助,不妨动手编译代码跑一跑,再试着把它改成 ET 模式,亲手踩一遍非阻塞循环读写的坑,对 epoll 的理解会更深刻。
✨把这些内容吃透超牛的!放松下吧✨
ʕ˘ᴥ˘ʔ
づきらど