◆ 博主名称: 小此方-CSDN博客
大家好,欢迎来到小此方的博客。
⭐️网络系列个人专栏:
【项目】C++AI大模型接入SDK
⭐️此方的GitHub:
github_此方
⭐️
我们思考 (Rethink) · 我们重建 (Rebuild) · 我们记录 (Record)
文章目录
- 概要&序論
- 一、C++大模型接入SDK项目的整体架构
-
- 1.1 应用层与服务端角色定义
- 1.2 ChatSDK核心架构设计
-
- 1.2.1 核心业务层:LLMManager与多模型Provider扩展
- 1.2.2 核心业务层:SessionManager会话管理
- 1.2.3 数据存储层:基于SQLite的会话持久化
- 1.2.4 三方服务层:云端与本地大模型集成
- Tips:聊一聊C++在AI领域能做什么
- 二、封装第三方日志库Spdlog
-
- 2.1 日志的作用与常见输出位置
- 2.2 Spdlog 的日志级别定义与顺序
- 2.3源码参考
-
- 2.3.1小细节讲解
-
- 1. format语法中的 **{}**
- 2. **{:>10}** 与 **{: <4}** 的格式化含义
- 3. **__FILE__**、**__LINE__** 与 **##__VA_ARGS__**
- 三、构建基础数据结构
-
- 2.3源码参考
概要&序論
Hello大家好,我是此方。Linux网络正在更新中,我们从本文开始,本专栏将开始介绍“C++大模型接入SDK”,本文开始,我们正式开始写这么一个代码,但是在讲之前还得先整体了解一下架构,补充一点前置知识。,我们开始吧。
一、C++大模型接入SDK项目的整体架构
1.1 应用层与服务端角色定义
位于整个架构最顶层的是应用层。主要包含了基于ChatSDK实现的智能聊天助手服务——ChatServer。
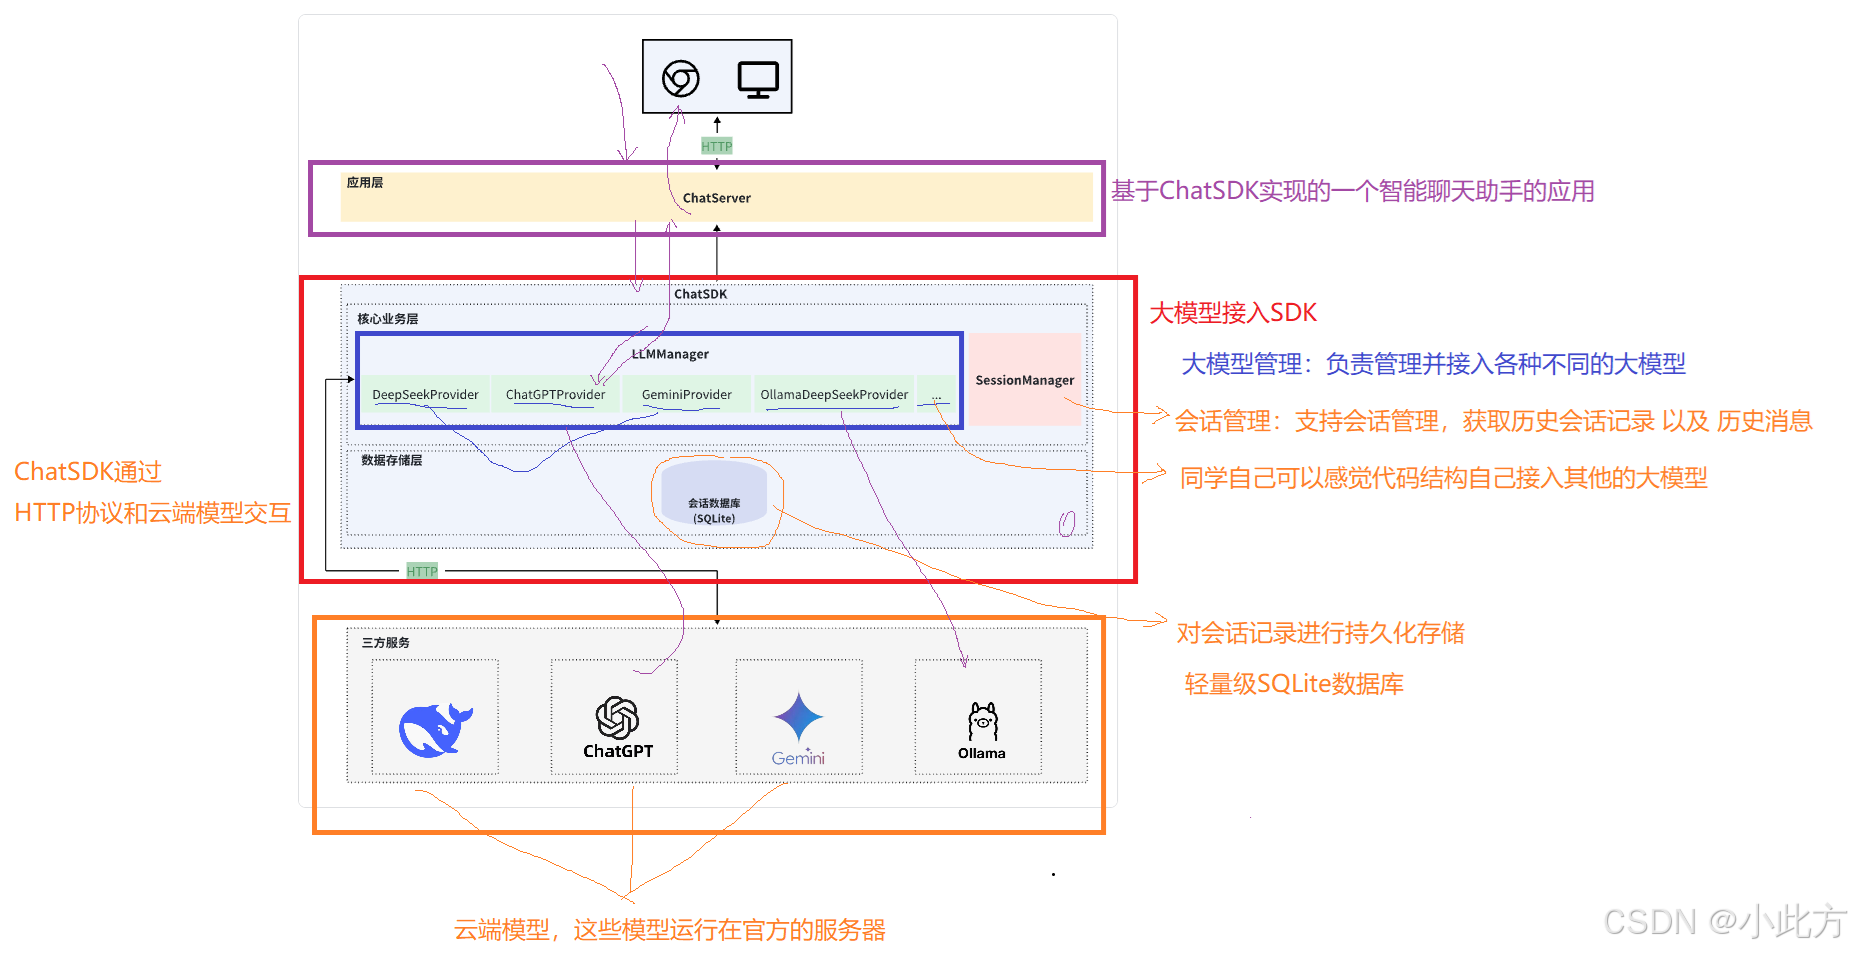
ChatServer作为一个具体的业务应用,负责向上对接终端设备(如浏览器Web端或桌面客户端设备),通过标准HTTP协议接收用户的输入请求并返回处理后的响应。
1.2 ChatSDK核心架构设计
ChatSDK是整个架构的核心部分,负责屏蔽底层不同大模型厂商的接口差异,向应用层提供统一、规范的接入抽象。从内部结构来看,ChatSDK主要分为核心业务层与数据存储层。 ChatSDK通过HTTP协议与外部云端模型或本地服务进行交互,其内部模块的职责划分如下:
1.2.1 核心业务层:LLMManager与多模型Provider扩展
核心业务层负责具体的模型管理与会话状态控制,其中包含两个核心组件:
- DeepSeekProvider:负责对接DeepSeek官方云端服务。
- ChatGPTProvider:负责对接OpenAI ChatGPT云端服务。
- GeminiProvider:负责对接Google Gemini云端服务。
- OllamaDeepSeekProvider:负责对接本地基于Ollama部署的DeepSeek等私有化模型。
- 其他扩展Provider(…):框架具备良好的扩展性,开发者可以参考现有代码结构非常方便地接入其他自定义的大模型。
1.2.2 核心业务层:SessionManager会话管理
在处理大模型交互时,上下文与历史消息的管理至关重要。核心业务层中的 SessionManager 模块专门负责支持完整的会话管理机制,主要承担以下职责:
1.2.3 数据存储层:基于SQLite的会话持久化
在ChatSDK的底层设计中,包含了一个独立的数据存储层。为了保证SDK的轻量化与开箱即用特性,数据存储层采用了轻量级内嵌式数据库 SQLite。 通过数据存储层中的会话数据库(SQLite),ChatSDK能够对用户的对话记录进行本地化持久化存储。无论是在应用重启还是会话切换时,SessionManager均可通过数据存储层快速调取与更新历史记录,极大提升了会话连续性与数据可靠性。
1.2.4 三方服务层:云端与本地大模型集成
最下层为三方服务层,代表真实的底层大模型算力来源。ChatSDK通过标准HTTP协议与这些三方服务进行通信:
Tips:聊一聊C++在AI领域能做什么
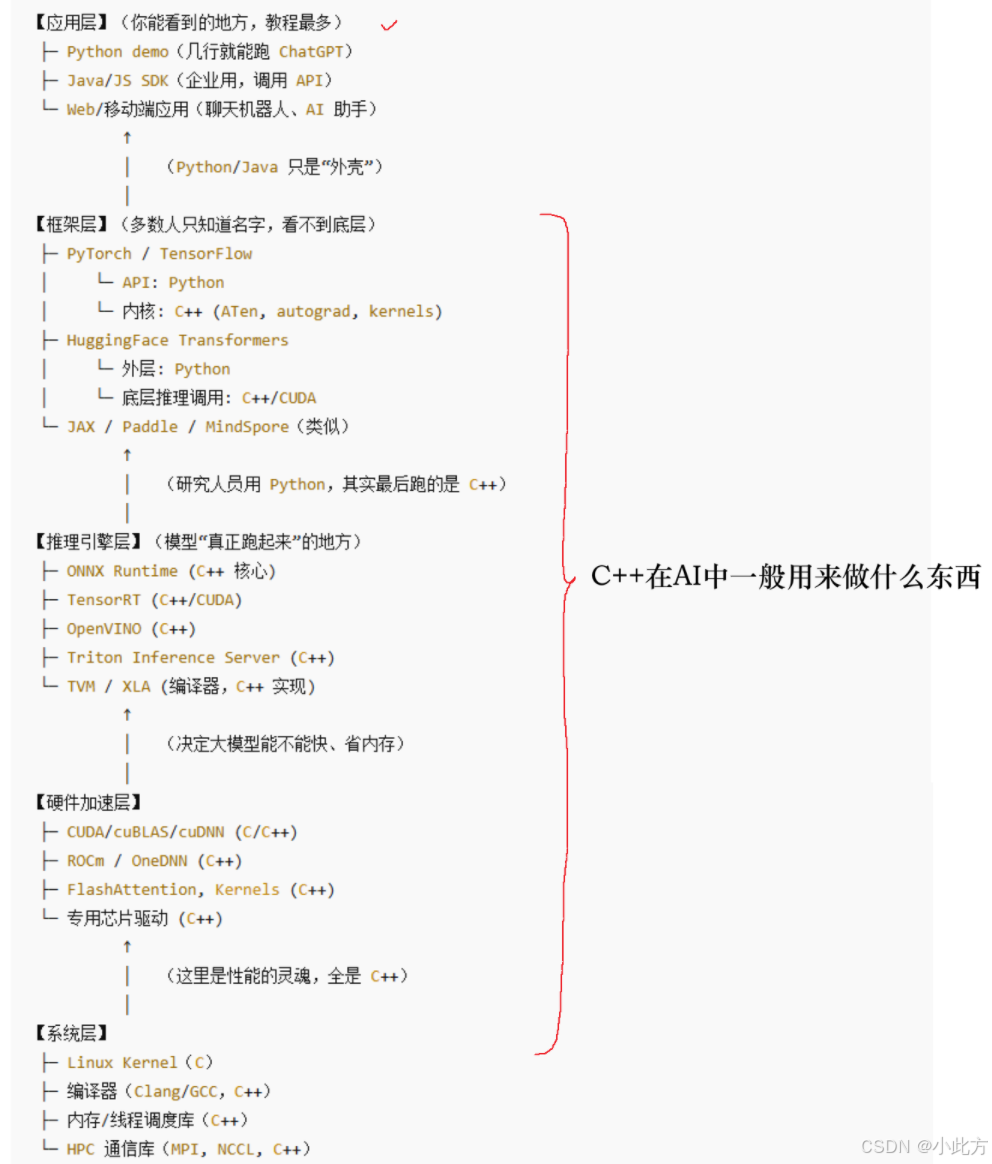
很多开发者提到AI开发,第一反应往往是Python,甚至认为AI领域是Python一统天下。然而在实际工业级落地与高性能工程实践中,C++依然占据着不可替代的核心地位。
二、封装第三方日志库Spdlog
我以前写过一个原生的日志类,但是我们这次的项目不会再去写这玩意儿,直接用现成开源的一个库Spdlog。,但是为了提升易用性,我们得封装一下。
SpdLog的使用讲解我想放在未来的脚手架部分讲解。
2.1 日志的作用与常见输出位置
日志是程序在运行过程中记录的重要信息,主要方便开发者、测试人员和运维人员了解程序运行时发生了什么事情。 在实际的项目开发中,通常会将日志信息写入到控制台、文件或远程服务器中。
2.2 Spdlog 的日志级别定义与顺序
Spdlog 提供了丰富的日志级别划分,帮助我们在不同开发阶段和生产环境中灵活控制日志输出粒度。常见的日志级别从小到大排序依次为:
TRACE < DEBUG < INFO < WARN < ERROR < CRITICAL
不同级别的详细说明如下:
2.3源码参考
我接下来所有的代码都会放在这个仓库里,仓库正在建设中!Readme还没有写,请见谅!CPlusPlus_LLM_SDK
2.3.1小细节讲解
别的问题不大,这里对我封装的宏提一嘴:
#define TRACE(format, ...) SpdLogPack::GetSpdLog()->trace(std::string("[{:>10}][{:<4}]")+format,__FILE__,__LINE__,##__VA_ARGS__);
#define DEBUG(format, ...) SpdLogPack::GetSpdLog()->debug(std::string("[{:>10}][{:<4}]")+format,__FILE__,__LINE__,##__VA_ARGS__);
#define INFO(format, ...) SpdLogPack::GetSpdLog()->info(std::string("[{:>10}][{:<4}]")+format,__FILE__,__LINE__,##__VA_ARGS__);
#define WARNING(format, ...) SpdLogPack::GetSpdLog()->warn(std::string("[{:>10}][{:<4}]")+format,__FILE__,__LINE__,##__VA_ARGS__);
#define ERROR(format, ...) SpdLogPack::GetSpdLog()->err(std::string("[{:>10}][{:<4}]")+format,__FILE__,__LINE__,##__VA_ARGS__);
#define CRITICAL(format, ...) SpdLogPack::GetSpdLog()->critical(std::string("[{:>10}][{:<4}]")+format,__FILE__,__LINE__,##__VA_ARGS__);
1. format语法中的 {}
大括号 {} 是 C++20 std::format 以及 fmt 库的核心占位符语法,用于指代后续传入参数需要被格式化输出的具体位置。
2. {:>10} 与 {: <4} 的格式化含义
这两个格式化指令用于规范日志中文件名与行号的对齐样式:
- {:>10} 表示右对齐,最小显示宽度为 10 个字符,不足则在左侧补空格,通常用来保持文件名对齐。
- {: <4} 表示左对齐,最小显示宽度为 4 个字符,不足则在右侧补空格,通常用来保持代码行号对齐。
3. FILE、LINE 与 ##VA_ARGS
这三个预定义宏和编译器特性用于捕获代码位置与处理可变参数:
- FILE 是 C++ 预定义宏,在预编译阶段自动展开为当前源码文件的名称字符串。
- LINE 是 C++ 预定义宏,在预编译阶段自动展开为当前代码行号的整数。
- ##VA_ARGS 表示接收宏定义的变参列表,前面的 ## 运算符用于在可变参数为空时自动消除多余的逗号,防止编译报错。
三、构建基础数据结构
2.3源码参考
问题不大,不讲。CPlusPlus_LLM_SDK/Include /CommonStruct.h
好的本期内容就到这里,如果对你有帮助,还不要忘记点赞三联支持。我是此方,我们下期再见。bye!