一、量化技术详解
1.1 什么是量化?
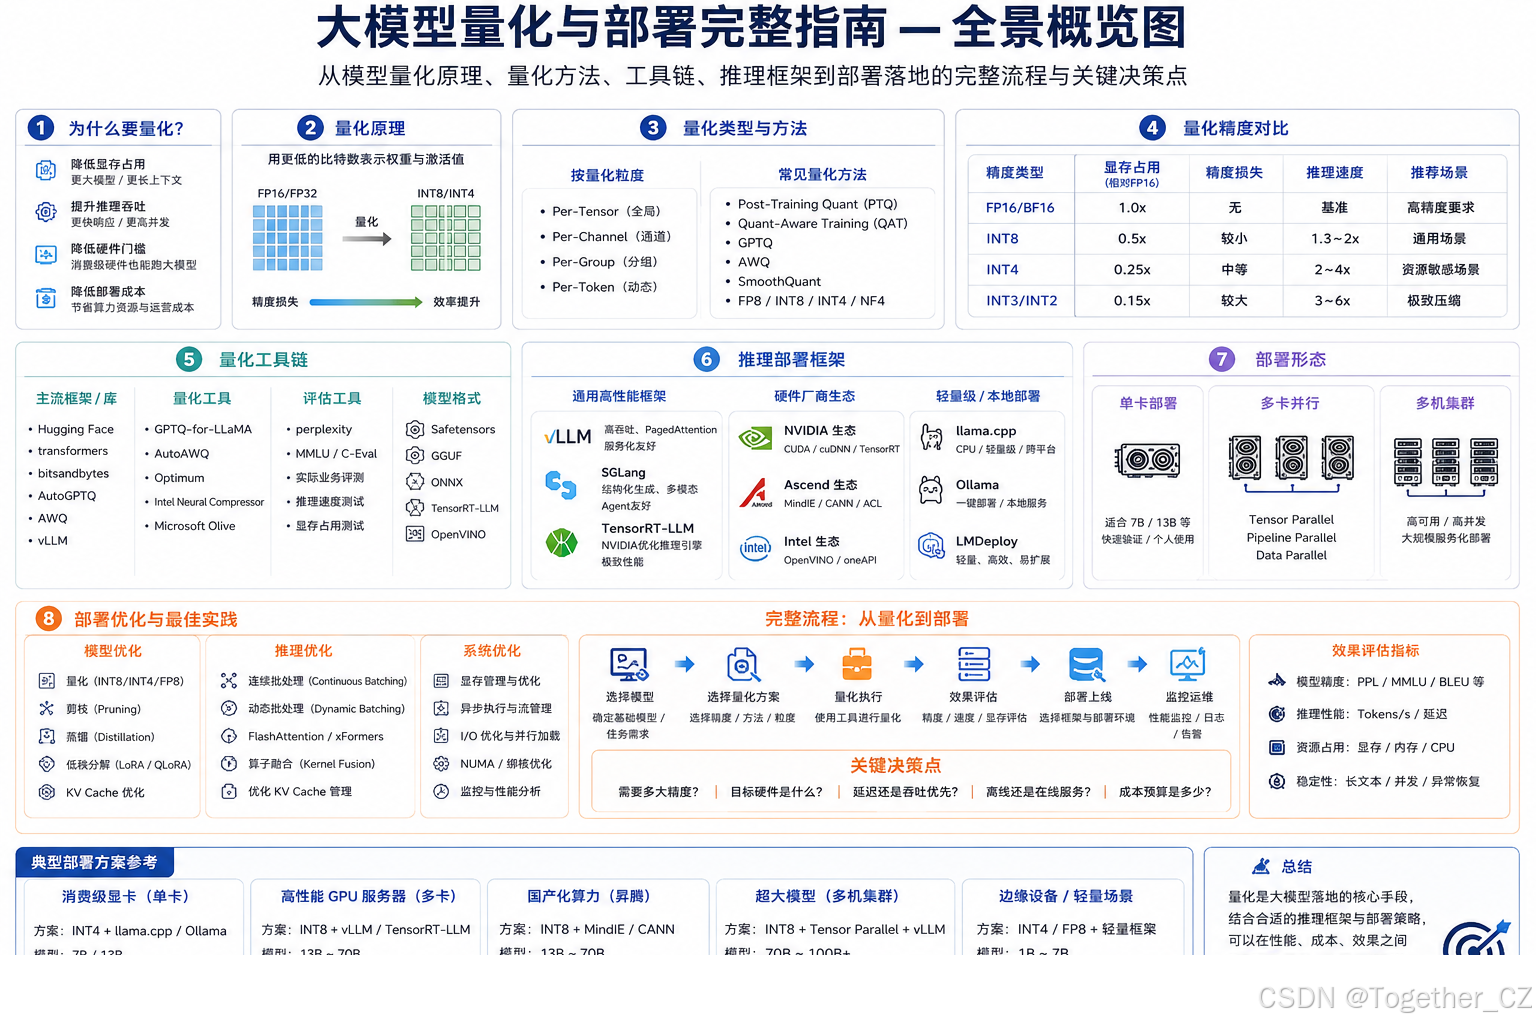
量化(Quantization)是将深度学习模型的权重从高精度浮点数转换为低精度数字的表示过程,从而减少内存使用、提高推理速度。
1.1.1 为什么需要量化?
传统训练精度(FP32)的问题:
- 32位浮点数表示范围:-3.4×10³⁸ 到 +3.4×10³⁸
- 每个权重需要占用 4 字节
- 对于 7B 参数模型:7×10⁹ × 4B = 28GB
量化后的优势:
- 16位浮点数(FP16):每个权重 2 字节
- 8位整数(INT8):每个权重 1 字节
- 4位整数(INT4):每个权重 0.5 字节
关键发现(GPT-2论文):
“The majority of the weights in the model were less than 1 in magnitude”
“We observed that the majority of the weights in the model were less than 1 in magnitude”
这意味着大多数权重值集中在 -1 到 1 之间,对于低精度表示足够友好。
1.1.2 量化精度对比
| FP32 | 32位 | 28 GB | 52 GB | 280 GB |
| BF16/FP16 | 16位 | 14 GB | 26 GB | 140 GB |
| INT8 | 8位 | 7 GB | 13 GB | 70 GB |
| INT4 | 4位 | 3.5 GB | 6.5 GB | 35 GB |
1.2 主要量化技术详解
1.2.1 GPTQ(Generative Pretrained Transformer Quantized)
开发者:FRAPPE Lab at UC San Diego
核心思想:
GPTQ 是一种基于二阶泰勒展开的逐层量化算法,它利用Hessian矩阵信息来估计量化误差,并最小化量化对模型输出的影响。
数学原理:
对于每个权重 w_i,量化后的权重 w_q 为:
w_q = round(w_i / s) × s – z
其中:
– s 是缩放因子(scale)
– z 是零偏(zero point)
– round() 表示取整操作
量化误差最小化目标:
min Σ_i ||w_i – w_q_i||²
GPTQ的工作流程:
优点:
- 量化质量高,通常INT4量化后精度损失<1%
- 推理时无需特殊硬件支持
- 支持动态batch size
缺点:
- 量化过程慢(需要Hessian矩阵计算)
- 7B模型量化需要约10-20GB内存
典型量化质量(Pythia模型):
| FP16 | 0.732 | 0.644 | 0.531 | 0.456 | 0.406 |
| GPTQ-INT4 | 0.734 | 0.645 | 0.522 | 0.448 | 0.390 |
| GPTQ-INT8 | 0.733 | 0.644 | 0.531 | 0.453 | 0.405 |
1.2.2 AWQ(Activation-Aware Quantization)
开发者:UW Miller Lab
核心思想:
AWQ 认为"并非所有权重都同等重要",通过分析激活值(activation)的重要性,识别出对模型输出影响较小的权重,对这些权重进行更激进的量化。
AWQ的量化策略:
1. 计算每个权重的"重要性分数":
importance(w_i) = |w_i| × |activation_i|
2. 根据重要性分数,将权重分为三组:
– 重要权重:保持较高精度(如FP16)
– 一般权重:中等精度(如INT8)
– 不重要权重:低精度(如INT4)
3. 对每组权重应用不同的量化参数
AWQ的优势:
- 精度保持更好:AWQ-4Bit > GPTQ-4Bit
- 量化速度快于GPTQ
- 特别适合LLM(大语言模型)
AWQ的局限性:
- 仅适用于LLM,不适用于CNN等模型
- 量化过程仍需GPU支持
- 需要原始权重进行量化
1.2.3 ExLlamaV2 / ExLlama
开发者:turboderf
核心思想:
ExLlamaV2 是一种高效的LLM推理引擎,专门针对量化模型进行了优化。它不仅实现了量化,还优化了推理过程。
ExLlamaV2的核心特性:
量化格式支持:
- GPTQ格式(INT4/INT8)
- AWQ格式(INT4)
- 支持混合精度量化
性能特点:
- 推理速度比标准实现快2-3倍
- 内存占用减少50-70%
- 支持高并发推理
适用场景:
- 需要高吞吐量的生产环境
- 资源受限的边缘设备
- 需要低延迟的实时应用
1.2.4 GGUF/GGML
开发者:ggml (TheBloke等社区维护)
核心思想:
GGUF(GGML格式的后继者)是一种跨平台的量化格式,旨在实现"一次量化,到处运行"。
GGUF的核心特性:
常见量化预设:
| Q4_0 | INT4 | 最低精度,最小内存 | ~3.8 GB |
| Q4_1 | INT4+FP16混合 | 平衡精度和内存 | ~4.1 GB |
| Q5_0 | INT5 | 较高精度 | ~4.5 GB |
| Q5_1 | INT5+FP16混合 | 高保真度 | ~4.8 GB |
| Q8_0 | INT8 | 高精度 | ~7.5 GB |
GGUF的优势:
- 支持纯CPU推理,无需GPU
- 丰富的预量化模型(HuggingFace上有大量社区模型)
- 兼容多种推理框架(llama.cpp、Ollama等)
GGUF的劣势:
- 推理速度通常慢于GPU原生量化
- 精度损失相对较大(尤其是Q4_0)
1.3 量化格式对比总结
| 开发者 | UCSD | UW Miller | turboderf | ggml社区 |
| 适用模型 | CNN+LLM | LLM | LLM | LLM |
| 量化精度 | INT4/INT8 | INT4 | INT4/INT8 | Q4_Q8 |
| 量化质量 | 高 | 很高 | 高 | 中等 |
| 量化速度 | 慢 | 中等 | 中等 | 快 |
| 推理速度 | 快 | 快 | 很快 | 中等 |
| 硬件要求 | GPU | GPU | GPU | CPU/GPU |
| 跨平台 | 否 | 否 | 否 | 是 |
| 典型应用 | 生产环境 | 生产环境 | 高吞吐场景 | 本地/边缘 |
二、部署硬件平台详解
2.1 NVIDIA GPU平台
2.1.1 高性能GPU(数据中心级)
NVIDIA A100(第八代Tensor Core GPU)
基本规格:
- GPU显存:80 GB HBM2e
- Tensor Core:第三代
- FP64性能:19.5 TFLOPS
- TF32性能:156 TFLOPS
- BF16/FP16性能:312 TFLOPS
- INT8性能:624 TOPS
- INT4性能:1248 TOPS
- 功耗:400W(SXM)/ 300W(PCIe)
部署场景:
- 大模型推理(7B-70B+参数)
- 多模型并发
- 大规模训练
推理性能估算(7B模型,INT8量化):
- 内存占用:约7 GB
- 推理速度:约200-400 tokens/s
- 支持并发:20-50个并发用户
NVIDIA H100(Hopper架构)
基本规格:
- GPU显存:80 GB HBM3
- Tensor Core:第四代
- FP64性能:67 TFLOPS
- TF32性能:989 TFLOPS
- BF16/FP16性能:1979 TFLOPS
- INT8性能:3958 TOPS
- INT4性能:7916 TOPS
- 功耗:700W(SXM)/ 350W(PCIe)
部署场景:
- 超大模型推理(70B+参数)
- 高吞吐生产环境
- 前沿模型部署
推理性能估算(7B模型,INT8量化):
- 内存占用:约7 GB
- 推理速度:约400-800 tokens/s
- 支持并发:50-100+个并发用户
2.1.2 消费级GPU
NVIDIA RTX 4090(Ada Lovelace架构)
基本规格:
- GPU显存:24 GB GDDR6X
- Tensor Core:第四代
- FP16性能:82.6 TFLOPS
- INT8性能:330 TOPS
- INT4性能:660 TOPS
- 功耗:450W
- 价格:约¥12,000-15,000
部署场景:
- 中小型模型推理(7B-13B参数)
- 个人/小团队部署
- 开发测试
推理性能估算(7B模型,INT4量化):
- 内存占用:约4 GB(INT4量化后)
- 推理速度:约150-250 tokens/s
- 支持并发:5-15个并发用户
推理性能估算(13B模型,INT4量化):
- 内存占用:约7 GB
- 推理速度:约80-150 tokens/s
- 支持并发:3-8个并发用户
注意:
- RTX 4090不支持NVLink,多卡互联需要PCIe
- 24GB显存限制了可同时加载的模型大小
- 对于70B模型,需要多卡或更低精度量化
NVIDIA RTX 5090(Blackwell架构,预计2024年底发布)
预期规格:
- GPU显存:32 GB GDDR7
- Tensor Core:第五代
- FP16性能:预计150+ TFLOPS
- INT8性能:预计600+ TOPS
- 功耗:预计600W
- 价格:预计¥18,000-22,000
预期部署能力:
- 7B模型(INT4):约300-500 tokens/s
- 13B模型(INT4):约150-250 tokens/s
- 32GB显存支持加载更大模型
消费级GPU与数据中心级GPU对比:
| 显存 | 24 GB | 80 GB | 80 GB |
| 显存类型 | GDDR6X | HBM2e | HBM3 |
| FP16性能 | 82.6 TFLOPS | 312 TFLOPS | 1979 TFLOPS |
| INT8性能 | 330 TOPS | 624 TOPS | 3958 TOPS |
| 多卡支持 | PCIe | NVLink/PCIe | NVLink |
| 典型价格 | ¥12,000 | ¥150,000+ | ¥250,000+ |
| 适用模型 | 7B-13B | 7B-70B+ | 70B+ |
| 并发能力 | 低 | 高 | 很高 |
2.2 AMD GPU平台
AMD Instinct MI300X
基本规格:
- GPU显存:192 GB HBM3
- FP16性能:约1315 TFLOPS
- INT8性能:约2630 TOPS
- 功耗:750W
优势:
- 超大显存,支持加载超大模型
- 性价比高(相比NVIDIA)
- ROCm生态逐步成熟
劣势:
- 软件生态不如NVIDIA完善
- 部分框架兼容性有待提升
消费级AMD GPU(如RX 7900 XTX)
基本规格:
- GPU显存:24 GB GDDR6
- FP16性能:约122 TFLOPS
- 功耗:355W
部署能力:
- 7B模型(INT4):约100-180 tokens/s
- 13B模型(INT4):约50-100 tokens/s
注意:
- 消费级AMD GPU的量化支持不如NVIDIA成熟
- 需要额外的优化工作
2.3 Intel平台
Intel Xeon处理器
特点:
- 基于x86架构
- 支持AVX-512指令集
- 适合CPU推理
部署场景:
- 低延迟CPU推理
- 作为GPU的补充
- 边缘部署
性能参考:
- 7B模型(INT8量化):约20-50 tokens/s
- 适合低并发场景
Intel Data Center GPU(如Ponte Vecchio)
基本规格:
- GPU显存:96 GB HBM2e
- FP16性能:约100+ TFLOPS
- 支持ONEAPI生态
部署能力:
- 7B模型(INT8量化):约100-200 tokens/s
- 适合Intel生态部署
2.4 Apple Silicon
Apple M系列芯片(如M1/M2/M3 Max/Ultra)
特点:
- 统一内存架构
- 支持Metal Performance Shaders
- 能效比高
部署场景:
- 本地开发测试
- 轻量级部署
- 创意工作者
性能参考(M1 Ultra,128GB统一内存):
- 7B模型(INT4量化):约50-100 tokens/s
- 13B模型(INT4量化):约20-40 tokens/s
优势:
- 内存带宽高(约2000 GB/s)
- 低功耗
- 静音设计
劣势:
- 绝对性能不如高端GPU
- 生态支持有限
2.5 国产化平台
2.5.1 华为昇腾(Ascend)
华为昇腾910B(当前主力)
基本规格:
- AI算力:355 TFLOPS(FP16)
- 内存:32 GB HBM2
- 功耗:310W
- 支持ATC/ACL推理框架
部署场景:
- 全国产化部署
- 政府/国企项目
- 信创项目
推理性能:
- 7B模型(INT8量化):约100-200 tokens/s
- 支持CANN软件栈
注意事项:
- 需要适配华为MindSpore或昇腾AI推理框架
- 模型需要转换为昇腾支持格式(OM模型)
- 工具链相对封闭
华为昇腾310P(边缘/端侧)
基本规格:
- AI算力:32 TFLOPS(FP16)
- 内存:8 GB LPDDR4
- 功耗:20W
- 支持轻量级部署
部署场景:
- 边缘设备
- 低功耗应用
- 端侧推理
性能参考:
- 1B-3B小模型:约20-50 tokens/s
- 适合轻量级应用
2.5.2 其他国产AI芯片
寒武纪思元590
- AI算力:256 TFLOPS
- 内存:32 GB HBM2
- 适用场景:数据中心
海光DCU
- 兼容CUDA生态
- AI算力:约200 TFLOPS
- 适用场景:科学计算、AI推理
天数智芯
- 独立GPU
- 内存:32 GB GDDR6
- 适用场景:云端推理
三、不同部署模式详解
3.1 全GPU部署
3.1.1 适用场景
- 模型完全加载到GPU显存中
- 推理速度最快
- 需要充足显存
3.1.2 资源需求
- 7B模型(FP16):需要至少15 GB显存
- 7B模型(INT8量化):需要至少8 GB显存
- 7B模型(INT4量化):需要至少5 GB显存
- 13B模型(FP16):需要至少30 GB显存
- 70B模型(FP16):需要至少160 GB显存
3.1.3 推荐硬件
- 单卡RTX 4090(7B-13B,INT4量化)
- 双卡A100(70B模型)
- 多卡H100(70B+模型,高并发)
3.2 CPU+GPU混合部署
3.2.1 适用场景
- GPU显存不足以加载整个模型
- 需要平衡性能和成本
- 大模型在GPU,小模型在CPU
3.2.2 部署策略
分层部署:
- GPU层:处理核心计算密集型操作
- CPU层:处理数据预处理和后处理
模型并行:
- 部分层在GPU上运行
- 部分层在CPU上运行
- 需要优化层间数据传输
批处理优化:
- 在CPU上进行批量预处理
- 在GPU上进行推理
- 在CPU上进行后处理
3.2.3 性能影响
- 数据传输延迟:PCIe带宽限制(约32 GB/s)
- 需要优化数据传输效率
- 适合中等负载场景
3.3 纯CPU部署
3.3.1 适用场景
- 没有GPU资源
- 低并发需求
- 成本敏感场景
3.3.2 部署策略
量化优化:
- 必须使用INT8或INT4量化
- 模型大小减半到四分之一
内存优化:
- 使用大内存(64GB+)
- 启用内存分页
多线程优化:
- 利用多核CPU并行计算
- 优化线程调度
3.3.3 性能参考
- 7B模型(INT8量化):约20-50 tokens/s
- 适合个人使用或低并发场景
3.4 国产化部署
3.4.1 部署架构
┌─────────────────────────────────────┐
│ 应用层(Web API) │
├─────────────────────────────────────┤
│ 昇腾推理框架(CANN/ACL) │
├─────────────────────────────────────┤
│ 模型转换工具(ATC) │
├─────────────────────────────────────┤
│ 昇腾AI芯片(910B/310P) │
└─────────────────────────────────────┘
3.4.2 部署步骤
模型转换:
- 将PyTorch/TF模型转换为昇腾支持格式
- 使用ATC工具进行模型转换
- 生成OM模型文件
环境配置:
- 安装CANN软件栈
- 配置驱动和固件
- 设置环境变量
推理部署:
- 加载OM模型
- 初始化推理上下文
- 执行推理请求
优化调优:
- 调整批次大小
- 优化内存使用
- 调优计算图
3.4.3 注意事项
- 模型需要重新适配
- 工具链相对封闭
- 生态完善度不如NVIDIA
- 需要华为技术支持
四、详细资源计算示例
4.1 示例1:7B模型部署(RTX 4090)
模型:LLaMA 7B
量化方式:INT4(GPTQ)
硬件:NVIDIA RTX 4090(24GB显存)
资源计算:
1. 模型权重内存:
7×10⁹ 参数 × 0.5 字节/参数(INT4) = 3.5 GB
2. KV Cache内存:
假设128个序列长度,batch_size=4
每层KV Cache ≈ 2 × 128 × 7×10⁹/(2×32) × 2 字节
= 约 1 GB(简化计算)
3. 激活值内存:
batch_size=4,序列长度=128
约 0.5 GB
4. 总显存占用:
3.5 + 1 + 0.5 = 5 GB
5. 可用显存(用于并发):
24 – 5 = 19 GB
支持约15个并发用户
推理性能:
- 推理速度:约150-250 tokens/s
- 延迟:约10-20 ms/token
- 并发:15个用户
4.2 示例2:13B模型部署(双卡A100)
模型:LLaMA 13B
量化方式:INT8(GPTQ)
硬件:2× NVIDIA A100(80GB显存,NVLink)
资源计算:
1. 模型权重内存:
13×10⁹ 参数 × 1 字节/参数(INT8) = 13 GB
2. KV Cache内存:
batch_size=8,序列长度=256
约 4 GB
3. 激活值内存:
约 2 GB
4. 总显存占用:
13 + 4 + 2 = 19 GB(每张卡约9.5 GB)
5. 支持并发:
50-100个用户
推理性能:
- 推理速度:约200-400 tokens/s
- 延迟:约5-15 ms/token
- 并发:100个用户
4.3 示例3:70B模型部署(全GPU)
模型:LLaMA 70B
量化方式:INT4(GPTQ)
硬件:4× NVIDIA A100(80GB显存,NVLink)
资源计算:
1. 模型权重内存:
70×10⁹ 参数 × 0.5 字节/参数(INT4) = 35 GB
2. KV Cache内存:
batch_size=4,序列长度=512
约 8 GB
3. 激活值内存:
约 4 GB
4. 总显存占用:
35 + 8 + 4 = 47 GB(每张卡约11.75 GB)
5. 支持并发:
20-40个用户
推理性能:
- 推理速度:约100-200 tokens/s
- 延迟:约15-30 ms/token
- 并发:40个用户
4.4 示例4:7B模型部署(华为昇腾910B)
模型:ChatGLM-6B
量化方式:INT8(华为格式)
硬件:华为昇腾910B(32GB显存)
资源计算:
1. 模型权重内存:
6×10⁹ 参数 × 1 字节/参数(INT8) = 6 GB
2. KV Cache内存:
batch_size=8,序列长度=256
约 3 GB
3. 激活值内存:
约 1 GB
4. 总显存占用:
6 + 3 + 1 = 10 GB
5. 支持并发:
30-60个用户
推理性能:
- 推理速度:约100-200 tokens/s
- 延迟:约10-25 ms/token
- 并发:60个用户
五、实际部署案例
5.1 案例1:个人开发者部署7B模型
场景:
- 用户:个人开发者
- 硬件:RTX 4090(24GB)
- 模型:LLaMA 7B(INT4量化)
部署方案:
性能:
- 推理速度:150-250 tokens/s
- 显存占用:5 GB
- 功耗:150W
成本:
- 硬件:¥12,000(GPU)
- 电费:约¥200/月
5.2 案例2:中小企业部署13B模型
场景:
- 用户:中小企业
- 硬件:2× RTX 4090(48GB总显存)
- 模型:LLaMA 13B(INT4量化)
部署方案:
性能:
- 推理速度:100-200 tokens/s
- 显存占用:8 GB/卡
- 支持并发:20-30用户
成本:
- 硬件:¥24,000(2×GPU)
- 电费:约¥400/月
5.3 案例3:大型企业部署70B模型
场景:
- 用户:大型企业
- 硬件:4× A100(320GB总显存)
- 模型:LLaMA 70B(INT4量化)
部署方案:
性能:
- 推理速度:150-300 tokens/s
- 显存占用:12 GB/卡
- 支持并发:100+用户
成本:
- 硬件:¥600,000+(4×A100)
- 电费:约¥2000/月
5.4 案例4:信创项目部署(国产化)
场景:
- 用户:政府/国企
- 硬件:8× 华为昇腾910B(256GB总显存)
- 模型:ChatGLM-6B(INT8量化)
部署方案:
性能:
- 推理速度:80-150 tokens/s
- 显存占用:8 GB/卡
- 支持并发:200+用户
成本:
- 硬件:¥400,000+(8×910B)
- 电费:约¥1500/月
- 华为技术支持:另计
六、部署框架对比
6.1 主流推理框架
| vLLM | UC Berkeley | GPTQ/AWQ | NVIDIA | 高吞吐,PagedAttention |
| TensorRT-LLM | NVIDIA | FP16/INT8 | NVIDIA | 优化最好,NVIDIA专属 |
| llama.cpp | ggml | GGUF | CPU/GPU | 跨平台,纯CPU支持 |
| ExLlamaV2 | turboderf | GPTQ/AWQ | NVIDIA | 高效推理 |
| MindSpore | 华为 | OM | 昇腾 | 国产化支持 |
| ONNX Runtime | Microsoft | ONNX | 多平台 | 跨框架 |
6.2 框架选择指南
NVIDIA GPU用户:
- 追求最高性能:TensorRT-LLM
- 高吞吐:vLLM
- 简单易用:llama.cpp
AMD GPU用户:
- ROCm支持:TensorRT-LLM
- 通用选择:llama.cpp
Apple Silicon用户:
- llama.cpp(Metal支持)
- MLX(Apple官方框架)
华为昇腾用户:
- MindSpore/ACL
- 华为CANN工具栈
七、优化策略与调优技巧
7.1 模型量化优化
量化方案选择:
量化工具:
- GPTQ:精度高,适合生产环境
- AWQ:质量更好,适合LLM
- ExLlamaV2:推理优化
- GGUF:跨平台,CPU友好
7.2 推理优化
批处理优化:
- 动态批次大小:根据负载调整
- 连续批处理:减少空等时间
- 异步批处理:提高吞吐量
内存优化:
- KV Cache优化:量化KV Cache
- 内存分页:vLLM的PagedAttention
- 模型分片:大模型分片到多卡
计算优化:
- CUDA内核优化:针对特定模型
- 矩阵乘法优化:使用cuBLAS等
- 数据布局优化:NCHW vs NHWC
7.3 系统优化
多卡优化:
- 负载均衡:合理分配模型层
- 通信优化:减少卡间通信
- 流水线并行:重叠计算和通信
网络优化:
- 推理服务化:使用gRPC/HTTP API
- 负载均衡:多实例负载均衡
- 弹性伸缩:根据负载动态调整
监控优化:
- 性能监控:QPS、延迟、吞吐量
- 资源监控:显存、CPU、内存
- 错误监控:异常检测和处理
八、未来趋势
8.1 硬件趋势
更大显存:
- RTX 5090:32GB
- 下一代:64GB+
更高带宽:
- GDDR7:更高带宽
- HBM4:下一代HBM
能效提升:
- 更低功耗
- 更高算力/瓦
8.2 软件趋势
更智能量化:
- 混合精度量化
- 自适应量化
- 任务特定量化
更好的框架:
- 更优化的推理内核
- 更自动化的调优
- 更好的可观测性
国产化生态:
- 更完善的工具链
- 更多模型支持
- 更好的性能优化
九、总结与建议
9.1 部署方案选择建议
个人开发者:
- 推荐:RTX 4090 + INT4量化模型
- 成本:约¥12,000
- 适用:7B-13B模型
中小企业:
- 推荐:2× RTX 4090 + INT4量化
- 成本:约¥24,000
- 适用:13B-30B模型
大型企业:
- 推荐:4× A100 + 混合量化
- 成本:约¥600,000+
- 适用:70B+模型
信创项目:
- 推荐:华为昇腾910B集群
- 成本:约¥400,000+
- 适用:国产化要求项目