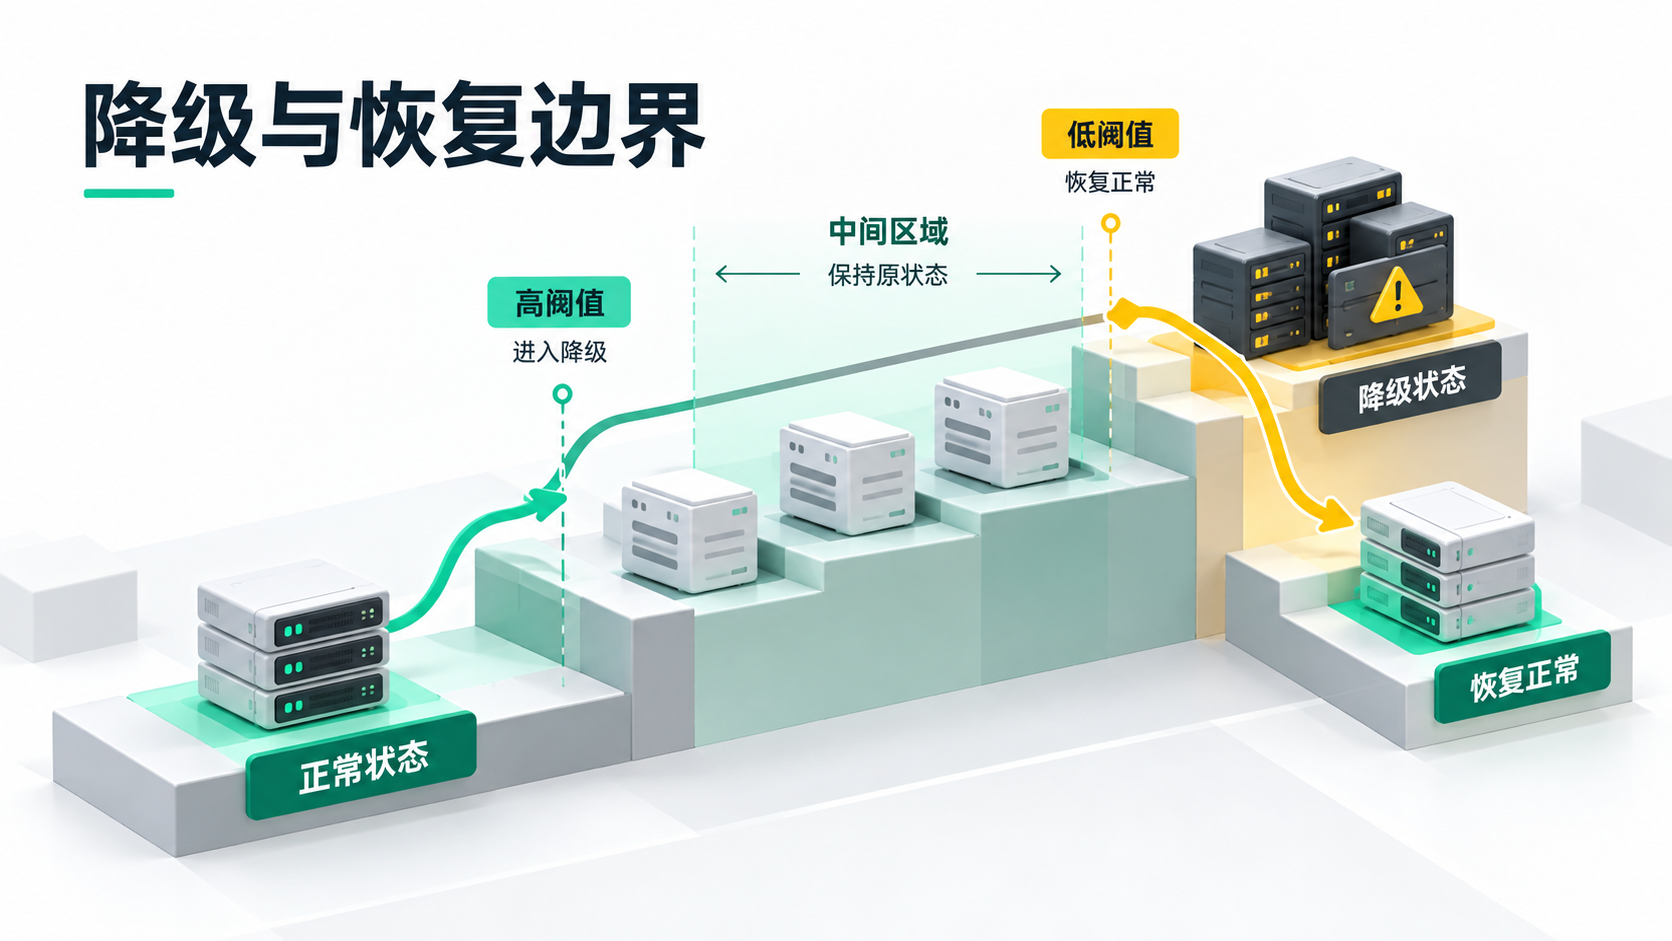
队列超过 100 就降级,降到 100 以下就恢复,这个规则看起来果断,实际上容易在边界来回切换。每次切换又可能触发模型预热、缓存变化或用户体验波动。降级不是一个 if,而是一份有进入、停留、恢复与退出条件的协议。
用迟滞避免边界抖动
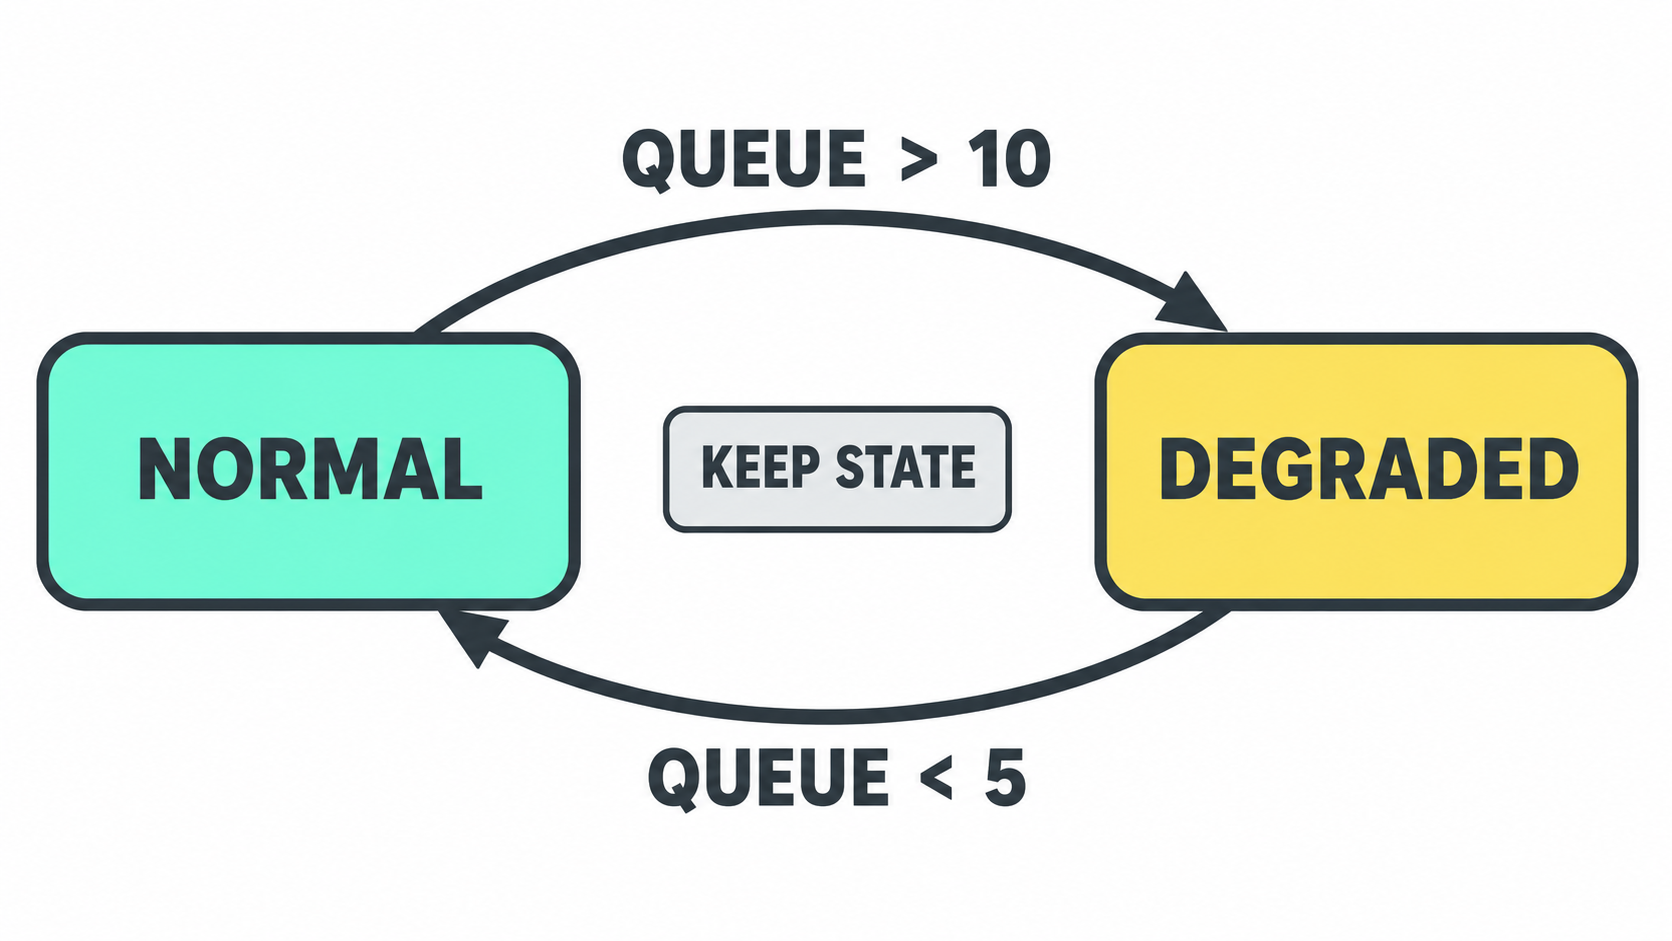
阈值为教学假设;生产阈值需结合排队、质量和业务截止时间测定。
下面设高阈值 10、低阈值 5,仅演示状态保持。阈值和输入都是人为构造,没有代表生产容量。
state, history = "normal", []
for queue in [4, 10, 11, 9, 6, 5, 4]:
if state == "normal" and queue > 10: state = "degraded"
elif state == "degraded" and queue < 5: state = "normal"
history.append(state)
print(history)
assert history == ["normal","normal","degraded","degraded","degraded","degraded","normal"]
运行输出:
['normal', 'normal', 'degraded', 'degraded', 'degraded', 'degraded', 'normal']
迟滞只能避免一种抖动,不能解决所有问题。真实系统还可能需要最短停留时间、恢复观察窗口和人工冻结。若核心依赖仍故障,队列下降可能只是因为所有请求都被拒绝,并不意味着服务已经恢复。
先减少无用工作
最先处理已过截止时间的请求,继续算它们只会延长后面的排队。重试必须有次数与总时间预算,客户端取消要传到模型执行层。对于无法中断的计算,应如实记录资源仍被占用,不把网关返回错误等同于 GPU 已释放。
KubeRay 的自动伸缩说明和应用降级处理的层级不同。增加节点通常有准备时间,不能把扩容当作眼前过载的即时解决方案。
换小模型之前先定义可接受答案
缩短输出、关闭昂贵功能和切换模型会改变行为。金融计算、结构化字段和工具参数等任务,需要单独定义允许的退化;不能用“有损生存”覆盖错误执行的后果。用户应能理解当前能力边界,内部也要记录降级路径与质量指标。
10 月的vLLM 多后端进展增加了部署选择,但后端切换仍需要兼容与质量验证。本文只执行 CPU 状态机,没有部署限流器、Ray 或真实模型。演练时应观察失败比例、排队、取消传播和恢复过程,而非只看某一刻的队列长度。