一、扩缩容概述
弹性伸缩是根据用户的业务需求和策略,自动“调整”其“弹性资源”的管理服务。通过弹性伸缩功能,用户可设置定时、周期或监控策略,恰到好处地增加或减少“弹性资源”,并完成实例配置,保证业务平稳健康运行。
在实际工作中,我们常常需要做一些扩容缩容操作,如:电商平台在 618 和双十一搞秒杀活动;由于资源紧张、工作负载降低等都需要对服务实例数进行扩缩容操作。
在 Kubernetes 中扩缩容分为两种:
| Node 层面 | 对 K8s 物理节点扩容和缩容,根据业务规模实现物理节点自动扩缩容 |
| Pod 层面 | 一般使用 Deployment 中的 replicas 参数设置多个副本集来保证高可用,但这是一个固定值。流量少时也是多个 Pod 同时运行造成资源浪费,流量暴增时又可能出现 Pod 不够用的情况 |
二、自动伸缩的方案
2.1 HPA(Horizontal Pod Autoscaler):Pod 水平自动伸缩
HPA(Horizontal Pod Autoscaler) 是控制器(如deployment,StatefulSet等)的控制器,是 Kubernetes 生态里最通用、应用最广泛的自动扩缩容方案,没有之一。
核心功能:通过此功能,只需简单的配置,便可以利用监控指标(CPU 使用率、磁盘、自定义指标等)自动地扩容或缩容服务中 Pod 数量,当业务需求增加时,系统将无缝地自动增加适量 Pod 容器,提高系统稳定性。
| HPA v1 | 仅支持根据 CPU 使用率进行自动扩缩容 |
| HPA v2 | 支持根据 CPU、内存以及自定义指标进行自动扩缩容 |
HPA 默认每 15 秒同步一次,且有“稳定窗口”防止频繁扩缩容(默认缩容等待 5 分钟)
2.2 KPA(Knative Pod Autoscaler):基于请求数的自动扩缩容
核心功能:基于请求数对 Pod 自动扩缩容。
主要限制:不支持基于 CPU 的自动扩缩容。
相比 HPA 的优势:会考虑更多的场景,其中一个比较重要的是流量突发的时候,能够更快地响应突发流量。
KPA 是 Knative 生态下的组件,非通用方案
2.3 VPA(Vertical Pod Autoscaler):垂直 Pod 自动扩缩容
核心功能:VPA 会基于 Pod 的资源使用情况自动为集群设置资源占用的限制,从而让集群将 Pod 调度到有足够资源的最佳节点上。VPA 也会保持最初容器定义中资源 request 和 limit 的占比。
工作原理:
- 根据容器资源使用率自动设置 Pod 的 CPU 和内存的 requests
- 允许在节点上进行适当的调度,以便为每个 Pod 提供适当的可用节点
- 既可以缩小过度请求资源的容器,也可以根据其使用情况随时提升资源不足的容量
VPA 不是内置组件,需要单独安装,更新模式有三种:
| Off | 只给建议,不自动调整 |
| Auto | 自动调整,需重建 Pod 才能生效 |
| Initial | 只在 Pod 创建时设置一次 |
三、HPA 工作原理
HPA 全称是 Horizontal Pod Autoscaler,翻译成中文是 Pod 水平自动伸缩。HPA 可以基于 CPU 利用率对 Deployment 中的 Pod 数量进行自动扩缩容(除了 CPU 也可以基于自定义的指标进行自动扩缩容)。
重要说明:Pod 自动缩放不适用于无法缩放的对象,比如 DaemonSets。
3.1 核心机制
HPA 由 Kubernetes API 资源和控制器实现。控制器会周期性地获取平均 CPU 利用率,并与目标值相比较后调整 Deployment 中的副本数量。
3.2 工作原理流程图
┌─────────────────────────────────────────────────────────────────────────────┐
│ HPA 工作原理 │
├─────────────────────────────────────────────────────────────────────────────┤
│ │
│ ① 创建 HPA 资源,设定目标 CPU 使用率限额,以及最大、最小实例数 │
│ │ │
│ ▼ │
│ ② 收集一组中(PodSelector)每个 Pod 最近一分钟内的 CPU 使用率,并计算平均 │
│ │ │
│ ▼ │
│ ③ 读取 HPA 中设定的 CPU 使用限额 │
│ │ │
│ ▼ │
│ ④ 计算:平均值之和/限额,求出目标调整的实例个数 │
│ │ │
│ ▼ │
│ ⑤ 目标调整的实例数不能超过①中设定的最大、最小实例数 │
│ 未超过则扩容;超过则扩容至最大的实例个数 │
│ │ │
│ ▼ │
│ ⑥ 回到 ②,不断循环 │
│ │
└─────────────────────────────────────────────────────────────────────────────┘
3.3 关键参数
| 检测周期 | 默认每 30s 检测一次指标 |
| 扩缩容冷却 | 默认在 5min 内没有重新扩缩容的情况下,才会触发扩缩容 |
| 算法特点 | HPA 本身的算法相对比较保守,快速流量突发场景下,如果正处在 5min 内的 HPA 稳定期,会导致无法扩容 |
3.4 查看支持的 API 版本
kubectl api-versions | grep autoscal
3.5 Metrics API
Kubernetes 从 1.8 版本开始,CPU、内存等资源的 metrics 信息可以通过 Metrics API 来获取,用户可以直接获取这些 metrics 信息(例如通过执行 kubectl top 命令),HPA 使用这些 metrics 信息来实现动态伸缩。
四、HPA 部署与实战案例
4.1 安装数据采集组件 metrics-server
metrics-server 是一个集群范围内的资源数据集和工具。它主要关注的是资源度量 API 的实现,比如 CPU、文件描述符、内存、请求延时等指标。metrics-server 收集数据给 K8s 集群内使用,如 kubectl top、HPA、Scheduler 等。
项目地址:https://github.com/kubernetes-sigs/metrics-server
稳定版本:v0.6.2
YAML 下载地址:https://github.com/kubernetes-sigs/metrics-server/releases/download/v0.6.2/components.yaml
a. 部署 metrics-server 组件
上传镜像压缩包并导入(根据容器运行时选择):
# 容器运行时为 docker:
[root@h2 ~]# docker load -i metrics-server0.62.tar.gz
[root@h3 ~]# docker load -i metrics-server0.62.tar.gz
# 容器运行时为 containerd:
[root@h2 ~]# ctr -n k8s.io images import metrics-server0.62.tar.gz
[root@h3 ~]# ctr -n k8s.io images import metrics-server0.62.tar.gz
b. 修改 kube-apiserver 配置
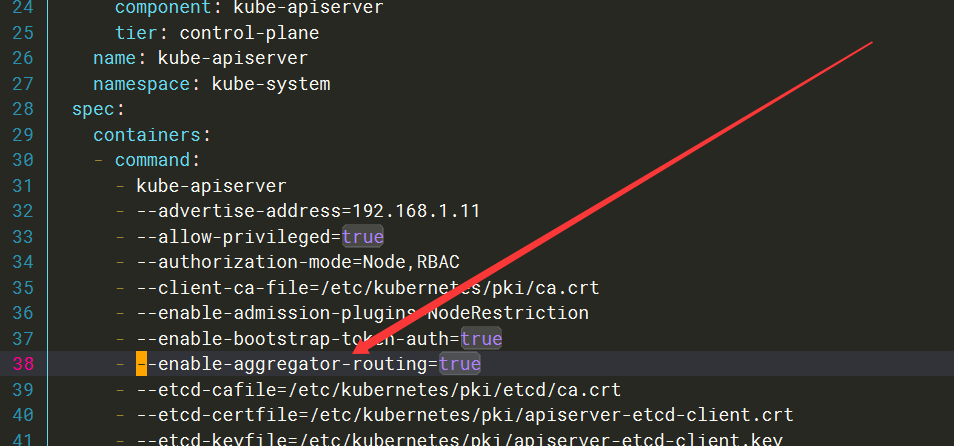
在 /etc/kubernetes/manifests 里面修改 apiserver 的配置,添加 –enable-aggregator-routing=true 参数:
# 修改 kube-apiserver.yaml 文件,添加一行内容
[root@hd1 ~]# vim /etc/kubernetes/manifests/kube-apiserver.yaml
# 添加内容如下
– –enable-aggregator-routing=true
[root@hd1 ~]# kubectl apply -f /etc/kubernetes/manifests/kube-apiserver.yaml
# 这一步可以省略,因为 /etc/kubernetes/manifests 中的 yaml 文件对应的资源都是静态 Pod,Kubelet 会实时监控,不需要单独执行 kubectl apply
重要说明:这是 Kubernetes 在 1.7 的新特性,如果是 1.16 版本的可以不用添加,1.17 以后要添加。这个参数的作用是 Aggregation(聚合),允许在不修改 Kubernetes 核心代码的同时扩展 Kubernetes API。
c. 部署 metrics-server
# 上传 components.yaml 文件
[root@hd1 ~]# kubectl apply -f components.yaml
由于文件中配置较多,可能需要等待一到两分钟才能完成部署
d. 验证 metrics-server 是否部署成功
# 查看 Pod 状态
[root@hd1 ~]# kubectl get pods -n kube-system | grep metrics
metrics-server-59549d9b85-7xxkq 1/1 Running 0 5m16s
# 测试 kubectl top 命令(查看节点资源)
[root@hd1 ~]# kubectl top nodes
NAME CPU(cores) CPU% MEMORY(bytes) MEMORY%
hd1 689m 17% 2005Mi 61%
hd2 429m 10% 1342Mi 40%
hd3 450m 11% 1832Mi 55%
# 测试 kubectl top 命令(查看 Pod 资源)
[root@hd1 ~]# kubectl top pods -n kube-system
NAME CPU(cores) MEMORY(bytes)
calico-kube-controllers-57b57c56f-khn8l 3m 67Mi
calico-node-bqzkp 37m 177Mi
calico-node-kpwwf 36m 153Mi
calico-node-tkm27 45m 158Mi
coredns-5bbd96d687-464gw 3m 37Mi
coredns-5bbd96d687-wcvmp 3m 39Mi
etcd-hd1 42m 127Mi
fluentd-elasticsearch-d22wn 2m 53Mi
fluentd-elasticsearch-pmqzx 1m 57Mi
fluentd-elasticsearch-tm8rz 1m 51Mi
kube-apiserver-hd1 81m 341Mi
kube-controller-manager-hd1 40m 59Mi
kube-proxy-lzqgk 1m 49Mi
kube-proxy-mfhjd 1m 48Mi
kube-proxy-srfhg 1m 49Mi
kube-scheduler-hd1 6m 20Mi
metrics-server-59549d9b85-7xxkq 6m 17Mi
4.2 创建 php-apache 服务,利用 HPA 进行自动扩缩容
步骤 1:构建 PHP 应用镜像
上传我们的源镜像包 php-5-apache.tar
[root@hd1 ~]# docker load -i php-5-apache.tar
Loaded image: php:5-apache
先创建目标目录,编写DockerFile
[root@hd1 ~]# mkdir php
[root@hd1 ~]# cd php/
[root@hd1 php]# cat dockerfile
FROM php:5-apache
ADD index.php /var/www/html/index.php #将本地当前目录下的 index.php 文件,复制到容器内的 /var/www/html/index.php
RUN chmod a+rx index.php #给 index.php 文件授权
创建 index.php(这是一个 CPU 密集计算脚本):
[root@hd1 php]# cat index.php
<?php
$x = 0.0001;
for ($i = 0; $i <= 1000000;$i++) {
$x += sqrt($x);
}
echo "OK!";
?>
构建镜像:
# 构建镜像
[root@hd1 php]# docker build -t hpa-example:v1 .
# 打包镜像
[root@hd1 php]# docker save -o hpa-example.tar.gz hpa-example:v1
分发镜像:
[root@hd1 php]# scp hpa-example.tar.gz hd2:/root/
[root@hd1 php]# scp hpa-example.tar.gz hd3:/root/
在 K8s 工作节点解压镜像:
#假如容器运行时为docker
[root@hd2 ~]# docker load -i hpa-example.tar.gz
[root@hd3 ~]# docker load -i hpa-example.tar.gz
# 假如容器运行时为 containerd
[root@hd2 ~]# ctr -n k8s.io images import hpa-example.tar.gz
[root@hd3 ~]# ctr -n k8s.io images import hpa-example.tar.gz
步骤 2:通过 Deployment 部署 php-apache 服务
创建deployment和service
[root@hd1 ~]# php-apache.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
name: php–apache
spec:
selector:
matchLabels:
run: php–apache
replicas: 1
template:
metadata:
labels:
run: php–apache
spec:
containers:
– name: php–apache
image: hpa–example:v1
imagePullPolicy: IfNotPresent
ports:
– containerPort: 80
resources:
limits:
cpu: 500m
requests:
cpu: 200m
—
apiVersion: v1
kind: Service
metadata:
name: php–apache
labels:
run: php–apache
spec:
ports:
– port: 80
selector:
run: php–apache #选择标签为run: php-apache的pod
# 更新资源清单文件
[root@hd1 ~]# kubectl apply -f php-apache.yaml
deployment.apps/php-apache created
service/php-apache created
# 验证 php 是否部署成功
[root@hd1 ~]# kubectl get pod
NAME READY STATUS RESTARTS AGE
php-apache-6c4dd55c95-5wv2t 1/1 Running 0 8m2s
步骤 3:创建 HPA
# 给 php-apache 这个 Deployment 创建 HPA。autoscale,自动扩缩容的缩写
[root@hd1 ~]# kubectl autoscale deployment php-apache –cpu-percent=50 –min=1 –max=10
horizontalpodautoscaler.autoscaling/php-apache autoscaled
命令参数说明:
| php-apache | Deployment 的名字 |
| –cpu-percent=50 | CPU 使用率目标值(不超过 50%) |
| –min=1 | 最少 1 个 Pod |
| –max=10 | 最多 10 个 Pod |
# 验证 HPA 是否创建成功
[root@hd1 ~]# kubectl get hpa
NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE
php-apache Deployment/php-apache 0%/50% 1 10 1 18s
由于没有向服务器发送任何请求,当前 CPU 消耗为 0%(TARGET 列显示了由相应 Deployment 控制的所有 Pod 的平均值)。
4.3 压测 php-apache 服务(基于 CPU)
步骤 1:导入压测用镜像
把busybox.tar.gz和nginx-1-9-1.tar.gz上传到hd2、hd3上
#容器运行时为 docker
[root@hd2 ~]#ctr -n k8s.io images import -i busybox.tar.gz
[root@hd3 ~]#ctr -n k8s.io images import -i busybox.tar.gz
# 容器运行时为 containerd
[root@hd2 ~]# ctr -n k8s.io images import busybox.tar.gz
[root@hd3 ~]# ctr -n k8s.io images import busybox.tar.gz
步骤 2:启动压测容器
启动一个容器,并将无限查询循环发送到 php-apache 服务(打开一个新的终端窗口):
[root@hd1]# kubectl run v2 -it –image=docker.io/library/busybox:1.28 \\
–image-pull-policy=IfNotPresent /bin/sh
登录到容器之后,执行如下命令:
# 持续发送请求,触发 CPU 负载
/# while true; do wget -q -O- http://php-apache.default.svc.cluster.local; done
步骤 3:观察 HPA 自动扩容
在一分钟左右的时间内,在另一个终端窗口通过执行以下命令看到更高的 CPU 负载:
[root@hd1]# kubectl get hpa
显示如下:
NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS
php-apache Deployment/php-apache 231%/50% 1 10 4
上面可以看到,CPU 消耗已经达到 231%,每个 Pod 的目标 CPU 使用率是 50%,所以 php-apache 这个 Deployment 创建的 Pod 副本数将调整为 5 个副本。
[root@hd1]# kubectl get deployment php-apache
显示如下:
NAME READY UP-TO-DATE AVAILABLE AGE
php-apache 5/5 5 5 2h1m
步骤 4:停止压测并观察自动缩容
停止向 php-apache 服务发送查询请求,在 busybox 镜像创建容器的终端中,通过 <Ctrl>+C 把刚才 while 请求停止,然后验证结果状态(大约 5 分钟后):
[root@hd1]# kubectl get deployment php-apache
显示如下:
php-apache 1/1 1 1 5s
Pod 数量自动恢复到 1 个。
4.4 利用 HPA 基于内存指标实现 Pod 自动扩缩容
步骤 1:创建 Nginx Deployment 和 Service
[root@hd1 ~]# vim nginx.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
name: nginx-hpa
spec:
selector:
matchLabels:
app: nginx
replicas: 1
template:
metadata:
labels:
app: nginx
spec:
containers:
– name: nginx
image: nginx:latest
imagePullPolicy: IfNotPresent
ports:
– containerPort: 80
name: http
protocol: TCP
resources: #资源限制
requests:
cpu: 0.01
memory: 25Mi
limits:
cpu: 0.05
memory: 60Mi
—
apiVersion: v1
kind: Service
metadata:
name: nginx
labels:
app: nginx
spec:
selector:
app: nginx
type: NodePort
ports:
– name: http
protocol: TCP
port: 80
targetPort: 80
# 更新资源清单文件
[root@hd1 ~]# kubectl apply -f nginx.yaml
deployment.apps/nginx-hpa created
service/nginx created
# 验证 nginx 是否运行
[root@hd1 ~]# kubectl get pods
NAME READY STATUS RESTARTS AGE
nginx-hpa-69964b867b-9j6ml 1/1 Running 0 69s
注意:Nginx 的 Pod 里必须包含 resources.requests 和 resources.limits 资源限制的字段,否则 HPA 无法采集到内存指标。
步骤 2:创建基于内存的 HPA(v2 版本)
[root@hd1 ~]# vim hpa-v2.yaml
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
name: nginx–hpa
spec:
maxReplicas: 10 # 扩容上限:最多不能超过 10 个 Pod(防止资源耗尽)
minReplicas: 1 # 缩容下限:至少保留 1 个 Pod(防止全缩容导致服务不可用)
scaleTargetRef: #指定目标资源(管理谁)
apiVersion: apps/v1 # 目标资源的 API 版本
kind: Deployment # 目标资源的类型(也支持 StatefulSet,不支持 DaemonSet)
name: nginx–hpa # 目标 Deployment 的名称(必须与 metadata.name 一致)
metrics:
– type: Resource
resource:
name: memory
target:
averageUtilization: 60 # 【平均利用率】所有匹配 Pod 的内存平均值达到 60% 即触发扩容
type: Utilization # 指标类型:Utilization(利用率百分比,基于 Pod 的 requests 计算)
# 更新资源清单文件
[root@hd1 ~]# kubectl apply -f hpa-v2.yaml
# 查看创建的 HPA
[root@hd1 ~]# kubectl get hpa
NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE
nginx-hpa Deployment/nginx-hpa 17%/60% 1 10 1 31s
4.5 压测内存
步骤 1:进入容器生成大文件增加内存使用
[root@hd1]# kubectl exec -it nginx-hpa-fb74696c-6m6st — /bin/sh
进入容器内部执行压测命令:
# 生成一个 1GB 的大文件,消耗内存
# dd if=/dev/zero of=/tmp/a bs=1M count=1000
# 或持续写入
# dd if=/dev/zero of=/tmp/a
步骤 2:观察 HPA 自动扩容
打开新的终端进行查看:
[root@hd1 ~]# kubectl get hpa
NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE
nginx-hpa Deployment/nginx-hpa 200%/60% 1 10 4
TARGETS 列显示 200%/60%:200% 表示当前内存使用率,60% 表示所有 Pod 的内存使用率维持在 60%。内存使用率达到 200%,Pod 自动增加到 4 个。
# 查看 Deployment
[root@hd1 ~]# kubectl get deployment
NAME READY UP-TO-DATE AVAILABLE AGE
nginx-hpa 4/4 4 4 25m
# 查看 Pod 数量
[root@hd1 ~]# kubectl get pods
NAME READY STATUS RESTARTS AGE
nginx-hpa-bb598885d-j4kcp 1/1 Running 0 25m
nginx-hpa-bb598885d-rj5hk 1/1 Running 0 63s
nginx-hpa-bb598885d-twv9c 1/1 Running 0 18s
nginx-hpa-bb598885d-v9ft5 1/1 Running 0 63s
步骤 3:取消压测并观察自动缩容
# 取消对 Nginx 内存的压测
[root@hd1 ~]# kubectl exec -it nginx-hpa-fb74696c-6m6st — /bin/sh
# rm -rf /tmp/a
# 查看 HPA 指标(内存使用率逐渐下降)
[root@hd1 ~]# kubectl get hpa
NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS
nginx-hpa Deployment/nginx-hpa 5%/60% 1 10 1
# 查看 Deployment(Pod 恢复到 1 个)
[root@hd1 ~]# kubectl get deployment
NAME READY UP-TO-DATE AVAILABLE AGE
nginx-hpa 1/1 1 1 38m
五、三种扩缩容方案对比
| HPA | Horizontal Pod Autoscaler | 水平(Pod 数量) | CPU、内存、自定义指标(v2) | 默认 5min 冷却期 | 最常见的 Pod 弹性伸缩场景 |
| VPA | Vertical Pod Autoscaler | 垂直(Pod 资源配额) | CPU、内存使用率 | 需要重启 Pod 才能调整资源 | 优化 Pod 资源 requests/limits 配置 |
| KPA | Knative Pod Autoscaler | 水平(Pod 数量) | 请求数(QPS) | 不支持基于 CPU 的扩缩容 | Serverless 场景,流量突发时快速响应 |
六、关键要点速查
HPA 常用命令
# 使用命令行创建 HPA
kubectl autoscale deployment <deployment-name> \\
–cpu-percent=<目标CPU使用率> \\
–min=<最小副本数> \\
–max=<最大副本数>
# 查看 HPA
kubectl get hpa
kubectl describe hpa <hpa-name>
# 查看 HPA 支持的所有版本
kubectl api-versions | grep autoscal
# 查看节点/ Pod 资源使用情况
kubectl top nodes
kubectl top pods [-n <namespace>]
HPA 核心参数说明
| –cpu-percent | 目标 CPU 使用率阈值(百分比),超过即触发扩容 |
| –min | 最小副本数,即使没有流量也不会少于这个数 |
| –max | 最大副本数,防止无限扩容耗尽集群资源 |
| averageUtilization | 平均利用率模式(v2 版本中用于内存等指标) |
HPA v2 vs v1
| v1 | 仅 CPU | 基础版本,功能简单 |
| v2 | CPU、内存、自定义指标(如 QPS、消息队列长度等) | 推荐使用,功能更强大 |
七、常见问题排查
| kubectl top 无法获取指标 | metrics-server 未安装或未正常运行 | 检查 kubectl get pods -n kube-system | grep metrics |
| HPA 不触发扩容 | 未配置 Pod 的 resources.requests | HPA 必须基于 requests 计算使用率,需在 Pod 模板中配置 |
| HPA 扩容后一直不缩容 | HPA 默认有 5min 冷却期 | 等待 5 分钟后自动缩容,或调整 HPA 参数 |
| 内存 HPA 采集不到数据 | Pod 没有设置 resources.requests.memory | 添加 memory requests 字段 |
| metrics-server Pod 启动失败 | kube-apiserver 未开启聚合层 | 检查 –enable-aggregator-routing=true 是否添加 |
八、拓展补充
前文为了方便理解和示例,对部分内容进行简化了说明,在本节进行拓展补充
1. 关于 HPA 算法的准确说明
计算方式“平均值之和/限额”不够准确。HPA 实际算法的核心逻辑是:
期望副本数 = ceil(当前副本数 × (当前指标值 / 期望指标值))
示例:当前 1 个 Pod,CPU 使用率 231%,期望 50%,则:
期望副本数 = ceil(1 × (231% / 50%)) = ceil(4.62) = 5
这就是为什么 kubectl get hpa 显示 REPLICAS 变为 4 或 5 的原因。
2. 关于 HPA 冷却时间
原文提到“5min 内没有重新扩缩容的情况下,才会触发扩缩容”
更准确的理解是:HPA 有两个控制稳定性的参数:
- 扩容稳定窗口(horizontal-pod-autoscaler-upscale-stabilization-window):默认 5 分钟。HPA 会记录最近 5 分钟内的所有扩容决策,取其中的最大值作为实际扩容目标,避免因指标抖动导致频繁扩容。
- 缩容稳定窗口(horizontal-pod-autoscaler-downscale-stabilization-window):默认 5 分钟。类似地,缩容时也会取最近 5 分钟内的最小决策值。
3. 关于 metrics-server 的作用
metrics-server 只负责实时采集和提供 CPU/内存指标数据,不负责存储历史数据。这也是为什么 kubectl top 只能看到当前数据,无法查看历史趋势的原因。如果需要历史数据,需要部署 Prometheus + 自定义指标适配器。
4. 关于自定义指标的补充
HPA v2 支持自定义指标,常见的使用场景包括:
- 基于 RabbitMQ/Kafka 消息队列长度自动扩容消费者 Pod
- 基于 HTTP 请求数(QPS)自动扩容
- 基于数据库连接数自动扩容
这需要配合 Prometheus Adapter 或 Custom Metrics API 实现。
九、总结
Kubernetes HPA 是实现 Pod 水平自动伸缩的核心组件,它通过 Metrics API 获取 Pod 的资源使用指标,根据设定的阈值自动调整 Deployment 的副本数量。HPA v1 仅支持 CPU 指标,HPA v2 则支持 CPU、内存和自定义指标,满足更复杂的弹性伸缩场景。
核心要点: