《RabbitMQ 学习指南》
写在前面
消息队列是分布式系统架构中绕不开的基石组件。无论是电商的订单异步处理、秒杀的流量削峰,还是微服务间的最终一致性,MQ 都在其中扮演着关键角色。
市面上关于 RabbitMQ 的文章大多停留在"怎么用"的层面——配置几个参数、跑通一个 Demo 就结束了。但真正到了生产环境,面对消息丢失、重复消费、积压堆积、延迟不可控等问题时,很多同学会陷入"配置都对了但就是出问题"的困境。
这篇文章的目标是:从第一性原理出发,把 RabbitMQ 的核心机制讲透,再落到每一行可执行的代码上。全文覆盖了从基础概念到生产级部署的完整路径,你可以把它当作学习路线图,也可以作为实战手册来查阅。
一、为什么你的系统需要一个 MQ
1.1 同步调用的困境
先看一个典型的订单创建流程:
用户请求 → 订单服务 → 扣减库存 → 增加积分 → 发送短信 → 返回结果
每一步都是同步阻塞的。假设各环节耗时分别为:订单落库 50ms、库存扣减 80ms、积分增加 60ms、短信发送 120ms,那么用户需要等待 310ms 才能看到下单成功。
这个数字在低并发下看起来还能接受,但问题远不止响应时间这么简单。
第一个问题:线程资源被长期占用。 Tomcat 默认的线程池大小通常在 200 个左右。每个请求在业务处理期间都会占用一个线程,而且是被阻塞的——它在等待下游服务的响应,自身没有做任何计算。当 QPS 达到 200 时,线程池已经全部被占满,新的请求只能排队等待或被直接拒绝。
第二个问题:故障传导放大。 假设短信服务因为某次运营商接口超时而响应缓慢,从 120ms 飙升到 3000ms。那么整个订单链路的响应时间也会从 310ms 飙升到 3190ms,而且每一个等待短信响应的线程都被长时间占用。最终的结果是:短信服务的一个小抖动,导致整个订单系统线程池耗尽,所有下单请求全部失败。
第三个问题:扩展性差。 产品经理提了一个新需求:下单后需要调用风控服务做风险评估。为了实现这个功能,开发团队必须在订单服务的代码中引入风控服务的 RPC 调用,然后重新编译、测试、部署。这种硬编码的依赖关系,让系统的扩展变得异常困难。
1.2 异步解耦的解决思路
引入消息队列后,架构变成了这样:
用户请求 → 订单服务(本地事务 + 发送消息)→ 返回结果
↓
[MQ Broker]
↓
┌───────────────┼───────────────┐
↓ ↓ ↓
库存服务 积分服务 短信服务
订单服务只需要完成自己的本地事务(落库订单),然后往 MQ 中发送一条"订单已创建"的消息,就可以立即返回给用户。整个过程耗时从 310ms 降低到了约 50ms(本地事务 45ms + 网络发送 5ms)。
下游的库存、积分、短信服务各自订阅这个消息,按照自己的节奏去处理。即使短信服务宕机了,消息也会安全地存储在 MQ 中,等它恢复后再继续消费——订单服务完全不受影响。
这就是异步解耦的核心价值:让上游服务不再依赖下游服务的可用性和性能。
1.3 流量削峰的本质
秒杀场景是 MQ 最经典的落地场景之一。假设系统每秒涌入 10 万条下单请求,而数据库的写入能力上限只有 5000 TPS。如果没有 MQ,数据库会被瞬间打挂。
MQ 在这中间起到了缓冲区的作用。所有请求先把订单消息写入 MQ(这是一个非常轻量的操作,RabbitMQ 单节点每秒可以处理数万条消息的写入),然后消费者以数据库能承受的速度(5000/s)慢慢拉取消息进行处理。
这里的核心思想是:把突发的流量峰值平滑成一个持续的平均流量。用户端的体验是下单请求立即返回"处理中",随后异步完成真正的订单落库。
1.4 引入 MQ 的代价
任何架构决策都有 trade-off,引入 MQ 也不例外。
首先是系统复杂度显著上升。你需要考虑消息丢失怎么办、消息重复怎么办、消息积压怎么办、顺序消息怎么保证。这些在同步 RPC 调用中都不是问题的事情,在异步架构中变成了必须解决的课题。
其次是运维成本增加。原来只需要维护应用服务器和数据库,现在多了一个 MQ Broker 集群需要监控、备份、扩缩容。
最重要的是最终一致性的接受。用户下单成功后,积分可能过了几秒钟才增加——这在技术上是合理的,但需要产品层面明确告知用户"积分稍后到账"。
二、RabbitMQ 核心概念与安装
2.1 理解 RabbitMQ 的架构模型
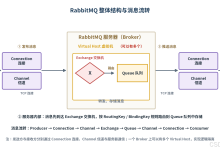
RabbitMQ 是基于 AMQP(Advanced Message Queuing Protocol,高级消息队列协议)实现的,它的核心架构可以用一个简单的类比来理解:
你把 RabbitMQ 想象成一个邮局。 生产者是寄信人,消费者是收信人。但信件并不是直接从寄信人送到收信人手中的,而是先送到邮局,邮局根据地址(RoutingKey)和分拣规则(Exchange)把信件投递到对应的邮箱(Queue),最后收信人从自己的邮箱里取信。
在这个类比中,有几个核心概念必须彻底搞清楚:
生产者(Producer) 是发送消息的应用程序。它只负责把消息发往 Broker,不关心消息最终被谁消费。
消费者(Consumer) 是接收消息的应用程序。它通过订阅队列来获取消息,处理完成后向 Broker 发送确认信号。
队列(Queue) 是消息的容器,它实际存储着消息数据。队列具有 FIFO(先进先出)的特性,这意味着在单个队列中,消息的消费顺序和发送顺序是一致的。队列可以持久化到磁盘,Broker 重启后数据不丢失。
交换机(Exchange) 是消息的路由中枢,但这是初学者最容易误解的地方:交换机本身不存储任何消息。它只负责接收生产者发来的消息,然后根据绑定规则(Binding)和路由键(RoutingKey)决定把消息分发给哪些队列。如果交换机无法将消息路由到任何一个队列,并且生产者没有设置 mandatory 参数,这条消息就会被 Broker 丢弃。
绑定(Binding) 是交换机和队列之间的关联关系。一个交换机可以绑定多个队列,一个队列也可以被多个交换机绑定。绑定时可以指定一个 RoutingKey,交换机根据这个 Key 来决定消息的去向。
虚拟主机(Virtual Host) 提供了资源隔离的能力。你可以把它类比为 MySQL 中的 Database——不同的 vhost 之间完全隔离,拥有独立的交换机、队列、绑定和权限配置。在实际项目中,通常为开发、测试、生产环境分别创建独立的 vhost。
2.2 生产级安装指南
RabbitMQ 官方提供了 Docker 镜像,这是最快捷的安装方式。但有几个生产环境的要点需要注意:
docker run -d \\
–name rabbitmq \\
–hostname rabbitmq-node1 \\
-p 5672:5672 \\
-p 15672:15672 \\
-p 15692:15692 \\
-e RABBITMQ_DEFAULT_USER=admin \\
-e RABBITMQ_DEFAULT_PASS=Admin@2026 \\
-e RABBITMQ_VM_MEMORY_HIGH_WATERMARK=0.6 \\
-v /data/rabbitmq:/var/lib/rabbitmq \\
–memory=2g \\
–cpus=2 \\
rabbitmq:3.13-management-alpine
端口说明:5672 是 AMQP 协议端口,供客户端连接使用;15672 是管理控制台端口;15692 是 Prometheus 监控指标暴露端口。
内存阈值:通过 RABBITMQ_VM_MEMORY_HIGH_WATERMARK 设置,默认值为 0.4,即当内存使用率达到 40% 时,Broker 会触发流控,阻塞生产者继续发送消息。生产环境中建议调高到 0.6 或 0.7,但不要超过 0.8,否则可能导致 OOM。
数据持久化:通过 -v /data/rabbitmq:/var/lib/rabbitmq 将数据目录挂载到宿主机,防止容器重启后数据丢失。
安装完成后,访问 http://{你的IP}:15672,用上面设置的用户名密码登录。管理控制台是一个重要的运维工具,你需要熟悉以下几个核心页面:
- Overview:查看 Broker 整体的内存使用、磁盘可用空间、连接数和通道数。
- Connections:查看所有客户端连接,包括连接状态、心跳间隔、Channel 数量。
- Queues:列出所有队列及其深度(Ready/Unacked/Total)、消费者数量、消息吞吐量。
- Admin:管理用户、虚拟主机和权限。
2.3 虚拟主机的使用
在生产环境中,强烈建议为不同环境创建独立的虚拟主机。操作步骤如下:
在管理控制台点击 Admin → Virtual Hosts → Add a new virtual host,填写名称如 order-prod。然后点击刚刚创建的 vhost 名称,进入 Permissions 页面,为用户配置权限。
权限分为三类:
- Configure:允许创建/删除队列和交换机。
- Write:允许发布消息到交换机。
- Read:允许从队列消费消息。
代码中指定 vhost 的方式很简单:
factory.setVirtualHost("order-prod");
需要注意的是,默认的 guest 用户只能在 "/" vhost 下工作,无法访问其他 vhost。生产环境应该创建独立的用户,并赋予最小必要权限。
三、Java 原生客户端深度解析
3.1 第一个消息的发送与接收
在引入 SpringBoot 之前,我们先使用官方提供的 amqp-client 来理解最底层的 API。这有助于你理解后续 SpringBoot 封装背后的原理。
生产者代码:
public class Producer {
public static void main(String[] args) throws Exception {
ConnectionFactory factory = new ConnectionFactory();
factory.setHost("192.168.1.100");
factory.setPort(5672);
factory.setVirtualHost("/");
factory.setUsername("admin");
factory.setPassword("Admin@2026");
// 开启自动恢复
factory.setAutomaticRecoveryEnabled(true);
factory.setNetworkRecoveryInterval(5000);
try (Connection connection = factory.newConnection();
Channel channel = connection.createChannel()) {
// 声明队列:持久化、非独占、非自动删除
channel.queueDeclare("hello.queue", true, false, false, null);
String message = "Hello RabbitMQ";
// 发送消息:空交换机表示使用默认交换机,routingKey 就是队列名
channel.basicPublish("", "hello.queue",
MessageProperties.PERSISTENT_TEXT_PLAIN,
message.getBytes(StandardCharsets.UTF_8));
System.out.println("消息发送成功: " + message);
}
}
}
消费者代码:
public class Consumer {
public static void main(String[] args) throws Exception {
ConnectionFactory factory = new ConnectionFactory();
// 连接配置同上…
Connection connection = factory.newConnection();
Channel channel = connection.createChannel();
channel.queueDeclare("hello.queue", true, false, false, null);
// 设置 QoS:每次只拉取 1 条消息,处理完再拉取下一条
channel.basicQos(1);
DeliverCallback deliverCallback = (consumerTag, delivery) -> {
String msg = new String(delivery.getBody(), StandardCharsets.UTF_8);
System.out.println("收到消息: " + msg);
try {
// 模拟业务处理
Thread.sleep(100);
// 手动确认
channel.basicAck(delivery.getEnvelope().getDeliveryTag(), false);
} catch (Exception e) {
// 处理失败,拒绝并重新入队
channel.basicNack(delivery.getEnvelope().getDeliveryTag(), false, true);
}
};
// 第二个参数 false 表示关闭自动 ACK,改为手动确认
channel.basicConsume("hello.queue", false, deliverCallback, consumerTag -> {});
System.out.println("开始消费消息…");
}
}
3.2 Connection 与 Channel 的正确使用
这里有一个非常关键的性能知识点:Connection 是重量级的 TCP 连接,应该全局单例;Channel 是轻量级的逻辑通道,应该在线程中复用但不要跨线程共享。
Connection 的创建开销很大(需要 TCP 三次握手 + AMQP 协议握手),生产环境通常使用连接池来管理。而 Channel 虽然创建开销小,但它不是线程安全的,多个线程共用一个 Channel 会导致消息发送顺序错乱甚至报错。
最佳实践是:每个线程维护自己的 Channel,或者使用 ThreadLocal 来管理。
3.3 Work Queue 与消息分发策略
Work Queue 模型指的是一个队列被多个消费者同时消费的场景。RabbitMQ 默认采用**轮询分发(Round-Robin)**策略,即消息依次发送给各个消费者,不管消费者的处理能力如何。
假设有 3 个消费者,第 1 个处理很快(10ms/条),第 2 个处理中等(100ms/条),第 3 个处理很慢(1000ms/条)。轮询分发会让三个消费者收到的消息数量大致相等,但处理慢的消费者会迅速积压,而处理快的消费者却空闲着。
解决方案是公平分发(Fair Dispatch),通过设置 basicQos(1) 来实现。这个参数的含义是:消费者在发送 ACK 确认之前,最多允许预取多少条消息。设置为 1 后,每个消费者每次只会被推送一条消息,处理完并 ACK 后才会收到下一条。这样处理快的消费者自然能处理更多的消息。
3.4 三种交换机的工作机制
交换机是 RabbitMQ 路由能力的核心,三种内置交换机的行为完全不同。
Fanout 交换机 的行为最直接:它会将收到的消息广播给所有绑定的队列,完全忽略 RoutingKey。这种模式适用于"一个事件需要通知多个服务"的场景,比如用户注册成功后需要同时发送欢迎邮件、赠送优惠券、同步 CRM 数据。如果未来要增加一个新的下游服务(比如发送站内信),只需要新增一个队列绑定到这个 Fanout 交换机即可,上游代码完全不需要修改。
Direct 交换机 根据 RoutingKey 进行精确匹配。只有 RoutingKey 完全相同的队列才能收到消息。这种模式适合日志分级场景:error 级别的日志进入告警队列,info 级别的日志进入普通日志队列。一个队列可以绑定多个 RoutingKey,比如 all.queue 同时绑定了 error 和 info,那么所有级别的日志都能进入这个队列。
Topic 交换机 提供了通配符匹配能力。* 匹配一个单词(以 . 为分隔符),# 匹配零个或多个单词。举个例子,订单事件包含 order.create、order.pay、order.cancel。如果某个队列绑定了 order.*,它能收到所有订单相关事件;如果绑定了 #.pay,它能收到所有支付相关事件;如果绑定了 order.#,它能收到 order.create.success 这种多级事件。Topic 是最灵活但也是初学者最容易配错的交换机,需要在实际使用中多调试。
四、SpringBoot 整合与最佳实践
4.1 基础整合配置
SpringBoot 对 RabbitMQ 的封装非常完善,引入 spring-boot-starter-amqp 后,只需要在配置文件中填写连接信息即可。
spring:
rabbitmq:
host: 192.168.1.100
port: 5672
username: admin
password: Admin@2026
virtual-host: order–prod
connection-timeout: 5000
requested-heartbeat: 30
核心组件 RabbitTemplate 会被自动注入,它封装了发送消息的所有操作。@RabbitListener 注解则提供了声明式的消息消费能力。
4.2 消息转换器的改造
默认的 SimpleMessageConverter 只支持 String、byte[] 和 Serializable 对象。如果直接发送一个 POJO,它会尝试使用 Java 序列化,这不但效率低下,而且接收方也必须使用 Java 语言才能反序列化。
更好的方案是使用 Jackson2JsonMessageConverter,将对象序列化为 JSON 格式。
@Configuration
public class MqConfig {
@Bean
public MessageConverter messageConverter() {
ObjectMapper mapper = new ObjectMapper()
.configure(DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES, false)
.registerModule(new JavaTimeModule());
return new Jackson2JsonMessageConverter(mapper);
}
}
配置完成后,生产者可以直接发送 Java 对象:
rabbitTemplate.convertAndSend("order.exchange", "order.create", order);
消费者也可以直接接收 Java 对象:
@RabbitListener(queues = "order.queue")
public void handleOrder(Order order) {
// 直接使用 order 对象
}
JSON 序列化的另一个好处是:消息体是纯文本,可以在管理控制台直接查看内容,方便调试。
4.3 队列和交换机的声明策略
在 SpringBoot 中,队列、交换机、绑定关系通常通过 @Configuration 类来声明。
@Configuration
public class RabbitDeclareConfig {
@Bean
public Queue orderQueue() {
return QueueBuilder.durable("order.queue")
.withArgument("x-max-length", 10000)
.withArgument("x-message-ttl", 60000)
.build();
}
@Bean
public DirectExchange orderExchange() {
return new DirectExchange("order.direct", true, false);
}
@Bean
public Binding orderBinding(Queue orderQueue, DirectExchange orderExchange) {
return BindingBuilder.bind(orderQueue)
.to(orderExchange)
.with("order.create");
}
}
这里有一个常见的坑:当生产者和消费者分别声明同一个队列时,如果参数不一致(比如一个设置了 TTL,另一个没设置),Broker 会抛出 PRECONDITION_FAILED 异常。
解决方案是:把队列声明放在消费者端,因为消费者启动时一定会执行声明逻辑,而生产者只负责发送消息。
更稳妥的做法是:所有队列、交换机的声明都放在一个独立的配置类中,由运维或架构组统一管理,避免不同团队各自声明导致参数冲突。
4.4 同步代码的异步改造
改造前的订单创建代码可能是这样的:
@Transactional
public void createOrder(Order order) {
orderDao.save(order);
inventoryClient.deductStock(order.getSkuId(), order.getCount());
pointsClient.addPoints(order.getUserId(), order.getPoints());
smsClient.send(order.getPhone(), "订单创建成功");
}
改造后的代码:
@Transactional
public void createOrder(Order order) {
orderDao.save(order);
// 发送 MQ 消息,必须在事务提交之后执行
TransactionSynchronizationManager.registerSynchronization(
new TransactionSynchronization() {
@Override
public void afterCommit() {
rabbitTemplate.convertAndSend("order.exchange", "order.create", order);
}
}
);
}
这里有一个非常关键的细节:为什么要在事务提交后才发送消息?
假设先发送消息再提交事务,如果事务提交失败了,消息已经发出去了,下游消费者会拿到一个不存在的数据,导致数据不一致。反过来,先提交事务再发送消息,如果消息发送失败,至少数据库是正确的,可以通过定时任务或补偿机制来修复。
Spring 提供的 TransactionSynchronization 机制可以完美解决这个问题:afterCommit() 方法只在事务成功提交后才会执行。
五、生产级可靠性保障
5.1 消息丢失的三个环节
消息从生产到消费,要经历三个环节,每个环节都可能丢失消息:
针对这三个环节,需要分别采取措施。
5.2 生产者确认机制
生产者确认分为两层:Confirm 和 Return。
Confirm 机制确保消息到达了 Broker。生产者发送消息后,Broker 会异步回调一个 ACK,告知消息是否成功接收。如果回调的是 NACK,则说明消息丢失了,需要重发或记录日志。
Return 机制确保消息被正确路由到了队列。如果交换机无法将消息路由到任何队列(比如 RoutingKey 配错了),Broker 会触发 Return 回调,将消息返回给生产者。
配置如下:
spring:
rabbitmq:
publisher-confirm-type: correlated
publisher-returns: true
template:
mandatory: true
回调实现:
@Component
public class MqCallback implements RabbitTemplate.ConfirmCallback, RabbitTemplate.ReturnCallback {
@Override
public void confirm(CorrelationData correlationData, boolean ack, String cause) {
if (ack) {
log.info("消息确认成功,ID: {}", correlationData.getId());
} else {
log.error("消息确认失败,原因: {}", cause);
// 落库记录失败消息,定时重发
}
}
@Override
public void returnedMessage(Message message, int replyCode, String replyText,
String exchange, String routingKey) {
log.error("消息路由失败,exchange: {}, routingKey: {}", exchange, routingKey);
// 路由失败的消息可以重新发送到正确的交换机
}
}
每条消息发送时带上唯一的 CorrelationData ID,方便在回调中定位具体是哪条消息。
5.3 消息持久化
持久化分成三层:
- 交换机持久化:声明时设置 durable=true,Broker 重启后交换机仍然存在。
- 队列持久化:声明时设置 durable=true,Broker 重启后队列仍然存在。
- 消息持久化:发送时设置 DeliveryMode.PERSISTENT,消息会被写入磁盘。
这三层缺一不可。如果交换机或队列是非持久化的,重启后它们就消失了,即使消息设置了持久化也找不到容器来存放。如果消息是非持久化的,Broker 重启后内存中的消息全部丢失。
需要注意的是,持久化会带来一定的性能损耗。根据官方测试数据,开启持久化后 TPS 大约下降 30%~50%。对于非关键业务(比如日志收集),可以关闭持久化来换取更高的吞吐量。
5.4 Lazy Queue 惰性队列
默认情况下,RabbitMQ 会把消息尽量保存在内存中,以提高消费速度。但当消息积压超过内存阈值时,会触发**换页(Page Out)**操作,将内存中的消息换页到磁盘。这个过程中,Broker 的性能会剧烈波动,甚至出现"换页风暴"。
Lazy Queue 的设计理念正好相反:消息直接写入磁盘,内存中只缓存少量消息供消费者拉取。这样做的代价是消费速度略慢(磁盘读取 vs 内存读取),但好处是性能极其稳定,不会出现换页导致的抖动。
对于秒杀、大促这种流量洪峰场景,Lazy Queue 是必选项。声明方式如下:
@Bean
public Queue lazyQueue() {
return QueueBuilder.durable("lazy.queue")
.withArgument("x-queue-mode", "lazy")
.build();
}
也可以通过策略全局启用,匹配所有以 lazy. 开头的队列:
rabbitmqctl set_policy Lazy "^lazy\\." '{"queue-mode":"lazy"}' –apply-to queues
5.5 消费者手动确认
自动 ACK 模式下,消费者拉取消息后立即向 Broker 发送确认,此时即使业务处理失败了,消息也已经从队列中删除,无法找回。
手动 ACK 是防止业务处理失败导致消息丢失的唯一正确做法。
配置:
spring:
rabbitmq:
listener:
simple:
acknowledge-mode: manual
prefetch: 1
代码实现:
@RabbitListener(queues = "order.queue")
public void handle(Order order, Channel channel,
@Header(AmqpHeaders.DELIVERY_TAG) long tag) {
try {
orderService.process(order);
// 处理成功,确认消息
channel.basicAck(tag, false);
} catch (Exception e) {
log.error("处理失败", e);
// 处理失败,拒绝并重新入队
channel.basicNack(tag, false, true);
}
}
basicNack 的第三个参数 requeue 表示是否重新入队。设置为 true 时,消息会回到队列头部,被再次消费。如果业务逻辑中有不可恢复的错误(比如数据校验失败),应该设置为 false,并把消息转入死信队列等待人工处理。
5.6 失败重试与死信
SpringBoot 提供了基于 Spring Retry 的重试机制:
spring:
rabbitmq:
listener:
simple:
retry:
enabled: true
max-attempts: 3
initial-interval: 1000
multiplier: 2
max-interval: 10000
重试 3 次后仍然失败,默认会抛出 AmqpRejectAndDontRequeueException,消息被直接丢弃。
更好的做法是:重试耗尽后,将消息转入死信队列,由运维人员介入处理。
@Bean
public RetryOperationsInterceptor retryInterceptor() {
return RetryInterceptorBuilder.stateless()
.maxAttempts(3)
.backOffOptions(1000, 2.0, 10000)
.recoverer((message, cause) -> {
// 重试失败后转入死信
rabbitTemplate.send("dlx.exchange", "dlx.key", message);
})
.build();
}
死信交换机是一个普通的交换机,只是用于接收处理失败的消息。运维人员可以写一个专门的管理后台,从死信队列中读取消息,分析失败原因,手动重放。
六、业务幂等性设计
6.1 重复消费的根源
消息重复消费的原因主要有两个:
重复消费本身不是 MQ 的 bug,而是分布式系统中为了可靠性而不得不接受的副作用。我们要做的是让业务逻辑在面对重复消息时保持正确。
6.2 三种幂等方案
方案一:数据库唯一约束
这是最简单也最可靠的方案。在业务表中建立唯一索引,比如订单支付记录表中,order_id 设置为唯一索引。第二次插入相同 order_id 的记录时,数据库会抛出重复键异常,业务代码捕获异常后直接返回成功。
这种方案的缺点是:只适用于 insert 操作,不适用于 update 操作。
方案二:Redis 去重
在业务处理前,使用 Redis 的 SETNX 命令设置一个键,键名为业务唯一标识(如 pay:order:12345),键值为当前时间戳,设置过期时间(如 300 秒)。
如果 SETNX 返回 1,说明这条消息第一次被处理,执行业务逻辑。如果返回 0,说明已经处理过了,直接忽略。
这种方案的优点是不依赖数据库,性能很高。缺点是需要额外维护 Redis 的高可用。
方案三:状态机校验
对于有状态流转的业务,可以通过校验当前状态来决定是否处理。比如订单状态从 待支付 → 已支付,如果收到重复的支付成功消息,发现订单状态已经是 已支付,直接忽略。
@RabbitListener(queues = "order.pay.queue")
public void handlePay(OrderPayEvent event) {
Order order = orderDao.selectById(event.getOrderId());
// 状态机校验:只有待支付状态才处理
if (order.getStatus() != OrderStatus.PENDING) {
log.info("订单状态不是待支付,忽略重复消息");
return;
}
// 执行业务逻辑
orderService.paySuccess(order);
}
实际生产环境通常会组合使用多种方案:Redis 去重作为第一道防线,状态机校验作为第二道防线,数据库唯一约束作为最后的兜底。
七、延迟消息与超时订单取消
7.1 业务场景与实现思路
延迟消息是 RabbitMQ 的高级特性之一,最常见的场景是订单超时自动取消:用户下单后 30 分钟内未支付,系统自动取消订单并释放库存。
实现延迟消息有两种主流方案:死信交换机(DLX)和延迟消息插件。
7.2 死信交换机方案
死信交换机的原理是:消息发送到一个普通队列,并设置消息的 TTL(生存时间)。TTL 到期后,消息变为"死信",自动转入预先绑定的死信交换机,最终进入死信队列。消费者监听死信队列,处理过期消息。
配置方式:
@Bean
public Queue normalQueue() {
return QueueBuilder.durable("normal.queue")
.withArgument("x-message-ttl", 30 * 60 * 1000) // 30 分钟
.withArgument("x-dead-letter-exchange", "dlx.exchange")
.withArgument("x-dead-letter-routing-key", "dlx.key")
.build();
}
@Bean
public Queue dlxQueue() {
return QueueBuilder.durable("dlx.queue").build();
}
@Bean
public DirectExchange dlxExchange() {
return new DirectExchange("dlx.exchange");
}
死信方案有两个缺陷:
7.3 延迟消息插件
延迟消息插件(rabbitmq-delayed-message-exchange)解决了死信方案的所有缺陷。它的原理是:消息发送到特殊的延迟交换机后,先存储在 Mnesia 数据库中,到指定时间后再投递到目标队列。
插件安装:
wget https://github.com/rabbitmq/rabbitmq-delayed-message-exchange/releases/download/v3.13.0/rabbitmq_delayed_message_exchange-3.13.0.ez
mv rabbitmq_delayed_message_exchange-3.13.0.ez /plugins/
rabbitmq-plugins enable rabbitmq_delayed_message_exchange
声明延迟交换机:
@Bean
public CustomExchange delayedExchange() {
return new CustomExchange(
"delayed.exchange",
"x-delayed-message",
true,
false,
Map.of("x-delayed-type", "direct")
);
}
发送延迟消息:
MessagePostProcessor processor = msg -> {
msg.getMessageProperties().setDelay(30 * 60 * 1000); // 延迟 30 分钟
return msg;
};
rabbitTemplate.convertAndSend("delayed.exchange", "order.cancel", orderId, processor);
消费延迟消息:
@RabbitListener(queues = "delay.cancel.queue")
public void handleOrderCancel(Long orderId) {
Order order = orderDao.selectById(orderId);
if (order == null || order.getStatus() != OrderStatus.PENDING) {
return;
}
// 取消订单,释放库存
order.setStatus(OrderStatus.CANCELLED);
orderDao.updateById(order);
inventoryService.restoreStock(order.getSkuId());
log.info("超时订单取消成功: {}", orderId);
}
延迟消息插件的优势非常明显:每条消息可以独立设置延迟时间,没有队头阻塞问题,重启后消息不丢失。
7.4 兜底补偿机制
无论采用哪种方案,延迟消息都存在丢失的风险(网络问题、插件故障等)。因此,定时任务扫描是最重要的兜底保障。
@Component
public class OrderTimeoutScanTask {
@Scheduled(cron = "0 */5 * * * ?") // 每 5 分钟执行一次
public void scanTimeoutOrders() {
LocalDateTime timeout = LocalDateTime.now().minusMinutes(30);
List<Order> orders = orderDao.selectPendingBefore(timeout);
for (Order order : orders) {
orderService.cancelOrder(order.getId(), "超时自动取消");
}
log.info("超时订单扫描完成,共取消 {} 单", orders.size());
}
}
定时任务作为最后的防线,确保即使 MQ 完全不可用,订单也不会无限期处于待支付状态。
写在最后
RabbitMQ 的入门门槛并不高,跑通一个 Demo 只需要十几分钟。但真正把它用好、用稳,需要理解它背后的设计哲学:AMQP 协议的分层设计、Exchange 和 Queue 的解耦、Confirm/Return 的双层确认、以及各类保障消息不丢的机制。