/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
一.队列数据管理
当前队列数据的管理,本质上是队列描述信息的管理,描述当前服务器上有哪些队列。
- 定义队列描述数据类
- 定义队列数据持久化类(数据持久化的 sqlite3 数据库中)
- 定义队列数据管理类
因为这一篇的内容和上一篇很像,所以我就不再过多赘述,咱们直接上代码:
三者之间的关系:
MsgQueueManager
├─ 持有 MsgQueueMapper
├─ 持有 QueueMap(内存集合,装的是 MsgQueue::ptr)
└─ 用 MsgQueue
MsgQueueMapper
├─ 持有 SqliteHelper
└─ 用 MsgQueue
MsgQueue
└─ 谁都不依赖
依赖是单向的:Manager –> Mapper –> SqliteHelper,三者都用到 MsgQueue。
分工:
| MsgQueue | 数据长什么样 |
| MsgQueueMapper | 数据怎么进出数据库 |
| MsgQueueManager | 数据在内存里怎么管 |
二.代码展现:
1.mq_queue.hpp
MsgQueue类
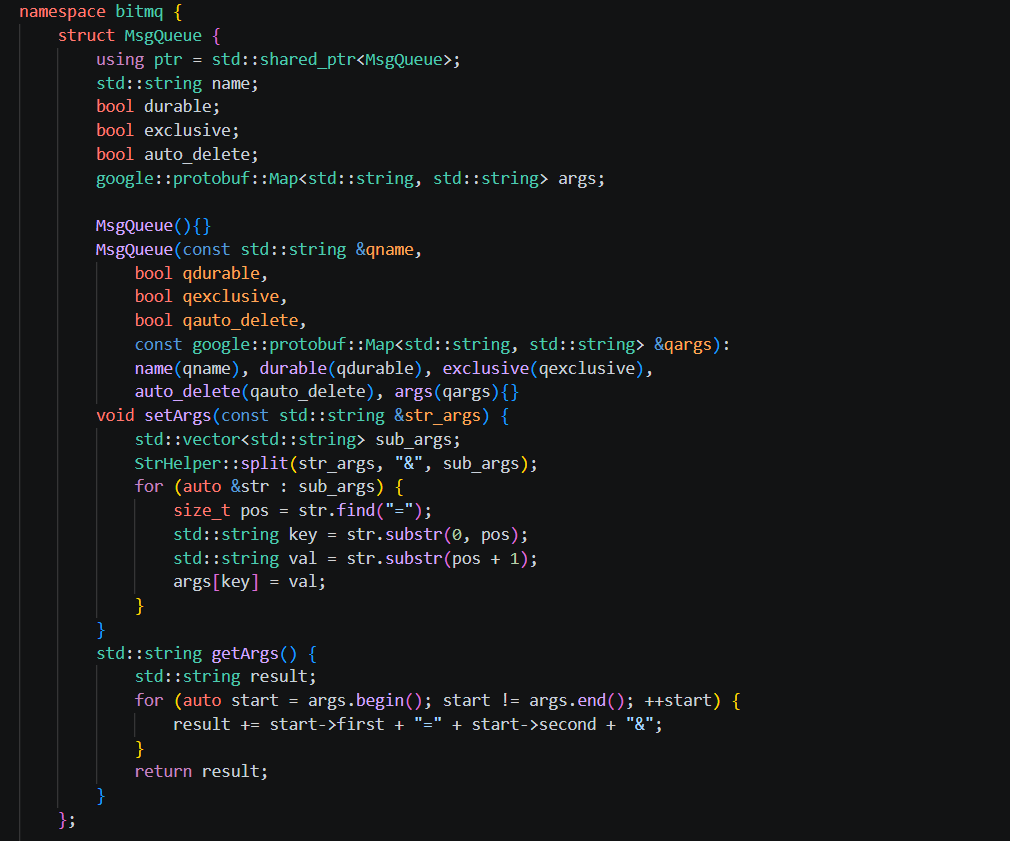
1.这个类是干什么的
它定义"一条队列记录长什么样"。打个比方 —— 它就像一张表格的"表头":
┌──────────┬─────────┬───────────┬─────────────┬──────┐
│ name │ durable │ exclusive │ auto_delete │ args │
├──────────┼─────────┼───────────┼─────────────┼──────┤
│ queue1 │ 1 │ 0 │ 0 │k1=v1&│
│ queue2 │ 1 │ 0 │ 0 │k1=v1&│
└──────────┴─────────┴───────────┴─────────────┴──────┘
↑ ↑ ↑ ↑ ↑
这五个就是 MsgQueue 里的五个成员
它只描述"有哪些字段",不负责存、不负责查 —— 存和查是另外两个类的事。
2.五个成员
using ptr = std::shared_ptr<MsgQueue>;
std::string name; // ①
bool durable; // ②
bool exclusive; // ③
bool auto_delete; // ④
google::protobuf::Map<std::string, std::string> args; // ⑤
using ptr = std::shared_ptr<MsgQueue>;
这不是成员,是给类型起个短名字。
// 不用别名
std::shared_ptr<MsgQueue> q1;
std::unordered_map<std::string, std::shared_ptr<MsgQueue>> mymap;
// 用别名
MsgQueue::ptr q1;
std::unordered_map<std::string, MsgQueue::ptr> mymap;
为什么用 shared_ptr 而不是直接存对象:
因为队列对象要被多个地方同时用到,用智能指针可以共享,而且不用担心"谁负责释放"。
① std::string name —— 队列名字
std::string name; // 比如 "queue1"
每个队列必须有个唯一的名字,就像每个人的身份证号一样。
它后面会当数据库的主键用:
create table queue_table(
name varchar(32) primary key, — 主键 = 不允许重复
…
);
② bool durable —— 是否持久化
bool durable; // true 或 false
含义:
true –> 这个队列要存进数据库,重启后还在
false –> 只活在内存里,程序一关就没了
打个比方理解就是:
durable = true –> 写在纸上的笔记,撕不掉
durable = false –> 写在黑板上的字,一擦就没
③ bool exclusive —— 是否独占
bool exclusive; // 这是队列独有的字段
含义:这个队列只允许一个连接使用 —— 别的连接想访问它会被拒绝。
典型用途:一个客户端临时创建的私有队列,用完就扔。
注意:交换机(Exchange)没有这个字段 —— 这是队列特有的。
④ bool auto_delete —— 是否自动删除
bool auto_delete;
含义:当最后一个使用它的连接断开时,自动把这个队列删掉。
典型场景:客户端临时建个队列收结果,断开后不想留垃圾,就设成 true。
⑤ args —— 其他参数
google::protobuf::Map<std::string, std::string> args;
这是一个"键值对表",用来存一些不确定的参数:
args["最大长度"] = "1000";
args["消息存活时间"] = "60000";
为什么用 Map 而不是多加几个成员:
因为"其他参数"是不确定的
–> 今天想加"最大长度",明天想加"优先级"
–> 如果每个都加个成员,代码要一直改
–> 用一个 map,爱放什么放什么
踩的坑:这个 Map 是 google::protobuf::Map,不是 std::unordered_map。
// 编译不过
std::unordered_map<std::string, std::string> args;
// 必须用这个
google::protobuf::Map<std::string, std::string> args;
因为它在 .proto 文件里定义成 map<string, string>,protoc 生成的就是这个类型。
3.两个构造函数
// ① 默认构造:什么都不传
MsgQueue(){}
// ② 带参构造:一次把 5 个字段全填上
MsgQueue(const std::string &qname,
bool qdurable,
bool qexclusive,
bool qauto_delete,
const google::protobuf::Map<std::string, std::string> &qargs):
name(qname), durable(qdurable), exclusive(qexclusive),
auto_delete(qauto_delete), args(qargs){}
为什么要两个
它们服务两个不同场景:
场景 A:从数据库读出来时 –> 用默认构造
// 数据库里读出来的是一个个字符串:
// row[0] = "queue1"
// row[1] = "1"
// row[2] = "0"
// row[3] = "0"
// row[4] = "k1=v1&"
// 没法一次性塞进构造函数(还得把 "1" 转成 true)
// 所以先造个空壳,再一个个字段填:
MsgQueue::ptr mqp = std::make_shared<MsgQueue>(); // <– 默认构造
mqp->name = row[0];
mqp->durable = (bool)std::stoi(row[1]); // 字符串 –> int –> bool
mqp->exclusive = (bool)std::stoi(row[2]);
mqp->auto_delete = (bool)std::stoi(row[3]);
if (row[4]) mqp->setArgs(row[4]);
场景 B:业务代码里创建时 –> 用带参构造
// 所有值都齐了,一次构造最干净
MsgQueue::ptr mqp = std::make_shared<MsgQueue>(qname, qdurable, qexclusive, qauto_delete, qargs);
两个命名细节:
① 参数名都加了 q 前缀(qname、qdurable…)
为什么:参数名不能和成员名重名。
// 如果不加前缀
MsgQueue(const std::string &name, …) : name(name) {}
// ↑ ↑
// 成员 参数 ← 分不清
用 qname 就一目了然:name(qname) = "用参数 qname 初始化成员 name"。
② 冒号后面那一串叫"初始化列表"
: name(qname), durable(qdurable), exclusive(qexclusive),
auto_delete(qauto_delete), args(qargs){}
// ↑
// 函数体是空的
含义:"在进函数体之前,先把这几个成员初始化好。"
函数体为什么是空的 —— 因为该做的都在初始化列表里做完了,没别的事。
为什么 MsgQueue(){} 不能删
C++ 有一条规则:
只要你写了任何一个构造函数,编译器就不再自动生成"默认构造函数"。
删掉 MsgQueue(){} 之后:
MsgQueue::ptr mqp = std::make_shared<MsgQueue>(); <– 编译报错!
(因为编译器找不到"无参数"的构造函数了)
所以两个都得留着。
4.setArgs —— 字符串 –> map
void setArgs(const std::string &str_args) {
std::vector<std::string> sub_args;
StrHelper::split(str_args, "&", sub_args); // ① 按 & 切
for (auto &str : sub_args) { // ② 逐个处理
size_t pos = str.find("="); // ③ 找 =
std::string key = str.substr(0, pos); // ④ = 左边是 key
std::string val = str.substr(pos + 1); // ⑤ = 右边是 val
args[key] = val; // ⑥ 存进 map
}
}
把 "k1=v1&k2=v2&" 这种字符串,拆回成 map。
逐步演示(假设 str_args = "k1=v1&k2=v2&"):
第 ① 步:按 & 切
"k1=v1&k2=v2&" → ["k1=v1", "k2=v2"]
第 ②~⑥ 步:循环处理每一段
处理 "k1=v1":
find("=") → 2
substr(0, 2) → "k1" (key)
substr(3) → "v1" (val)
args["k1"] = "v1"
处理 "k2=v2":
args["k2"] = "v2"
最后 args = {"k1":"v1", "k2":"v2"}
这里有个隐患
size_t pos = str.find("=");
std::string key = str.substr(0, pos); // 没有 "=" 会怎样?
std::string val = str.substr(pos + 1);
如果某一段里没有 =(比如脏数据是 "abc"):
pos = std::string::npos (一个特殊值,表示"没找到")
key = str.substr(0, npos) = 整个字符串 "abc"
val = str.substr(npos + 1)
= str.substr(0) (npos+1 溢出变成 0)
= 又是整个字符串 "abc"
结果:args["abc"] = "abc" ← [错误数据被悄悄写进去了]
不会崩溃,只是数据错了 —— 这种 bug 最难查。
改法是是补一行判断:
size_t pos = str.find("=");
if (pos == std::string::npos) continue; // 没有 "=",跳过这一段
5.getArgs —— map –> 字符串
std::string getArgs() {
std::string result;
for (auto start = args.begin(); start != args.end(); ++start) {
result += start->first + "=" + start->second + "&";
}
return result;
}
把 map 拼回成 "k1=v1&k2=v2&" 这种字符串。
逐步演示(假设 args = {"k1":"v1", "k2":"v2"}):
第 1 轮:result = "" + "k1" + "=" + "v1" + "&" = "k1=v1&"
第 2 轮:result = "k1=v1&" + "k2=v2&" = "k1=v1&k2=v2&"
返回 "k1=v1&k2=v2&"
这个 for 循环写法的解释(新手可能不熟):
for (auto start = args.begin(); start != args.end(); ++start)
// 迭代器:指向第一个元素 不是末尾就继续 指向下一个
start->first 是 key,start->second 是 value —— map 里每个元素是一个 pair<key, value>。
两个要注意的
① 末尾会多一个 &
代码块
"k1=v1&k2=v2&"
↑ 多了一个
这不是 bug —— 因为 setArgs 里是按 & 切分并跳过空段的,能正确解析回来。
② 遍历顺序不保证
args 是【哈希表】
-> 遍历顺序和插入顺序无关
->可能是 "k1=v1&k2=v2&"
->也可能是 "k2=v2&k1=v1&"
所以测试的时候,不要直接比对整个字符串,要解析回来按 key 验证。
6.图解
【内存里的样子】 【数据库里的样子】
args(map) args 列(字符串)
┌──────────────┐ ┌──────────────────┐
│ "k1" → "v1" │ ──getArgs()──> │ "k1=v1&k2=v2&" │
│ "k2" → "v2" │ │ │
└──────────────┘ <──setArgs()── └──────────────────┘
为什么要来回转换:
因为数据库里【存不了 map】,只能存字符串
–> 要存进去:map → 字符串 (getArgs)
–> 要读出来:字符串 → map (setArgs)
这一对函数必须严格配对 —— 一个拼出来的格式,另一个必须能解回去。
MsgQueueMapper类
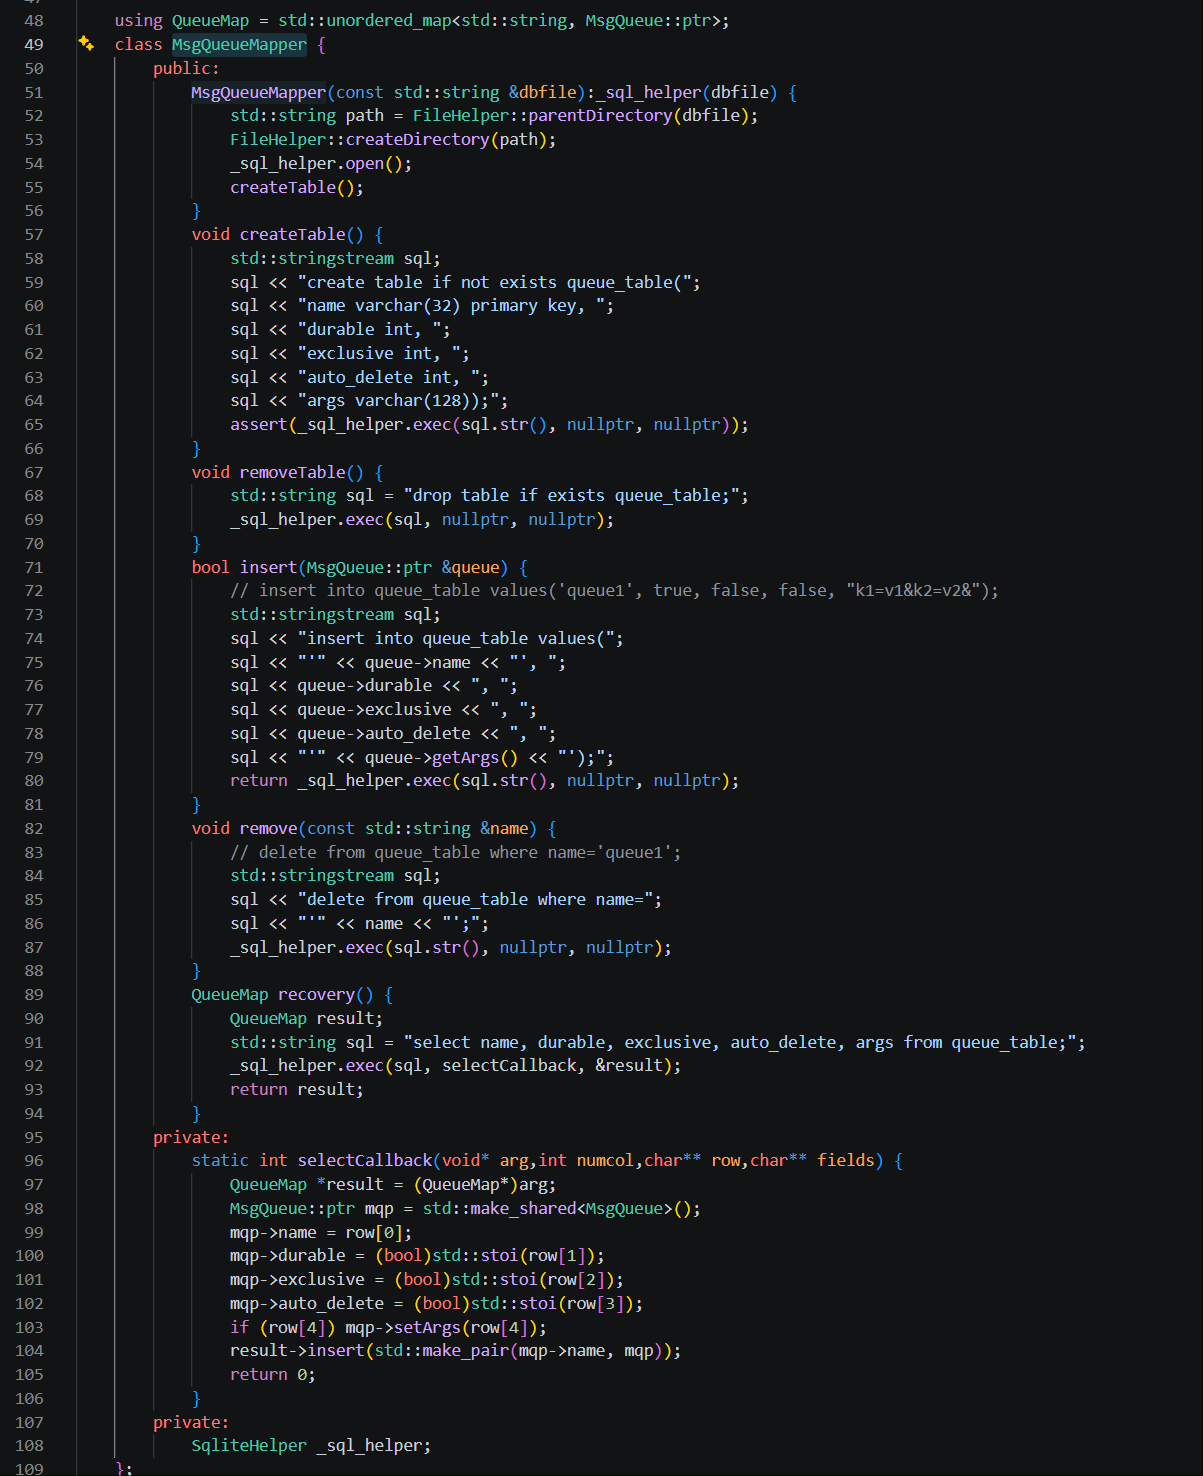
MsgQueueMapper 是怎么和数据库打交道的
1.这个类的定
MsgQueueMapper 的职责很纯粹:它只管数据库,不知道内存里有什么。
七个函数,分成三组:
【铺地基】 构造函数、createTable、removeTable
【一条条】 insert、remove
【一次搬完】recovery + selectCallback
2.铺地基:构造函数
MsgQueueMapper(const std::string &dbfile) : _sql_helper(dbfile) {
std::string path = FileHelper::parentDirectory(dbfile);
FileHelper::createDirectory(path);
_sql_helper.open();
createTable();
}
四步,顺序不能乱:
① 取出目录 "./data/meta.db" –> "./data"
② 建出目录 目录不存在的话,SQLite 打不开文件
③ 打开数据库
④ 建表
为什么要先建目录?
SQLite 打开文件:
文件不存在 → 可以自动创建
但【目录】不存在 → 直接失败
这就是前面写的 FileHelper 派上用场的地方。
注意:_sql_helper.open() 的返回值没有被检查 —— 打开失败也不会报错,后面全崩。 更稳的写法是:
if (!_sql_helper.open()) {
DLOG("打开数据库失败!");
abort();
}
3.建表 / 删表
void createTable() {
std::stringstream sql;
sql << "create table if not exists queue_table(";
sql << "name varchar(32) primary key, ";
sql << "durable int, ";
sql << "exclusive int, ";
sql << "auto_delete int, ";
sql << "args varchar(128));";
assert(_sql_helper.exec(sql.str(), nullptr, nullptr));
}
用 stringstream 一段段拼 SQL,拼出来是这样:
create table if not exists queue_table(
name varchar(32) primary key,
durable int,
exclusive int,
auto_delete int,
args varchar(128));
字段设计的三点考虑
① name 做主键 —— 保证队列名唯一,这也是 declareQueue 幂等的基础。
② 三个 bool 用 int 存 —— 因为 SQLite 没有 bool 类型,只有 NULL / INTEGER / REAL / TEXT / BLOB 五种存储类,所以用 0/1 代替。
③ args 存字符串 —— 因为 map 存不进数据库,得先序列化成 "k1=v1&"。
4.一条条进出:insert 和 remove
insert
bool insert(MsgQueue::ptr &queue) {
std::stringstream sql;
sql << "insert into queue_table values(";
sql << "'" << queue->name << "', ";
sql << queue->durable << ", ";
sql << queue->exclusive << ", ";
sql << queue->auto_delete << ", ";
sql << "'" << queue->getArgs() << "');";
return _sql_helper.exec(sql.str(), nullptr, nullptr);
}
拼出来的 SQL:
insert into queue_table values('queue1', 1, 0, 0, 'k1=v1&');
// 加引号 数字不加引号
两条规则:
字符串字段 → 两端加单引号 'queue1'
数字字段 → 不加引号 1
getArgs() 的作用:把 args 这个 map 序列化成字符串 —— 因为 map 存不进数据库。
返回值直接透传,上层就能判断落盘成没成功:
bool ret = _mapper.insert(mqp);
if (ret == false) return false;
remove
void remove(const std::string &name) {
std::stringstream sql;
sql << "delete from queue_table where name=";
sql << "'" << name << "';";
_sql_helper.exec(sql.str(), nullptr, nullptr);
}
拼出来:delete from queue_table where name='queue2';
为什么返回 void:
删一条不存在的记录,SQL 也算"成功"(只是影响 0 行),报错意义不大。
代价是信息丢失:
if (it->second->durable == true) _mapper.remove(name);
_msg_queues.erase(name); // 无论数据库删没删成功,内存都删了
两次出现的 nullptr
_sql_helper.exec(sql, nullptr, nullptr);
// ↑ ↑
// 回调函数 传给回调的数据
为什么传空:
insert 和 remove 只是"执行一个动作",没有查询结果 —— 不需要逐行通知,也就没有东西要传给回调。
5.一次搬完:recovery 和 selectCallback
这一组是整个类里最绕的,单独讲。
问题:SQLite 为什么不直接返回一个列表
因为它是 C 库 —— C 里没有 vector、没有 map,它不知道你想把数据存成什么样。
所以它换了个办法:
"我一行一行地读,每读到一行就喊你一声,你自己决定怎么放。"
那个"喊你一声",就是回调。
打个比方
你让搬运工去仓库取货,但你没手拿
→ 约定:"你搬一个出来就喊我一声,我自己接过来放车上"
搬出第 1 个 → "第一个来了!" → 你接过来(车上 1 个)
搬出第 2 个 → "第二个来了!" → 你接过来(车上 2 个)
搬完了 → "没了"
最后车上就有 2 个箱子
搬运工 = sqlite3_exec,喊你一声 = 回调,你的车 = 那个 result 容器。
调用方 recovery
QueueMap recovery() {
QueueMap result; // ① 准备箱子
std::string sql = "select name, durable, exclusive, auto_delete, args from queue_table;";
_sql_helper.exec(sql, selectCallback, &result); // ② 把箱子地址交出去
return result; // ③ 返回装满的箱子
}
注意第 ② 步传的是 &result(地址),不是 result —— 因为要把它交给回调去填。
被回调方 selectCallback
static int selectCallback(void* arg, int numcol, char** row, char** fields) {
QueueMap *result = (QueueMap*)arg; // ① 把箱子认回来
MsgQueue::ptr mqp = std::make_shared<MsgQueue>(); // ② 造一个空对象
mqp->name = row[0]; // ③ 逐列填
mqp->durable = (bool)std::stoi(row[1]);
mqp->exclusive = (bool)std::stoi(row[2]);
mqp->auto_delete = (bool)std::stoi(row[3]);
if (row[4]) mqp->setArgs(row[4]); // ④ 有 args 才解析
result->insert(std::make_pair(mqp->name, mqp)); // ⑤ 装进箱子
return 0; // ⑥ 继续读下一行
}
几个必须理解的点:
① arg 为什么要 cast
sqlite3 是 C 库,只认识 void*(万能指针)
→ 交出去时,它只看到"一个地址",不知道指向什么
→ 回调里你自己知道传的是什么,所以自己转回来
② 为什么用"默认构造 + 逐字段填"
因为数据是一条条字符串读出来的,还得 stoi 转换、判断空值 —— 没法一次塞进构造函数。
③ (bool)std::stoi(row[1]) 这条转换链
row[1] = "1"
↓ stoi() 字符串 → int 得到 1
↓ (bool) int → bool 得到 true
④ if (row[4]) 为什么必须判空
SQLite 对值为 NULL 的列,会传一个空指针进来 —— 不判断就会崩。
⑤ return 0 是什么意思
返回 0 → 告诉 SQLite"继续读下一行"
返回非 0 → sqlite3_exec 立即中止
最容易错的一点:row[] 的下标
下标由 select 的字段顺序决定,不是由建表顺序决定:
select name, durable, exclusive, auto_delete, args
↑0 ↑1 ↑2 ↑3 ↑4
↓ 一一对应
row[0] → mqp->name
row[1] → mqp->durable
row[2] → mqp->exclusive
row[3] → mqp->auto_delete
row[4] → mqp->setArgs(…)
改了 SQL 的字段顺序,必须同步改回调里的下标 —— 而且错了不会崩溃,只会"静默地把字段搞混",最难查。
6.一条规律
七个函数虽然长得不一样,但有一句话能概括:
有查询结果 → 传 &result + 写回调 (只有 recovery)
只执行动作 → 传 nullptr,不写回调 (createTable / removeTable / insert / remove)
因为"执行动作"没有数据要收,"查询"才需要逐行通知。
7.小结
MsgQueueMapper 做三件事:
① 铺地基 建目录 → 开数据库 → 建表
② 一条条存取 insert / remove,把对象拼成 SQL
③ 一次搬完 recovery,用回调把整张表变成内存对象
它不知道内存里有什么 —— 那本账由 MsgQueueManager 管。
MsgQueueManager类
理解起来就是:内存和数据库的"总指挥"
1.这个类的定位
三层结构里,它是最上面那层,它手里握着两样东西:
private:
std::mutex _mutex; // 一把锁(并发控制)
MsgQueueMapper _mapper; // 数据库那一侧
QueueMap _msg_queues; // 内存这一侧(一本账)
它要做的,就是让"内存这本账"和"数据库那张表"始终对得上。
七个函数,分成两组:
【写操作】declareQueue、deleteQueue、clear
→ 内存 + 数据库,两边都要动
【读操作】selectQueue、allQueues、exists、size
→ 只查内存,一次磁盘 IO 都不做
这个"读写分离"就是整套设计的性能来源。
2.构造函数:启动即同步
MsgQueueManager(const std::string &dbfile) : _mapper(dbfile) {
_msg_queues = _mapper.recovery();
}
两句话,但背后发生了一连串事情:
① _mapper(dbfile) 构造持久化层
└─ 建目录 → 打开数据库 → 建表
② _mapper.recovery() 把数据库里的队列全部读出来
└─ 通过回调逐行读,最后返回一个 QueueMap
③ 装进 _msg_queues 内存这本账,填满了
执行完之后,状态是:
内存 _msg_queues ←→ 数据库 queue_table 两边一致
这一步的意义是什么?
服务器重启之后:
→ 数据库里还留着上次的队列
→ recovery() 把它们搬回内存
→ 客户端连上来,看到的是"数据还在"
这就是"持久化"这三个字的兑现时刻。
一个常被考的点:成员初始化的顺序由"声明顺序"决定,不是由初始化列表的书写顺序决定。
private:
std::mutex _mutex; // ① 先构造
MsgQueueMapper _mapper; // ② 再构造(有参)
QueueMap _msg_queues; // ③ 后构造(默认构造,空的)
所以 recovery() 必须写在函数体里 —— 因为要等 _mapper 构造完才能调它。
3.写操作:两边都要动
① declareQueue —— 声明队列
bool declareQueue(const std::string &qname, bool qdurable,
bool qexclusive, bool qauto_delete,
const google::protobuf::Map<std::string, std::string> &qargs) {
std::unique_lock<std::mutex> lock(_mutex); // 加锁
auto it = _msg_queues.find(qname);
if (it != _msg_queues.end()) {
return true; // 已存在就返回成功
}
MsgQueue::ptr mqp = std::make_shared<MsgQueue>(); // 造对象
mqp->name = qname;
mqp->durable = qdurable;
mqp->exclusive = qexclusive;
mqp->auto_delete = qauto_delete;
mqp->args = qargs;
if (qdurable == true) { // 有条件的落盘
bool ret = _mapper.insert(mqp);
if (ret == false) return false;
}
_msg_queues.insert(std::make_pair(qname, mqp)); // 入内存
return true;
}
这个函数里藏着三个设计决策,都值得说。
决策一:加锁
std::unique_lock<std::mutex> lock(_mutex);
原因:
_msg_queues 会被多个客户端线程同时访问 —— 服务器处理并发请求是常态。
为什么用 unique_lock 而不是手动 lock()/unlock():
unique_lock 出作用域自动解锁
→ 中途 return 也不会忘记解锁
→ 这就是 RAII:把"释放资源"这件事交给对象的析构函数
决策二:幂等
if (it != _msg_queues.end()) {
return true; // 已存在 → 返回【成功】,不是失败
}
"声明一个已经存在的队列"应该是成功,理由:
客户端可能因为网络重发、程序重连而重复声明
→ 每次都报错的话,客户端会很难写
→ 所以"已存在"就是"成功"
这和建表用 if not exists 是同一个思路 —— 一个操作执行多次,结果和执行一次一样,这就是幂等。
决策三:先落盘,再入内存
if (qdurable == true) {
bool ret = _mapper.insert(mqp);
if (ret == false) return false; // 落盘失败 → 直接返回,内存不动
}
_msg_queues.insert(std::make_pair(qname, mqp));
顺序很讲究:
先落盘,成功才入内存
→ 数据库和内存永远一致
如果反过来(先入内存,再落盘)
→ 落盘失败时,内存里多一条、数据库里没有 → 两边对不上
还有那个 if (qdurable == true):
durable = true → 写数据库(重启后还要用)
durable = false → 跳过(重启后反正会消失,没必要占空间)
一次 IO 都不浪费。
② deleteQueue —— 删除队列
void deleteQueue(const std::string &name) {
std::unique_lock<std::mutex> lock(_mutex);
auto it = _msg_queues.find(name);
if (it == _msg_queues.end()) {
return; // 不存在 → 直接返回
}
if (it->second->durable == true) _mapper.remove(name); // 有条件的删库
_msg_queues.erase(name); // 删内存
}
和 declareQueue 是对称的:
代码块
declare:先落盘 → 再入内存
delete :先删库 → 再删内存
顺序的道理一样:数据库先动,失败时内存还没动,状态仍然一致。
⚠️ 一个小遗憾:_mapper.remove() 返回 void,所以这里无法感知删除失败 —— 数据库删失败时,内存照样删了,两边会不一致。
在你这个场景下影响不大(删除基本不会失败),但要知道这个取舍。
③ clear —— 清空全部
void clear() {
std::unique_lock<std::mutex> lock(_mutex);
_mapper.removeTable(); // 删表
_mapper.createTable(); // ★ 立刻重建
_msg_queues.clear(); // 清内存
}
为什么删完要立刻重建:
removeTable() 执行的是 drop table(删表!)
→ 表【结构和数据】全没了
→ 如果后面还要用,必须重新建出来
不重建的后果:
→ 之后再 declareQueue → insert 报 "no such table"
→ 你在程序外面用 sqlite3 查表 → 也报 "no such table"
这个函数还有个"隐形用途":测试的 TearDown 里调它,保证每次跑测试都是干净起点。
4.读操作:只走内存
MsgQueue::ptr selectQueue(const std::string &name) {
std::unique_lock<std::mutex> lock(_mutex);
auto it = _msg_queues.find(name);
if (it == _msg_queues.end()) {
return MsgQueue::ptr(); // 没找到 → 返回空智能指针
}
return it->second; // 返回 shared_ptr 的【拷贝】
}
这四个读函数(selectQueue / allQueues / exists / size)都不碰数据库:
因为内存是数据库的【镜像】
→ 查内存 = 查数据库,但快几个数量级
→ 数据库只在"启动恢复"和"增删改"时才碰
selectQueue 为什么要返回 shared_ptr
这是整个类里最值得理解的一个设计。
函数一返回,锁就释放了
↓
如果是裸指针:
另一个线程可能立刻 deleteQueue(name)
→ 对象被销毁
→ 你手里的指针变成【悬空指针】
→ 一用就崩
返回 shared_ptr 的拷贝:
引用计数 +1
→ 即使 map 里那份被 erase
→ 你手里这份仍然有效
举个具体例子:
MsgQueue::ptr q = mgr->selectQueue("queue1");
// 此刻引用计数至少是 2(map 里一份 + q 一份)
// 另一个线程同时:
mgr->deleteQueue("queue1"); // map 里那份被 erase → 计数减 1 → 还剩 1
// 你继续用:
std::cout << q->name; // 安全对象还活着
这就是"智能指针延长生命周期"的价值 —— 它把锁的保护延伸到了函数外面。
allQueues 的取舍
QueueMap allQueues() {
std::unique_lock<std::mutex> lock(_mutex);
return _msg_queues; // 返回整个 map 的【拷贝】
}
这个函数返回的是"值",不是引用 —— 意味着一次完整的 map 拷贝,开销比前面几个大。
但换来的是安全:
如果返回引用:
锁一释放,别的线程改动 map → 你的引用随时可能失效
返回值拷贝:
拿到的是"那一刻的快照",完全独立
这个接口一般用在"需要遍历所有队列"的地方 —— 调用频率低,开销可以接受。
exists 和 size
bool exists(const std::string &name) {
std::unique_lock<std::mutex> lock(_mutex);
return _msg_queues.find(name) != _msg_queues.end();
}
size_t size() {
std::unique_lock<std::mutex> lock(_mutex);
return _msg_queues.size();
}
两个都是"只读",但都要加锁:
因为别的线程可能正在 declareQueue / deleteQueue
→ 不加锁读,可能读到"正在修改中"的值
exists 和 selectQueue 的区别:
selectQueue 返回 shared_ptr → 有引用计数开销(原子操作)
exists 只查"在不在" → 不产生对象拷贝,更轻
所以"只想知道在不在"的时候,用 exists 更划算。
5.三个值得记住的设计点
① 幂等
if (it != _msg_queues.end()) return true;
"已存在"不是错误,是成功。
② 先库后内存
// 增
if (durable) { if (!insert()) return false; }
_msg_queues.insert(…);
// 删
if (durable) remove(name);
_msg_queues.erase(name);
数据库先动,失败时内存还没动 → 两边始终一致。
③ unique_lock 自动解锁
std::unique_lock<std::mutex> lock(_mutex);
// …
return xxx; // 中途 return 也不会忘解锁
RAII 的价值:把"释放"交给析构函数。
6.图解
【写操作:两边都动】
declareQueue → _msg_queues +1,_mapper.insert
deleteQueue → _msg_queues -1,_mapper.remove
clear → _msg_queues 清空,_mapper 删表重建
【读操作:只走内存】
selectQueue / allQueues / exists / size
→ 只查 _msg_queues,不碰磁盘
【启动时对齐】
构造函数 → _mapper.recovery() → 把数据库搬进内存
归纳成一句话:
读操作只走内存(快),写操作两边同步(一致),启动时用 recovery() 把两边对齐。
七.小结
MsgQueueManager 七个函数,干的是同一件事:
让"内存这本账"和"数据库那张表"始终对得上
具体手段:
| 启动 | recovery() 把数据库搬进内存 |
| 增 | 先 insert 落盘,成功才入内存 |
| 删 | 先 remove 删库,再删内存 |
| 查 | 只读内存,不碰磁盘 |
| 并发 | 每个 public 函数第一个动作都是加锁 |
这也是三层结构"各司其职"的体现:
MsgQueue 只描述数据
MsgQueueMapper 只管数据库
MsgQueueManager 管内存 + 协调两边 ← 复杂度都在这一层
2.mq_queuetest.cpp
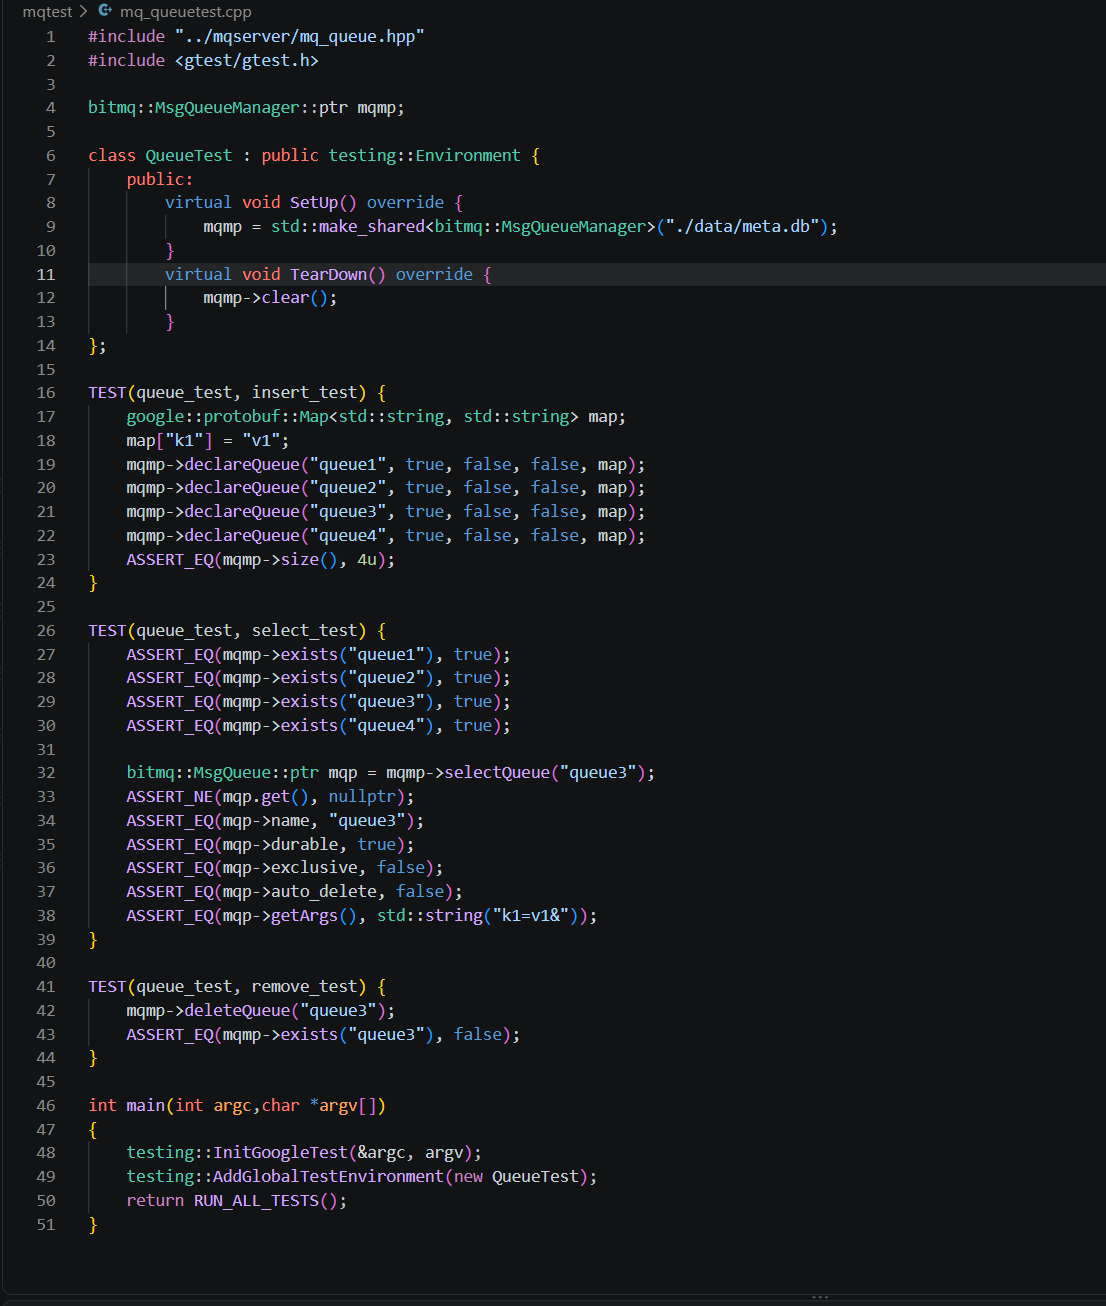
给队列模块写单元测试
1.这次测试要验证什么
队列模块提供了七个接口,测试的目标是把"增、查、删"这条主线走通:
declareQueue 增
exists / selectQueue 查
deleteQueue 删
三个用例,正好对应这三个动作。
2.先搭骨架:全局环境
bitmq::MsgQueueManager::ptr mqmp; // 全局的管理对象
class QueueTest : public testing::Environment {
public:
virtual void SetUp() override {
mqmp = std::make_shared<bitmq::MsgQueueManager>("./data/meta.db");
}
virtual void TearDown() override {
mqmp->clear();
}
};
为什么要用"全局环境"
关键在于继承的是 testing::Environment,不是 testing::Test —— 这两者的 SetUp 执行次数完全不同:
| testing::Test | 每个用例前后各一次 |
| testing::Environment | 所有用例前后各一次 |
为什么这里选 Environment:
MsgQueueManager 的构造很"重":
建目录 → 打开数据库 → 建表 → recovery() 读全表
如果每个用例都 new 一次:
→ 开三次数据库,跑三次 recovery
→ 慢,而且互相干扰
只建一次,三个用例共用 → 又快又省
SetUp 里那一行做了什么
mqmp = std::make_shared<bitmq::MsgQueueManager>("./data/meta.db");
这一行背后是一连串连锁反应:
构造 MsgQueueManager
├─ 构造 MsgQueueMapper
│ ├─ 建目录 ./data
│ ├─ 打开 ./data/meta.db
│ └─ 建表 queue_table
└─ recovery() 把数据库里的队列读进内存
所以 SetUp 跑完,mqmp 就是一个"可用、且和数据库对齐"的对象。
TearDown 里为什么要 clear()
mqmp->clear();
因为数据库是"持久"的 —— 测试跑完不清理,数据就会留下来,影响下一次运行。
为什么现在可以放心调 clear():
void clear() {
std::unique_lock<std::mutex> lock(_mutex);
_mapper.removeTable();
_mapper.createTable(); // 删完立刻重建空表
_msg_queues.clear();
}
注意那个 createTable() —— removeTable() 执行的是 drop table(删表),删完不重建,表就永久消失了。
所以 clear() 的正确语义是"清空数据、保留表",而不是"把表删了"。
这一步踩过坑:一开始 clear() 里没有 createTable(),跑完测试再用 sqlite3 查表,会报 no such table: queue_table。
3.三个用例
① insert_test —— 测"增"
TEST(queue_test, insert_test) {
google::protobuf::Map<std::string, std::string> map;
map["k1"] = "v1";
mqmp->declareQueue("queue1", true, false, false, map);
mqmp->declareQueue("queue2", true, false, false, map);
mqmp->declareQueue("queue3", true, false, false, map);
mqmp->declareQueue("queue4", true, false, false, map);
ASSERT_EQ(mqmp->size(), 4u);
}
分两步看:
第一步:造数据
mqmp->declareQueue("queue1", true, false, false, map);
// ↑名字 ↑durable ↑exclusive ↑auto_delete ↑args
四个参数对应 MsgQueue 的四个字段,map 里放了 k1=v1,所以四个队列都带这个参数。
第二步:断言
ASSERT_EQ(mqmp->size(), 4u);
验证四个都加进内存了。
一个新手细节:4u 的 u 是"无符号"后缀。
size() 返回 size_t(无符号),4 是 int(有符号)
→ 混着比会有 -Wsign-compare 警告
→ 加 u 让两边都是无符号
另一个坑:map 的类型必须是 google::protobuf::Map,不能是 std::unordered_map。
// ❌ 编译不过
std::unordered_map<std::string, std::string> map;
// ✅ 正确
google::protobuf::Map<std::string, std::string> map;
因为 declareQueue 的参数就是 protobuf::Map —— 这是 .proto 里 map<string,string> 生成出来的类型,两个类型之间没有隐式转换。
② select_test —— 测"查"
这个用例有 10 条断言,分三段看。
第一段:验证存在性
ASSERT_EQ(mqmp->exists("queue1"), true);
ASSERT_EQ(mqmp->exists("queue2"), true);
ASSERT_EQ(mqmp->exists("queue3"), true);
ASSERT_EQ(mqmp->exists("queue4"), true);
验证 exists() 和 declareQueue 配合正常。
第二段:取出对象,验证字段
bitmq::MsgQueue::ptr mqp = mqmp->selectQueue("queue3");
ASSERT_NE(mqp.get(), nullptr); // 确实取到了
ASSERT_EQ(mqp->name, "queue3"); // 名字对
ASSERT_EQ(mqp->durable, true);
ASSERT_EQ(mqp->exclusive, false);
ASSERT_EQ(mqp->auto_delete, false);
这五条最有价值 —— 它们验证的是"对象存进去、取出来,字段一个不差"。
.get() 是把智能指针转成裸指针,用来判空:
ASSERT_NE(mqp.get(), nullptr);
// 等价于判断 mqp 是不是空智能指针
第三段:验证序列化
ASSERT_EQ(mqp->getArgs(), std::string("k1=v1&"));
验证 getArgs() 把 map 拼成的字符串是对的。
为什么这里可以直接比对字符串:
因为 map 里【只有一个键】k1
→ 哈希表的遍历顺序无所谓
→ getArgs() 只会返回 "k1=v1&"
→ 断言稳定
(如果放了 k1、k2 两个键,顺序可能颠倒
→ 就不能直接比字符串了
→ 要改成"解析回来按 key 验证")
③ remove_test —— 测"删"
TEST(queue_test, remove_test) {
mqmp->deleteQueue("queue3");
ASSERT_EQ(mqmp->exists("queue3"), false);
}
两步:删掉 queue3 → 断言查不到了。
只有一条断言,但已经够了 —— 因为前面 select_test 已经证明"删之前是存在的",这里证明"删之后没了"。
4.main
int main(int argc, char *argv[])
{
testing::InitGoogleTest(&argc, argv);
testing::AddGlobalTestEnvironment(new QueueTest);
return RUN_ALL_TESTS();
}
三行,各有用途:
① InitGoogleTest(&argc, argv)
初始化 GTest,解析命令行参数
(–gtest_filter、–gtest_repeat 这些都在这里被吃掉)
② AddGlobalTestEnvironment(new QueueTest)
注册全局环境
★ 此刻只是"登记",SetUp 还没被调用
★ GTest 接管这个对象的所有权,会自动 delete
③ return RUN_ALL_TESTS()
跑测试,返回结果(0 = 全过,1 = 有失败)
★ 必须 return 出去!否则测试失败时程序仍返回 0
→ CI 里看不出失败 → 测试"永远绿"
第 ③ 点踩过坑:
RUN_ALL_TESTS(); // 编译器警告:返回值被忽略
return 0; // 无论测试成功失败都返回 0
// 正确写法
return RUN_ALL_TESTS();
5.执行流程
程序启动
│
▼
main()
├─ InitGoogleTest
├─ AddGlobalTestEnvironment(只登记)
└─ RUN_ALL_TESTS()
│
├─ QueueTest::SetUp() 只调一次
│ 建 Manager(建库、建表、recovery)
│
├─ insert_test 声明 4 个队列 → 断言 size == 4
├─ select_test 验证存在 → 验证字段 → 验证序列化
├─ remove_test 删掉 queue3 → 断言查不到
│
└─ QueueTest::TearDown() 只调一次
clear() → 删表 + 重建 + 清内存
│
▼
返回 RUN_ALL_TESTS() 的结果
注意三个用例是"串联"的:
insert_test 造数据
↓ 依赖
select_test 验证数据
↓ 依赖
remove_test 删数据
代价:单独跑 select_test 会失败(因为 insert_test 没跑,数据不存在)。
七.小结
这份测试 = 3 个用例 + 12 条断言
insert_test 1 条 → 测"增"
select_test 10 条 → 测"查"(字段完整性 + 序列化)
remove_test 1 条 → 测"删"
骨架:用 testing::Environment 只建一次 Manager(重量级对象)
收尾:TearDown 里 clear(),保证每次跑都是干净起点
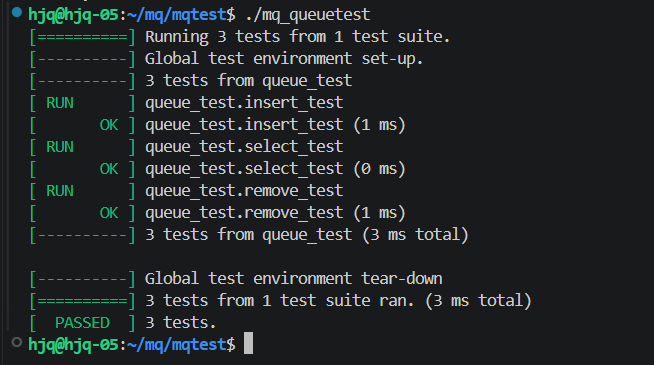
三.运行结果:
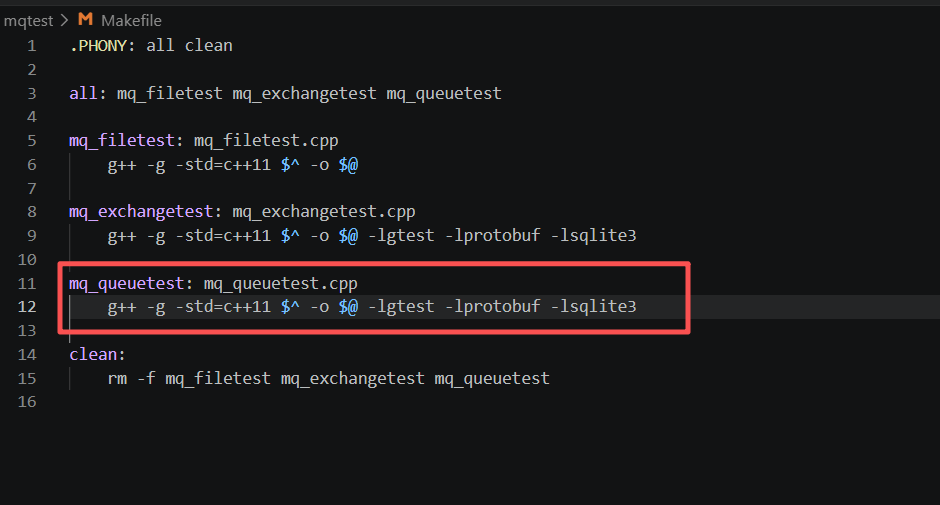
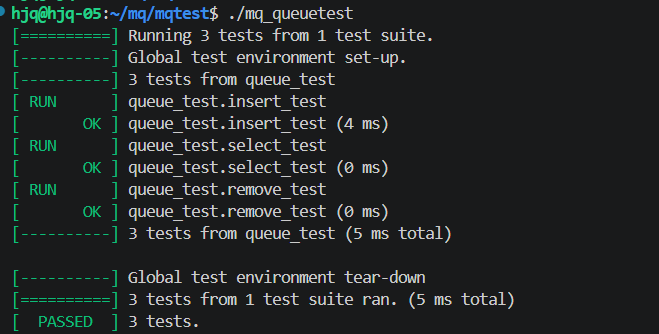
第 1 步:编译 + 跑测试
make clean
make
./mq_queuetest
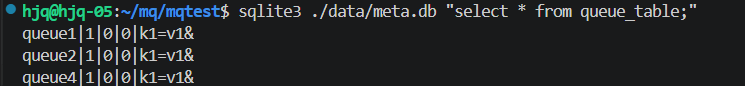
第 2 步:查数据库(验证落盘)
sqlite3 ./data/meta.db "select * from queue_table;"
第 3 步:看表结构
sqlite3 ./data/meta.db ".schema queue_table"

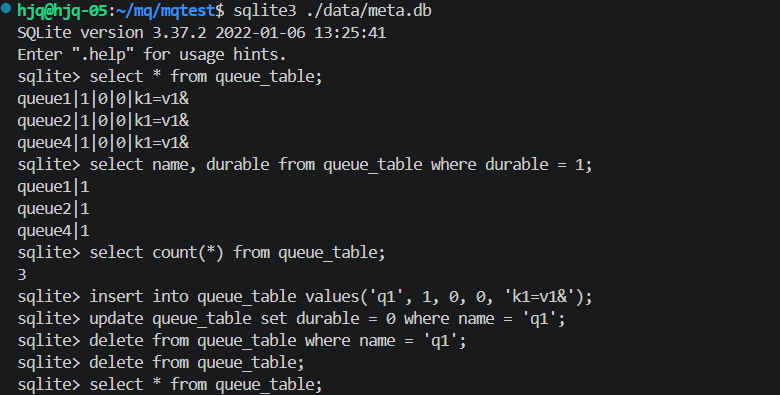
第 4 步:玩 CRUD(进交互模式)
sqlite3 ./data/meta.db
select * from queue_table;
select name, durable from queue_table where durable = 1;
select count(*) from queue_table;
insert into queue_table values('q1', 1, 0, 0, 'k1=v1&');
update queue_table set durable = 0 where name = 'q1';
delete from queue_table where name = 'q1';
delete from queue_table;
select * from queue_table;
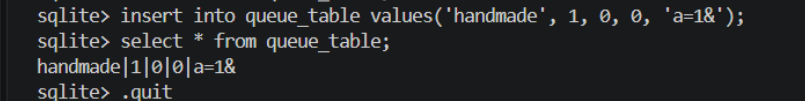
第 5 步: 关键实验 —— 手工插一条
insert into queue_table values('handmade', 1, 0, 0, 'a=1&');
select * from queue_table;
.quit
然后跑测试:
./mq_queuetest
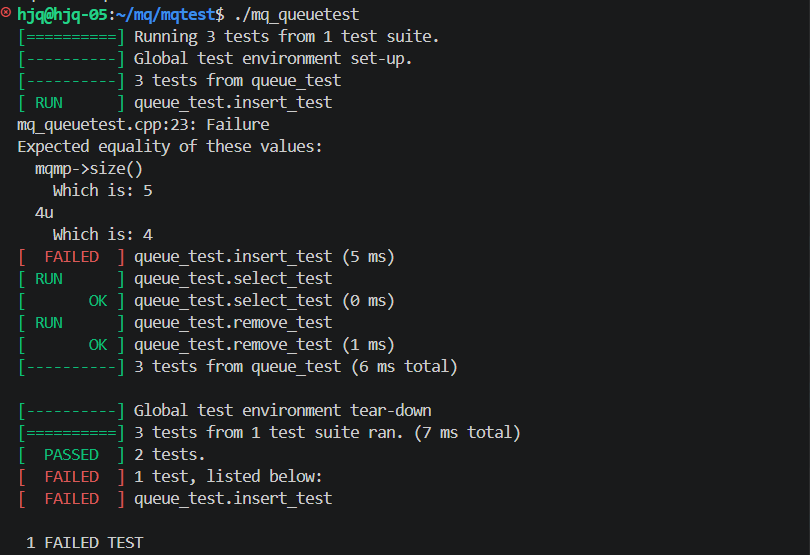
为什么测试断言失败?
核心原因:recovery() 会把数据库中已持久化的数据全部加载到内存。
数据库原有4条记录:queue1、queue2、queue4(上轮测试遗留)、handmade(手工插入)
测试启动
↓ SetUp 中创建 MsgQueueManager 对象
↓ 构造函数内部调用 _mapper.recovery()
↓ recovery() 将【4条记录全部加载进内存】
↓ 初始内存中就存在4条队列
执行 insert_test,依次声明 queue1 ~ queue4:
queue1 → 已存在,跳过
queue2 → 已存在,跳过
queue3 → 不存在,新增,内存+1
queue4 → 已存在,跳过
↓ 内存总数 = 4 + 1 = 5
断言预期 size == 4,实际得到5 → 测试失败
最终数量变成 5,是因为recovery()初始化时,把数据库遗留的历史队列全部加载进内存。
为什么删除数据后测试可以正常通过?
核心原因:数据库删除记录后,recovery()启动加载的数据就变少了。
删除 handmade 这条记录,数据库剩余3条:queue1、queue2、queue4
测试启动
↓ recovery() 读取3条数据载入内存
↓ 初始内存 = 3条
执行 insert_test,依次声明 queue1 ~ queue4:
queue1、queue2、queue4 → 已存在,跳过
queue3 → 不存在,新增,内存+1
↓ 内存总数 = 3 + 1 = 4
断言预期 size == 4,实际得到4 → 测试通过
数据库中的历史记录被清理后,recovery()读取到的数据变少,最终内存队列数量和预期匹配。
第 6 步:恢复现场
sqlite3 ./data/meta.db "delete from queue_table where name='handmade';"
./mq_queuetest