/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
RabbitMQ 详解:从核心概念到七大工作模式
在分布式系统中,服务之间的通信永远绕不开一个问题:调用方和被调用方,如何优雅地对话? 本文基于课程资料整理,先讲清楚 什么是 RabbitMQ、它的核心概念,再逐一剖析 RabbitMQ 的七大工作模式,每种模式都配有结构示意图,帮你一次学透。
目录
- 一、什么是 MQ
- 二、什么是 RabbitMQ
- 三、RabbitMQ 的安装
- 四、RabbitMQ 核心概念
- 五、RabbitMQ 的七大工作模式
- 1. Simple 简单模式
- 2. Work Queue 工作队列模式
- 3. Publish/Subscribe 发布订阅模式
- 4. Routing 路由模式
- 5. Topics 通配符模式
- 6. RPC 通信模式
- 7. Publisher Confirms 发布确认模式
- 六、七种模式对比总结
一、什么是 MQ
MQ(Message Queue,消息队列),从字面意思看,本质就是一个队列——FIFO(先进先出),只不过队列中存放的内容是消息(message)而已。消息可以非常简单,比如只包含一个文本字符串、JSON;也可以很复杂,比如内嵌对象。
MQ 多用于分布式系统之间进行通信。
1.1 系统间通信的两种方式
系统之间的调用通常有两种方式:
| 同步通信 | 直接调用对方的服务,数据从一端发出后立即就可以达到另一端 | 实时性强,但调用方需要阻塞等待,耦合度高 |
| 异步通信 | 数据从一端发出后,先进入一个容器进行临时存储,当达到某种条件后,再由这个容器发送给另一端 | 削峰填谷、解耦,这个"容器"的典型实现就是 MQ |
RabbitMQ 就是 MQ 的一种实现。
1.2 MQ 的作用
可以把 MQ 想象成一个仓库:采购部进货之后,把零件放进仓库里,生产部从仓库中取出零件加工成产品。MQ 和仓库的区别是——仓库里放的是物品,MQ 里放的是消息;仓库负责存储和转发物品,MQ 负责存储和转发消息。
具体来说,MQ 主要有以下作用:
二、什么是 RabbitMQ
RabbitMQ 是采用 Erlang 语言实现 AMQP 协议的消息中间件,它最初起源于金融系统领域,是为了在分布式系统中存储和转发消息而设计的。
先解释两个名词:
- Rabbit:兔子,也是一个公司名(Rabbit Technologies)。之所以取名为 Rabbit,是因为兔子行动非常迅速且繁殖起来非常"疯狂"——创始团队认为这个名字再合适不过了。
- MQ:Message Queue,消息队列。RabbitMQ 就是 Rabbit 公司旗下的一个消息队列产品。
AMQP,即 Advanced Message Queuing Protocol(高级消息队列协议),是一个通用的应用层协议,为面向消息的中间件设计。基于此协议的客户端与消息中间件可传递消息,并不受客户端/中间件、开发语言等条件的限制。
2.1 为什么选择 RabbitMQ
目前业界有很多 MQ 产品:RabbitMQ、RocketMQ、ActiveMQ、Kafka、ZeroMQ 等,也有直接用 Redis 充当消息队列的案例。这些消息队列各有侧重,没有绝对的好坏,只有适合不适合。选型时需要结合自身需求和产品特征综合考虑。
当前最主流的 3 种 MQ 产品对比:
| Kafka | Scala/Java | 追求高吞吐量,单机吞吐达十万级,在日志领域比较成熟,功能较为简单 | 日志采集、大数据流式处理(有日志采集需求首选 Kafka) |
| RocketMQ | Java(阿里开源,后捐赠 Apache) | 借鉴 Kafka 并做了改进,可靠性、稳定性出色;但客户端语言支持不多,社区活跃度一般 | 可靠性要求高、并发量大的场景,如互联网金融 |
| RabbitMQ | Erlang | MQ 功能较完备,几乎支持所有主流语言,管理界面非常友好,吞吐量万级,社区活跃度高 | 中小型公司、数据量没那么大且并发没那么高的场景 |
💡 综合来看:RabbitMQ 综合能力较强,社区比较成熟、管理界面友好,因此学习消息中间件,RabbitMQ 是非常好的入门选择。
2.2 发展历史
- 2006 年,RabbitMQ 开发始于 Rabbit Technologies 公司;
- 2010 年 4 月,Rabbit Technologies 被 VMware 旗下的 SpringSource 收购;
- 2013 年 5 月,被并入 Pivotal(我们现在常用的 Spring 系列框架,就是 Pivotal 公司的门户产品之一);
- 后来 Pivotal 将其开源,RabbitMQ 才逐渐走向大众,如今在易用性、扩展性、可靠性和高可用性等方面都有卓越表现,被互联网公司大规模应用。
三、RabbitMQ 的安装
RabbitMQ 基于 Erlang 语言编写,所以安装 RabbitMQ 之前,需要先安装部署 Erlang 环境,再安装 RabbitMQ。RabbitMQ 大多部署在 Linux 操作系统上。
3.1 Ubuntu 环境安装(学习阶段推荐)
安装过程分为四步:
💡 默认用户名和密码都是 guest。但 RabbitMQ 从 3.3.0 开始禁止使用 guest/guest 权限通过除 localhost 以外的访问,所以建议添加一个管理员用户:先用添加用户命令创建账号(如 admin),再用设置角色命令将其赋予管理员角色。
RabbitMQ 用户角色共六种:Administrator(超级管理员)、Monitoring(监控者)、Policymaker(策略制定者)、Management(普通管理者)、Impersonator、None(普通生产者/消费者)。
💡 另一种更简单的方式——Docker 安装:直接拉取带管理界面的 rabbitmq 镜像并运行容器,同时映射 5672(客户端通信端口)和 15672(管理界面端口)两个端口即可。
四、RabbitMQ 核心概念
4.1 一个比喻:邮局模型
RabbitMQ 是一个消息中间件,也是一个生产者消费者模型,它负责接收、存储并转发消息。
消息传递的过程非常类似邮局:
- 当你要发送一封邮件时,你把邮件放到邮局,邮局接收邮件,并通过邮递员送到收件人的手上。
- 按照这个逻辑:Producer 就类似邮件发件人,Consumer 就是收件人,RabbitMQ 就类似于邮局。
4.2 核心概念详解
(1)Producer / Consumer / Broker
| Producer(生产者) | RabbitMQ Server 的客户端,向 RabbitMQ 发送消息。消息通常是带有业务逻辑结构的数据(如 JSON 字符串),并可以携带标签,RabbitMQ 根据标签进行路由 |
| Consumer(消费者) | 也是 RabbitMQ Server 的客户端,从 RabbitMQ 接收消息。消费过程中标签会被丢掉,消费者只收到消息,并不知道(也不需要知道)生产者是谁 |
| Broker(代理节点) | 就是 RabbitMQ Server 本身,负责接收和收发消息。一个 Broker 可以简单看作一个 RabbitMQ 服务节点/实例,大多数情况下也可以看作一台 RabbitMQ 服务器 |
(2)Connection 和 Channel
- Connection(连接):客户端和 RabbitMQ 服务器之间的一个 TCP 连接,是建立消息传递的基础,负责传输所有数据和控制信息。
- Channel(通道/信道):Connection 之上的一个抽象层。一个 TCP 连接可以有多个 Channel,每个 Channel 都是独立的虚拟连接,消息的发送和接收都是基于 Channel 进行的。
💡 Channel 的主要作用是把消息的读写操作复用到同一个 TCP 连接上,减少建立和关闭连接的开销,提升性能。如果每次收发消息都建立一条 TCP 连接,开销太大了。
(3)Virtual Host(虚拟主机)
Virtual host 是一个虚拟概念,为消息队列提供了逻辑上的隔离机制。一个 Broker 上可以存在多个 Virtual Host,当多个不同的用户使用同一个 RabbitMQ Server 时,可以划分出多个 vhost,每个用户在自己的 vhost 中创建交换机、队列等资源。
💡 类比 MySQL 的 database:一个 MySQL 服务器可以有多个 database,一个 RabbitMQ Broker 可以有多个 vhost。
(4)Queue(队列)
Queue 是 RabbitMQ 的内部对象,用于存储消息。多个消费者可以订阅同一个队列。
(5)Exchange(交换机)
Exchange 是 message 到达 Broker 的第一站,它负责接收生产者发送的消息,并按照特定规则把消息路由到一个或多个 Queue 中。
💡 类比快递物流:发快递之后,物流公司根据地址把快递分派到不同的站点,再送到收件人手上——这个"分拣"的工作就是交换机做的。
RabbitMQ 交换机有四种类型,不同类型有着不同的路由策略:
| Fanout | 广播,把消息交给所有绑定到交换机的队列 | Publish/Subscribe 模式 |
| Direct | 定向,把消息交给符合指定 routing key 的队列 | Routing 模式 |
| Topic | 通配符,把消息交给符合 routing pattern 的队列 | Topics 模式 |
| Headers | 不依赖路由键,根据消息内容中的 headers 属性匹配 | 性能差、不实用,基本不会用到 |
⚠️ 重要:Exchange 只负责转发消息,不具备存储消息的能力。如果没有任何队列与 Exchange 绑定,或者没有符合路由规则的队列,那么消息就会丢失!
(6)RoutingKey 与 BindingKey
- RoutingKey(路由键):生产者将消息发给交换器时指定的一个字符串,告诉交换机该如何处理这个消息。
- BindingKey(绑定键):通过 Binding(绑定) 将交换器与队列关联起来,绑定的时候一般会指定一个 BindingKey,RabbitMQ 就知道如何正确地将消息路由到队列了。
两者可以这样理解:
多数时候(包括官方文档和 Java API)都把两者统称为 Routing Key,根据使用场景区分即可。
4.3 RabbitMQ 工作流程
把上面的概念串起来,RabbitMQ 的完整工作流程是:

4.4 快速入门:Hello World
使用 Java 原生客户端体验最简单的收发消息,只需要引入官方的 amqp-client 依赖。
生产者端的编程套路可以总结为"五步曲":
消费者端的前三步与生产者相同,第 4 步改为消费消息:调用消费方法时传入队列名、是否自动确认和一个回调对象,收到消息后回调方法会自动执行,打印消息内容即可。消费者相当于一个监听程序,一般不需要关闭资源。
运行后,消费者控制台输出接收到的消息内容,这就是 RabbitMQ 的简单模式。
五、RabbitMQ 的七大工作模式
RabbitMQ 官方提供了 7 种工作模式,入门程序的案例其实就是其中的"简单模式"。官方文档:RabbitMQ Tutorials
1. Simple(简单模式)
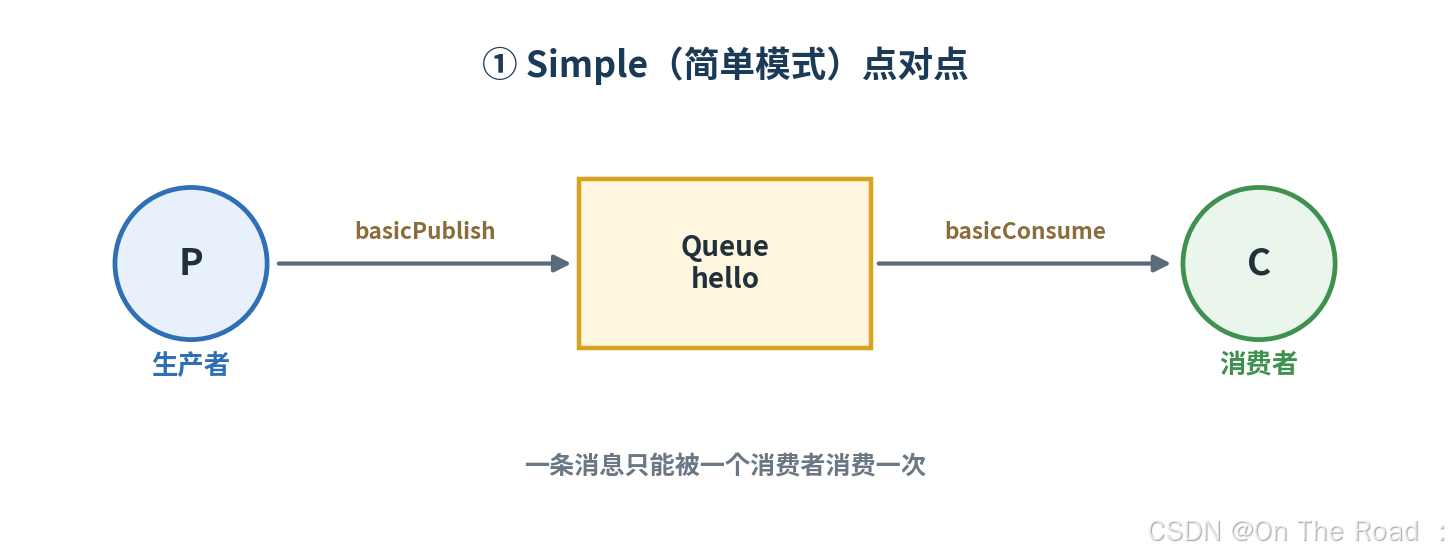
- P:生产者,发送消息的程序;
- C:消费者,消息的接收者;
- Queue:消息队列(黄色部分),类似一个邮箱,可以缓存消息;生产者向其中投递消息,消费者从其中取出消息。
特点:一个生产者 P,一个消费者 C,消息只能被消费一次,也称为点对点(Point-to-Point)模式。
适用场景:消息只能被单个消费者处理。
(实现方式见上文 4.4 快速入门)
2. Work Queue(工作队列模式)
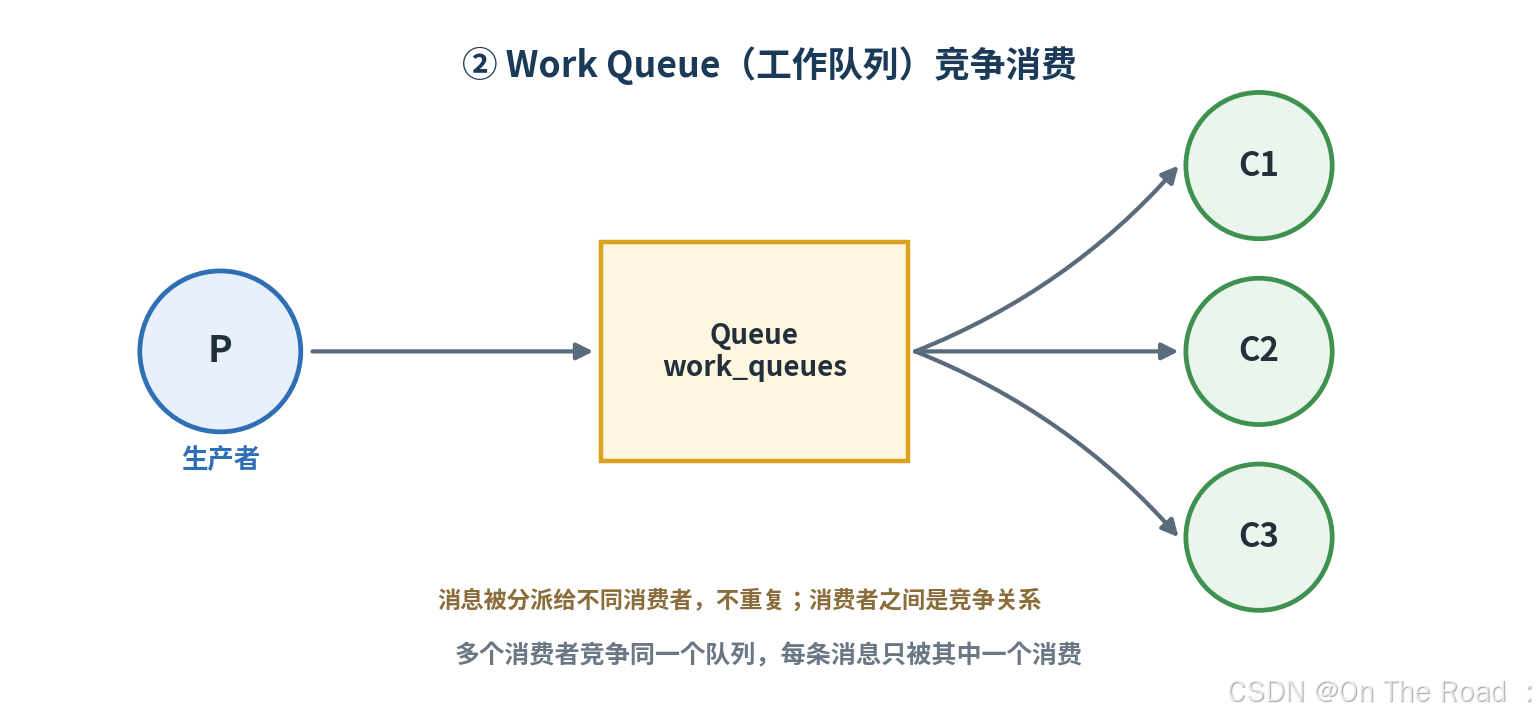
一个生产者 P,多个消费者 C1、C2…… 在有多个消息的情况下,Work Queue 会将消息分派给不同的消费者,每个消费者都会接收到不同的消息。
特点:消息不会重复,消费者之间是竞争关系,每个消息只能被一个消费者接收。
适用场景:集群环境中做异步处理。例如 12306 短信通知服务——订票成功后订单消息发送到 RabbitMQ,多个短信服务实例从 RabbitMQ 中获取订单信息并发送通知,相当于在短信服务之间进行任务分配。
实现思路:生产者代码和简单模式基本一样,为了看到多个消费者竞争的关系,循环发送 10 条消息即可;消费者代码复制两份(内容可以完全一样)。运行后 10 条消息被轮流分配给了两个消费者(一个收到偶数序号、一个收到奇数序号),没有任何一条被重复消费。
💡 测试技巧:要先启动两个消费者,再启动生产者。如果先启动生产者,由于消息较少处理较快,第一个启动的消费者会瞬间把 10 条消息全部消费掉。
3. Publish/Subscribe(发布/订阅模式)
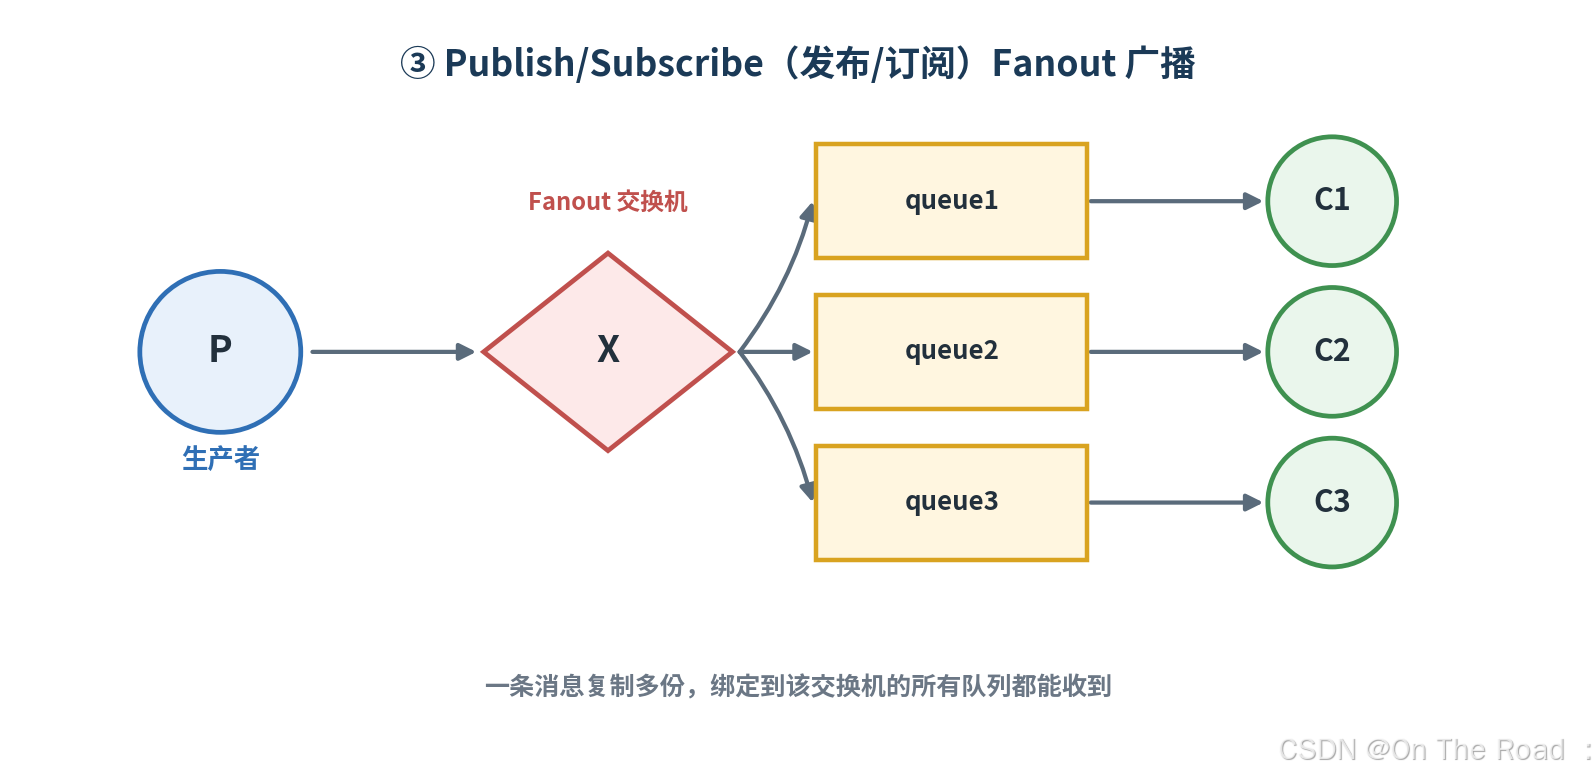
在订阅模型中,多了一个角色 Exchange(交换机,图中 X),过程略有变化:
- 生产者不再直接把消息投递到队列(实际上这个在 RabbitMQ 中不会发生),而是发送到 Exchange;
- 由交换机按一定规则将消息路由到一个或多个队列中;
- 一条消息经过交换机被复制成多份,每个消费者接收相同的消息。
特点:生产者发送一条消息,经过交换机转发到多个不同的队列,多个不同的队列就有多个不同的消费者。
适用场景:消息需要被多个消费者同时接收的场景,如实时通知或广播消息。例如中国气象局发布"天气预报"消息送入交换机,新浪、百度、搜狐、网易等门户网站将各自队列绑定到该交换机,即可自动获取气象数据。
实现思路(Fanout 类型交换机):与前两种模式的区别是需要创建交换机,并绑定队列和交换机——先创建 fanout 类型的交换机(可指定是否持久化、是否自动删除等参数),再声明两个队列,然后把队列和交换机绑定(fanout 类型 RoutingKey 设置为空字符串,表示所有绑定队列都能收到全部消息),最后把消息发送到交换机。运行后两个队列各收到一条消息,两个消费者都打印了相同的内容。
4. Routing(路由模式)
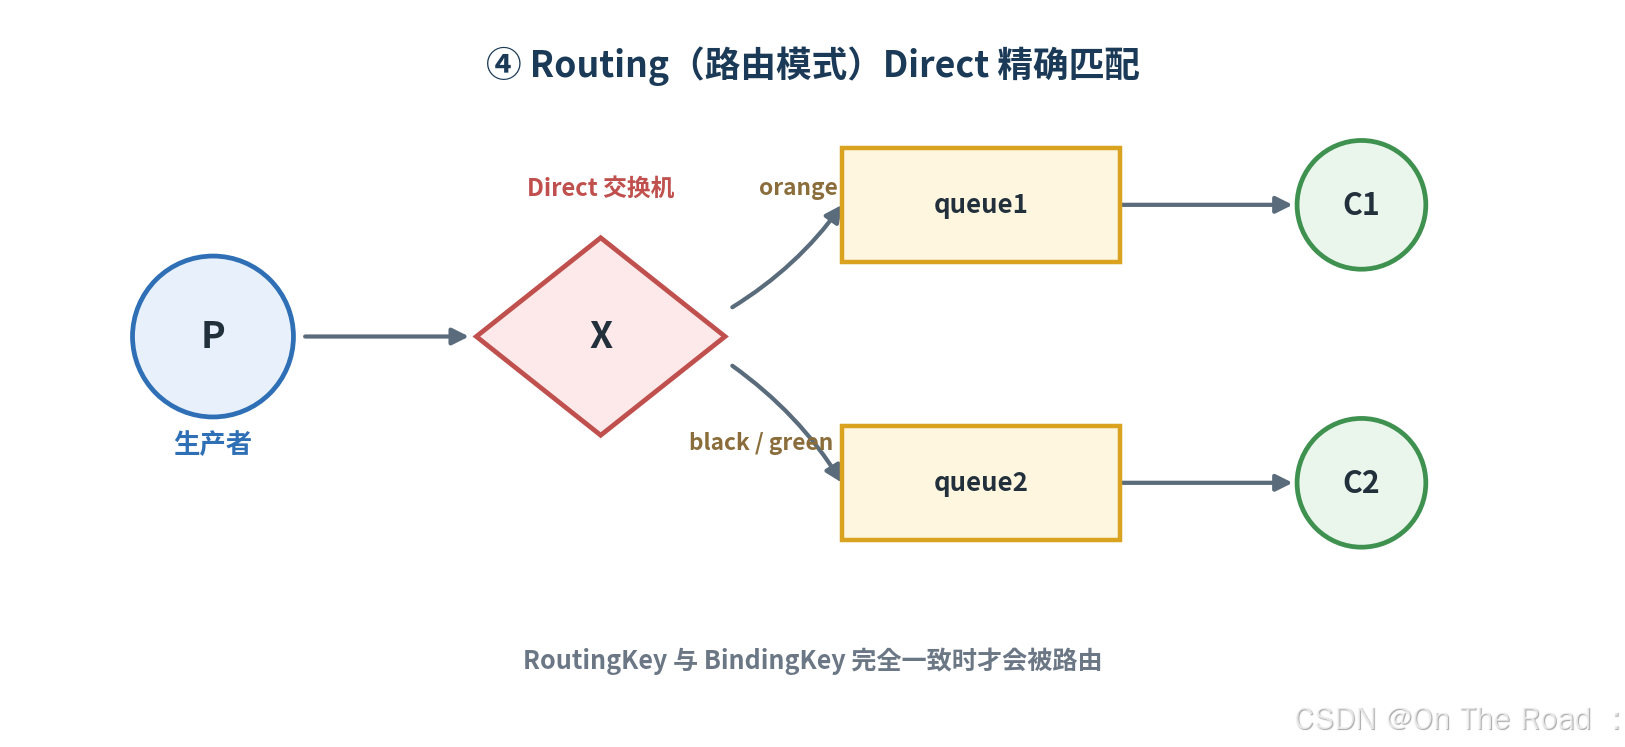
路由模式是发布订阅模式的变种,在发布订阅基础上增加了路由 key:
- 队列和交换机绑定的时候,不能任意绑定了,要指定一个 BindingKey;
- 消息发送方向 Exchange 发送消息时,也需要指定 RoutingKey;
- Exchange 根据消息的 RoutingKey 进行判断,只有队列绑定的 BindingKey 和消息的 RoutingKey 完全一致,该队列才会接收到消息。
区别:发布订阅模式是无条件地将所有消息分发给所有消费者;路由模式是 Exchange 将数据筛选后发给对应的消费者队列。
适用场景:需要根据特定规则分发消息的场景。例如系统打印日志,日志等级分为 error、warning、info、debug,可以把不同的日志发送到不同的队列,最终输出到不同的文件。
实现思路(Direct 类型交换机):和发布订阅模式的区别就是交换机类型不同、绑定队列的 RoutingKey 不同——创建 direct 类型交换机后,队列 1 只绑定 orange,队列 2 绑定 black 和 green(一个队列可以绑定多个 BindingKey)。发送消息时指定不同的 RoutingKey,最终队列 1 只收到 orange 的消息,队列 2 收到 black 和 green 的消息。
5. Topics(通配符模式)
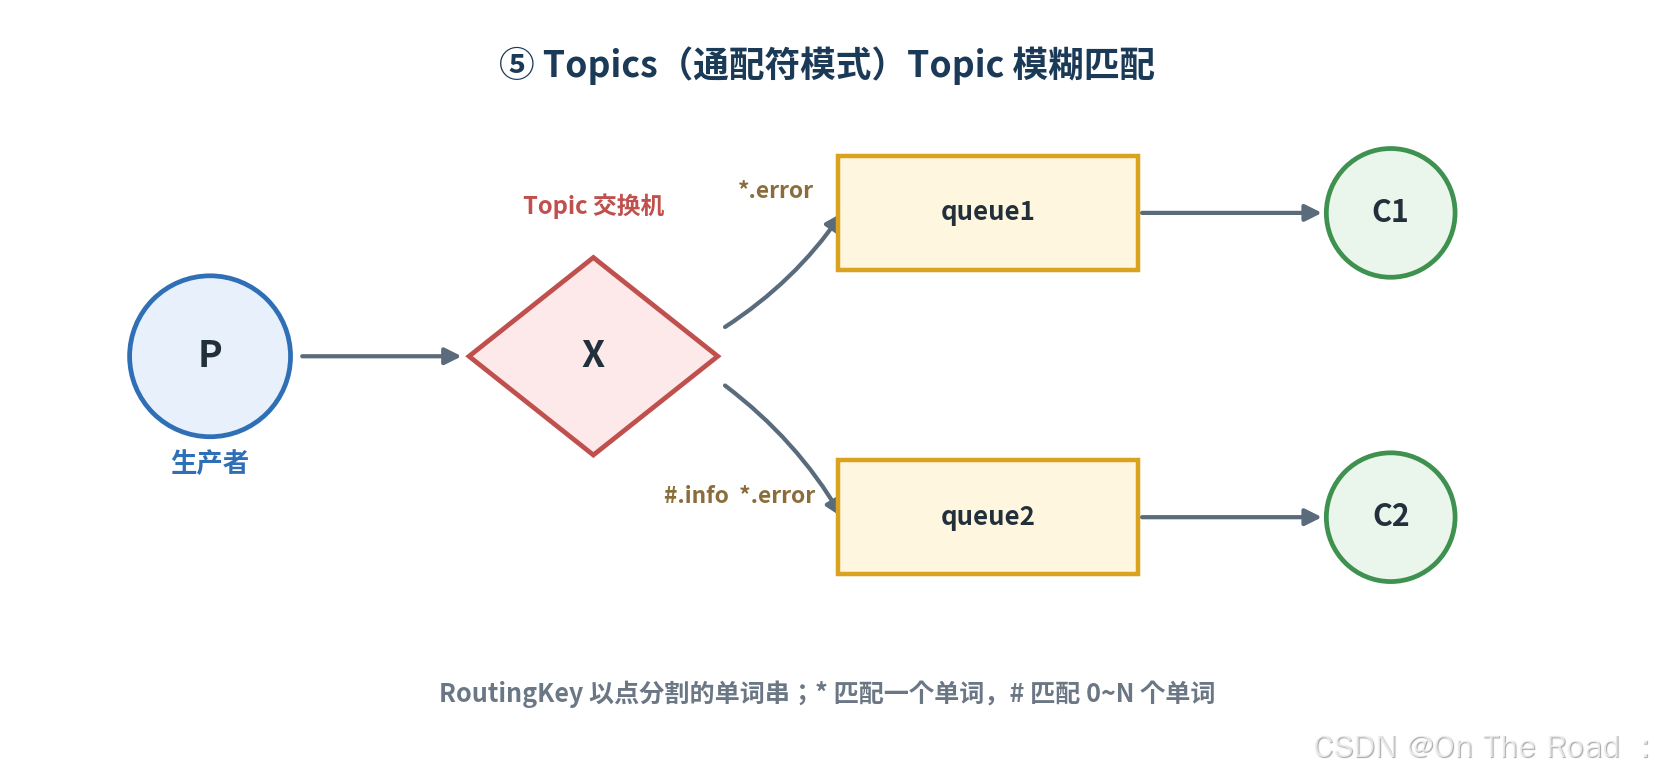
路由模式的升级版,在 RoutingKey 的基础上增加了通配符功能,使之更加灵活。
Topics 和 Routing 的基本原理相同,不同之处在于 RoutingKey 的匹配方式:
- Routing 模式是相等匹配(完全一致);
- Topics 模式是通配符匹配(类似正则表达式的思路)。
匹配规则:
- *:表示一个单词;
- #:表示多个单词(0~N 个)。
适用场景:需要灵活匹配和过滤消息的场景。
举例(Topic 类型交换机):队列 1 只绑定 *.error(仅接收 error 信息),队列 2 绑定 #.info 和 *.error(error、info 都接收)。发送 order.error 时两个队列都收到;发送 order.pay.info 时只有队列 2 收到——因为它有三段单词,不匹配两段的 *.error,但能匹配 #.info(# 匹配多段)。
| order.error | ✅ 匹配 *.error | ✅ 匹配 *.error |
| order.pay.info | ❌ | ✅ 匹配 #.info |
| pay.error | ✅ | ✅ |
💡 如果消息的 RoutingKey 与任何 BindingKey 都不匹配,消息会被丢弃,或者退回给生产者(需要设置 mandatory 参数)。
6. RPC(远程过程调用)
RPC(Remote Procedure Call),即远程过程调用,是一种通过网络从远程计算机上请求服务、而不需要了解底层网络技术的技术,类似于 HTTP 远程调用。
在 RPC 通信的过程中,没有生产者和消费者之分,比较像我们平时使用的 RPC 远程调用——通过两个队列实现了一个可回调的过程:
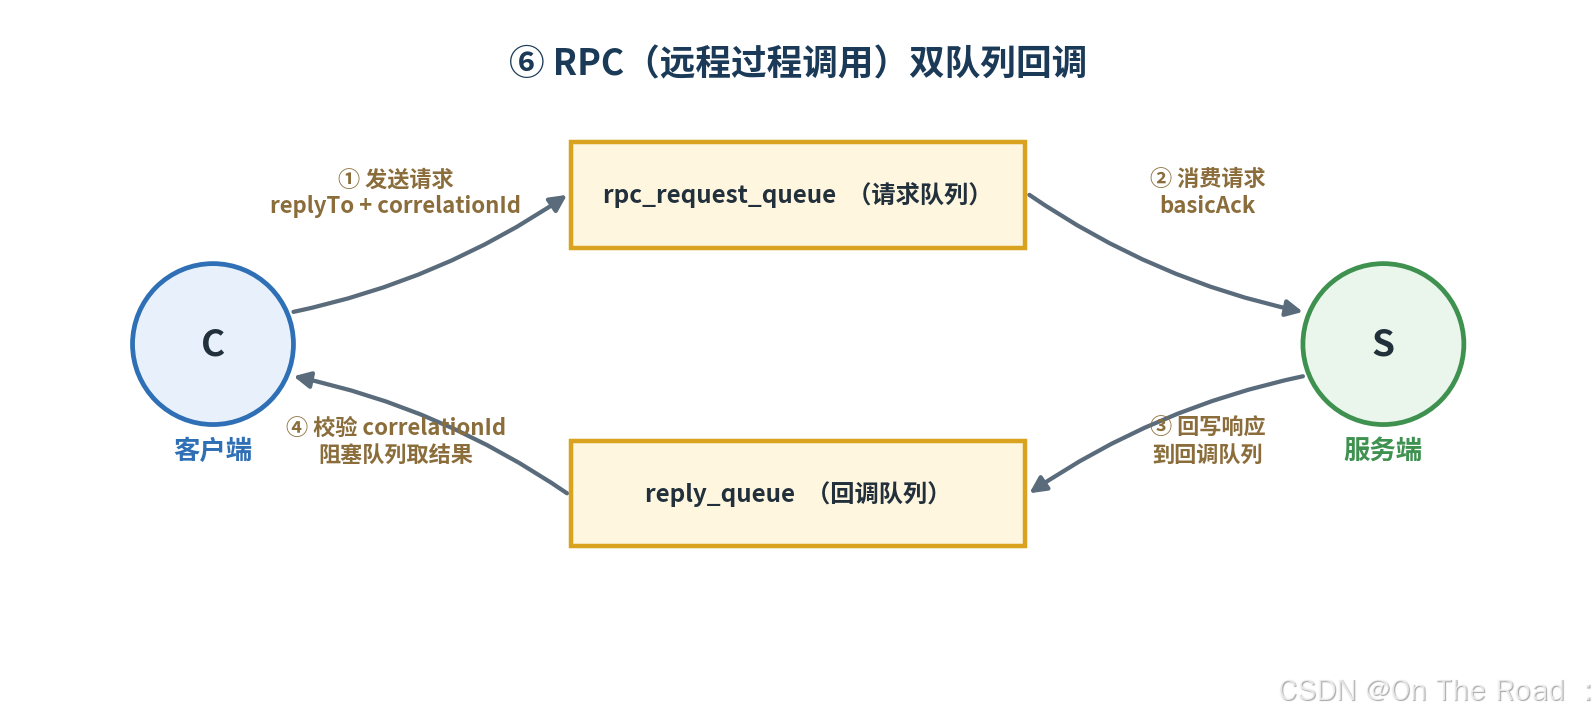
流程:
客户端实现思路:声明请求队列和一个临时回调队列;生成本次请求的唯一标志(如 UUID),连同回调队列名一起设置到消息属性中,通过内置交换机发出请求;然后用阻塞队列监听回调队列——收到响应后先校验 correlationId 与本次请求是否匹配,匹配才放入阻塞队列,主线程从阻塞队列取出结果,从而实现"发出请求 → 等待响应"的同步效果。
服务端实现思路:声明同一个请求队列;通过 QoS 设置同时最多只能获取一个消息(保证一个请求对应一个响应,否则默认情况下消费者可能同时收到多条消息);收到请求后进行处理,把响应消息发送到请求属性中 replyTo 指定的回调队列(响应中携带原请求的 correlationId,方便客户端匹配),最后手动对消息进行应答。
💡 关于 autoAck(消息确认机制):消费方法的 autoAck 参数指定消费者是否自动向队列确认消息。
- autoAck=true(自动确认):消息发给消费者后立即从内存中删除,如果消费者处理失败,消息就丢了;
- autoAck=false(手动确认):消费者需要显式调用确认方法,消息队列才删除消息。可靠性更高,适用于消息处理重要且需要确保每个消息被正确处理的场景。
7. Publisher Confirms(发布确认)
作为消息中间件,都会面临消息丢失的问题。消息丢失大概分为三种情况:
针对这三种问题,RabbitMQ 给出了对应的解决方案:
| 生产者 → Broker | 发布确认(Publisher Confirms) |
| Broker 自身 | 持久化机制 |
| Broker → 消费者 | 消息应答机制(上文 RPC 中提到的手动 ack) |
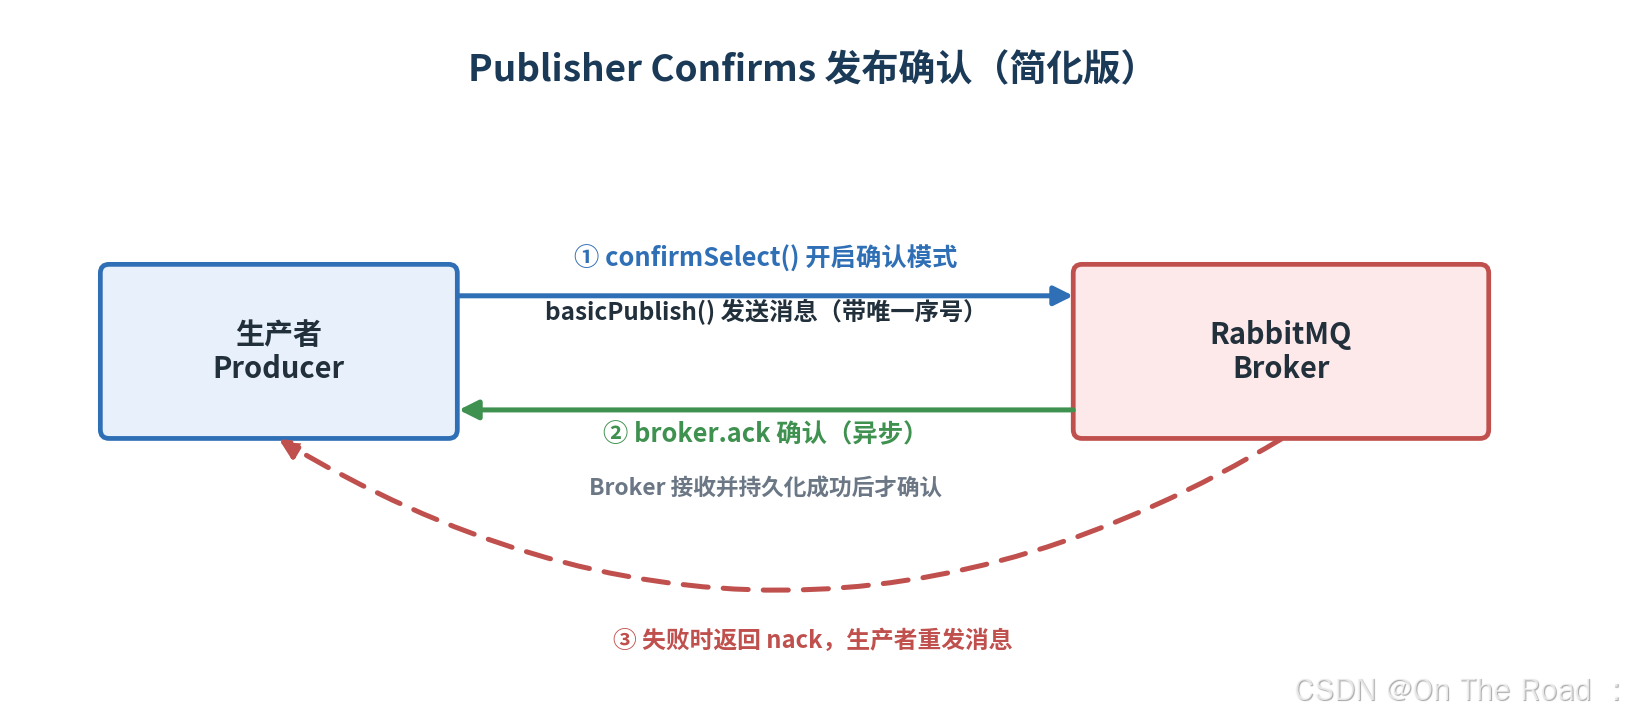
发布确认是 RabbitMQ 七大工作模式之一,属于 AMQP 0.9.1 协议的扩展,默认不开启,需要将信道设置为 confirm 模式。
工作原理:
适用场景:对数据安全性要求较高的场景,如金融交易、订单处理。
三种确认策略
① 单独确认(Publishing Messages Individually)
每发送一条消息后就同步等待确认,收到确认(或超时/收到 nack 抛出异常)后才发送下一条。这实际上是一种串行同步等待的方式,尤其对持久化消息还需要等待写盘(fsync),速度非常慢——实测发布 200 条消息耗时约 6000+ ms。优点是实现简单,但吞吐量很低(每秒只有几百条)。
② 批量确认(Publishing Messages in Batches)
每发送一批消息(如 100 条)后再统一等待这批消息的确认,发送下一批前先等上一批全部确认完毕,最后收尾确认剩余消息。吞吐量相比单独确认能提升 20~30 倍——实测发布 200 条消息耗时约 130 ms。
缺点:出现 nack 或超时时,不清楚具体哪条消息出了问题,客户端需要把这一整批消息全部重发,会带来明显的重复消息。当消息经常丢失时,批量确认的性能反而会下降。
③ 异步确认(Handling Publisher Confirms Asynchronously)
编程实现最复杂,但效率最高。信道提供了 addConfirmListener 方法注册 ConfirmListener 回调接口,其中包含两个回调方法:
- handleAck(deliveryTag, multiple):处理服务端返回的 ack;
- handleNack(deliveryTag, multiple):处理服务端返回的 nack。
其中 deliveryTag 是消息的序号,multiple 为 true 表示序号小于等于 deliveryTag 的所有消息都被批量确认了。
实现思路:为每个信道维护一个已发送消息序号的有序集合——发送消息前用 getNextPublishSeqNo() 获取下一个序号并加入集合;收到 ack 回调时,multiple=false 移除当前序号,multiple=true 清除集合中小于等于该序号的所有元素;收到 nack 回调时按业务做消息重发。这样生产者不阻塞、不间断地发送消息,确认由回调异步处理,实测发布 200 条消息仅需约 73 ms。
💡 官方还提醒:不要在确认回调中直接重发 nack 的消息——回调运行在客户端库的 I/O 线程中,不宜在该线程执行信道操作;更好的做法是把待重发的消息放入内存队列,由发送线程轮询处理。
三种策略性能对比(实测)
| 200 条 | 6931 ms | 137 ms | 73 ms |
| 500 条 | 15805 ms | 246 ms | 107 ms |
💡 结论:单独确认最慢(串行同步);批量确认大幅提速但故障时需整批重发;异步确认最快,且消息数越多优势越明显,还能精确定位丢失的消息——生产环境推荐使用异步确认。
六、七种模式对比总结
| Simple 简单模式 | 内置交换机 | 一生产一消费,点对点 | 消息只能被单个消费者处理 |
| Work Queue 工作队列 | 内置交换机 | 多消费者竞争,消息不重复 | 集群环境做异步处理、任务分配 |
| Publish/Subscribe 发布订阅 | Fanout | 一条消息复制多份广播,所有绑定队列都收到 | 实时通知、广播消息(如气象数据分发) |
| Routing 路由模式 | Direct | RoutingKey 与 BindingKey 完全一致才路由 | 按规则精确分发(如日志分级) |
| Topics 通配符模式 | Topic | * 匹配一个单词,# 匹配 0~N 个单词 | 灵活匹配和过滤消息 |
| RPC 远程调用 | 内置交换机 | 双队列 + replyTo + correlationId 实现回调 | 需要拿到远程处理结果的场景 |
| Publisher Confirms 发布确认 | 无关 | 信道 confirm 模式 + 异步 ACK/NACK | 数据安全性要求高(金融、订单) |
一句话记忆:前两种模式(Simple、Work Queue)解决"消费能力"问题;中间三种(Publish/Subscribe、Routing、Topics)围绕 Exchange 的类型解决"消息路由"问题;最后两种(RPC、Publisher Confirms)解决"可靠性与交互"问题。
如果这篇文章对你有帮助,欢迎点赞、收藏、评论支持!有问题也欢迎在评论区交流~ 🐰
推荐阅读
- RabbitMQ 官网:https://www.rabbitmq.com
- 官方教程:RabbitMQ Tutorials
- Spring AMQP 文档:Spring AMQP