/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
YOLOv8模型压力测试方案设计:高并发场景模拟
在智能安防摄像头实时追踪行人、工业质检流水线毫秒级识别缺陷、自动驾驶系统应对复杂路况的今天,一个目标检测模型能否扛住成百上千路图像并发请求,往往比它的mAP(平均精度)更决定其“能不能上线”。YOLOv8作为当前工业界最主流的目标检测框架之一,虽然以“快”著称,但当它从单机推理走向服务化部署时,真正的挑战才刚刚开始——我们不再只关心一张图跑多快,而是要问:1000个用户同时上传图片,你的API还能稳定响应吗?GPU会不会瞬间爆掉?
这正是压力测试的价值所在。与其等到线上事故频发再去救火,不如提前用科学手段模拟极端负载,把系统瓶颈暴露在实验室里。本文将围绕如何基于标准YOLOv8深度学习镜像,构建一套可复现、可量化的高并发测试方案,帮助AI工程师和MLOps团队验证模型服务的真实承载能力。
为什么是YOLOv8?它真的适合高并发吗?
YOLOv8由Ultralytics公司维护,延续了YOLO系列“一次前向传播完成检测”的核心理念,但在架构上做了多项关键升级。它不再是简单地“更快一点”,而是在精度与效率之间找到了新的平衡点。
与早期版本相比,YOLOv8取消了锚框(anchor-based)机制,转为完全无锚框(anchor-free)的设计,直接预测物体中心点与宽高偏移。这一改动不仅简化了后处理流程,还配合动态标签分配策略(如Task-Aligned Assigner),显著提升了小目标检测能力和训练收敛速度。更重要的是,这种端到端结构天然更适合批量化推理——没有复杂的候选区域生成阶段,也没有多模块协同开销,整个前向过程高度规整,非常适合GPU并行加速。
此外,YOLOv8支持多种规模变体:
– YOLOv8n(nano):参数量仅约300万,可在边缘设备上实现百帧以上推理;
– YOLOv8s(small)/m(medium):中等体量,兼顾精度与速度;
– YOLOv8l/x(large/x-large):追求极致精度,适用于离线或高性能服务器场景。
这意味着你可以根据实际业务需求灵活选择模型尺寸。比如在视频监控平台中,若需同时处理数十路1080P流,显然应优先考虑YOLOv8s甚至v8n,牺牲少量精度换取更高的吞吐量和服务并发数。
更重要的是,YOLOv8原生支持ONNX、TensorRT、OpenVINO等多种导出格式,便于后续做量化、剪枝和硬件加速。这一点对于构建高效推理服务至关重要——毕竟谁也不想每张图都跑在FP32满血模式下。
如何让YOLOv8跑成一个“服务”?容器化是第一步
要想进行压力测试,首先得把模型变成一个能对外提供接口的服务。手动配置PyTorch环境、安装CUDA驱动、解决依赖冲突……这些操作不仅耗时,还会导致“本地能跑,线上报错”的经典问题。
解决方案就是——使用官方提供的YOLOv8 Docker镜像。
这个镜像是一个开箱即用的AI运行时环境,集成了:
– PyTorch + TorchVision
– Ultralytics库(含YOLOv8完整实现)
– CUDA 11.8 / cuDNN 8(适配主流NVIDIA GPU)
– Jupyter Lab 和 SSH 服务
– 常用工具链(pip, git, opencv-python等)
你只需要一条命令就能启动:
docker run -it \\
–gpus all \\
-p 8888:8888 \\
-p 5000:5000 \\
-v ./data:/root/data \\
ultralytics/yolov8:latest
其中 –gpus all 启用GPU支持,-p 映射端口用于访问Jupyter或自定义API,-v 挂载数据卷以便读取测试图像。
进入容器后,你可以通过两种方式交互:
1. 使用Jupyter Lab进行开发调试
浏览器访问 http://<ip>:8888,输入token即可进入图形化编程界面。特别适合快速验证模型功能、可视化结果或调试训练脚本。
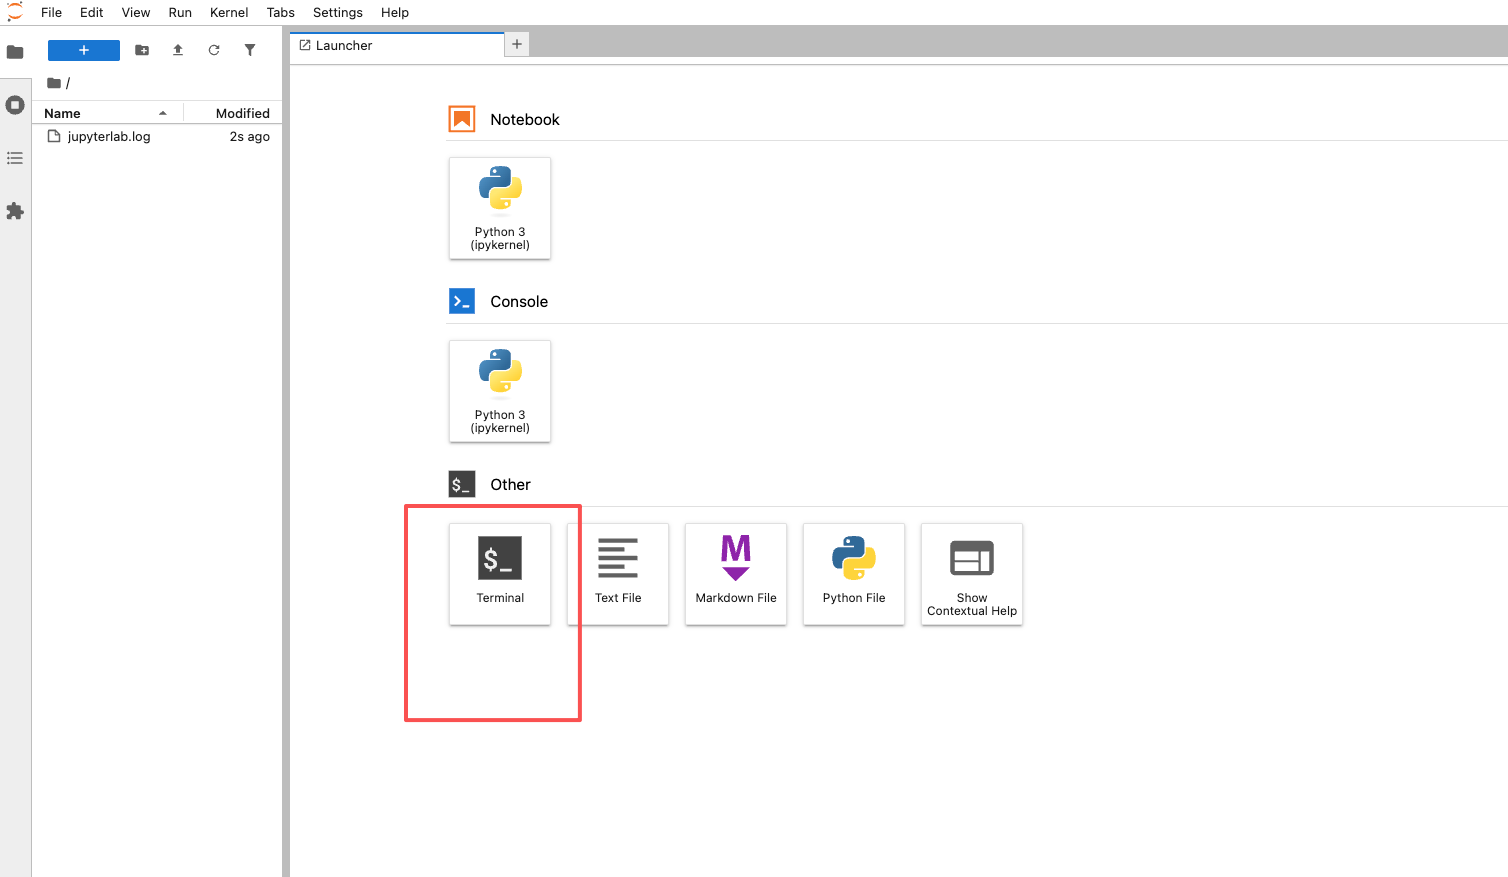
图示:Jupyter项目目录与代码编辑界面
2. 使用SSH远程运维管理
更适合自动化任务或生产环境部署:
ssh root@<container_ip> -p 2222
登录后可直接运行Python脚本、监控资源占用、查看日志输出,适合集成到CI/CD流水线中。
无论哪种方式,核心逻辑一致。以下是一段典型的YOLOv8使用代码,涵盖了加载、训练、推理全流程:
from ultralytics import YOLO
# 加载预训练模型
model = YOLO("yolov8n.pt")
# 查看模型信息(参数量、FLOPs等)
model.info()
# 开始训练(以COCO8为例)
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)
# 执行推理
results = model("path/to/bus.jpg")
这段代码不仅可以用来验证镜像是否正常工作,更是后续构建压力测试客户端的基础模板。
把模型封装成API:让别人“调”你
有了容器环境,下一步是将其包装为HTTP服务。我们可以借助轻量级Web框架如FastAPI,几行代码就实现一个RESTful接口:
from fastapi import FastAPI, UploadFile, File
from ultralytics import YOLO
import uvicorn
import io
from PIL import Image
app = FastAPI()
model = YOLO("yolov8n.pt") # 全局加载模型,避免重复初始化
@app.post("/detect")
async def detect(file: UploadFile = File(…)):
# 读取上传图像
image_data = await file.read()
img = Image.open(io.BytesIO(image_data)).convert("RGB")
# 推理
results = model(img)
# 返回JSON格式结果
return {"results": results.pandas().xyxy[0].to_dict(orient="records")}
if __name__ == "__main__":
uvicorn.run(app, host="0.0.0.0", port=5000)
保存为 app.py 并在容器内运行:
python app.py
此时服务监听在 0.0.0.0:5000,外部可通过POST请求发送图像进行检测:
curl -X POST "http://localhost:5000/detect" \\
-H "Content-Type: multipart/form-data" \\
-F "file=@test.jpg"
一旦API可用,我们就具备了开展压力测试的前提条件。
高并发怎么“造”?用工具模拟真实流量
真正的考验不是单次请求的速度,而是系统在持续高压下的稳定性。我们需要一个工具来模拟数百乃至数千用户同时发起请求,并收集性能指标。
常用的工具有:
– Locust:基于Python的分布式负载测试工具,支持自定义用户行为,适合复杂场景。
– wrk/wrk2:高性能HTTP压测工具,擅长短平快的基准测试。
– ab(Apache Bench):老牌工具,简单易用但功能有限。
推荐使用 Locust,因为它可以精确控制并发用户数、请求频率,并支持自定义任务流。
编写一个简单的测试脚本 load_test.py:
from locust import HttpUser, task, between
import random
class YOLOv8User(HttpUser):
wait_time = between(0.1, 1) # 用户间隔0.1~1秒发起请求
@task
def detect(self):
with open(f"test_images/{random.randint(1, 10)}.jpg", 'rb') as f:
files = {'file': ('image.jpg', f, 'image/jpeg')}
self.client.post("/detect", files=files)
然后启动Locust:
locust -f load_test.py –host http://localhost:5000
打开浏览器访问 http://localhost:8089,设置:
– Number of users to simulate: 200
– Spawn rate: 10 users/sec
点击“Start swarming”,系统会逐步增加并发连接,观察QPS(每秒查询数)、响应延迟(P95/P99)、错误率等关键指标。
与此同时,在服务端使用 nvidia-smi 实时监控GPU利用率、显存占用:
+—————————————————————————–+
| NVIDIA-SMI 525.60.13 Driver Version: 525.60.13 CUDA Version: 12.0 |
|——————————-+———————-+———————-+
| GPU Name Persistence-M| Bus-Id Disp.A | Volatile Uncorr. ECC |
| Fan Temp Perf Pwr:Usage/Cap| Memory-Usage | GPU-Util Compute M. |
|===============================+======================+======================|
| 0 NVIDIA A100-SXM4 On | 00000000:00:1B.0 Off | 0 |
| N/A 35C P0 55W / 400W | 2000MiB / 40960MiB | 78% Default |
+——————————-+———————-+———————-+
如果发现显存迅速打满或GPU利用忽高忽低,说明可能存在批处理不足或资源争抢问题。
性能瓶颈在哪?常见问题与优化思路
在实际测试中,我们经常会遇到以下几种典型情况:
❌ 现象一:QPS上不去,GPU利用率却很低(<30%)
原因分析:每次只处理一张图,无法充分发挥GPU并行计算优势。
解决方案:引入批处理(Batching)机制。例如使用NVIDIA Triton Inference Server,它可以自动合并多个独立请求为一个批次送入模型,大幅提升吞吐量。
# config.pbtxt 示例
name: "yolov8n"
platform: "pytorch_libtorch"
max_batch_size: 32
input [ … ]
output [ … ]
启用批处理后,即使单次延迟略有上升,整体QPS通常可提升3~8倍。
❌ 现象二:P99延迟飙升,部分请求超时
原因分析:可能是冷启动问题,或是长尾请求堆积导致队列阻塞。
建议做法:
– 预热模型:在正式压测前先发送几百个“预热请求”,确保模型已加载至显存;
– 设置合理超时:客户端设置10秒超时,服务端限制最大推理时间;
– 启用限流熔断:结合API网关(如Kong/Nginx)配置速率限制,防止雪崩。
❌ 现象三:内存溢出(OOM),容器自动重启
根本原因:大量并发请求同时加载大图,导致CPU/GPU内存耗尽。
应对策略:
– 统一输入分辨率(如强制缩放到640×640);
– 限制最大图像大小(如不超过2MB);
– 使用轻量模型(v8n > v8s > v8m);
– 开启FP16半精度推理:
model = YOLO("yolov8n.pt").to('cuda').half() # 减少显存占用约40%
构建完整的可观测体系:不只是“跑起来”
一个好的压力测试方案,不仅要能“施压”,更要能“看清”。
推荐搭建如下监控组合:
– Prometheus + Node Exporter + cAdvisor:采集主机与容器资源指标;
– Grafana:可视化展示GPU利用率、内存、QPS、延迟等曲线;
– ELK Stack 或 Loki:集中收集日志,便于排查异常请求。
例如,你可以创建一个仪表盘,实时显示:
– 当前活跃请求数
– 平均响应时间趋势图
– GPU显存使用率
– HTTP状态码分布(5xx突增预警)
再配合告警规则,比如“连续5分钟GPU使用率 > 90%”,即可实现主动式运维。
写在最后:压力测试不是终点,而是起点
很多人以为模型训练完、精度达标就万事大吉,殊不知部署后的表现才是真正的“终极大考”。YOLOv8虽强,但它只是一个组件;真正决定系统成败的,是你对服务架构的理解、对资源调度的掌控以及对极限场景的预见能力。
通过本文介绍的方法,你可以快速搭建一套标准化的压力测试流程:
1. 使用Docker镜像统一环境;
2. 封装为API服务暴露接口;
3. 利用Locust等工具模拟高并发;
4. 收集性能数据并针对性优化;
5. 集成监控告警形成闭环。
这套方法不仅适用于YOLOv8,也可推广至其他深度学习模型的服务化验证。更重要的是,它应当被纳入CI/CD流程,成为每次模型迭代的必经环节——就像单元测试一样不可或缺。
最终你会发现,一个能在千并发下稳定运行的AI服务,远比一个纸上谈兵的高分模型更有价值。