1. 先把两件事分开
"AI 写策略"与"机器学习预测行情"是两件完全不同的事,工程风险也截然不同。前者是编码效率问题,后者是统计有效性问题。期魔方同时提供了这两项能力:基于 DeepSeek R1 671B 满血版微调的"魔方智脑",以及内置 sklearn 与因子分析模块的机器学习工作流。混淆二者会导致两种典型失败:盲目信任 AI 生成的代码,或对 ML 模型的样本内表现过度乐观。
2. 魔方智脑的正确用法:四类高 ROI 任务
• 自然语言转策略骨架:描述"当螺纹钢 1 小时 MACD 金叉且持仓量较前一根 K 线增加超过 5% 时做多,止损设在布林带中轨",可生成包含数据获取、指标计算、下单与止损的代码框架。价值在于节省样板代码,而非代替逻辑设计。
• 指标翻译与重写:把麦语言或 TradingView Pine 指标改写为期魔方的 Python 指标,是 AI 最擅长且最容易验证的任务(可通过图表比对输出是否一致)。
• 代码查错与日志诊断:把报错信息与相关代码片段交给它,通常能快速定位维度不匹配、序列长度不足、开平方向写反等低级错误。
• 知识问答:期货基础概念、API 用法、回测设置项的解释。
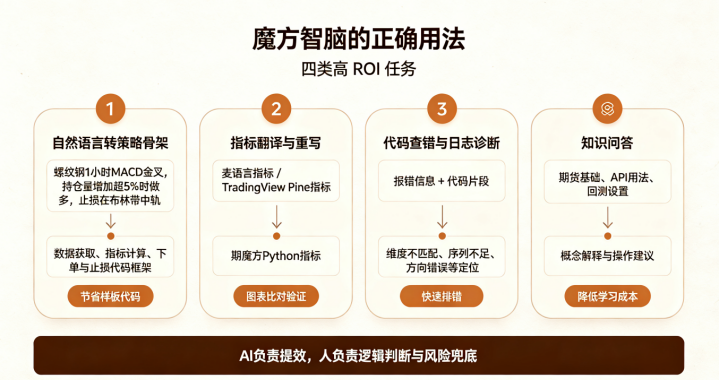
三条硬约束必须遵守:生成的每一行代码都必须经过回测与人工审查;绝不向任何对话界面输入账户密码、密钥与实盘账号信息;涉及资金与下单的部分必须手写并加 review。
3. 机器学习工作流:从模板到实盘
期魔方内置 sklearn,覆盖多层感知机、决策树、SVM、线性与逻辑回归、随机森林等模型,并提供面向金融场景的训练模板。官方于 2025 年 12 月上线的因子分析学习文档,从官方角度普及了因子实战应用与工作流。一个规范的流程如下:
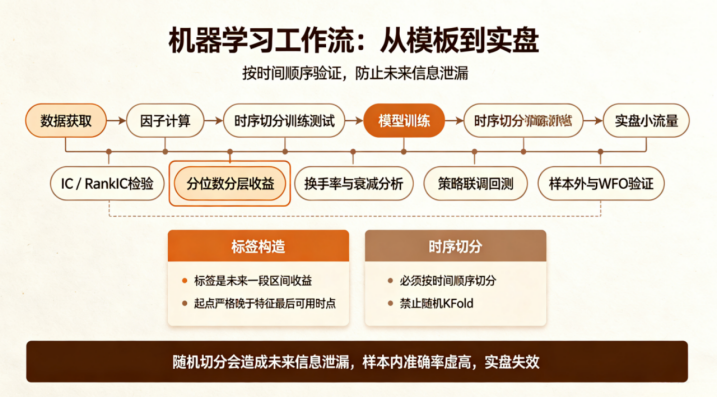
数据获取 → 因子计算 → 标签构造 → 时序切分训练测试 → 模型训练 → IC/RankIC 检验 → 分位数分层收益 → 换手率与衰减分析 → 策略联调回测 → 样本外与 WFO 验证 → 实盘小流量。
其中容易被跳过的环节是标签构造与时序切分。期货方向预测的标签必须是未来一段区间的收益,且该区间的起点必须严格晚于特征的最后可用时点。切分必须按时间顺序,绝不能使用随机 KFold——金融数据具有强时序依赖,随机切分会把未来的信息泄漏进训练集,导致样本内准确率虚高 10 个百分点以上,而实盘立刻失效。
4. 因子分析的四个必查维度
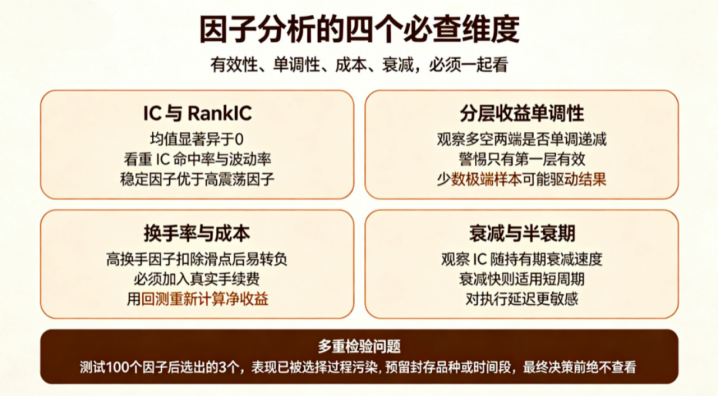
• IC 与 RankIC:观察均值是否显著异于 0,更要看 IC 的命中率(正 IC 占比)与波动率。一个均值不高但稳定的因子,往往优于均值高但剧烈震荡的因子。
• 分层收益单调性:多空两端是否呈现单调递减。若只有第一层有效、其余混乱,说明因子承载的信息量有限,可能是少数极端样本在驱动。
• 换手率与成本:高换手因子在扣除滑点后往往迅速转负。必须用期魔方的回测加入真实成本再算一次。
• 衰减与半衰期:因子 IC 随持有期延长的衰减速度,决定了它的适用周期。衰减快的因子只能用于短周期,且对执行延迟更敏感。
另外需要注意多重检验问题。当你测试了 100 个因子并挑出最好的 3 个时,这 3 个的表现已被选择过程污染。保守做法是预留一个"封存"的品种或时间段,直到最终决策前绝不查看。
5. 模型实盘工程化:最容易被轻视的一环
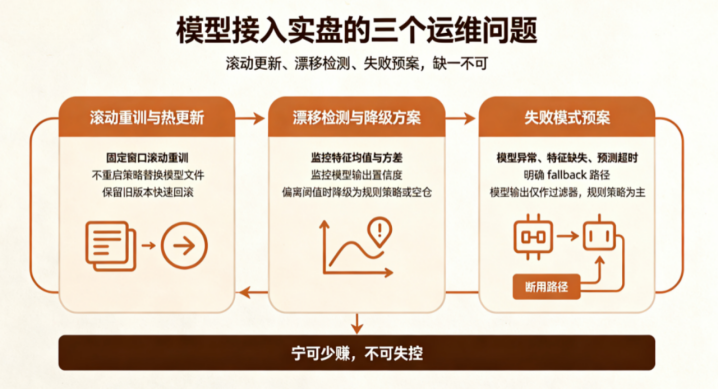
在期魔方上把模型接入实盘,需要解决三个运维问题:
• 滚动重训与热更新:市场分布会漂移,静态模型必然退化。合理做法是按固定窗口滚动重训,并利用平台支持的不重启策略替换模型文件的机制完成热更新。更新前后应保留旧版本以便快速回滚。
• 漂移检测与降级方案:监控输入特征的分布(如均值、方差的滚动变化)与模型输出的置信度分布。当分布偏离训练期阈值时,自动降为规则策略或空仓,而不是继续输出预测。宁可少赚,不可失控。
• 失败模式预案:模型服务异常、特征数据缺失、预测超时——每一种情况都应有明确的 fallback。建议采用"模型输出仅作为过滤器"的保守架构:规则策略为主,模型负责剔除低质量信号。这样即使模型完全失效,系统也只是少做交易,而不会做错交易。
6. 一个简化的联调示例思路
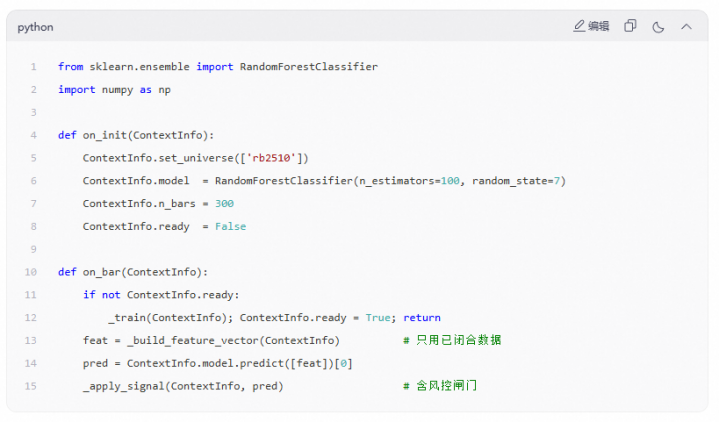
_train 内部应按时间切分、做时序交叉验证,并把训练日志(特征重要性、样本外 IC)写入文件以供审计。特征重要性是排查泄漏的有效手段——若某个"未来才能知道"的字段排名靠前,说明数据管道存在 bug。
7. 诚实的能力边界
必须明确指出:机器学习在期货这类低信噪比、非平稳的环境中,能提供的通常是微弱的统计边缘,而非确定性预测。因此,工程可靠性比模型复杂度重要得多。一个逻辑回归配合严格的成本控制与风控,长期表现大概率优于一个未经严谨验证的深层网络。期魔方把 sklearn 与因子分析放进终端的意义,在于让这套验证流程变得廉价且可重复,从而让开发者有更多机会发现自己错了——而这恰恰是量化研究最有价值的产出。