搞 Linux 网络编程有段时间了,之前写的 UDP 词典和聊天室,数据量小,发个 "hello" 过去 recvfrom 一收就完事,简单粗暴。但等真正上 TCP 做正经项目的时候,发现事情没那么简单——你发的结构体对方收到是一坨乱码,你发三条消息对方收到一条,关了终端服务器就没了。
踩了一堆坑之后回头看,这些问题其实都指向同一件事:你得自己定协议。这篇就把从"裸发字符串"到"能上线的 TCP 服务器"中间缺的那一课补上。
一.TCP 和 UDP 到底差在哪
UDP 是"寄快递"——你发一个包,对方收一个包,一收一发对得整整齐齐。但 TCP 不一样,它是面向字节流的。啥意思?你把 TCP 想象成一根水管,你往里面倒水,水一股脑地流过去。你倒了三杯水,对方那头可能接了一盆,也可能接了半杯。
你发三次 "10+20",对方 recv 一次拿到的可能是 "10+2010+2010+20"——三条全黏一块了。也可能第一次只收到 "10+2",剩下半截在路上还没到。
前者叫粘包,后者叫半包。这是 TCP 的天性,不是 bug,你没法关掉它,只能想办法对付。
二.序列化:结构体不能直接扔网上
来看一段之前写的"裸收发"代码:
static void service(int sock, const std::string &clientip, const uint16_t &clientport)
{
char buffer[1024];
while(true)
{
ssize_t s = read(sock, buffer, sizeof(buffer)-1);
if(s > 0)
{
buffer[s] = 0;
std::cout << clientip << ":" << clientport << "#" << buffer << std::endl;
}
}
}
收发字符串没问题,但现实里你要传的是结构体。有人可能想偷懒:
// 直接发结构体,反面教材
Request req;
write(fd, &req, sizeof(Request));
我以前也这么干过。同一台机器上跑得好好的,一换环境就炸。三个坑等着你:
内存对齐:我这边 g++ 编出来 sizeof(Request) 是 12 字节,到了 MSVC 那边可能就变 16 了,字段位置全错位
大小端:我的 int 是小端,对方 ARM 可能是大端,数字 1 过去变成 16777216
指针:结构体里有指针的话,发过去就是个地址数字,对方那台机器上这个地址压根没有你那块数据
所以正确做法是在发送前把结构体"压扁"成字符串(序列化),收到后再"展开"回结构体(反序列化)。规则你自己定,这套规则就是协议。
三.自定义协议:网络版计算器
要做一个服务器版加法器:客户端发两个数加运算符,服务器算完把结果返回。
3.1先定数据结构
服务端收到请求,客户端收到响应,所以协议里要有两个类:
class Request
{
public:
Request(int x, int y, char op)
: x_(x), y_(y), op_(op) {}
~Request() {}
public:
int x_; // 左操作数
int y_; // 右操作数
char op_; // 运算符:'+' '-' '*' '/' '%'
};
class Response
{
public:
Response(int result, int code)
: result_(result), code_(code) {}
~Response() {}
public:
int result_; // 计算结果
int code_; // 状态码(0=成功,非0=出错)
};
有人可能会问 Response 里为啥要个 code_ ——因为计算可能失败啊。10/0 你怎么返回?返回 0?那 0/0 也返回 0,对方怎么知道"结果是 0"还是"根本算不了"?HTTP 不也有状态码嘛,200 和 404 是一回事。
3.2序列化:把对象变成字符串
Request 序列化目标格式:"x_ op_ y_",比如 "10 + 20"
std::string Serialize()
{
#ifdef MYSELF
std::string str;
str = std::to_string(x_); // "10"
str += SPACE; // 空格
str += op_; // "+"
str += SPACE; // 空格
str += std::to_string(y_); // "20"
return str; // "10 + 20"
#else
std::cout << "TODO" << std::endl;
#endif
}
Response 同理,格式 "code result",比如 "0 30" 表示成功、结果 30。
3.3反序列化:把字符串还原成对象
bool Deserialized(const std::string &str)
{
#ifdef MYSELF
std::size_t left = str.find(SPACE);
if (left == std::string::npos) return false;
std::size_t right = str.rfind(SPACE);
if (right == std::string::npos) return false;
// "1234 + 5678"
x_ = atoi(str.substr(0, left).c_str());
y_ = atoi(str.substr(right + SPACE_LEN).c_str());
if (left + SPACE_LEN > str.size()) return false;
else op_ = str[left + SPACE_LEN];
return true;
#else
std::cout << "TODO" << std::endl;
#endif
}
这里有个技巧:find 找第一个空格、rfind 找最后一个空格。为啥不用 find 找两个空格?因为操作数可能是多位数——"1234 + 5678" 和 "1 + 2" 的空格位置不一样。用一头一尾夹中间,不管操作数几位都能正确切分。
拆解过程画一下就一目了然:
"1234 + 5678"
↑ ↑ ↑
0 5 7
find(SPACE) → left=4 第一个空格
rfind(SPACE) → right=6 最后一个空格
substr(0, 4) → "1234" → x_=1234
str[5] → '+' → op_='+'
substr(7) → "5678" → y_=5678
四.粘包怎么破:长度头方案
序列化出来的 "10 + 20" 只是有效载荷,对方不知道这条消息有多长。你在两条消息之间没有边界,TCP 就会把它们当一坨数据流给你。
三种定界方案:
|
定长 |
每条固定 1024 字节,不够补空格 |
浪费带宽 |
|
特殊字符 |
用 \\n 分隔 |
正文里不能出现分隔符 |
|
长度头 |
先发长度,再发正文 |
最灵活,工业级 |
选第三种。报文格式:"length\\r\\npayload\\r\\n"
比如 "10 + 20" 是 7 字节,编码后变成 "7\\r\\n10 + 20\\r\\n"。
有人可能担心:length 里面会不会出现 \\r 或 \\n?不会。std::to_string(s.size()) 转出来的是纯数字 0-9,不可能有换行符。所以用 \\r\\n 做分隔是安全的。当然你要是以后用 JSON 序列化,正文里可能就有 \\r\\n 了,那时候得换二进制长度头,不靠分隔符——不过那是后话。
Encode 函数:
std::string Encode(std::string &s)
{
std::string new_package = std::to_string(s.size());
new_package += SEP; // \\r\\n
new_package += s; // 正文
new_package += SEP; // \\r\\n
return new_package;
}
五.Recv 和 Decode:粘包半包的解法
5.1Recv:只管收,不管切
recv 不能保证一次读到完整报文。所以 Recv 干的事就是:把收到的数据往 inbuffer 后面追加,完整性交给 Decode 判断。
bool Recv(int sock, std::string *out)
{
char buffer[1024];
ssize_t s = recv(sock, buffer, sizeof(buffer)-1, 0);
if (s > 0)
{
buffer[s] = 0; // recv 返回的是裸字节,不保证有 '\\0',必须手动加
*out += buffer; // 注意是 += 不是 =
}
else if (s == 0) // 对端关了
{
std::cout << "client quit" << std::endl;
return false;
}
else // 出错
{
std::cout << "recv error" << std::endl;
return false;
}
return true;
}
*out += buffer 这个 += 是整个设计的精髓。上一次可能只读了半条,这次接着读,必须往后面追加,用 = 赋值会把之前的数据全覆盖掉。
5.2Decode:从缓冲区切出完整报文
这是协议里最精妙的部分。从一坨字节流里准确切出一条完整报文,靠的就是长度头:
std::string Decode(std::string &buffer)
{
// 1. 找第一个 \\r\\n,前面就是长度
std::size_t pos = buffer.find(SEP);
if(pos == std::string::npos) return ""; // 连长度头都没收到
// 2. 把长度字符串转成数字
int size = atoi(buffer.substr(0, pos).c_str());
// 3. 看看剩余字节够不够取出完整报文
int surplus = buffer.size() – pos – 2*SEP_LEN;
if(surplus >= size)
{
// 够了,切出来
buffer.erase(0, pos+SEP_LEN); // 删掉长度头+第一个\\r\\n
std::string s = buffer.substr(0, size); // 取出正文
buffer.erase(0, size + SEP_LEN); // 删掉正文+结尾\\r\\n
return s; // 剩下的留在 buffer 里,下次继续切
}
else
{
return ""; // 不够,等下次 recv
}
}
三种场景走一遍就彻底懂了:
完整一条:
收到: "7\\r\\n10 + 20\\r\\n"
→ 找到 \\r\\n,长度=7,正文够 7 字节 → 切出 "10 + 20" ✓
半包(只发了半截):
第1次收到: "7\\r\\n10 +"
→ 长度=7,但正文只有 5 字节 → 不够 → 返回空 → continue 等下次
第2次收到: 追加后变成 "7\\r\\n10 + 20\\r\\n"
→ 够了 → 切出 "10 + 20" ✓
粘包(两条黏一起):
收到: "7\\r\\n10 + 20\\r\\n8\\r\\n30 * 40\\r\\n"
→ 切出第一条 "10 + 20",buffer 剩 "8\\r\\n30 * 40\\r\\n"
→ 下一轮循环再切第二条 "30 * 40" ✓
六.服务端主循环
把零件拼起来,服务端的 calculator 就是七步循环:
void calculator(int sock)
{
std::string inbuffer; // 累积缓冲区
while (true)
{
// 1. 收数据 → 追加到 inbuffer
bool res = Recv(sock, &inbuffer);
if (!res) break;
// 2. 切出一条完整报文
std::string package = Decode(inbuffer);
if (package.empty()) continue; // 没凑齐,继续等
// 3. 反序列化:"10 + 20" → Request 对象
Request req;
req.Deserialized(package);
// 4. 计算
Response resp = calculatorHelper(req);
// 5. 序列化:Response → "0 30"
std::string respString = resp.Serialize();
// 6. 加长度头:"4\\r\\n0 30\\r\\n"
respString = Encode(respString);
// 7. 发回去
Send(sock, respString);
}
}
收 → 切包 → 反序列化 → 计算 → 序列化 → 加头 → 发。网络层(Recv/Send)和业务层(calculatorHelper)各管各的,中间靠协议层做翻译。想换业务?把 calculatorHelper 换成别的函数就行,服务器框架一行不用动。
七.计算逻辑
static Response calculatorHelper(const Request &req)
{
Response resp(0, 0); // 默认成功
switch (req.op_)
{
case '+': resp.result_ = req.x_ + req.y_; break;
case '-': resp.result_ = req.x_ – req.y_; break;
case '*': resp.result_ = req.x_ * req.y_; break;
case '/':
if (0 == req.y_) resp.code_ = 1; // 除0
else resp.result_ = req.x_ / req.y_;
break;
case '%':
if (0 == req.y_) resp.code_ = 2; // 模0
else resp.result_ = req.x_ % req.y_;
break;
default: resp.code_ = 3; // 非法操作符
}
return resp;
}
|
0 |
正常 |
|
1 |
除 0 |
|
2 |
模 0 |
|
3 |
非法操作符 |
八.客户端
流程跟服务端镜像对称:序列化请求 → 加报头 → 发 → 收响应 → 去报头 → 反序列化 → 看结果。
int main(int argc, char *argv[])
{
if (argc != 3) { Usage(argv[0]); exit(1); }
std::string server_ip = argv[1];
uint16_t server_port = atoi(argv[2]);
Socket sock;
int sockfd = sock.Socket();
if (!sock.Connect(sockfd, server_ip, server_port))
{ std::cerr << "Connect error" << std::endl; exit(2); }
bool quit = false;
std::string buffer;
while (!quit)
{
// 1. 输入
Request req;
std::cout << "Please Enter # ";
std::cin >> req.x_ >> req.op_ >> req.y_;
// 2. 序列化 + 3. 加报头 + 4. 发送
std::string s = req.Serialize();
s = Encode(s);
Send(sockfd, s);
// 5. 收响应(也要循环,响应也可能半包)
while (true)
{
bool res = Recv(sockfd, &buffer);
if (!res) { quit = true; break; }
std::string package = Decode(buffer);
if (package.empty()) continue;
Response resp;
resp.Deserialized(package);
std::string err;
switch (resp.code_)
{
case 1: err = "除0错误"; break;
case 2: err = "模0错误"; break;
case 3: err = "非法操作"; break;
default:
std::cout << req.x_ << req.op_ << req.y_ << " = "
<< resp.result_ << " [success]" << std::endl;
break;
}
if (!err.empty()) std::cerr << err << std::endl;
break;
}
}
close(sockfd);
return 0;
}
注意第 5 步也有个内层 while——响应跟请求一样可能半包到达,也得反复 Recv+Decode。
九.参数传递的小约定
顺带提一下,后面代码里有三种参数写法,记一下省得看晕:
// const std::string & — 只看不摸(输入型)
void printName(const std::string &name) { std::cout << name << std::endl; }
// std::string * — 只写不读(输出型)
void getData(std::string *result) { *result = "算出来的数据"; }
// std::string & — 又看又摸(输入输出型)
void processData(std::string &data) { data += "追加"; }
服务端那个回调 func_t 里 const Request& req 是输入、Response& resp 是输出,就是这么来的。
十.守护进程:别让你的服务器死在终端上
10.1为啥要搞这个
之前写的所有服务器都挂在前台终端上跑。你关了 XShell,它就没了。正经的网络服务哪能这样?用户一注销服务器就挂,那还叫什么"服务"。
原理是这样的:你登录 Linux,系统给你建一个会话(Session),bash 和你之后开的进程全在这个会话里。你一注销,会话散了,里面所有进程跟着没。网络服务器必须从会话里逃出来,自己单独立一个新会话——这就是守护进程(Daemon)。
10.2怎么逃出来
setsid() 能让进程自立新会话。但有个前提:当前进程不能是组长。怎么保证?fork() 一个子进程让父进程退场,子进程拿了个新 PID,肯定不是组长。
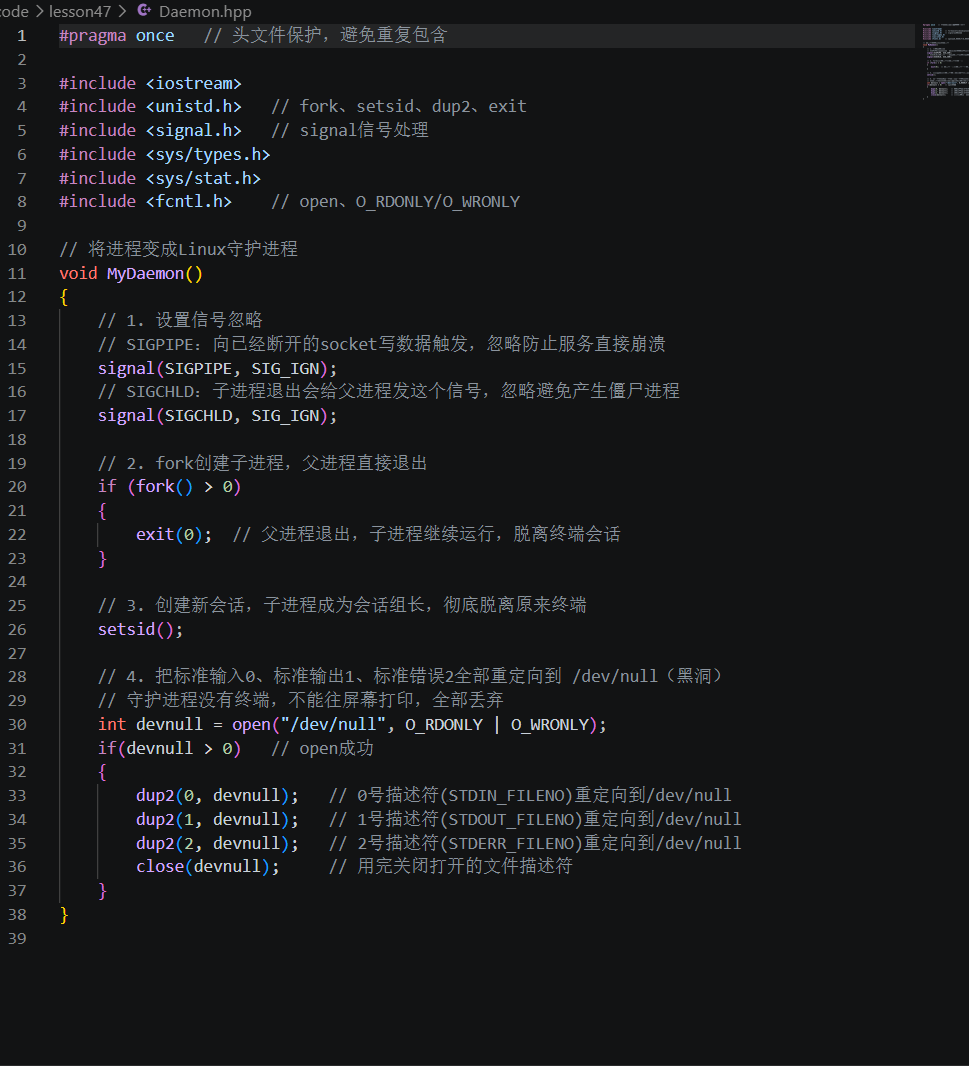
10.3完整代码
#pragma once
#include <iostream>
#include <unistd.h>
#include <signal.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
void MyDaemon()
{
// 1. 装聋作哑:忽略 SIGPIPE 和 SIGCHLD
// SIGPIPE:往断开的管道写数据会崩,忽略它
// SIGCHLD:子进程死了会变僵尸,忽略它省得收尸
signal(SIGPIPE, SIG_IGN);
signal(SIGCHLD, SIG_IGN);
// 2. 断后路:fork 子进程,父进程退场
// 确保子进程不是组长,为 setsid 做准备
if (fork() > 0)
exit(0);
// 3. 自立门户:调用 setsid,脱离终端
// 从此 SID = 自己的 PID,不再受任何终端控制
setsid();
// 4. 扔垃圾:把 0/1/2 全指向 /dev/null
// 守护进程不能往显示器打印,一打印可能被暂停
int devnull = open("/dev/null", O_RDONLY | O_WRONLY);
if(devnull > 0)
{
dup2(devnull, 0); // 标准输入 → 黑洞
dup2(devnull, 1); // 标准输出 → 黑洞
dup2(devnull, 2); // 标准错误 → 黑洞
close(devnull);
}
}
四步口诀:装聋作哑 → 断后路 → 自立门户 → 扔垃圾。
/dev/null 是 Linux 的"黑洞文件",写进去的数据全丢,读出来永远 EOF。守护进程把 0/1/2 全指向它,等于堵住耳朵闭上嘴,外面怎么吵都不影响干活。
守护进程化之后,相当于你的服务真正"部署"到了 Linux 上——XShell 关了它还在跑,客户端照样连。想停只能 kill -9。这也是为什么正经的守护进程名字都带个 d 后缀:sshd、mysqld、httpd。
十一.数据流转全景
一条消息从用户输入到屏幕显示,要走 12 步:
|
1 |
客户端 |
用户输入 |
std::cin |
|
2 |
协议层 |
序列化 |
Serialize() |
|
3 |
协议层 |
加长度头 |
Encode() |
|
4 |
通信层 |
发送 |
Send() |
|
5 |
通信层 |
接收 |
Recv() |
|
6 |
协议层 |
撕掉长度头 |
Decode() |
|
7 |
协议层 |
反序列化 |
Deserialized() |
|
8 |
服务端 |
算结果 |
calculatorHelper() |
|
9 |
协议层 |
序列化+编码 |
Serialize() + Encode() |
|
10 |
通信层 |
发回 |
Send() |
|
11 |
客户端 |
解码+反序列化 |
Decode() + Deserialized() |
|
12 |
客户端 |
显示 |
cout |
三层分工:
-
Sock.hpp / TcpServer.hpp:跑腿的,不管业务
-
Protocol.hpp:定规矩的,不管跑腿
-
CalClient.cc / CalServer.cc:发号施令的,算账的
十二.踩过的坑
别直接发结构体:内存对齐、大小端、指针,跨平台必乱码。老老实实序列化。
粘包半包是必然的:别指望一次 recv 恰好读到一条完整报文,长度头 + 累积缓冲区 + Decode 缺一不可。
Recv 用 += 不是 =:上次读的半条不能覆盖,必须追加。
length 不会有 \\r\\n:to_string(size) 只产生数字,用 \\r\\n 做分隔是安全的。换 JSON 就不行了。
buffer[s] = 0 不能忘:recv 返回裸字节,不保证有 \\0,不手动加的话 string += 拼出来的东西长度不对。
守护进程别往屏幕打印:重定向到 /dev/null 后 cout 全进黑洞了。想看日志写文件。
setsid 前必须 fork:你是组长的话 setsid 会失败。fork 后父退出,子进程保证不是组长。
dup2 参数别写反:dup2(devnull, 1) 是把 devnull 复制到 1,不是反过来。
客户端收响应也要循环:响应也可能半包到达,跟请求一样。
十三.知识图谱
自定义 TCP 协议
│
┌────────────────────┼────────────────────┐
序列化/反序列化 报文边界 守护进程
│ │ │
┌────┴────┐ ┌────┴────┐ ┌────┴────┐
Request Response 长度头方案 装聋作哑 signal
"x op y" "code r" "len\\r\\npayload\\r\\n" 断后路 fork+exit
│ │ │ 自立门户 setsid
Serialize Serialize Encode 扔垃圾 dup2→/dev/null
Deserial Deserial Decode
│ │ │
└────┬───┴────────┘
│
服务端 7 步:Recv→Decode→Deserial→calc→Serial→Encode→Send
客户端镜像:输入→Serial→Encode→Send→Recv→Decode→Deserial→显示
说到底,网络编程的核心不是"收发数据"——那只是 read/write 两个系统调用的事。真正难的是怎么让对方看懂你的数据。序列化把结构体变成可传输的字符串,长度头保证对方切出完整报文,守护进程让服务脱离终端独立跑——三件事各管一摊,你的 TCP 服务器才算真正能上线的。不是玩具了
十四.代码演示:
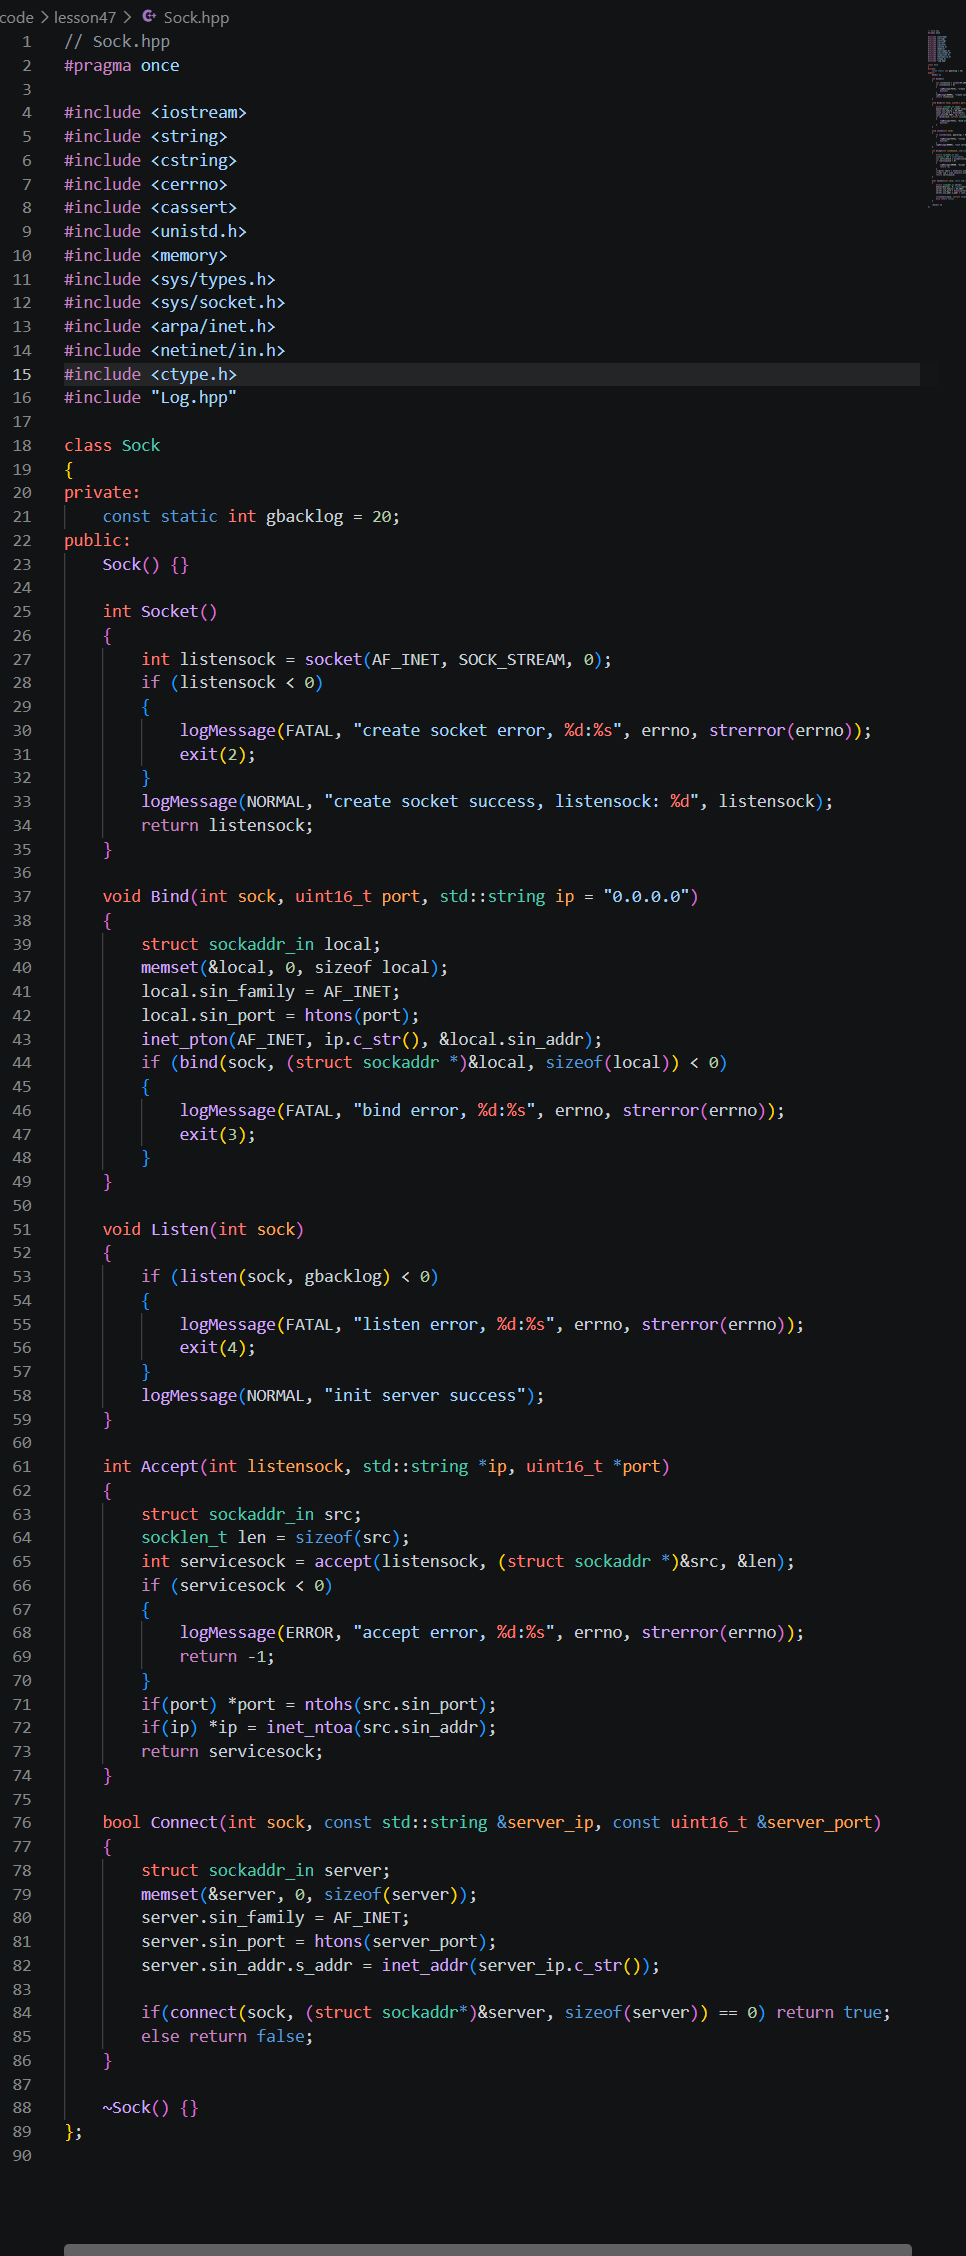
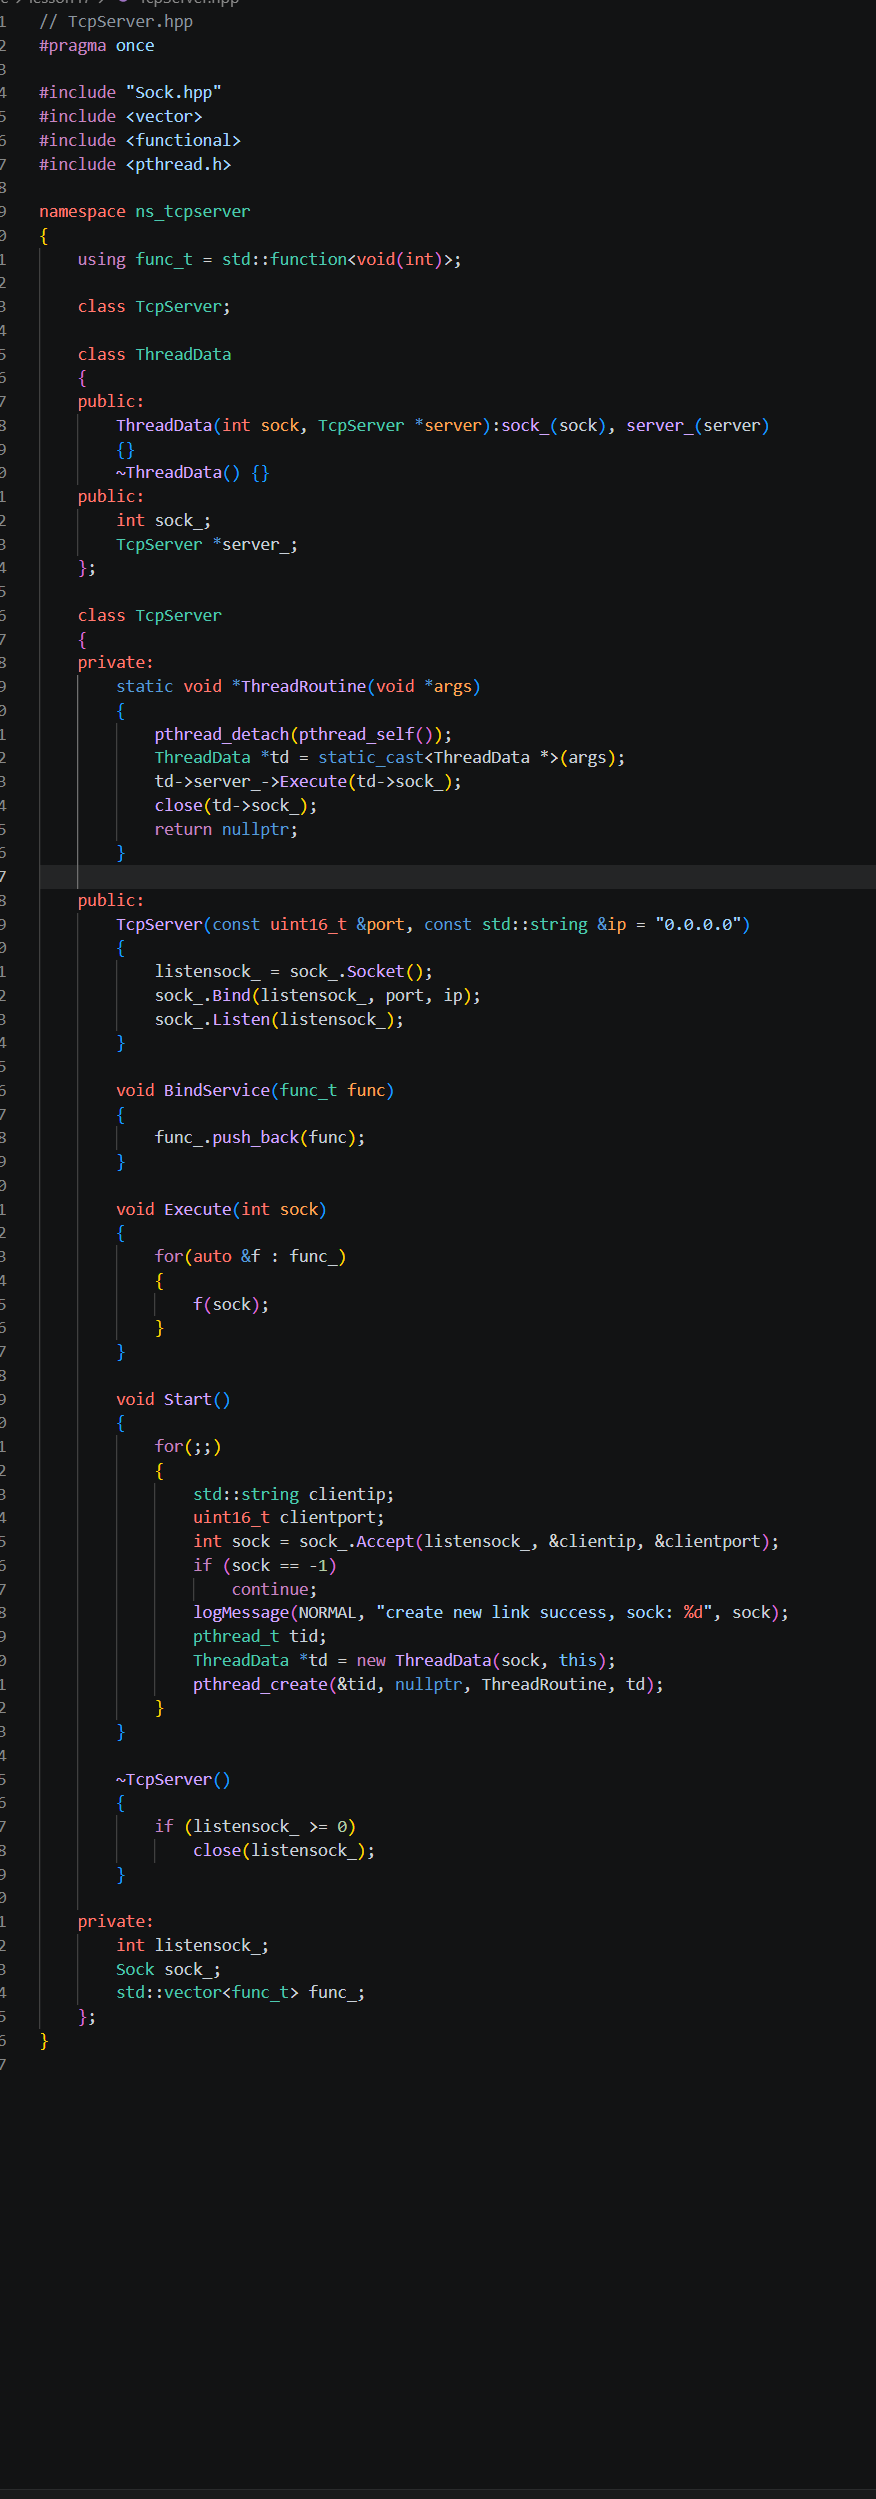
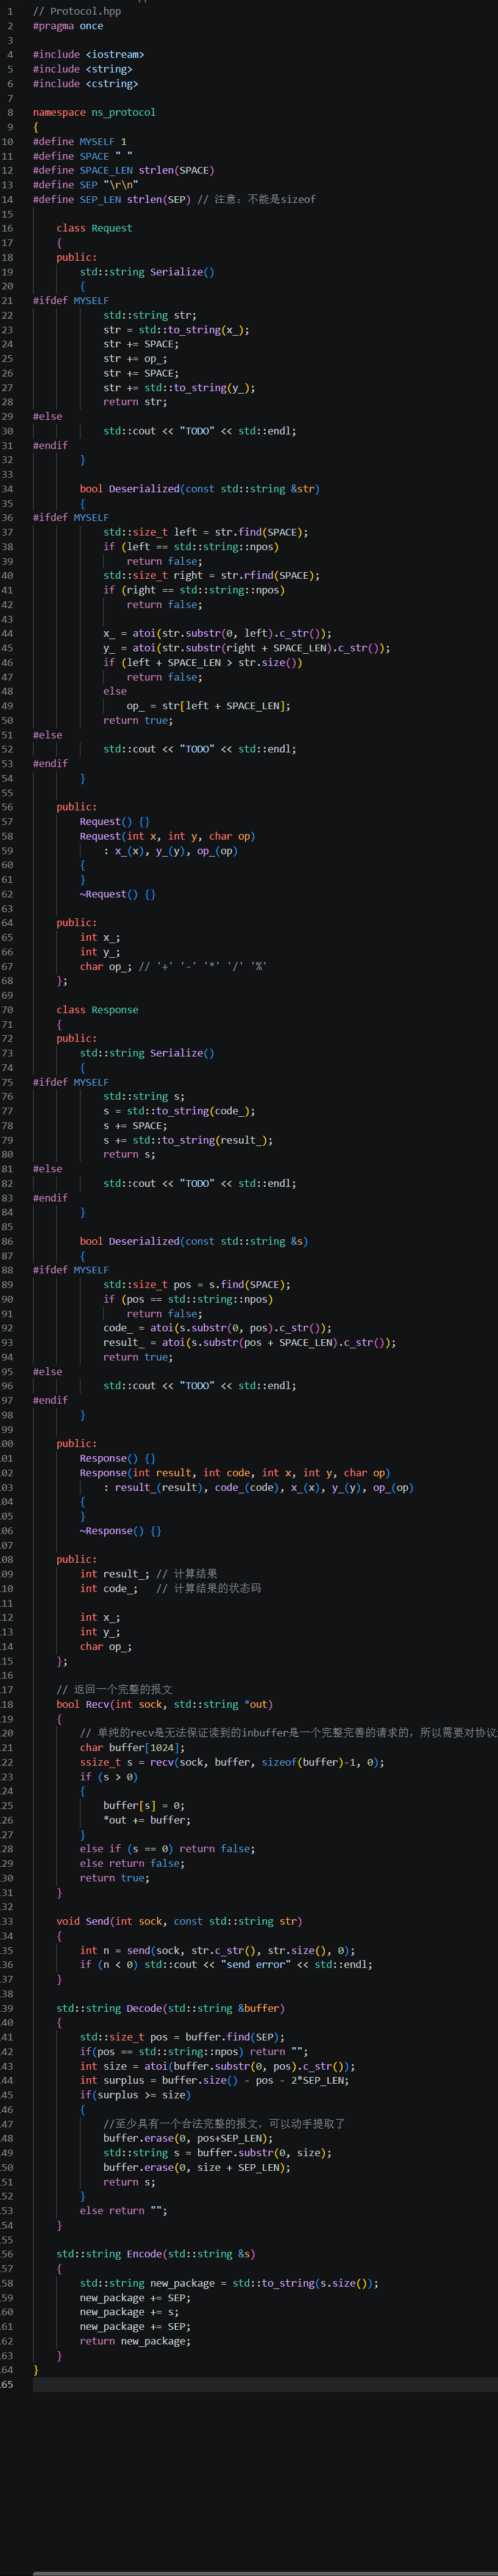
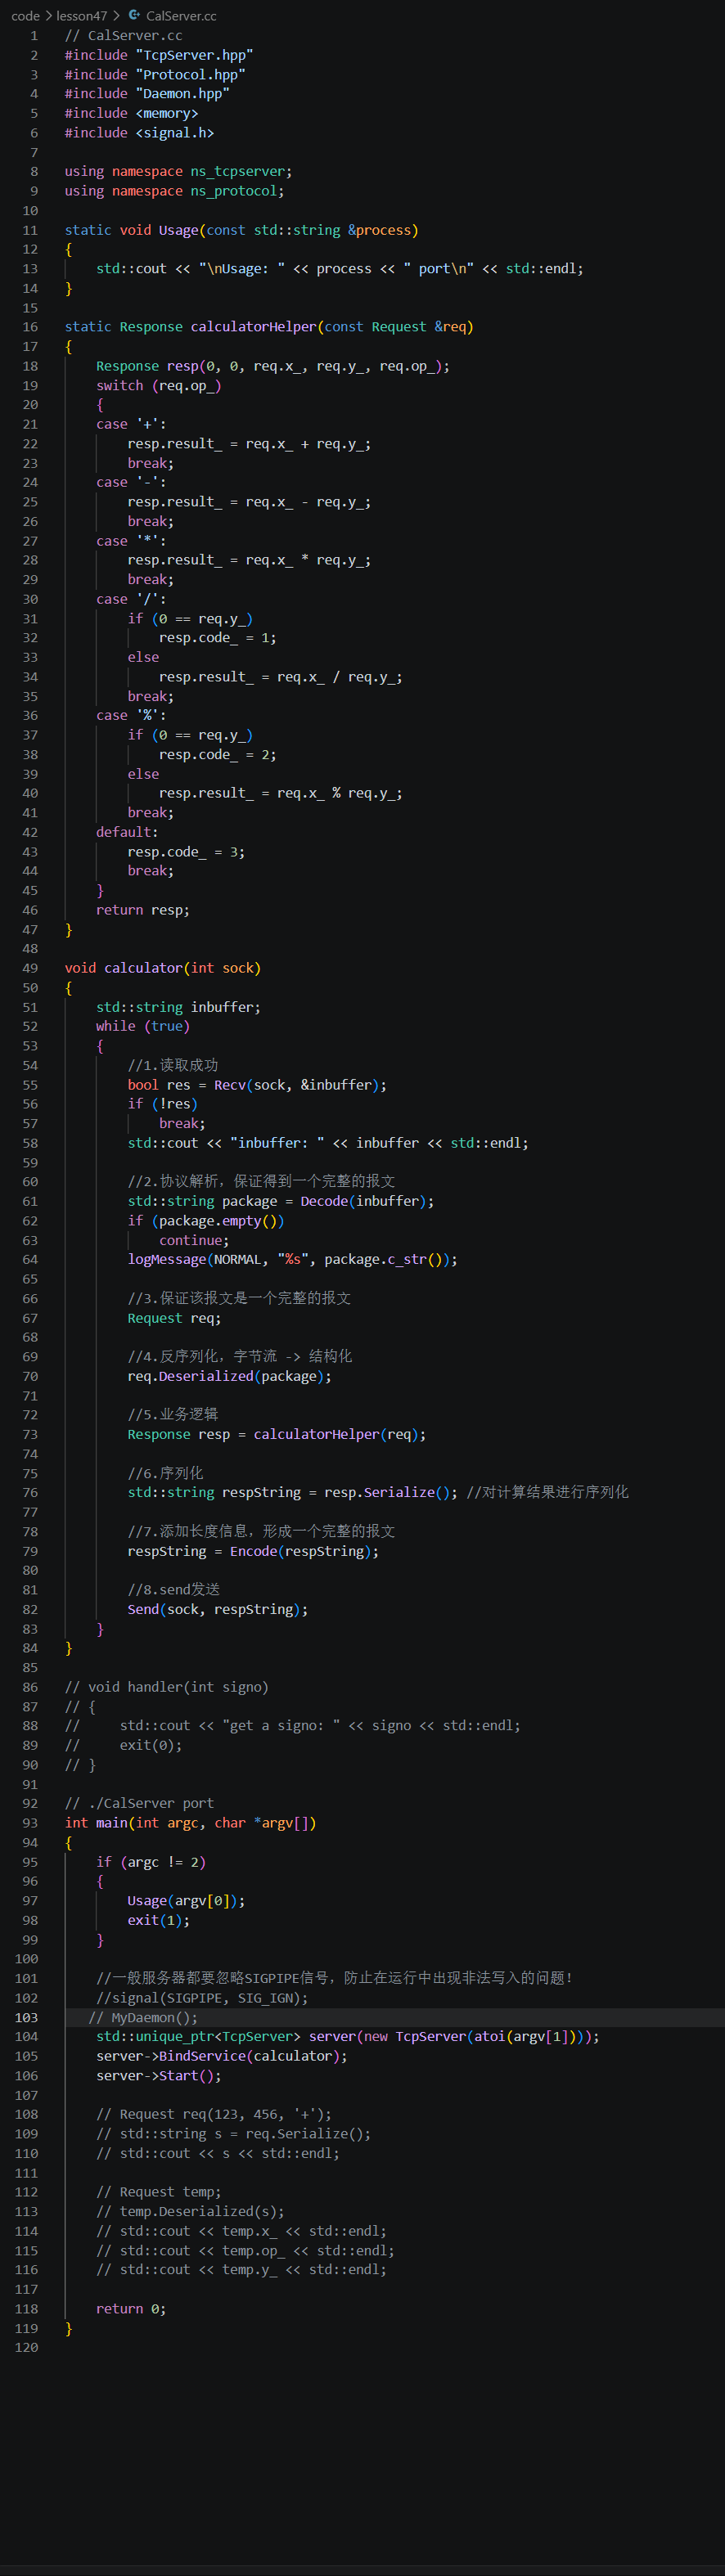
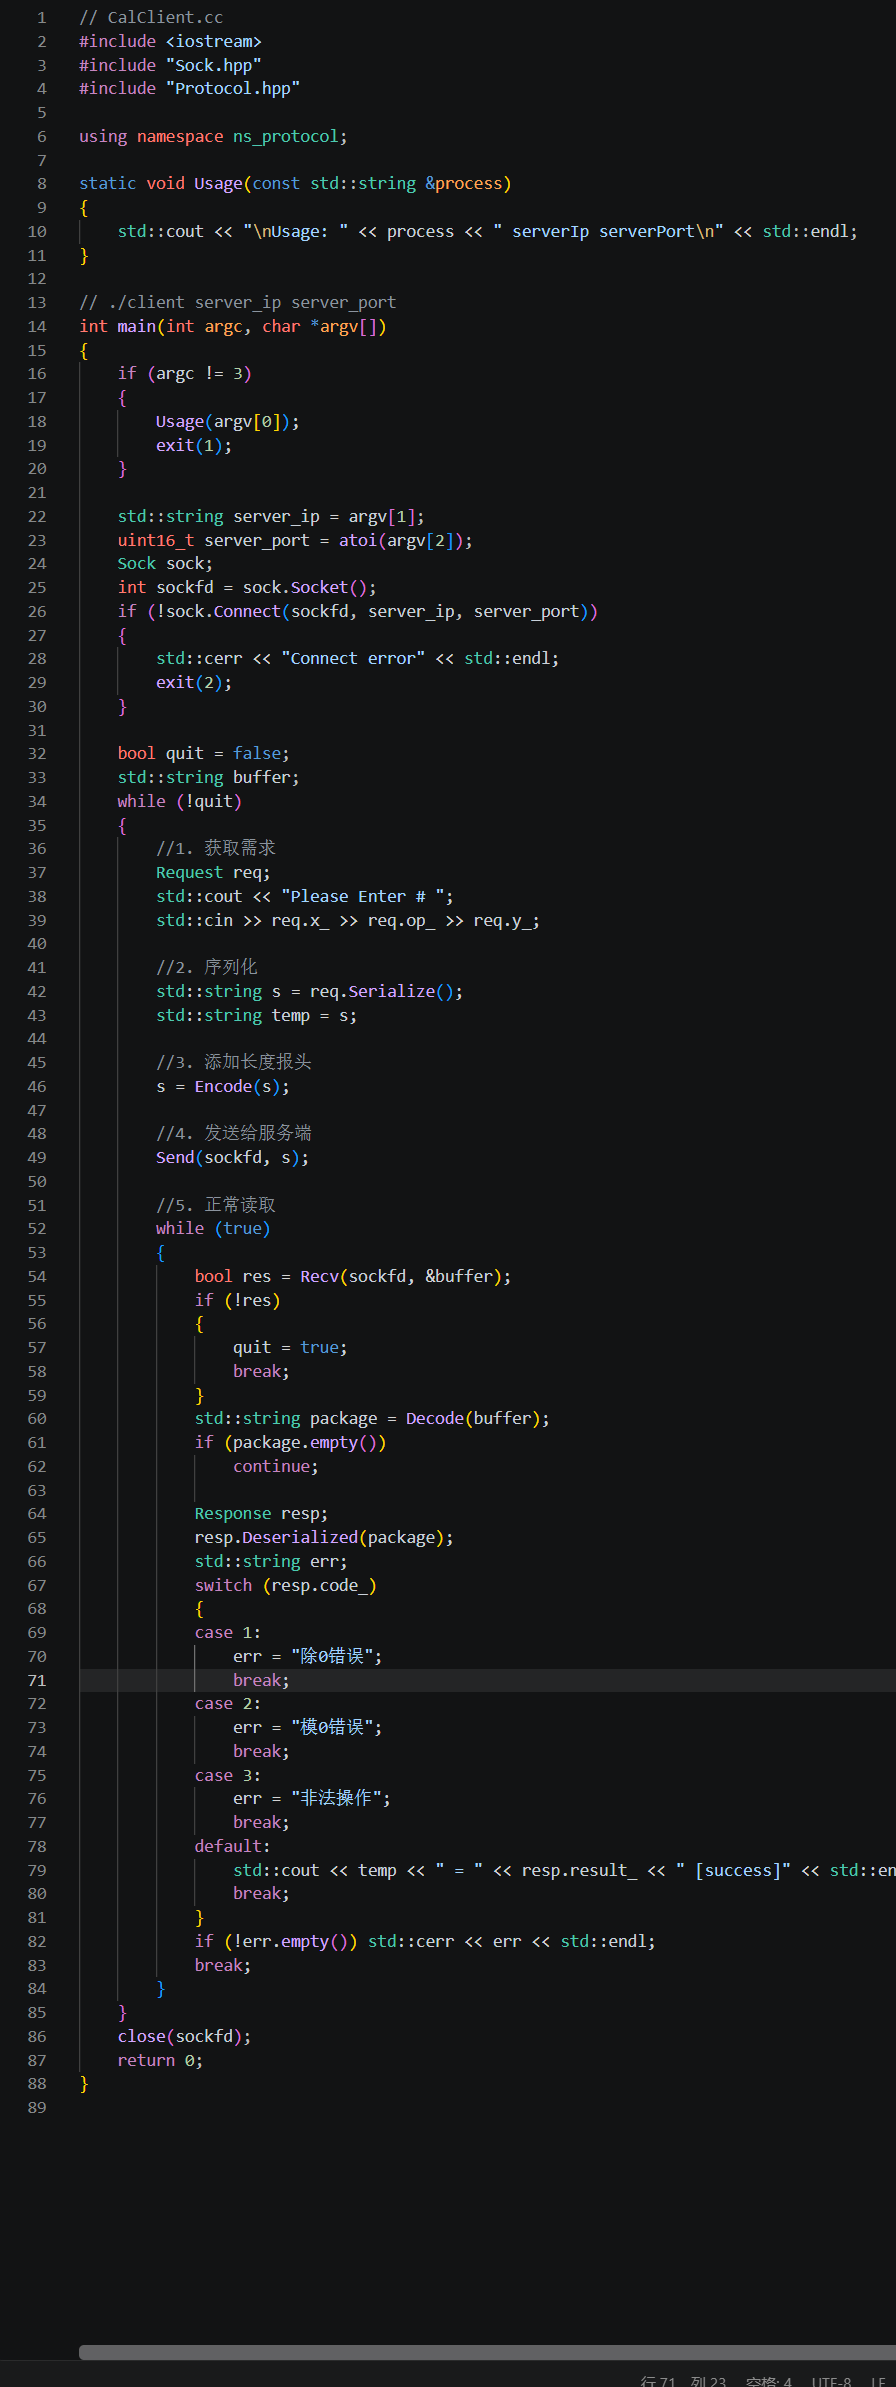
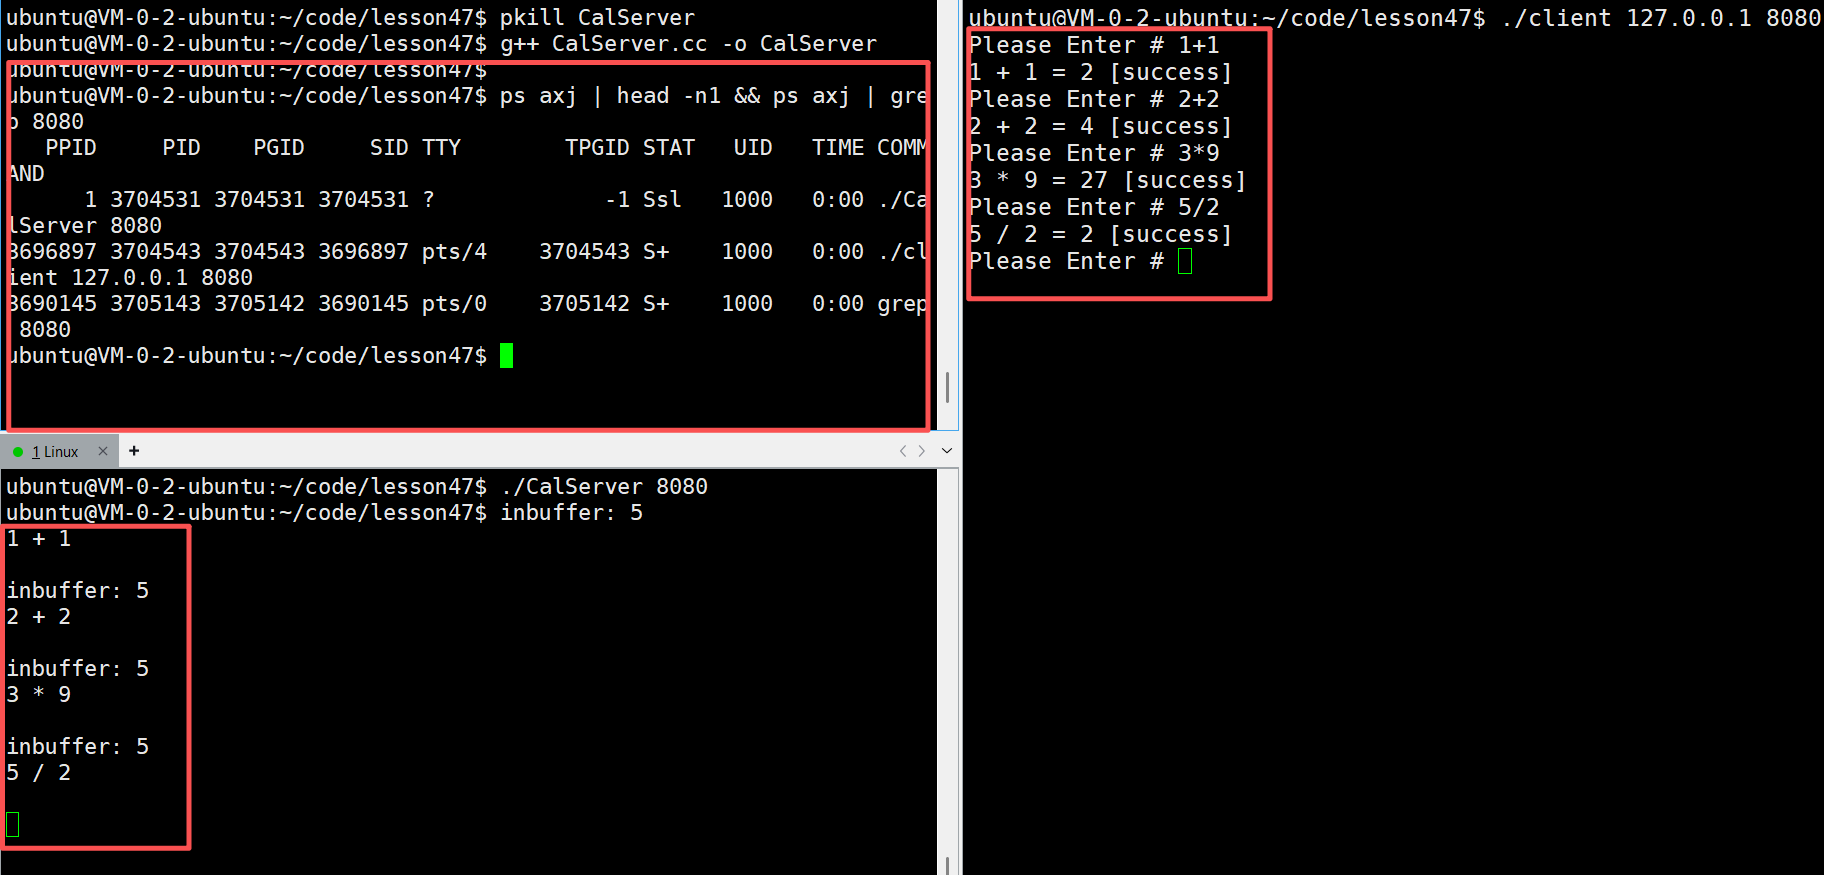
| 1. 提需求 | 客户端 (CalClient.cc) | 用户输入数据 | 输入 1 + 2 | 用户说:我要算这个。 |
| 2. 结构化→字符串 | 协议层 (Protocol.hpp) | 序列化 | Serialize() | 把 1、+、2 打包成字符串 1 + 2。 |
| 3. 字符串→带信封 | 协议层 (Protocol.hpp) | 编码 | Encode() | 套上长度头,变成 5\\r\\n1 + 2\\r\\n,防止数据粘包。 |
| 4. 运输 | 通信层 (Sock.hpp) | 发送 | Send() | 客户端通过 TCP 把信封扔给服务器。 |
| 5. 接收 | 通信层 (Sock.hpp) | 接收 | Recv() | 服务器在门口拿到信封。 |
| 6. 带信封→字符串 | 协议层 (Protocol.hpp) | 解码 | Decode() | 撕掉长度头 5\\r\\n,拿出纯净的 1 + 2。 |
| 7. 字符串→结构化 | 协议层 (Protocol.hpp) | 反序列化 | Deserialized() | 把 1 + 2 拆开,重新装进结构体。 |
| 8. 算数 | 服务端 (CalServer.cc) | 业务逻辑 | calculatorHelper() | 服务器算出结果 3。 |
| 9. 结果打包 | 协议层 (Protocol.hpp) | 序列化+编码 | Serialize() + Encode() | 把结果 3 打包成 1\\r\\n3\\r\\n。 |
| 10. 回传 | 通信层 (Sock.hpp) | 发送 | Send() | 服务器把结果信封扔回客户端。 |
| 11. 拆包展示 | 客户端 (CalClient.cc) | 解码+反序列化 | Decode() + Deserialized() | 客户端收到信封,拆开取出 3。 |
| 12. 显示结果 | 客户端 (CalClient.cc) | 打印 | cout | 屏幕上显示:1 + 2 = 3。 |
- Sock.hpp / TcpServer.hpp:只负责跑腿(网络传输),不负责懂业务。
- Protocol.hpp:只负责定规矩(打包拆包),不负责跑腿。
- CalClient.cc / CalServer.cc:只负责发号施令和算账(业务逻辑)。