今天刷榜,看到一个挺有意思的新模型:Spark-X2.5。我个人是从事轻量化这个方向研究的,对本地部署也一直比较关注。科大讯飞也算是磨出了把大剑。直接看榜吧:
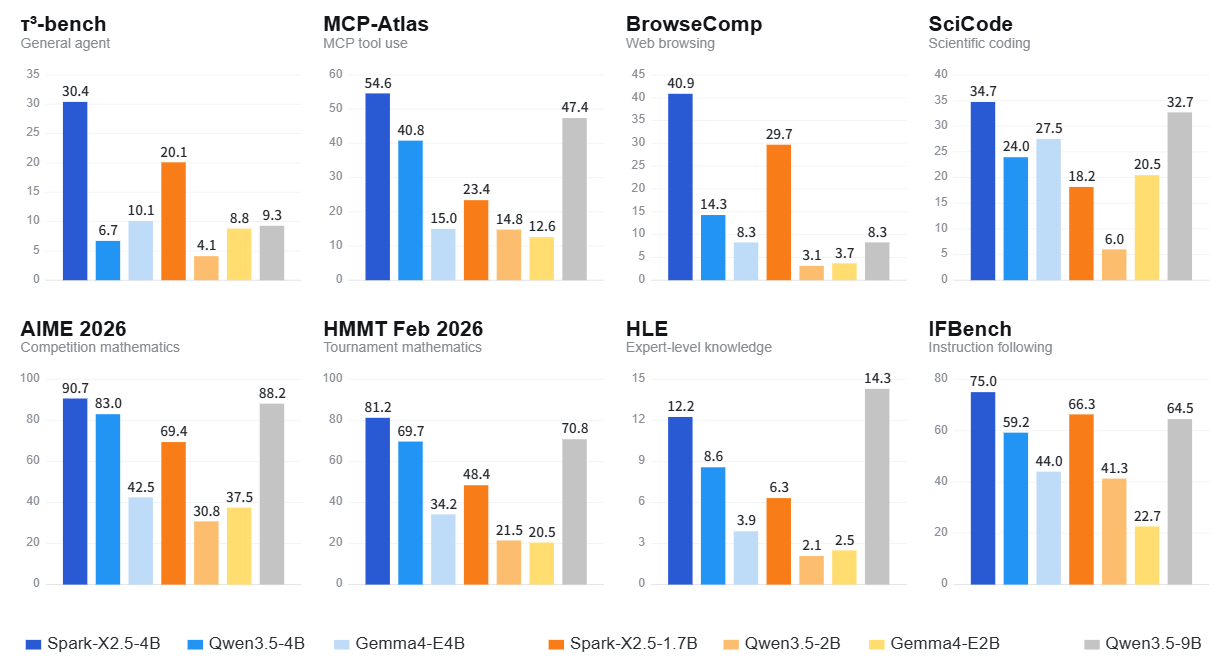
4B打败了9B和7B确实令人印象深刻,而且最主要的是这个结果反直觉。因此,了解了个大概后,我就自觉地跑来写文章了。想着先分享给大家,如果有错误也欢迎大家给我指出来。它目前主要有两个版本:Spark-X2.5-4B 和 Spark-X2.5-1.7B。
Spark-X2.5
真正让我注意到它的,并不是又发布了一个“小参数模型”,而是官方给它的定位非常明确:
Pushing the Limits of Agentic Capabilities in On-Device Models
翻译过来,大致就是:
把端侧小模型的 Agent 能力继续往前推。
这句话其实比“4B 模型”本身更重要。
因为过去几年,大模型的发展主线一直很直观:模型越来越大,7B、14B、32B、70B……参数规模不断上涨。但真正到了本地部署、个人电脑、手机、边缘设备这些场景以后,一个现实问题始终绕不开:
大模型很好,但太贵、太慢,也太吃显存。
于是另一个方向开始变得越来越重要:
与其想办法把一个 70B 模型塞进个人电脑,不如反过来思考:能不能把一个 4B 模型训练到真正“够用”?
Spark-X2.5 就是在回答这个问题。
它只有约 4B 参数,却重点强化了推理、Coding、工具调用、Agent 工作流和长上下文能力,同时原生支持最高 1M Token Context,并且从一开始就考虑了 vLLM、SGLang、llama.cpp、MLX、Ollama、LM Studio 等本地推理生态。
所以这篇文章不打算简单讨论“4B 能不能打赢 9B”,而是想聊清楚一个更有意思的问题:
为什么今天,一个只有 4B 的模型,已经开始有资格成为真正的本地 Agent 大脑?
一、Spark-X2.5 的核心思路:模型做小,但训练不能小
Spark-X2.5 官方披露的预训练规模大约为:
20 Trillion Tokens,也就是约 20T Token。
而 Spark-X2.5-4B 本身只有大约 4B 量级参数。
如果只是为了帮助理解,简单做一个粗略比值:
20T4B≈5000
\\frac{20T}{4B}\\approx5000
4B20T≈5000
当然,这并不意味着“每个参数训练 5000 次”这么简单,也不能直接拿这个数衡量模型能力,但它反映了一个很明显的思路:
这是一个参数规模不大,但被非常充分训练的小模型。
这其实是近年来小模型发展中非常重要的一条路线。
以前人们容易形成一个简单直觉:
参数越多,模型越强。
这个规律当然没有失效,但今天模型能力已经越来越不能只看参数量。更合理的理解是:
能力=f(参数规模, 数据质量, 训练量, 后训练, 推理计算, 工具能力)
能力=f(参数规模,\\ 数据质量,\\ 训练量,\\ 后训练,\\ 推理计算,\\ 工具能力)
能力=f(参数规模, 数据质量, 训练量, 后训练, 推理计算, 工具能力)
Spark-X2.5 恰恰是在后面几个变量上下了很大功夫。
它不是简单完成预训练和监督微调就结束,而是在 SFT 之后继续进行了面向语言理解、数学推理、编程、Agent 工具调用和指令遵循的大规模强化学习。
官方还提到一个很有意思的训练思路:不同训练阶段会得到面向不同能力的 Teacher Policies,例如推理、代码、Agent、语言、指令遵循等,然后再通过官方称为 MOPD 的方法,把这些互补能力整合回最终可部署的 Spark-X2.5。
可以把它理解成一种“小模型能力压缩”的思路:
不是要求一个 4B 模型从头到尾什么都自己学,而是在训练阶段利用更强、更专业的策略不断教它,最后把这些能力尽可能压缩进一个小模型里。
这也是为什么现在越来越多厂商愿意花更大的训练成本去“喂饱”一个小模型。
原因很现实。
训练模型只发生有限次数,而模型上线以后,推理可能发生千万次、亿次甚至更多次。对于真正需要大规模部署的 AI 来说:
训练阶段贵一点可以接受,推理阶段长期便宜才真正重要。
一个训练得足够好的 4B,如果能够承担原本需要 10B、20B 甚至更大模型处理的一部分任务,它的实际价值会非常高。
二、它为什么特别强调 Agent,而不是只做一个“小号聊天模型”?
Spark-X2.5 最有意思的地方,是它明显没有把目标只放在传统 Chatbot 上。
它重点强化的是:
- Coding
- Tool Use
- Function Calling
- Agent Planning
- Browser / Workspace 类任务
- 多步任务执行
这背后的逻辑其实很好理解。
传统聊天模型主要依赖参数内部已有的知识回答问题,而 Agent 的能力并不完全取决于“模型脑子里记了多少东西”。
一个真正的 Agent 可以调用搜索、Python、Shell、浏览器、数据库、文件系统、代码执行器等外部工具。遇到不知道的信息可以检索,算不准可以运行 Python,代码是否正确可以直接执行测试,文件内容不知道可以读取,项目结构不清楚也可以搜索。
因此,Agent 的最终能力更接近:
Agent能力≈模型推理+工具使用+任务规划+反馈修正
Agent能力 \\approx 模型推理 + 工具使用 + 任务规划 + 反馈修正
Agent能力≈模型推理+工具使用+任务规划+反馈修正
这对小模型特别重要。
因为小模型天然存在一个问题:参数容量有限,它不可能像更大的模型一样“把更多知识都记在脑子里”。
但如果它足够擅长判断:
我现在缺什么信息?应该调用什么工具?拿到结果以后下一步怎么做?
那么系统最终体现出来的能力,就可能远远超过这个 4B 模型本身的知识容量。
这也是为什么 Spark-X2.5 的官方测试中,Agent 相关项目表现尤其突出。
它在 BFCL、MCP、Workspace Bench、BrowseComp 等测试中都给出了很有竞争力的结果,有些项目甚至明显超过更大尺寸模型。
这里其实没必要简单理解成“4B 比 9B 更聪明”。
更合理的理解是:
Spark-X2.5 针对 Agent 工作方式进行了非常重的后训练,因此它在工具调用、任务拆解和多步执行这些能力上,远远超过了传统意义上的 4B 小模型。
这也是我认为它真正值得研究的地方。
未来很多本地 AI 应用,未必需要一个“什么都知道”的模型,而更可能需要一个:
自己知道的不一定特别多,但特别会解决问题的小模型。
三、4B 为什么还能支持 1M Context?关键在它没有每一层都做完整注意力
Spark-X2.5 另一个非常吸引眼球的指标是:
Native 1M Context。
也就是最高支持约 104 万 Token 的上下文。
如果放在传统 Transformer 上,这其实是一个非常夸张的长度。
因为标准 Full Attention 的计算复杂度近似为:
O(N2)
O(N^2)
O(N2)
上下文越长,计算量和 KV Cache 压力都会迅速增加。
Spark-X2.5 没有选择让所有 Transformer 层都进行完整的全局 Attention,而是使用了混合结构:
3 层 Sliding Window Attention + 1 层 Full Attention。
也就是大致按照 3:1 的比例交替。
Sliding Window Attention 很容易理解:普通 Full Attention 会让当前 Token 观察整个上下文,而 Sliding Window Attention 只观察附近一个局部窗口。Spark-X2.5 的 Sliding Window 大小是 512 Token。
这样做以后,大部分层都只处理局部信息,只有一部分层负责全局信息传播。
相比“每一层都做 Full Attention”,这种结构显然更适合超长上下文。
Spark-X2.5 还使用了 GQA(Grouped Query Attention)。它的 Query Head 数量高于 KV Head 数量,也就是让多个 Query Head 共享较少的 Key / Value Head。
GQA 的一个直接收益,就是进一步降低 KV Cache。
因此 Spark-X2.5 的长上下文设计可以简单概括为:
Sliding Window Attention 降低局部计算成本,周期性 Full Attention 负责全局信息传播,GQA 则进一步控制 KV Cache。
这几项设计组合起来,才让“4B + 超长上下文”变得现实。
不过这里必须说明一个特别容易被误解的问题:
支持 1M,不等于普通显卡可以轻松跑 1M
所谓“原生支持 1M Context”,首先意味着模型架构、位置编码和训练过程允许处理这么长的序列。
但实际部署时,上下文越长,KV Cache 仍然会持续增长。
社区目前针对 Spark-X2.5 的 GGUF 测试中,即使对 KV Cache 进行量化,几十万 Token 以后显存占用依然会非常明显。真正跑到接近 1M 时,光 KV Cache 就可能达到 10GB 量级,再加模型权重、CUDA Buffer 和推理工作区,普通 8GB 显卡显然不可能因为模型只有 4B 就“无压力跑百万上下文”。
所以对于普通用户来说,我反而认为:
Spark-X2.5 真正有价值的不是非要跑满 1M,而是让 32K、64K、128K 甚至更长的本地上下文变得更加实用。
对于论文阅读、代码库分析、本地知识库、RAG 和长期 Agent History 来说,这已经非常有意义。
四、4B 为什么表现得不像传统 4B?除了训练,还有 Thinking
如果只看到“4B 参数”,很容易忽略 Spark-X2.5 的另一个重要条件:
官方 Benchmark 全部是在 Thinking Mode 下进行的。
这意味着它并不是面对所有问题都立即给出答案。
模型可以在生成最终结果之前投入更多推理 Token,进行分析、拆解、检查和修正。
这就是近年来经常提到的:
Test-Time Compute。
以前提升模型能力,最直观的方法是增加训练规模和参数量。
现在另一条路线越来越重要:
训练时不一定无限增大模型,而是在真正遇到复杂问题时,让模型多思考一会儿。
于是我们看到一种很有意思的组合:
Small Model+More Reasoning Tokens
Small\\ Model + More\\ Reasoning\\ Tokens
Small Model+More Reasoning Tokens
在部分数学、代码和 Agent 任务中,可以逐渐逼近更大模型。
这也是为什么单纯拿“4B”来估计 Spark-X2.5 的能力容易失真。
实际运行时,它更接近:
4B 参数 + 比较充分的后训练 + 推理阶段额外计算。
当然,这同样不是免费的。
Thinking 越长,生成 Token 越多,总延迟和总计算量也会增加。一个 4B 模型如果为了回答简单问题思考很久,实际体验未必一定优于一个更大、但回答更直接的模型。
所以小模型未来真正重要的优化目标,不只是“会思考”,而是:
该简单回答的时候别想太多,该认真推理的时候再投入计算。
这也是当前各种 Reasoning Model 都还在继续解决的问题。
五、Spark-X2.5 真正有意思的地方,是它可能代表了一类新的本地 AI
如果单纯把 Spark-X2.5 看成又一个开源语言模型,我觉得反而低估了它。
它真正展示出来的是这样一种系统形态:
一个不算大的本地模型,负责理解任务、推理和规划;知识、计算和环境操作则交给外部工具完成。
例如未来一台个人电脑上,可以常驻一个 4B~8B 的模型,同时连接:
- 本地文档和知识库;
- 浏览器与搜索;
- Python、Shell 和代码执行环境;
- 用户长期 Memory;
- MCP 工具;
- 本地数据库;
- 个人软件和工作流。
模型本身不需要把所有东西记在参数里,它只需要做好最核心的事情:
理解用户、规划任务、选择工具、观察结果、继续行动。
这就让小模型第一次真正有机会成为:
Personal Agent 的控制中枢。
而这一点对于本地部署非常重要。
Spark-X2.5-4B 的 BF16 权重大约是 8GB 量级,经过 GGUF 等方式量化以后可以降低到几 GB,因此 8GB、12GB 显存的普通消费级 GPU 已经具备比较现实的运行条件。
这和 32B、70B 模型完全是两种部署逻辑。
后者往往要求用户围绕模型准备硬件,而 4B 模型则有机会反过来:
进入用户本来已经拥有的设备。
这可能也是“On-Device Model”真正重要的地方。
当然,目前 Spark-X2.5 仍然是一个非常新的模型,生态还在快速完善。1M Context 的实际有效利用能力、不同量化版本损失、长时间 Agent 稳定性,以及与不同 Harness 的兼容性,都还需要更多第三方测试。
所以现在最合适的评价并不是:
“4B 已经全面打败大模型。”
而是:
Spark-X2.5 证明了,小模型已经不再只能做简单聊天。通过大规模训练、RL 后训练、Thinking、Tool Use 和高效长上下文架构,一个真正只有几 B 参数的模型,已经开始能够承担本地 Agent 的核心工作。
这才是它最值得关注的地方。
参考资料
Spark-X2.5 官方 GitHub 仓库
https://github.com/XHToken/Spark-X2.5
Spark-X2.5-4B 官方 Hugging Face Model Card
https://huggingface.co/XHToken/Spark-X2.5-4B
Spark-X2.5-1.7B 官方 Hugging Face Model Card
https://huggingface.co/XHToken/Spark-X2.5-1.7B
Spark-X2.5 Hugging Face 模型集合
https://huggingface.co/collections/XHToken/spark-x25
Spark-X2.5 ModelScope 模型集合
https://www.modelscope.cn/collections/XHToken/Spark-X25
Spark-X2.5 官方 Ollama 页面
https://ollama.com/SparkLLM
社区 Spark-X2.5-4B GGUF 量化与本地部署测试
https://huggingface.co/darioooooo0o/Spark-X2.5-4B-GGUF
另一组 Spark-X2.5-4B GGUF 社区量化版本
https://huggingface.co/abenzerps/Spark-X2.5-4B-GGUF
llama.cpp 上游 Spark-X2.5 支持 PR
https://github.com/ggml-org/llama.cpp/pull/27868
注:Spark-X2.5 发布不久,推理框架支持、社区 Benchmark 和量化方案仍在快速更新。实际部署时建议以官方仓库和对应推理框架的最新版本说明为准。
如果你已经在本地跑过 Spark-X2.5,也欢迎分享自己的显卡配置、推理速度和实际 Agent 体验。