这是《跟着计算机老师系统学大模型 · 第一季》。 前面我们讲了大模型在"预测"什么、训练靠哪三大范式。今天进入整个系列的"承重墙"——Transformer。 看完这篇,你不用背公式,也能在脑子里画出一张完整的图,讲清"注意力机制到底让模型懂了啥"。
我上课最爱问学生一个问题:"ChatGPT 底层是什么?"
十个人里有九个会说"AI"。再追问"AI 底下呢",就卡壳了。
答案其实就一个词:Transformer。2017 年 Google 那篇《Attention Is All You Need》,把 RNN/LSTM 时代彻底终结,成了今天所有大模型(GPT、BERT、T5)的共同地基。
今天我就用一张图 + 一个比喻,把它讲透。
一、一张图:Transformer 到底长啥样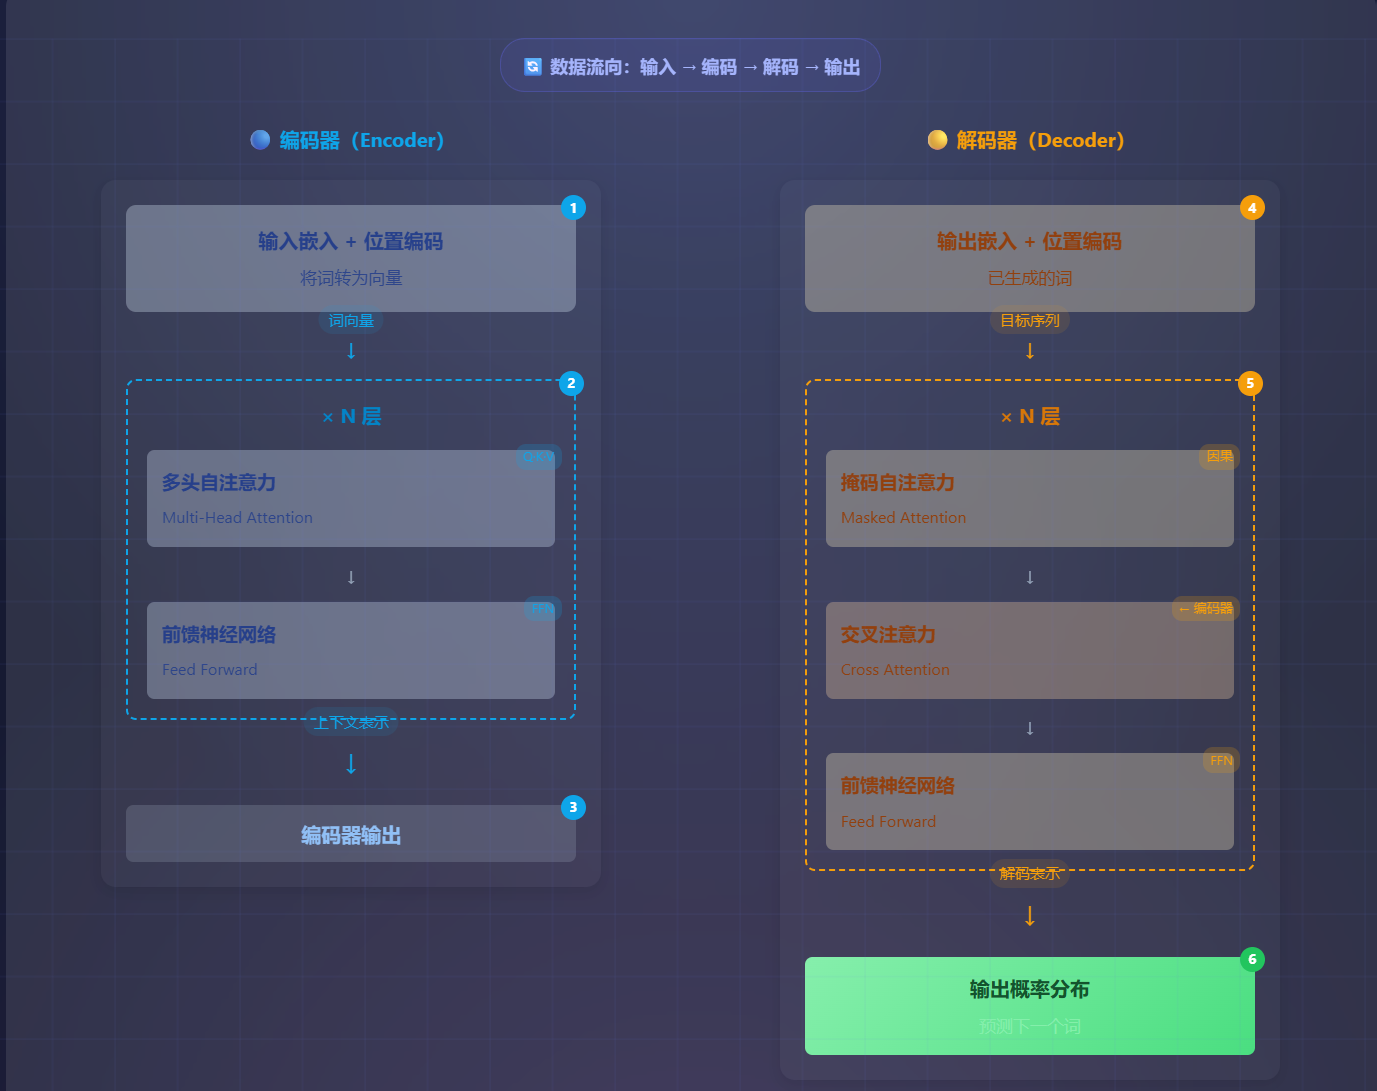
别被论文里那个对称的"两边方块"吓到。它本质就是一条流水线:
原始文本
│
▼
[ 词嵌入 + 位置编码 ] ← 把文字变成"带位置的数字"
│
▼
┌──────────── 编码器 Encoder(×N 层)────────────┐
│ 多头自注意力 → 前馈网络 → 上下文表示 │
└─────────────────────────────────────────────────┘
│ 编码器输出("读懂了的原文")
▼ 进入解码器的"交叉注意力"
┌──────────── 解码器 Decoder(×N 层)────────────┐
│ 掩码自注意力 → 交叉注意力 → 前馈网络 │
└─────────────────────────────────────────────────┘
│
▼
[ Linear + Softmax ] → 预测下一个词
一句话记住:编码器负责"读懂原文",解码器负责"逐词生成",中间靠注意力机制把信息传过去。
后面的内容,就是拆开这张图里的每一块。但真正的核心,只有一样东西——注意力机制。
二、为什么需要 Transformer:RNN 的三个坑
要懂 Transformer 好在哪,得先看它取代了什么。在它之前,大家用 RNN / LSTM 处理语言,思路像"人读书":一个词一个词地顺序读。
这带来三个致命问题:
串行太慢:必须等前一个词处理完才能处理下一个,吃不满 GPU 的并行能力。
长距离依赖难:信息在传递中逐渐丢失。比如这句:
"我在北京工作了五年,然后搬到上海,那里的生活节奏很快,我非常喜欢。"
传统 RNN 处理到"非常喜欢"时,可能早把"上海"忘了,填不出该填"上海"还是"北京"。
错误会累积:生成时一步错,后面步步错。
Transformer 的解法很暴力也很优雅:所有词同时算(并行)+ 任意两个词直接连(全局)。于是"上海"和"那里"哪怕隔了一整句话,也能一秒建立联系。
三、心脏:注意力机制(用"老板接项目"秒懂)
这是全文最该看懂的部分。先上一个直觉例子:
句子:"The animal didn't cross the street because it was too tired." 问:it 指的是什么? 注意力机制会给每个词打分:animal 85%、tired 45%、street 15%……于是模型判断 it 指 animal。
那这个"打分"是怎么算的?公式是:
Attention(Q, K, V) = softmax(QKᵀ / √d_k) V
别慌。我把这个公式拆成4 个动作,你再用一个生活比喻就彻底通了。
比喻:老板接新项目,向各部门征询意见
你(老板)要决策:"这个新项目技术风险大不大?"
-
Q(Query)= 你的问题:"技术风险大不大?"——当前这个词想找什么信息。
-
K(Key)= 各部门的标签:"我是技术部 / 财务部 / 法务部……"——每个词能提供哪类线索。
-
V(Value)= 各部门的具体意见:技术部给架构风险,财务给成本——你关注了谁,就真正拿走它的内容。
现在看 4 个动作:
| ① 打分 | QKᵀ | 你的问题去和每个部门匹配,得到"该听谁"的原始分数 |
| ② 缩放 | / √d_k | 维度越大点积越容易暴涨,除以它把分数拉回合理区间,训练更稳 |
| ③ 变权重 | softmax(…) | 把分数变成百分比(总和=100%),即"每个部门意见占多少" |
| ④ 汇总 | × V | 按占比加权各部门的具体意见,得到"综合后的结论" |
一句话:注意力 = 先给每个词打分(我该关注谁),再把信息按分数加权汇总(把重点内容拎出来)。
四、自注意力的"超能力":让每个词都认识全场
自注意力(self-attention)特殊在:Q、K、V 都来自同一句话。也就是说,每个词既当提问者,又当被提问者,于是每个词都能"看到"全句其他词,并融合进自己的新表示。
它的超能力体现在三处:
-
消除歧义:"苹果公司发布了新手机"里,"苹果"因为和"公司"强相关,模型知道它不是水果。
-
长距离依赖:不管"上海"和"那里"隔多远,权重直接连上。
-
语法/语义理解:自动识别主谓宾、指代关系、深层含义。
记忆技巧:自注意力 = 智能关系分析器,让每个词都"认识"其他词。
五、多头注意力:多个视角同时看
单个注意力像"只用一种标准看人"。Transformer 用多头(Multi-Head),等于同时派好几个视角的"评委":
-
H1 偏语法(主谓宾)
-
H2 偏指代(它/他/这)
-
H3 偏短语边界
-
H4 偏语义相似
每个头算完自己的 Attention(Q,K,V),再把结果拼起来过一层 W_O,得到融合了多视角的表示。
多头: O = Concat( O₁, O₂, …, O_h ) · W_O
直觉:一个人看问题容易偏,一群人从不同角度看了再汇总,理解才立体。
六、编码器和解码器:两个角色怎么配合
Transformer 是"编码器 + 解码器"结构。它俩都靠注意力,但干的活不一样。
编码器:只负责"读懂"
-
每层 = 多头自注意力 + 前馈网络。
-
输出是一串"富含上下文的表示",每个位置都理解了全句。
-
代表模型:BERT 系列(只保留编码器,擅长理解/分类,不擅长生成)。
解码器:负责"生成",但多了两道关
解码器每层有三步,我用两个比喻帮你记:
① 掩码自注意力 = "考试不能偷看答案" 生成是逐词进行的,预测第 i 个词时,不能让它看到第 i 个词之后的内容(否则就是作弊)。实现方式是一个"下三角掩码":当前位置只能看自己和过去。
mask = [
[1, 0, 0, 0], # 位置1 只看自己
[1, 1, 0, 0], # 位置2 看1、2
[1, 1, 1, 0], # 位置3 看1、2、3
[1, 1, 1, 1] # 位置4 看全部
]
记忆:回头看 = 掩码自注意力(只看过去的自己)。
② 交叉注意力 = "翻译官不断翻原文" 解码器生成每个中文词时,要回头看编码器输出的英文原文,对齐对应关系。
-
Q 来自解码器:"我现在要翻译啥?"
-
K、V 来自编码器:"原文有哪些词、各自啥意思?"
比如翻译 "I love you" → "我 爱 你":生成"爱"时,交叉注意力会把权重压到原文的 "love" 上。记忆:对照看 = 交叉注意力(看原文参考)。
③ 前馈网络 = "深度想" 把前面拿到的信息再加工,提取更抽象的特征。记忆:深度想 = 前馈网络。
三步串起来:每生成一个新词,解码器都要「回头看 → 对照看 → 深度想」。
七、第一步:文字怎么变成数字(嵌入 + 位置编码)
Transformer 不懂文字,第一步必须把词变成向量。
-
词嵌入(Embedding):把每个词映射成一个向量(常见 512/768/1024 维),语义相近的词在向量空间里离得近。
-
位置编码(Positional Encoding):这是关键!因为 Transformer 本身是"置换不变"的——它分不清"我爱你"和"你爱我"。所以必须给每个词额外加上位置信息。
经典做法是正弦/余弦公式(也可用可学习的,如 BERT):
PE(pos, 2i) = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
最终输入 = 词向量 + 位置向量。这一步解决了"词语如何表示"和"词序如何传递"两个问题,后面所有计算都基于它。
八、一句话总结 + 下讲预告
看到这里,你脑子里应该已经有那张图了。我用一句话收尾:
Transformer = 用"注意力机制"彻底替代"循环结构",从而同时拿到三样东西:并行训练(快)、全局依赖(准)、可堆叠加深(强)。
它为什么是 GPT/BERT 的地基?因为"注意力"足够通用,既能堆成编码器做理解(BERT),也能堆成解码器做生成(GPT),还能两头一起上做翻译(T5)。
课后一问
Transformer 这块,你卡得最厉害的是公式本身,还是编码器/解码器怎么配合?或者多头注意力那块?
评论区告诉我,点赞最高的那个,我下一篇单独再掰开讲。
下一篇预告
《从预训练到 RLHF:一个 LLM 是怎么"养"出来的?》——咱们把 Transformer 这个"发动机",放进完整的训练流水线里看看。