第一卷:大模型 基础篇
第3章 模型能力认知
第4节:为什么同一个问题,AI每次回答都不一样?——大模型的随机性、Temperature与采样机制
引言
你有没有遇到过这样的情况?
第一次问AI:
请推荐一个适合初学者学习的编程语言。
AI回答:
Python。
它语法简单、生态丰富,非常适合初学者。
你什么都没改,再问一次:
请推荐一个适合初学者学习的编程语言。
它可能回答:
JavaScript。
它可以直接在浏览器运行,而且能够覆盖前端和后端开发。
再问一次:
Go。
它语法简洁,非常适合学习现代后端开发。
同一个问题、同一个模型、甚至完全一样的Prompt,为什么答案却不一样?
很多开发者第一次接触大模型时,会产生一个疑问:
AI到底是不是在“随机回答”?
答案是:
某种意义上,是的。
但如果简单理解成“AI随机选择一个答案”,又是不准确的。
真正发生的事情更加有意思:
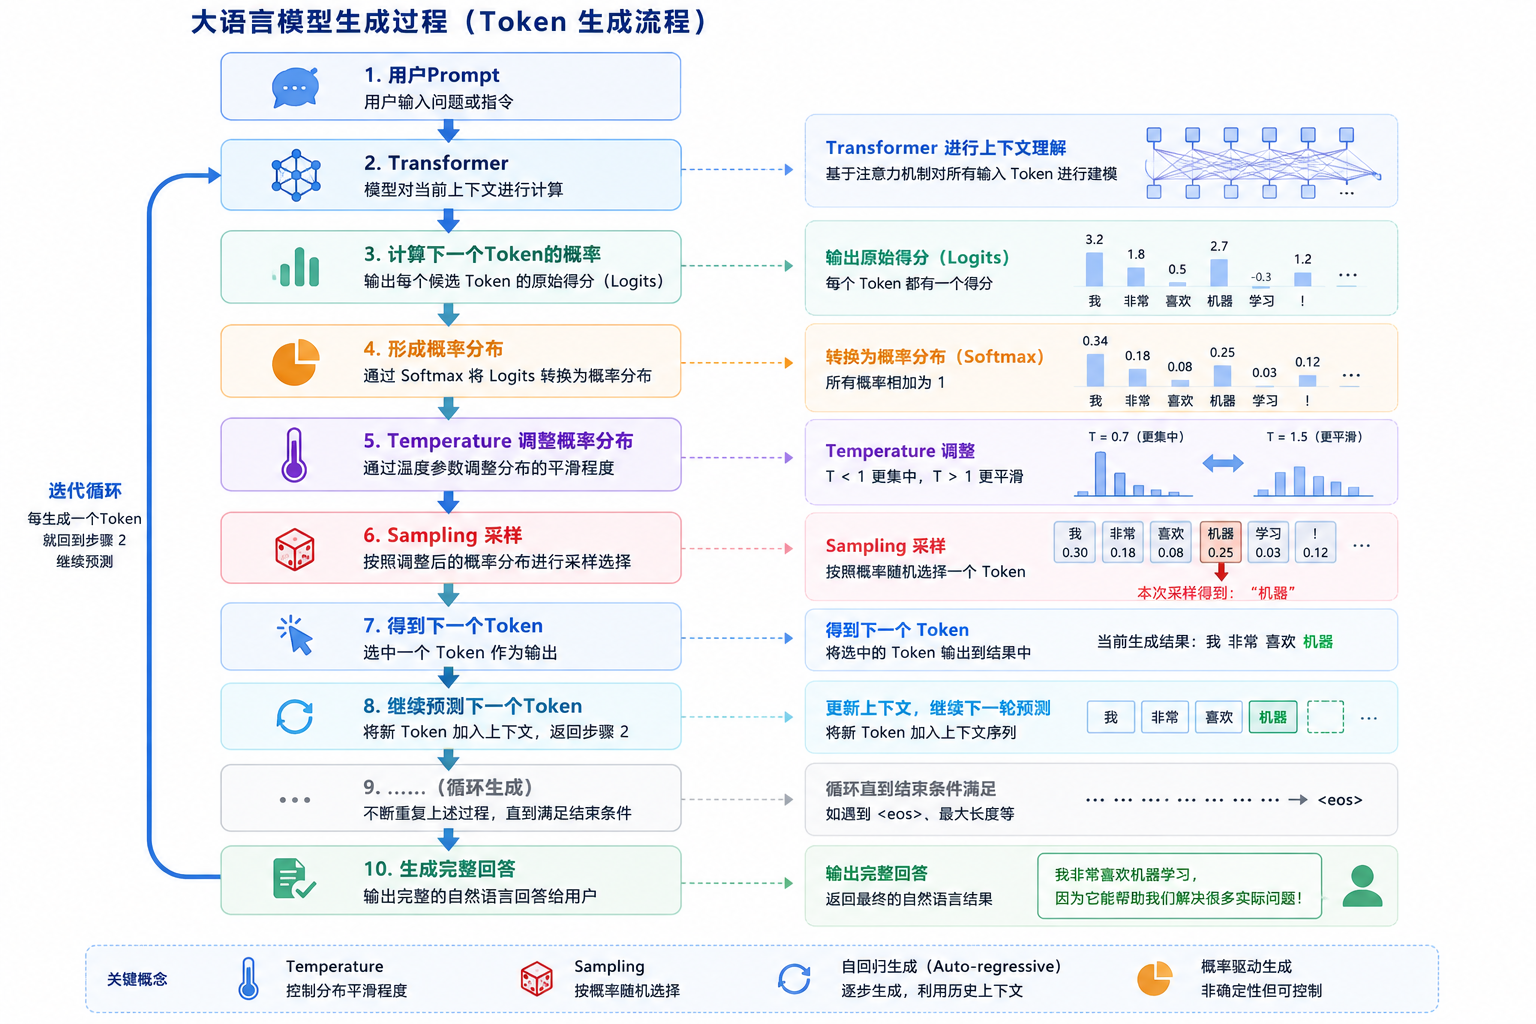
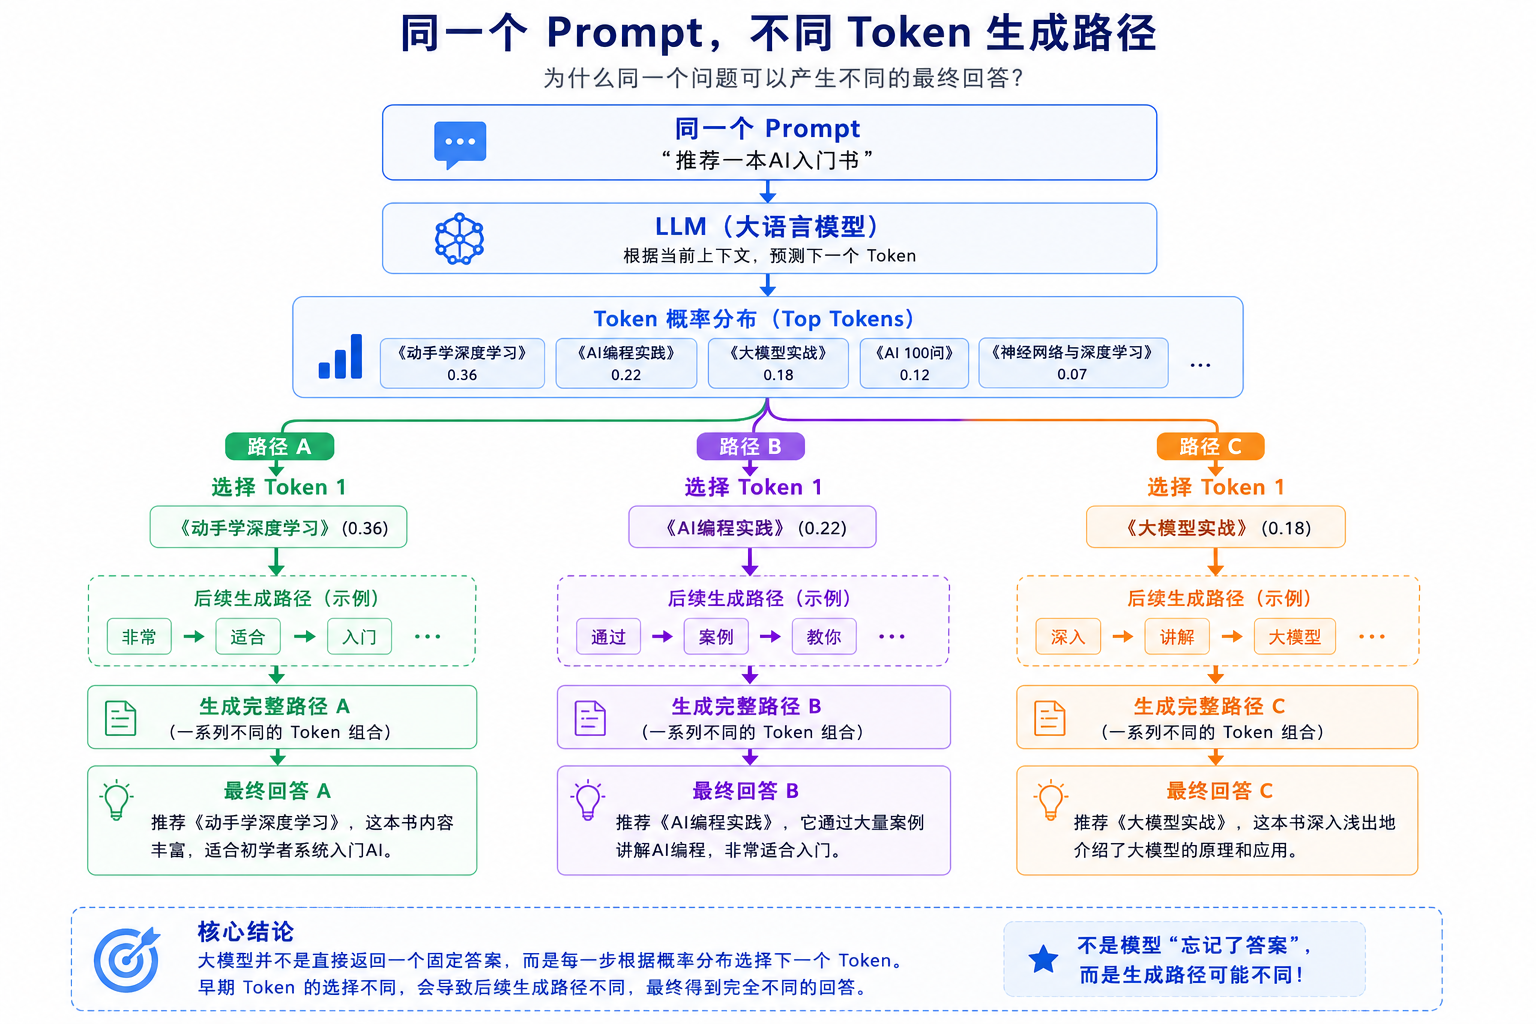
用户Prompt
↓
Transformer
↓
计算下一个Token的概率
↓
形成概率分布
↓
Temperature调整概率分布
↓
Sampling采样
↓
得到下一个Token
↓
继续预测下一个Token
↓
……
↓
生成完整回答
因此:
大模型不是从一个固定答案库里取答案,而是在每一步根据概率分布生成下一个Token。
而这正是理解:
Temperature
Sampling
Top-K
Top-P
模型随机性
Agent稳定性
的基础。
更重要的是,对于Agent开发工程师来说,这不仅仅是一个模型参数问题。
它直接影响:
Agent是否稳定
Tool是否正确调用
Workflow是否可控
RAG回答是否一致
Agent是否容易测试
企业系统是否敢于上线
所以,本节我们不仅要理解:
为什么AI每次回答不一样?
还要进一步理解:
如何在“随机性”和“确定性”之间找到工程上的平衡?
一、先理解一个最根本的问题:LLM不是传统程序
如果你是一名传统软件开发工程师,对下面的代码应该非常熟悉:
def add(a, b):
return a + b
调用:
add(1, 2)
得到:
3
再调用100次:
3
3
3
3
……
只要:
输入相同
+
程序相同
+
运行环境没有变化
通常就会得到相同结果。
这是一种典型的:
确定性计算(Deterministic Computing)
也就是:
Input
↓
Function
↓
Output
但是大语言模型不是这样工作的。
例如:
用户:
请写一句关于春天的句子。
模型并不是简单地:
查询数据库
↓
找到一句标准答案
↓
返回
它更接近:
Prompt
↓
Transformer
↓
计算Token概率
↓
选择一个Token
↓
加入上下文
↓
再次计算Token概率
↓
再次选择
↓
……
↓
生成完整回答
也就是说:
LLM的核心任务并不是直接找到“答案”,而是不断预测“下一个Token最可能是什么”。
这就是:
Next Token Prediction
二、大模型究竟在预测什么?
假设我们输入:
今天天气
模型需要预测下一个Token。
它可能得到类似这样的概率分布:
很好 42%
不错 25%
晴朗 15%
很冷 8%
如何 3%
……
这里最重要的不是具体数字,而是理解:
模型得到的不是一个答案,而是一组概率。
也就是说,模型内部更接近:
Token A → 42%
Token B → 25%
Token C → 15%
Token D → 8%
……
而不是:
答案 = Token A
这意味着:
模型已经知道“最可能出现什么”,但还需要决定“这一次到底选择什么”。
这个过程,就是:
Sampling——采样。
三、为什么一个Token的变化,会导致整段回答发生变化?
这是理解大模型随机性的关键。
假设模型生成:
今天天气
下一步可能选择:
很好
于是:
今天天气很好
接下来模型继续预测。
可能生成:
今天天气很好,适合出去散步。
但如果这一次选择的是:
不错
那么上下文已经变成:
今天天气不错
后面的概率分布也会随之改变。
于是可能继续生成:
今天天气不错,适合进行户外活动。
如果一开始选择:
阴沉
后面的回答又可能变成:
今天天气阴沉,可能会下雨,出门最好带把伞。
于是:
Token 1
↓
改变Context
↓
影响Token 2概率
↓
影响Token 3概率
↓
……
↓
最终影响整个回答
这就是一个非常重要的概念:
大模型生成具有路径依赖。
早期一个Token的差异,有可能被不断放大,最终形成完全不同的回答。
四、如果每次都选择概率最高的Token,会怎么样?
假设模型得到:
Python 45%
Java 20%
Go 15%
Rust 10%
JavaScript 7%
其他 3%
最简单的做法是:
永远选择概率最高的Token。
也就是:
选择Python
下一步继续计算。
然后:
继续选择概率最高的Token
不断重复。
这种方式叫:
Greedy Decoding——贪心解码。
流程可以理解为:
Prompt
↓
最高概率Token
↓
最高概率Token
↓
最高概率Token
↓
最高概率Token
↓
……
它最大的优点是:
稳定。
但是它也有一个问题:
可能过于保守。
五、为什么AI不能永远只选择第一名?
假设让AI:
写一句关于秋天的句子。
如果每次都选择概率最高的Token,很容易得到类似:
秋天来了,树叶变黄了,天气渐渐变凉。
这当然没错。
但是如果每次都这样:
秋天来了……
树叶变黄……
天气变凉……
AI的输出就容易:
机械
重复
缺乏变化
缺乏创造性
而大模型最有价值的能力之一恰恰是:
生成具有多样性的内容。
所以实际生成时,并不一定每次都选择第一名。
而是:
按照概率分布进行采样。
六、Sampling:AI不是“随便选”,而是“按概率选”
还是刚才的例子:
Python 45%
Java 20%
Go 15%
Rust 10%
JavaScript 7%
其他 3%
如果采用概率采样,那么:
Python
最容易被选中。
但:
Java
Go
Rust
也存在被选择的可能。
这就是Sampling。
非常重要的一点是:
Sampling不是完全随机。
它不是:
Python 20%
Java 20%
Go 20%
Rust 20%
……
而是:
概率高
→
更容易被选择
概率低
→
更难被选择
所以:
模型概率
+
采样策略
=
最终Token
七、Temperature到底是什么?
理解Sampling以后,就可以理解Temperature了。
Temperature通常翻译成:
温度参数。
它并不是:
Temperature高
→
模型更聪明
Temperature低
→
模型更笨
这种理解是错误的。
更加准确的理解是:
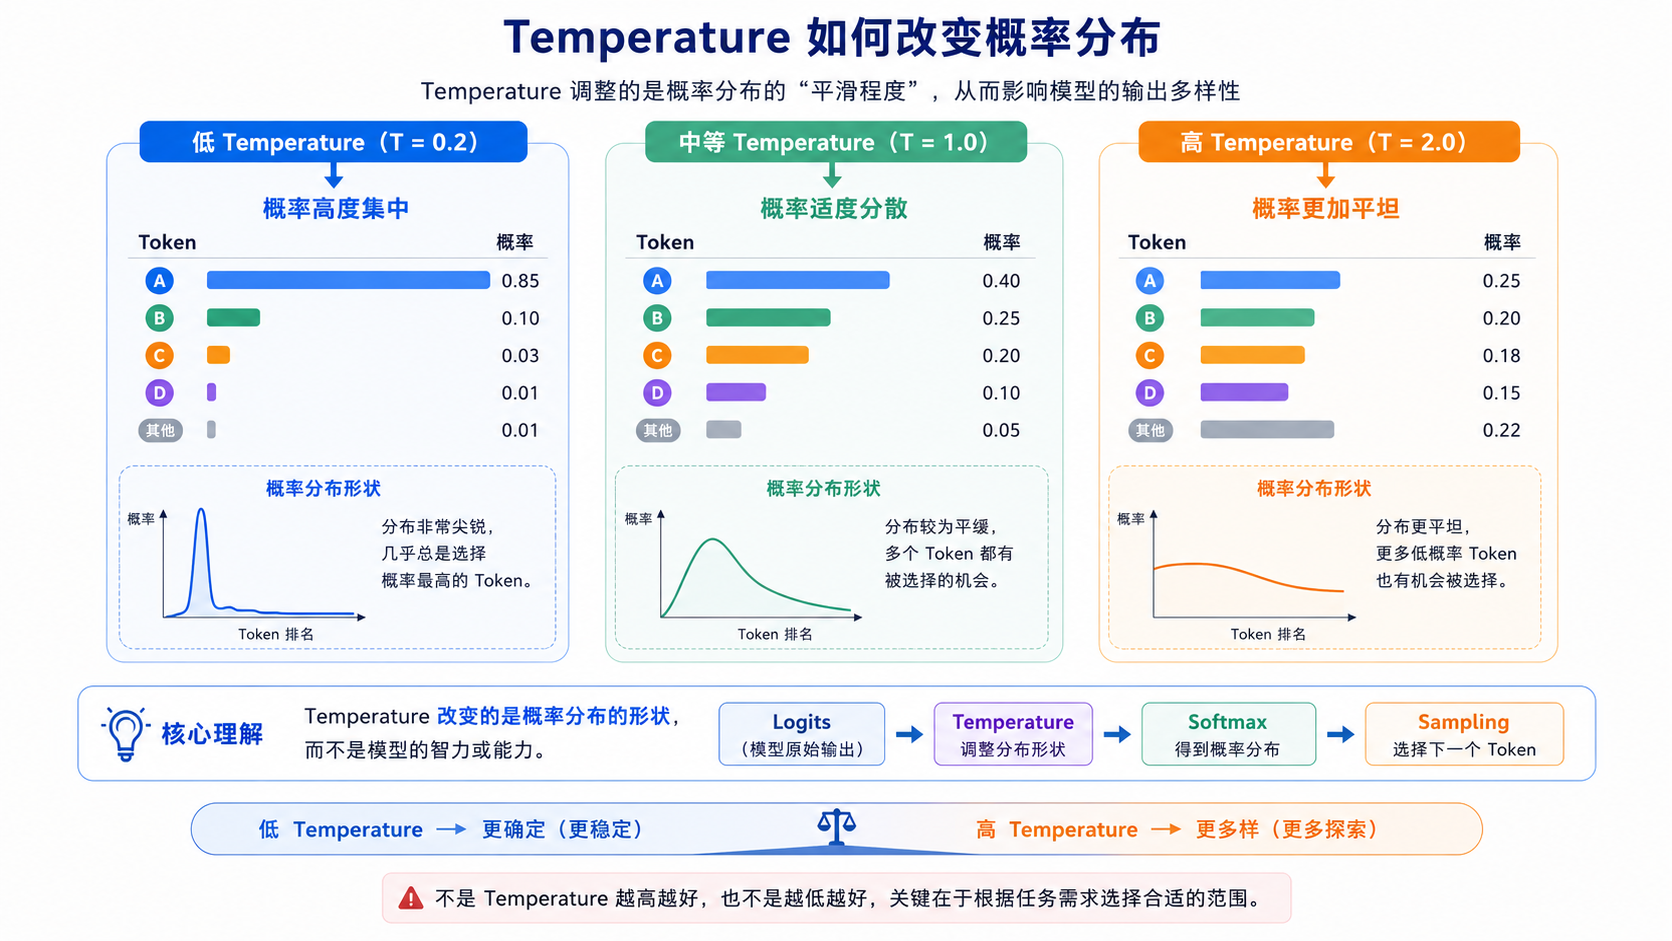
Temperature控制概率分布的“尖锐程度”,从而影响模型探索不同Token的程度。
简单理解:
低Temperature
↓
更集中
↓
更保守
↓
更稳定
高Temperature
↓
更分散
↓
更开放
↓
更多样
八、Temperature低的时候发生了什么?
假设原始概率:
A:60%
B:25%
C:10%
D:5%
当Temperature较低时:
A ████████████████████
B ██
C
D
概率会更加集中。
于是:
A
几乎总是占据绝对优势。
结果就是:
输出更加稳定
九、Temperature高的时候发生了什么?
提高Temperature以后,概率分布会变得更加平坦。
例如可以直观理解成:
A:40%
B:30%
C:18%
D:12%
这时候:
A
B
C
D
都有更大的机会被采样。
于是:
输出更多样
表达更加丰富
创造性更强
但与此同时:
错误概率
+
不确定性
+
不可重复性
也可能增加。
所以:
Temperature本质上是在稳定性和探索性之间调节。
十、Temperature背后的数学原理
如果只是做AI应用开发,可以先把Temperature理解成:
控制随机程度
但是作为Agent开发工程师,最好进一步理解它背后的数学机制。
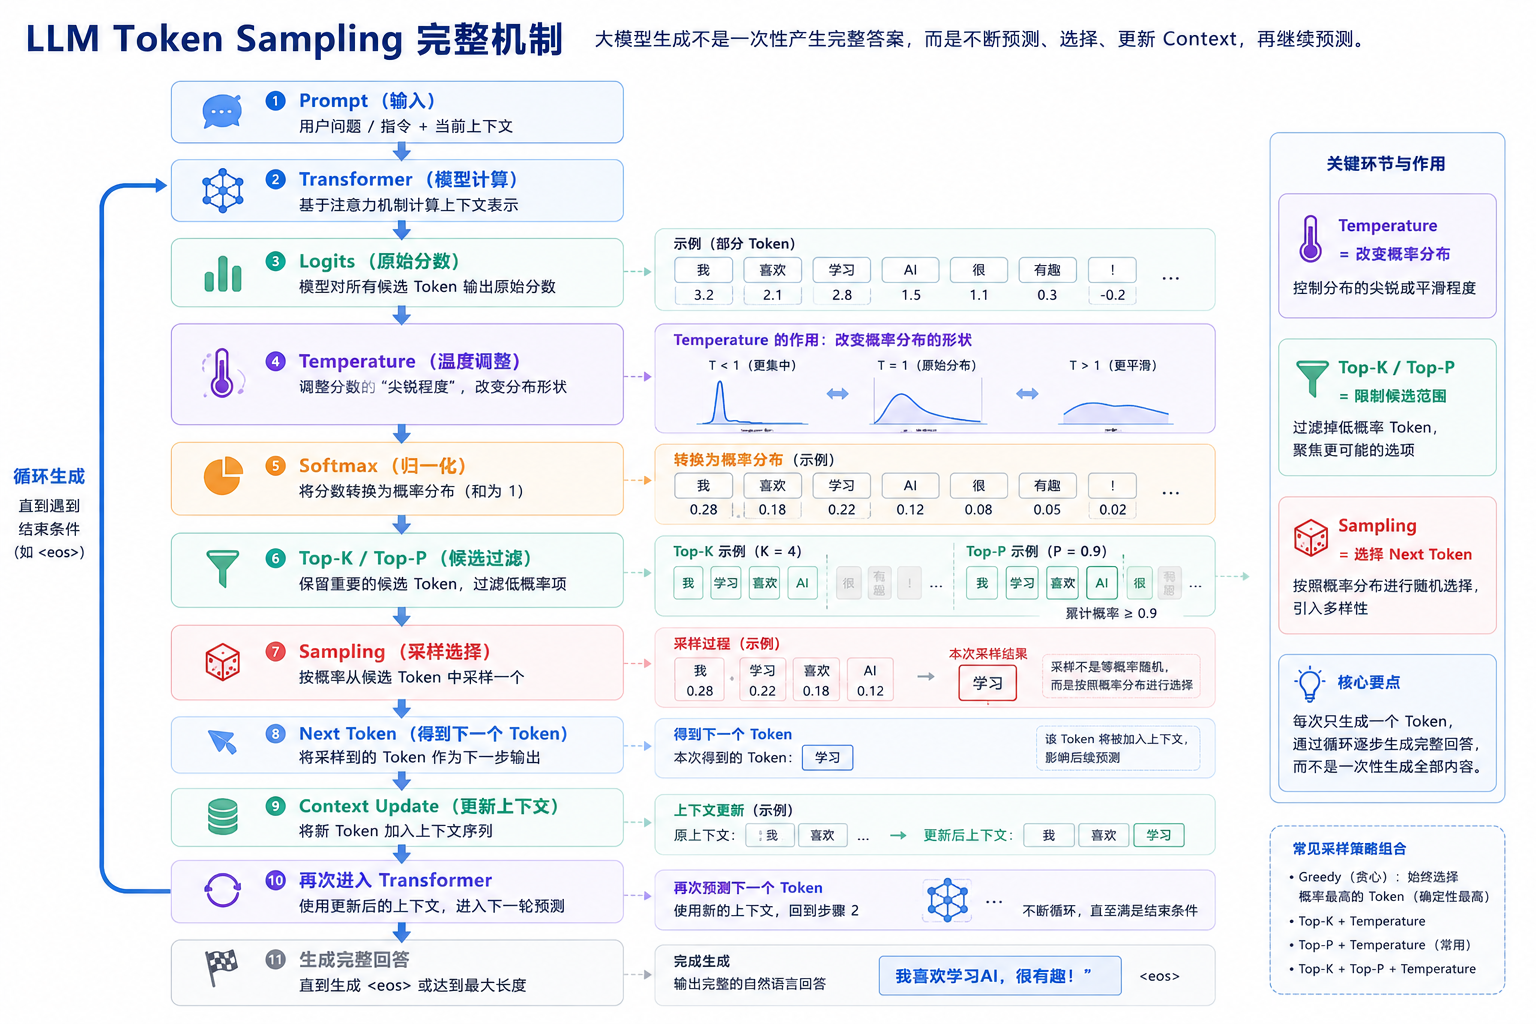
模型经过Transformer以后,会得到一组:
Logits
假设:
A = 5.2
B = 4.1
C = 3.8
D = 2.5
然后经过Softmax转换成概率。
简化表示:
P(i) = softmax(logit_i / T)
其中:
T = Temperature
当:
T < 1
概率分布更加尖锐。
当:
T = 1
保持原始概率分布。
当:
T > 1
概率分布更加平坦。
因此:
Logits
↓
Temperature
↓
Softmax
↓
Probability Distribution
↓
Sampling
↓
Next Token
这就是Temperature最核心的技术机制。
十一、Temperature不是“随机开关”
这是一个非常重要的认知纠正。
很多开发者会简单理解:
Temperature = 0
→ 没有随机性
Temperature = 1
→ 有随机性
Temperature = 2
→ 随机性更强
虽然这个理解适合入门,但从技术上并不严谨。
更加准确的是:
Temperature
↓
改变概率分布
↓
Sampling
↓
产生不同Token
也就是说:
Temperature负责改变“概率长什么样”,Sampling负责“从概率里选什么”。
十二、Top-K:限制候选Token数量
除了Temperature,还有一个常见采样机制:
Top-K Sampling
假设模型得到:
A:35%
B:25%
C:15%
D:10%
E:5%
F:4%
G:3%
H:3%
如果:
K = 3
那么只保留:
A
B
C
其他Token直接排除:
D ❌
E ❌
F ❌
G ❌
H ❌
于是:
概率分布
↓
Top-K
↓
候选Token缩小
↓
Sampling
十三、Top-P:动态限制候选Token范围
Top-P又叫:
Nucleus Sampling
它与Top-K不同。
Top-K是:
固定保留K个
Top-P则是:
按照概率从高到低累加,直到达到P。
例如:
A:40%
B:30%
C:15%
D:8%
E:4%
F:3%
如果:
Top-P = 0.85
那么:
A = 40%
A + B = 70%
A + B + C = 85%
于是保留:
A
B
C
后面的:
D
E
F
不参与采样。
十四、Temperature、Top-K、Top-P到底有什么区别?
可以把三者理解成三个不同层面的控制机制:
| Temperature | 调整概率分布 | 控制探索程度 |
| Top-K | 固定候选数量 | 只看前K名 |
| Top-P | 动态候选范围 | 看累计概率达到P的候选 |
| Greedy | 只选第一名 | 最大确定性 |
简单记忆:
Temperature
↓
改变概率分布
Top-K
↓
限制候选数量
Top-P
↓
限制候选概率范围
Sampling
↓
最终选择Token
十五、为什么Temperature = 0也不一定意味着绝对一致?
这是开发Agent时经常遇到的问题。
很多开发者会认为:
temperature = 0
就意味着:
每次调用必须100%得到完全相同的结果。
实际上不能简单这么认为。
原因很多。
原因一:底层计算可能存在非确定性
现代大模型运行在大规模GPU集群上。
涉及:
并行计算
浮点数计算
GPU Kernel
分布式推理
在某些实现下,底层计算可能存在微小差异。
原因二:模型服务实现不同
不同模型平台对于:
Temperature = 0
的处理方式可能不同。
有的平台可能更接近:
Greedy
有的平台可能仍然保留某些采样机制。
因此:
不能把Temperature = 0简单理解成绝对确定性。
原因三:Context可能已经发生变化
开发者经常认为:
我发送的是同一个问题。
但是实际上模型收到的可能是:
System Prompt
+
历史对话
+
用户问题
+
RAG Context
+
Tool Result
+
Memory
其中任何一个Token变化,都可能影响最终输出。
所以:
用户看到的Prompt一样
≠
模型收到的完整Context一样
原因四:模型服务版本可能发生变化
即使:
Prompt一样
Temperature一样
如果:
模型版本
推理框架
服务实现
System Prompt
发生变化,也可能导致输出变化。
所以企业级AI系统需要关注:
Model Version
而不是只记录:
model = xxx
十六、真正决定AI输出的,不只是Temperature
现在可以建立一个更加完整的公式:
最终输出
≈
Model
+
System Prompt
+
User Prompt
+
Context
+
Sampling Parameters
+
Tool Results
+
Model Version
+
Runtime Environment
因此:
“同一个问题”并不等于“同一个模型输入状态”。
这也是为什么后面学习:
Context
Memory
RAG
State
Tool Calling
Agent
时,会不断遇到:
状态管理问题。
十七、这个问题为什么对Agent尤其重要?
普通聊天机器人可能只是:
用户
↓
LLM
↓
回答
但Agent不是。
Agent可能是:
用户
↓
Agent
↓
LLM
↓
Planning
↓
Tool Calling
↓
Tool Result
↓
Context Update
↓
LLM
↓
下一步决策
↓
Tool Calling
↓
……
↓
最终答案
这里每一步都可能存在概率决策。
例如:
应该调用哪个Tool?
↓
Tool A / Tool B / Tool C
应该查询什么参数?
↓
参数A / 参数B
查询结果出来以后怎么办?
↓
继续调用 / 结束 / 重新规划
所以:
Agent的非确定性远比普通LLM聊天复杂。
十八、Agent随机性可能导致什么问题?
举一个企业真实业务场景。
假设你开发了一个:
企业销售数据分析Agent
用户问:
帮我分析一下今年华东地区的销售情况。
Agent可能需要:
理解问题
↓
识别地区 = 华东
↓
识别时间 = 今年
↓
调用销售数据库
↓
查询数据
↓
计算同比
↓
分析异常
↓
生成报告
如果模型的决策不稳定:
第一次:
调用SalesQuery
第二次:
调用CustomerQuery
第三次:
调用OrderQuery
甚至可能:
先查客户
→
再查订单
→
再查销售
结果可能是:
执行路径不同
↓
Tool调用次数不同
↓
成本不同
↓
执行时间不同
↓
最终结果可能不同
这就是Agent工程中非常典型的:
Non-Determinism——非确定性。
十九、Agent工程不是消灭随机性,而是控制随机性
这是本节最重要的工程思想之一。
很多初学者第一反应是:
“那就把Temperature调成0。”
这并不是完整答案。
因为Agent真正的问题不是:
随机性 = 坏事
而是:
随机性
应该出现在哪里?
应该有多大?
哪些地方必须确定?
哪些地方可以探索?
例如:
聊天
↓
可以有随机性
内容创作
↓
可以有更多随机性
RAG问答
↓
应该适当降低
SQL生成
↓
应该高度约束
数据库写操作
↓
必须验证
支付
↓
必须确定
所以成熟的Agent系统不是:
消灭随机性。
而是:
把随机性控制在合适的边界内。
二十、不同任务应该如何使用Temperature?
没有一个适用于所有模型、所有任务的固定数字。
更重要的是理解任务类型。
| 代码生成 | 低 | 准确、稳定 |
| SQL生成 | 低 | 可执行 |
| JSON结构化输出 | 低 | 格式一致 |
| 数据抽取 | 低 | 字段稳定 |
| 企业知识库问答 | 低~中 | 忠于事实 |
| RAG摘要 | 低~中 | 准确概括 |
| 普通聊天 | 中 | 自然表达 |
| 文案创作 | 中~高 | 表达丰富 |
| 小说/诗歌 | 高 | 创造性 |
| Brainstorming | 高 | 探索空间 |
可以记住一个简单原则:
越需要确定性,越应该控制随机性;越需要探索性,越可以允许随机性。
二十一、为什么代码生成通常需要更低的随机性?
例如:
请生成一个用户登录API。
我们通常希望:
结构稳定
参数稳定
代码规范
逻辑一致
而不是:
第一次使用Spring Boot
第二次使用FastAPI
第三次自己设计一个框架
尤其是企业Agent。
假设Agent负责:
生成SQL
高随机性可能导致:
SELECT * FROM user;
下一次:
SELECT id,name FROM user;
再下一次甚至:
SELECT * FROM users;
如果数据库中根本不存在:
users
就会导致执行失败。
因此:
LLM
↓
生成SQL
↓
SQL Parser
↓
SQL Validator
↓
Permission Check
↓
Database
比单纯:
LLM
↓
Database
可靠得多。
二十二、这就是“概率系统 + 确定性系统”
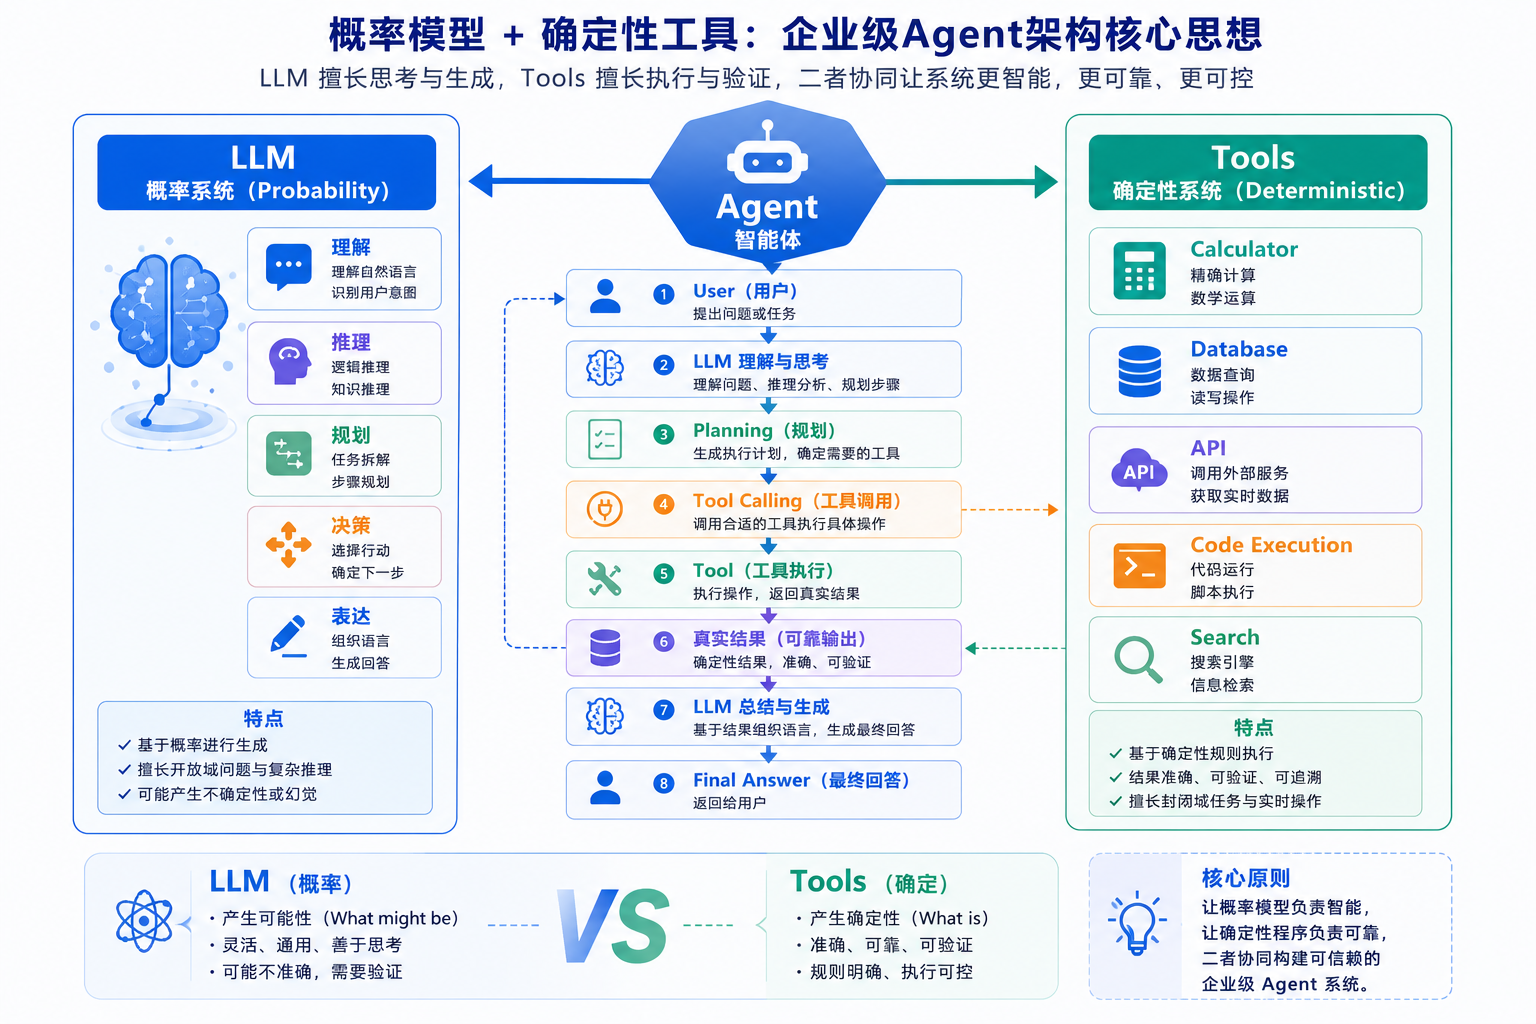
Agent工程有一个非常重要的架构原则:
LLM
=
概率系统
Tools
=
确定性系统
LLM擅长:
理解
推理
规划
语言表达
意图识别
工具擅长:
计算
查询
执行
验证
数据处理
所以:
用户
↓
Agent
↓
LLM
↓
理解任务
↓
选择Tool
↓
Tool
↓
获得真实结果
↓
LLM
↓
解释结果
↓
用户
这比让LLM自己“猜答案”更加可靠。
二十三、为什么RAG也需要控制随机性?
假设企业知识库中有一份制度:
2026年差旅报销标准:
经济舱……
用户问:
出差可以报销什么?
如果直接让模型回答:
用户问题
↓
LLM
↓
生成
模型可能根据自己的语言知识产生一个“听起来合理”的答案。
但是:
听起来合理
≠
企业制度真实规定
所以使用RAG:
用户问题
↓
Retriever
↓
知识库
↓
相关文档
↓
Context
↓
LLM
↓
回答
这时候模型的主要任务变成:
基于检索到的事实组织回答。
而不是:
凭自己的语言概率猜答案。
因此:
Sampling
解决的是:
输出为什么可能不同。
而:
RAG
解决的是:
输出是否有事实依据。
这是两个不同的问题。
二十四、随机性与幻觉是什么关系?
很多人会把:
随机性
和:
幻觉
完全等同起来。
这是不准确的。
即使:
Temperature = 0
模型依然可能产生幻觉。
因为:
模型概率最高的Token,不一定对应真实世界中的事实。
例如:
某个不存在的人
某篇不存在的论文
某个不存在的API
某个错误的技术参数
都可能在语言上非常合理。
所以:
高概率
≠
真实
这是大模型非常重要的认知。
而RAG、Tool Calling、外部验证等机制,就是在解决这个问题。
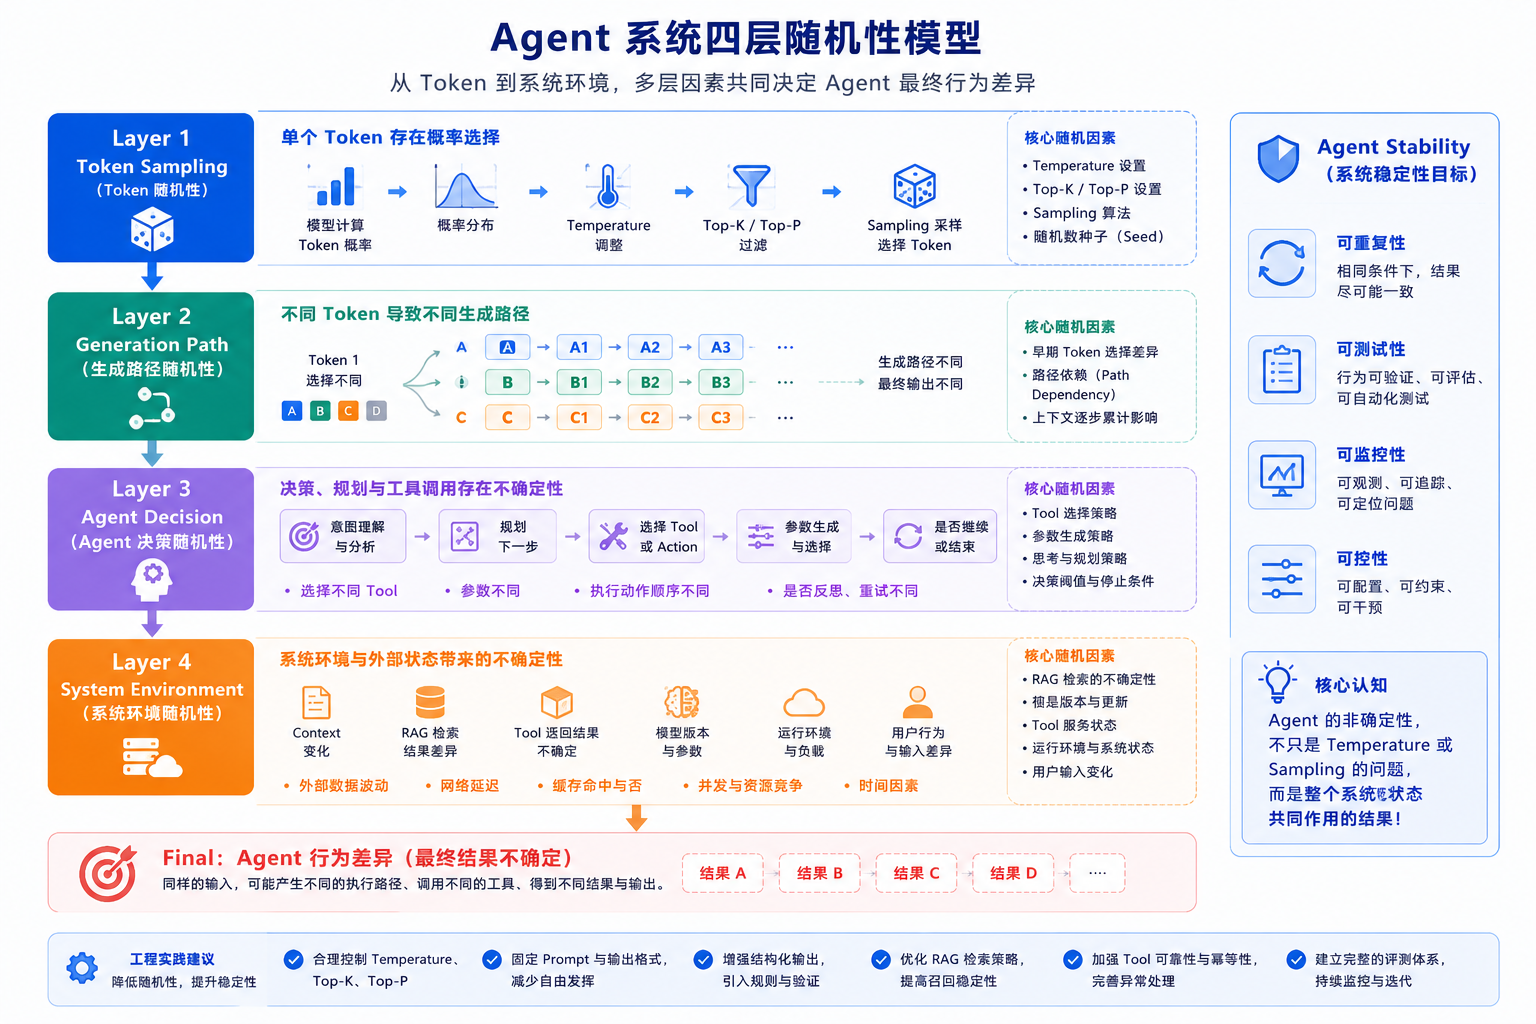
二十五、Agent中的四层随机性
如果进一步从Agent架构看,可以把随机性分成四层。
第一层:Token随机性
Token Probability
↓
Sampling
↓
Next Token
第二层:生成路径随机性
Token 1不同
↓
Context不同
↓
Token 2概率不同
↓
Token 3不同
↓
最终回答不同
第三层:Agent决策随机性
选择哪个Tool?
选择什么参数?
下一步做什么?
什么时候停止?
第四层:系统级随机性
Model Version
Context
RAG结果
Memory
Tool Result
Runtime
System Prompt
最终:
Token随机性
↓
生成路径差异
↓
Agent决策差异
↓
系统执行差异
↓
最终结果差异
二十六、企业级Agent为什么必须做“确定性边界设计”?
假设一个企业Agent负责:
订单处理
用户说:
把订单A123取消掉。
如果整个流程完全交给LLM:
用户
↓
LLM
↓
理解
↓
生成
↓
调用API
风险非常高。
更合理的架构:
用户
↓
LLM
↓
识别意图
↓
生成结构化Action
↓
权限验证
↓
参数验证
↓
业务规则验证
↓
用户确认
↓
执行API
↓
返回结果
也就是说:
LLM可以决定“应该做什么”,但真正执行高风险操作之前,必须经过确定性系统验证。
这就是企业级Agent与Demo级Agent之间的重要区别。
二十七、Agent可靠性不能只靠Temperature
一个成熟Agent至少需要:
Prompt
+
Context
+
Model
+
Sampling
+
Tool
+
Validation
+
Permission
+
Monitoring
+
Evaluation
其中:
Temperature
只是其中非常小的一部分。
因此不要把:
“Agent不稳定”
简单归因于:
“Temperature太高。”
真正需要分析的是:
Prompt稳定吗?
Context稳定吗?
RAG稳定吗?
Tool结果稳定吗?
模型版本稳定吗?
输出格式稳定吗?
业务规则验证了吗?
二十八、如何提高Agent输出的一致性?
方法一:合理降低随机性
对于:
SQL
JSON
数据抽取
工具参数
企业知识库问答
通常应该倾向于更低的随机性。
方法二:固定System Prompt
不要每次动态产生完全不同的规则。
例如:
你是企业销售分析Agent。
必须遵循:
1. 只能使用销售数据库数据。
2. 不允许虚构数据。
3. 所有金额必须通过Calculator计算。
4. 最终输出必须使用JSON格式。
方法三:控制Context
保证:
System Prompt
+
History
+
RAG
+
Memory
+
Tool Result
具有明确的结构和优先级。
方法四:结构化输出
例如:
{
"intent": "sales_analysis",
"region": "east_china",
"period": "2026",
"action": "query_sales"
}
比:
请自由决定下一步。
更加容易控制。
方法五:Tool参数验证
例如:
LLM
↓
Tool Call
↓
Schema Validation
↓
Permission Check
↓
Business Validation
↓
Execute
方法六:增加验证模型或规则引擎
例如:
LLM生成SQL
↓
SQL Validator
↓
通过?
├── Yes → Execute
└── No → Reject / Repair
二十九、不要试图让LLM承担“计算器”的工作
举一个最简单的例子:
10086 × 2387
LLM理论上可以计算。
但是工程上为什么还应该使用Calculator Tool?
因为:
LLM
=
概率生成
Calculator
=
确定性计算
更加合理的架构:
User
↓
Agent
↓
LLM识别:
这是数学计算
↓
Calculator Tool
↓
准确结果
↓
LLM组织语言
↓
User
这就是:
让模型做它擅长的事,让程序做它擅长的事。
三十、从“随机性”进一步理解Agent为什么需要Workflow
如果所有任务都让LLM自由决定:
LLM
↓
决定下一步
↓
LLM
↓
再决定下一步
↓
LLM
↓
继续决定
那么系统自由度非常高。
自由度越高:
灵活性 ↑
不可控性 ↑
所以企业Agent通常会引入:
Workflow——工作流。
例如:
用户请求
↓
意图识别
↓
参数提取
↓
权限验证
↓
数据查询
↓
数据计算
↓
结果校验
↓
生成报告
其中只有:
需要理解
需要规划
需要生成
的地方交给LLM。
其他步骤尽可能确定化。
于是:
LLM
+
Workflow
+
Tools
+
Rules
形成更加可靠的Agent系统。
三十一、最终理解:Agent就是概率与确定性的结合
到这里,我们可以把Agent重新定义一次:
传统软件
=
确定性逻辑
LLM
=
概率性智能
Agent
=
概率性智能
+
确定性执行
也就是:
Agent
│
┌────────────┴────────────┐
↓ ↓
LLM Tools
概率系统 确定系统
│ │
理解/推理/规划 查询/计算/执行
│ │
└────────────┬────────────┘
↓
Workflow
↓
State
↓
Final Result
这也是为什么:
Agent不是简单地给LLM套一个Prompt。
真正的Agent工程,需要解决:
模型能力
Context
Memory
State
Tool
Workflow
Permission
Evaluation
Monitoring
Cost
Security
三十二、面试题
问题1
为什么同一个Prompt,大模型每次可能返回不同答案?
参考答案:
因为大语言模型采用概率生成机制。模型首先计算下一个Token的概率分布,然后通过Sampling选择Token。不同生成过程中可能选择不同Token,而早期Token的差异又会影响后续概率分布,因此最终可能形成不同的生成路径和回答。
问题2
Temperature的作用是什么?Temperature越高是不是模型越聪明?
参考答案:
不是。
Temperature主要用于调整Token概率分布的尖锐程度。
低Temperature
→ 概率更集中
→ 输出更加稳定
高Temperature
→ 概率更加平坦
→ 输出更加多样
它控制的是生成过程中的探索程度,并不会直接提高模型的智力。
问题3
Top-K和Top-P有什么区别?
参考答案:
Top-K按照固定数量限制候选Token,例如K=5表示只保留概率最高的5个Token。
Top-P则按照累计概率动态选择候选Token,例如P=0.9表示保留概率从高到低累计达到90%的候选Token。
因此:
Top-K
→ 固定候选数量
Top-P
→ 动态候选范围
问题4
Temperature设置为0以后,是否可以保证Agent每次完全一致?
参考答案:
不能绝对保证。
因为最终输出不仅受Temperature影响,还可能受到:
模型版本
System Prompt
Context
RAG结果
Tool结果
底层推理实现
运行环境
等因素影响。
另外不同模型平台对Temperature=0的实现也可能存在差异。
因此企业级Agent如果要求稳定,不能只依赖Temperature=0,而应该建立完整的确定性控制和验证机制。
问题5
为什么企业Agent不能让LLM直接完成所有任务?
参考答案:
因为LLM属于概率系统,而企业中的很多任务需要确定性和可验证性。
例如:
计算
数据库操作
权限判断
订单处理
支付
库存修改
应该交给:
Calculator
Database
API
Rule Engine
Permission System
等确定性组件。
比较合理的架构是:
LLM
负责理解、推理、规划
Tool
负责查询、计算、执行
Validation
负责验证
Workflow
负责控制流程
这样可以兼顾模型智能和系统可靠性。
三十三、本节小结
本节从一个最简单的问题开始:
为什么同一个问题,AI每次回答都不一样?
最终我们得到了完整的知识链路。
✅ 核心概念
LLM
=
概率生成模型
模型不是直接返回一个固定答案,而是在不断预测:
Next Token
✅ 底层原理
Prompt
↓
Transformer
↓
Logits
↓
Temperature
↓
Softmax
↓
Token Probability
↓
Top-K / Top-P
↓
Sampling
↓
Next Token
然后不断循环。
✅ Temperature
低Temperature
→ 概率集中
→ 更稳定
高Temperature
→ 概率分散
→ 更多样
Temperature控制的是:
概率分布,而不是模型智力。
✅ Sampling
Sampling并不是:
完全随机
而是:
按照概率分布进行采样。
✅ Agent影响
在Agent中,随机性不仅存在于:
Token
还可能进一步影响:
Generation
↓
Planning
↓
Tool Calling
↓
Workflow
↓
最终执行结果
✅ 工程解决方案
企业级Agent不能简单地:
Temperature = 0
然后认为问题解决了。
真正需要建立:
LLM
+
Context
+
Workflow
+
Tools
+
Validation
+
Permission
+
Monitoring
+
Evaluation
最终形成:
概率模型
+
确定性系统
最重要的一句话
大模型的随机性并不是一个需要彻底消灭的缺陷,而是一种需要被工程化控制的能力;优秀的Agent不是让LLM变得完全确定,而是让概率模型负责“智能”,让确定性系统负责“可靠”。
下一篇
下一节,我们继续解决一个比“AI为什么每次回答不同”更加重要的问题:
《第3章 第5节:AI到底怎么知道自己回答得好不好?——从大模型评测到Agent Evaluation》
我们将开始进入一个真正的Agent工程核心领域:
LLM
↓
Evaluation
↓
Agent Evaluation
↓
准确率
↓
Faithfulness
↓
Tool Calling准确率
↓
Task Success
↓
成本
↓
延迟
↓
企业级Agent质量体系
因为当你真正开始开发Agent以后,问题就不再是:
“AI能不能做?”
而会变成:
“AI做得到底好不好?100次运行有多少次成功?出了问题怎么定位?模型升级后有没有变差?”
这将是从:
AI应用开发
真正迈向:
Agent工程化
的关键一步。