Python+Django+Vue 实现热点新闻智能推荐分析平台:推荐算法、热度分析、数据可视化全链路实战
用 Python 做一个真正"懂你"的新闻站点是什么体验?本文完整拆解一个热点新闻智能推荐分析平台的实现过程:Django 承载 API 与定时任务,jieba 分词驱动多路推荐算法,APScheduler 调度数据采集与离线分析,Vue 2 双前端(用户门户 + 管理后台)配合 ECharts 完成数据可视化。全文配真实运行截图,适合做 Python Web 课程设计、毕业设计或全栈练手项目参考。
一、前言
新闻资讯类产品最核心的竞争力是"分发效率":同一个站点,给体育迷推赛事战报、给财经用户推行情解读,留存率才起得来。这个项目就是把"新闻门户"升级成"个性化推荐平台"——不只是一个能看新闻的网站,而是一套从数据采集 → 内容分析 → 热度计算 → 多路推荐 → 可视化运营的完整闭环。
项目覆盖的能力点相当密集:
- 多类别新闻聚合浏览(国内/国际/社会/体育/娱乐/军事/科技/财经/股市/美股十个频道);
- 基于用户兴趣标签、所在地区、新闻热度三条通路的个性化推荐;
- jieba 中文分词 + TF-IDF 思想的关键词提取,新闻相似度计算;
- 定时爬虫持续补充语料,新闻热度值随阅读、评论、点赞动态更新;
- 管理端可以一键启停推荐引擎与数据分析引擎,实时查看运行日志。
二、技术栈与整体架构
项目采用前后端分离的三层结构:
| 后端框架 | Python 3.x + Django 3.1 + PyMySQL |
| 推荐与数据层 | jieba 分词、APScheduler 定时调度、requests + BeautifulSoup 采集、selenium 辅助抓取视频资源 |
| 用户门户前端 | Vue 2 + View Design(iView)+ Element UI + ECharts 5 |
| 管理后台前端 | Vue 2 + Vue CLI 4 + View Design + ECharts(含中国地图) |
| 数据存储 | MySQL 5.7(utf8mb4) |
分层职责非常清晰:
- Django API 层(newsapi):暴露新闻、用户、评论、推荐、爬虫、推荐引擎管理等 40 余个 REST 风格接口,django-cors-headers 解决跨域;
- 算法层(Recommend 模块):与 Web 层解耦的独立包,五个算法脚本各司其职,由 APScheduler 按配置的时间间隔循环执行;
- 采集层(Spider 模块):新闻 URL 采集与详情正文抓取两类线程,采集结果落库供分析层消费;
- 前端层:门户面向读者,后台面向运营,两者都通过 devServer 代理或 Nginx 反代对接同一套 API。
部署形态上是三个独立服务:Django 后端单独起进程对外提供 API,门户与管理端是两个互不依赖的 Vue 工程,各有独立的构建与启动入口,开发期走代理转发,生产环境收敛到 Nginx 反代之后即可,任何一端改动都不牵连另外两端。
APScheduler 的职责边界也值得单独说明:调度逻辑统一收敛在 Recommend 模块的控制脚本里,推荐引擎与分析引擎各持有一个调度器实例——前者挂载城市、热度、标签三个推荐 Job,后者挂载关键词提取、热度计算、相似度计算、热词库更新四个分析 Job,全部以 interval 触发器按设定间隔循环执行,并显式设置 max_instances=1,上一轮任务没跑完时同名 Job 不会重入,避免对数据库形成并发写压力。调度间隔由管理端接口动态下发,Web 层只负责转发参数与启停调度器,算法层只管按间隔干活,两层之间通过数据库表交换数据,边界干净。
三、功能设计与推荐算法实现
3.1 用户门户
门户端围绕"阅读 + 推荐"两条主线展开:
- 登录/注册/游客模式:注册时从热词词云中选择兴趣标签,作为冷启动推荐的输入;游客可体验基础浏览功能;
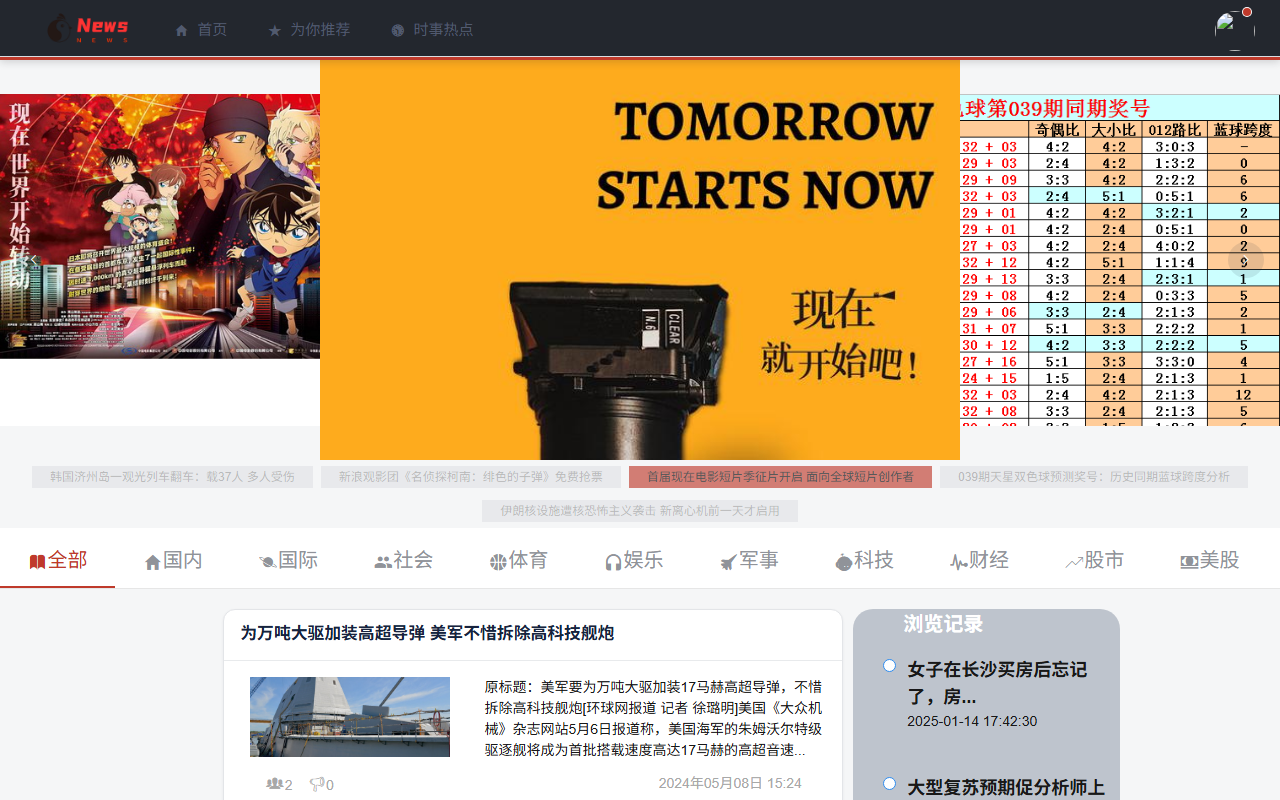
- 首页新闻流:顶部轮播头条 + 十个频道的分类新闻列表,右侧栏同步展示个人浏览记录;
- 为你推荐:按用户维度拉取推荐列表,每条推荐标注推荐来源(兴趣/热度),支持对推荐结果表达"感兴趣/不感兴趣"反馈;
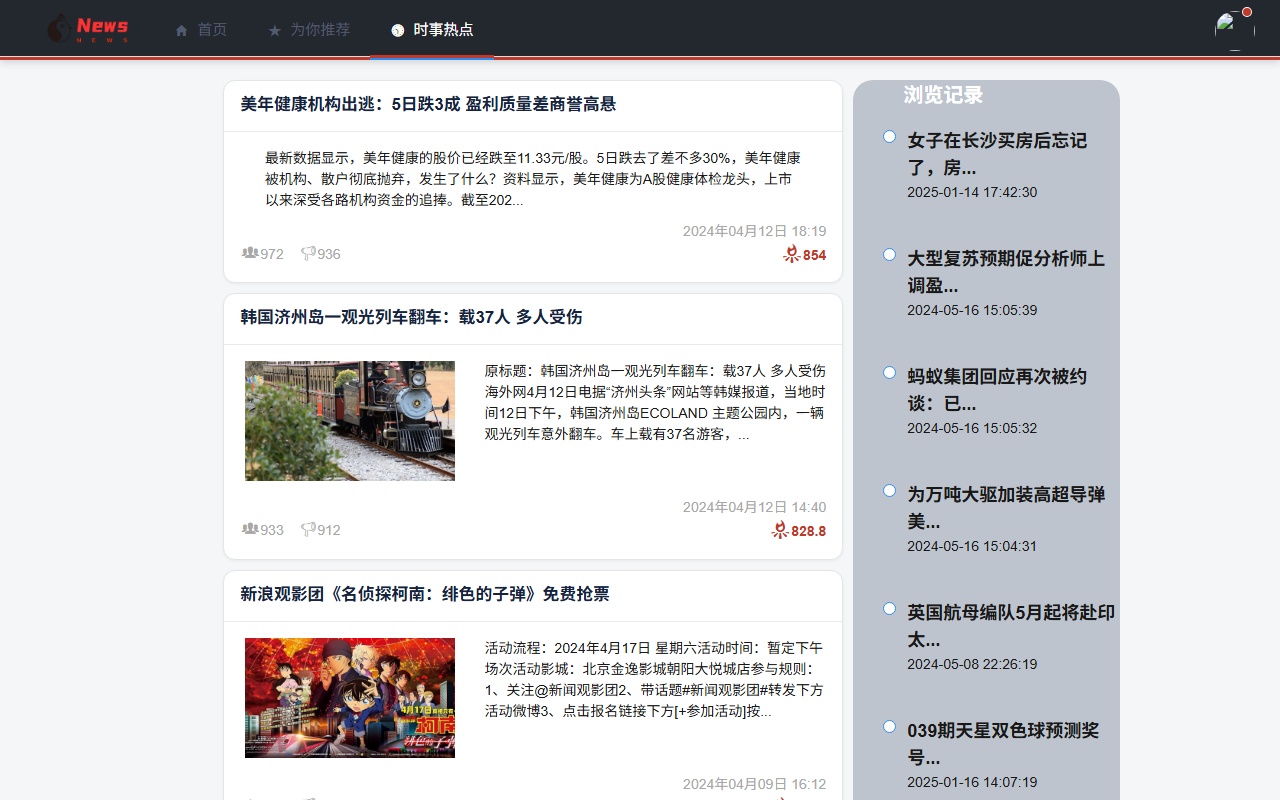
- 时事热点榜:按热度值降序排列的全站热点新闻,热度值以火焰图标直观呈现;
- 新闻详情:图文正文、同类新闻推荐、评论区互动(回复、点赞、消息通知)。
3.2 三路推荐算法(核心)
推荐引擎在 Recommend 包内实现,三条通路并行计算后统一写入推荐结果表:
匹配度的具体口径并不玄乎:把用户标签集合与新闻关键词集合做交并比,交集越大、并集越小,匹配度越高,每轮每个用户只保留得分最高的前 20 条候选写入推荐表,天然控制了结果表的膨胀速度。
配套的四个分析任务构成数据底座:
- NewsKeyWordsSelect:jieba 提取每条新闻的关键词(去停用词,内置百度/HIT/川大等多套停用词表),写入新闻关键词字段;
- NewsHotValueCal:周期性根据阅读、评论、点赞的增量更新热度值;
- NewsCorrelationCalculation:基于关键词集合计算新闻两两相似度,支撑详情页"相关资讯";
- HotWordLibrary:滚动维护全站热词库,反哺注册页词云与推荐权重。
把七个任务串起来看,就是一条完整的离线流水线:爬虫线程把采集到的新闻正文写入详情表;关键词任务逐条分词、去停用词,把结果回填 keywords 字段;热度任务按阅读量、评论数等互动指标加权,再叠加时间衰减项——发布越久的新闻热度扣减越多,老内容自然沉底;相似度任务基于关键词集合两两求交并比,写入相似度表;最后三路推荐任务以这些中间数据为原料批量生产推荐结果。门户端刷新"为你推荐"时只是读表渲染,几乎零计算开销,这是把"算"与"看"分离带来的直接好处。
所有任务由 APScheduler 的 BlockingScheduler 按秒/分粒度定时触发,管理端可远程启停——这正是"推荐系统"而非"推荐功能"的工程化体现。
3.3 管理后台
后台是数据运营的驾驶舱:
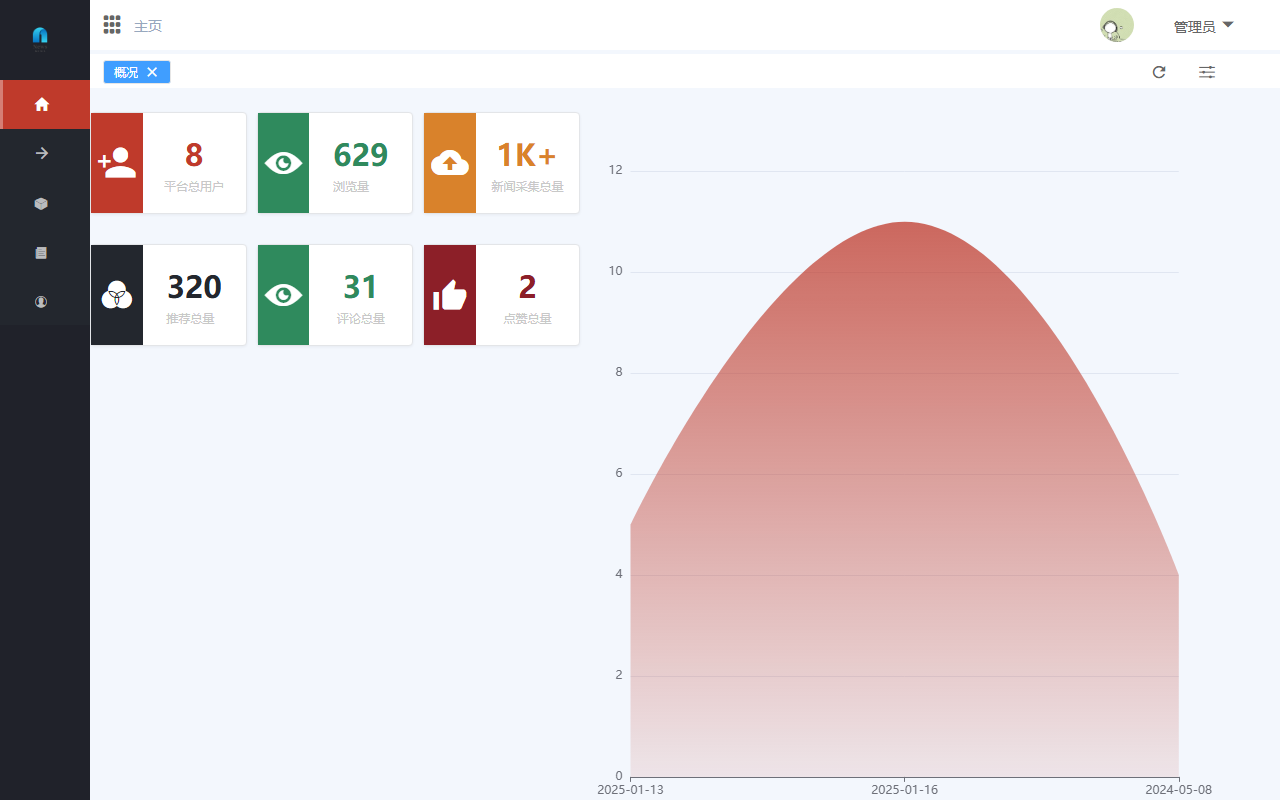
- 数据概况:平台总用户、浏览量、新闻采集总量、推荐总量、评论/点赞总量六张统计卡 + 推荐量走势面积图 + 用户地域分布中国地图;
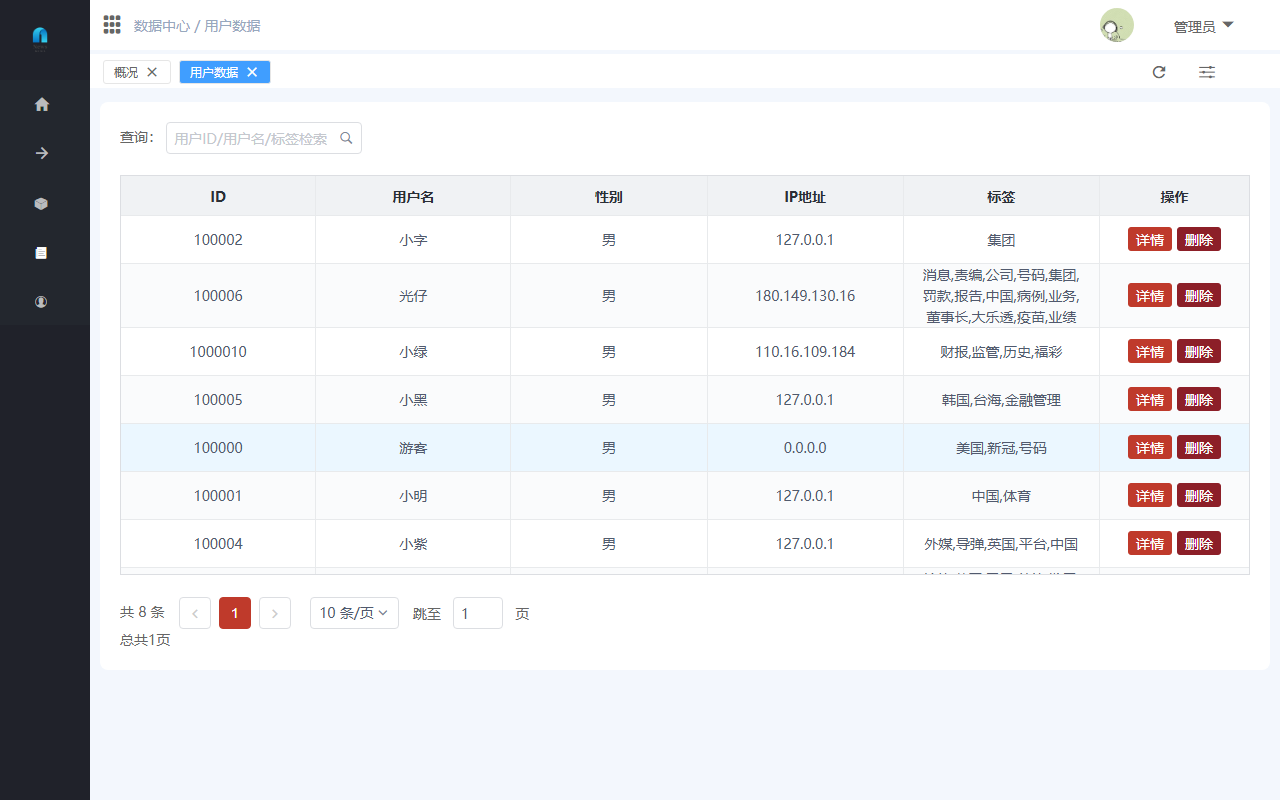
- 用户数据:按用户ID/用户名/标签检索,支持新增、编辑、删除,可下钻查看单个用户的兴趣画像与浏览轨迹;
- 新闻数据:全量新闻的管理与检索,评论审核与删除;
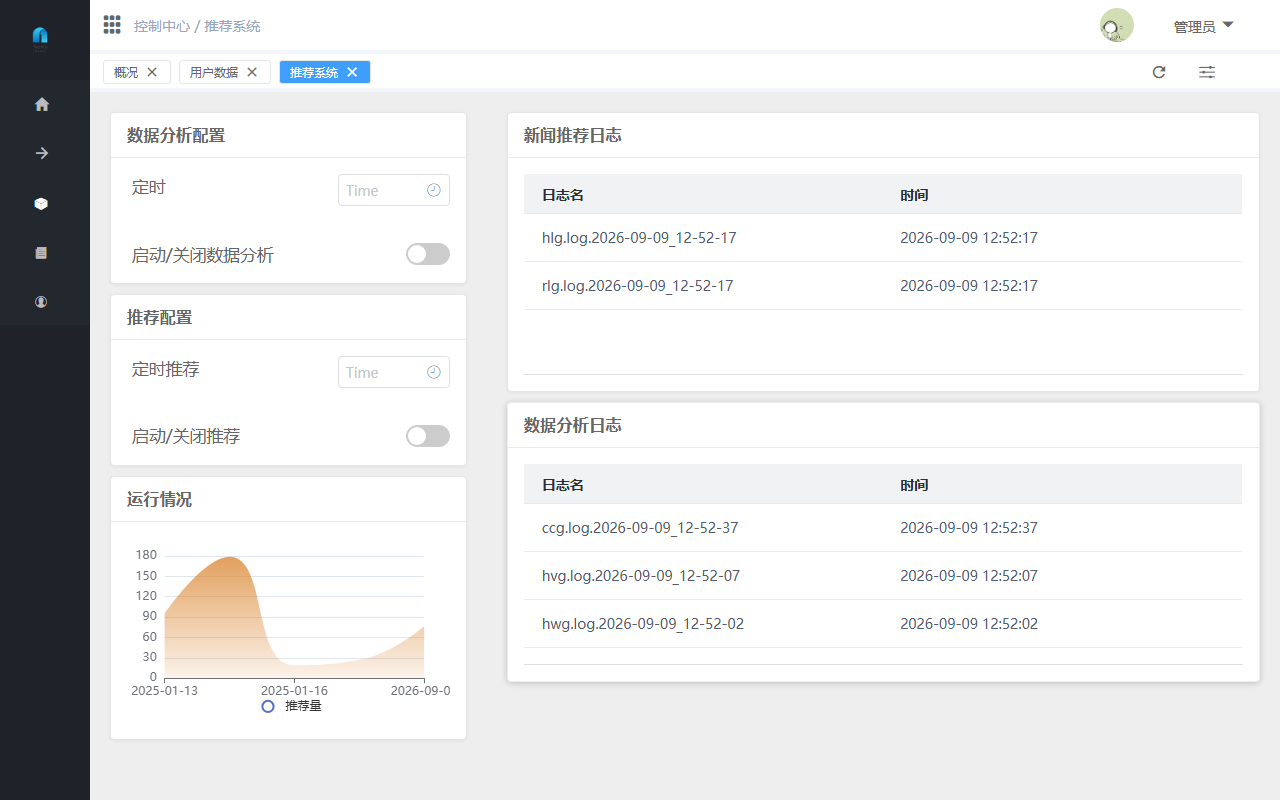
- 推荐系统控制台:以时间间隔参数启动/停止推荐引擎与数据分析引擎,实时查看引擎运行日志与推荐量曲线;
- 爬虫管理:启停 URL 采集与详情采集线程,监控采集状态。
门户与后台的分界线因此非常清楚:门户只做"消费"——读新闻、收推荐、发评论;后台专注"生产与管控"——语料从哪来(爬虫线程)、推荐怎么算(引擎启停)、算得怎么样(运行日志与统计曲线)全部收口在管理端。引擎相关接口在 API 层也是独立分组:启动推荐、启动分析、停止系统各占一个端点,运行日志还单独提供下载接口,方便把留档拉到本地排查问题。
四、数据库设计
数据库 news 共 15 张业务表,围绕"新闻-用户-推荐"三域展开,核心表如下:
| news_api_newsdetail | 新闻详情 | title、origin(正文)、category、readnum、keywords、pic_url |
| news_api_user | 用户 | userid、tags(兴趣标签)、tagsweight(标签权重 JSON)、region |
| news_api_recommend | 推荐结果 | userid、newsid、cor(匹配度)、species(推荐来源)、time |
| news_api_newshot | 新闻热度 | news_id、news_hot、category |
| news_api_hotword | 热词库 | hotword、num |
| news_api_newssimilar | 新闻相似度 | new_id_base、new_id_sim、new_correlation |
| news_api_comments | 评论 | newsid、userid、touserid、status |
| news_api_history | 浏览历史 | userid、history_newsid、time |
| news_api_givelike | 点赞记录 | userid、newsid、commentsid |
| news_api_spiderstate | 引擎运行状态 | spiderid、status、interval |
设计上有两个值得借鉴的细节:一是把标签权重 tagsweight 直接以 JSON 存入用户表,推荐计算时内存展开,避免了中间权重表的膨胀;二是推荐结果表用 species 字段区分推荐来源,取值 0/1/2 分别对应标签、城市、热度三路,前端据此展示"推荐 By:兴趣/热度",让推荐结果可解释。
数据落地层面,项目随附了完整的初始化 SQL:除 15 张表结构外,还内置 1793 条新闻语料、8 个演示用户和 320 条预生成的推荐记录,热词、热度、相似度等中间数据一应俱全,建库导入后不依赖爬虫预热即可看到完整效果。验证环境中将推荐与分析引擎真实拉起运行约一分钟,推荐表记录即从 320 条增长到 397 条,运行日志同步落盘,整条离线链路是实际跑通过的。
五、系统演示
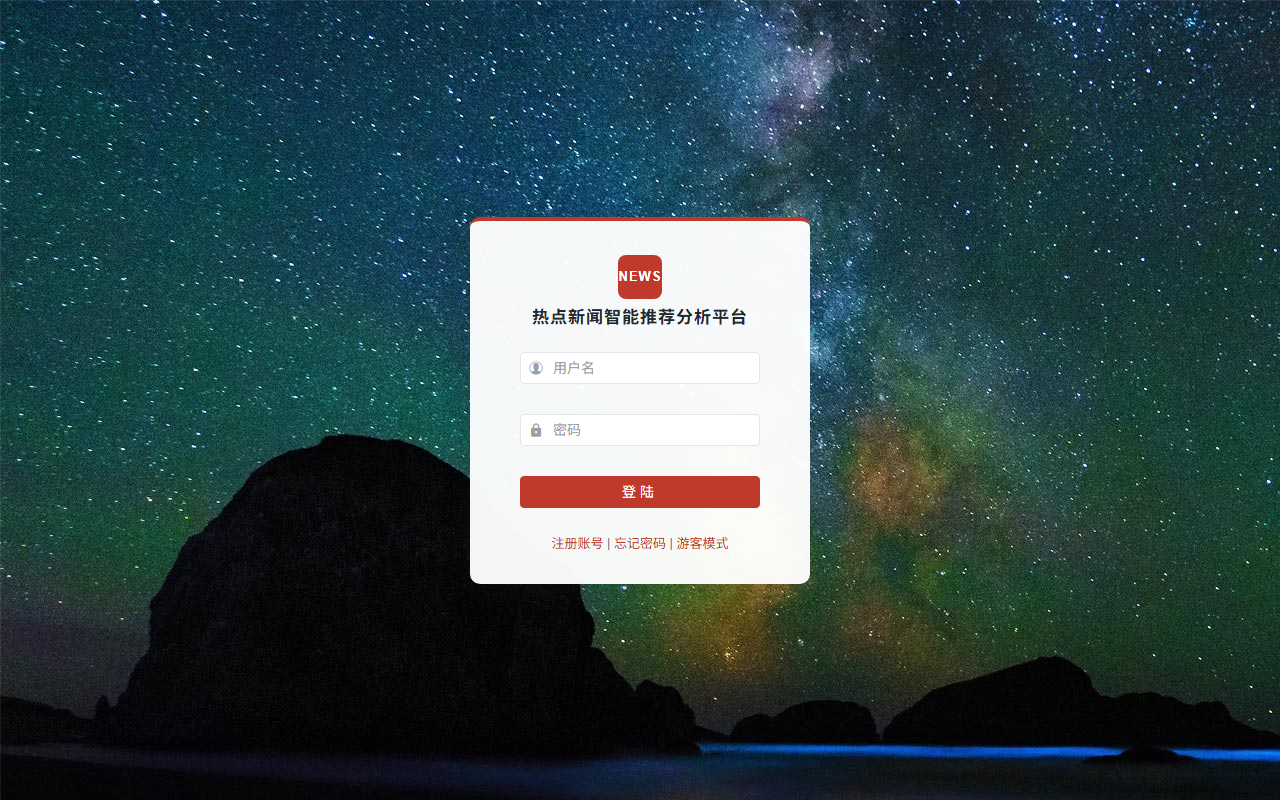
门户登录页,注册用户或游客均可进入(演示账号 admin/123456 对应管理端,门户演示账号 100002/123456):
首页:轮播头条 + 频道分类 + 新闻流 + 个人浏览记录,十个频道覆盖全站 1793 条新闻语料:
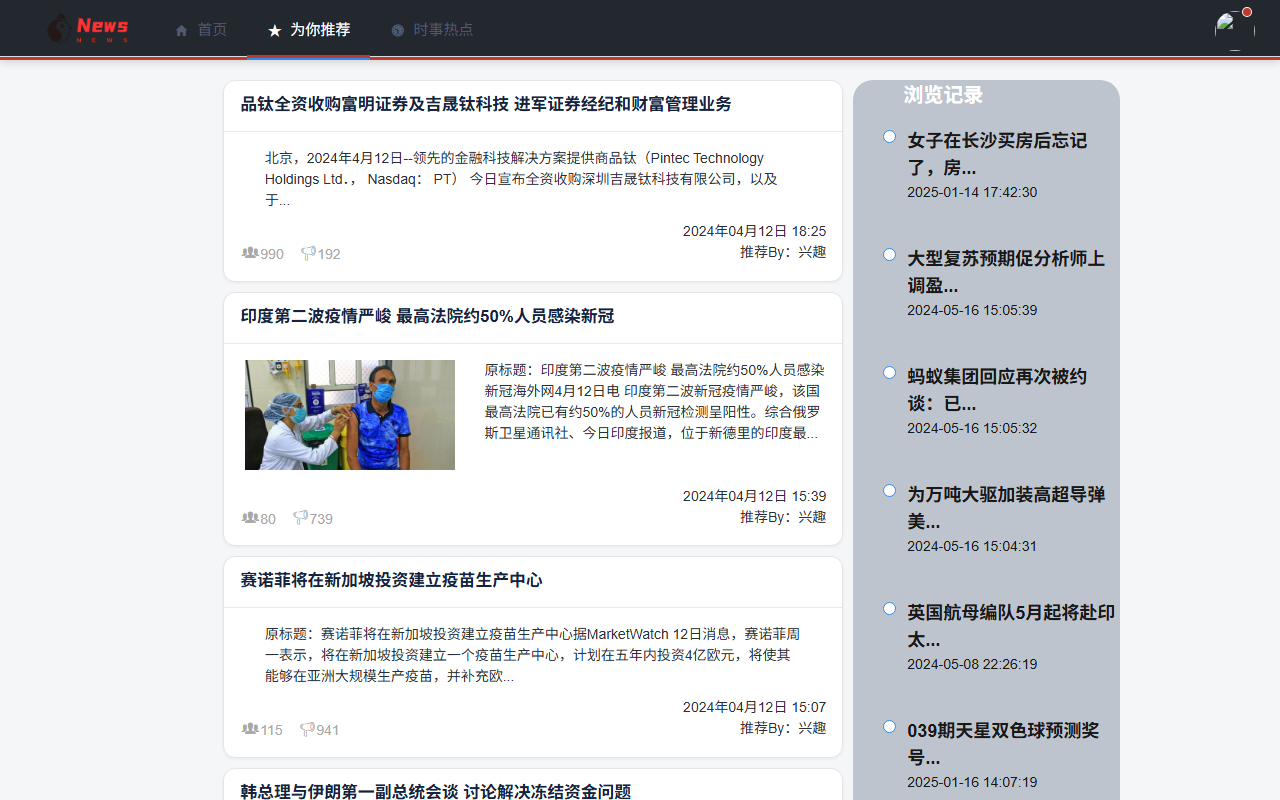
为你推荐:每条推荐都标注了推荐来源,右侧浏览记录与推荐内容形成兴趣闭环:
时事热点榜:按热度值降序,火焰数值即 NewsHotValueCal 的实时计算结果:
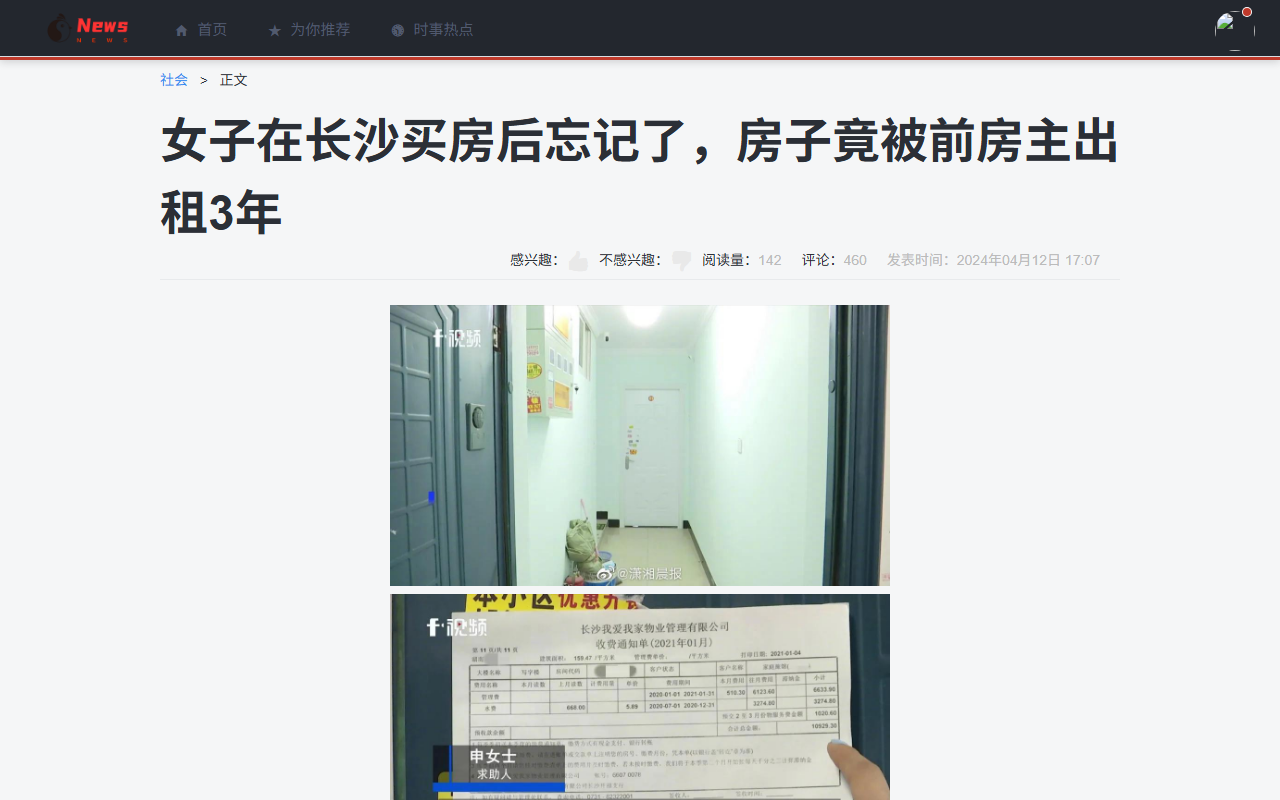
新闻详情页:图文正文、阅读/评论互动数据与相关资讯推荐:
管理端数据概况:六张统计卡 + 推荐量走势图,统计数字由 countUp 动画渲染:
用户数据管理:标签列可以直接看到每个用户的兴趣画像:
推荐系统控制台:一键启停推荐/分析引擎,运行日志实时落盘可查:
六、小结
这个项目最大的价值在于把"推荐系统"从论文概念落成了可运行的工程:jieba 分词质量决定了关键词与相似度的下限,APScheduler 的调度间隔需要在实时性与数据库压力之间折中,热度公式里阅读/评论/点赞的配比则直接塑造了热点榜的"口味"——这些都是动手跑一遍才能体会的细节。
接口层还有不少可以继续演进的方向:推荐结果目前由定时任务批量刷新,可以改为"浏览行为触发 + 定时兜底"的混合策略;相似度计算可以在新闻量级上来后引入向量检索;地域推荐的用户定位也可以细化到城市粒度。如果你正在找一份功能完整、算法链路清晰的 Python 全栈项目研究,这套"新闻 + 推荐 + 可视化"的组合会是一个不错的范本。欢迎在评论区交流实现细节。
完整资源已整理上传(含全部源码、数据库脚本与部署说明):
热点新闻智能推荐分析平台源码 Python+Django+Vue 推荐算法毕设(含演示数据)
如果在实现类似系统时遇到问题,欢迎评论区交流。